推理本身,成了近乎“免费”的数据增强!具身思维链 ECoT ,做对了什么?
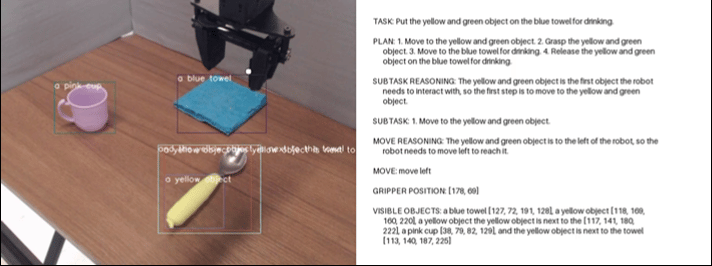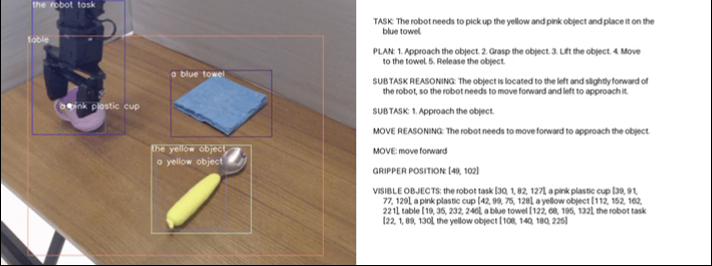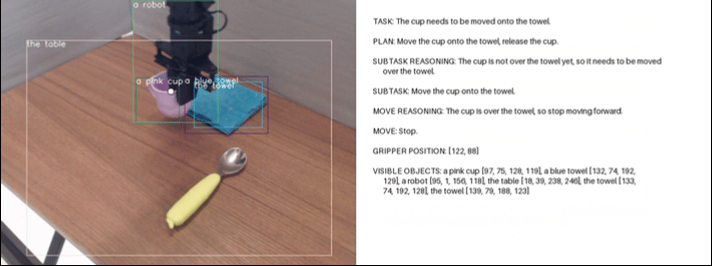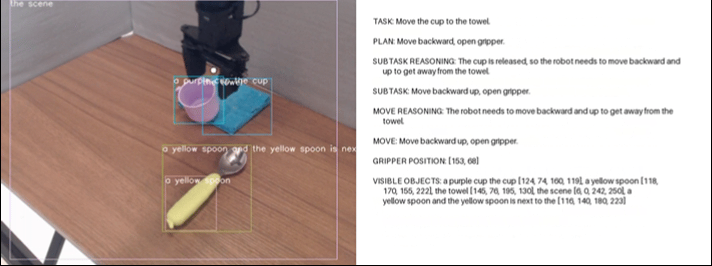
推理本身,成了近乎“免费”的数据增强。
——具身思维链ECoT
目录
过去两年,大语言模型给出过一个极具启发性的答案——思维链(Chain-of-Thought,CoT)。与其让模型直接吐出一个答案,不如让它先把推理过程一步一步写出来;这种"慢思考"显著提升了复杂逻辑任务的准确率。
一个顺理成章的问题随之而来:既然语言模型可以“先想清楚再作答”,机器人能不能也“先想清楚再动手”?
但把文本 CoT 原样搬到机器人身上,会立刻撞上物理世界的墙。语言模型只需要对符号负责,而机器人必须对重力、惯性、碰撞和自身的关节极限负责——
一段逻辑自洽的推理,如果没有锚定在真实的视觉观测与本体状态上,对动作预测几乎没有帮助。
这正是 ECoT(Embodied Chain-of-Thought,具身思维链)的出发点。
据初代 ECoT 论文中所提,在不增加任何真实机器人训练数据的前提下,仅靠这一结构改动,就能让当时最强的开源 VLA 基线在泛化任务上的绝对成功率提升约 28 个百分点——推理本身,成了近乎“免费”的数据增强。
这篇内容,我们将沿着三条线索把 ECoT 拆开来看:背后的数学原理究竟是什么?与文本 CoT 存在哪些本质差异?部署 ECoT 前后,具身智能系统的能力发生了怎样的变化?
01 换到数学视角:ECoT在算什么?
很多人听到“机器人推理”会先入为主地认为,它依赖某种难以言说的经验或直觉。事实恰恰相反:
ECoT的整套运行逻辑可以通过成熟的机器学习数学体系完成解释,所有分步推理和决策流程都对应可量化的运算规则,不存在模糊的经验性判断
——这也是 ECoT 可以被工程化实现、可以被系统化调优的根本前提。
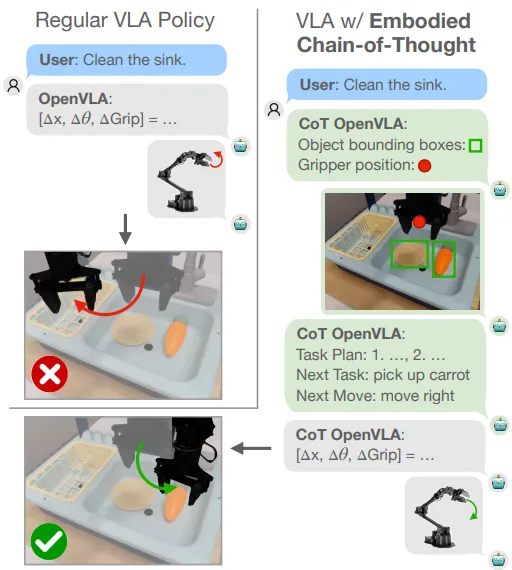
▲图 | 初代ECoT对比VLA有无ECoT的效果
先看全貌:一条被"显式展开"的推理链路
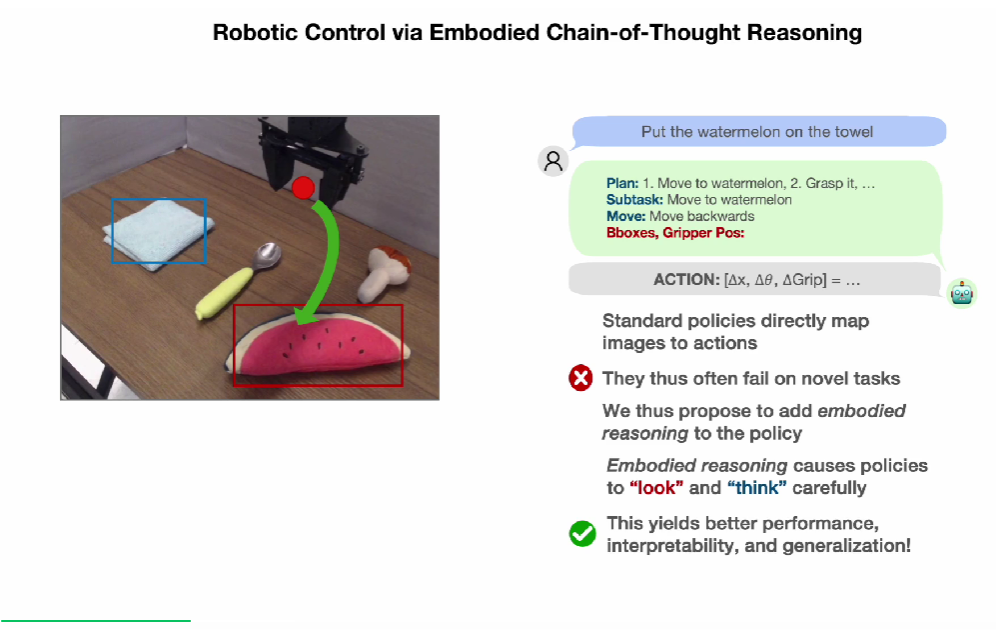
ECoT的意图是非常直观的,既然端到端推理缺乏可解释性也不容易观察和管控,那么我们就把它拆成多个段,段内还是有不可解释性;但段与段之间就有因果关系和可解释性了。
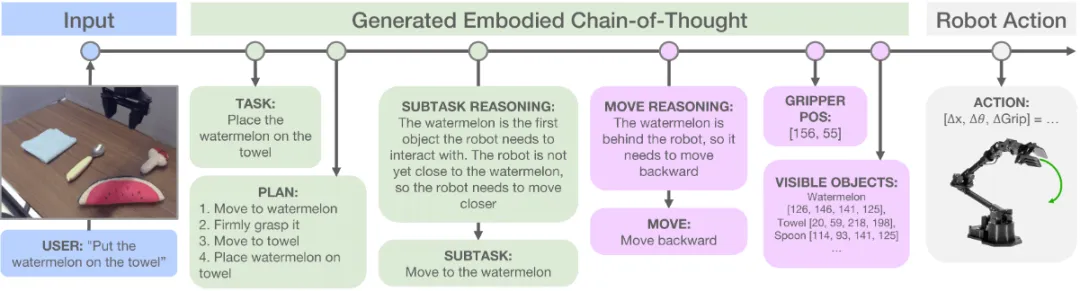
▲图 | ECoT链条示意图
这张图完整呈现了ECoT从人类自然语言指令输入,到机器人最终输出底层控制动作的全流程,每一个环节都保留了对应的推理记录:
- 任务输入:Instruction是整个任务的起始输入节点
内容为自然语言指令 Put the hammer in the basket,是人类向机器人下达的原始作业要求。
- 视觉输入:环境画面,即左侧实景画面节点
直观展示机器人的作业场景,画面里包含待抓取的锤子、目标容器篮子以及机器人本体,是机器人获取视觉环境信息的来源。
- 任务理解:Task 是系统接收到指令后生成的顶层任务节点
明确目标是“Place the hammer in the basket”,把人类的模糊指令转化为机器人可理解的明确任务目标。
- 任务规划:Plan基于顶层任务分解出的完整执行计划节点
包含4个有序步骤:移动到锤子旁→抓取锤子→移动到篮子位置→将锤子丢入篮子,为后续子任务执行划定清晰的路径框架。
- 决策推理:Subtask Reasoning 子任务逻辑判断节点
输出推理结论“锤子是机器人首个需要交互的目标,当前距离过远还未达到可抓取的近距离状态”,为当前阶段的子任务提供决策依据。
- 决策推理:Subtask 基于推理结果生成的当前阶段子任务节点
明确当前要执行的动作是“Move to the hammer”,让机器人聚焦于靠近目标物体这一动作。
- 决策推理:Move Reasoning是移动动作的推理节点
判定锤子处于机器人当前位置的下方,因此机器人需要执行向下移动的操作,把空间位置关系转化为动作方向指令。
- 决策推理:Move输出的具体移动指令节点
内容为“Move downward”,是机器人可直接响应的粗粒度动作指令。
- 状态感知:Gripper Position机器人夹爪的实时状态节点
记录当前夹爪的二维坐标 [164, 102],用于后续抓取动作的位置校准。
- 状态感知:Visible objects视觉感知输出节点
记录当前视野内识别到的物体信息,其中锤子的空间坐标为 [156, 166, 133 ...],为机器人提供目标物体的精确空间定位数据。
- 动作输出:Action作为整个链路的最终输出节点
输出机器人底层控制参数 [Δx, Δθ, ΔGrip],分别对应位移增量、角度增量、夹爪开合度,直接驱动机器人硬件完成对应的物理动作。
- 物理执行:执行画面,即右侧机器人执行画面节点
用来直观展示机器人接收动作指令后,在真实物理空间中执行作业的状态,是整个任务链路的物理落地。
将这 12 个节点归纳起来,整条链路实际可划分为五个功能层:
理解指令 → 规划任务 → 推理决策 → 感知状态 → 输出动作。
每一层都吃进上一层的结果,产出自带语义的中间表征,并把决策依据写入推理日志。
于是在 ECoT 的体系里,“机器人为什么这么做?”在任何一个节点上都能得到回答。
数学基础:三类模型的协同运算
整套数学体系由条件概率自回归建模,马尔可夫时序状态转移,带约束多目标优化三部分内容构成,三类数学模型相互配合,支撑机器人从环境观测到动作输出的完整链式推理过程。
(1)条件概率自回归建模——决定"下一步推理什么"。
ECoT的推理环节生成过程服从条件概率分布:模型每一次输出的推理子步骤,都以当前环境观测特征,历史推理序列以及预设任务目标作为前置条件。模型训练的核心过程就是持续拟合最优的条件概率参数,提升有效推理步骤的生成概率,压低无效推理内容的输出概率。
自回归的建模方式让整套推理链路具备时序递进特性,后续步骤的生成逻辑严格依赖前置步骤的输出结果,形成逻辑闭环的链式结构。
(2)条件概率自回归建模——决定"下一步推理什么"。
时序推演的动态更新过程贴合马尔可夫状态转移规则:模型在任意时刻的推理状态,仅由当前环境状态和近期有效推理序列决定,不需要调用全部历史冗余数据。
这种运算特性大幅降低了模型的算力消耗和推理延迟,能够适合机器人高频次的实时控制需求。
环境发生动态变化时,状态转移矩阵会同步更新参数,让后续推理步骤实时适合新的场景状态,实现推理链路的动态校正。
(3)带约束多目标优化——决定"最终选哪个动作"。
多候选动作的最优筛选过程属于带约束的多目标优化问题。模型将机器人硬件运动极限,空间碰撞规避规则,任务推进进度,能耗控制标准都整理为量化约束条件。
同时将任务完成稳定性和环境适合性设置为目标函数,在有限的可行动作解空间内求解最优执行方案。强化学习的梯度下降算法会持续优化目标函数的权重配比,让模型决策逻辑持续贴合真实物理场景的运行规律,减少不合理动作输出的概率。
直观运行逻辑:从"直连映射"到"结构化分步思考"
ECoT可以理解为机器人的结构化分步思考流程。
传统机器人模型会直接根据环境观测数据输出对应动作,中间不存在逻辑推演的过程,环境出现细微变化就容易出现动作失效的情况。ECoT机制会在动作输出前插入多层推理步骤,设备先完成环境状态识别和任务分解,再生成多个可行动作方案,最后结合场景约束筛选最优动作来执行。
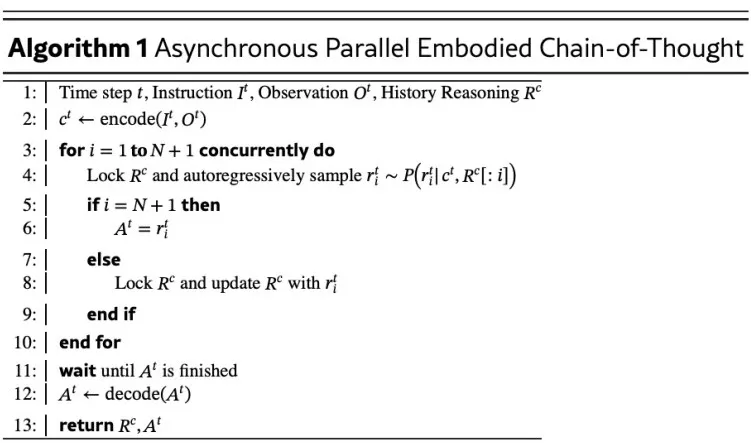
▲图 | 一种并行ECoT算法的流程图,并不复杂
这套运行模式和人类处理复杂物理任务的思考方式存在相似性。
人类完成复杂操作时不会直接输出最终动作,会分步判断场景状态,预判操作带来的后续影响,再确定最终执行方式。
ECoT就是将这种隐性思考逻辑,转化为模型可运算的结构化推理链路,并且通过硬件反馈持续修正推理逻辑,让机器人的作业方式更贴合物理世界的运行规则。
02 ECoT与文本CoT的核心差异:同源,但不同道
文本CoT是大语言模型专属的推理范式,作用是提升语言逻辑推演和文本问答的准确性。
ECoT在文本推理结构的基础上完成体系重构,适合物理交互场景的时序性和空间性需求。
两类思维链的底层场景,推理约束条件以及输出形式存在本质区别,不存在直接替代的关系。
推理约束条件:锚定"符号",还是锚定"物理"?
- 文本CoT
文本CoT的推理全程依托纯文本语义特征完成运算,输入内容和输出内容都属于语言符号序列。整套推理过程不绑定真实物理环境,不考虑空间位置关系和运动约束,推理结果仅需要满足语言逻辑通顺和语义合理即可。
文本CoT的推理链路具备静态属性,同一问题对应的推理逻辑不会随时间发生变化,不需要根据外部环境动态调整推理步骤。
- ECoT
ECoT属于多模态融合推理体系,推理输入包含视觉图像数据,本体姿态数据以及环境传感数据,语言文本仅作为任务指令和推理辅助内容。
整套推理链路的核心服务对象是物理动作执行,所有推理步骤都需要贴合机器人硬件能力和场景物理规则。
推理链路具备动态可变属性,相同任务指令在不同环境状态下,会生成完全不同的推理步骤和动作方案,环境的细微变动都会触发推理逻辑的迭代更新。
两类技术的推理约束维度存在明显区分。
文本CoT仅受语义逻辑和知识图谱的约束,运算过程不需要考虑能耗和空间限制。
ECoT需要同时叠加多重约束条件,包含硬件运动行程限制,运动速度限制,空间碰撞约束,任务时序约束以及能耗约束,所有推理步骤和动作输出都不能突破物理和硬件的边界条件。
推理输出形式:输出"答案",还是输出"动作"?
推理输出的落地形式存在本质不同。
文本CoT最终输出结构化文本推理过程和文本答案,全程无实体动作交互。
ECoT的推理过程是中间运算环节,最终输出的是机器人可执行的运动控制指令,推理结果会直接作用于物理环境,同时环境的反馈数据会反向修正模型后续的推理逻辑,形成闭环迭代体系。
简单来说,文本CoT解决的是语言逻辑层面的思考问题,ECoT解决的是物理交互层面的决策规划问题。文本思维链可以完成抽象逻辑推演,具身思维链可以将抽象逻辑落地为可执行的物理动作,并且适合动态变化的真实场景。
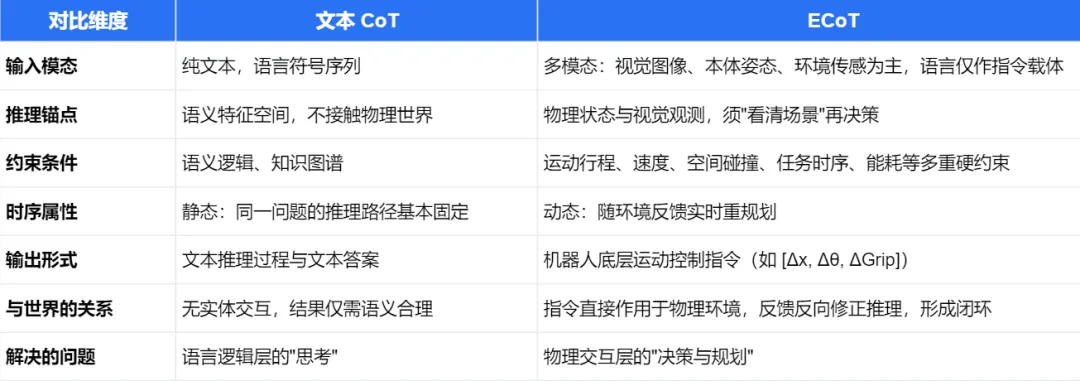
▲图 | 文本 CoT 与 ECoT 的本质差异
03 ECoT部署前后的具身智能效果差异
- 未搭载ECoT的传统具身模型普遍采用端到端直连映射架构,模型直接建立环境观测数据和动作指令的对应关系。
(1)泛化弱
这类模型的训练依托固定场景数据集,在训练场景内可以保持稳定作业状态。但是一旦场景物体位置、环境布局或者任务细节出现小幅变动,模型就容易输出无效动作,出现任务中断或者作业失误的情况。
(2)缺乏长时序任务分解能力
复杂多步骤任务会被模型当作单一映射问题处理,无法拆分出递进式子目标。长周期作业过程中,模型无法识别阶段性任务进度,容易出现路径冗余或者动作遗漏的问题,整体任务完成效率偏低。
(3)失误不可追溯
模型不存在中间推理环节,人类使用者无法追溯动作失误的成因,模型调试和问题优化的难度会大幅提升。
(4)决策偏向局部最优
无ECoT结构的模型决策方式偏向局部最优解。模型仅能根据当前帧环境状态输出即时最优动作,无法预判动作执行后的后续环境变化。部分动作可以完成当前子步骤,但会造成后续作业路径堵塞或者场景状态紊乱,模型没有前置预判能力,整体作业容错率偏低。
- 搭载ECoT结构的具身模型会新增完整的结构化推理链路,模型作业不再依赖单一帧画面的直接映射。
(1)长周期任务推进更稳定
设备可以自主完成高层任务分解,将复杂长时序任务拆分为多个有序可执行的子任务,每一个子任务都对应独立的推理和决策过程,长周期任务的推进稳定性可以得到显著提升。
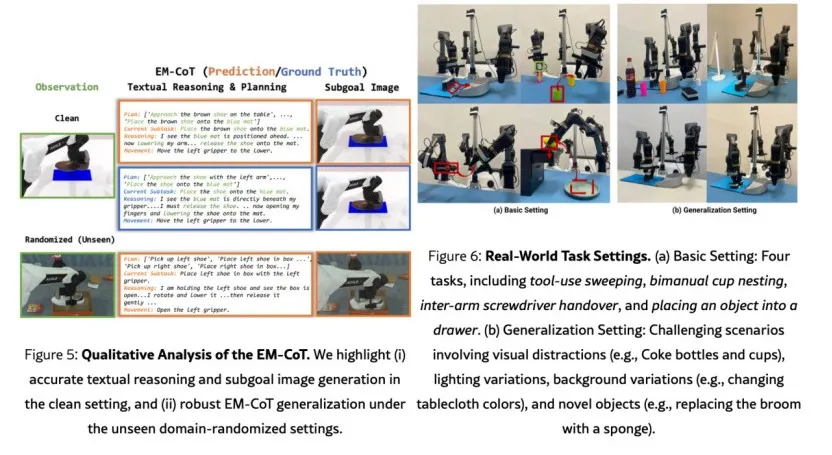
▲图 | 多模态ECoT在真实世界的效果,来自HALO论文
(2)环境动态适配与泛化能力增强
ECoT可以让模型具备环境动态适合的能力。推理链路会实时接收环境反馈数据,对比动作执行结果和预设子目标的偏差,根据偏差信息调整后续规划逻辑。
场景出现未知变动时,模型不会机械复刻固定动作序列,会通过分步推理重新适合场景状态,生成新的作业方案,模型的泛化覆盖范围可以有效拓展。
(3)可解释、可溯源、可迭代
前面我们也提到了:ECoT会留存完整的分步推理记录,每一步动作的生成依据都可以实现溯源。
因此,技术人员可以根据推理日志定位模型失误的具体环节,是场景识别偏差还是任务分解错误,或是动作决策失误,针对性完成模型迭代优化。这种可解释特性是传统直连式模型不具备的核心优势。
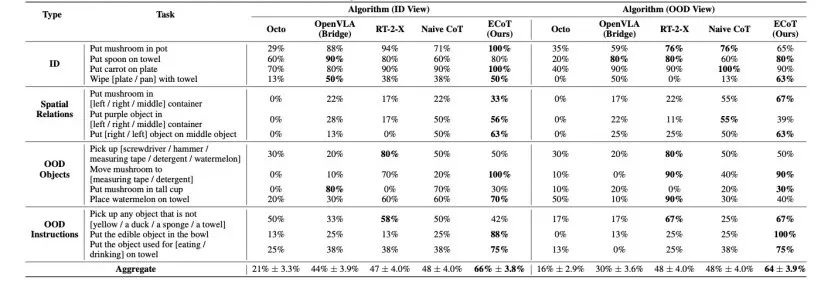
▲图 | 有无ECoT时动作成功率对比
(4)多设备迁移适合效果会出现明显提升
ECoT的结构化推理逻辑聚焦任务本质和环境交互规律,不会绑定单一设备的硬件参数。训练完成的模型推理逻辑,可以适合不同构型的机械臂以及人形机器人,降低了不同设备的模型迭代成本,提升了通用机器人的研发效率。
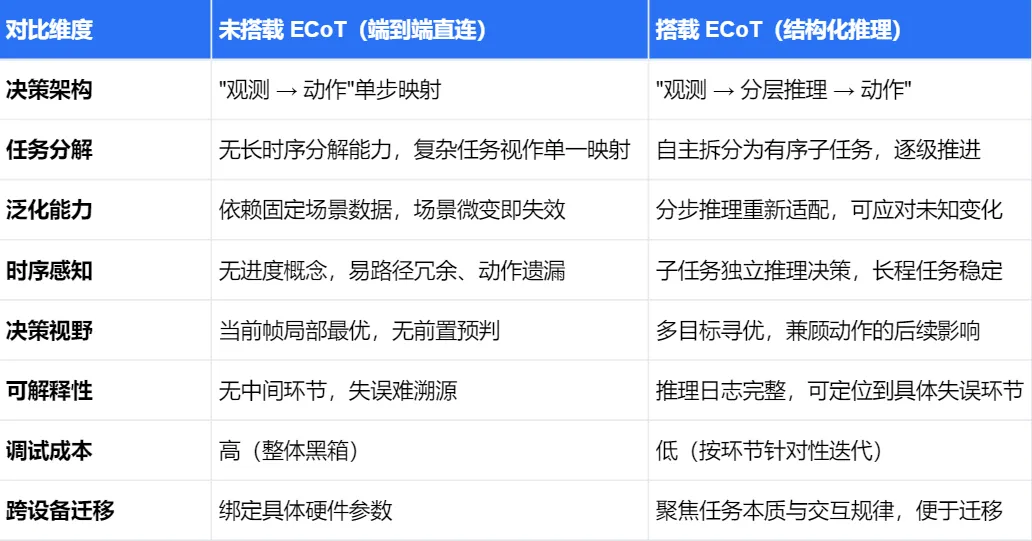
▲图 | 部署 ECoT 前后的能力对比
04 让机器人的每一步,都经得起追问
模型的进步不只来自参数规模的扩张,更来自决策结构的升级。端到端直连让机器人学会了“做”,ECoT 则让机器人开始“知道为什么这么做”——它把一段无法被审视的黑箱决策,拆解成一条可以被阅读、被校验、被纠错的推理链。
ECoT,更像是一个路口的标志。
初代 ECoT 已经证明,大语言模型的“慢思考”能力可以被迁移到物理世界;而新一代研究正在追问更深的问题:
推理究竟应该作为显式的文本痕迹存在,还是被蒸馏进模型的隐式表征、只作为训练信号而不参与在线推理?当推理不再需要逐字生成,模型能否在保留泛化红利的同时,摆脱长思维链带来的时延与误差累积?高层的任务认知,又能在多大程度上跨平台、跨本体迁移?
这些问题的答案尚未尘埃落定,但方向已经清晰——让机器人的“思维链”不再悬浮于符号空间,而是与重力、惯性、碰撞这些物理法则逐一对齐。
Ref
1. Robotic Control via Embodied Chain-of-Thought Reasoning. ECoT 领域奠基原创论文,正式提出具身思维链基础框架与训练范式,收录于 CoRL 2024。
2. Fast ECoT: Efficient Embodied Chain-of-Thought via Thoughts Reuse. ECoT 推理加速核心论文,解决原生自回归推理延迟过高的工程落地问题。
3. Revisiting Embodied Chain-of-Thought for Generalizable Robot Manipulation. 国内团队完成的 ECoT 复盘修正研究,完善稀疏奖励与高精度操作场景的推理缺陷。
4. Training Vision-Language-Action Models with Dense Embodied Chain-of-Thought Supervision. ZR-0 模型配套论文,提出密集型 ECoT 监督方案,验证通用机器人多设备适合能力。
5. Embodied Chain of Action Reasoning with Multi-Modal Foundation Model for Humanoid Loco-manipulation. 属于人形机器人 ECoT locomotion 拓展研究,面向全身运动操控推理优化。
6. HALO: A Unified Vision-Language-Action Model for Embodied Multimodal Chain-of-Thought Reasoning, 是多模态统一 ECoT 推理架构研究,拓展复杂遮挡与动态干扰场景的推理稳定性。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 1
 0
- 0


 已为社区贡献216条内容

所有评论(0)