斩获 ICRA 2026 双最佳论文的运动重定向,三条技术路线一次讲透
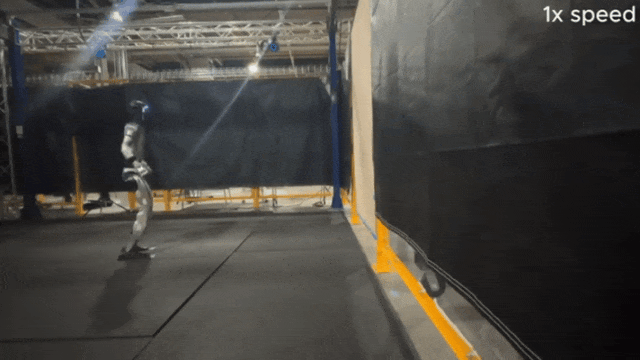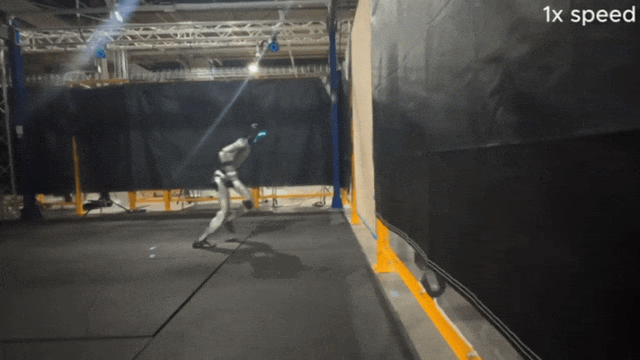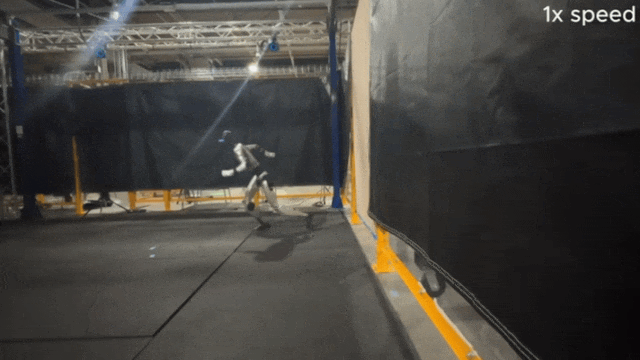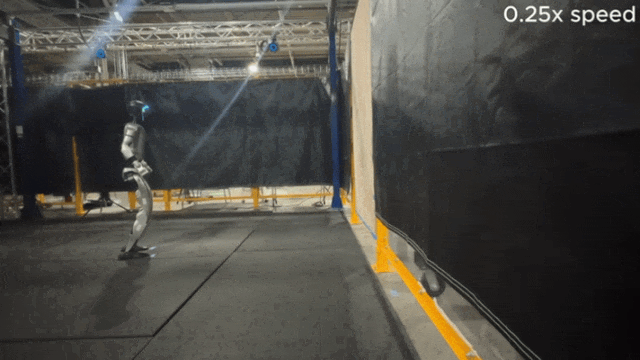
机器人运动重定向:运动学、深度学习、物理交互
——从IK求解,到ICRA 2026最佳论文
目录
GMR(General Motion Retargeting,通用运动重定向),适配多类人形机器人的通用动作迁移算法框架。
PHC(Pose-based Humanoid Control,基于姿态的人形机器人控制),靠人体姿态数据优化机器人关节运动的基础控制方案。
人类自然流畅的动作背后,是复杂的骨骼结构、肌肉协调与物理直觉,如何将这类高维演示数据“翻译”为机器人可执行的关节指令?
这便是运动重定向(Motion Retargeting)技术所要解决的关键任务。
运动重定向(Motion Retargeting)可以将人类这类源角色的动作数据,完成转换后,输入形态结构存在差异的机器人设备,生成机器人可以直接执行的关节轨迹,而且最好是同步超低时延。
一般来说,人体动作捕捉数据无法直接用于机器人控制,人体和机器人的肢体连杆比例存在区别,关节数量和关节运动形式也不相同,硬件层面的运动限位和动力学参数也有明显出入。
直接照搬人体关节角度数据会让机器人出现肢体形变和姿态偏移,还会产生设备运动超限等无效运行状态。
▲图 | 科幻电影《铁甲钢拳》是对retarget的最好注解之一,来自网络
该技术的基础理论体系成型于1998年,后续业界研究逐步落地出三类主要实现方式,不同实现方式的技术原理和落地场景存在明显区别,各类方案也在实际应用中持续迭代优化。
01 基于逆向运动学IK的约束优化路线
基于逆向运动学IK(Inverse Kinematics,逆向运动学,通过设备末端目标位置反解各关节运动参数的机器人运动求解算法)是落地时间最早且工业场景应用最成熟的技术方案,该方案将运动重定向流程转化为带多重约束的数值优化求解流程。
这套技术体系不需要靠大规模训练数据集(那时候也没有训练这个概念)。
系统会靠机器人和人体的骨架匹配逻辑,结合笛卡尔空间姿态对齐方式,通过逆运动学算法修正机器人关键点位置,缩小机器人姿态和人体源动作姿态的误差。
系统运算过程中会嵌入机器人的硬件运行规则,会参考关节角度的极限范围,设备运行的扭矩上限,同时规避肢体自碰撞问题以及足部接触地面的稳定约束,逐帧输出合规的机器人关节角度数据。
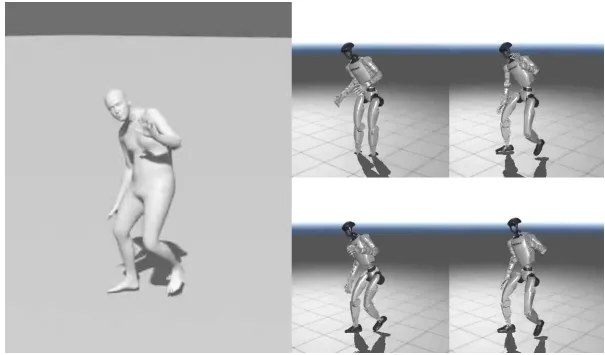
▲图 | 原始动作与机器人动作,来自论文《Retargeting Matters》
GMR(General Motion Retargeting,通用运动重定向),适配多类人形机器人的通用动作迁移算法框架。
通用运动重定向框架是该技术路线的代表性成果,也是人形机器人领域应用广泛的标杆工具。
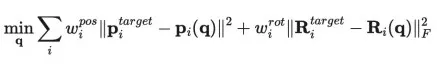
▲图 | GMR的核心还是机器人追随人类动作的误差最小化,来自论文《Retargeting Matters》
这套框架的运行流程包含多个基础步骤:
系统先完成人体与机器人主要刚体结构的匹配工作,再对静止状态下的设备姿态做空间对齐处理,通过局部尺度调整修正肢体迁移偏差,最后完成躯干根基姿态和全身姿态的迭代求解。
传统重定向方式会用统一尺度缩放处理动作数据,这种处理方式容易造成机器人动作畸变。
GMR框架采用差异化局部缩放模式,对躯干和四肢等不同身体结构做独立迁移处理,大幅减少设备运行时的姿态异常问题。
该框架可以满足实时运行需求,能够适配多款主流人形机器人设备,也可对接普通单目视频提取的人体姿态数据。
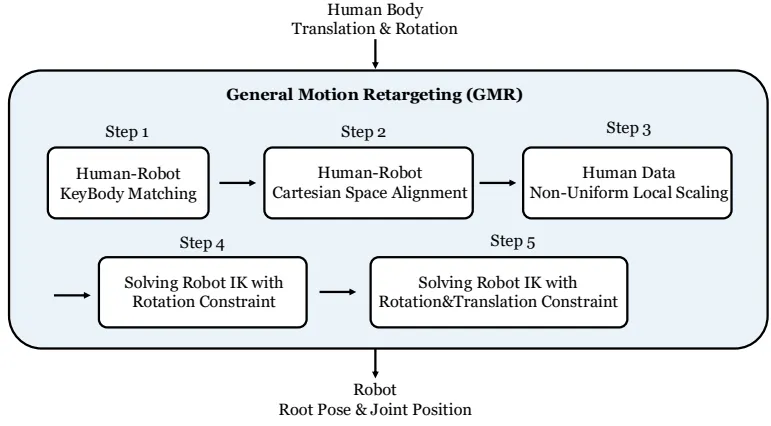
▲图 | GMR的五个步骤,来自论文《Retargeting Matters: General Motion Retargeting for Humanoid Motion Tracking》
PHC(Pose-based Humanoid Control,基于姿态的人形机器人控制),靠人体姿态数据优化机器人关节运动的基础控制方案。
姿态人形控制方案也是该领域的基础实现方式,业内常将其作为基准对比模型。
该方案靠SMPL人体模型完成姿态拟合,通过梯度下降算法优化全身关节的运动参数。
这套方案的缺陷比较明显,针对形态差异较大的机器人设备,最终生成的动作数据会存在较多偏差,一般需要搭配强化学习算法做二次修正,目前仅用于技术对比测试场景。
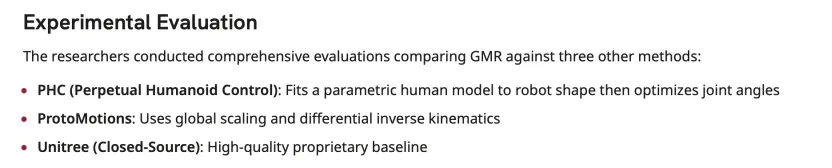
▲图 | PHC用于技术对比测试
- 优势
基于逆向运动学的优化方案可解释性好,人为调参的可控性更强,能够直接适配实体机器人硬件设备,现场调试的操作难度更低。整套体系不依赖数据训练,实时运算表现可以满足遥操作这类实时控制场景的需求。
- 劣势
该方案的短板也较为突出,逐帧求解的模式缺少长时序的整体判断逻辑,机器人和人体形态差距过大时,算法求解结果容易陷入局部最优状态。
但是,这套技术很难自主适配人机交互场景,需要工作人员手动增设多重约束条件,对原始动作的风格特征保留效果相对有限。
02 基于深度学习的数据驱动重定向路线
深度学习技术的普及,让运动重定向摆脱了传统人工调参的固有模式,相关算法可以自主学习人体动作到机器人动作的转换逻辑,实现动作语义和运动风格的跨设备迁移。
该技术路线的主要思路是搭建统一的特征隐空间,把人体运动信息和机器人运动信息编码取齐至同一空间,拆分出动作内容信息和设备形态信息,屏蔽不同载体的硬件差异。
系统输入人体动作数据后,会直接输出适配目标机器人的完整运动序列。业内根据数据使用形式的不同,将该路线分为有监督配对学习和无监督跨域映射两种分支。
有监督配对学习
有监督配对学习需要靠一一对应的人体与机器人动作样本,来完成模型训练。
高质量配对数据的采集流程复杂且成本很高,很难覆盖不同型号的机器人设备,所以该技术分支的工程落地范围相对有限。
无监督跨域映射
无监督对抗式重定向是目前应用更多的深度学习方案,这类方案靠循环一致性损失函数,在无需配对样本的前提下完成跨设备运动迁移。
Human2Humanoid(Human to Humanoid,人体动作转人形机器人动作,专为人体机器人动作跨域迁移设计的图卷积算法。
该算法引入骨架感知图卷积结构,靠末端执行器约束条件,结合设备关节限位规则优化输出结果,能有效减少机器人运行过程中的物理姿态异常。
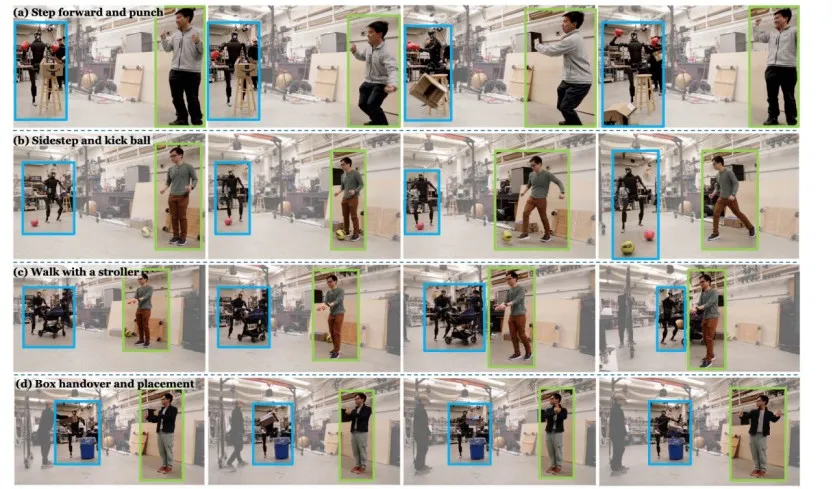
▲图 | Human to Humanoid
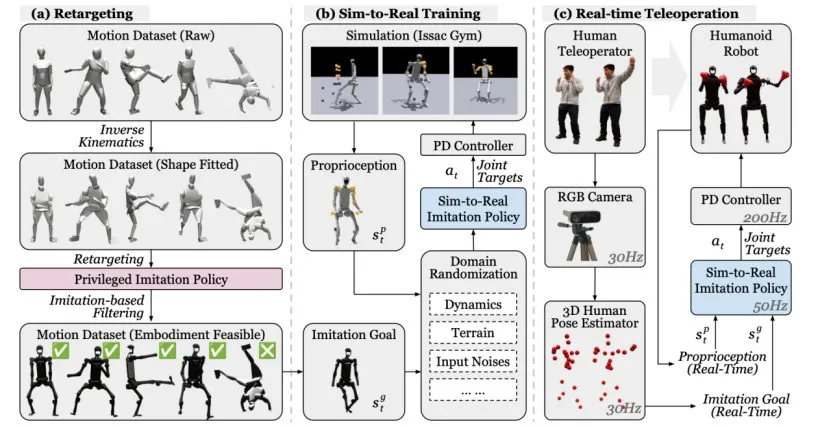
▲图 | Human to Humanoid的a和b是在训练,c是在遥操作
MoReFlow(Motion Retargeting Flow,运动重定向流模型)基于流匹配机制的跨角色运动适配算法。
模型靠流匹配逻辑完成运动迁移,借助VQ-VAE(Vector Quantized Variational Autoencoder,向量量化变分自编码器)用于对时序动作数据做编码压缩以及特征提取的深度学习模型,结构实现动作编码,不同载体的运动特征可以完成精确对齐,模型泛化表现优于传统对抗生成网络方案。
AdaMorph(Adaptive Morphology Retargeting,自适应形态重定向)适配多类机器人拓扑结构的通用动作重定向大模型。
统一大模型是该路线的前沿研究方向,模型可以适配多种拓扑结构不同的机器人设备。
研究人员将运动重定向定义为条件生成任务,先把人体动作转化为脱离设备形态的动作意图特征,再结合目标机器人的硬件参数动态调整输出结果,能够对未参与训练的新型机器人完成动作重定向处理。
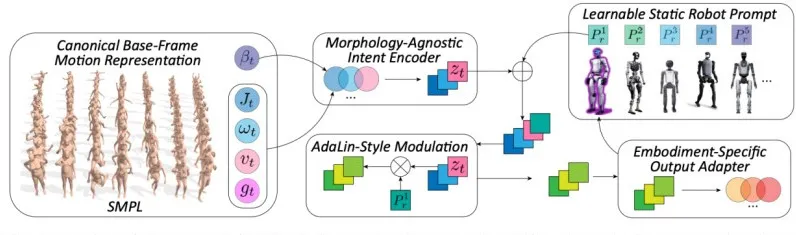
▲图 | 自适应形态重定向一览图
- 优势
数据驱动的重定向方案可以完整保留原始动作的细节特征和风格特点,通用大模型能够适配多类机器人设备,对灵巧手这类高自由度设备的动作迁移效果更好。
- 劣势
模型最终输出结果的质量会直接受训练数据分布影响,部分复杂模型的推理延迟偏高,无法适配高频实时控制场景。算法生成的动作数据存在不可控的情况,部署到实体设备前需要完成安全校验工作,模型原生处理物理接触和环境交互场景的能力偏弱,大多需要配套后处理流程修正运动轨迹。
03 基于物理约束与交互感知的前沿路线
前述两类技术方案大多只针对骨骼运动学特征做迁移处理,不会考虑机器人和外部环境以及操作物体的互动关系。
单纯依靠骨骼姿态对齐生成的运动轨迹,在仿真测试和真机运行过程中,容易出现足部滑移和地面穿透等问题,机器人抓取的物体也可能出现位置偏移,这类轨迹无法直接用于实际作业。
物理约束与交互感知重定向技术,将设备动力学特征和接触关系纳入算法优化体系,不再单一对齐关键点的空间位置,重点建模设备和外部环境的互动逻辑,保障最终生成的运动轨迹具备实际执行可行性。
DynaRetarget(Dynamic Motion Retargeting,动态运动重定向)面向长时序高动态动作的物理可行轨迹优化算法。
是该路线的代表性技术之一,主要用于解决长时序动态运动的适配问题。
这套技术靠采样轨迹优化框架,对IK算法或深度学习模型生成的初始轨迹做二次优化处理,通过逐步扩大时序优化范围的方式,解决高维长序列运算难以收敛的业界痛点。
经过该算法优化的运动轨迹,完全贴合机器人的动力学约束规则,对跑跳这类动态幅度较大的动作适配效果优异,也能提升后续强化学习策略训练过程的稳定性。
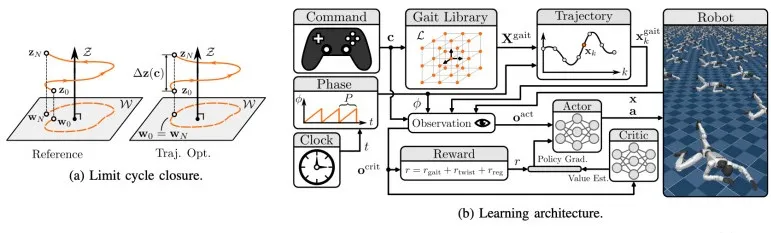
▲图 | Dynamic Motion Retargeting示意图,里面机器人在爬而不是走,是强调更多物理接触和物理约束
ReActor(Reactive Actor Retargeting,响应式动作重定向)结合仿真校验的物理可行动作迁移算法。
该算法将重定向流程和仿真运行环境深度结合,把物理可行性判定纳入算法优化闭环。系统靠仿真器完成动力学校验工作,通过两级优化机制剔除不符合硬件运行规则的动作数据,输出适配机器人力矩平衡特性的运动轨迹,有效解决传统算法仿真效果达标但真机运行失效的问题。
- 优势
这类前沿技术可以生成物理逻辑合规的运动轨迹,能够适配复杂的人机交互作业场景。靠该技术产出的轨迹数据,能够加快机器人策略训练的收敛速度,生成结果更贴合实体设备的运行边界。
- 劣势
整套算法的运算开销较大,多数方案无法实现实时运算,且高度依赖仿真环境支撑运算流程,迭代优化需要消耗较长时间,更适合离线生成高质量运动数据集。
04 OmniRetarget专项技术详解
OmniRetarget是面向人形机器人全身移动操作场景研发的交互感知重定向系统,由亚马逊FAR团队联合麻省理工学院以及加州大学伯克利分校共同研发,是当前交互类运动重定向领域的主要落地成果。
▲图 | OmniRetarget:ICRA2026最佳会议论文奖、ICRA2026机器人操作与运动最佳论文奖,非常值得单独一节描述
该系统突破了传统重定向技术只优化肢体姿态的局限,主要创新在于引入交互网格技术,专门用于处理设备和外部场景的关联适配问题。
该系统的主要运行逻辑是通过交互网格完成多维度关系建模,系统会实时记录智能体自身姿态,地形环境结构以及操作物体的空间位置关联,在运动重定向的全流程中保留各类关键空间约束关系。
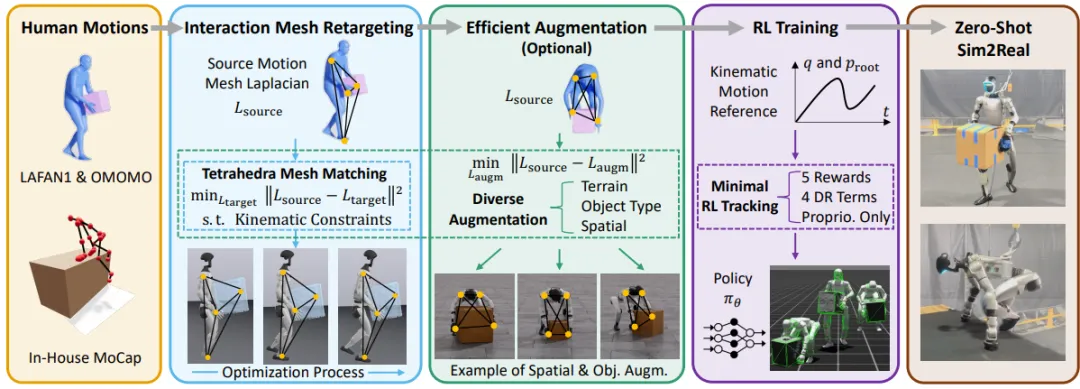
▲图 | OmniRetarget一览图,来自原始论文
传统算法迁移搬运和翻越障碍这类交互动作时,容易改变肢体和物体的相对位置,最终导致机器人作业逻辑失效。
OmniRetarget可以完整留存原始动作的交互逻辑,保证迁移后的机器人动作和人类示范动作的作业意图保持一致。
更具体来讲,训练人形机器人全身运动的传统路径是拍一段人类做动作的视频,把动作"映射"到机器人身上(重定向),用映射后的轨迹训练强化学习策略。
这条路有点生搬硬套的味道,有两个致命缺陷:物理不可行和交互信息丢失。
- 物理不可行
物理不可行因为人类和机器人的身体结构差异巨大——比例不同、质量分布不同、关节自由度不同。
简单的关键点映射会导致脚在仿真里离地走完全没有接触或者摩擦、穿模(身体部分穿进墙里)、重心漂移等等,生成的"参考轨迹"在物理上无法执行。
- 交互信息丢失
交互信息丢失是指人与物的交互关联信息在视屏中丢掉了。
当一个人搬椅子踩上去爬高台,关键信息不是他各个部位在空间中的绝对坐标,而是"手抓住了椅子边缘、脚踩在椅子面上、身体重心压在前脚掌"——这些人与物体人与环境的接触(交互)信息。
传统重定向因为只做几何映射,这些关系没有体现。
- OmniRetarget
为此,OmniRetarget的主要创新是一张叫做"交互网格"(Interaction Mesh)的东西,可以想象为一张画着格点的胶皮膜。
要把一个真人的动作映射到一个机器人身上。OmniRetarget的做法是在这张弹性网上,不仅连接机器人身体各部位,还把机器人-物体-地形之间的空间与接触关系都包括进去——脚与台阶边缘的距离、手与扶手的相对位置、身体重心与支撑点的空间分布。
然后,用拉普拉斯变形优化(Laplacian Deformation Minimization)来求解重定向,在满足关节限位、碰撞避免、足部接触稳定性等硬约束的前提下,最小化人类网格与机器人网格之间的变形。
就像拉伸一张橡皮网——整体形状会变,但网格中每个点的相对关系依然保持。
这套系统具备数据增强的运行特性,单条人类示范轨迹可以通过算法衍生出多组适合不同物体尺寸和地形条件的机器人运动轨迹。扩充后的数据集可以直接用于机器人强化学习训练,能够降低仿真环境到实体设备的迁移误差,实现零样本真机迁移效果。
在全身协同操作的复杂场景中,该系统的运行稳定性明显优于传统运动学重定向方案,解决了复杂交互场景下动作失真和任务失效的主要问题。
- 应用优势
从实际应用来看,OmniRetarget更适合机器人实景作业的主要需求。它不再优先追求精确对齐骨骼点位,而是以任务交互的合理性作为主要优化目标,让人形机器人的复杂实操动作满足现实。
- 劣势
该系统的缺陷和多数交互感知类方案一样,就是成本高,复杂的多维度建模流程会增加运算耗时,暂时无法支撑高频实时遥操作场景,主要用于生产离线高质量运动数据,以及复杂操作技能的模型训练。
05 技术融合与未来发展趋势
现阶段业界不会单独使用某一种重定向技术,多数落地项目采用混合技术架构完成开发工作。
通常会靠逆向运动学算法完成基础动作适配,利用深度学习模型优化动作细节与风格特征,最后通过物理交互感知模块完成轨迹校验修正,兼顾系统运行实时性,动作还原度以及真机执行稳定性。
——一层层向上微调。
运动重定向是衔接人类动作演示与机器人自主运行的主要技术。
传统逆向运动学方案搭建了工程落地的基础框架,深度学习技术提升了动作迁移的泛化效果与细节还原度,物理交互感知方案意在解决复杂场景下的真机落地难题。
三类技术体系相互补充,持续推动人形机器人模仿学习技术的产业化应用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 11
 0
- 0


 已为社区贡献216条内容

所有评论(0)