microduck_rl(MuJoCo+PPO+WandB+UV训练机器人)
·
- MuJoCo:
- MuJoCo Warp:
- mjlab:
- rsl_rl:
- PPO:
- WandB:
- UV:
一、win11安装wsl ubuntu环境
1. windows开启wsl,查看wsl版本:
    启动或关闭windows功能,勾选[虚拟机平台]+[适用于Linux的windows子系统]
2. 管理员权限打开powershell,查看wsl版本
    wsl --version
3. 更新wsl:
    wsl --update
4. 查看可安装的系统:
    wsl --list --online
5. wsl安装ubuntu2204:
    wsl --install -d Ubuntu-22.04 --location D:\WSL\ubuntu2204x64
6. 查看已安装的系统
    wsl -l -v
    wsl --list --verbose
7. 启动指定系统
    wsl -d Ubuntu-24.04
8. 设置默认启动系统
	wsl --set-default Ubuntu-24.04
9. 卸载已安装系统
    wsl --unregister Ubuntu-22.04
10. 关闭wsl
    wsl --shutdown
11. 备份wsl系统
    wsl --shutdown
    wsl --export Ubuntu-22.04 D:\WSL_Backup\Ubuntu2204.tar
12. 恢复wsl系统
    wsl --import Ubuntu-22.04 D:\WSL\Ubuntu-22.04 D:\WSL_Backup\Ubuntu2204.tar --version 2

1. 更新:
    sudo apt update && sudo apt upgrade
2. 检查wsl.conf存在
    cat /etc/wsl.conf
3. 安装Ubuntu Desktop:
    sudo apt install ubuntu-desktop -y
4. 安装XRDP:
    sudo apt install xrdp -y
5. 启动XRDP:
    sudo service xrdp start
6. 查看IP
    ip addr
7. 主机远程登录ubuntu界面
    mstsc
二、在wsl ubuntu环境使用GPU CUDA
三、训练步骤
Step 1:准备 Ubuntu + NVIDIA GPU
	nvidia-smi

Step 2:安装 uv
	curl -LsSf https://astral.sh/uv/install.sh | sh

Step 3:下载代码
	git clone https://github.com/pollen-robotics/microduck_rl
	cd microduck_rl

Step 4:安装依赖
	//uv sync
    //uv sync -i https://pypi.tuna.tsinghua.edu.cn/simple
    uv sync -i https://mirrors.aliyun.com/pypi/simple/
    //uv sync -i https://pypi.mirrors.ustc.edu.cn/simple/

Step 5:登录 WandB
	./.venv/bin/wandb login
    此处需要输入wandb key,需要登陆wandb官网登陆后创建key

Step 6:查看任务
	uv run list-envs

Step 7:跑 smoke test
	uv run train Mjlab-Velocity-Flat-MicroDuck \
		--env.scene.num-envs 64 \
		--agent.max_iterations 5

Step 8:正式训练
	uv run train Mjlab-Velocity-Flat-MicroDuck \
		--env.scene.num-envs 4096
    查看训练过程:uv run play Mjlab-Velocity-Flat-MicroDuck --checkpoint-file /home/chunyangzhang/microduck_rl-develop/wandb/run-20260910_020602-unkowd3z/files/model_250.pt --viewer viser
    在浏览器查看:http://localhost:8080/
	官方给出的经验是,4096 environments 下,得到一个可用 gait 大约需要 1–2 小时,具体当然取决于 GPU。


Step 9:查看训练结果
	uv run play \
		Mjlab-Velocity-Flat-MicroDuck \
		--wandb-run-path <entity/project/run_id>

Step 10:导出
	uv run scripts/export.py \
		Mjlab-Velocity-Flat-MicroDuck \
		--wandb-run-path <entity/project/run_id>
	得到:
	output.onnx

Step 11:CPU仿真验证
	uv run scripts/infer_policy.py \
		--walking output.onnx

Step 12:再考虑部署到真实 Microduck
	output.onnx
		  ▼
	Microduck policy/runtime
		  ▼
	robotd
		  ▼
	真实机器人
四、创建自定义动作
五、创建自定义训练任务
六、创建自定义机器人
七、PPO训练详解(结合cuda+GPU/GPGPU)
以下是一个倒立摆使用Pytorch编写的PPO训练及推理代码,与microduck_rl不同,microduck_rl使用MuJoCo Warp+PPO框架,这个示例直接编写代码,但原理一样,作为参考:
train.py:
import gymnasium as gym
import numpy as np
import torch
import torch.nn as nn
import torch.optim as optim
from torch.distributions import Categorical


# ============================================================
# 1. Actor-Critic 网络
# ============================================================

class PolicyNetwork(nn.Module):

    def __init__(self, state_dim, action_dim):
        super().__init__()

        # Actor 和 Critic 共享的特征提取网络
        self.shared = nn.Sequential(
            nn.Linear(state_dim, 64),
            nn.Tanh(),
            nn.Linear(64, 64),
            nn.Tanh()
        )

        # Actor
        self.policy_head = nn.Linear(64, action_dim)

        # Critic
        self.value_head = nn.Linear(64, 1)

    def forward(self, x):

        feature = self.shared(x)

        logits = self.policy_head(feature)

        value = self.value_head(feature).squeeze(-1)

        return logits, value

    # 获取 action、log_prob、value
    def get_action_and_value(self, x, action=None):

        logits, value = self.forward(x)

        dist = Categorical(logits=logits)

        if action is None:
            action = dist.sample()

        log_prob = dist.log_prob(action)

        entropy = dist.entropy()

        return action, log_prob, entropy, value


# ============================================================
# 2. RolloutBuffer
# ============================================================

class RolloutBuffer:

    def __init__(self):

        self.states = []
        self.actions = []
        self.rewards = []
        self.dones = []
        self.values = []
        self.log_probs = []

    def clear(self):

        self.states.clear()
        self.actions.clear()
        self.rewards.clear()
        self.dones.clear()
        self.values.clear()
        self.log_probs.clear()


# ============================================================
# 3. GAE
# ============================================================

def compute_gae(
    rewards,
    values,
    dones,
    next_value,
    gamma=0.99,
    lam=0.95
):

    advantages = np.zeros(len(rewards), dtype=np.float32)

    last_gae = 0.0

    for t in reversed(range(len(rewards))):

        if t == len(rewards) - 1:
            next_non_terminal = 1.0 - dones[t]
            next_val = next_value
        else:
            next_non_terminal = 1.0 - dones[t + 1]
            next_val = values[t + 1]

        delta = (
            rewards[t]
            + gamma * next_val * next_non_terminal
            - values[t]
        )

        last_gae = (
            delta
            + gamma * lam * next_non_terminal * last_gae
        )

        advantages[t] = last_gae

    returns = advantages + np.array(
        values,
        dtype=np.float32
    )

    return advantages, returns


# ============================================================
# 4. PPO Update
# ============================================================

def ppo_update(
    model,
    optimizer,
    states,
    actions,
    old_log_probs,
    advantages,
    returns,
    clip_eps=0.2,
    value_coef=0.5,
    entropy_coef=0.01,
    epochs=4,
    batch_size=64
):

    # Advantage标准化
    advantages = (
        advantages - advantages.mean()
    ) / (advantages.std() + 1e-8)

    dataset_size = states.shape[0]

    for _ in range(epochs):

        indices = torch.randperm(dataset_size)

        for start in range(0, dataset_size, batch_size):

            end = start + batch_size

            batch_idx = indices[start:end]

            batch_states = states[batch_idx]
            batch_actions = actions[batch_idx]
            batch_old_log_probs = old_log_probs[batch_idx]
            batch_advantages = advantages[batch_idx]
            batch_returns = returns[batch_idx]

            # 当前策略重新计算
            _, new_log_probs, entropy, values = (
                model.get_action_and_value(
                    batch_states,
                    batch_actions
                )
            )

            # PPO ratio
            ratio = torch.exp(
                new_log_probs - batch_old_log_probs
            )

            # PPO clipping
            surr1 = ratio * batch_advantages

            surr2 = torch.clamp(
                ratio,
                1.0 - clip_eps,
                1.0 + clip_eps
            ) * batch_advantages

            policy_loss = -torch.min(
                surr1,
                surr2
            ).mean()

            # Value loss
            value_loss = (
                (values - batch_returns) ** 2
            ).mean()

            # Entropy
            entropy_loss = entropy.mean()

            # 总Loss
            loss = (
                policy_loss
                + value_coef * value_loss
                - entropy_coef * entropy_loss
            )

            optimizer.zero_grad()

            loss.backward()

            torch.nn.utils.clip_grad_norm_(
                model.parameters(),
                0.5
            )

            optimizer.step()


# ============================================================
# 5. 导出 ONNX
# ============================================================

def export_onnx(model, state_dim, filename):

    # 创建一个只包含 Actor 的网络
    class ActorOnly(nn.Module):

        def __init__(self, policy):
            super().__init__()

            self.shared = policy.shared
            self.policy_head = policy.policy_head

        def forward(self, x):

            x = self.shared(x)

            logits = self.policy_head(x)

            return logits

    actor = ActorOnly(model)

    actor.eval()

    # 创建假的输入
    dummy_input = torch.randn(
        1,
        state_dim,
        dtype=torch.float32
    )

    # 导出 ONNX
    torch.onnx.export(
        actor,
        dummy_input,
        filename,
        input_names=["observation"],
        output_names=["logits"],
        dynamic_axes={
            "observation": {
                0: "batch_size"
            },
            "logits": {
                0: "batch_size"
            }
        },
        opset_version=17
    )

    print(f"ONNX模型已保存:{filename}")


# ============================================================
# 6. PPO训练
# ============================================================

def train():

    device = torch.device(
        "cuda"
        if torch.cuda.is_available()
        else "cpu"
    )

    print("Device:", device)

    env = gym.make("CartPole-v1")

    state_dim = env.observation_space.shape[0]

    action_dim = env.action_space.n

    print("State dimension:", state_dim)
    print("Action dimension:", action_dim)

    model = PolicyNetwork(
        state_dim,
        action_dim
    ).to(device)

    optimizer = optim.Adam(
        model.parameters(),
        lr=3e-4
    )

    buffer = RolloutBuffer()

    num_updates = 500

    rollout_steps = 1024

    for update in range(num_updates):

        buffer.clear()

        state, info = env.reset()

        episode_reward = 0

        # ====================================================
        # Rollout
        # ====================================================

        for step in range(rollout_steps):

            state_tensor = torch.tensor(
                state,
                dtype=torch.float32,
                device=device
            ).unsqueeze(0)

            with torch.no_grad():

                action, log_prob, _, value = (
                    model.get_action_and_value(
                        state_tensor
                    )
                )

            action_value = action.item()

            next_state, reward, terminated, truncated, info = (
                env.step(action_value)
            )

            done = terminated or truncated

            # 保存数据
            buffer.states.append(state)

            buffer.actions.append(action_value)

            buffer.rewards.append(reward)

            buffer.dones.append(done)

            buffer.values.append(
                value.item()
            )

            buffer.log_probs.append(
                log_prob.item()
            )

            episode_reward += reward

            state = next_state

            if done:

                state, info = env.reset()

                episode_reward = 0

        # ====================================================
        # Bootstrap
        # ====================================================

        state_tensor = torch.tensor(
            state,
            dtype=torch.float32,
            device=device
        ).unsqueeze(0)

        with torch.no_grad():

            _, next_value = model.forward(
                state_tensor
            )

        next_value = next_value.item()

        # ====================================================
        # GAE
        # ====================================================

        advantages, returns = compute_gae(
            buffer.rewards,
            buffer.values,
            buffer.dones,
            next_value,
            gamma=0.99,
            lam=0.95
        )

        # ====================================================
        # NumPy → PyTorch
        # ====================================================

        states = torch.tensor(
            np.array(buffer.states),
            dtype=torch.float32,
            device=device
        )

        actions = torch.tensor(
            buffer.actions,
            dtype=torch.long,
            device=device
        )

        old_log_probs = torch.tensor(
            buffer.log_probs,
            dtype=torch.float32,
            device=device
        )

        advantages = torch.tensor(
            advantages,
            dtype=torch.float32,
            device=device
        )

        returns = torch.tensor(
            returns,
            dtype=torch.float32,
            device=device
        )

        # ====================================================
        # PPO Update
        # ====================================================

        ppo_update(
            model,
            optimizer,
            states,
            actions,
            old_log_probs,
            advantages,
            returns
        )

        if update % 10 == 0:

            print(
                f"Update {update}/{num_updates}"
            )

    # ========================================================
    # 保存 PyTorch 模型
    # ========================================================

    torch.save(
        model.state_dict(),
        "cartpole_ppo.pt"
    )

    print("PyTorch模型已保存:cartpole_ppo.pt")

    # ========================================================
    # 导出 ONNX
    # ========================================================

    export_onnx(
        model,
        state_dim,
        "cartpole_policy.onnx"
    )

    env.close()


# ============================================================
# 7. Main
# ============================================================

if __name__ == "__main__":
    train()
run.py:
import gymnasium as gym
import numpy as np
import onnxruntime as ort


def main():
    # 1. 创建 CartPole 环境
    env = gym.make("CartPole-v1", render_mode="human")

    # 2. 加载 ONNX 模型
    session = ort.InferenceSession(
        "cartpole_policy.onnx",
        providers=["CPUExecutionProvider"]
    )

    # 获取 ONNX 输入/输出名称
    input_name = session.get_inputs()[0].name
    output_name = session.get_outputs()[0].name

    print("ONNX input :", input_name)
    print("ONNX output:", output_name)

    # 3. 开始一个 episode
    state, info = env.reset()

    total_reward = 0

    while True:
        # --------------------------------
        # state 是 CartPole 的 4 维状态
        # --------------------------------
        # [cart_position,
        #  cart_velocity,
        #  pole_angle,
        #  pole_angular_velocity]
        state_input = np.asarray(
            state,
            dtype=np.float32
        ).reshape(1, 4)

        # --------------------------------
        # ONNX Actor 推理
        # --------------------------------
        outputs = session.run(
            [output_name],
            {input_name: state_input}
        )

        logits = outputs[0]

        # logits:
        # [[logit_action_0, logit_action_1]]
        #
        # 选择 logits 最大的动作
        action = int(np.argmax(logits, axis=1)[0])

        # --------------------------------
        # 执行动作
        # --------------------------------
        next_state, reward, terminated, truncated, info = env.step(action)

        total_reward += reward

        state = next_state

        # --------------------------------
        # episode 是否结束
        # --------------------------------
        if terminated or truncated:
            print("Episode reward:", total_reward)

            state, info = env.reset()
            total_reward = 0


if __name__ == "__main__":
    main()
八、.onnx文件格式详解
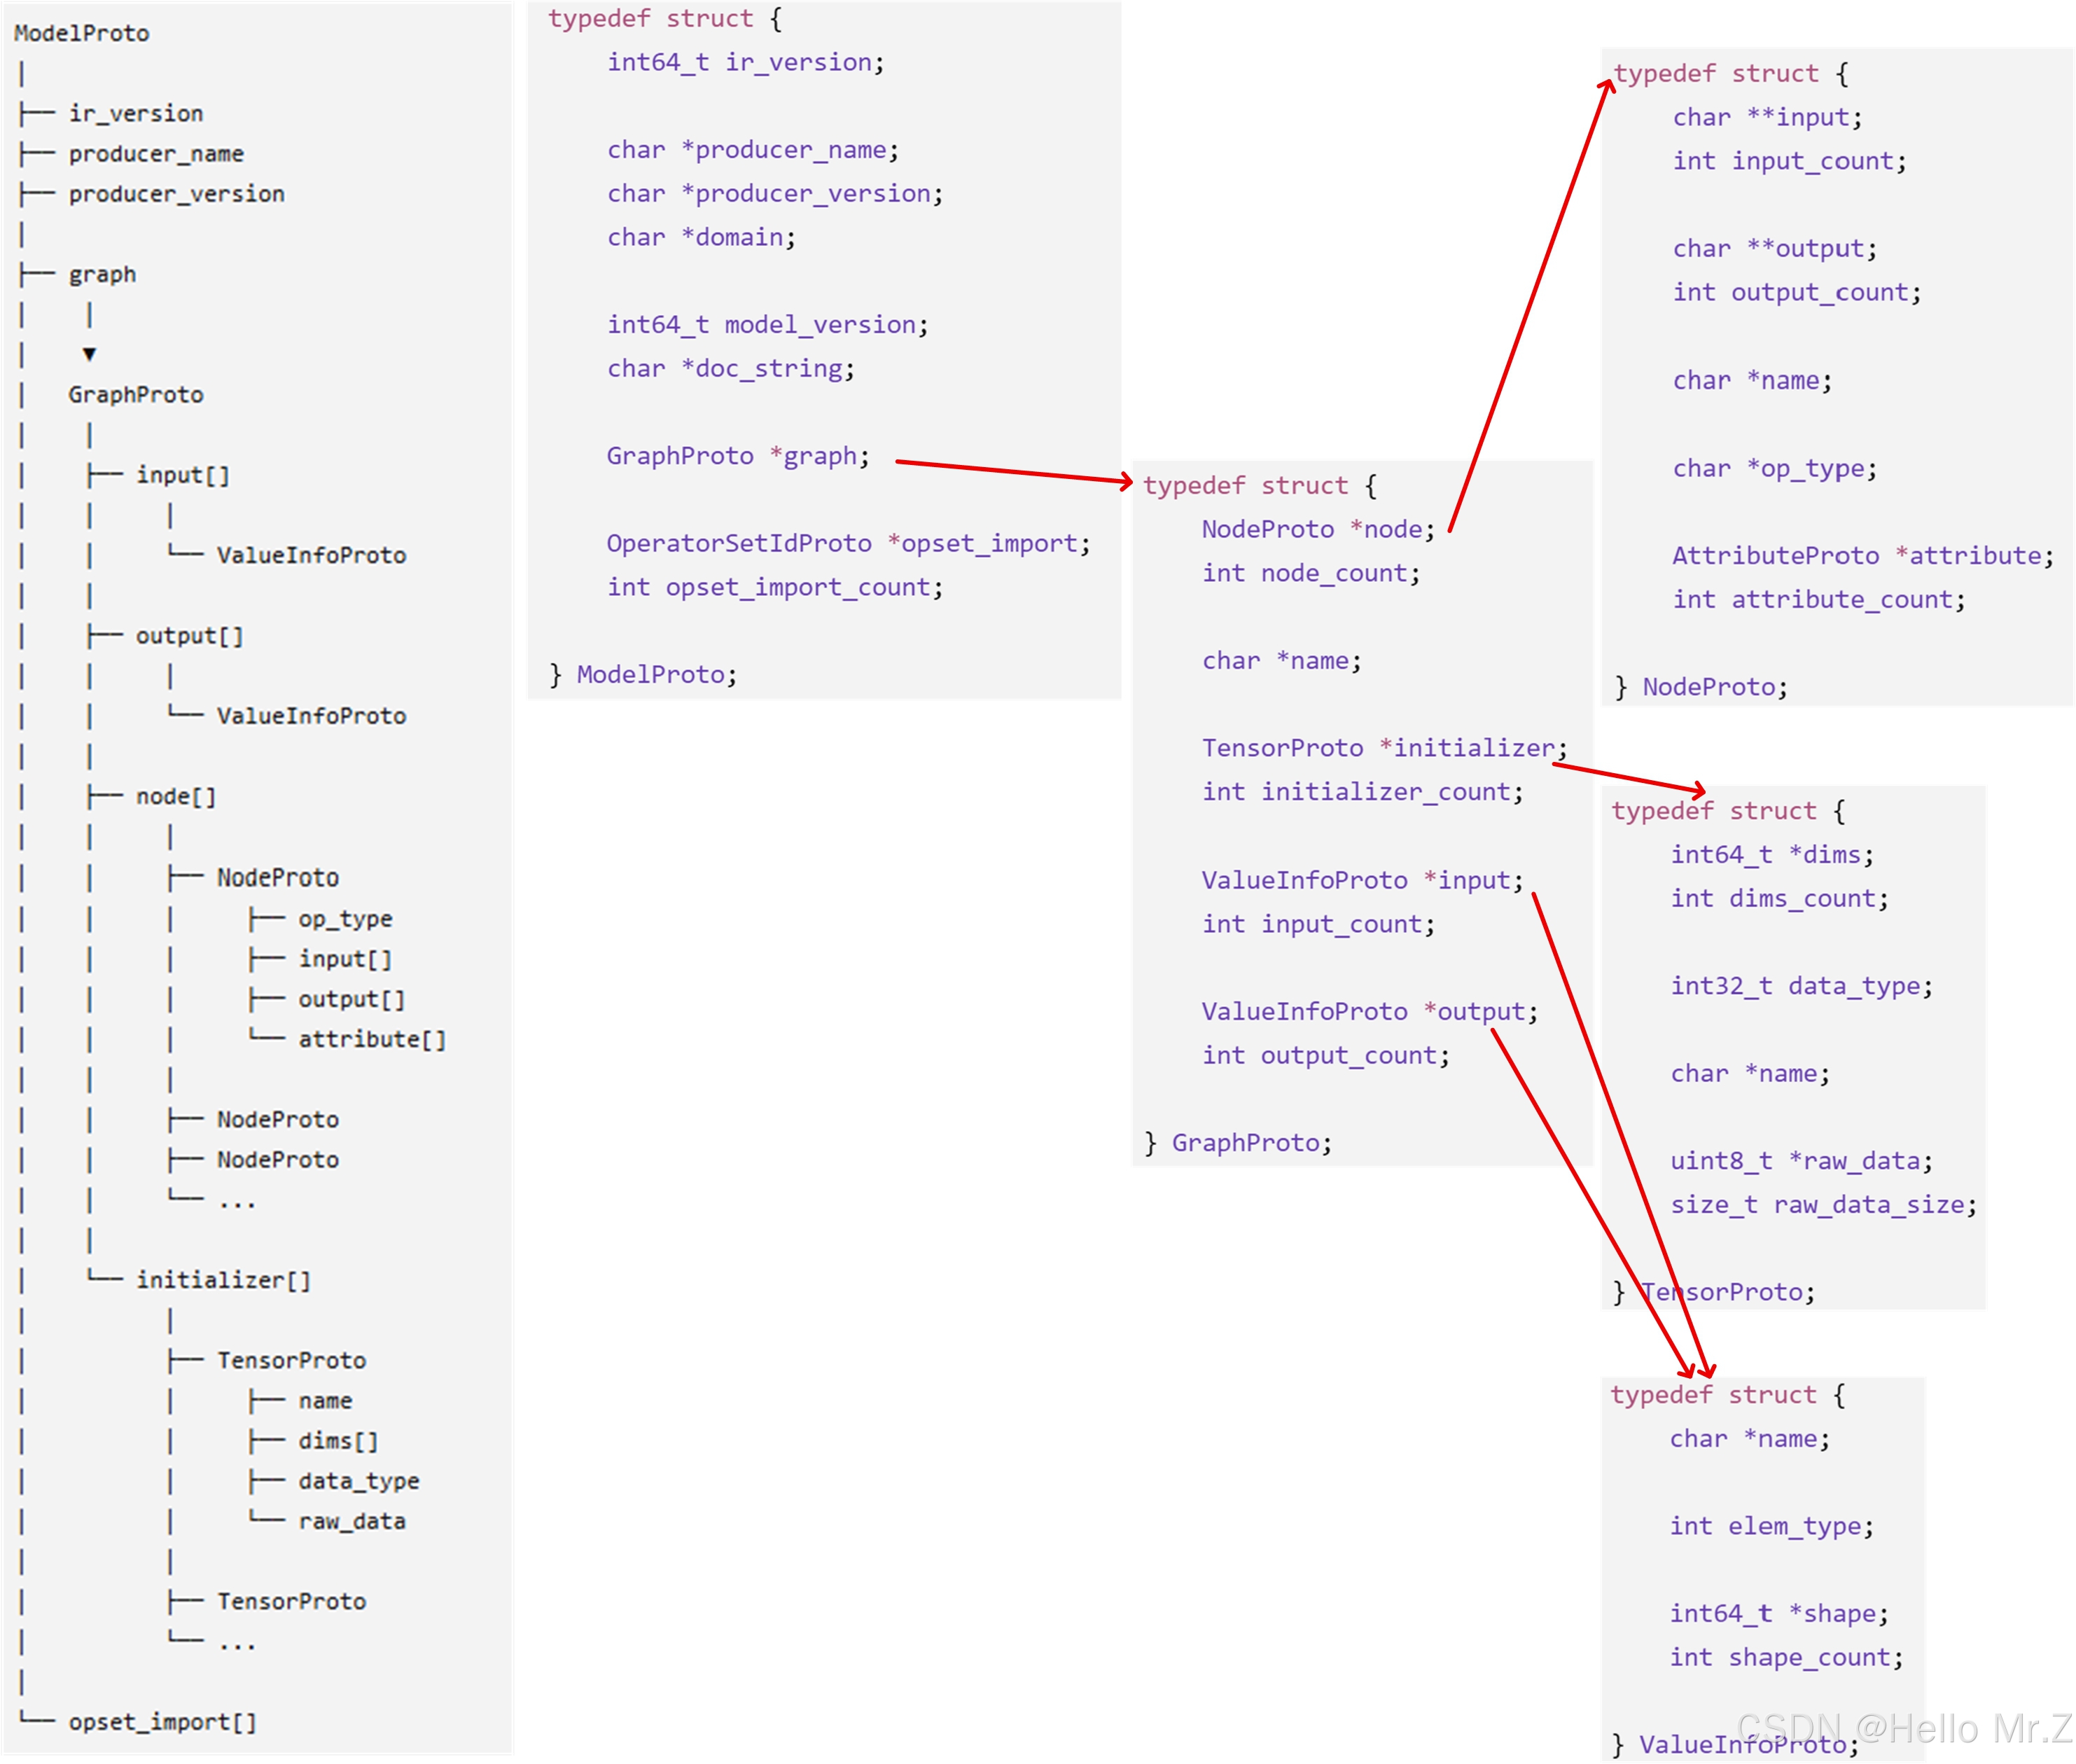
.onnx文件使用Protobuf Decoder格式存储,即直接将结构体保存为二进制文件,数据结构为onnx定义的固定格式,如下如所示:
相关连接

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)