LingBot-VLA 2.0:从视觉语言理解走向可部署的机器人动作策略
0. 简介
关于UCloud(优刻得)旗下的compshare算力共享平台
UCloud(优刻得)是中国知名的中立云计算服务商,科创板上市,中国云计算第一股。
Compshare GPU算力平台隶属于UCloud,专注于提供高性价4090算力资源,配备独立IP,支持按时、按天、按月灵活计费,支持github、huggingface访问加速。
使用下方链接注册可获得20元算力金,免费体验10小时4090云算力
https://www.compshare.cn/?ytag=GPU_lovelyyoshino_Lcsdn_csdn_display
最近受到优刻得的使用邀请,正好解决了我在大模型和自动驾驶行业对GPU的使用需求。UCloud云计算旗下的Compshare的GPU算力云平台。他们提供高性价比的5090 GPU,按时收费每卡2.5元,并附带50G的免费磁盘空间。暂时已经满足我的使用需求了,同时支持访问加速,独立IP等功能,能够更快的完成项目搭建。
LingBot-VLA 2.0 面向多机器人形态下的视觉语言动作生成,处理的是实验室 VLA 在数据质量、全身动作空间和未来变化判断上的落地缺口。项目整理约 6 万小时预训练数据,以 55 维统一向量容纳机械臂、末端、夹爪、灵巧手、腰、头和移动底盘,并用稀疏 MoE 动作专家与深度、视频双查询蒸馏连接当前几何和未来动态。论文在 GM-100、RoboTwin 2.0 与长程移动操作上给出结果,仓库则提供 6B 权重、后训练代码和 WebSocket 策略服务。下面结合论文、源码和单卡服务器部署,拆解它怎样从 checkpoint 变成可在浏览器操作的推理服务。
LingBot-VLA 2.0 是面向真实机器人操作的视觉语言动作基础模型。它使用约 6 万小时机器人与第一视角视频完成预训练,把不同机器人映射到统一 55 维状态和动作空间,再通过稀疏 MoE 动作专家分配控制能力。模型还利用 LingBot-Depth 和 DINO-Video 蒸馏当前几何与未来动态,可在浏览器上传三路相机画面、填写状态和任务指令,返回动作向量供仿真或受控机器人系统继续消费。目前相关内容已经在官网中可以直接安装使用了LingBot-VLA自动生成项目中了。
1. 为什么 VLA 需要从模型指标走向应用约束
1.1 跨任务泛化还不等于跨机器人可用
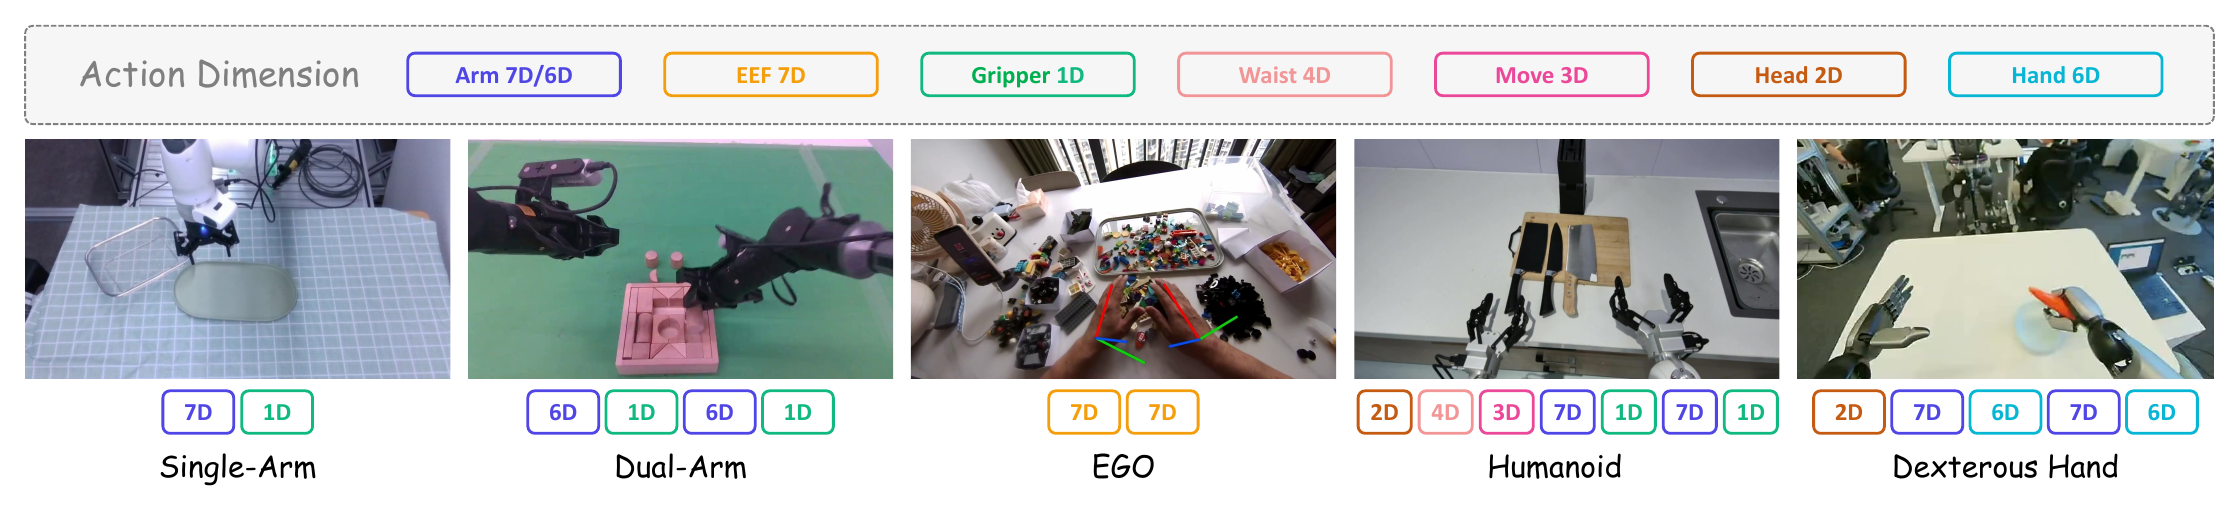
常见 VLA 评测会强调任务数量或成功率,但真实平台的差异并不只在场景图片:单臂和双臂的关节数量不同,夹爪和灵巧手的控制维度不同,移动机器人还要处理底盘、腰部和头部自由度。LingBot-VLA 2.0 收集 20 种机器人配置,原始机器人数据约 9 万小时,经过视频状态对齐、模糊遮挡、多视角错位、速度加速度和 jerk 异常过滤后保留约 5 万小时高质量轨迹。核心问题在于,数据量必须和动作语义、时间对齐、机器人结构同时扩展,否则规模只会放大噪声。
1.2 它补的是数据、动作和时间三处缺口
进一步看,论文把实践缺口归纳为三条相互制约的链路。第一条是跨任务、跨形态数据能否进入同一训练接口;第二条是模型输出能否覆盖双臂以外的全身动作;第三条是策略能否理解动作完成后的场景变化,而不只对当前图像做反应。LingBot-VLA 2.0 的贡献不是单点加模块,而是把数据清洗、统一动作表示、稀疏专家和未来表征放进同一个训练闭环。 这也是为什么部署时仅下载基础预训练权重还不够,浏览器演示需要选用带 RoboTwin 后训练结果和归一化统计的 checkpoint。
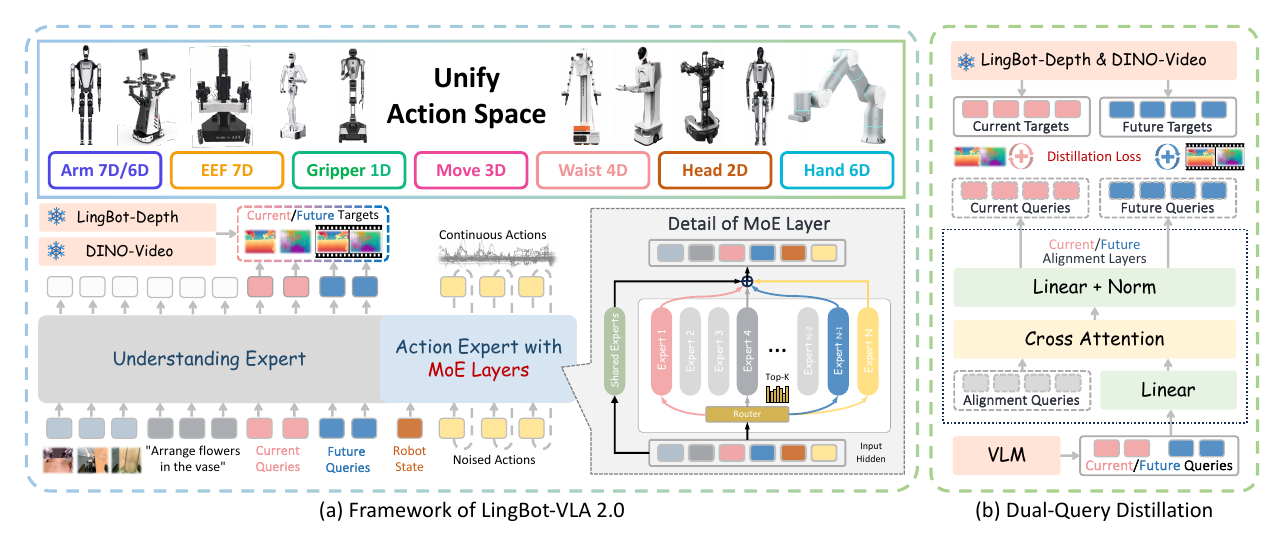
2. 整体框架:视觉语言前缀与动作专家共同生成轨迹
2.1 输入输出接口不是一张图配一句话
RoboTwin 后训练模型在一次推理中接收顶部、左腕、右腕三路 RGB 图像,接收 14 维原始机器人状态和自然语言任务,再经过 robot config 映射到统一状态空间。Qwen3-VL 4B 负责理解视觉和语言前缀,动作专家接收状态与噪声动作,通过 10 步 flow matching 去噪得到动作 chunk。对浏览器而言,最小请求可以写成 m a t h c a l O t = { I t top , I t left , I t right , s t , l } mathcal{O}_t=\{I_t^{\text{top}},I_t^{\text{left}},I_t^{\text{right}},s_t,l\} mathcalOt={Ittop,Itleft,Itright,st,l},输出则是后训练机器人配置下的动作序列,而不是自然语言答案。
A ^ t : t + H = π θ ( I t top , I t left , I t right , s t , l ) , A ^ t : t + H ∈ R H × 55 \hat{A}_{t:t+H}= \pi_{\theta}\!\left( I_t^{\text{top}},I_t^{\text{left}},I_t^{\text{right}},s_t,l \right), \qquad \hat{A}_{t:t+H}\in\mathbb{R}^{H\times 55} A^t:t+H=πθ(Ittop,Itleft,Itright,st,l),A^t:t+H∈RH×55
其中
H
H
H 是动作 chunk 长度,统一动作空间上限是 55 维;对于 RoboTwin,真实存在的双臂和夹爪维度由 mask 保留,腰、头、底盘和灵巧手等缺失部分被填充并屏蔽。换句话说,55 维是跨形态容器,不是要求每台机器人都执行 55 个控制量。Web 端最终展示 action 和 _normalized_actions,前者已经按归一化统计还原,后者用于排查模型内部输出是否异常。
2.2 训练时看未来,推理时只读当前
训练阶段可以从完整轨迹中取得当前帧和未来帧,让当前查询学习几何、未来查询学习动作时域末端的场景;部署阶段不能读取尚未发生的画面,只保留查询参数和从教师模型蒸馏得到的表示能力。这里的关键是,未来图像属于监督目标而不是在线输入,因而推理并没有偷看答案。动作生成仍以当前三路图像、当前状态和指令为条件,未来查询只是被训练成一种“接下来会怎样”的内部表征。
直觉理解:训练像教练拿着完整录像复盘,能指出驾驶员在转弯前应该观察什么;上路推理时驾驶员只有当前视野,却已经学会把路口几何、车辆运动和下一步动作联系起来。双查询保留的是这种观察习惯,不是把未来录像偷偷塞进在线请求,因此浏览器只上传当前三路画面也符合模型的因果部署边界。
3. 第一条核心机制:55 维统一动作表示
3.1 不同机器人先对齐身体部件语义
论文把状态和动作都组织成 55 维规范向量:机械臂关节 14 维、末端位姿 14 维、夹爪 2 维、灵巧手 12 维、腰部 4 维、头部 2 维、移动信号 3 维,并预留 4 维。单臂、双臂、人形和移动操作平台只填自己拥有的部分,其余位置补零并配合 joint mask。直观理解是,模型共享的是“哪个身体部件正在做什么”的槽位语义,而不是强迫所有机器人共享同一套电机编号。统一空间让跨形态数据可以共训,mask 则阻止不存在的自由度进入损失。
3.2 代码如何完成填充与有效维度屏蔽
下面代码来自 lingbotvla/data/vla_data/utils.py。它按配置中的 joint 顺序拼接状态和动作,对不足最大维度的身体部件做右侧填充,同时构造 state、action 和 chunk 三类 mask。这里的实现细节比“补零”更重要,因为补零值本身也可能是合法关节位置,只有 mask 才能告诉模型和损失函数哪些维度真正存在。
# lingbotvla/data/vla_data/utils.py
for k in self.feature_config.joints:
    state_key = f'observation.state.{k}'
    if state_key in self.states:
        pad_len = self.feature_config.joints_max_dim[k] - item[state_key].shape[-1]
        states.append(F.pad(item[state_key], (0, pad_len)))
        state_joints_pad.append(F.pad(torch.ones(item[state_key].shape), (0, pad_len)))
    else:
        states.append(torch.zeros(self.feature_config.joints_max_dim[k]))
        state_joints_pad.append(torch.zeros(self.feature_config.joints_max_dim[k]))

state_joint_mask = torch.cat(state_joints_pad, dim=-1).to(dtype=torch.bool)
state = torch.cat(states, dim=-1).to(torch.float32)
这段代码把机器人 YAML 从静态描述变成了模型真正消费的张量结构。部署新机器人时,不能只在网页里把状态输入框改成新的维度,还要同时提供 configs/robot_configs/<robot>.yaml、对应归一化统计和执行侧动作映射。当前 Web 页固定使用 RoboTwin 的 14 维原始状态,是为了让输入与官方后训练权重一致;真实设备若关节顺序、相机名或动作单位不同,必须先建立新的配置和后训练 checkpoint。
4. 第二条核心机制:Token 级稀疏 MoE 动作专家
4.1 共享专家和路由专家各自承担什么
跨形态动作数据同时包含可共享规律和平台特有规律,例如接近物体、闭合夹爪具有共性,但关节极限、底盘运动和末端控制又依赖具体机构。LingBot-VLA 2.0 在动作专家的 36 个 Transformer block 中用稀疏 MoE FFN 替换普通 FFN,默认配置包含 32 个路由专家,每个 token 激活 top-4,并保留一个共享专家。论文用相同激活参数预算比较 Dense 0.6B 与 MoE 1.6B-A-0.6B,MoE 在训练损失和 GM-100 验证动作误差上持续更低,说明收益来自容量分配而不只是总参数变大。
4.2 源码怎样把普通 FFN 替换成 MoE
下面代码来自 modeling_lingbot_vla_v2.py。配置先声明专家数、每个 token 的激活数量、路由与共享专家宽度,再逐层替换 action expert 的 MLP。moe_implementation 可以选择 eager 或 fused,本次 4090 部署沿用 checkpoint 的 fused 配置,避免改变参数布局;首启则关闭 torch.compile,把兼容性验证和编译优化拆成两个阶段。只有基础模型、权重键和单次推理都稳定后,才适合继续比较编译启动成本与稳态延迟。
# lingbotvla/models/vla/lingbot_vla/modeling_lingbot_vla_v2.py
token_config = CONFIG_MAPPING["qwen2_moe"](
    num_experts=getattr(self.config, "token_num_experts", 32),
    num_experts_per_tok=getattr(self.config, "token_top_k", 1),
    norm_topk_prob=True,
    hidden_size=hidden_size,
    moe_intermediate_size=getattr(self.config, "token_moe_intermediate_size", 256),
    shared_expert_intermediate_size=getattr(self.config, "token_shared_intermediate_size", 256),
    output_router_logits=False,
)
for idx in token_moe_layers:
    self.qwen_expert.model.layers[idx].mlp = Qwen2TokenMoeBlock(token_config)
工程上真正影响资源预算的是“总参数”和“激活参数”必须分开看。官方 RoboTwin checkpoint 的 safetensors 约 25.5 GB FP32,加载后转换为 BF16,GPU 常驻权重约为 12.6 GB 量级;但程序加载时会先在 CPU 合并多个分片,因此内存峰值明显高于 GPU 常驻值。当前服务器的 94 GiB RAM 可以覆盖这段加载过程,只有 32 GiB RAM 的节点则可能在模型进入 GPU 之前就被系统杀掉。
难点提示:稀疏 MoE 像一家有 32 个专业工位的维修中心,每个任务只叫 4 个工位处理,同时有一个公共工位保留通用能力。店面面积对应总参数,真正同时开机的工位对应激活参数;显存仍要保存整套权重,但单次计算不会把所有路由专家都跑一遍,这就是容量和计算量不再线性绑定的原因。
5. 无辅助损失路由:让负载均衡不干扰动作目标
5.1 Sigmoid 与 correction bias 的分工
传统 softmax 会让专家分数强竞争,一个专家得分提高会压低其他专家;LingBot-VLA 2.0 使用 sigmoid 计算独立亲和度,并在选择 top-k 时加 correction bias。实际混合权重仍取未加偏置的原始亲和度,偏置只负责把 token 引向负载较低的专家。设第 l l l 层第 j j j 个专家的亲和度为 s l , j s_{l,j} sl,j、校正偏置为 b l , j b_{l,j} bl,j,选择集合与归一化权重可以写成:
R ( u l , t ) = TopK j ( s l , j ( u l , t ) + b l , j , K ) , g l , j = s l , j ∑ k ∈ R s l , k \mathcal{R}(u_{l,t})=\operatorname{TopK}_{j}\left(s_{l,j}(u_{l,t})+b_{l,j},K\right), \quad g_{l,j}=\frac{s_{l,j}}{\sum_{k\in\mathcal{R}}s_{l,k}} R(ul,t)=TopKj(sl,j(ul,t)+bl,j,K),gl,j=∑k∈Rsl,ksl,j
这里的关键是, b l , j b_{l,j} bl,j 不进入最终混合权重,只改变入选名单;训练时再根据专家 token 数相对平均负载的偏差更新偏置。论文把这种方法称为 auxiliary-loss-free balancing,因为它没有把额外均衡损失叠加到动作学习目标上。路由调整负责分流,原始亲和度负责表决,两者解耦后更不容易为了统计均衡牺牲控制表示。
5.2 路由代码中的 FP32 边界
下面代码来自 qwen2_action_expert.py。路由线性层明确关闭 autocast 并转成 FP32,避免 BF16 在接近分数上翻转 top-k;选择时叠加 correction bias,取权重时又回到未经偏置的 routing score。这个细节对部署也有意义:虽然主体使用 BF16 节省显存,路由决策仍保留 FP32 精度,不能为了再省少量计算随意删掉转换。
# lingbotvla/models/vla/lingbot_vla/qwen2_action_expert.py
with torch.amp.autocast(hidden_flat.device.type, enabled=False):
    router_logits = F.linear(hidden_flat.float(), self.gate.weight.float())

if self._router_activation == 'sigmoid':
    routing_scores = router_logits.sigmoid()
else:
    routing_scores = F.softmax(router_logits, dim=1, dtype=torch.float)

scores_for_choice = routing_scores + self.e_score_correction_bias.unsqueeze(0)
_, selected_experts = torch.topk(scores_for_choice, self.top_k, dim=-1)
routing_weights = routing_scores.gather(1, selected_experts)
这段实现也解释了为什么 Web 服务默认只开一个模型进程。多进程并发会为每个进程复制整套 Qwen3-VL、动作专家和路由缓存,即使单次激活参数不大,GPU 常驻权重与 CPU 加载内存仍会成倍增长。当前单卡 48 GiB 理论上能容纳两个 BF16 模型副本,但 94 GiB RAM 在双进程同时合并 FP32 分片时接近风险区,所以更稳妥的做法是单模型常驻、请求串行化,再根据实测吞吐决定是否增加队列。
6. 双查询蒸馏:把当前几何和未来动态写进策略
6.1 LingBot-Depth 与 DINO-Video 的互补监督
深度教师回答“当前和未来的空间结构是什么”,视频教师回答“物体与机器人如何随时间变化”。模型向视觉语言前缀追加当前查询 Q t Q_t Qt 与未来查询 Q t + T Q_{t+T} Qt+T,分别预测当前、未来的 LingBot-Depth token 和 DINO-Video token。DINO-Video 从 DINOv3 初始化,加入 block-wise causal temporal attention 与 3D-RoPE,并在 500 万段互联网、第一视角和机器人视频上训练;LARYBench 中它在四项任务里的三项优于原始 DINOv3,说明时间教师确实携带了更适合机器人操作的动态信息。
L depth = E [ ∥ P d ( Q t ) − D t ∥ 1 + ∥ P d ( Q t + T ) − D t + T ∥ 1 ] \mathcal{L}_{\text{depth}}= \mathbb{E}\left[ \left\|P_d(Q_t)-D_t\right\|_1 + \left\|P_d(Q_{t+T})-D_{t+T}\right\|_1 \right] Ldepth=E[∥Pd(Qt)−Dt∥1+∥Pd(Qt+T)−Dt+T∥1]
L video = E [ ∥ P v ( Q t ) − Z t ∥ F 2 + ∥ P v ( Q t + T ) − Z t + T ∥ F 2 ] \mathcal{L}_{\text{video}}= \mathbb{E}\left[ \left\|P_v(Q_t)-Z_t\right\|_F^2 + \left\|P_v(Q_{t+T})-Z_{t+T}\right\|_F^2 \right] Lvideo=E[∥Pv(Qt)−Zt∥F2+∥Pv(Qt+T)−Zt+T∥F2]
其中 D t D_t Dt 与 D t + T D_{t+T} Dt+T 是深度表示, Z t Z_t Zt 与 Z t + T Z_{t+T} Zt+T 是因果视频表示, P d P_d Pd 和 P v P_v Pv 是带投影与交叉注意力的对齐模块。深度使用 L1,视频使用平方 Frobenius 范数,二者都只在训练阶段需要教师网络;发布的 VLA checkpoint 已经包含查询和对齐头参数,在线动作推理不需要另外常驻 LingBot-Depth 与 DINO-Video 教师,因此服务显存不会再叠加两套教师模型。
6.2 查询如何进入视觉语言前缀
下面代码来自 modeling_lingbot_vla_v2.py。它把深度查询压成固定数量的 task token,再根据配置把 language、current depth、future depth 和 video query 按规定顺序拼入前缀。多个监督共享 future query 时,还会通过投影层融合深度与视频查询,最终与图像 token、语言 token 一起进入因果 VLM。固定拼接次序同时决定 attention mask 和 position id 的语义,因此部署配置必须和训练 checkpoint 保持一致。
# lingbotvla/models/vla/lingbot_vla/modeling_lingbot_vla_v2.py
current_task = _get_align_tokens(self.depth_align_embs)
if self.use_current_video_patch and self.use_current_shared_task_proj:
    current_video_task = _get_align_tokens(self.current_video_align_embs)
    current_task = self.current_shared_task_proj(
        torch.cat([current_task, current_video_task], dim=-1)
    )
align_embs = current_task.repeat(img_emb.size(0), 1, 1)

for segment_name in prefix_query_segments(...):
    if segment_name == "language":
        _append(lang_emb, lang_masks, lang_tokens.to(device))
    elif segment_name == "current_depth":
        _append(align_embs, align_pad_masks, fake_align_ids)
    elif segment_name == "future_depth":
        _append(future_align_embs, align_pad_masks, fake_align_ids)
这段拼接不是为了让模型输出深度图给用户看,而是让动作 token 能访问经过几何和时间监督塑形的前缀表示。论文 Figure 13 展示了因果推理时的 depth 与 DINO PCA 预测,说明查询确实能重建相应感知目标;但动作质量仍是最终目的,Web 页只返回动作,不把这些中间预测包装成不存在的产品能力。若后续要展示深度或未来特征,需要增加经过验证的可视化接口。
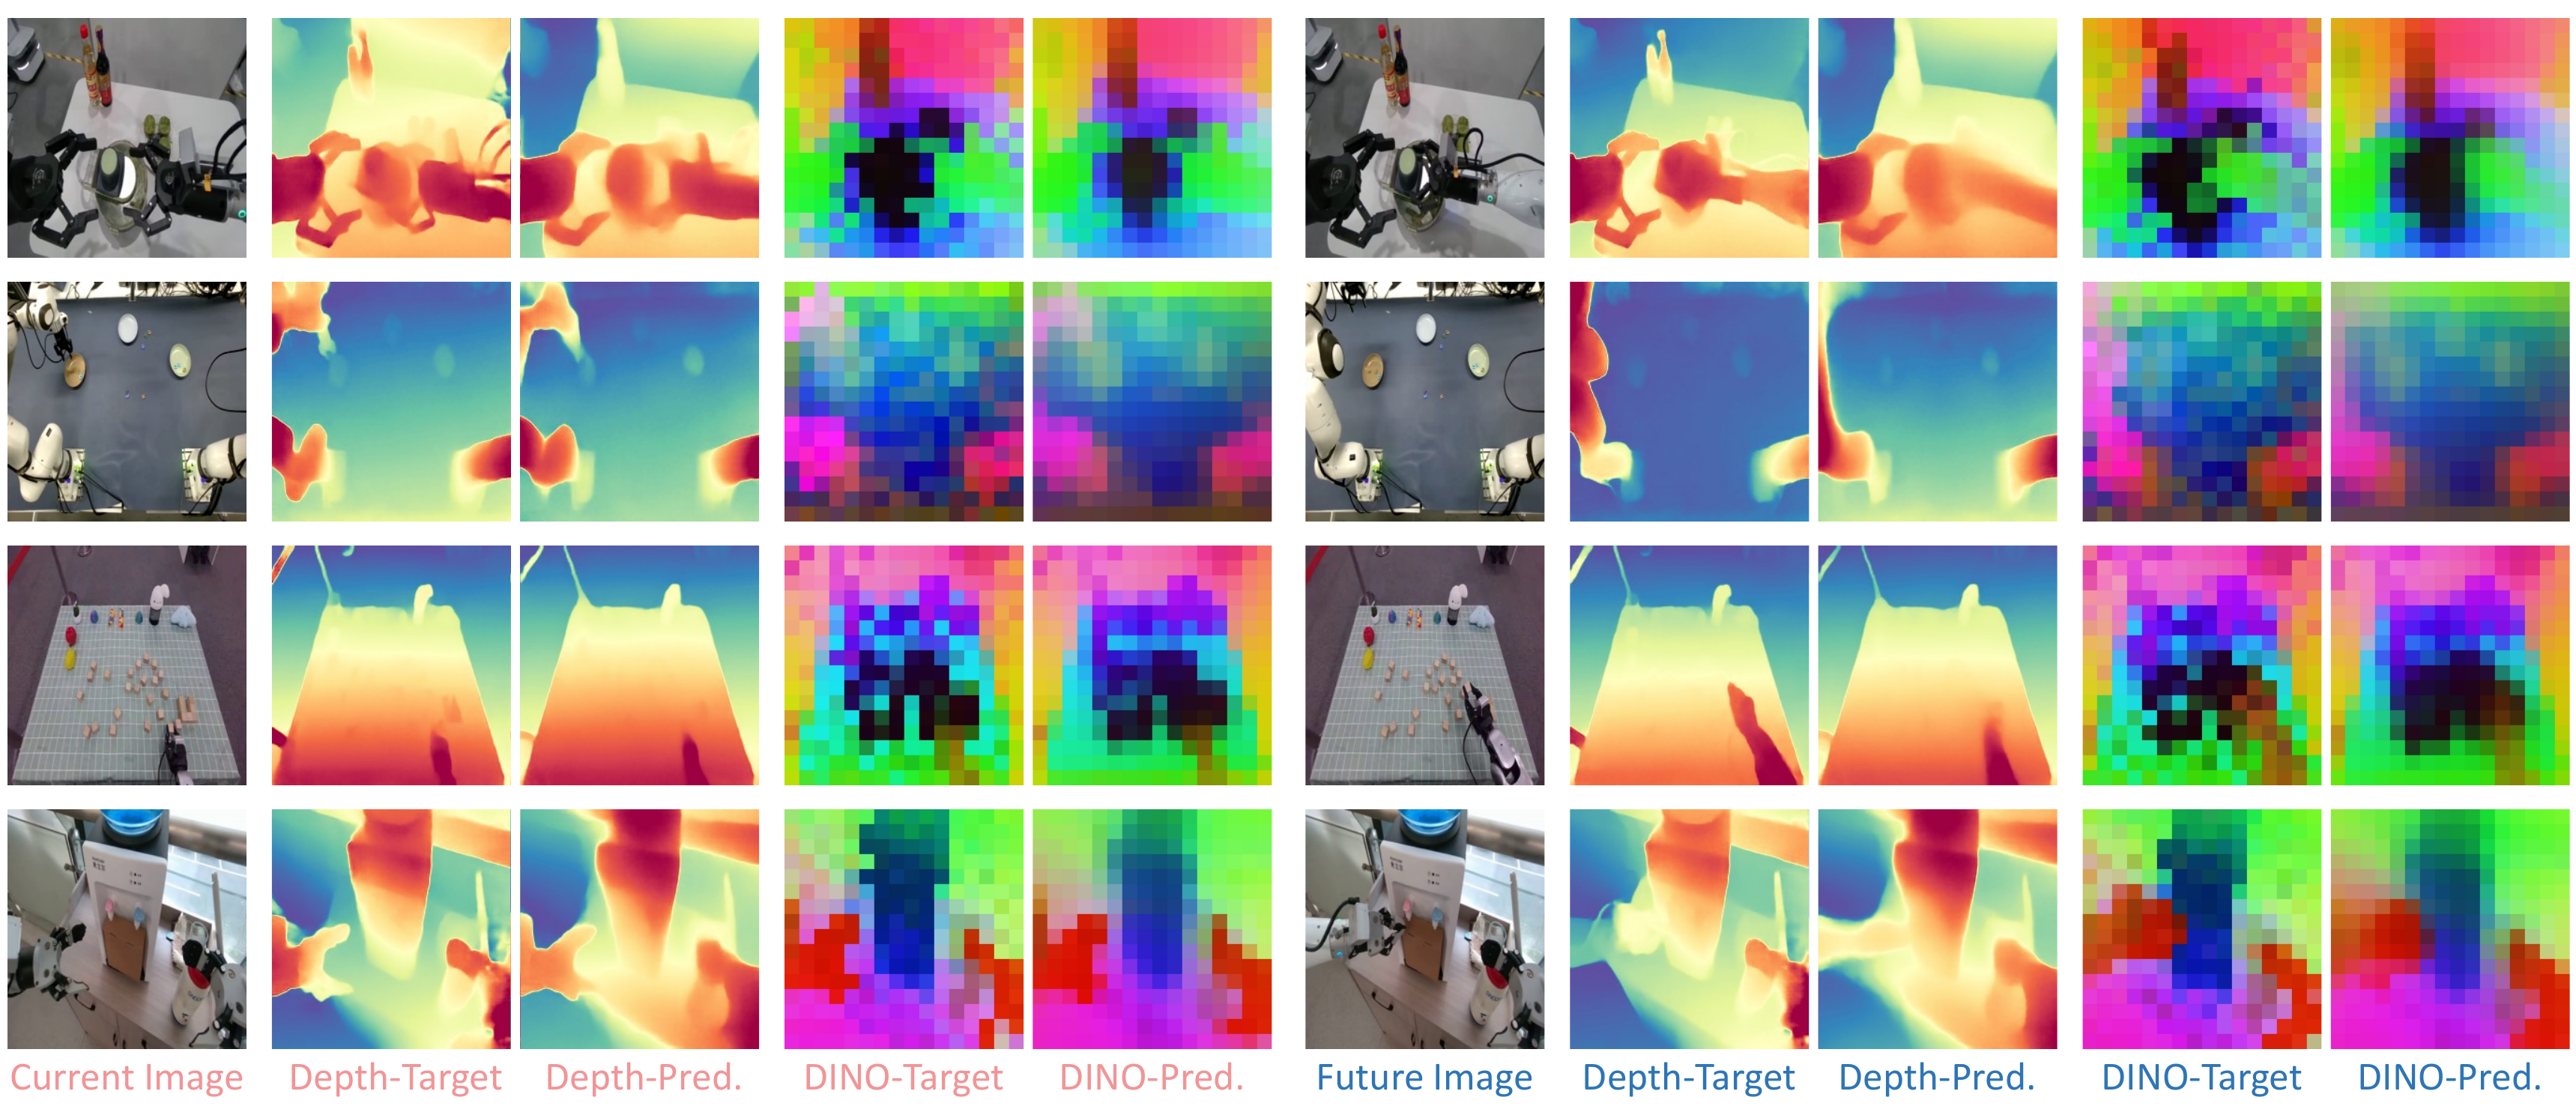
难点提示:双查询像给策略准备两张草稿纸,一张记录眼前物体的空间关系,另一张预演动作结束时可能出现的布局。教师模型只在训练时批改草稿,正式推理时不会站在旁边提示答案;模型留下的是被批改过的思考槽位,所以部署 checkpoint 不必再加载深度和视频教师,也不会把训练显存需求原样带到 Web 服务。
7. 训练目标:动作流匹配与感知蒸馏怎样装配
7.1 主损失、感知损失与路由项
动作专家从高斯噪声出发,学习在时间
τ
\tau
τ 上预测速度场,把噪声动作逐步积分回真实动作。仓库支持 fm 的 L2 与 L1_fm 两种主损失,RoboTwin 配置使用 L1 flow matching,同时叠加当前深度、未来深度、视频蒸馏和可选 MoE 路由项。一个简化的总目标可以写为下式,其中各蒸馏系数在配置中通常是较小数值,用于塑形表示而不是压过动作监督。
L = L action + λ d L depth + λ f d L future-depth + λ v L video + λ s L sequence + λ z L router-z \mathcal{L}= \mathcal{L}_{\text{action}} +\lambda_d\mathcal{L}_{\text{depth}} +\lambda_{fd}\mathcal{L}_{\text{future-depth}} +\lambda_v\mathcal{L}_{\text{video}} +\lambda_s\mathcal{L}_{\text{sequence}} +\lambda_z\mathcal{L}_{\text{router-z}} L=Laction+λdLdepth+λfdLfuture-depth+λvLvideo+λsLsequence+λzLrouter-z
其中 L action \mathcal{L}_{\text{action}} Laction 只在 action joint mask 标记的真实维度上计算, λ d \lambda_d λd、 λ f d \lambda_{fd} λfd 与 λ v \lambda_v λv 控制感知蒸馏强度,后两项用于可选的 MoE 训练稳定性。论文主方法强调无辅助损失均衡,而仓库后训练示例仍保留 sequence-wise loss 与 router z-loss 开关,说明“路由偏置均衡”和“训练监控或正则项”可以并存,部署者应按 checkpoint 原配置加载,不能仅凭方法名删除字段。
7.2 为什么动作归一化会改变最终成功率
GM-100 四任务消融给出一个很实用的工程信号:相对关节动作把平均成功率从 33.7 提高到 55.0,其原始标准差只有绝对动作的 31%–37%;MeanStd 归一化达到 55.0,而 MinMax 和未裁剪 Q01–Q99 分别约 47.5、47.4。L2 在这组相对小修正动作上从 L1 的 46.4 提高到 55.0,但挤番茄酱这种接触丰富任务又更偏好 L1。动作空间、归一化和损失函数是耦合选择,所以 Web 输入状态必须与后训练统计一致,不能把角度、弧度、米和归一化值混用。
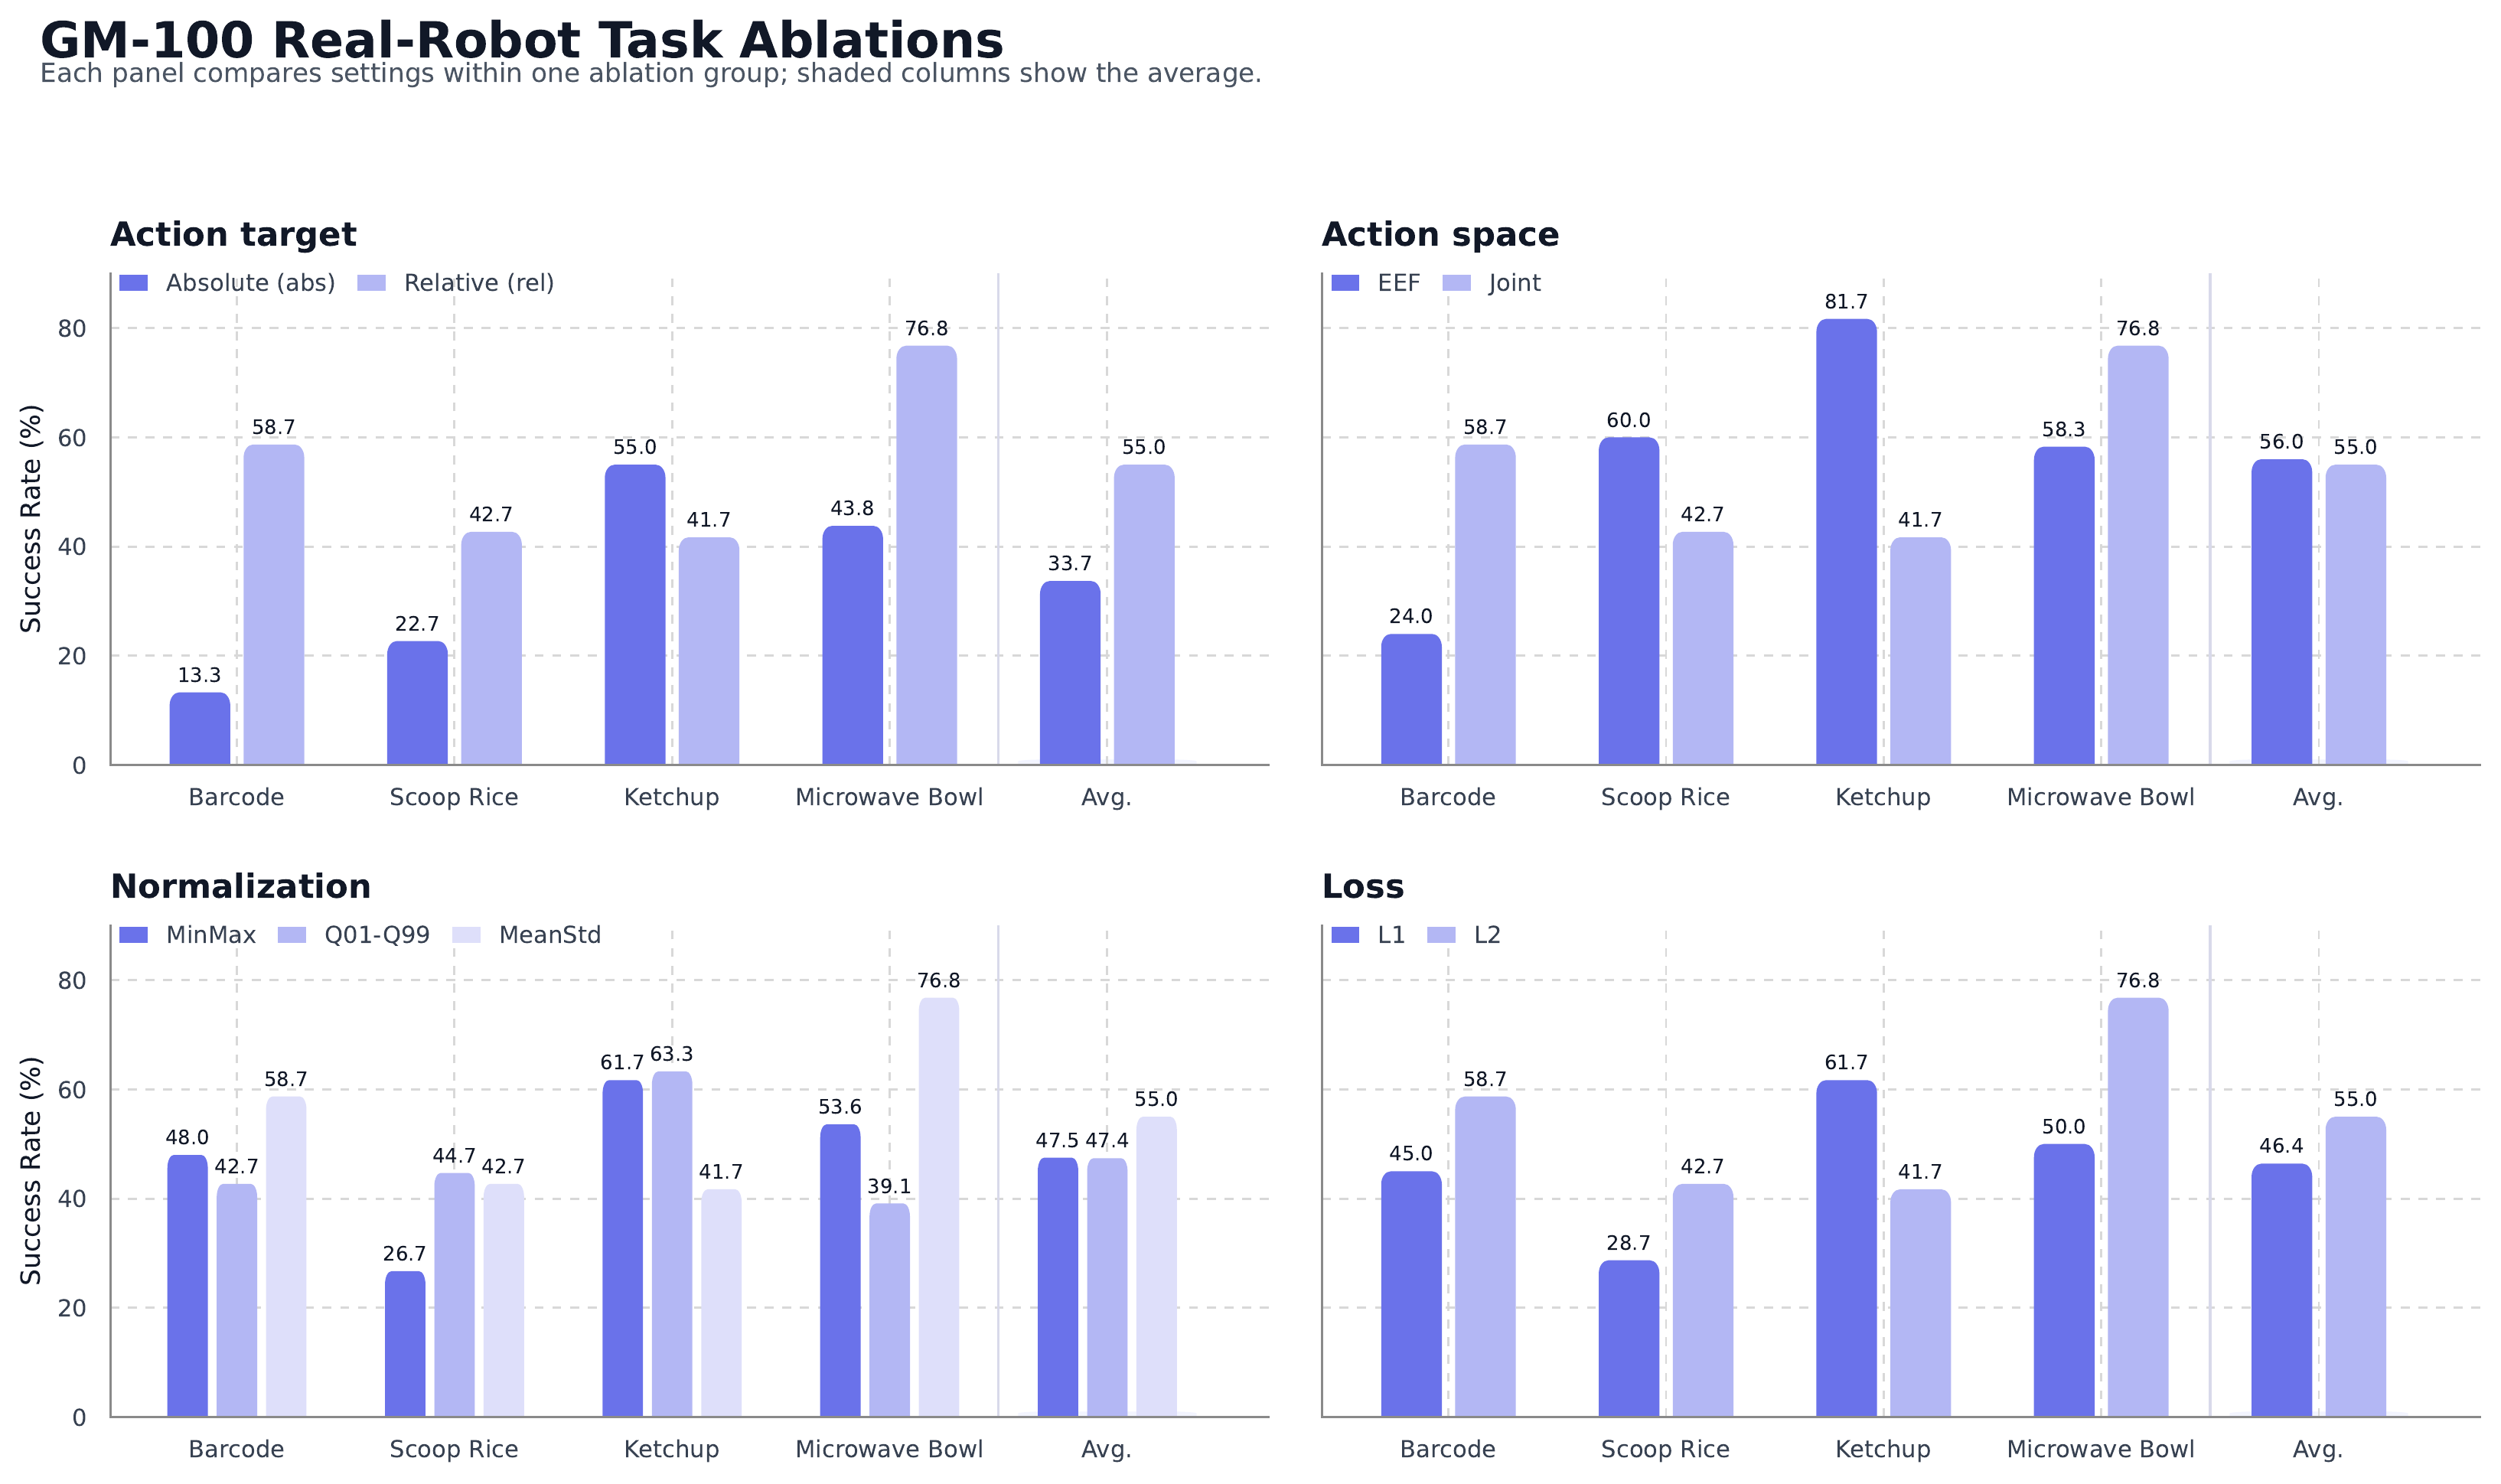
工程价值:归一化像给精密旋钮选择刻度,刻度太窄时多数动作挤在一起,模型分不清细小修正;刻度太散时又会把少数大动作放得过重。MeanStd 在这组相对动作上保留了更大的有效动态范围,但它不是所有机器人都通用的固定答案,换关节定义、动作频率或接触任务后必须重新统计并验证。
8. 推理执行:缓存视觉语言前缀,再迭代去噪动作
8.1 十步去噪与前缀 KV Cache
推理先计算三路图像、语言和查询前缀,填充一次 KV Cache,随后只让状态与噪声动作经过 10 个速度预测步。时间步长为 Δ τ = − 1 / N \Delta\tau=-1/N Δτ=−1/N,动作从 x 1 ∼ N ( 0 , I ) x_1\sim\mathcal{N}(0,I) x1∼N(0,I) 开始,按预测速度更新到 x 0 x_0 x0。由于视觉语言前缀不在每个去噪步重复编码,模型能把 6B 级视觉语言理解与连续动作生成放进单卡在线服务;官方 README 给出 RTX 4090D、10 步去噪约 130 ms 的一次策略调用参考值。
x τ + Δ τ = x τ + Δ τ v θ ( s t , x τ , τ ∣ K , V ) , Δ τ = − 1 N , N = 10 x_{\tau+\Delta\tau}= x_{\tau}+\Delta\tau\,v_{\theta}(s_t,x_{\tau},\tau\mid K,V), \qquad \Delta\tau=-\frac{1}{N},\quad N=10 xτ+Δτ=xτ+Δτvθ(st,xτ,τ∣K,V),Δτ=−N1,N=10
这里的
(
K
,
V
)
(K,V)
(K,V) 来自视觉语言前缀缓存,
v
θ
v_{\theta}
vθ 是动作速度场,
N
N
N 是去噪步数。减少
N
N
N 可以降低延迟,却会偏离 checkpoint 的训练与评测设置;开启 torch.compile 可能降低稳定运行后的 Python 与 kernel 调度开销,但首次请求需要编译并可能因驱动、Triton 或形状变化失败。本次启动配置先设 LINGBOT_USE_COMPILE=0,等基础推理跑通后再单独做编译基准。
8.2 源码中的缓存与积分循环
下面代码来自 modeling_lingbot_vla_v2.py 的 sample_actions()。前缀只 forward 一次并写入 past_key_values,之后循环调用 predict_velocity,每一步更新动作和时间。浏览器服务在模型外层增加线程锁,是因为官方策略还保存 global_step、上一个 action chunk 和 ensemble 状态,多用户请求如果交错进入同一个对象会破坏动作序列语义。
# lingbotvla/models/vla/lingbot_vla/modeling_lingbot_vla_v2.py
_, past_key_values, _ = self.qwenvl_with_expert.forward(
    attention_mask=prefix_att_2d_masks,
    inputs_embeds=[prefix_embs, None],
    use_cache=self.config.use_cache,
    fill_kv_cache=True,
)

dt = torch.tensor(-1.0 / self.config.num_steps, dtype=dtype, device=device)
x_t = noise
time = torch.tensor(1.0, dtype=dtype, device=device)
while time >= -dt / 2:
    v_t = predict_velocity_fn(state, prefix_pad_masks, past_key_values, x_t, time.expand(bsize))
    x_t += dt * v_t
    time += dt
return x_t
这段实现把优化重点指向两个位置:固定相机数量和图像处理尺度能提高缓存形状稳定性,串行复用单模型能避免重复加载权重。单纯增加 Web worker 数量不会提高单卡吞吐,反而会复制模型或引入 GPU 争用。实际线上更合适的是一个 GPU 推理进程配请求队列,前端状态接口独立响应;若未来需要多机器人低延迟控制,应把浏览器管理面和实时策略 WebSocket 分成两个服务。
9. 服务器安装、启动配置与 Web 使用
9.1 安装目录和模型下载
服务器运行 Ubuntu 22.04,已有 Python 3.12 的 py312 环境,但其中 PyTorch 2.13.0+cu132 与项目锁定的 PyTorch 2.8.0 不一致。本次没有覆盖它,而是使用 tools/create_train_env.sh 创建独立的 lingbotvla 环境,并修正了 MoGe 误解析 Gradio、OpenCV GUI 与 Git 仓库依赖的问题。由于 /model 是只读挂载,项目放在 /workspace/lingbot-vla-v2,RoboTwin 后训练权重放在 /workspace/models/lingbot-vla-v2-6b-robotwin,Qwen3-VL 4B 则直接复用只读模型盘中的现有文件。
# 服务器安装与下载
source /usr/local/miniconda3/etc/profile.d/conda.sh
cd /workspace/lingbot-vla-v2
PIP_INDEX_URL=https://pypi.org/simple \
bash tools/create_train_env.sh \
  --env-name lingbotvla \
  --flash-attn-wheel /workspace/packages/flash_attn-2.8.3+cu12torch2.8cxx11abiTRUE-cp312-cp312-linux_x86_64.whl \
  --lerobot-source /workspace/packages/lerobot-v0.4.2.tar.gz \
  --utils3d-source /workspace/packages/utils3d-3fab839f.tar.gz

conda activate lingbotvla
python scripts/download_hf_model.py \
  --repo_id robbyant/lingbot-vla-v2-6b-robotwin \
  --local_dir /workspace/models

实际下载采用单线程断点续传并限制到 lingbotvla_cli.yaml 与 checkpoints/global_step_50000/hf_ckpt/,用于降低大文件并发连接时的 TLS 中断概率。模型目录必须保留仓库层级,因为官方策略通过 hf_ckpt 向上三级查找 lingbotvla_cli.yaml;若把六个权重分片单独复制到任意目录,加载器会找不到训练配置。服务器访问 GitHub 较慢,因此 FlashAttention 2.8.3、LeRobot 0.4.2 和指定提交的 utils3d 先在本机下载、校验 SHA-256 后中转到 /workspace/packages,环境脚本新增本地源参数以支持重复安装。归一化统计显式指向项目中的 assets/norm_stats/robotwin.json,完成后执行 python -m pip cache purge 回收了约 9.3 GB 临时缓存。
9.2 浏览器操作与 API 边界
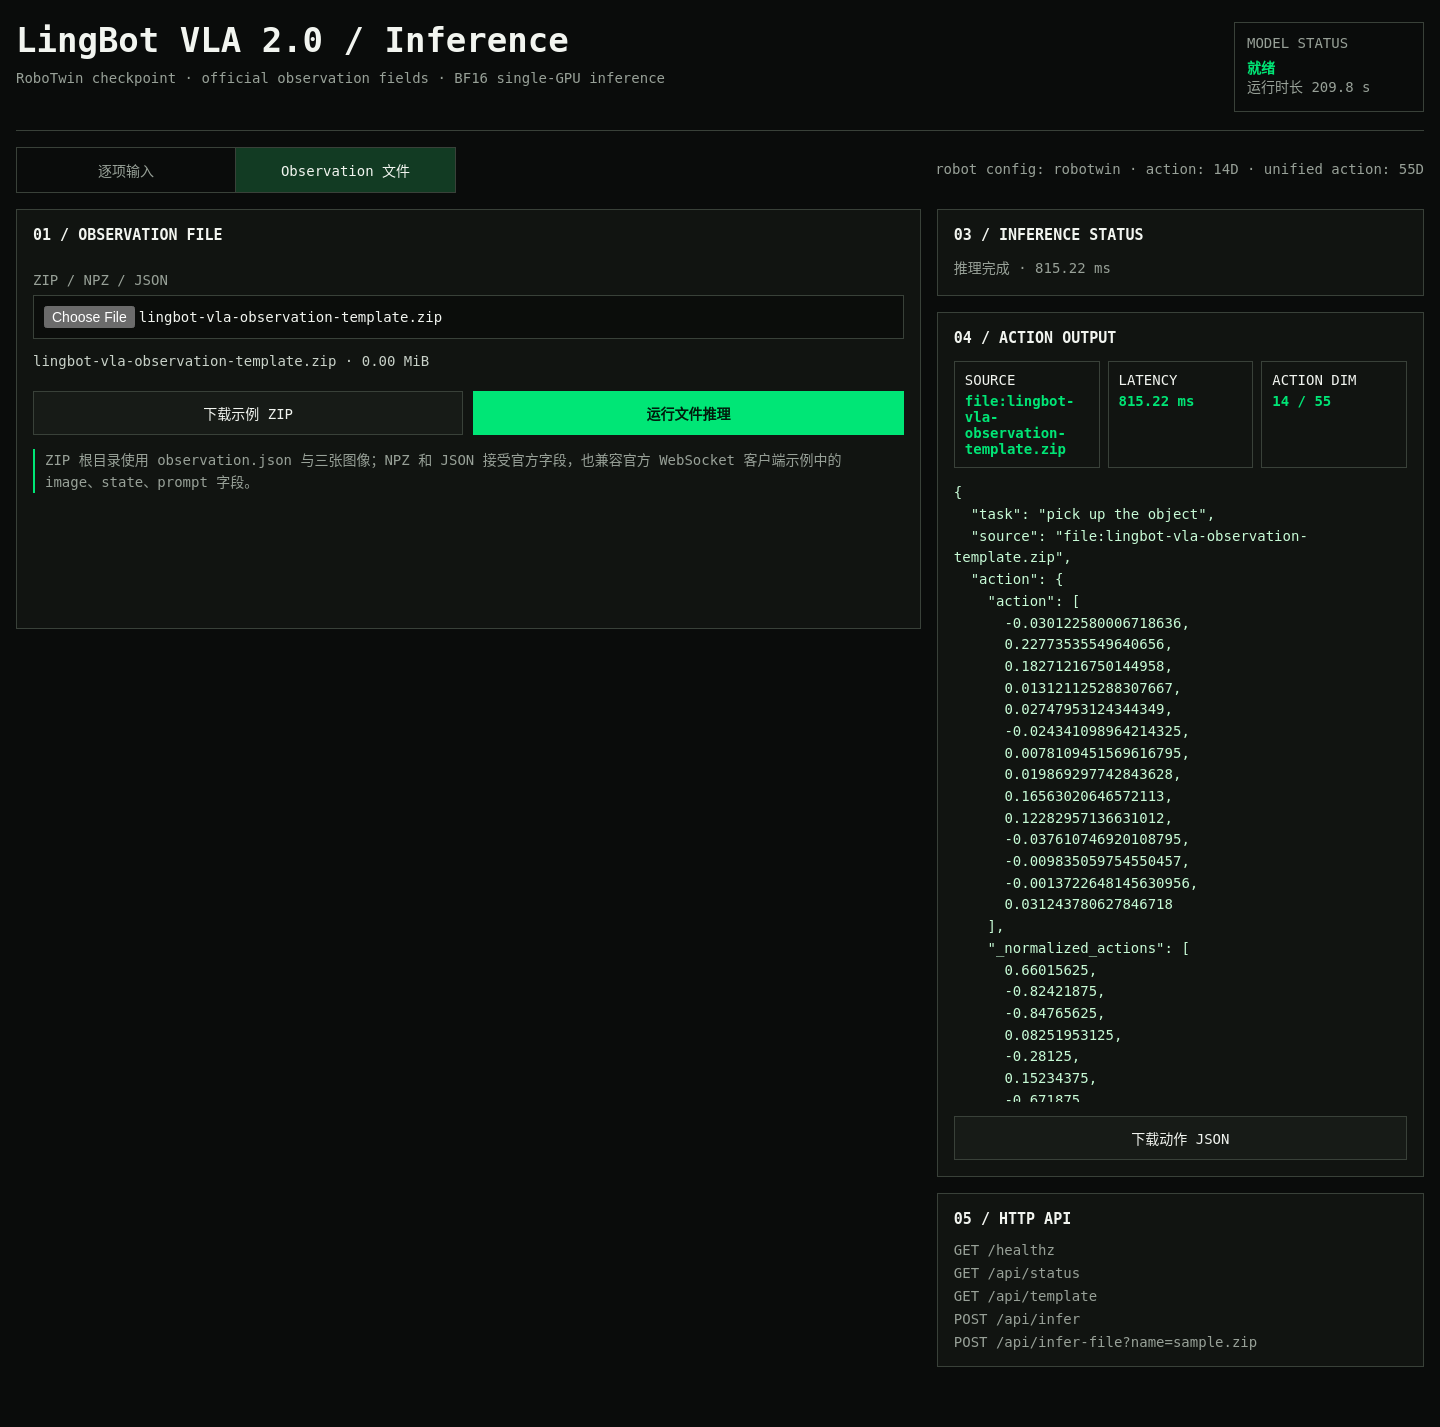
浏览器访问 http://117.50.193.149:18080/ 后,可以在“逐项输入”和“Observation 文件”之间切换。逐项输入仍然上传顶部、左腕和右腕三张 RGB 图,并填写任务文本与 14 维状态;文件模式支持 .zip、.npz 和 .json,其中 ZIP 根目录包含 observation.json 与三张图像,NPZ 与 JSON 使用官方 observation.images.*、observation.state 和 task 字段,同时兼容官方 WebSocket 客户端示例的 image、state、prompt 命名。页面提供可直接下载并重新上传的示例 ZIP,也允许把推理结果下载为动作 JSON。
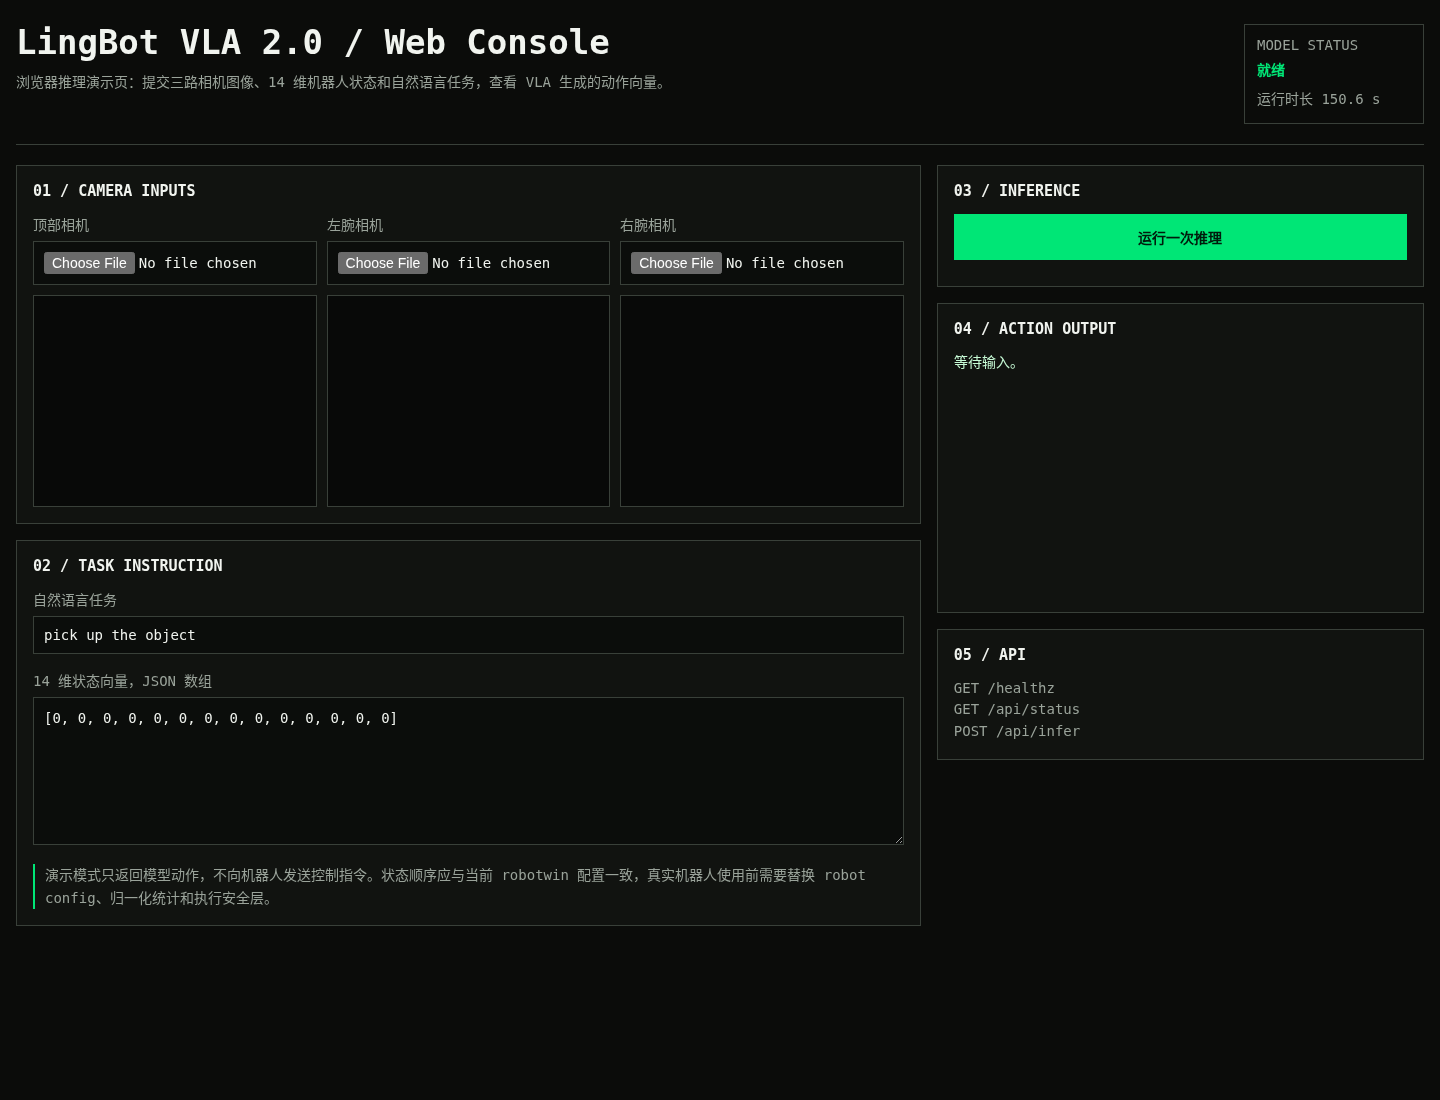
文件模式不是只做了一个上传控件。服务器对 ZIP 文件数量、解压总量、内部路径和图像像素数设置了上限,NPZ 使用 allow_pickle=False,不会加载可执行 Python 对象;解析完成后,所有输入都会统一为官方 RoboTwin observation,再进入同一个串行策略锁。使用 Chrome CDP 真实执行“选择 ZIP—点击文件推理—渲染动作结果”流程时,页面耗时约 815 毫秒,返回 14 维动作和 55 维归一化动作,浏览器控制台错误与网络失败均为零,桌面和 390 像素移动端没有出现内容重叠。
下面代码来自更新后的 deploy/web_app.py,它依次查找官方原始字段、浏览器简写和 WebSocket 客户端示例字段,最终统一为策略真正接收的 canonical key。这里的关键是格式兼容发生在模型调用之前,文件来源不会改变机器人配置、归一化统计或动作输出结构;状态不是 14 维、任务为空、缺少图像、出现 NaN 或 ZIP 路径越界时,请求都会在进入 GPU 前失败。
# deploy/web_app.py
for short_name, canonical_key in CANONICAL_IMAGE_KEYS.items():
    value = payload.get(canonical_key)
    if value is None:
        value = browser_images.get(short_name)
    if value is None:
        value = client_images.get(CLIENT_IMAGE_KEYS[short_name])
    if value is None:
        raise ValueError(f"缺少官方图像字段 {canonical_key}")
    label = canonical_key
    if isinstance(value, str):
        if value.startswith("data:image/"):
            image = _decode_image_data_url(value, label)
        elif file_loader is not None:
            image = file_loader(value, label)
        else:
            raise ValueError(f"{label} 必须是 image data URL")
    else:
        image = _normalize_image_array(value, label)
    observation[canonical_key] = image

with self._lock:
    result = policy.infer(observation, return_normalized=True)
9.3 数据导入与文件推理测试
完成 LingBot-VLA 推理最稳妥的方式是导入 ZIP observation。压缩包根目录固定放置 observation.json、顶部相机图、左腕相机图和右腕相机图,JSON 中的三项图像字段填写压缩包内的相对文件名。observation.state 必须是 14 个有限数字,顺序和单位必须与 RoboTwin 后训练数据一致;task 是不超过 256 个字符的非空任务指令。三张图会统一转换为 RGB uint8,但相机语义不能互换,否则模型接收到的视角位置与训练阶段不一致。
sample.zip
├── observation.json
├── cam_high.png
├── cam_left_wrist.png
└── cam_right_wrist.png
{
  "task": "pick up the object",
  "observation.state": [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0],
  "observation.images.cam_high": "cam_high.png",
  "observation.images.cam_left_wrist": "cam_left_wrist.png",
  "observation.images.cam_right_wrist": "cam_right_wrist.png"
}
浏览器操作时访问 http://117.50.193.149:18080/,切换到“Observation 文件”,先下载页面提供的示例 ZIP,再用真实相机帧和真实 14 维机器人状态替换示例内容,最后选择文件并点击“运行文件推理”。成功结果会显示 14 维当前动作、55 维归一化动作、图像形状和推理耗时。这里的关键是示例中的全零状态和彩色占位图只用于验证数据管线,不能用于控制真实机器人;换句话说,真实执行前仍要检查动作单位、关节顺序、限位、急停和碰撞约束。
# 下载页面生成的标准示例 ZIP
curl -fL http://117.50.193.149:18080/api/template \
  -o /tmp/lingbot-vla-observation-template.zip
/usr/local/miniconda3/bin/python -m zipfile -l \
  /tmp/lingbot-vla-observation-template.zip

# 将 ZIP 原始字节提交给文件推理接口
curl -fsS -X POST \
  --data-binary @/tmp/lingbot-vla-observation-template.zip \
  'http://117.50.193.149:18080/api/infer-file?name=sample.zip' \
  | /usr/local/miniconda3/bin/python -m json.tool
9.4 NPZ 与 JSON 数据格式
进一步看,若数据采集程序已经输出 NumPy 数组,也可以生成 .npz 文件:三路图像接受 HWC、CHW 或带单样本批维的数组,浮点图像在
[
0
,
1
]
[0,1]
[0,1] 区间时会自动缩放到
[
0
,
255
]
[0,255]
[0,255],状态仍必须展开为 14 维。纯 .json 同样受支持,但图像必须写成 data:image/...;base64,...,不适合保存较大的真实帧。Web 服务限制单次请求约 32 MiB、ZIP 内文件最多 32 个、解压总量约 64 MiB,因此单步 observation 推荐优先使用包含 PNG/JPEG 的 ZIP。
# tools/build_observation_npz.py
import numpy as np

np.savez_compressed(
    "observation.npz",
    **{
        "task": np.asarray(["pick up the object"]),
        "observation.state": np.zeros(14, dtype=np.float32),
        "observation.images.cam_high": np.zeros((224, 224, 3), dtype=np.uint8),
        "observation.images.cam_left_wrist": np.zeros((224, 224, 3), dtype=np.uint8),
        "observation.images.cam_right_wrist": np.zeros((224, 224, 3), dtype=np.uint8),
    },
)
9.5 我如何执行一次完整推理
仓库新增的 tools/run_web_inference.py 把一次推理拆成四步:读取同步采集的三路相机帧和 14 维机器人状态,构造带官方字段的 observation.json,把清单与图像压缩成内存 ZIP,最后向 /api/infer-file 提交原始字节并保存 JSON 结果。这里要厘清的是,脚本只负责数据封装与策略调用,不负责直接驱动机器人;返回的 14 维动作仍需经过机器人侧的单位转换、关节映射、限位和安全控制后才能下发。
# tools/run_web_inference.py
manifest: dict[str, Any] = {"task": task, "observation.state": state}
images: list[tuple[Path, str]] = []
for argument_name, canonical_key in IMAGE_FIELDS:
    path = _validate_file(
        Path(getattr(args, argument_name)), canonical_key, SUPPORTED_IMAGE_SUFFIXES
    )
    archive_name = f"{argument_name}{path.suffix.lower()}"
    manifest[canonical_key] = archive_name
    images.append((path, archive_name))

buffer = io.BytesIO()
with zipfile.ZipFile(buffer, "w", compression=zipfile.ZIP_DEFLATED) as archive:
    archive.writestr(
        "observation.json",
        json.dumps(manifest, ensure_ascii=False, indent=2),
    )
    for source_path, archive_name in images:
        archive.write(source_path, archive_name)
return buffer.getvalue(), "observation.zip"
若三张图片已经保存为文件,可以直接运行下面的命令,其中 --state 后必须依次提供当前机器人配置规定的 14 个状态值。脚本默认连接本机 18080 端口;从其他电脑访问当前服务器时,通过 --server http://117.50.193.149:18080 指定公开地址。推理成功后,终端会打印动作维度、归一化动作维度和服务耗时,完整响应则写入 lingbot-vla-result.json,便于后续控制程序读取或离线核查。
第一次测试时,服务器上的 /data/cam_high.png 等路径通常并不存在,需要先从 Web 服务下载标准模板并解压。下面命令会创建 /data,获得三张 224×224 的示例图片和 observation.json,随后文章中的完整推理命令就可以直接执行。这里要强调的是,模板图片只是三张纯色占位图,只能证明文件读取、ZIP 打包、HTTP 请求和模型调用链路正常;接入机器人时必须用同一时刻采集的顶部、左腕和右腕真实 RGB 帧覆盖这些文件。
mkdir -p /data
curl -fsS http://127.0.0.1:18080/api/template \
  -o /tmp/lingbot-vla-observation-template.zip
/usr/local/miniconda3/bin/python -m zipfile -e \
  /tmp/lingbot-vla-observation-template.zip /data
ls -lh /data/cam_high.png \
  /data/cam_left_wrist.png \
  /data/cam_right_wrist.png
cd /workspace/lingbot-vla-v2
/usr/local/miniconda3/bin/python tools/run_web_inference.py \
  --server http://117.50.193.149:18080 \
  --task "pick up the object" \
  --state 0 0 0 0 0 0 0 0 0 0 0 0 0 0 \
  --cam-high /data/cam_high.png \
  --cam-left-wrist /data/cam_left_wrist.png \
  --cam-right-wrist /data/cam_right_wrist.png \
  --output /data/lingbot-vla-result.json
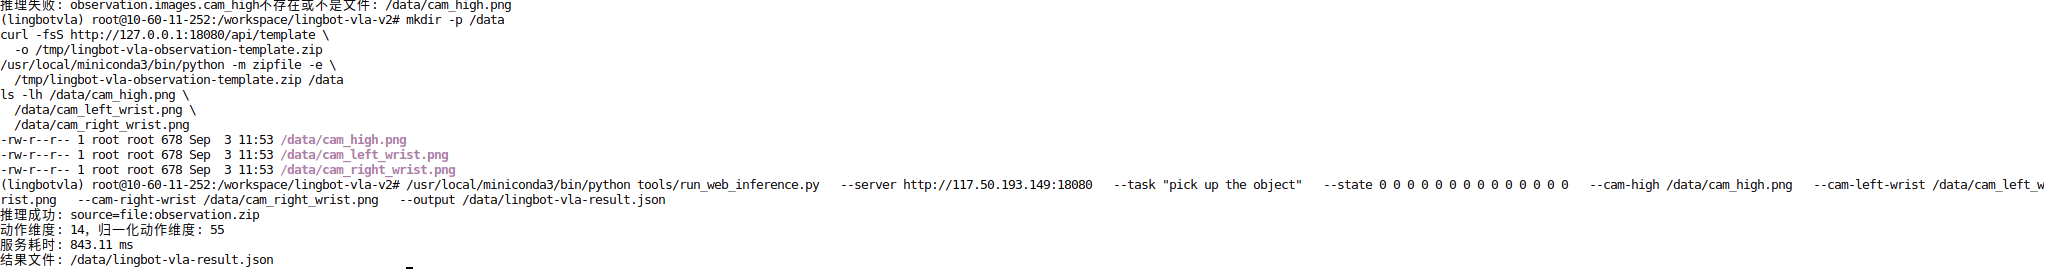
已有标准 observation 文件时不必重新打包,可以使用 --input /data/observation.zip、--input /data/observation.npz 或 --input /data/observation.json 直接推理。脚本会拒绝超过 32 MiB 的请求、不存在的图像、非 14 维状态以及无法连接的服务,并把服务返回的详细错误输出到标准错误。实际测试应先用 Web 页面下载的模板 ZIP 验证接口连通,再替换为同一时刻采集的真实状态与图像,避免把不同时间戳的数据拼成一个 observation。
/usr/local/miniconda3/bin/python tools/run_web_inference.py \
  --server http://127.0.0.1:18080 \
  --input /tmp/lingbot-vla-observation-template.zip \
  --output /tmp/lingbot-vla-test-result.json
10. 总结
LingBot-VLA 2.0 把跨形态数据、55 维动作容器、稀疏 MoE 和时空蒸馏组合成可后训练的机器人策略,而可靠部署的关键是让 checkpoint、机器人配置、归一化统计、三路相机和安全执行层保持一致。 当前单张约 48 GiB 的 RTX 4090 足以承担 BF16 单模型 Web 推理,浏览器页面已经把软件链路开放出来,但任何真实机器人动作仍应经过独立限位、碰撞检查、急停和人工确认。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献160条内容

所有评论(0)