光伏清洁机器人伪视觉 VS AI语义视觉,有何不同?
光伏清洁机器人,如今都爱标榜"视觉导航"。
但拆开看,很多所谓"视觉导航",内核并不是视觉。
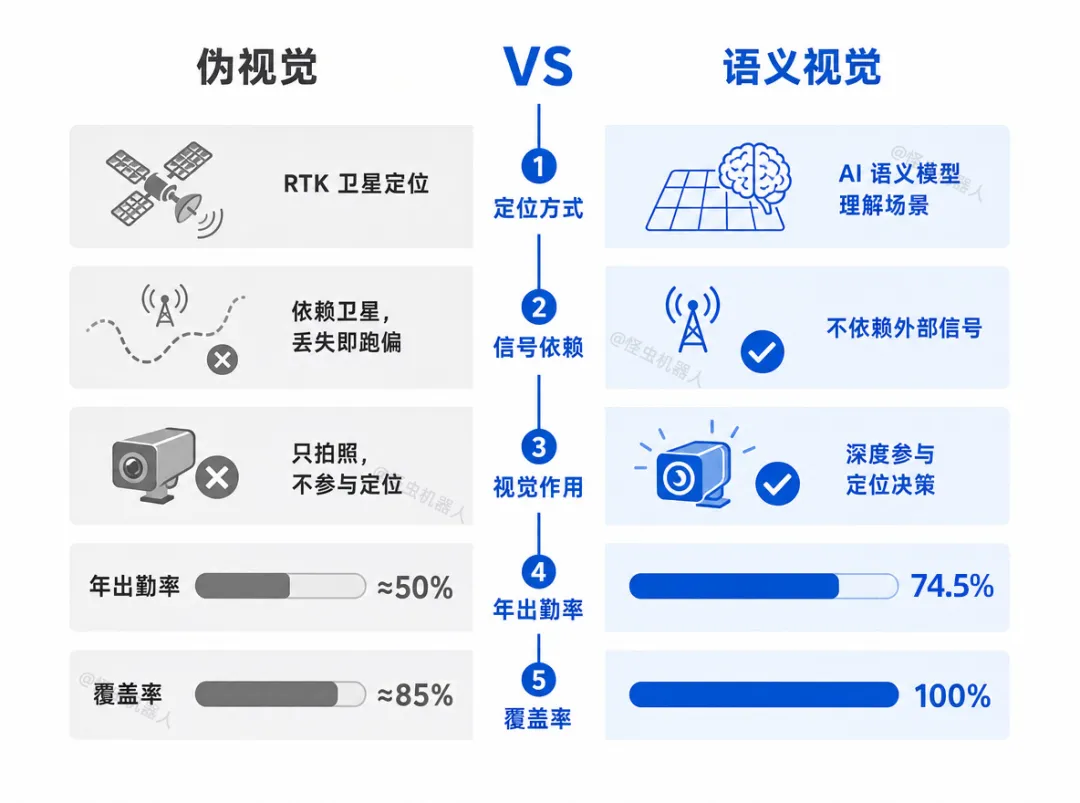
典型架构是"RTK + 摄像头"。整机导航完全依靠 RTK 卫星定位,摄像头只是挂在机身上做辅助,要么做简单的边缘提取,要么只用来拍照留档,从不参与核心的定位决策。
一旦 RTK 信号丢失、失锁,机器就直接跑偏,无法独立完成清扫。
这就是行业里说的"伪视觉":摄像头≠视觉系统,导航内核还是 RTK。视觉是表象,卫星才是实质。
伪视觉是"看",语义视觉是"理解"
伪视觉的问题,在于它只"看",不"理解"。
摄像头拍下画面,做的是边缘提取;判断哪里是板的边缘、哪里是边框。这是像素级的"看"。但光伏板是动态的:光线在变,阴影在移,灰尘在积。只靠"看",强光一照,画面过曝,判断就乱了。
真正的语义视觉,做的是"理解"。它不是认出"这里有一块板",而是理解"这块板的组件边界在哪、边框在哪、积灰分布是什么样"。
这个区别,决定了两条完全不同的技术路线:
-
伪视觉:靠外部信号(卫星)定位,视觉只是辅助
-
语义视觉:不依赖外部信号,靠语义模型理解场景本身
一个是"参照",一个是"理解"。差一个字,差一整代技术。
语义理解,落到清洁上是三层
怪虫的 AI 语义视觉,把"理解"拆成了三个层次。
感知层,理解组件。 识别组件的有效区域、边框位置、网格线走向。不是框出一个大概的矩形,而是理解每一块板的真实边界。
决策层,理解积灰。 判断哪里积灰多、哪里积灰少,据此规划最优清洁路径。不是按固定路线来回刷,而是针对积灰分布做决策。
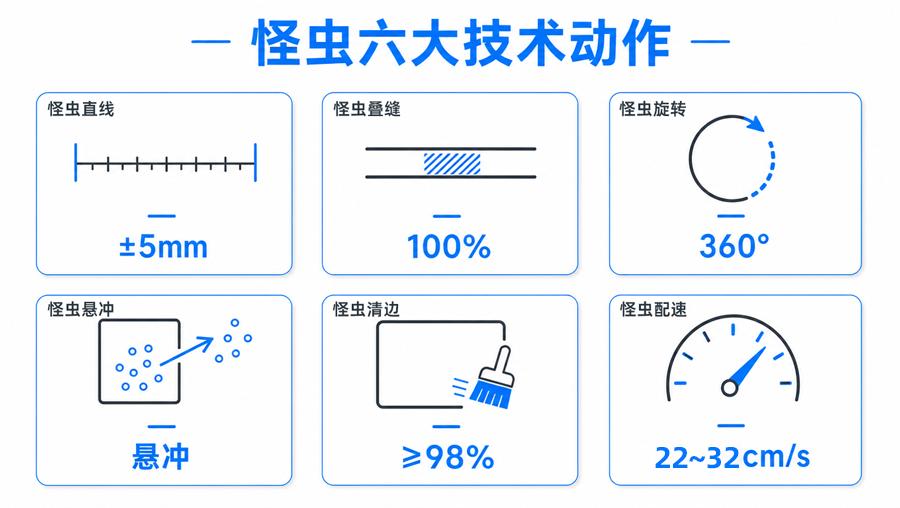
执行层,理解动作。 直线、叠缝、旋转、悬冲、清边、配速,六大技术动作对应清洁的每一个细节。换行不留缝、转弯不跑偏、边框不遗漏。
三层合起来,机器人才真正"懂"它脚下的光伏板。
数据,最能说明"理解"和"参照"的差距
技术路线不同,跑出来的数据也不同。
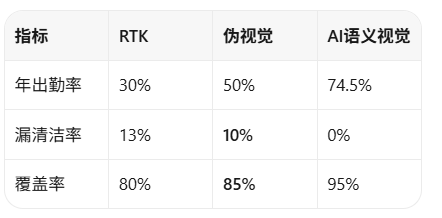
(年出勤率 =(年度实际出勤天数 ÷ 年度应出勤天数))
RTK 年出勤率 30%,意味着一年里大部分时间在停机——信号一丢,机器就不敢动。伪视觉约 50%,强光下判断出错,出勤率也上不去。
AI 语义视觉出勤率 74.5%,是 RTK 的 2.5 倍。漏清洁率 0%,覆盖率 100%。这就是"理解"和"参照"的差距:一个能稳定干活,一个受制于信号和光照。
语义理解,不是凭空来的
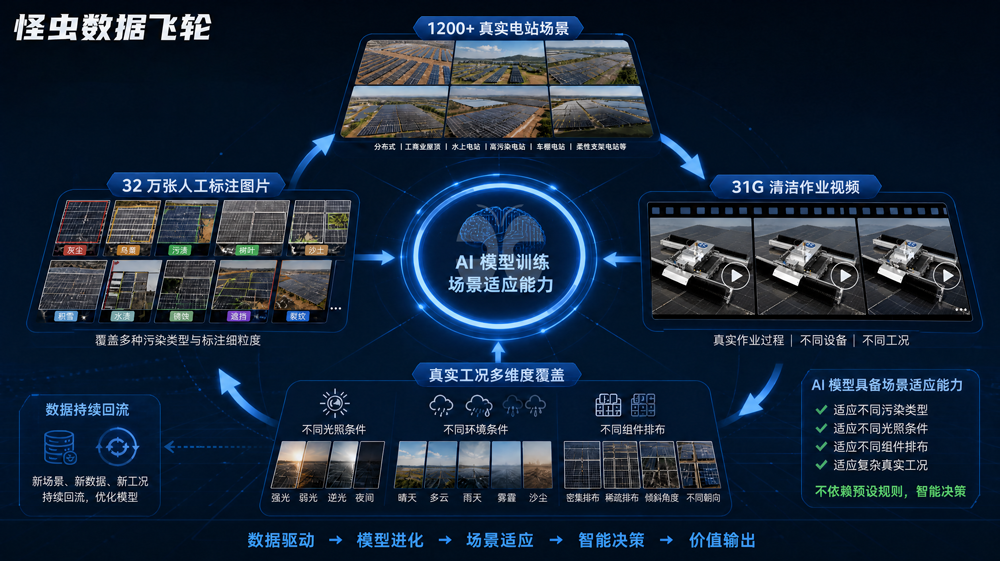
AI 语义视觉能"理解"光伏板,靠的是真实数据训练出来的。
怪虫的语义模型,基于 1200+ 真实电站场景、32 万张人工标注图片、31G 清洁作业视频训练。41 个国家、100GW+ 清洁量、近 4000 台在线设备,持续产生新的场景数据。
强光、阴影、反光、暴雨,这些真实环境里的复杂光照,都在训练数据里。模型越跑越懂光伏场景,越用越知道怎么在复杂条件下保持精准。
这就是语义视觉和伪视觉最根本的区别:一个靠算法理解,一个靠摄像头做营销。一个越用越准,一个换个光照就失灵。
从"看"到"理解",是光伏清洁的分水岭
光伏清洁走了这么多年,定位技术一直是它的软肋。
靠卫星定位,信号一丢就趴窝。伪视觉加装摄像头,看着智能,实则还是 RTK 的内核。
AI 语义视觉把这条路走通了:不靠外部信号,靠理解场景本身。出勤率、漏清洁率、覆盖率,三个数字把差距摆在了明面上。
光伏清洁的分水岭,不在摄像头有几个,而在机器到底"看"还是"理解"
真正语义视觉导航,机器人依靠识别光伏板环境自主规划路线,导航本身不需要卫星定位这类外部定位信号。如果去掉 RTK 机器人就无法作业,则导航核心还是 RTK,视觉只起到末端对位的辅助作用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献9条内容

所有评论(0)