从 0 到 1 构建 GitHub 自动化测试 Case Reviewer Bot(一):实现一个测试代码Review 机器人
从 0 到 1 构建 GitHub 自动化测试 Case Reviewer Bot(一):实现一个测试代码Review 机器人
之前公司的测试跟我聊天的时候,说现在的测试的项目越来越多,AI生成代码的速度也越来越快,导致大家开始没法清楚哪些测试节点项目做了,有没有出现重复,所以想整一个AI code review试试。
现在 AI code review 已经不算稀奇了。GitHub 自己有 Copilot code review,CodeRabbit、Qodo、Greptile、Graphite 这类商业产品也都在做 PR 自动审查;开源世界里也有 reviewdog、Danger、PR-Agent 这种可以接入 CI 和 PR 的工具。
真正让我想单独写这个系列的原因,是测试代码 review 里有一个更具体的问题:测试用例越写越多之后,大家很难判断一个新 case 到底是在补边界,还是把已有场景又测了一遍。
这个问题在业务仓库里挺容易出现。比如登录接口已经有一个“密码错误返回 401”的测试,后来另一个人又补了一个“用户输入错误密码不能登录”的测试。名字不一样,写法也不一样,但测试意图可能高度重合。reviewer 如果熟悉历史代码还能看出来,如果仓库大一点,靠人脑翻历史 case 就很累。
所以这个系列要做一个很小但能跑通的东西:
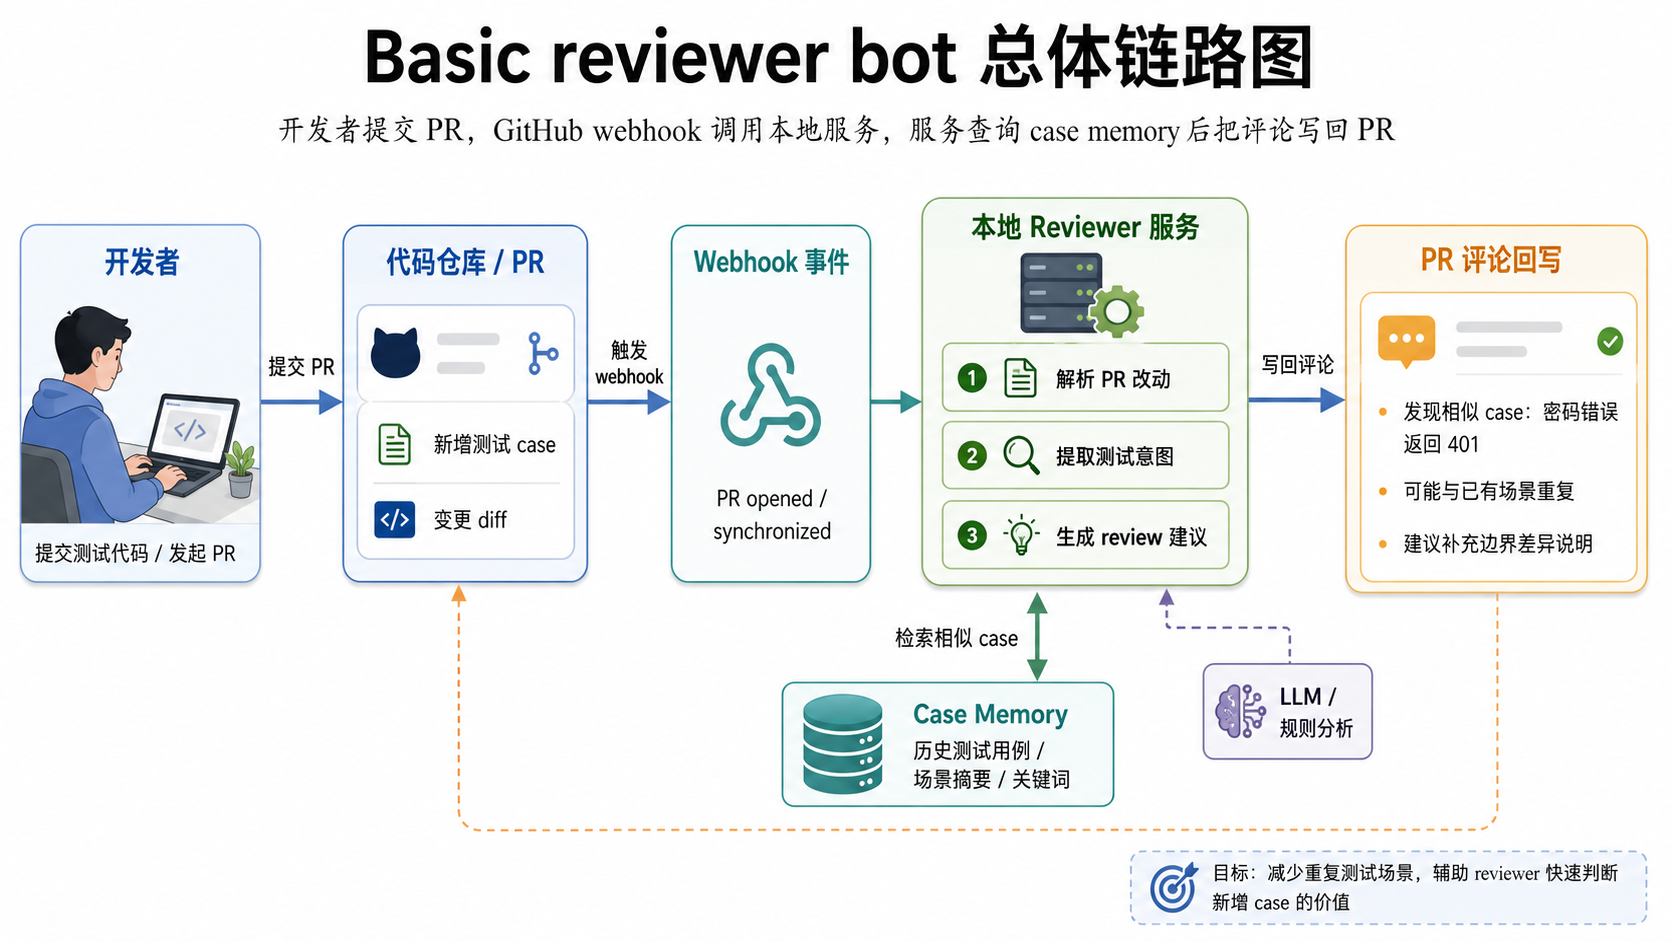
开发者提交 PR
  -> GitHub webhook 通知我们的服务
  -> 服务提取 PR 里的自动化测试 case
  -> 和历史 case memory 做相似度比较
  -> 生成一段 review 意见
  -> 评论回 GitHub PR
先看一下现在已有的工具
在动手写 demo 前,我先粗略看了下现在已有工具大概做到了什么程度。这里不是做严格选型报告,只是确认一件事:我们要做的东西,是不是已经有现成工具完全覆盖了。
开源工具:更偏“自动化检查和 PR 评论框架”
开源里最典型的是 reviewdog。它的定位很清楚:把各种 linter / analyzer 的输出过滤到 PR diff 上,然后自动发 review comment。它很适合做这类事情:
eslint / flake8 / golangci-lint
  -> reviewdog
  -> GitHub PR comment
它解决的是“如何把检查结果优雅地评论到 PR 上”。但它本身不负责理解测试 case 是否重复。
另一个老牌工具是 Danger JS。Danger 更像是团队规范自动化工具,比如:
PR 没写 changelog
测试文件没改
改了 package.json 但没改 lockfile
这类规则非常适合用 Danger 固化。它也能在 PR 里留言,但它不是一个语义相似度系统。
还有 PR-Agent,它是开源的 AI PR reviewer。它能做 PR 描述、review、改进建议这类事情。这个方向离我们更近,但它的目标更通用:看整个 PR 的代码质量,而不是专门围绕“自动化测试 case memory”做重复场景识别。
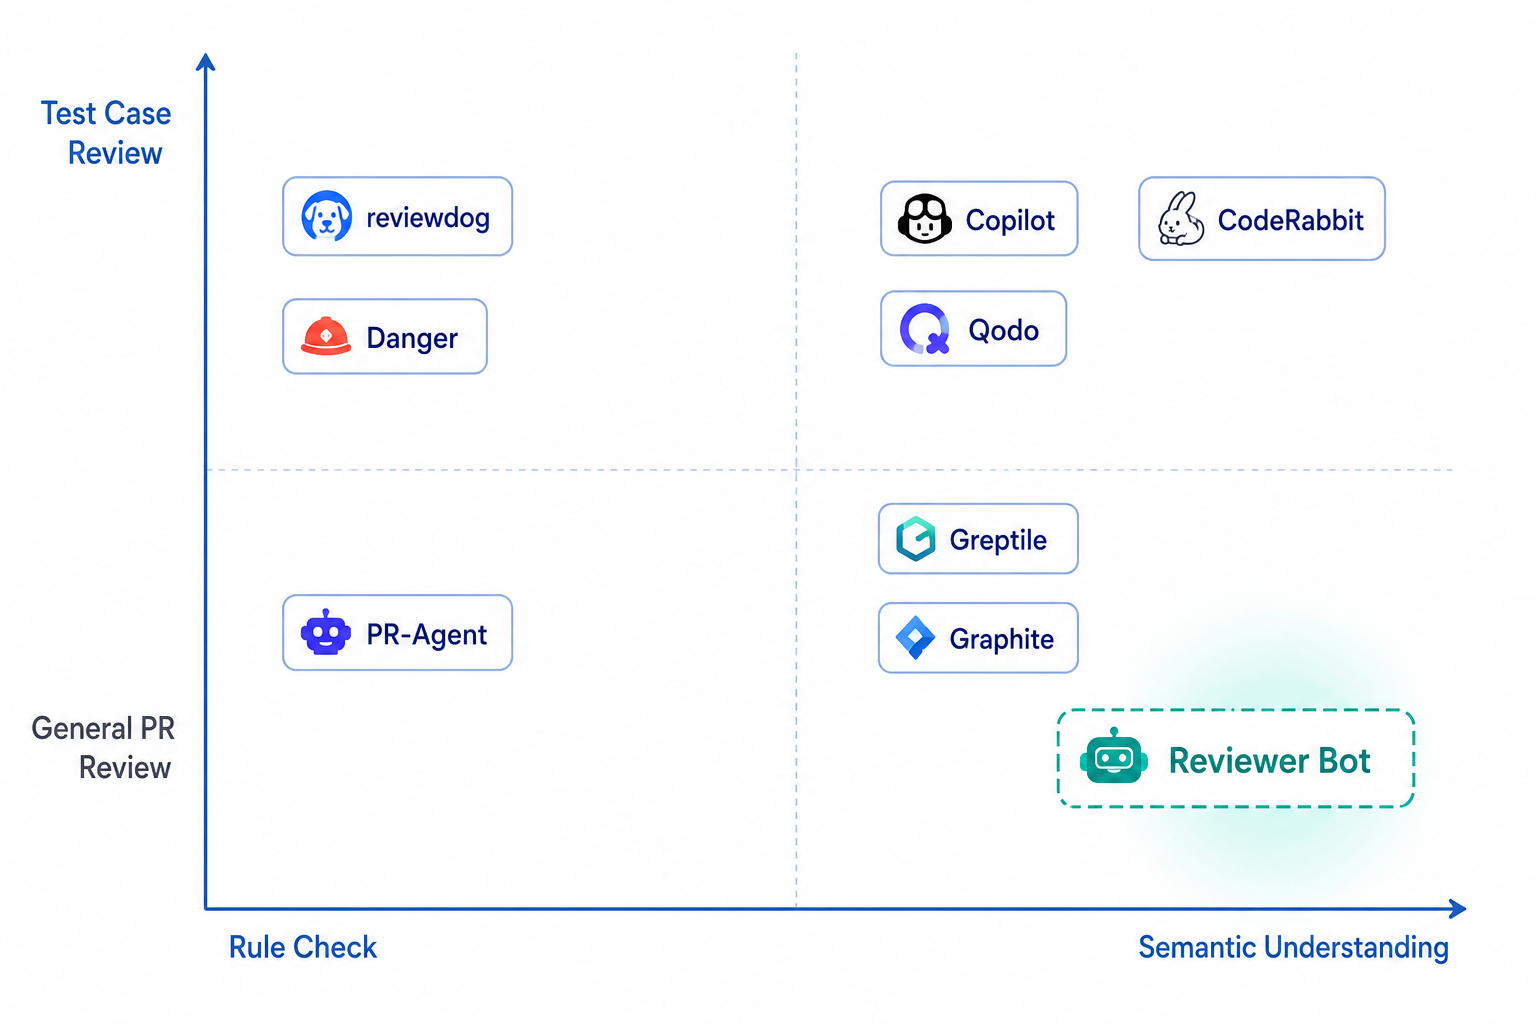
如果把这些开源工具放在一条线上,它们大概是:
reviewdog / Danger
  -> 自动化规则和检查结果评论

PR-Agent
  -> 通用 AI PR reviewer

我们这个 demo
  -> 自动化测试 case 的历史记忆和相似判断
商业工具:更偏“通用 AI Code Review 平台”
商业产品这两年推进得更快。
GitHub Copilot code review 已经直接集成在 GitHub 里,GitHub 也在 changelog 里宣布过 Copilot code review GA。它的优势是入口天然,开发者不用额外搭一套服务。
CodeRabbit 的定位是 AI-first pull request reviewer,强调上下文反馈、逐行建议和聊天式交互。
Qodo 更强调 code quality 和 SDLC governance,除了 review,还把测试覆盖、文档、规范治理等工作流也放进去。
Greptile 的卖点是理解整个 codebase,用团队规则和历史上下文做 PR review。
Graphite 也在做 AI code review 平台,并把 code review workflow 和 AI reviewer 结合在一起。
这些产品基本说明一个趋势:AI code review 不是没人做,而是已经开始平台化了。
它们通常覆盖:
- PR diff 代码问题
- bug 和潜在风险
- style / readability
- security issue
- repo context
- review comment 自动生成
- 团队规则
但对我这个系列来说,问题不在“它们好不好”,而在“我要讲的这条链路够不够具体”。
我想拆的是一个更窄的问题:
新增自动化测试 case
  -> 历史测试 case memory
  -> 是否重复覆盖同一测试意图
这个问题比通用 AI review 更小,也更适合拿来做教学 demo。因为它能把 webhook、GitHub API、case 提取、数据库、相似度、LLM 评论这些点串起来,而且每一步都能看见结果。
现在大家大概做到什么程度了
看完这些工具后,我的感觉是:现在 PR 自动审查已经分成了几类。
第一类是规则型。
linter
static analysis
Danger rules
reviewdog comments
SonarQube PR analysis
这类工具成熟、稳定、可解释,适合发现明确规则问题。比如 SonarQube Cloud Pull Request Analysis 就是典型的代码质量分析接入 PR。
第二类是通用 AI reviewer。
Copilot code review
CodeRabbit
Qodo
Greptile
Graphite
PR-Agent
这类工具更像“多看一眼 PR 的 AI reviewer”。它们适合抓 bug、解释风险、给改进建议,但输出质量会受上下文、规则、模型和产品设计影响。
第三类是垂直场景 reviewer。
比如我们这个 demo 想做的是:
专门看自动化测试 case 是否重复
这个场景没有通用 code review 那么大,但工程上很有价值。它要求 bot 不只是看 diff,还要有历史 case memory。也就是说,它要记得仓库里以前测过什么。
这也是我最后决定写这个系列的原因:通用工具已经很多,但把一个垂直 reviewer 从 basic demo 拆开讲,反而更适合新人理解 AI 工程应用怎么落地。
为什么不直接用现成工具
如果你的目标是“立刻给团队上一个 AI code review 产品”,那当然应该先试现成工具。
但这个系列的目标不是替代 CodeRabbit、Qodo 或 Copilot。这个系列想回答的是另一个问题:
如果我自己做一个很小的 reviewer bot,需要哪些基本模块?
做完 basic 版,至少能把这些东西串起来:
- GitHub webhook 怎么触发服务
- GitHub API 怎么发 PR 评论
- 自动化测试 case 怎么提取
- 历史 case 怎么存
- 相似度怎么判断
- LLM 在哪里发挥作用
- 日志和 fallback 怎么保证 demo 可调试
这些能力就算最后不用自研,也有价值。因为你再去看商业工具或开源工具时,就不会只看“它很智能”,而是会问更工程化的问题:
它有没有 repo context?
它的评论是否幂等?
它怎么处理模型失败?
它能不能解释为什么判相似?
它有没有针对测试 case 的历史记忆?
这就是这个系列的真正目的。
这篇系列先不追求生产级
这个系列先围绕 basic 版来写。basic 版的目标不是做一个完整平台,而是先验证一条闭环:
PR 触发
  -> case 提取
  -> 相似度判断
  -> 评论发布
所以它会有一些明确边界:
- 默认用 SQLite,不强制上 PostgreSQL。
- 默认可以关闭模型调用,先用规则相似度跑通。
- webhook 先 inline 处理,不引入任务队列。
- 测试框架先支持 pytest、Jest、Vitest。
- 复杂的 case rename、fixture 影响范围、多分支隔离,先放到升级版。
这不是偷懒,而是工程上很重要的一步:先确认这个工具有没有价值,再考虑把它做厚。
什么是测试 case
这里的 case 指自动化测试用例,不是业务需求里的 case。
比如 pytest:
def test_login_success():
    response = login("alice", "correct-password")
    assert response.status_code == 200
或者 Jest / Vitest:
test("returns 401 if password is invalid", async () => {
  const response = await login("alice", "bad-password")
  expect(response.status).toBe(401)
})
bot 需要从代码里识别出这些测试函数或测试块,再把它们转成结构化信息:
case_name
file_path
framework
raw_code
assertions
normalized_code
target_module
summary
这些信息后面会进入 case memory,作为历史记忆。
为什么不是直接让 LLM 看整个 PR
最直接的想法是:把 PR diff 全塞给 LLM,让它判断有没有重复测试。
这个办法 demo 也能做,但我不太喜欢把第一版做成这样,原因有几个:
- PR diff 可能很大,成本和延迟都不好控。
- LLM 不知道仓库历史 case,容易只看当前 patch。
- 没有结构化数据,后面很难做回放和调阈值。
- 一旦误判,很难解释它到底依据什么判断。
所以 basic 版采用更工程化一点的路线:
规则提取 case
  -> 规则归一化
  -> 数据库存历史 case
  -> 相似度计算
  -> LLM 只做评论增强
LLM 可以让评论更自然,但不应该成为唯一判断来源。这个取舍会贯穿整个系列。
basic 版最后能看到什么效果
跑通后,在 GitHub PR 页面会看到类似这样的评论:
## 自动化测试用例 Review 结果

本次变更检测到 2 个新增或修改的自动化测试用例。

### 1. `test_login_success`

- 结论:新测试用例
- 最高相似度:0%
- 文件:`tests/test_login3.py`

**新增用例意图**

- 覆盖对象:`login3`
- 场景:`-`
- 期望:`-`
- 输入:`-`
- 断言意图:`1 + 1 equals expected`
- signature 置信度:30%
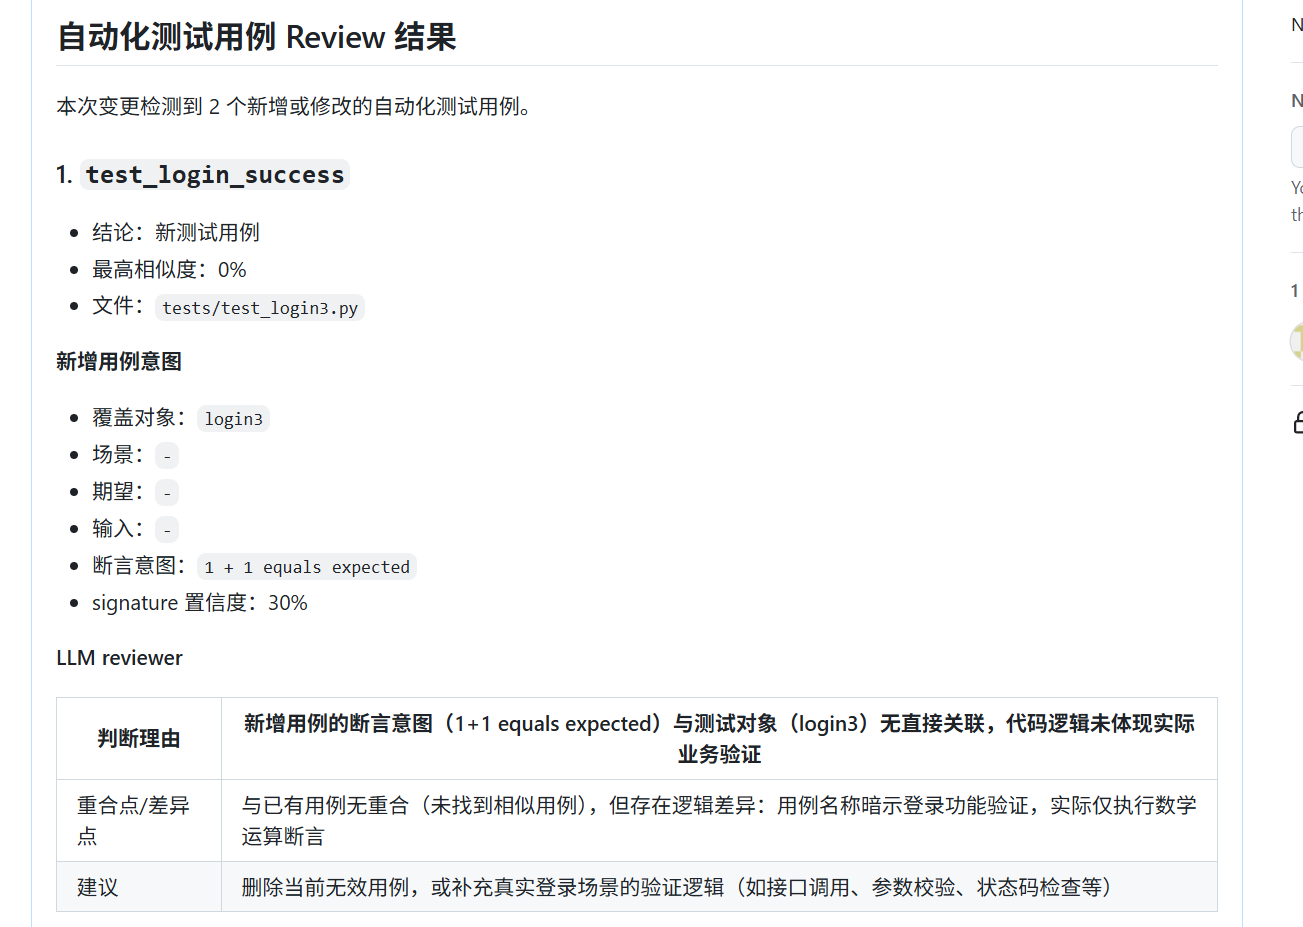
这就是 basic 版最重要的验收标准:不是概念讲通,而是真的能在 PR 上看到 bot 评论。
系列怎么安排
这个系列会按下面的节奏推进:
- 先启动本地服务。
- 再接 GitHub webhook。
- 然后让 bot 能发 PR 评论。
- 接着讲 case 提取。
- 再讲 case memory。
- 然后讲 basic 版相似度判断。
- 再接入 LLM reviewer。
- 最后补 smoke test、阶段日志和升级路线。
每一篇都尽量有一个能验证的结果。
下一篇先把基础服务在本地跑起来。先让它动,然后再分析一下这个流程。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)