Agent Demo能跑团队却不敢接?权限日志和交付文档才是真正的门槛
《Agentic AI到底能不能干活?别只看 Demo 和跑分》看起来是个大话题,但真落到项目里,常常就是几个具体选择。下面我尽量按实际开发时会遇到的问题来讲。
摘要
前阵子我带团队把一个 Claude Code 接进内部项目,单人跑 Demo 确实丝滑,结果团队接手第二天就翻车了。不是模型能力不够,是权限越界、日志缺失、交付文档缺失,三个人对着满屏报错互相甩锅。
这件事让我意识到一个问题:现在 AI 编程工具从个人试用走向团队协作,真正卡脖子的不是"Agent 能不能干活",而是"团队能不能接手并维护"。
目录
- Agentic 的定义:不止是聊天机器人
- 自主性边界:别指望 Agent 什么都干
- 任务拆解:从模糊需求到可执行步骤
- 可观测性:日志缺失是最大隐形成本
- 安全约束:权限越界是最常见的翻车点
- 交付文档:团队接手的最后一块拼图
- 总结
Agentic 的定义:不止是聊天机器人
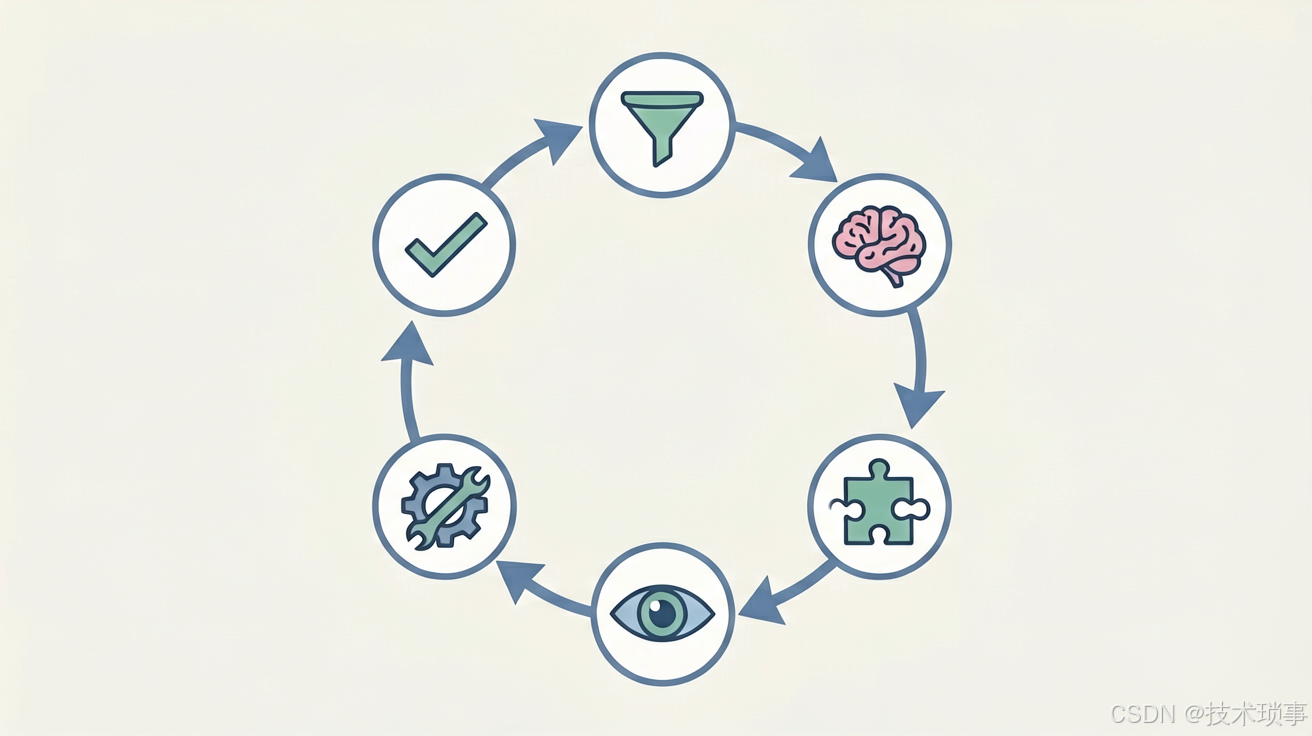
很多人对 Agentic AI 的理解还停留在"能对话的机器人"层面。但真正的 Agentic 系统,核心差异在于自主决策和执行循环。
一个典型的 Agentic 工作流是这样的:
接收任务 → 理解意图 → 拆解子任务 → 调用工具执行 → 观察结果 → 判断是否完成 → 未完成则继续循环
关键区别在于,它不是被动回答问题,而是主动规划、执行、反馈、修正。
我见过很多团队把"能调 API 的聊天机器人"叫做 Agent,这其实是误解。Agent 的核心能力是工具调用和循环执行,不是多轮对话。
自主性边界:别指望 Agent 什么都干
这是最容易踩坑的地方。团队接手 Agent 项目,首先要明确边界:
- 能做什么:代码生成、单元测试、文档整理、简单脚本编写
- 不能做什么:数据库直接操作、生产环境部署、敏感数据访问
- 需要人工确认的:架构调整、核心逻辑修改、权限变更
我有个同事之前让 Agent 直接连生产数据库跑查询,结果数据被清空,差点被开除。这不是模型问题,是边界没划清楚。
实用建议:在项目启动前,和团队一起写一份"Agent 能力清单",明确哪些操作需要人工审批,哪些可以自动执行。
任务拆解:从模糊需求到可执行步骤
Agent 最值钱的能力是任务拆解。但拆解质量直接决定执行效果。
真实案例:
输入:用户要求"优化项目的登录接口性能"
拆解过程:
1. 定位登录接口代码位置
2. 分析现有查询逻辑
3. 识别瓶颈(发现是 N+1 查询问题)
4. 生成优化方案
5. 实施优化并生成测试用例
可观察结果:接口响应时间从 2.3s 降到 0.4s,但生成的代码缺少注释,团队接手后花了一小时理解逻辑。
这个案例说明:Agent 能完成任务,但交付质量参差不齐。日志和文档才是团队接手的关键。
可观测性:日志缺失是最大隐形成本
排查过程:
现象:Agent 生成的代码在本地能跑,但团队集成时报错,没人知道 Agent 做了什么决策。
验证动作:
1. 检查 Agent 的调用日志 → 发现日志只有 API 请求记录,没有决策路径
2. 对比手动编写的代码 → 发现 Agent 用了不同的库版本
3. 回滚代码 → 问题消失,但无法定位根本原因
排除结果:不是模型问题,是日志粒度不够。Agent 的每一步决策、工具调用、结果观察都需要记录,否则团队接手就是盲人摸象。
代码解释:
一个基础的可观测性框架:
import logging
from datetime import datetime

# 配置日志格式,包含关键上下文
logging.basicConfig(
    format='%(asctime)s | %(levelname)s | agent_id: %(message)s',
    level=logging.INFO
)
logger = logging.getLogger("agentic_system")

class AgentLogger:
    """Agent 执行日志记录器"""

    def __init__(self, agent_id: str):
        self.agent_id = agent_id
        self.logger = logging.getLogger(f"agent.{agent_id}")
        self.decision_log = []

    def log_decision(self, step: str, reasoning: str, tool_used: str = None):
        """记录决策点和工具调用"""
        entry = {
            "timestamp": datetime.now().isoformat(),
            "step": step,
            "reasoning": reasoning,
            "tool": tool_used,
            "agent_id": self.agent_id
        }
        self.decision_log.append(entry)
        self.logger.info(f"[{step}] {reasoning}" +
                        (f" | tool: {tool_used}" if tool_used else ""))
        return entry

    def log_result(self, step: str, success: bool, output: str = None):
        """记录执行结果"""
        status = "SUCCESS" if success else "FAILURE"
        self.logger.info(f"[{step}] {status}" +
                        (f" | output: {output[:200]}" if output else ""))
这段代码的关键点:
log_decision记录 Agent 的决策路径,包括推理和使用的工具log_result记录执行结果,成功或失败都要记录- 日志格式统一,方便后续检索和分析
适用边界:这个框架适合中小型项目。如果 Agent 调用频次极高,建议引入结构化日志(如 JSON 格式)和集中式日志系统(如 ELK)。
安全约束:权限越界是最常见的翻车点
失败原因分析:
业务错误:Agent 理解错了任务意图,执行了错误的操作。
- 区分方法:检查 Agent 的决策日志,看推理路径是否符合预期
- 解决方式:优化 prompt 设计,增加任务澄清环节
配置错误:权限配置过于宽松,Agent 能访问不该访问的资源。
- 区分方法:检查环境变量、配置文件、权限策略
- 解决方式:最小权限原则,明确标注敏感操作
环境错误:本地环境和生产环境不一致,导致 Agent 行为异常。
- 区分方法:对比环境配置,检查依赖版本
- 解决方式:容器化部署,环境配置版本控制
我见过最典型的权限越界案例:Agent 被允许写入配置目录,结果覆盖了团队的 CI/CD 配置,导致整个构建流程瘫痪。
实用建议:
1. 给 Agent 分配独立的低权限账号
2. 敏感操作需要二次确认(如删除、修改生产配置)
3. 定期审计 Agent 的操作日志
交付文档:团队接手的最后一块拼图
很多团队忽视这一点:Agent 生成的代码,必须有对应的文档说明。
文档应该包含:
- 这段代码解决什么问题
- 关键逻辑的解释
- 潜在的边界情况
- 后续维护建议
没有文档的代码,团队接手成本会指数级上升。
总结
Agentic AI 从 Demo 到生产,真正值钱的不是模型能力,而是可观测性、权限控制和交付文档。
我的建议是:
1. 先建立日志框架,再考虑功能扩展
2. 权限配置宁严勿松,敏感操作必须人工确认
3. 要求 Agent 生成代码的同时生成文档
4. 定期回顾 Agent 的执行日志,优化决策路径
Demo 能跑只是第一步,团队能接手、能维护、能迭代,才是真正的价值。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 6
 0
- 0


 已为社区贡献18条内容

所有评论(0)