智谱 AI 免费模型实战教程
智谱 AI 免费模型实战教程(学生自学版)
本教程面向初学者。只要你跟着教程逐课敲代码,不看任何已有代码文件也能独立复现整个项目。
每一课都给出完整的、与原始项目一致的代码(直接复制粘贴即可运行)。
项目使用智谱 AI 官方免费模型,覆盖「文本聊天 / 视觉理解 / 文生图 / 视频生成」四大能力。
一、教程目录
| 课次 | 主题 | 产出文件 | 模型 | 端口 |
|---|---|---|---|---|
| 第 1 课 | 文本聊天机器人(SSE 流式 + 深度思考) | src/01_chat_bot.py、templates/chat.html | glm-4.7-flash | 8001 |
| 第 2 课 | 视觉聊天机器人(图片理解) | src/02_chat_bot_vision.py、templates/chat_vision.html | glm-4.6v-flash | 8002 |
| 第 3 课 | 文生图(CogView) | src/03_chat_bot_image.py、templates/chat_image.html | cogview-3-flash | 8003 |
| 第 4 课 | 视频生成(CogVideoX 异步任务) | src/04_chat_bot_video.py、templates/chat_video.html | cogvideox-flash | 8004 |
| 第 5 课 | 端到端测试 | tests/e2e_test.py | — | — |
建议按顺序学习:每一课都建立在前一课的基础上,难度循序渐进。
二、项目最终结构
学完本教程,你将得到这样一个完整的项目:
fastapi-glm/
├── .env                  # 环境变量(API Key、模型名)
├── pyproject.toml        # Python 依赖配置
├── uv.lock               # 依赖锁定文件(uv 自动生成)
├── src/
│   ├── 01_chat_bot.py        # 第 1 课:文本聊天后端
│   ├── 02_chat_bot_vision.py # 第 2 课:视觉聊天后端
│   ├── 03_chat_bot_image.py  # 第 3 课:文生图后端
│   └── 04_chat_bot_video.py  # 第 4 课:视频生成后端
├── templates/
│   ├── chat.html         # 第 1 课:文本聊天前端
│   ├── chat_vision.html  # 第 2 课:视觉聊天前端
│   ├── chat_image.html   # 第 3 课:文生图前端
│   └── chat_video.html   # 第 4 课:视频生成前端
├── tests/
│   └── e2e_test.py       # 第 5 课:端到端测试
└── uploads/              # 运行时自动创建(保存图片/视频)
    ├── cogview/
    └── cogvideox/
三、技术栈一览
| 层级 | 技术 | 作用 |
|---|---|---|
| Web 框架 | FastAPI | 提供路由、请求校验、流式响应 |
| ASGI 服务器 | uvicorn | 承载 FastAPI 应用运行 |
| AI SDK | zai-sdk | 智谱 AI 官方 Python SDK |
| 环境变量 | python-dotenv | 从 .env 加载密钥与配置 |
| HTTP 客户端 | httpx | 下载远程图片/视频(文生图、视频生成课用到) |
| 前端 | 原生 HTML/CSS/JavaScript | 无需任何前端框架,单文件页面 |
| 流式协议 | SSE (Server-Sent Events) | 聊天逐 token 输出 |
| 包管理 | uv | 快速的 Python 包管理器 |
四、环境准备(一次配置,全程使用)
4.1 安装 uv
uv 是一个极快的 Python 包管理器,本项目用它来管理依赖和运行脚本。
- Windows(PowerShell):
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"
- macOS / Linux:
curl -LsSf https://astral.sh/uv/install.sh | sh
安装后,重新打开终端,执行 uv --version 确认安装成功。
4.2 创建项目目录
# Windows
mkdir fastapi-glm
cd fastapi-glm
# macOS / Linux
mkdir script_murder
cd script_murder
4.3 创建 pyproject.toml
在项目根目录创建 pyproject.toml,内容必须完全一致:
[project]
name = "fastapi-glm"
version = "0.1.0"
requires-python = ">=3.14"
dependencies = [
    "fastapi>=0.141.1",
    "httpx>=0.28.1",
    "python-dotenv>=1.2.2",
    "python-multipart>=0.0.32",
    "uvicorn[standard]>=0.52.1",
    "zai-sdk>=0.2.3",
]
[[tool.uv.index]]
url = "https://pypi.tuna.tsinghua.edu.cn/simple"
default = true
说明:
requires-python = ">=3.14":本项目要求 Python 3.14 及以上。zai-sdk是智谱 AI 官方 SDK,封装了对 GLM、CogView、CogVideoX 等模型的调用。tool.uv.index指定使用清华镜像源,加速国内下载。
4.4 创建 .env 文件
.env 存放密钥和模型名。在项目根目录创建 .env:
# 智谱 AI(GLM)聊天机器人配置
# 官网控制台获取:https://open.bigmodel.cn/usercenter/apikeys
ZAI_API_KEY=你的API_KEY

# 免费模型:glm-4.7-flash(参考 https://docs.bigmodel.cn/cn/guide/models/free/glm-4.7-flash)
ZAI_MODEL=glm-4.7-flash

# 免费视觉(多模态)模型:glm-4.6v-flash(参考 https://docs.bigmodel.cn/cn/guide/models/free/glm-4.6v-flash)
ZAI_VISION_MODEL=glm-4.6v-flash

# 免费"文生图"模型:cogview-3-flash(参考 https://docs.bigmodel.cn/cn/guide/models/free/cogview-3-flash)
ZAI_IMAGE_MODEL=cogview-3-flash

# 免费"文生视频/图生视频"模型:cogvideox-flash(参考 https://docs.bigmodel.cn/cn/guide/models/free/cogvideox-flash)
ZAI_VIDEO_MODEL=cogvideox-flash
如何获取 API Key:打开 https://open.bigmodel.cn/usercenter/apikeys,注册登录后点击「添加新的 API Key」,把生成的 Key(形如
xxxxxxxx.xxxxxxxx)填入ZAI_API_KEY=后面。
4.5 安装依赖
在项目根目录执行:
uv sync
这会自动创建虚拟环境并安装 pyproject.toml 中所有依赖。安装完成后,项目根目录会多出 .venv 目录和 uv.lock 文件。
4.6 创建必要的子目录
# Windows
mkdir src
mkdir templates
mkdir tests
# macOS / Linux
mkdir -p src templates tests
4.7 验证环境
创建一个测试文件 src/_hello.py(学完即可删除):
import os
from pathlib import Path
from dotenv import load_dotenv
from zai import ZhipuAiClient

load_dotenv(Path(__file__).resolve().parents[1] / ".env")
client = ZhipuAiClient(api_key=os.getenv("ZAI_API_KEY"), disable_token_cache=True)
resp = client.chat.completions.create(
    model="glm-4.7-flash",
    messages=[{"role": "user", "content": "你好"}],
)
print(resp.choices[0].message.content)
运行:
uv run python src/_hello.py
如果打印出 AI 的回复,说明环境配置成功!然后可以删除这个测试文件。
五、各课共同的后端骨架说明
四个后端文件的结构高度相似,都遵循以下骨架。理解它,后面学习会非常轻松:
1. 导入依赖(uvicorn / dotenv / fastapi / pydantic / zai)
2. load_dotenv() 加载 .env,读取 API_KEY 与 MODEL
3. 构造 ZhipuAiClient(智谱客户端)
4. app = FastAPI() 创建应用,添加 CORS 中间件
5. 定义 Pydantic 请求模型(BaseModel)
6. 定义业务函数(chat_stream / call_generations 等)
7. 定义路由(@app.post / @app.get)
8. if __name__ == "__main__": asyncio.run(uvicorn.Server(...).serve())
每一课只会在这套骨架上做增量改动:
- 第 1 课:最基础的 SSE 文本流。
- 第 2 课:请求体扩展为「多模态片段列表」。
- 第 3 课:从「流式」改为「一次性生成 + 线程池」。
- 第 4 课:从「同步生成」改为「异步任务 + 前端轮询」。
六、运行方式汇总
每一课的后端都是独立可运行的 FastAPI 应用:
# 第 1 课
uv run python src/01_chat_bot.py
# 浏览器打开 http://127.0.0.1:8001

# 第 2 课
uv run python src/02_chat_bot_vision.py
# 浏览器打开 http://127.0.0.1:8002

# 第 3 课
uv run python src/03_chat_bot_image.py
# 浏览器打开 http://127.0.0.1:8003

# 第 4 课
uv run python src/04_chat_bot_video.py
# 浏览器打开 http://127.0.0.1:8004
七、前置知识建议
如果你对以下知识完全陌生,建议先花半天预习:
- Python 基础:函数、类、生成器(
yield)、类型注解(str | None)。 - HTTP 基础:GET / POST、请求体、响应状态码。
- FastAPI 基础:会定义一个
@app.get("/")返回 JSON 即可(不必深入)。 - JavaScript 基础:能看懂
fetch、addEventListener、async/await即可。 - SSE 概念:服务端推送事件,浏览器通过
ReadableStream读取。第 1 课会详细讲。
准备好了吗?开始 第 1 课:文本聊天机器人!
第 1 课:文本聊天机器人(SSE 流式 + 深度思考)
本课你将从零实现一个完整的 AI 聊天机器人:前端页面 + 后端 API + 流式输出 + 思考过程展示。
这是整个项目的基石,后面三课都在本课的骨架上演进。请务必完整学完。
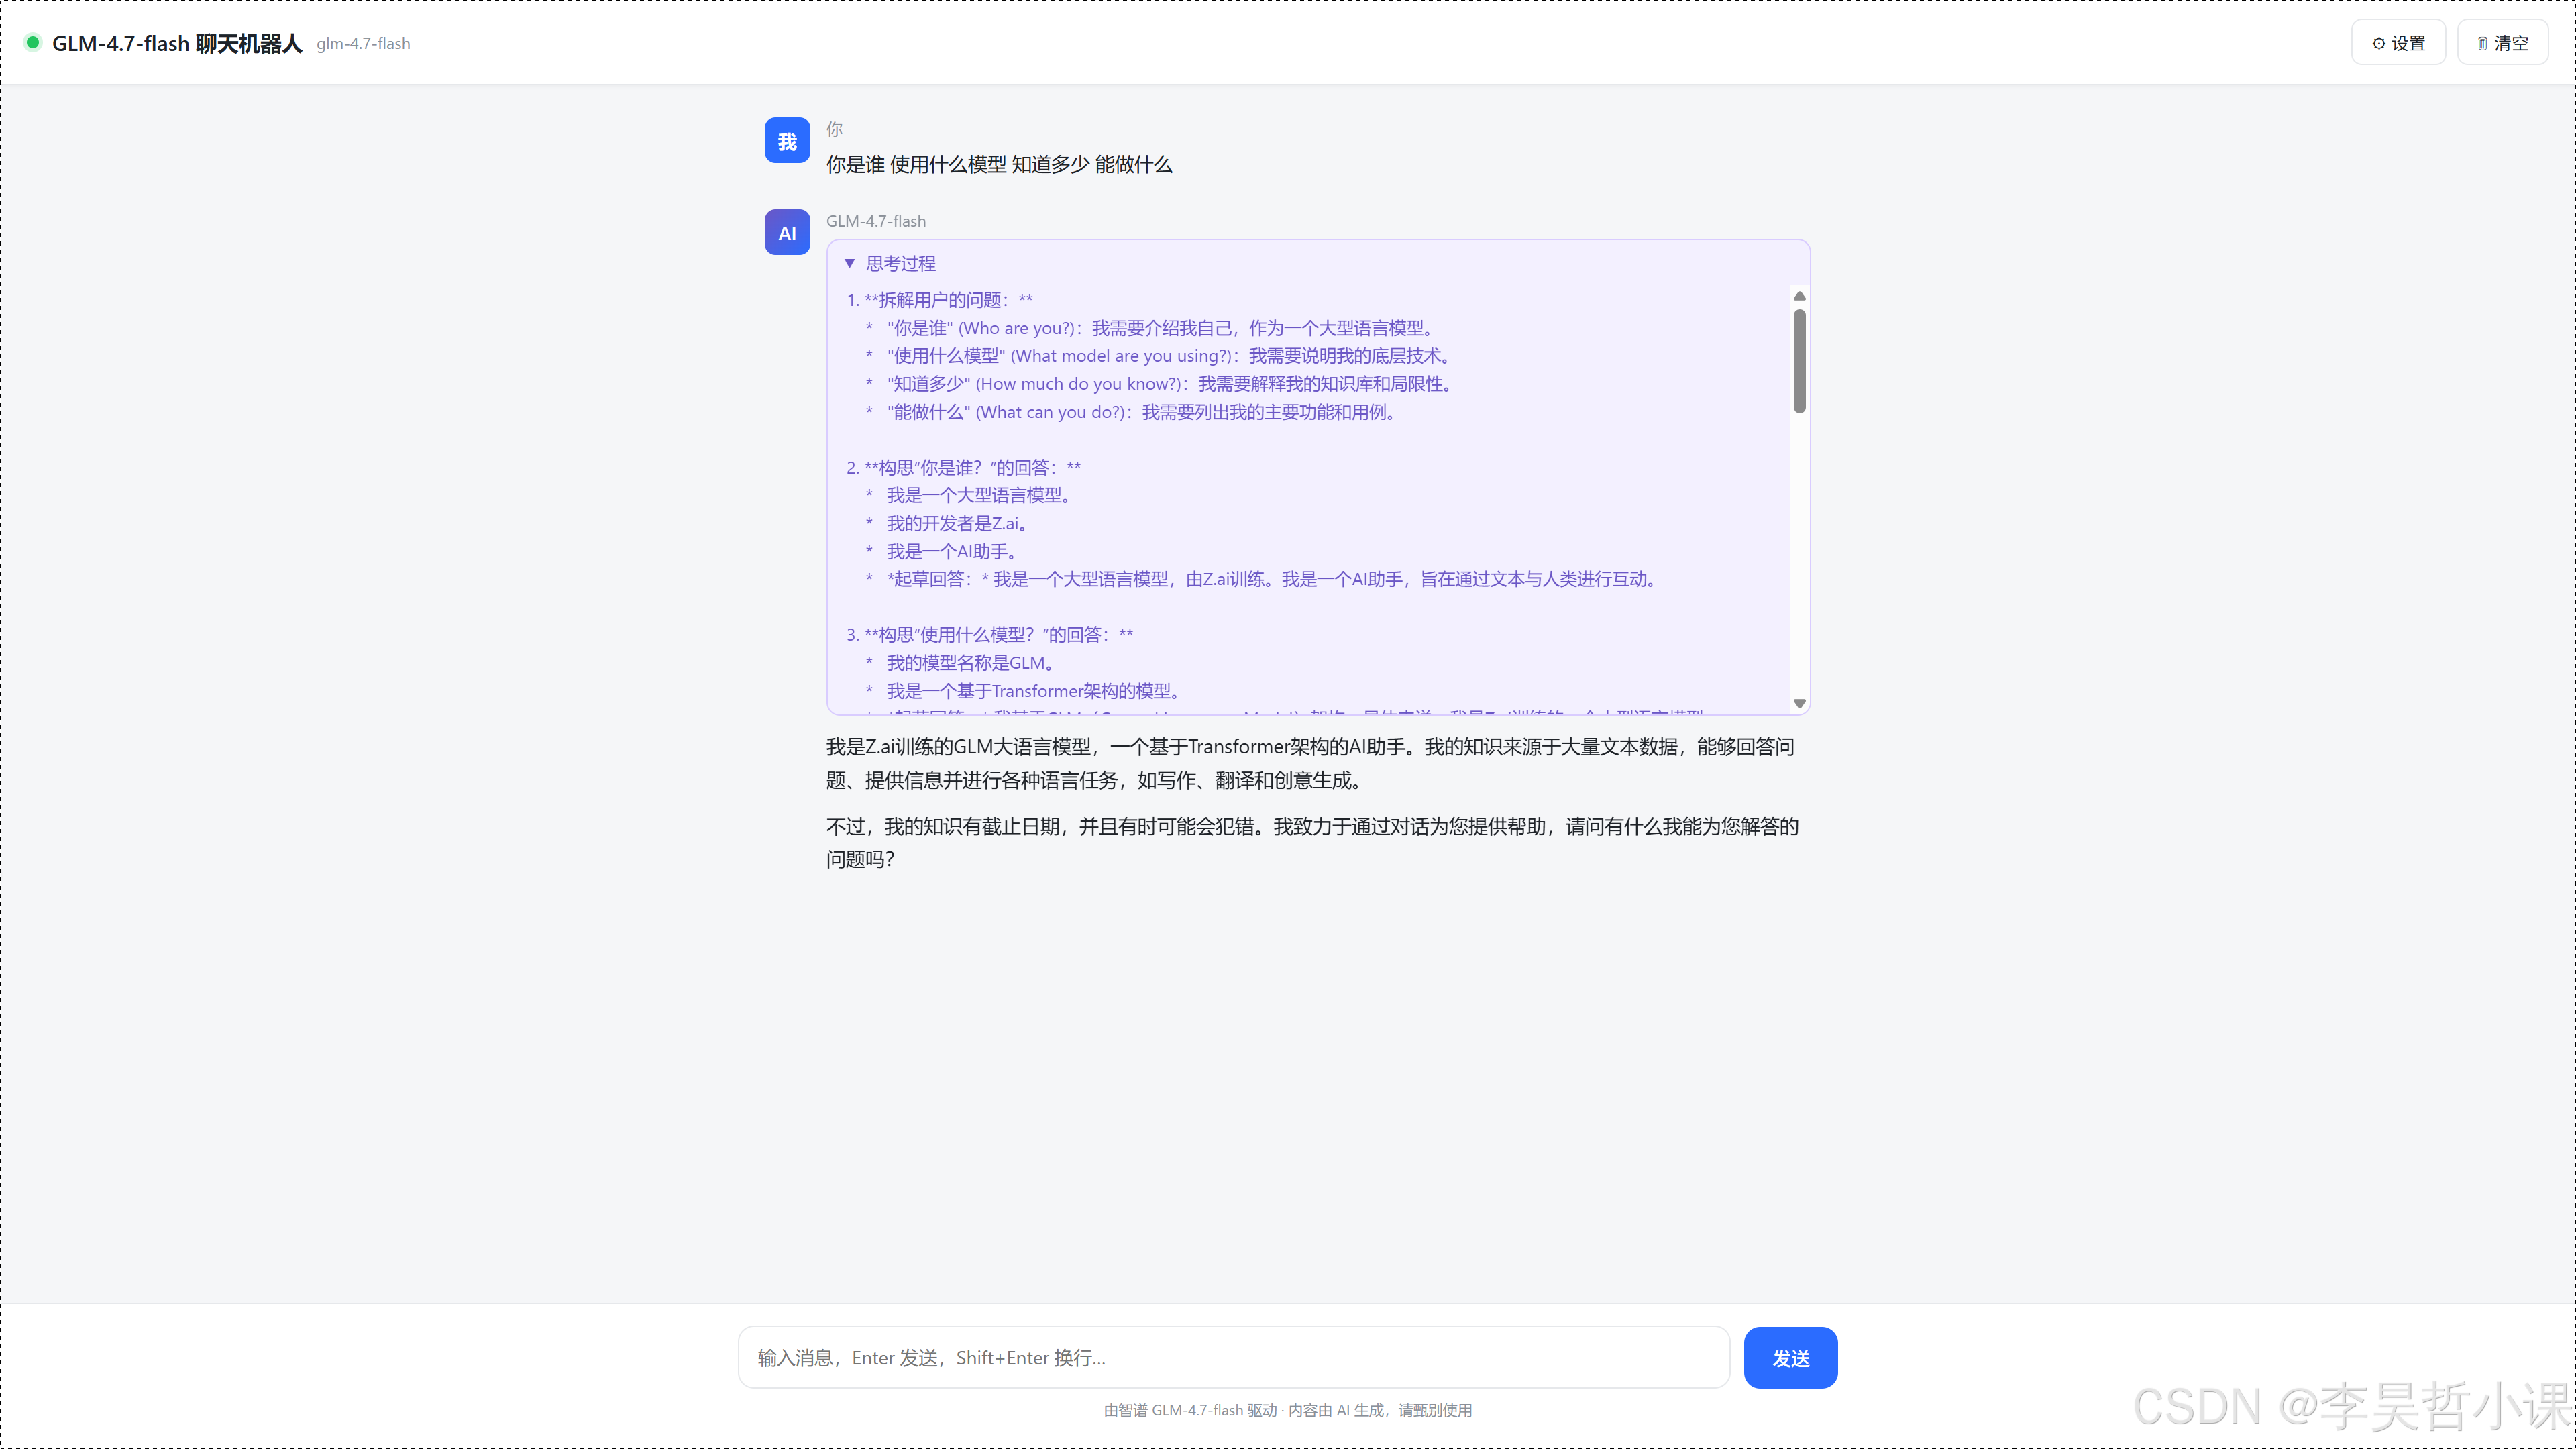
运行效果
一、本课学习目标
完成本课后,你应当能够:
- 理解 SSE(Server-Sent Events) 流式输出的工作原理。
- 使用 FastAPI 的
StreamingResponse返回流式数据。 - 调用智谱
glm-4.7-flash模型的流式接口,处理reasoning_content(思考过程)与content(正文)。 - 在前端用
fetch+ReadableStream读取 SSE 流并实时渲染。 - 实现一个可多轮对话、可中断、可配置温度的聊天页面。
二、核心概念预热
2.1 什么是 SSE(Server-Sent Events)
SSE 是一种「服务器向浏览器单向推送」的协议。它的数据帧格式非常简单:
data: {"type":"answer_delta","content":"你"}\n\n
data: {"type":"answer_delta","content":"好"}\n\n
每条消息以 data: 开头,以 \n\n(两个换行)结尾。浏览器收到一段字节流后,按 \n\n 切分就能拿到一帧。
为什么用 SSE 而不是 WebSocket?
- SSE 是单向的(服务端→客户端),刚好符合「AI 边生成边吐字」的场景。
- SSE 走普通 HTTP,无需额外协议升级,FastAPI 的
StreamingResponse直接支持。 - 前端用
fetch+ReadableStream即可读取,无需引入 WebSocket 库。
2.2 什么是「深度思考」(reasoning_content)
glm-4.7-flash 是一个「常开思考」模型。它的流式响应中,每个 chunk 的 delta 对象可能包含两个字段:
reasoning_content:思考过程。模型在给出答案前,先输出一段「我是怎么想的」。content:正文回答。思考结束后,才输出真正的答案。
时序如下:
chunk 1: delta.reasoning_content = "用户问1+1,这是一个加法..."
chunk 2: delta.reasoning_content = "所以结果是2"
chunk 3: delta.content = "1+1=2"   ← 思考结束,开始正文
chunk 4: finish_reason = "stop"    ← 结束
我们的后端要把这两种内容分别打包成不同类型的 SSE 帧发给前端,前端再分别渲染到「思考区」和「回答区」。
2.3 为什么后端用「同步生成器」却能在 FastAPI 里流式返回
FastAPI 的 StreamingResponse 接受一个生成器(generator)。如果你传的是同步生成器(普通 yield,不是 async yield),Starlette 会自动把它放到线程池里迭代,不会阻塞事件循环。
而 zai SDK 的 client.chat.completions.create(stream=True) 返回的是同步迭代器(只有 __iter__/__next__),所以正好用同步生成器包裹即可,无需写 async。
三、后端实现:src/01_chat_bot.py
3.1 设计蓝图
POST /chat  ← 前端发来对话历史,后端以 SSE 流返回
GET  /      ← 返回聊天 HTML 页面
GET  /health← 健康检查
SSE 帧类型约定(前后端必须一致):
| type | 含义 | 附加字段 |
|---|---|---|
start | 会话开始 | model, thinking |
thinking_start | 思考区开始 | — |
thinking_delta | 思考增量 | content |
thinking_end | 思考区结束 | — |
answer_start | 回答区开始 | — |
answer_delta | 回答增量 | content |
usage | token 用量 | usage{prompt,completion,total} |
finish | 生成完成 | reason |
error | 出错 | message |
done | 全部结束 | — |
3.2 完整代码
在 src/01_chat_bot.py 写入以下代码(与原始项目完全一致):
"""GLM-4.7-flash 聊天机器人(FastAPI + SSE 流式)

参考:https://docs.bigmodel.cn/cn/guide/models/free/glm-4.7-flash
模型 glm-4.7-flash 为智谱免费模型,支持"深度思考"(reasoning_content)。

运行:
    uv run python src/zhipi/01_chat_bot.py
然后浏览器打开 http://127.0.0.1:8000
"""

import asyncio  # 用于运行异步事件循环(uvicorn.serve)
import json  # 用于 SSE 帧的 JSON 序列化
import os  # 用于读取环境变量
from pathlib import Path  # 用于跨平台路径拼接,定位 .env 与 templates
from typing import Any  # 用于类型注解 dict[str, Any]

import uvicorn  # ASGI 服务器,用于承载 FastAPI 应用
from dotenv import load_dotenv  # 从 .env 文件加载环境变量到 os.environ
from fastapi import FastAPI  # Web 框架主体
from fastapi.middleware.cors import CORSMiddleware  # 跨域中间件,允许前端 file:// 访问
from fastapi.responses import HTMLResponse, StreamingResponse  # HTML 响应与 SSE 流式响应
from pydantic import BaseModel, Field  # 请求体校验与字段约束
from zai import ZhipuAiClient  # 智谱 AI 官方 SDK 客户端

# 读取项目根目录的 .env(含 ZAI_API_KEY / ZAI_MODEL)
# Path(__file__) = src/01_chat_bot.py,向上两级到项目根
load_dotenv(Path(__file__).resolve().parents[1] / ".env")

# 环境变量;若未配置则回退到 01_chat.py 中演示用的 Key,保证开箱即用
API_KEY = os.getenv("ZAI_API_KEY")  # 智谱 API 密钥(Bearer 鉴权)
MODEL = os.getenv("ZAI_MODEL") or "glm-4.7-flash"  # 默认使用 glm-4.7-flash 免费模型

# 构造智谱客户端(Bearer 直接鉴权,禁用 JWT 缓存)
client = ZhipuAiClient(api_key=API_KEY, disable_token_cache=True)

app = FastAPI(title="GLM-4.7-flash Chatbot")  # 创建 FastAPI 应用实例

# 允许跨域:使独立的 HTML 文件也可通过 file:// 直接打开并连接本服务
app.add_middleware(
    CORSMiddleware,  # 添加 CORS 中间件
    allow_origins=["*"],  # 允许任意来源
    allow_methods=["*"],  # 允许任意 HTTP 方法
    allow_headers=["*"],  # 允许任意请求头
)


# ========== 请求模型 ==========
class ChatMessage(BaseModel):  # 单条聊天消息
    role: str  # 角色:system / user / assistant
    content: str  # 消息文本内容


class ChatRequest(BaseModel):  # 聊天请求体
    messages: list[ChatMessage]  # 对话历史列表
    thinking: bool = True  # 是否开启深度思考
    temperature: float | None = Field(default=0.7, ge=0.0, le=1.0)  # 采样温度,0~1
    max_tokens: int | None = Field(default=4096, ge=1, le=65535)  # 最大生成 token 数
    model: str | None = None  # 可覆盖默认模型


def sse(payload: dict[str, Any]) -> str:
    """构造一条 SSE 数据帧:data: <json>\\n\\n

    内容经 json.dumps 转义,天然处理换行,保证每帧为单行物理数据。
    """
    return f"data: {json.dumps(payload, ensure_ascii=False)}\n\n"  # SSE 格式:data: + JSON + 两个换行


def chat_stream(req: ChatRequest):
    """同步生成器:调用智谱流式接口,逐 token 产出 SSE 帧。

    Starlette 的 StreamingResponse 会把同步生成器自动放到线程池中迭代,
    因此可直接使用 zai SDK 的同步 StreamResponse(仅有 __iter__/__next__)。
    """
    model = req.model or MODEL  # 请求未指定模型时回退到全局默认
    # Pydantic 模型 -> 原始 dict,交给 SDK
    messages = [{"role": m.role, "content": m.content} for m in req.messages]

    kwargs: dict[str, Any] = dict(  # 组装 SDK 调用参数
        model=model,  # 模型名
        messages=messages,  # 对话消息
        stream=True,  # 启用流式返回
        temperature=req.temperature,  # 采样温度
        max_tokens=req.max_tokens,  # 最大 token
    )
    # 深度思考:开启时显式传 enabled。
    # 说明:glm-4.7-flash 为"常开思考"模型,即便传 disabled 通常仍会输出
    # reasoning_content,服务端已兼容处理(前端默认展示思考过程,可折叠)。
    if req.thinking:
        kwargs["thinking"] = {"type": "enabled"}  # 显式开启深度思考

    # 起始信号:前端可据此渲染"思考中"
    yield sse({"type": "start", "model": model, "thinking": req.thinking})  # 发送起始帧

    try:
        response = client.chat.completions.create(**kwargs)  # 发起流式请求,返回迭代器
        thinking_started = False  # 标记是否已发送 thinking_start(避免重复)
        answer_started = False  # 标记是否已发送 answer_start(避免重复)
        for chunk in response:  # 逐 chunk 迭代流式响应
            # 兼容空 choices(部分心跳/结束帧)
            if not chunk.choices:
                # 可能附带 usage 的最后一帧
                if chunk.usage:  # 若包含用量信息
                    yield sse({
                        "type": "usage",  # 帧类型:用量
                        "usage": {
                            "prompt_tokens": chunk.usage.prompt_tokens,  # 输入 token 数
                            "completion_tokens": chunk.usage.completion_tokens,  # 输出 token 数
                            "total_tokens": chunk.usage.total_tokens,  # 总 token 数
                        },
                    })
                continue  # 跳过空 choices 帧

            delta = chunk.choices[0].delta  # 增量内容对象
            finish_reason = chunk.choices[0].finish_reason  # 结束原因(stop/length 等)

            # 深度思考内容(reasoning_content):先于正文输出
            rc = getattr(delta, "reasoning_content", None)  # 安全获取思考内容
            if rc:  # 存在思考内容
                if not thinking_started:  # 首次出现思考内容
                    thinking_started = True  # 标记已开始
                    yield sse({"type": "thinking_start"})  # 通知前端开始思考区
                yield sse({"type": "thinking_delta", "content": rc})  # 推送思考增量

            # 正文内容
            c = getattr(delta, "content", None)  # 安全获取正文内容
            if c:  # 存在正文内容
                if thinking_started:  # 若此前在思考区
                    # 首次出现正文,关闭思考区
                    thinking_started = False  # 标记已切换(thinking_end 仅发一次)
                    yield sse({"type": "thinking_end"})  # 通知前端思考结束
                if not answer_started:  # 首次出现正文
                    answer_started = True  # 标记已开始
                    yield sse({"type": "answer_start"})  # 通知前端开始回答区
                yield sse({"type": "answer_delta", "content": c})  # 推送正文增量

            # 结束
            if finish_reason:  # 收到结束信号
                if thinking_started:  # 若思考区未关闭
                    yield sse({"type": "thinking_end"})  # 补发关闭
                if not answer_started:  # 若回答区未开启(极端情况)
                    yield sse({"type": "answer_start"})  # 补发开启
                if chunk.usage:  # 结束帧可能附带用量
                    yield sse({
                        "type": "usage",  # 帧类型:用量
                        "usage": {
                            "prompt_tokens": chunk.usage.prompt_tokens,  # 输入 token 数
                            "completion_tokens": chunk.usage.completion_tokens,  # 输出 token 数
                            "total_tokens": chunk.usage.total_tokens,  # 总 token 数
                        },
                    })
                yield sse({"type": "finish", "reason": finish_reason})  # 通知前端完成
                break  # 跳出迭代
    except Exception as e:  # noqa: BLE001 - 统一错误返回给前端
        yield sse({"type": "error", "message": f"{type(e).__name__}: {e}"})  # 推送错误帧
        return  # 终止生成器

    # 正常结束
    yield sse({"type": "done"})  # 通知前端全部结束


@app.post("/chat")  # POST /chat 接口
async def chat(req: ChatRequest):
    """聊天接口:以 SSE 流式返回思考过程与回答。"""
    # 必须有最后一条用户消息
    if not req.messages or req.messages[-1].role != "user":  # 校验末尾消息为 user
        # 直接返回错误帧(非流式)
        def err():  # 内联错误生成器
            yield sse({"type": "error", "message": "messages 末尾需为 user 消息"})  # 错误帧
            yield sse({"type": "done"})  # 结束帧
        return StreamingResponse(err(), media_type="text/event-stream")  # 返回错误流

    return StreamingResponse(chat_stream(req), media_type="text/event-stream")  # 返回 SSE 流


@app.get("/")  # GET / 首页
async def index():
    """首页:返回独立 HTML 聊天页面。"""
    html_path = Path(__file__).resolve().parents[1] / "templates" / "chat.html"  # 定位模板
    return HTMLResponse(html_path.read_text(encoding="utf-8"))  # 返回 HTML 内容


@app.get("/health")  # GET /health 健康检查
async def health():
    return {"status": "ok", "model": MODEL}  # 返回状态与当前模型名


# ========== 入口 ==========
if __name__ == "__main__":  # 直接运行本文件时
    config = uvicorn.Config(app, host="127.0.0.1", port=8001)  # 配置 uvicorn(本地 8001)
    server = uvicorn.Server(config)  # 创建服务器实例
    asyncio.run(server.serve())  # 启动事件循环并运行
3.3 代码逐段讲解
(1)加载配置
load_dotenv(Path(__file__).resolve().parents[1] / ".env")
API_KEY = os.getenv("ZAI_API_KEY")
MODEL = os.getenv("ZAI_MODEL") or "glm-4.7-flash"
client = ZhipuAiClient(api_key=API_KEY, disable_token_cache=True)
Path(__file__).resolve().parents[1]:当前文件src/01_chat_bot.py,parents[0]是src/,parents[1]是项目根。这样无论你在哪里运行都能找到.env。disable_token_cache=True:zai SDK 默认会缓存 JWT token,这里禁用,避免本地调试时旧 token 干扰。
(2)请求模型
class ChatMessage(BaseModel):
    role: str
    content: str

class ChatRequest(BaseModel):
    messages: list[ChatMessage]
    thinking: bool = True
    temperature: float | None = Field(default=0.7, ge=0.0, le=1.0)
    max_tokens: int | None = Field(default=4096, ge=1, le=65535)
    model: str | None = None
Pydantic 会自动校验前端发来的 JSON:
temperature必须在 0~1 之间,否则返回 422。messages必须是列表,每项有role和content。model可不传,不传则用全局MODEL。
(3)SSE 帧构造函数
def sse(payload: dict[str, Any]) -> str:
    return f"data: {json.dumps(payload, ensure_ascii=False)}\n\n"
ensure_ascii=False:让中文直接输出,不转成\uXXXX,便于调试观察。- 每帧以
\n\n结尾,这是 SSE 规范。
(4)流式生成器 chat_stream
这是后端的核心。关键点:
a. 先发 start 帧:让前端知道开始了、用哪个模型。
b. 用两个布尔标记管理状态:
thinking_started = False  # 是否已发过 thinking_start
answer_started = False    # 是否已发过 answer_start
为什么需要?因为一个 chunk 里可能同时有 reasoning_content 和 content,也可能只有其中一个。我们要保证 thinking_start / answer_start 各只发一次。
c. 思考→正文的切换:
if c:  # 出现正文
    if thinking_started:  # 之前在思考区
        thinking_started = False
        yield sse({"type": "thinking_end"})  # 关闭思考区
    if not answer_started:
        answer_started = True
        yield sse({"type": "answer_start"})  # 开启回答区
    yield sse({"type": "answer_delta", "content": c})
d. 结束处理:收到 finish_reason 时,补发可能缺失的 thinking_end / answer_start,再发 finish 帧并 break。这保证了前端状态机不会卡住。
e. 异常处理:任何异常都打包成 error 帧发给前端,而不是让 HTTP 连接直接挂掉。
(5)路由
@app.post("/chat")
async def chat(req: ChatRequest):
    ...
    return StreamingResponse(chat_stream(req), media_type="text/event-stream")
media_type="text/event-stream"是 SSE 的标准 MIME 类型,浏览器和 curl 都能识别。- 注意
chat函数是async def,但传入的chat_stream是同步生成器——这正是 2.3 节讲的「Starlette 自动放线程池」。
(6)首页路由
@app.get("/")
async def index():
    html_path = Path(__file__).resolve().parents[1] / "templates" / "chat.html"
    return HTMLResponse(html_path.read_text(encoding="utf-8"))
直接读 templates/chat.html 文件内容返回。这样前端页面和后端同源,避免跨域问题。
四、前端实现:templates/chat.html
4.1 设计思路
前端要实现:
- 多轮对话(维护
history数组)。 - 发送消息后,用
fetchPOST 到/chat,读取 SSE 流。 - 根据
type分发渲染:思考区(可折叠)+ 回答区(Markdown 渲染)。 - 支持「停止」(AbortController)、「清空」、「设置」(系统提示词、温度、token 数)。
- 一个极简的 Markdown 渲染器(防 XSS)。
4.2 完整代码
在 templates/chat.html 写入以下代码(与原始项目完全一致):
篇幅原因 省略前端代码
4.3 前端关键讲解
(1)SSE 读取核心循环
const reader = resp.body.getReader();
const decoder = new TextDecoder('utf-8');
let buffer = '';
while (true) {
    const { value, done } = await reader.read();
    if (done) break;
    buffer += decoder.decode(value, { stream: true });
    let idx;
    while ((idx = buffer.indexOf('\n\n')) !== -1) {
        const raw = buffer.slice(0, idx);
        buffer = buffer.slice(idx + 2);
        handleFrame(raw, frame, ...);
    }
}
reader.read()每次返回一段Uint8Array,可能是半句话、一句话、甚至半个 SSE 帧。- 用
buffer累积,按\n\n切分出完整帧再处理,避免「帧被拆分」的 bug。 { stream: true }告诉解码器「数据还没完」,避免末尾多字节字符被截断。
(2)多轮历史的维护
history.push({ role: 'user', content: text });
history.push({ role: 'assistant', content: answerText });
每次成功对话后,把 user 和 assistant 消息都存入 history。下次发送时,把 history 整体回传给后端,模型就有了上下文。注意:系统提示词不存入 history,每次发送时临时拼接。
(3)流式期间用纯文本,结束后才 Markdown 渲染
// 流式中
content.textContent = st.answer;  // 纯文本

// 流式结束
content.innerHTML = renderMarkdown(answerText);  // 整体渲染
为什么?因为流式过程中 Markdown 是不完整的(比如 ```代码块还没闭合),实时渲染会错乱。等全部到齐后再一次性渲染,保证格式正确。
(4)停止功能
controller = new AbortController();
fetch(..., { signal: controller.signal });
// 点击停止:
controller.abort();
AbortController 是浏览器原生 API,abort() 会让 fetch 立即中断,触发 AbortError。我们在 catch 里把已收到的部分渲染出来,并追加「(已停止)」提示。
(5)防 XSS
- 用户消息:用
textContent赋值,不解析 HTML。 - AI 消息:流式期间用
textContent;结束后用renderMarkdown,该函数会先转义 HTML 再还原 Markdown 标记,确保不会注入<script>。
五、运行与验证
5.1 启动后端
uv run python src/01_chat_bot.py
看到类似输出说明启动成功:
INFO: Uvicorn running on http://127.0.0.1:8001 (Press CTRL+C to quit)
5.2 打开页面
浏览器访问 http://127.0.0.1:8001
5.3 验证清单
请逐项确认:
- 页面正常打开,顶部显示「glm-4.7-flash」。
- 输入「你好」回车,AI 逐步吐字回答。
- 回答上方出现紫色「思考过程」区域,可点击折叠/展开。
- 回答结束后,回答区出现「tokens:输入 X · 输出 Y · 合计 Z」。
- 点击「⚙ 设置」打开抽屉,修改温度为 0.2,再次提问,回答更稳定。
- 在设置里填系统提示词「你是一名诗人,只用古诗回答」,再提问验证生效。
- 回答过程中点击「停止」,回答中断并显示「(已停止)」。
- 连续多轮对话,AI 能记住上下文(如「我刚才说了什么?」)。
- 点击「🗑 清空」后历史重置。
- 健康检查:浏览器访问 http://127.0.0.1:8001/health 返回
{"status":"ok","model":"glm-4.7-flash"}。
5.4 用 curl 观察原始 SSE 流
新开一个终端:
curl -N -X POST http://127.0.0.1:8001/chat -H "Content-Type: application/json" -d "{\"messages\":[{\"role\":\"user\",\"content\":\"1+1\"}],\"thinking\":false}"
你会看到一帧帧 data: {...} 滚动输出,这就是 SSE 的真面目。
六、常见问题
Q1:启动报错 ModuleNotFoundError: No module named 'zai'
A:说明依赖没装好。在项目根目录重新执行 uv sync。
Q2:页面打开后发送消息一直转圈,没有回答
A:检查 .env 中的 ZAI_API_KEY 是否正确。看后端终端有无报错。
Q3:回答出现了但思考过程不显示
A:检查设置抽屉里的「深度思考」开关是否勾选。本课前端用这个开关控制是否展示思考,但始终向后端请求思考内容。
Q4:多轮对话后 AI 忘了前面说的
A:确认 history 是否正确累加。可以在浏览器 F12 控制台输入 history 查看(若没被局部作用域遮挡)。
Q5:端口被占用
A:修改 01_chat_bot.py 最后的 port=8001 为其他端口,同时修改前端 endpoint。
七、本课小结
你已经掌握了项目的核心骨架:
- 后端:FastAPI +
StreamingResponse+ 同步生成器 +zaiSDK 流式调用。 - SSE 帧协议:
start / thinking_* / answer_* / usage / finish / error / done。 - 前端:
fetch+ReadableStream读取 SSE,按\n\n分帧,switch(type)分发渲染。 - 状态机:用两个布尔变量管理「思考区」和「回答区」的开关。
下一课,我们在这个骨架上增加「图片输入」能力 → 第 2 课:视觉聊天机器人。
第 2 课:视觉聊天机器人(图片理解)
本课在第 1 课的骨架上增加「图片输入」能力。模型换成
glm-4.6v-flash,它能同时理解文字和图片。
你将学会多模态消息的构造、前端图片上传(粘贴/拖拽/选择)、以及 base64 data URL 的使用。
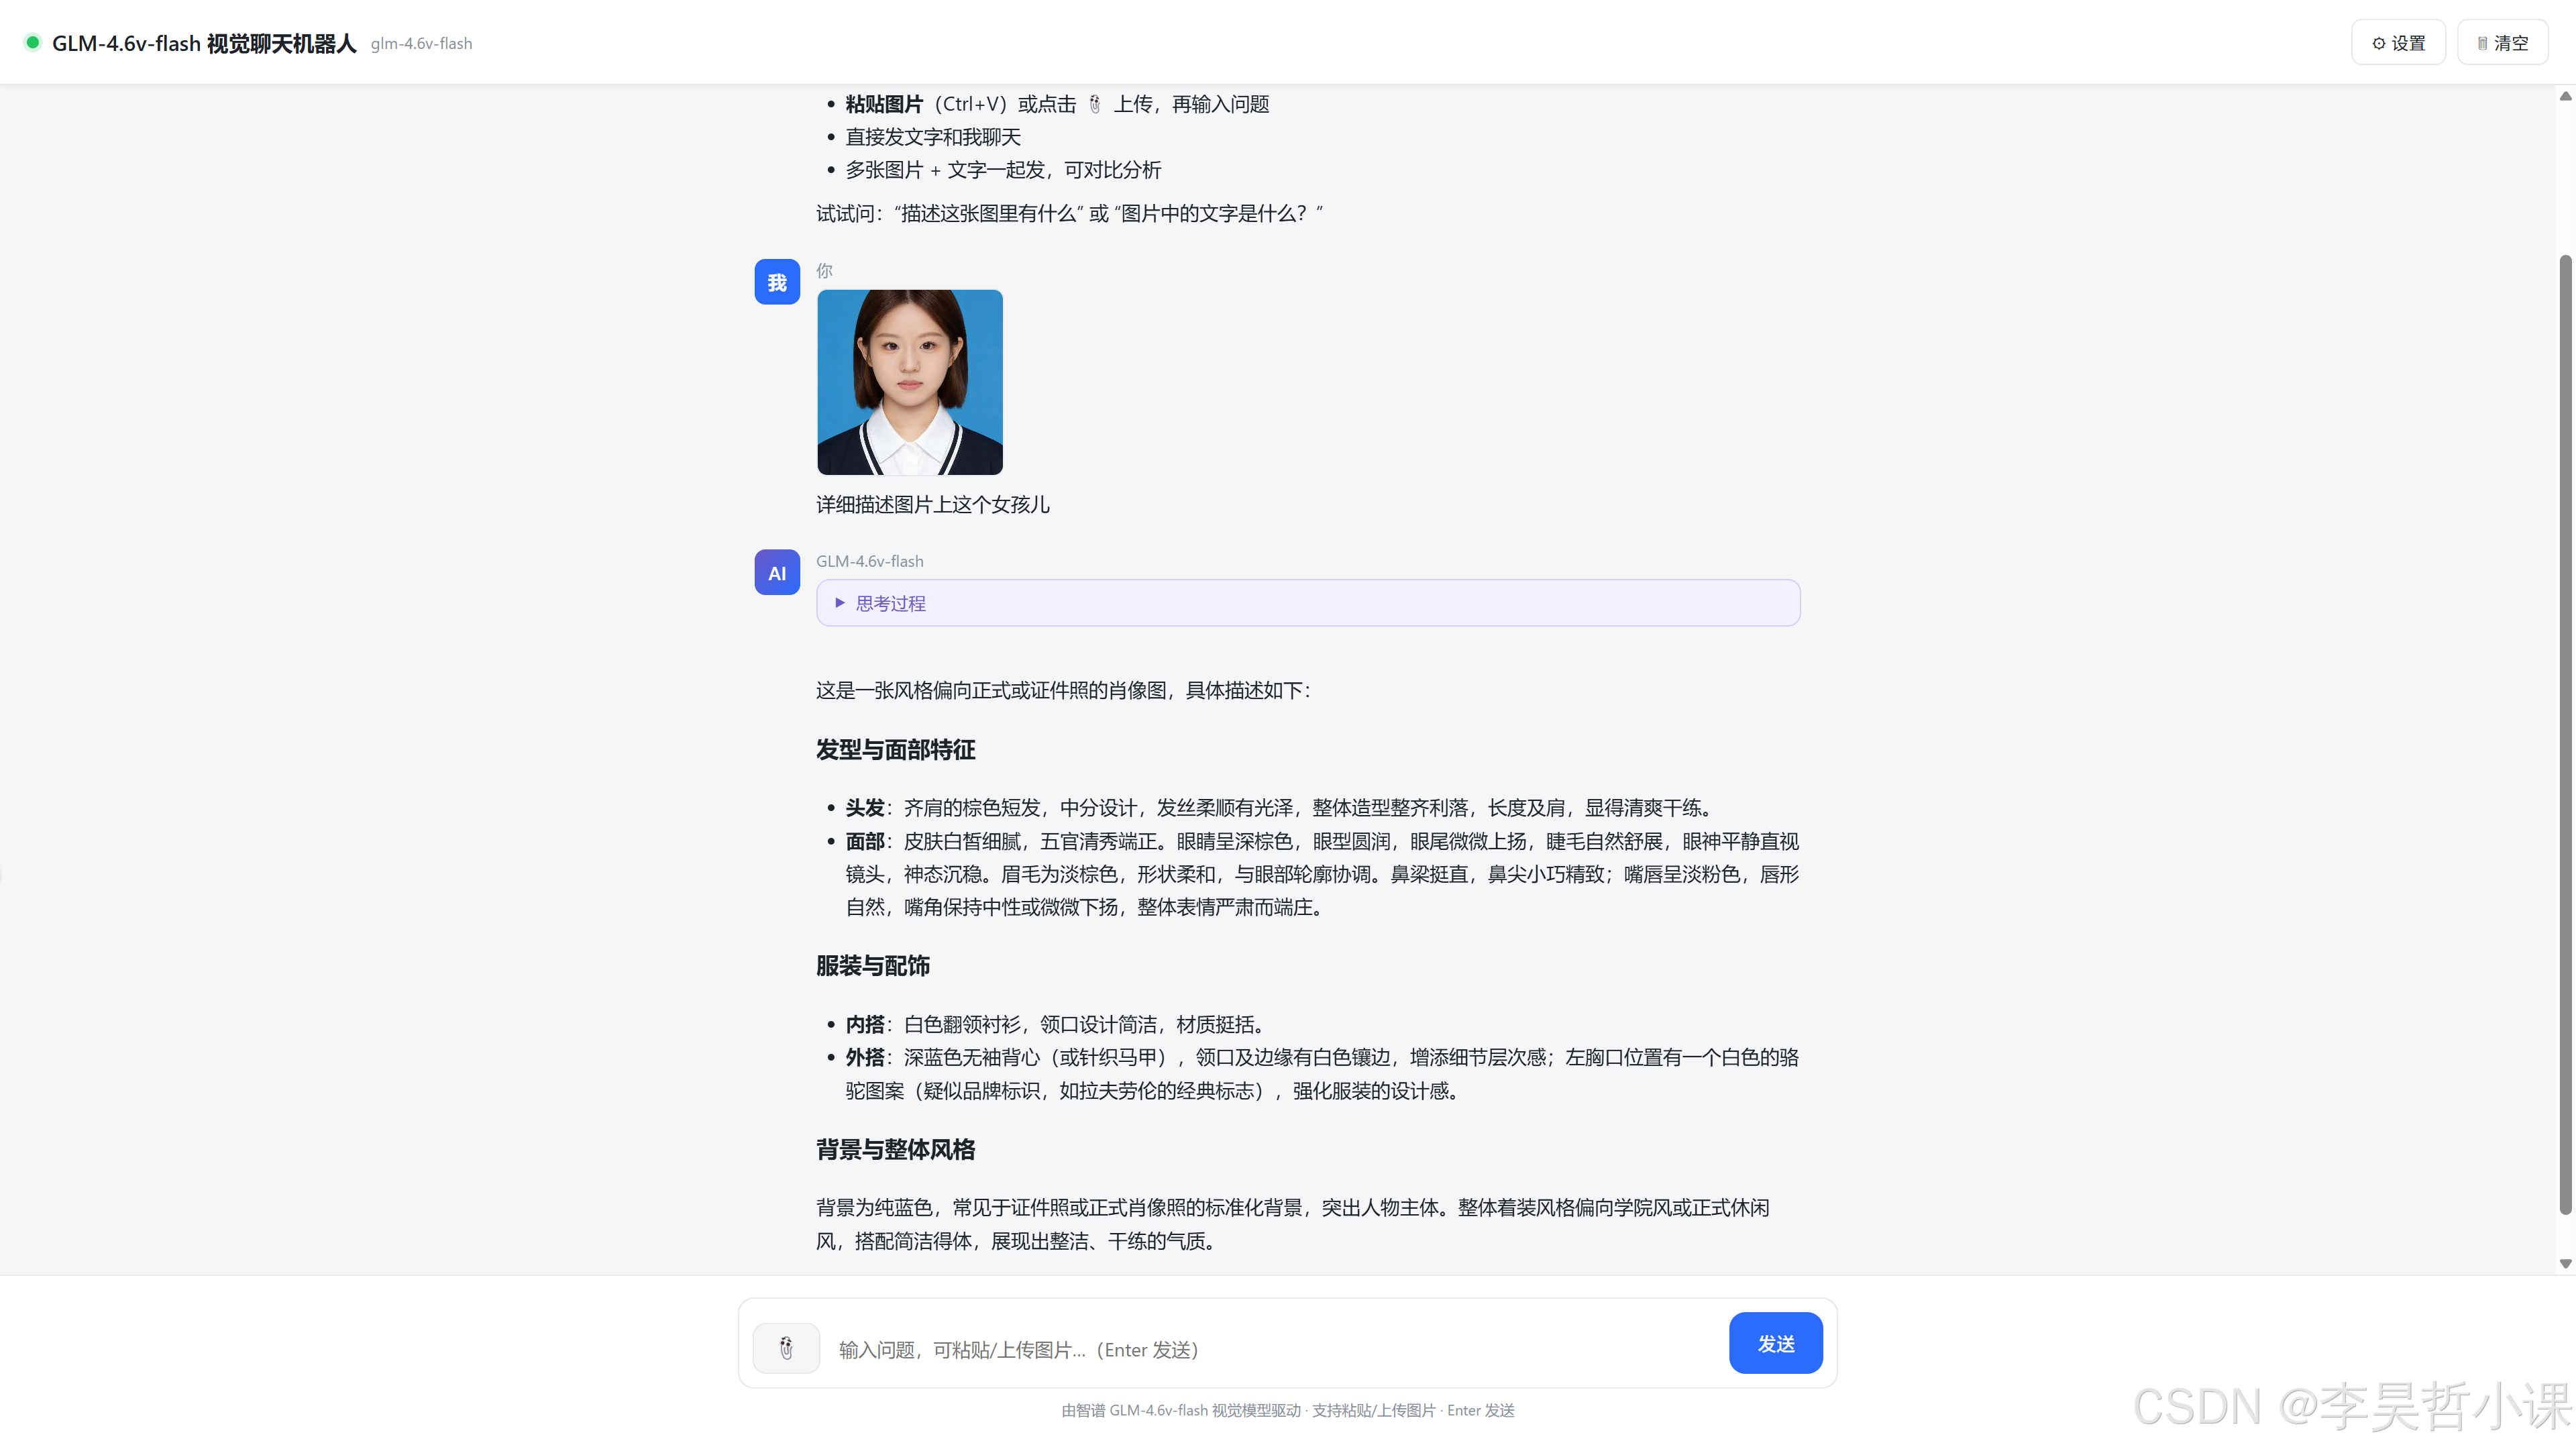
运行效果
一、本课学习目标
- 理解「多模态消息」的 OpenAI 风格格式:
content既可以是字符串,也可以是片段列表。 - 在前端用
FileReader把图片转成 base64 data URL。 - 实现粘贴(Ctrl+V)、拖拽、点击三种上传方式。
- 复用第 1 课的 SSE 流式框架,只是消息结构不同。
二、核心概念
2.1 多模态消息格式
第 1 课里,content 是字符串:
{"role": "user", "content": "你好"}
本课里,带图片的 content 变成片段列表:
{
  "role": "user",
  "content": [
    {"type": "text", "text": "描述这张图"},
    {"type": "image_url", "image_url": {"url": "data:image/jpeg;base64,<BASE64>"}}
  ]
}
type: "text":文本片段。type: "image_url":图片片段,url既支持 http(s) 链接,也支持data:image/...;base64,...。
zai SDK 内部会自动剥离 data:image/...;base64, 前缀,所以前端直接传完整 data URL 即可。
2.2 base64 data URL 是什么
把图片二进制数据用 base64 编码成文本,再拼上 MIME 前缀,就能像 URL 一样放在 <img src> 或 JSON 里传输:
data:image/png;base64,iVBORw0KGgoAAAANSUhEUg...
优点:无需文件存储,单次请求即可带图。缺点:体积比原图大约 33%。本课限制单图 5MB 以内。
2.3 与第 1 课的差异点
| 方面 | 第 1 课 | 第 2 课 |
|---|---|---|
| 模型 | glm-4.7-flash | glm-4.6v-flash |
请求 content | 仅字符串 | 字符串 或 片段列表 |
| 前端上传 | 无 | 粘贴/拖拽/点击 |
| 端口 | 8001 | 8002 |
| 流式逻辑 | 完全相同 | 完全相同 |
后端只有「请求模型」和「消息转换函数」两处变化,其余几乎照搬第 1 课。
三、后端实现:src/02_chat_bot_vision.py
3.1 完整代码
在 src/02_chat_bot_vision.py 写入以下代码(与原始项目完全一致):
"""GLM-4.6v-flash 视觉聊天机器人(FastAPI + SSE 流式)

参考:https://docs.bigmodel.cn/cn/guide/models/free/glm-4.6v-flash
glm-4.6v-flash 为智谱免费"视觉/多模态"模型,支持图像输入(image_url)+ 文本,
同时具备深度思考能力(reasoning_content)。

图像传入格式(OpenAI 风格 multipart content):
    messages = [
      {
        "role": "user",
        "content": [
            {"type": "text",  "text": "描述这张图"},
            {"type": "image_url", "image_url": {"url": "data:image/jpeg;base64,<BASE64>"}}
        ]
      }
    ]
SDK 内部会自动剥离 "data:image/...;base64," 前缀,因此这里直接传完整 data URL 即可。
同时也支持纯文本对话。

运行:
    uv run python src/zhipi/02_chat_bot_vision.py
然后浏览器打开 http://127.0.0.1:8000
"""

import asyncio  # 用于运行异步事件循环(uvicorn.serve)
import json  # 用于 SSE 帧的 JSON 序列化
import os  # 用于读取环境变量
from pathlib import Path  # 用于跨平台路径拼接,定位 .env 与 templates
from typing import Any  # 用于类型注解 dict[str, Any]

import uvicorn  # ASGI 服务器,用于承载 FastAPI 应用
from dotenv import load_dotenv  # 从 .env 文件加载环境变量到 os.environ
from fastapi import FastAPI  # Web 框架主体
from fastapi.middleware.cors import CORSMiddleware  # 跨域中间件,允许前端 file:// 访问
from fastapi.responses import HTMLResponse, StreamingResponse  # HTML 响应与 SSE 流式响应
from pydantic import BaseModel, Field  # 请求体校验与字段约束
from zai import ZhipuAiClient  # 智谱 AI 官方 SDK 客户端

# 读取项目根目录的 .env(含 ZAI_API_KEY / ZAI_VISION_MODEL)
# Path(__file__) = src/02_chat_bot_vision.py,向上两级到项目根
load_dotenv(Path(__file__).resolve().parents[1] / ".env")

API_KEY = os.getenv("ZAI_API_KEY")  # 智谱 API 密钥(Bearer 鉴权)
MODEL = os.getenv("ZAI_VISION_MODEL") or "glm-4.6v-flash"  # 默认视觉模型

client = ZhipuAiClient(api_key=API_KEY, disable_token_cache=True)  # 构造智谱客户端,禁用 JWT 缓存

app = FastAPI(title="GLM-4.6v-flash Vision Chatbot")  # 创建 FastAPI 应用实例

# 允许跨域:使独立 HTML 文件可通过 file:// 打开并连接本服务
app.add_middleware(
    CORSMiddleware,  # 添加 CORS 中间件
    allow_origins=["*"],  # 允许任意来源
    allow_methods=["*"],  # 允许任意 HTTP 方法
    allow_headers=["*"],  # 允许任意请求头
)


# ========== 请求模型 ==========
class ContentPart(BaseModel):  # 多模态消息内容片段
    """多模态消息内容片段:文本 / 图像。"""
    type: str  # "text" 或 "image_url"
    text: str | None = None  # 文本片段内容(type=text 时有效)
    image_url: dict[str, Any] | None = None  # {"url": "data:image/...;base64,..."}


class ChatMessage(BaseModel):  # 单条聊天消息
    role: str  # 角色:system / user / assistant
    # content 既可为纯文本字符串,也可为多模态片段列表
    content: str | list[ContentPart]  # 文本或多模态片段列表


class ChatRequest(BaseModel):  # 聊天请求体
    messages: list[ChatMessage]  # 对话历史列表
    thinking: bool = True  # 是否开启深度思考
    temperature: float | None = Field(default=0.7, ge=0.0, le=1.0)  # 采样温度,0~1
    max_tokens: int | None = Field(default=4096, ge=1, le=65535)  # 最大生成 token 数
    model: str | None = None  # 可覆盖默认模型


def sse(payload: dict[str, Any]) -> str:
    """构造一条 SSE 数据帧:data: <json>\\n\\n"""
    return f"data: {json.dumps(payload, ensure_ascii=False)}\n\n"  # SSE 格式:data: + JSON + 两个换行


def to_sdk_messages(req: ChatRequest) -> list[dict]:
    """把 Pydantic 消息转为 SDK 接受的原始结构。

    - content 为字符串:原样返回
    - content 为片段列表:每个片段转为 dict(去掉 None 字段)
    SDK 会在 create() 内部对含 image_url 的 content 调用 drop_prefix_image_data,
    剥离 "data:image/...;base64," 前缀,因此传入完整 data URL 即可。
    """
    out = []  # 输出消息列表
    for m in req.messages:  # 遍历每条消息
        if isinstance(m.content, str):  # 纯文本内容
            out.append({"role": m.role, "content": m.content})  # 原样返回
        else:  # 多模态片段列表
            parts = []  # 片段 dict 列表
            for p in m.content:  # 遍历每个片段
                if p.type == "text":  # 文本片段
                    parts.append({"type": "text", "text": p.text or ""})  # 组装文本片段
                elif p.type == "image_url":  # 图像片段
                    parts.append({
                        "type": "image_url",  # 片段类型
                        "image_url": p.image_url or {},  # 图像 URL 字典
                    })
            out.append({"role": m.role, "content": parts})  # 组装完整消息
    return out  # 返回转换后的列表


def chat_stream(req: ChatRequest):
    """同步生成器:调用智谱流式接口,逐 token 产出 SSE 帧。

    Starlette 的 StreamingResponse 会把同步生成器自动放入线程池迭代,
    因此可直接使用 zai SDK 的同步 StreamResponse。
    """
    model = req.model or MODEL  # 请求未指定模型时回退到全局默认
    messages = to_sdk_messages(req)  # 转换为 SDK 原始结构

    kwargs: dict[str, Any] = dict(  # 组装 SDK 调用参数
        model=model,  # 模型名
        messages=messages,  # 对话消息
        stream=True,  # 启用流式返回
        temperature=req.temperature,  # 采样温度
        max_tokens=req.max_tokens,  # 最大 token
    )
    # 深度思考:开启时显式传 enabled。
    # 说明:glm-4.6v-flash 同样为"常开思考"模型,前端默认展示可折叠思考过程。
    if req.thinking:
        kwargs["thinking"] = {"type": "enabled"}  # 显式开启深度思考

    yield sse({"type": "start", "model": model, "thinking": req.thinking})  # 发送起始帧

    try:
        response = client.chat.completions.create(**kwargs)  # 发起流式请求,返回迭代器
        thinking_started = False  # 标记是否已发送 thinking_start
        answer_started = False  # 标记是否已发送 answer_start
        for chunk in response:  # 逐 chunk 迭代流式响应
            if not chunk.choices:  # 兼容空 choices(心跳/结束帧)
                if chunk.usage:  # 若包含用量信息
                    yield sse({
                        "type": "usage",  # 帧类型:用量
                        "usage": {
                            "prompt_tokens": chunk.usage.prompt_tokens,  # 输入 token 数
                            "completion_tokens": chunk.usage.completion_tokens,  # 输出 token 数
                            "total_tokens": chunk.usage.total_tokens,  # 总 token 数
                        },
                    })
                continue  # 跳过空 choices 帧

            delta = chunk.choices[0].delta  # 增量内容对象
            finish_reason = chunk.choices[0].finish_reason  # 结束原因(stop/length 等)

            rc = getattr(delta, "reasoning_content", None)  # 安全获取思考内容
            if rc:  # 存在思考内容
                if not thinking_started:  # 首次出现思考内容
                    thinking_started = True  # 标记已开始
                    yield sse({"type": "thinking_start"})  # 通知前端开始思考区
                yield sse({"type": "thinking_delta", "content": rc})  # 推送思考增量

            c = getattr(delta, "content", None)  # 安全获取正文内容
            if c:  # 存在正文内容
                if thinking_started:  # 若此前在思考区
                    thinking_started = False  # 标记已切换
                    yield sse({"type": "thinking_end"})  # 通知前端思考结束
                if not answer_started:  # 首次出现正文
                    answer_started = True  # 标记已开始
                    yield sse({"type": "answer_start"})  # 通知前端开始回答区
                yield sse({"type": "answer_delta", "content": c})  # 推送正文增量

            if finish_reason:  # 收到结束信号
                if thinking_started:  # 若思考区未关闭
                    yield sse({"type": "thinking_end"})  # 补发关闭
                if not answer_started:  # 若回答区未开启
                    yield sse({"type": "answer_start"})  # 补发开启
                if chunk.usage:  # 结束帧可能附带用量
                    yield sse({
                        "type": "usage",  # 帧类型:用量
                        "usage": {
                            "prompt_tokens": chunk.usage.prompt_tokens,  # 输入 token 数
                            "completion_tokens": chunk.usage.completion_tokens,  # 输出 token 数
                            "total_tokens": chunk.usage.total_tokens,  # 总 token 数
                        },
                    })
                yield sse({"type": "finish", "reason": finish_reason})  # 通知前端完成
                break  # 跳出迭代
    except Exception as e:  # noqa: BLE001 - 统一错误返回前端
        yield sse({"type": "error", "message": f"{type(e).__name__}: {e}"})  # 推送错误帧
        return  # 终止生成器

    yield sse({"type": "done"})  # 通知前端全部结束


@app.post("/chat")  # POST /chat 接口
async def chat(req: ChatRequest):
    """视觉/文本聊天接口:以 SSE 流式返回思考过程与回答。"""
    if not req.messages or req.messages[-1].role != "user":  # 校验末尾消息为 user
        def err():  # 内联错误生成器
            yield sse({"type": "error", "message": "messages 末尾需为 user 消息"})  # 错误帧
            yield sse({"type": "done"})  # 结束帧
        return StreamingResponse(err(), media_type="text/event-stream")  # 返回错误流

    return StreamingResponse(chat_stream(req), media_type="text/event-stream")  # 返回 SSE 流


@app.get("/")  # GET / 首页
async def index():
    """首页:返回独立 HTML 视觉聊天页面。"""
    html_path = Path(__file__).resolve().parents[1] / "templates" / "chat_vision.html"  # 定位模板
    return HTMLResponse(html_path.read_text(encoding="utf-8"))  # 返回 HTML 内容


@app.get("/health")  # GET /health 健康检查
async def health():
    return {"status": "ok", "model": MODEL}  # 返回状态与当前模型名


# ========== 入口 ==========
if __name__ == "__main__":  # 直接运行本文件时
    config = uvicorn.Config(app, host="127.0.0.1", port=8002)  # 配置 uvicorn(本地 8002)
    server = uvicorn.Server(config)  # 创建服务器实例
    asyncio.run(server.serve())  # 启动事件循环并运行
3.2 与第 1 课的差异讲解
(1)新增 ContentPart 模型
class ContentPart(BaseModel):
    type: str  # "text" 或 "image_url"
    text: str | None = None
    image_url: dict[str, Any] | None = None
这定义了多模态片段。注意两个字段都允许 None,因为 text 片段没有 image_url,反之亦然。
(2)ChatMessage.content 改为联合类型
class ChatMessage(BaseModel):
    role: str
    content: str | list[ContentPart]  # 字符串 或 片段列表
Pydantic 会根据 JSON 里的实际类型自动判断是字符串还是列表。
(3)新增 to_sdk_messages 转换函数
def to_sdk_messages(req: ChatRequest) -> list[dict]:
    out = []
    for m in req.messages:
        if isinstance(m.content, str):
            out.append({"role": m.role, "content": m.content})
        else:
            parts = []
            for p in m.content:
                if p.type == "text":
                    parts.append({"type": "text", "text": p.text or ""})
                elif p.type == "image_url":
                    parts.append({"type": "image_url", "image_url": p.image_url or {}})
            out.append({"role": m.role, "content": parts})
    return out
为什么需要这个函数?因为 Pydantic 模型对象不能直接丢给 SDK,要转成纯 dict。而且要区分纯文本消息(直接传字符串)和多模态消息(传片段列表)。
(4)其余完全一致
chat_stream、sse、路由逻辑、SSE 帧类型——全部和第 1 课一样。这就是骨架复用的价值:换模型只需改请求模型和转换函数。
四、前端实现:templates/chat_vision.html
4.1 完整代码
在 templates/chat_vision.html 写入以下代码(与原始项目完全一致):
篇幅原因 省略前端代码
4.2 前端关键讲解
(1)三种图片上传方式
点击上传:
uploadBtn.addEventListener('click', () => fileInput.click());
fileInput.addEventListener('change', async (e) => {
    await addFiles(e.target.files);
    fileInput.value = '';  // 允许重复选同一文件
});
粘贴(Ctrl+V):
document.addEventListener('paste', (e) => {
    const items = e.clipboardData?.items || [];
    const imgs = [];
    for (const it of items) {
        if (it.type.startsWith('image/')) {
            const f = it.getAsFile();
            if (f) imgs.push(f);
        }
    }
    if (imgs.length) { e.preventDefault(); addFiles(imgs); }
});
拖拽:
inputBox.addEventListener('drop', async (e) => {
    if (e.dataTransfer?.files?.length) await addFiles(e.dataTransfer.files);
});
(2)构造多模态 content
if (sentImages.length) {
    userContent = [];
    if (text) userContent.push({ type: 'text', text });
    for (const img of sentImages) {
        userContent.push({ type: 'image_url', image_url: { url: img.dataUrl } });
    }
} else {
    userContent = text;
}
有图片时 content 是数组,无图片时是字符串——正好对应后端 str | list[ContentPart] 联合类型。
(3)历史也存多模态 content
history.push({ role: 'user', content: userContent });
这里 userContent 可能是字符串或数组,下一轮请求会原样回传。模型能基于之前的图片继续对话。
(4)SSE 处理与第 1 课完全一致
handleFrame 函数和第 1 课完全相同,因为后端发出的 SSE 帧格式一样。这就是前后端协议一致的好处。
五、运行与验证
5.1 启动
uv run python src/02_chat_bot_vision.py
浏览器打开 http://127.0.0.1:8002
5.2 验证清单
- 页面打开,有欢迎语说明支持图片。
- 点击 📎 选择一张图片,下方出现缩略图预览。
- 缩略图右上角 × 可删除该图。
- 点击缩略图可放大查看,点击空白关闭。
- Ctrl+V 粘贴截图,自动加入预览。
- 拖拽图片到输入框,边框高亮,松手加入预览。
- 发送「描述这张图」+ 一张图片,AI 给出描述。
- 仅发送文字(无图片)也能正常聊天。
- 发送多张图片 + 「对比这两张图」,AI 能对比。
- 思考过程区正常显示/折叠。
- 健康检查 http://127.0.0.1:8002/health 返回
glm-4.6v-flash。
5.3 用 curl 测试(带图片)
curl -N -X POST http://127.0.0.1:8002/chat -H "Content-Type: application/json" -d "{\"messages\":[{\"role\":\"user\",\"content\":[{\"type\":\"text\",\"text\":\"什么颜色\"},{\"type\":\"image_url\",\"image_url\":{\"url\":\"data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVR42mP8/5+hHgAHggJ/Pch4mwAAAABJRU5ErkJggg==\"}}]}],\"thinking\":false}"
这是一个 1x1 红色像素的 base64,AI 应当回答「红色」。
六、常见问题
Q1:报错 image size too large
A:单图超过限制。前端已限制 5MB,但模型端也可能有更小限制,建议用 1MB 以内的图。
Q2:粘贴没反应
A:确保焦点在页面内(点击一下页面再 Ctrl+V)。部分浏览器对剪贴板图片限制较严。
Q3:AI 说看不到图
A:检查后端 to_sdk_messages 是否正确转换。用 F12 Network 查看请求体,确认 image_url.url 是完整 data URL。
Q4:能否用 http 图片链接代替 base64
A:可以。image_url: { url: "https://example.com/a.jpg" } 同样被支持。
七、本课小结
你掌握了:
- 多模态消息格式(
content既可是字符串也可是片段列表)。 - 前端三种图片上传方式 + base64 转换。
- 后端
to_sdk_messages转换函数。 - SSE 流式逻辑的完整复用——换模型不改协议。
下一课,我们从「流式聊天」切换到「一次性文生图」 → 第 3 课:文生图。
第 3 课:文生图(CogView)
本课从「流式聊天」切换到「一次性文生图」。模型换成
cogview-3-flash,输入文字提示词,输出图片。
你将学会用线程池处理同步阻塞调用、把图片下载落盘、以及一个图片画廊前端。
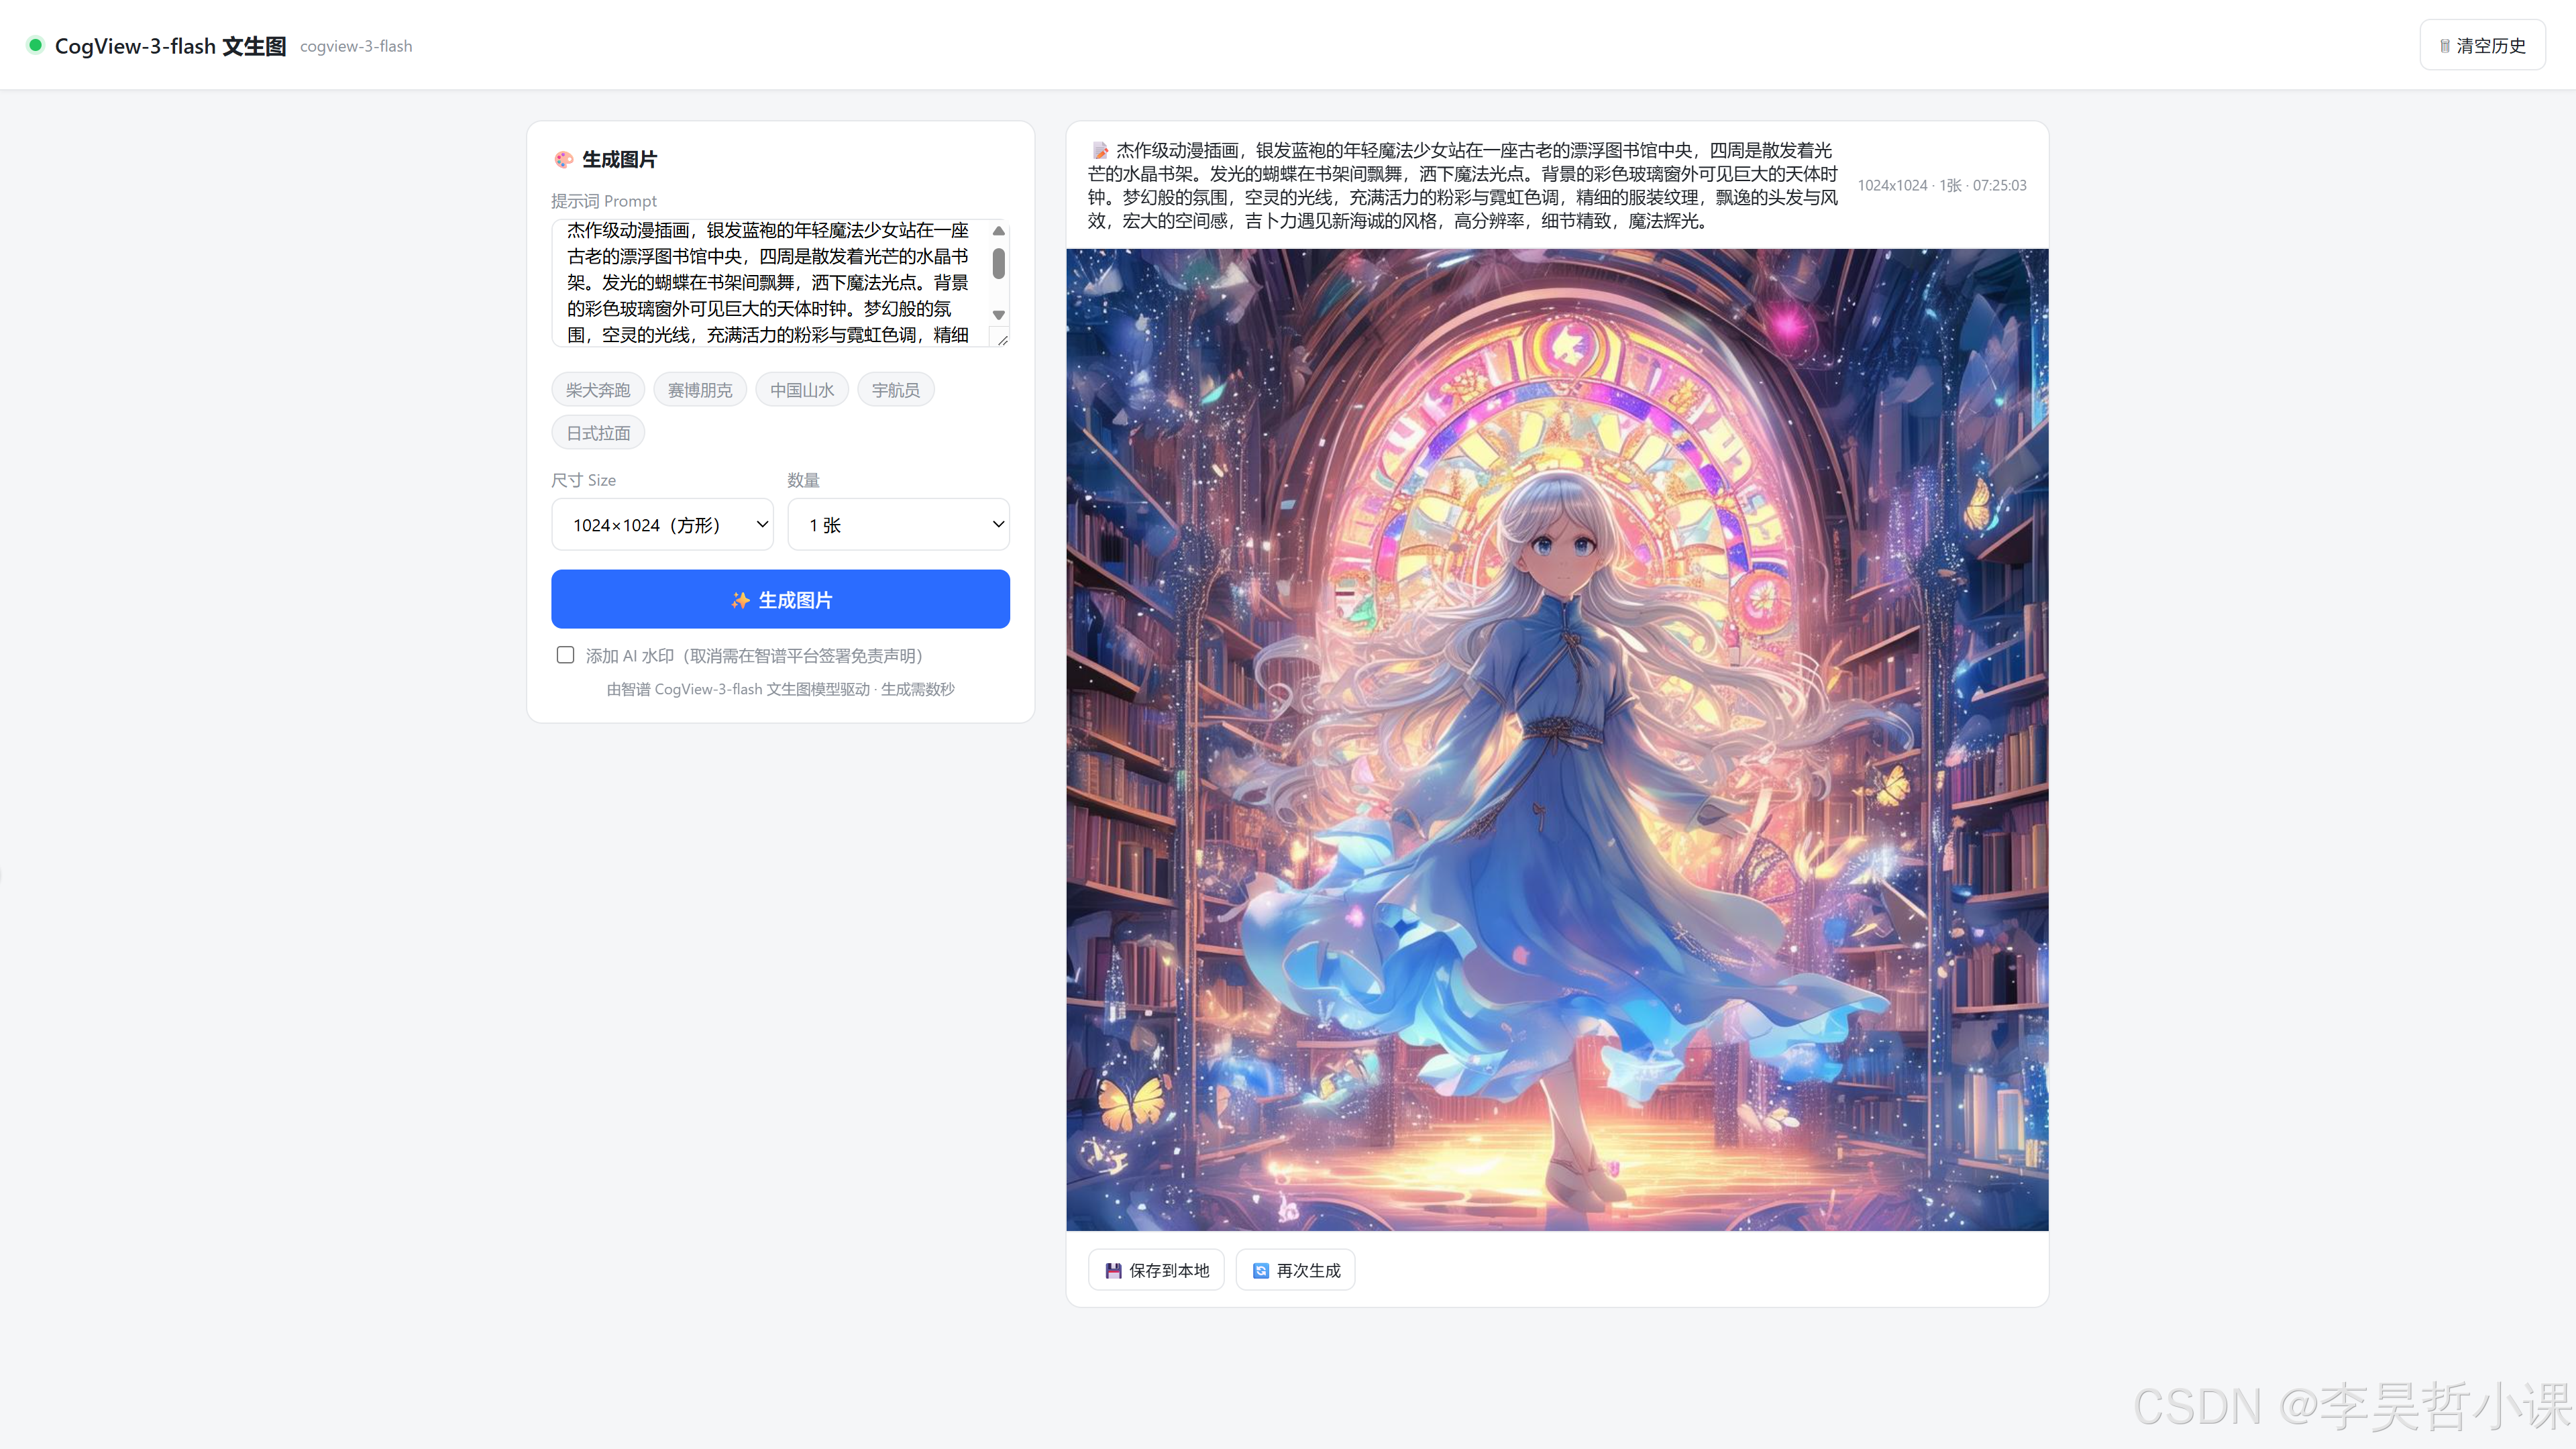
运行效果
一、本课学习目标
- 调用
client.images.generations()文生图接口。 - 用
fastapi.concurrency.run_in_threadpool把同步阻塞调用放到线程池,避免阻塞事件循环。 - 用
httpx.AsyncClient异步下载远程图片并保存到本地。 - 实现一个图片画廊前端:提示词输入、生成、预览、放大、保存。
二、核心概念
2.1 文生图与聊天的区别
| 方面 | 聊天(第 1/2 课) | 文生图(本课) |
|---|---|---|
| SDK 方法 | client.chat.completions.create | client.images.generations |
| 返回方式 | 流式(逐 token) | 一次性(整张图) |
| 响应内容 | 文本 | 图片 URL 或 base64 |
| 耗时 | 几秒 | 数秒~十几秒 |
| 前端协议 | SSE 流 | 普通 JSON |
2.2 为什么要用线程池
zai SDK 的 client.images.generations() 是同步阻塞接口——调用后线程会一直等待直到图生成完毕(数秒到十几秒)。
FastAPI 的事件循环是单线程的。如果在 async def 路由里直接调用同步阻塞函数,会卡住整个事件循环,其他请求无法处理。
解决方案:
from fastapi.concurrency import run_in_threadpool

async def generate(req):
    resp = await run_in_threadpool(call_generations, prompt, model, ...)  # 放线程池执行
run_in_threadpool 会把同步函数丢到线程池里跑,当前协程 await 等待结果,期间事件循环可以处理其他请求。
2.3 图片返回格式
resp = client.images.generations(model="cogview-3-flash", prompt="...", n=1, size="1024x1024")
# resp.data 是列表,每项有:
#   url: "https://..."          # 远程图片 URL(有过期时间)
#   b64_json: "iVBORw0KG..."    # 或 base64 数据(二选一)
#   revised_prompt: "..."        # 模型优化后的提示词
远程 URL 会过期,所以本课额外提供 /save 接口把图片下载到本地 uploads/cogview/ 持久保存。
三、后端实现:src/03_chat_bot_image.py
3.1 完整代码
在 src/03_chat_bot_image.py 写入以下代码(与原始项目完全一致):
"""CogView-3-flash 文生图案例(FastAPI)

参考:https://docs.bigmodel.cn/cn/guide/models/free/cogview-3-flash
cogview-3-flash 为智谱免费"文生图"模型:输入文本提示词 → 生成图片。

与聊天/视觉模型不同,文生图是"一次性"生成(非流式):
    client.images.generations(prompt=..., model="cogview-3-flash", size=..., n=...)
返回 ImagesResponded,其中 data 为图片列表,每个含 url 或 b64_json + revised_prompt。

由于生成耗时数秒~十几秒,且 zai SDK 的 generations() 为同步阻塞接口,
这里用 fastapi.concurrency.run_in_threadpool 在线程池中调用,避免阻塞事件循环。

运行:
    uv run python src/zhipi/03_chat_bot_image.py
然后浏览器打开 http://127.0.0.1:8002
"""

import asyncio  # 用于运行异步事件循环(uvicorn.serve)
import base64  # 用于解码 base64 图片数据
import os  # 用于读取环境变量
import time  # 用于生成时间戳文件名
import uuid  # 用于生成唯一文件名前缀
from pathlib import Path  # 用于跨平台路径拼接
from typing import Any  # 用于类型注解 dict[str, Any]

import httpx  # 异步 HTTP 客户端,用于下载远程图片
import uvicorn  # ASGI 服务器,用于承载 FastAPI 应用
from dotenv import load_dotenv  # 从 .env 文件加载环境变量
from fastapi import FastAPI  # Web 框架主体
from fastapi.concurrency import run_in_threadpool  # 在线程池运行同步阻塞调用
from fastapi.middleware.cors import CORSMiddleware  # 跨域中间件
from fastapi.responses import FileResponse, HTMLResponse, JSONResponse  # 文件/HTML/JSON 响应
from pydantic import BaseModel, Field  # 请求体校验与字段约束
from zai import ZhipuAiClient  # 智谱 AI 官方 SDK 客户端

# 读取项目根目录的 .env(含 ZAI_API_KEY / ZAI_IMAGE_MODEL)
# Path(__file__) = src/03_chat_bot_image.py,向上两级到项目根
load_dotenv(Path(__file__).resolve().parents[1] / ".env")

API_KEY = os.getenv("ZAI_API_KEY")  # 智谱 API 密钥(Bearer 鉴权)
MODEL = os.getenv("ZAI_IMAGE_MODEL") or "cogview-3-flash"  # 默认文生图模型

client = ZhipuAiClient(api_key=API_KEY, disable_token_cache=True)  # 构造智谱客户端,禁用 JWT 缓存

# 保存生成图片的目录(与同级项目 uploads 复用风格)
PROJECT_ROOT = Path(__file__).resolve().parents[1]  # 项目根目录
UPLOAD_DIR = PROJECT_ROOT / "uploads" / "cogview"  # 图片保存目录
UPLOAD_DIR.mkdir(parents=True, exist_ok=True)  # 确保目录存在

app = FastAPI(title="CogView-3-flash Image Generator")  # 创建 FastAPI 应用实例

app.add_middleware(  # 添加 CORS 中间件
    CORSMiddleware,  # 跨域中间件
    allow_origins=["*"],  # 允许任意来源
    allow_methods=["*"],  # 允许任意 HTTP 方法
    allow_headers=["*"],  # 允许任意请求头
)


# ========== 请求/响应模型 ==========
class GenerateRequest(BaseModel):  # 文生图请求体
    prompt: str = Field(..., min_length=1, max_length=2000)  # 提示词,1~2000 字
    size: str = "1024x1024"   # cogview-3-flash 支持的尺寸
    n: int = Field(default=1, ge=1, le=4)  # 生成数量,1~4
    model: str | None = None  # 可覆盖默认模型
    watermark_enabled: bool = True  # 是否添加 AI 水印(关闭需在智谱平台签署免责声明)


class SaveRequest(BaseModel):  # 保存图片请求体
    """把已生成的图片(url 或 base64)落盘保存到本地。"""
    url: str | None = None  # 远程图片 URL
    base64: str | None = None  # base64 编码的图片数据
    mime: str = "image/png"  # MIME 类型,用于推断扩展名
    prompt: str = ""  # 提示词(仅记录用)


# ========== 核心生成 ==========
def call_generations(prompt: str, model: str, size: str, n: int, watermark_enabled: bool = True):
    """同步调用智谱文生图接口(在线程池中执行)。

    cogview-3-flash 默认以 url 形式返回图片(OpenAI 风格 b64_json/url 二选一)。
    watermark_enabled=False 可关闭水印,但需在智谱平台签署免责声明。
    """
    resp = client.images.generations(  # 调用文生图接口
        model=model,  # 模型名
        prompt=prompt,  # 提示词
        n=n,  # 生成数量
        size=size,  # 图片尺寸
        watermark_enabled=watermark_enabled,  # 水印开关
    )
    return resp  # 返回 SDK 响应对象


def serialize(resp) -> list[dict[str, Any]]:
    """把 SDK 响应转为可 JSON 序列化的列表。"""
    out = []  # 输出列表
    for img in resp.data:  # 遍历每张图片
        out.append({
            "url": getattr(img, "url", None),  # 图片 URL(若存在)
            "b64_json": getattr(img, "b64_json", None),  # base64 数据(若存在)
            "revised_prompt": getattr(img, "revised_prompt", None),  # 模型修订后的提示词
        })
    return out  # 返回序列化结果


@app.post("/generate")  # POST /generate 文生图接口
async def generate(req: GenerateRequest):
    """文生图接口:返回生成图片(url 或 base64)。"""
    model = req.model or MODEL  # 请求未指定模型时回退到全局默认
    prompt = req.prompt.strip()  # 去除首尾空白
    if not prompt:  # 提示词为空
        return JSONResponse({"error": "prompt 不能为空"}, status_code=400)  # 返回 400

    try:
        # 同步阻塞调用放线程池
        resp = await run_in_threadpool(call_generations, prompt, model, req.size, req.n, req.watermark_enabled)  # 线程池调用
        images = serialize(resp)  # 序列化响应
        return {  # 返回 JSON
            "model": model,  # 模型名
            "prompt": prompt,  # 提示词
            "size": req.size,  # 尺寸
            "created": getattr(resp, "created", None),  # 创建时间戳
            "images": images,  # 图片列表
        }
    except Exception as e:  # noqa: BLE001
        return JSONResponse(  # 返回 500 错误
            {"error": f"{type(e).__name__}: {e}", "prompt": prompt},  # 错误信息
            status_code=500,  # 状态码
        )


@app.post("/save")  # POST /save 保存图片接口
async def save_image(req: SaveRequest):
    """把生成图片保存到本地 uploads/cogview/,返回可访问路径。

    前端拿到 /generate 返回的 url 后,若希望持久化,可调用本接口下载落盘。
    """
    try:
        ext = "png"  # 默认扩展名
        if req.mime:  # 若指定 MIME
            ext = req.mime.split("/")[-1].split("+")[0] or "png"  # 从 MIME 推断扩展名
        filename = f"cogview_{int(time.time())}_{uuid.uuid4().hex[:6]}.{ext}"  # 生成唯一文件名
        filepath = UPLOAD_DIR / filename  # 完整路径

        if req.base64:  # base64 保存
            # 去除可能的 data URL 前缀
            data = req.base64  # 原始数据
            if "," in data and data.startswith("data:"):  # 含 data: 前缀
                data = data.split(",", 1)[1]  # 去除前缀
            filepath.write_bytes(base64.b64decode(data))  # 解码并写入文件
        elif req.url:  # URL 下载
            # 下载远程图片
            async with httpx.AsyncClient(timeout=60.0) as http:  # 创建异步 HTTP 客户端
                r = await http.get(req.url)  # GET 请求
                r.raise_for_status()  # 检查状态码
                filepath.write_bytes(r.content)  # 写入文件
        else:  # 既无 base64 也无 url
            return JSONResponse({"error": "需提供 url 或 base64"}, status_code=400)  # 返回 400

        return {"saved": True, "path": f"/uploads/cogview/{filename}", "filename": filename}  # 返回保存信息
    except Exception as e:  # noqa: BLE001
        return JSONResponse({"error": f"{type(e).__name__}: {e}"}, status_code=500)  # 返回 500


# 静态访问已保存图片
@app.get("/uploads/cogview/{filename}")  # GET /uploads/cogview/{filename}
async def serve_uploaded(filename: str):
    path = UPLOAD_DIR / filename  # 定位文件
    if not path.is_file():  # 文件不存在
        return JSONResponse({"error": "文件不存在"}, status_code=404)  # 返回 404
    return FileResponse(path)  # 返回文件响应


@app.get("/")  # GET / 首页
async def index():
    """首页:返回独立 HTML 文生图页面。"""
    html_path = PROJECT_ROOT / "templates" / "chat_image.html"  # 定位模板
    return HTMLResponse(html_path.read_text(encoding="utf-8"))  # 返回 HTML 内容


@app.get("/health")  # GET /health 健康检查
async def health():
    return {"status": "ok", "model": MODEL}  # 返回状态与当前模型名


# ========== 入口 ==========
if __name__ == "__main__":  # 直接运行本文件时
    config = uvicorn.Config(app, host="127.0.0.1", port=8003)  # 配置 uvicorn(本地 8003)
    server = uvicorn.Server(config)  # 创建服务器实例
    asyncio.run(server.serve())  # 启动事件循环并运行
3.2 代码讲解
(1)创建上传目录
UPLOAD_DIR = PROJECT_ROOT / "uploads" / "cogview"
UPLOAD_DIR.mkdir(parents=True, exist_ok=True)
模块加载时自动创建 uploads/cogview/ 目录。parents=True 连父目录一起建,exist_ok=True 已存在不报错。
(2)同步调用 + 线程池
def call_generations(prompt, model, size, n, watermark_enabled=True):
    resp = client.images.generations(
        model=model, prompt=prompt, n=n, size=size,
        watermark_enabled=watermark_enabled,
    )
    return resp

@app.post("/generate")
async def generate(req: GenerateRequest):
    resp = await run_in_threadpool(call_generations, prompt, model, req.size, req.n, req.watermark_enabled)
关键点:
call_generations是普通同步函数(不是 async)。- 在
async def路由里用await run_in_threadpool(...)把它丢到线程池。 run_in_threadpool的第一个参数是函数,后面是函数的参数。
(3)序列化响应
def serialize(resp) -> list[dict[str, Any]]:
    out = []
    for img in resp.data:
        out.append({
            "url": getattr(img, "url", None),
            "b64_json": getattr(img, "b64_json", None),
            "revised_prompt": getattr(img, "revised_prompt", None),
        })
    return out
用 getattr 安全取值,因为不同模型返回的字段可能不同(有的只给 url,有的只给 b64_json)。
(4)保存图片(两种来源)
if req.base64:  # base64 保存
    data = req.base64
    if "," in data and data.startswith("data:"):
        data = data.split(",", 1)[1]  # 去掉 data:image/png;base64, 前缀
    filepath.write_bytes(base64.b64decode(data))
elif req.url:  # URL 下载
    async with httpx.AsyncClient(timeout=60.0) as http:
        r = await http.get(req.url)
        r.raise_for_status()
        filepath.write_bytes(r.content)
- base64 方式:先去掉
data:...;base64,前缀,再b64decode解码写入。 - URL 方式:用
httpx.AsyncClient异步下载(不阻塞事件循环),超时 60 秒。
(5)静态文件访问
@app.get("/uploads/cogview/{filename}")
async def serve_uploaded(filename: str):
    path = UPLOAD_DIR / filename
    if not path.is_file():
        return JSONResponse({"error": "文件不存在"}, status_code=404)
    return FileResponse(path)
保存后前端可以通过 /uploads/cogview/xxx.png 直接访问图片。FileResponse 会自动设置 Content-Type。
四、前端实现:templates/chat_image.html
4.1 完整代码
在 templates/chat_image.html 写入以下代码(与原始项目完全一致):
篇幅原因 省略前端代码
4.2 前端关键讲解
(1)生成流程
async function generate() {
    if (generating) return;       // 防重入
    generating = true;
    genBtn.disabled = true;
    renderLoading(prompt);        // 显示加载动画
    try {
        const resp = await fetch(API_BASE + 'generate', {...});
        const data = await resp.json();  // 一次性等完整响应
        removeLoading();
        renderResult(data);
    } finally {
        generating = false;
        genBtn.disabled = false;
    }
}
与第 1 课的 SSE 流式不同,这里用普通 fetch + await resp.json() 一次性等待。因为文生图是一次性返回,不流式。
(2)加载计时器
card._timer = setInterval(() => {
    const sec = Math.floor((Date.now() - Number(timer.dataset.start)) / 1000);
    timer.textContent = `已用 ${sec}s`;
}, 500);
用 setInterval 每 500ms 更新「已用 X 秒」,让用户知道还在生成。生成完成后 clearInterval 清除。
(3)保存到本地
const r = await fetch(API_BASE + 'save', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ url: b.dataset.url || null, base64: b.dataset.b64 || null })
});
把 /generate 返回的 url 或 b64_json 发给 /save,后端下载落盘后返回本地路径。
(4)图片网格自适应
const cols = Math.min(images.length, 4);
const gridCls = `cols-${cols === 3 ? 3 : (cols >= 4 ? 4 : cols)}`;
根据图片数量选择网格列数,1 张单列、2 张双列、3 张三列、4 张 2×2。
五、运行与验证
5.1 启动
uv run python src/03_chat_bot_image.py
浏览器打开 http://127.0.0.1:8003
5.2 验证清单
- 页面打开,左侧控制面板,右侧空状态。
- 点击示例词「柴犬奔跑」,提示词自动填入。
- 点击「生成图片」,右侧出现旋转加载动画和计时器。
- 数秒后出现图片卡片,显示提示词、尺寸、时间。
- 点击图片可放大查看,点击空白关闭。
- 鼠标悬停图片显示「优化后:…」(如有 revised_prompt)。
- 点击「保存到本地」,Toast 提示「已保存:/uploads/cogview/xxx.png」。
- 浏览器访问
/uploads/cogview/xxx.png能看到保存的图片。 - 点击「再次生成」用相同参数重新生成。
- 切换尺寸/数量,生成多张图。
- 健康检查 http://127.0.0.1:8003/health 返回
cogview-3-flash。
5.3 用 curl 测试
curl -X POST http://127.0.0.1:8003/generate -H "Content-Type: application/json" -d "{\"prompt\":\"一只橙猫\",\"size\":\"1024x1024\",\"n\":1}"
返回 JSON 包含 images[0].url,复制 URL 到浏览器可看图。
六、常见问题
Q1:生成很慢(超过 30 秒)
A:正常,cogview-3-flash 生成需数秒到十几秒。如果超 60 秒,检查网络。
Q2:报错 watermark_enabled 相关
A:关闭水印需要在智谱平台签署免责声明。默认开启水印即可。
Q3:保存的图片打不开
A:检查 uploads/cogview/ 目录是否有写入权限。看后端日志有无异常。
Q4:生成的图和提示词不符
A:模型会自动优化提示词(revised_prompt),悬停图片可看到优化后的版本。
七、本课小结
你掌握了:
- 同步阻塞调用用
run_in_threadpool放线程池。 client.images.generations()文生图接口。httpx.AsyncClient异步下载图片。FileResponse提供静态文件访问。- 前端画廊:加载动画、计时、网格布局、放大、保存。
下一课,从「一次性生成」升级到「异步任务 + 轮询」 → 第 4 课:视频生成。
第 4 课:视频生成(CogVideoX 异步任务)
本课是项目中最复杂的一课。视频生成是「异步任务」:提交后立即返回任务 ID,需要轮询状态直到成功。
你将学会异步任务模式、前端轮询、图生视频(上传图片转 base64)、以及视频播放器。
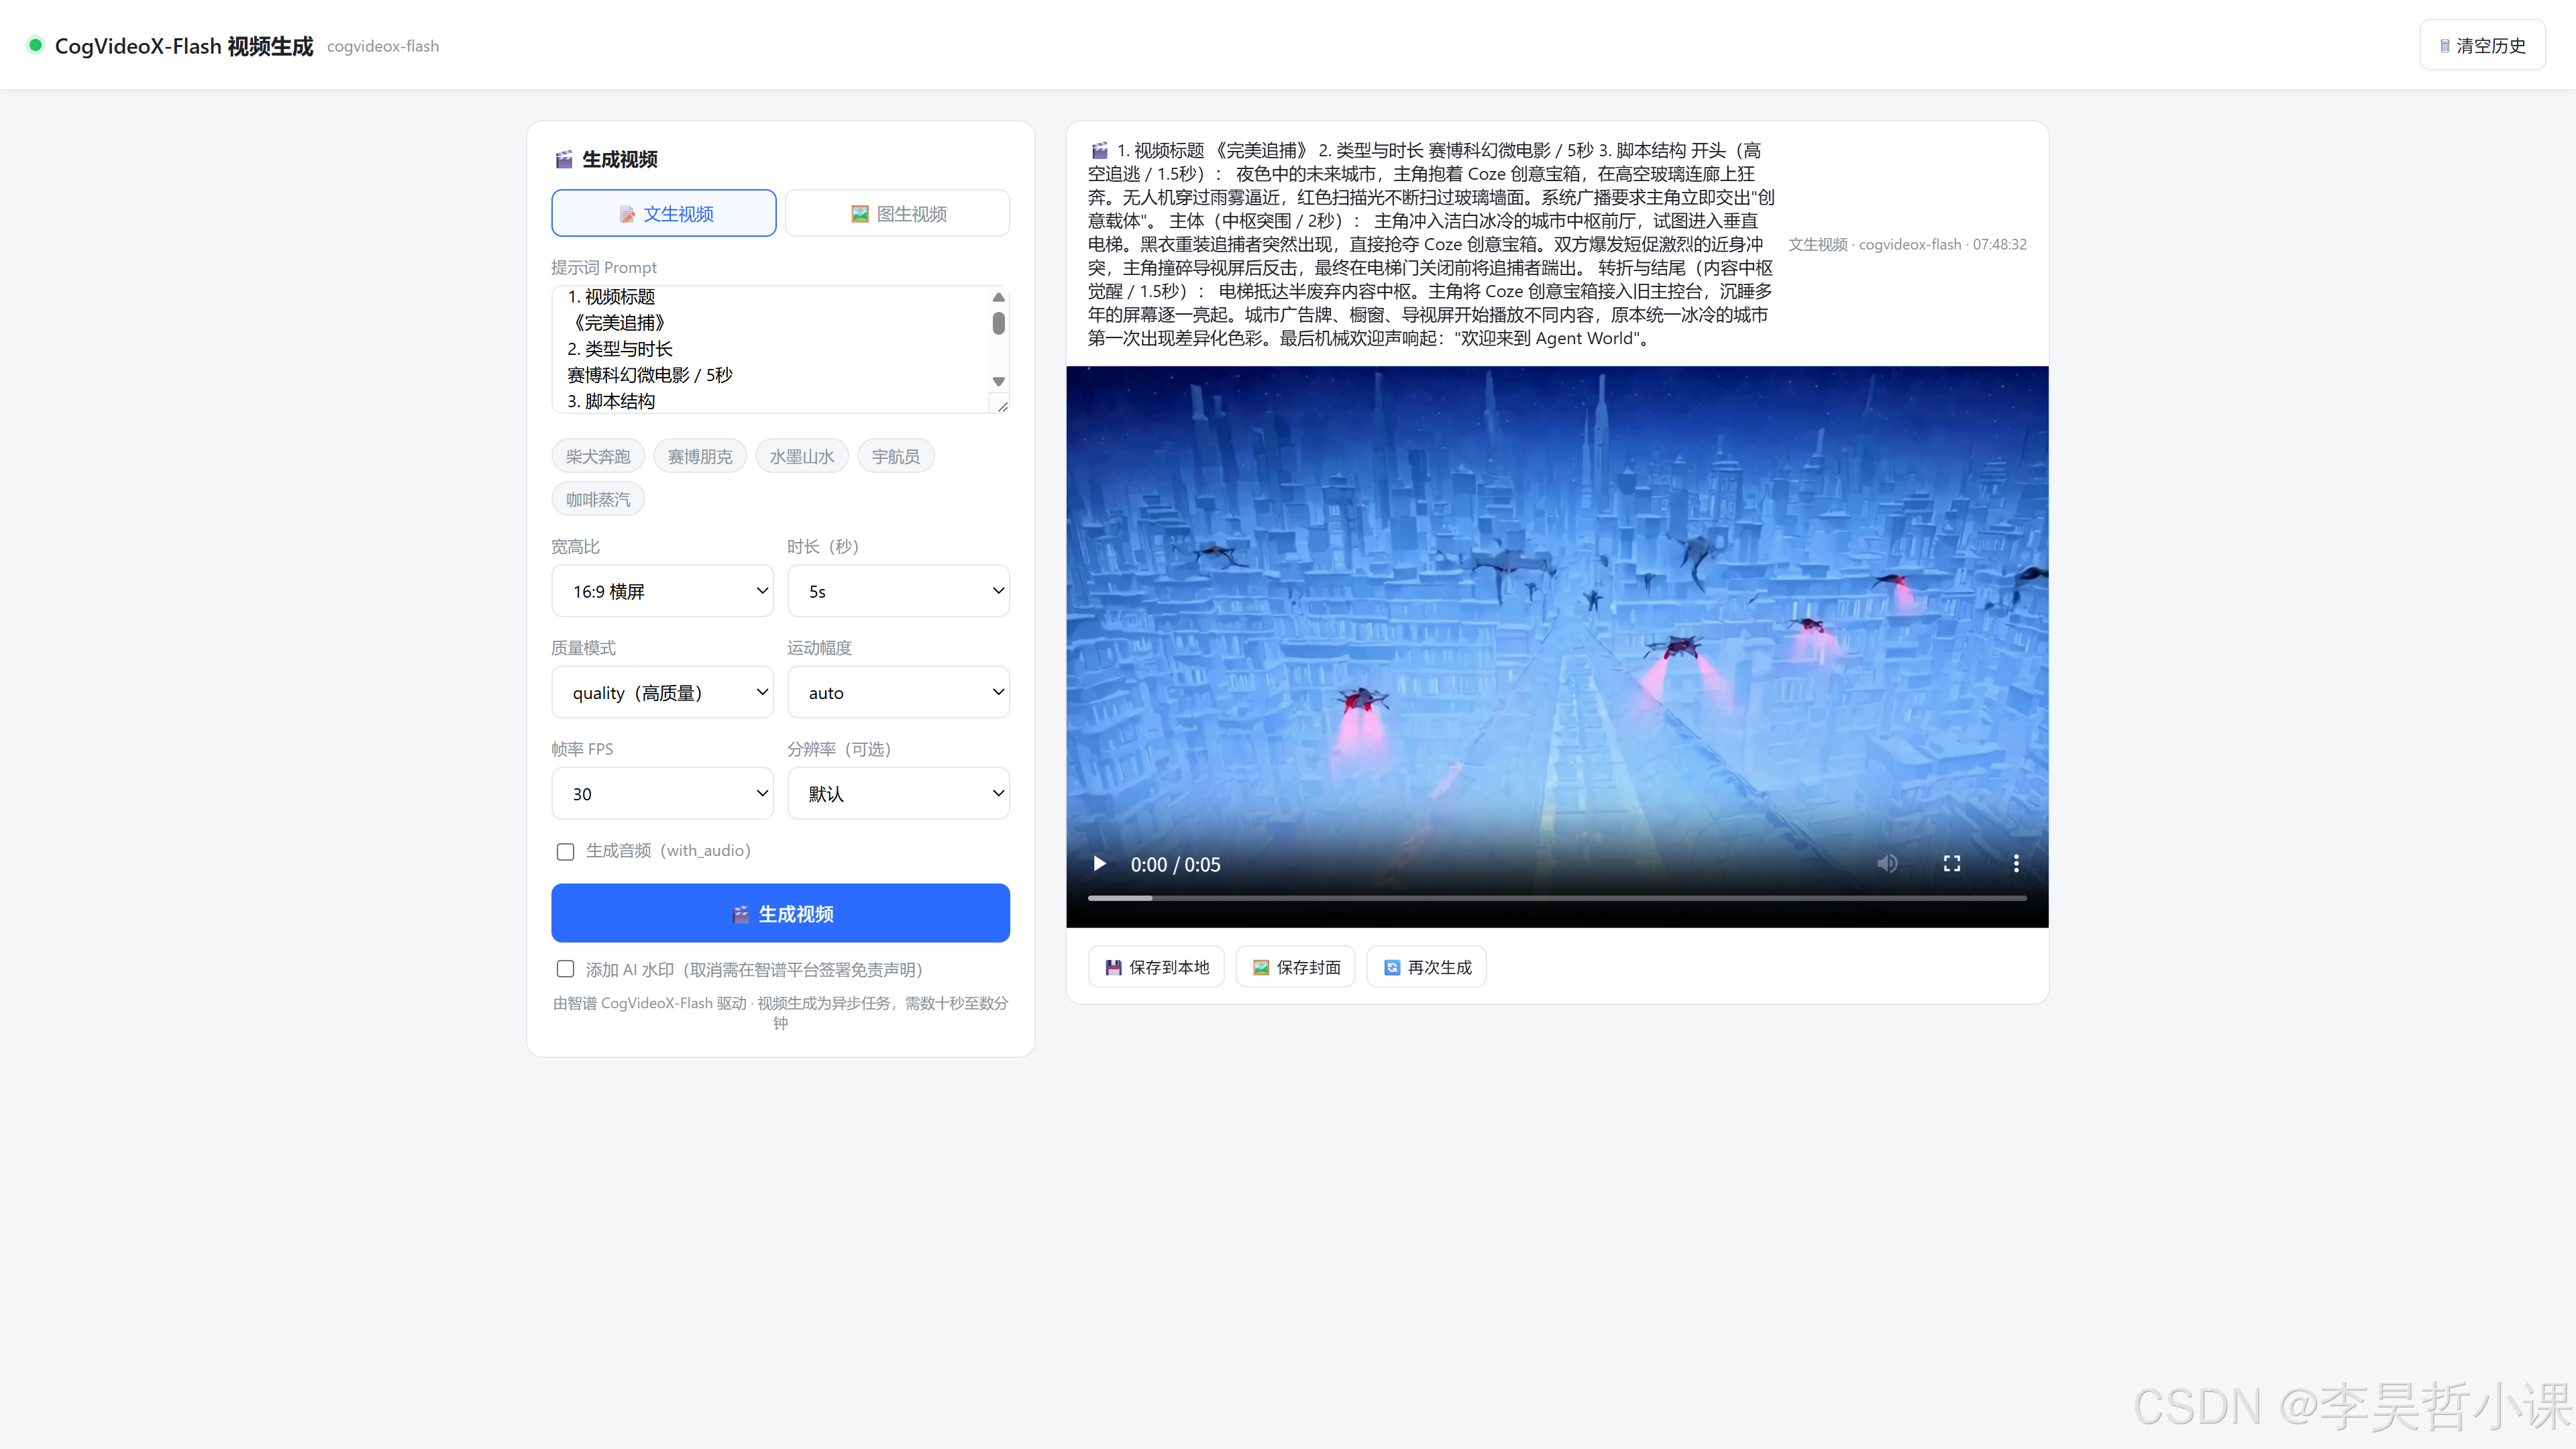
运行效果
文生视频
图生视频
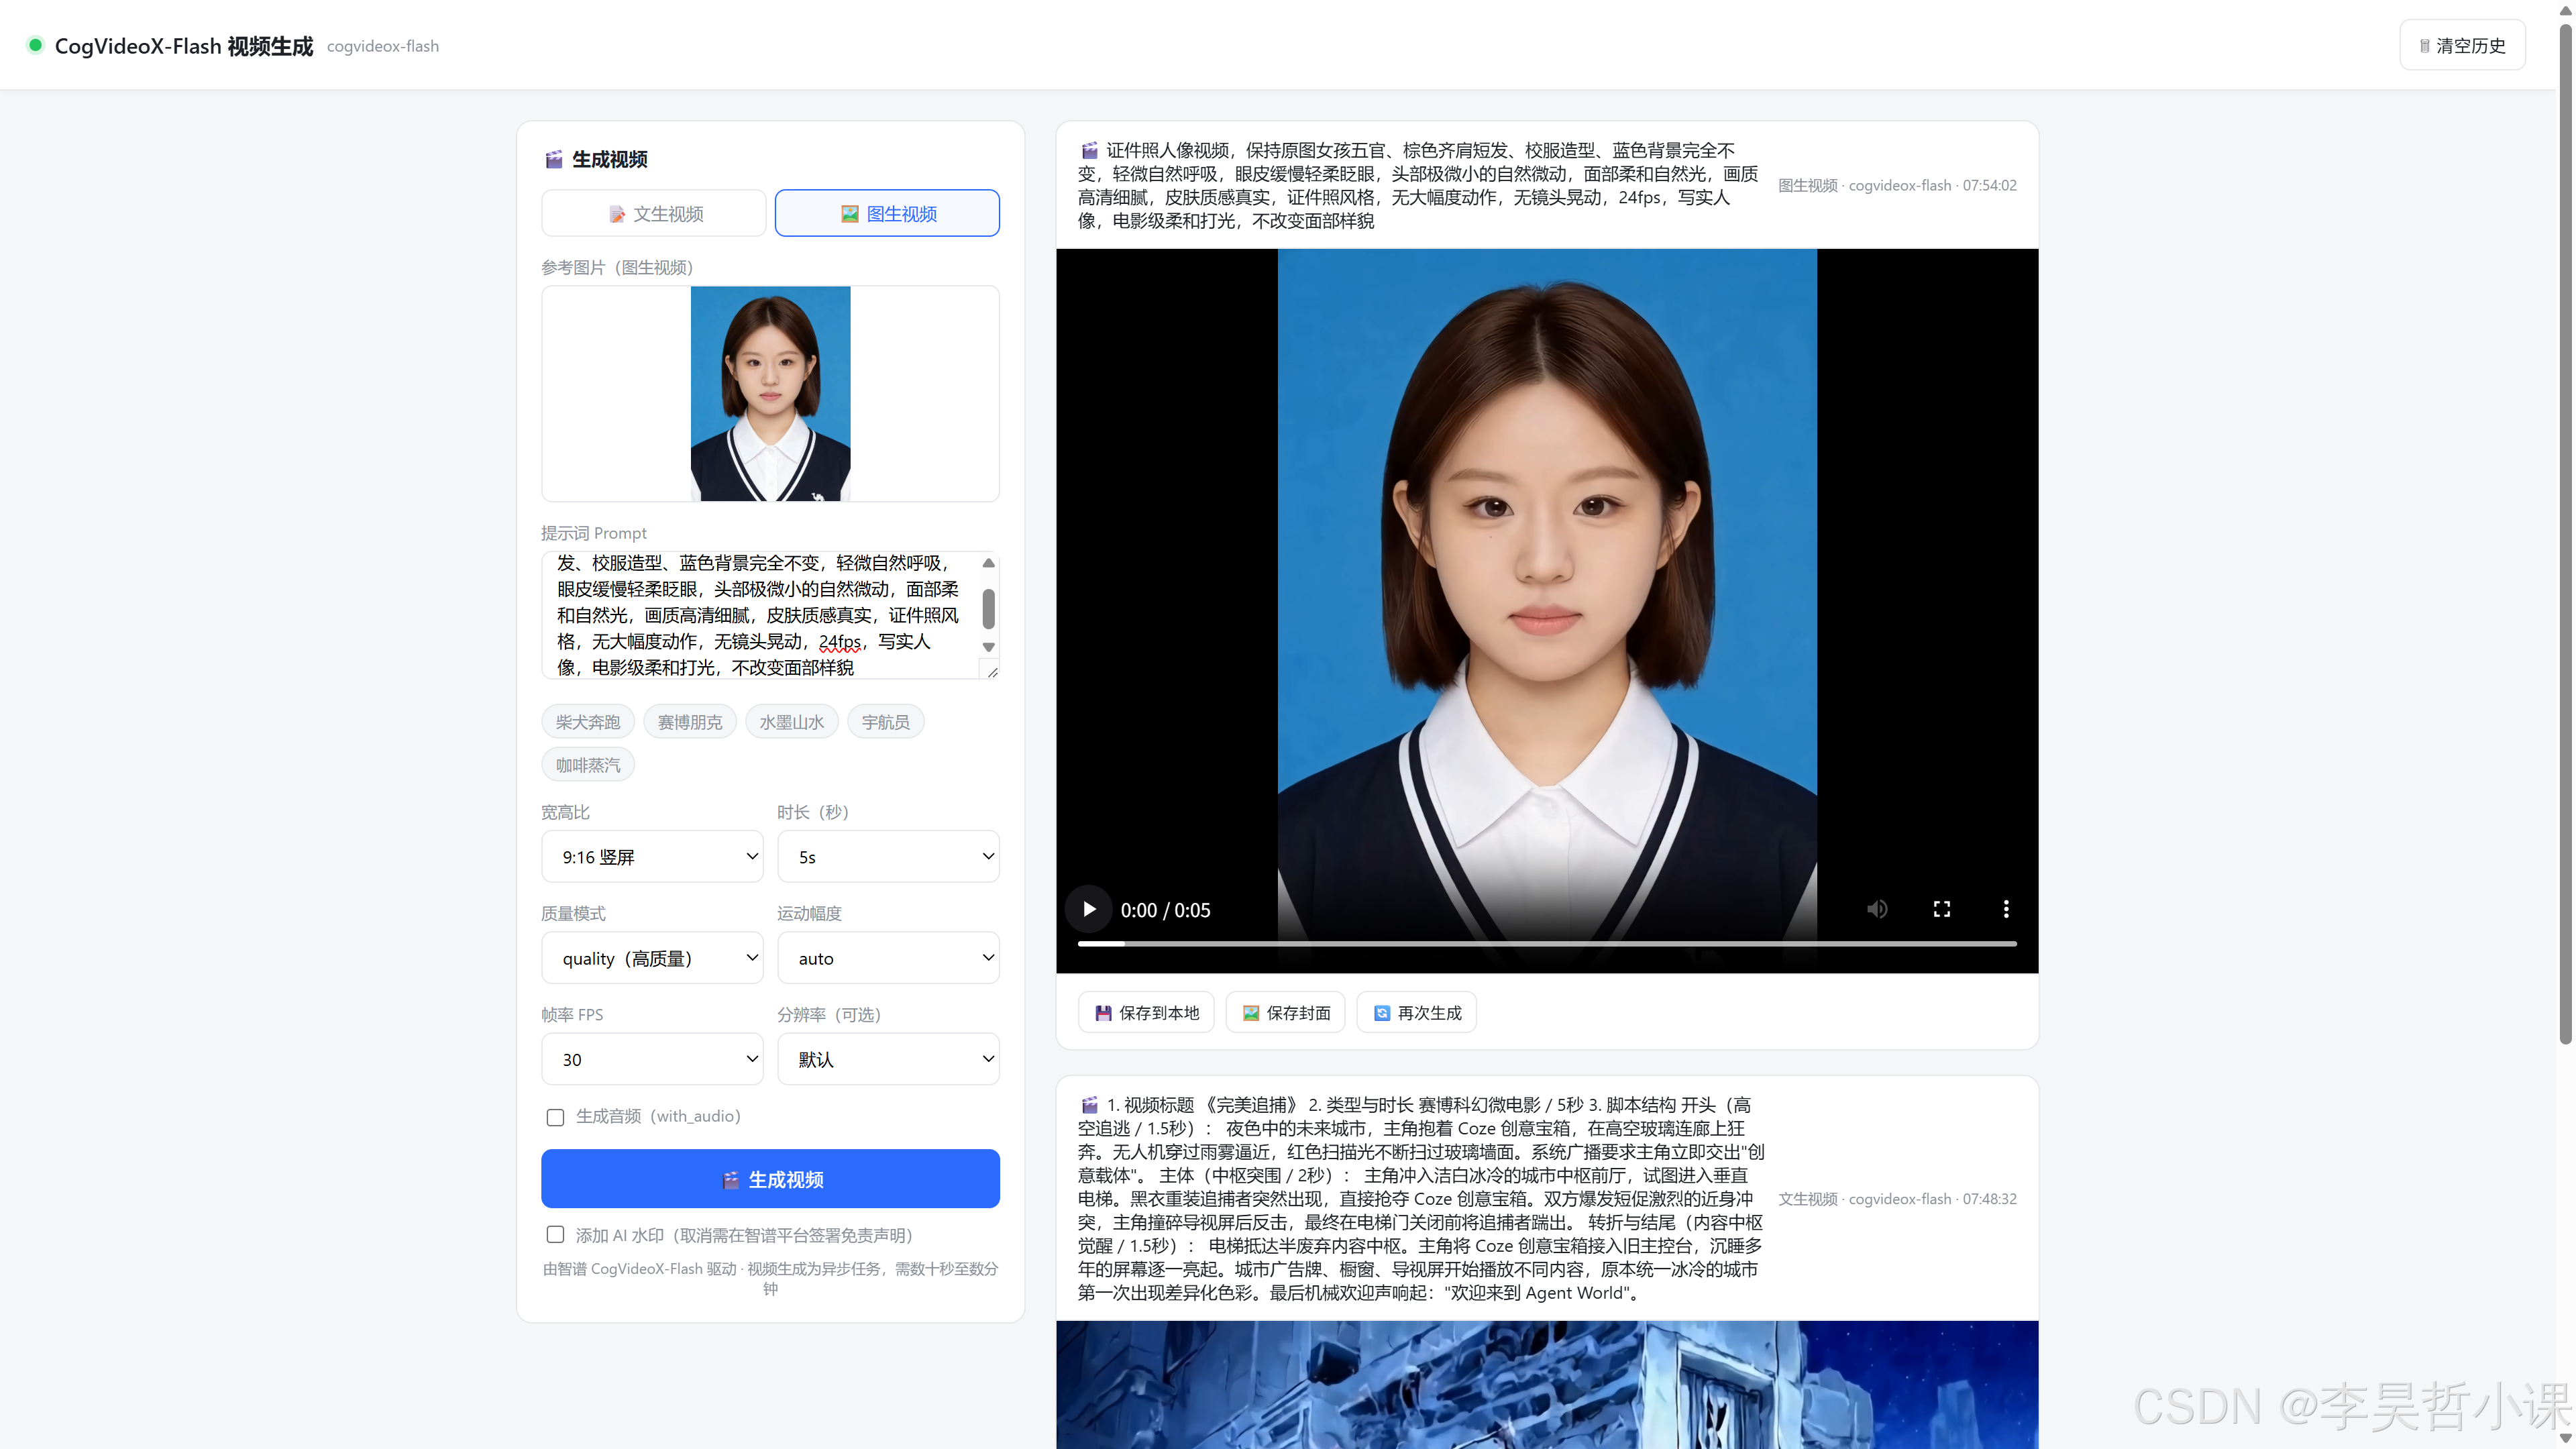
一、本课学习目标
- 理解「异步任务」模式:提交 → 轮询 → 获取结果。
- 调用
client.videos.generations()提交视频生成任务,client.videos.retrieve_videos_result()查询结果。 - 在前端实现轮询循环(
while + setTimeout),处理 PROCESSING/SUCCESS/FAIL 三种状态。 - 实现图生视频:前端上传图片转 base64,作为
image_url传给后端。 - 用
<video>标签播放生成的视频。
二、核心概念
2.1 为什么视频生成是异步任务
文生图(第 3 课)虽然慢(十几秒),但 HTTP 请求能保持等待。视频生成可能要几分钟,HTTP 请求会超时断开。
所以智谱设计了「异步任务」模式:
1. POST /generate  → 提交任务,立即返回 {id, task_status: "PROCESSING"}
2. GET /status/{id} → 查询状态:
       PROCESSING(还在生成)
       SUCCESS(成功,含 video_result)
       FAIL(失败)
3. 前端每隔几秒轮询一次 /status/{id},直到 SUCCESS 或 FAIL
2.2 文生视频 vs 图生视频
- 文生视频:只传
prompt(文字描述),生成视频。 - 图生视频:传
prompt(运动描述)+image_url(参考图片),让图片动起来。
前端通过模式切换选择,图生视频时上传图片转 base64 data URL 传给后端。
2.3 任务状态流转
提交 → PROCESSING → SUCCESS(成功,有 video_result)
                  → FAIL(失败)

video_result: [{url: "视频地址", cover_image_url: "封面地址"}]
2.4 与第 3 课的对比
| 方面 | 文生图(第 3 课) | 视频生成(本课) |
|---|---|---|
| 模式 | 同步等待 | 异步任务 + 轮询 |
| SDK | client.images.generations | client.videos.generations + retrieve_videos_result |
| 耗时 | 数秒~十几秒 | 数十秒~数分钟 |
| 前端 | 一次请求等结果 | 提交 + 轮询循环 |
| 输入 | 仅文字 | 文字 + 可选图片 |
三、后端实现:src/04_chat_bot_video.py
3.1 完整代码
在 src/04_chat_bot_video.py 写入以下代码(与原始项目完全一致):
"""CogVideoX-Flash 视频生成案例(FastAPI)

参考:https://docs.bigmodel.cn/cn/guide/models/free/cogvideox-flash
cogvideox-flash 为智谱免费"文生视频/图生视频"模型:
    文生视频 → client.videos.generations(model=..., prompt=..., ...)
    图生视频 → client.videos.generations(model=..., image_url=..., prompt=..., ...)

与聊天/文生图不同,视频生成是"异步任务":提交后立即返回任务 id,
随后需通过 client.videos.retrieve_videos_result(id) 轮询 task_status:
    PROCESSING(处理中)/ SUCCESS(成功)/ FAIL(失败)
SUCCESS 时 video_result 内含 url(视频)与 cover_image_url(封面)。

本服务采用"提交任务 + 前端轮询"模式:
    POST /generate        → 提交任务,返回 task id(立即返回,不阻塞)
    GET  /status/{id}     → 查询任务状态与结果(供前端轮询)
    POST /save           → 把生成的视频/封面下载落盘到 uploads/cogvideox/
    GET  /uploads/cogvideox/{filename} → 静态访问已保存文件

运行:
    uv run python src/zhipi/04_chat_bot_video.py
然后浏览器打开 http://127.0.0.1:8003
"""

import asyncio  # 用于运行异步事件循环(uvicorn.serve)
import base64  # 用于解码 base64 视频数据
import os  # 用于读取环境变量
import time  # 用于生成时间戳文件名
import uuid  # 用于生成唯一文件名前缀
from pathlib import Path  # 用于跨平台路径拼接
from typing import Any  # 用于类型注解 dict[str, Any]

import httpx  # 异步 HTTP 客户端,用于下载远程视频
import uvicorn  # ASGI 服务器,用于承载 FastAPI 应用
from dotenv import load_dotenv  # 从 .env 文件加载环境变量
from fastapi import FastAPI  # Web 框架主体
from fastapi.concurrency import run_in_threadpool  # 在线程池运行同步阻塞调用
from fastapi.middleware.cors import CORSMiddleware  # 跨域中间件
from fastapi.responses import FileResponse, HTMLResponse, JSONResponse  # 文件/HTML/JSON 响应
from pydantic import BaseModel, Field  # 请求体校验与字段约束
from zai import ZhipuAiClient  # 智谱 AI 官方 SDK 客户端

# 读取项目根目录的 .env(含 ZAI_API_KEY / ZAI_VIDEO_MODEL)
# Path(__file__) = src/04_chat_bot_video.py,向上两级到项目根
load_dotenv(Path(__file__).resolve().parents[1] / ".env")

API_KEY = os.getenv("ZAI_API_KEY")  # 智谱 API 密钥(Bearer 鉴权)
MODEL = os.getenv("ZAI_VIDEO_MODEL") or "cogvideox-flash"  # 默认视频模型

# 构造智谱客户端(Bearer 直接鉴权,禁用 JWT 缓存)
client = ZhipuAiClient(api_key=API_KEY, disable_token_cache=True)

# 保存生成视频/封面的目录(与同级项目 uploads 复用风格)
PROJECT_ROOT = Path(__file__).resolve().parents[1]  # 项目根目录
UPLOAD_DIR = PROJECT_ROOT / "uploads" / "cogvideox"  # 视频保存目录
UPLOAD_DIR.mkdir(parents=True, exist_ok=True)  # 确保目录存在

app = FastAPI(title="CogVideoX-Flash Video Generator")  # 创建 FastAPI 应用实例

# 允许跨域:使独立的 HTML 文件也可通过 file:// 直接打开并连接本服务
app.add_middleware(
    CORSMiddleware,  # 添加 CORS 中间件
    allow_origins=["*"],  # 允许任意来源
    allow_methods=["*"],  # 允许任意 HTTP 方法
    allow_headers=["*"],  # 允许任意请求头
)

# 任务状态内存表(仅用于本进程演示;重启即丢失)
# key: task id, value: 提交时的参数快照,便于失败时回看
_TASKS: dict[str, dict[str, Any]] = {}  # 内存任务表


# ========== 请求/响应模型 ==========
class GenerateRequest(BaseModel):  # 视频生成请求体
    """提交视频生成任务。

    prompt 必填(图生视频时作为对图片的运动/场景补充描述)。
    image 为可选项:图生视频时传入图片(data URL 形式 base64 或 http(s) URL)。
    """
    prompt: str = Field(..., min_length=1, max_length=2000)  # 提示词,1~2000 字
    image: str | None = None        # data:image/...;base64,... 或 http(s):// 链接
    quality: str = "quality"          # "quality" 或 "speed"
    with_audio: bool = True           # 是否带音频
    size: str = ""                    # 分辨率,如 "1920x1080";为空交由服务端默认
    duration: int = 5                 # 视频时长(秒),5/10
    fps: int = 30                     # 帧率
    aspect_ratio: str = "16:9"        # 宽高比 16:9 / 9:16 / 1:1 / 4:3 / 3:4 / 21:9
    movement_amplitude: str = "auto"  # auto / small / medium / large
    model: str | None = None  # 可覆盖默认模型
    watermark_enabled: bool = True  # 是否添加 AI 水印(关闭需在智谱平台签署免责声明)


class SaveRequest(BaseModel):  # 保存视频/封面请求体
    """把已生成的视频或封面落盘保存到本地。"""
    url: str | None = None  # 远程文件 URL
    base64: str | None = None  # base64 编码的数据
    mime: str = "video/mp4"  # MIME 类型,用于推断扩展名
    kind: str = "video"               # video / cover


# ========== 核心生成 ==========
def call_generations(req: GenerateRequest, model: str) -> Any:
    """同步调用智谱视频生成接口(在线程池中执行),返回提交任务响应。

    cogvideox-flash 提交后即返回含 id 的 VideoObject,task_status 通常为 PROCESSING。
    """
    # 仅传入非空、非默认的参数,避免发送冗余字段
    kwargs: dict[str, Any] = dict(model=model, prompt=req.prompt)  # 必填参数

    if req.image:  # 图生视频
        # 支持传入 data URL(前端上传本地图片)或 http(s) URL
        kwargs["image_url"] = req.image  # 图片 URL
    if req.quality:  # 质量/速度模式
        kwargs["quality"] = req.quality  # 传入
    if req.with_audio is not None:  # 音频开关
        kwargs["with_audio"] = req.with_audio  # 传入
    if req.size:  # 分辨率
        kwargs["size"] = req.size  # 传入
    if req.duration:  # 时长
        kwargs["duration"] = req.duration  # 传入
    if req.fps:  # 帧率
        kwargs["fps"] = req.fps  # 传入
    if req.aspect_ratio:  # 宽高比
        kwargs["aspect_ratio"] = req.aspect_ratio  # 传入
    if req.movement_amplitude:  # 运动幅度
        kwargs["movement_amplitude"] = req.movement_amplitude  # 传入
    kwargs["watermark_enabled"] = req.watermark_enabled  # 水印开关

    resp = client.videos.generations(**kwargs)  # 提交视频生成任务
    return resp  # 返回提交响应


def serialize_task(resp: Any) -> dict[str, Any]:
    """把 SDK 提交响应转为可 JSON 序列化的 dict(提交阶段,未必有 video_result)。"""
    def safe_list(v: Any) -> list[dict[str, Any]]:  # 内联辅助:安全转列表
        items = []  # 输出列表
        if v:  # 非空
            for r in v:  # 遍历每个结果
                items.append({
                    "url": getattr(r, "url", None),  # 视频 URL
                    "cover_image_url": getattr(r, "cover_image_url", None),  # 封面 URL
                })
        return items  # 返回列表

    return {  # 返回序列化的 dict
        "id": getattr(resp, "id", None),  # 任务 ID
        "model": getattr(resp, "model", model_str()),  # 模型名
        "task_status": getattr(resp, "task_status", "PROCESSING"),  # 任务状态
        "request_id": getattr(resp, "request_id", None),  # 请求 ID
        "video_result": safe_list(getattr(resp, "video_result", None)),  # 视频结果列表
    }


def model_str() -> str:
    """供 serialize_task 内引用的全局模型名。"""
    return MODEL  # 返回全局模型名


def retrieve_result(task_id: str) -> Any:
    """同步轮询任务结果(在线程池中执行)。"""
    return client.videos.retrieve_videos_result(task_id)  # 查询任务结果


@app.post("/generate")  # POST /generate 提交任务
async def generate(req: GenerateRequest):
    """提交视频生成任务:立即返回 task id,不等待生成完成。"""
    model = req.model or MODEL  # 请求未指定模型时回退到全局默认
    prompt = req.prompt.strip()  # 去除首尾空白
    if not prompt:  # 提示词为空
        return JSONResponse({"error": "prompt 不能为空"}, status_code=400)  # 返回 400

    try:
        resp = await run_in_threadpool(call_generations, req, model)  # 线程池提交任务
        task = serialize_task(resp)  # 序列化响应
        tid = task.get("id")  # 获取任务 ID
        if tid:  # 有任务 ID
            _TASKS[tid] = {  # 记录到内存表
                "prompt": prompt,  # 提示词
                "image": bool(req.image),  # 是否图生视频
                "model": model,  # 模型名
                "submitted_at": int(time.time()),  # 提交时间戳
            }
        return {"task": task, "params": {  # 返回任务与参数
            "prompt": prompt, "quality": req.quality, "with_audio": req.with_audio,
            "size": req.size, "duration": req.duration, "fps": req.fps,
            "aspect_ratio": req.aspect_ratio, "movement_amplitude": req.movement_amplitude,
        }}
    except Exception as e:  # noqa: BLE001
        return JSONResponse(  # 返回 500 错误
            {"error": f"{type(e).__name__}: {e}", "prompt": prompt},  # 错误信息
            status_code=500,  # 状态码
        )


@app.get("/status/{task_id}")  # GET /status/{task_id} 查询状态
async def status(task_id: str):
    """查询任务状态(供前端轮询)。"""
    if not task_id:  # 缺少 task_id
        return JSONResponse({"error": "缺少 task_id"}, status_code=400)  # 返回 400
    try:
        resp = await run_in_threadpool(retrieve_result, task_id)  # 线程池查询结果
        task = serialize_task(resp)  # 序列化响应
        task["meta"] = _TASKS.get(task_id, {})  # 附加元信息
        return {"task": task}  # 返回任务状态
    except Exception as e:  # noqa: BLE001
        return JSONResponse(  # 返回 500 错误
            {"error": f"{type(e).__name__}: {e}", "task_id": task_id},  # 错误信息
            status_code=500,  # 状态码
        )


@app.post("/save")  # POST /save 保存文件
async def save_file(req: SaveRequest):
    """把生成视频/封面保存到本地 uploads/cogvideox/,返回可访问路径。"""
    try:
        if req.kind == "cover":  # 封面图
            ext = "jpg"  # 默认 jpg
            mime = req.mime or "image/jpeg"  # 默认 image/jpeg
        else:  # 视频
            ext = "mp4"  # 默认 mp4
            mime = req.mime or "video/mp4"  # 默认 video/mp4
        if req.mime:  # 若指定 MIME
            ext = req.mime.split("/")[-1].split("+")[0] or ext  # 从 MIME 推断扩展名

        filename = f"cogvideox_{req.kind}_{int(time.time())}_{uuid.uuid4().hex[:6]}.{ext}"  # 生成唯一文件名
        filepath = UPLOAD_DIR / filename  # 完整路径

        if req.base64:  # base64 保存
            data = req.base64  # 原始数据
            if "," in data and data.startswith("data:"):  # 含 data: 前缀
                data = data.split(",", 1)[1]  # 去除前缀
            filepath.write_bytes(base64.b64decode(data))  # 解码并写入文件
        elif req.url:  # URL 下载
            # 下载远程文件(视频体积较大,放宽超时)
            async with httpx.AsyncClient(timeout=300.0) as http:  # 创建异步 HTTP 客户端,超时 300s
                r = await http.get(req.url)  # GET 请求
                r.raise_for_status()  # 检查状态码
                filepath.write_bytes(r.content)  # 写入文件
        else:  # 既无 base64 也无 url
            return JSONResponse({"error": "需提供 url 或 base64"}, status_code=400)  # 返回 400

        return {"saved": True, "path": f"/uploads/cogvideox/{filename}", "filename": filename}  # 返回保存信息
    except Exception as e:  # noqa: BLE001
        return JSONResponse({"error": f"{type(e).__name__}: {e}"}, status_code=500)  # 返回 500


# 静态访问已保存文件
@app.get("/uploads/cogvideox/{filename}")  # GET /uploads/cogvideox/{filename}
async def serve_uploaded(filename: str):
    path = UPLOAD_DIR / filename  # 定位文件
    if not path.is_file():  # 文件不存在
        return JSONResponse({"error": "文件不存在"}, status_code=404)  # 返回 404
    return FileResponse(path)  # 返回文件响应


@app.get("/")  # GET / 首页
async def index():
    """首页:返回独立 HTML 视频生成页面。"""
    html_path = PROJECT_ROOT / "templates" / "chat_video.html"  # 定位模板
    return HTMLResponse(html_path.read_text(encoding="utf-8"))  # 返回 HTML 内容


@app.get("/health")  # GET /health 健康检查
async def health():
    return {"status": "ok", "model": MODEL}  # 返回状态与当前模型名


# ========== 入口 ==========
if __name__ == "__main__":  # 直接运行本文件时
    config = uvicorn.Config(app, host="127.0.0.1", port=8004)  # 配置 uvicorn(本地 8004)
    server = uvicorn.Server(config)  # 创建服务器实例
    asyncio.run(server.serve())  # 启动事件循环并运行
3.2 代码讲解
(1)两个 SDK 调用
# 提交任务
resp = client.videos.generations(model=..., prompt=..., image_url=..., ...)
# 查询结果
resp = client.videos.retrieve_videos_result(task_id)
提交时返回的 resp.id 就是任务 ID,后续用它轮询。
(2)按需组装参数
kwargs: dict[str, Any] = dict(model=model, prompt=req.prompt)
if req.image:
    kwargs["image_url"] = req.image
if req.quality:
    kwargs["quality"] = req.quality
# ... 其余参数按需加入
为什么用 if 判断?因为有些参数传空字符串可能被服务端拒绝,只传非空的更安全。
(3)内存任务表
_TASKS: dict[str, dict[str, Any]] = {}

@app.post("/generate")
async def generate(req):
    ...
    _TASKS[tid] = {"prompt": prompt, "image": bool(req.image), "model": model, "submitted_at": int(time.time())}

@app.get("/status/{task_id}")
async def status(task_id: str):
    ...
    task["meta"] = _TASKS.get(task_id, {})
用全局字典记录每次提交的参数。查询状态时附加 meta 字段返回。注意:重启后丢失(生产环境应改用数据库)。
(4)序列化函数的安全取值
def serialize_task(resp: Any) -> dict[str, Any]:
    def safe_list(v: Any) -> list[dict[str, Any]]:
        items = []
        if v:
            for r in v:
                items.append({
                    "url": getattr(r, "url", None),
                    "cover_image_url": getattr(r, "cover_image_url", None),
                })
        return items

    return {
        "id": getattr(resp, "id", None),
        "model": getattr(resp, "model", model_str()),
        "task_status": getattr(resp, "task_status", "PROCESSING"),
        "request_id": getattr(resp, "request_id", None),
        "video_result": safe_list(getattr(resp, "video_result", None)),
    }
提交阶段 video_result 通常为空,查询成功阶段才有。用 getattr + safe_list 兼容两种情况。
(5)视频下载超时放宽
async with httpx.AsyncClient(timeout=300.0) as http: # 视频 300s 超时
视频文件比图片大得多,超时设 300 秒(5 分钟)。
四、前端实现:templates/chat_video.html
4.1 完整代码
在 templates/chat_video.html 写入以下代码(与原始项目完全一致):
篇幅原因 省略前端代码
4.2 前端关键讲解
(1)轮询循环
async function pollTask(taskId, params) {
    const deadline = Date.now() + MAX_POLL_MS;  // 10 分钟超时
    while (Date.now() < deadline) {
        setStage('任务处理中,正在轮询…', taskId);
        try {
            const r = await fetch(API_BASE + 'status/' + encodeURIComponent(taskId));
            const data = await r.json();
            const t = data.task || {};
            const status = (t.task_status || '').toUpperCase();
            if (status === 'SUCCESS') {
                removeLoading();
                renderResult(t, params);
                return true;
            }
            if (status === 'FAIL') {
                removeLoading();
                renderError('任务失败(FAIL)', params.prompt);
                return false;
            }
            // PROCESSING:继续轮询
            setStage('处理中… 状态:' + (status || 'PROCESSING'), taskId);
        } catch (e) {
            removeLoading();
            renderError(e.message, params.prompt);
            return false;
        }
        await new Promise(res => setTimeout(res, POLL_INTERVAL));  // 等 5 秒
    }
    // 超时
    removeLoading();
    renderError('轮询超时(超过 10 分钟)', params.prompt);
    return false;
}
关键点:
- 用
while (Date.now() < deadline)控制超时上限。 - 每 5 秒(
POLL_INTERVAL)请求一次/status/{id}。 - 三种状态分支:SUCCESS 渲染结果、FAIL 报错、PROCESSING 继续。
- 用
await new Promise(res => setTimeout(res, ms))实现异步等待。
(2)模式切换
modeSwitch.querySelectorAll('.seg').forEach(seg => {
    seg.addEventListener('click', () => {
        modeSwitch.querySelectorAll('.seg').forEach(s => s.classList.remove('active'));
        seg.classList.add('active');
        currentMode = seg.dataset.mode;
        imageField.style.display = currentMode === 'image' ? '' : 'none';
        if (currentMode === 'text') { imageDataUrl = null; resetDrop(); }
    });
});
点击「图生视频」时显示图片上传区,点击「文生视频」时隐藏并清空图片。
(3)图生视频的图片处理
function handleFile(file) {
    if (!file.type.startsWith('image/')) { showToast('请选择图片文件'); return; }
    const reader = new FileReader();
    reader.onload = () => {
        imageDataUrl = reader.result;  // base64 data URL
        dropEl.classList.add('has');
        dropEl.innerHTML = `<img src="${imageDataUrl}" alt="">`;
    };
    reader.readAsDataURL(file);
}
和第 2 课一样的 FileReader.readAsDataURL,这里只允许单张图片。
(4)视频播放器
<video controls playsinline ${coverUrl ? `poster="${escapeHtml(coverUrl)}"` : ''}>
    ${videoUrl ? `<source src="${escapeHtml(videoUrl)}" type="video/mp4">` : ''}
    您的浏览器不支持视频播放。
</video>
controls:显示播放控件。playsinline:移动端不全屏播放。poster:视频封面(加载前显示)。<source>:视频源地址。
五、运行与验证
5.1 启动
uv run python src/04_chat_bot_video.py
浏览器打开 http://127.0.0.1:8004
5.2 验证清单
- 页面打开,左侧控制面板,右侧空状态。
- 默认「文生视频」模式,图片上传区隐藏。
- 点击「图生视频」,图片上传区出现。
- 点击或拖拽图片到上传区,预览图片。
- 点击示例词填充提示词。
- 点击「生成视频」,按钮变「提交中…」,右侧出现加载卡片。
- 加载卡片显示旋转动画、计时器、任务 ID、阶段状态。
- 数十秒~数分钟后,加载卡片消失,出现视频结果卡片。
- 视频可播放,有控件。
- 点击「保存到本地」,Toast 提示保存路径。
- 点击「保存封面」,封面图保存成功。
- 点击「再次生成」用相同参数重新生成。
- 健康检查 http://127.0.0.1:8004/health 返回
cogvideox-flash。
5.3 注意事项
- 视频生成耗时较长(数十秒到数分钟),请耐心等待。
- 建议测试时用
speed质量模式 + 5 秒时长,生成更快。 - 图生视频时图片不要太大(建议 < 5MB)。
- 轮询超时上限 10 分钟。
5.4 用 curl 测试(提交 + 轮询)
# 提交任务
curl -X POST http://127.0.0.1:8004/generate -H "Content-Type: application/json" -d "{\"prompt\":\"一只小猫在草地上奔跑\",\"quality\":\"speed\",\"with_audio\":false,\"duration\":5,\"fps\":30,\"aspect_ratio\":\"16:9\"}"

# 返回的 task.id 记下来,替换下面的 TASK_ID
# 轮询状态
curl http://127.0.0.1:8004/status/TASK_ID
# 反复执行直到 task_status 为 SUCCESS
六、常见问题
Q1:轮询一直 PROCESSING 超过 10 分钟
A:可能任务排队中。检查网络,或换 speed 模式。超过 10 分钟前端会提示超时。
Q2:图生视频报错
A:检查图片格式(jpg/png)、大小(<5MB)。base64 data URL 必须完整。
Q3:视频播放不了
A:浏览器可能不支持 mp4。用 Chrome/Edge。检查 video URL 是否可访问。
Q4:保存的视频文件损坏
A:网络下载可能中断。看后端日志有无 httpx 异常。增大超时时间。
Q5:重启后任务状态丢失
A:_TASKS 是内存表,重启即丢失。这是教学项目的简化设计,生产应改用数据库。
七、本课小结
你掌握了最复杂的一课:
- 异步任务模式:提交 + 轮询 + 超时控制。
client.videos.generations+retrieve_videos_result两个 SDK 调用。- 前端
while + setTimeout轮询循环。 - 图生视频:图片上传转 base64 +
image_url参数。 <video>播放器 + poster 封面。- 保存视频/封面到本地(区分 kind)。
至此,四个核心功能全部学完!下一课写端到端测试 → 第 5 课:端到端测试。
第 5 课:端到端测试
本课你将编写一个端到端测试脚本,自动验证前四课的所有服务是否正常工作。
这不是单元测试,而是真实发起 HTTP 请求、接收 SSE 流、轮询任务状态的集成测试。
一、本课学习目标
- 用
httpx发起同步和流式 HTTP 请求。 - 解析 SSE 流的
data:行。 - 实现视频生成任务的轮询验证。
- 编写一个可汇总 PASS/FAIL 的测试报告。
二、测试策略
我们要测试四个服务(需要先启动它们):
| 测试 | 服务 | 端口 | 验证内容 |
|---|---|---|---|
| test_01_chat | 01_chat_bot | 8001 | SSE 流式文本聊天 |
| test_02_vision | 02_chat_bot_vision | 8002 | 视觉聊天(带图片) |
| test_03_image | 03_chat_bot_image | 8003 | 文生图 |
| test_04_video | 04_chat_bot_video | 8004 | 视频生成(提交+轮询) |
每个测试返回 True/False,最后汇总。
三、完整代码:tests/e2e_test.py
在 tests/e2e_test.py 写入以下代码(与原始项目完全一致):
"""端到端测试脚本:逐个测试四个 demo,每个测试间隔 30 秒"""
import httpx
import json
import time
import sys

def test_01_chat():
    """测试 01_chat_bot (8001) 文本聊天 SSE 流式"""
    print("\n" + "="*60)
    print("TEST 1: 01_chat_bot (8001) - 文本聊天 SSE 流式")
    print("="*60)
    url = "http://127.0.0.1:8001/chat"
    payload = {
        "messages": [{"role": "user", "content": "1+1等于几?请只回答数字"}],
        "thinking": False,
        "temperature": 0.7,
        "max_tokens": 256,
    }
    frame_types = []
    answer_text = ""
    t0 = time.time()
    try:
        with httpx.stream("POST", url, json=payload,
                          timeout=httpx.Timeout(connect=10, read=300, write=10, pool=10)) as r:
            r.raise_for_status()
            for line in r.iter_lines():
                if not line or not line.startswith("data: "):
                    continue
                data = json.loads(line[6:])
                ft = data.get("type")
                frame_types.append(ft)
                if ft == "answer_delta":
                    answer_text += data.get("content", "")
                elif ft == "usage":
                    print(f"  usage: {data['usage']}")
                elif ft == "error":
                    print(f"  ERROR: {data['message']}")
        elapsed = time.time() - t0
        print(f"  Frame types: {frame_types}")
        print(f"  Answer ({len(answer_text)} chars): {answer_text[:500]}")
        print(f"  Elapsed: {elapsed:.1f}s")
        ok = "answer_delta" in frame_types and bool(answer_text)
        print(f"  Result: {'PASS' if ok else 'FAIL'}")
        return ok
    except Exception as e:
        print(f"  EXCEPTION: {type(e).__name__}: {e}")
        print(f"  Result: FAIL")
        return False


def test_02_vision():
    """测试 02_chat_bot_vision (8002) 视觉聊天"""
    print("\n" + "="*60)
    print("TEST 2: 02_chat_bot_vision (8002) - 视觉聊天")
    print("="*60)
    url = "http://127.0.0.1:8002/chat"
    # 使用一个小的纯色 PNG base64(1x1 红色像素)
    red_pixel = "data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVR42mP8/5+hHgAHggJ/Pch4mwAAAABJRU5ErkJggg=="
    payload = {
        "messages": [{
            "role": "user",
            "content": [
                {"type": "text", "text": "这张图片是什么颜色的?只回答颜色名称"},
                {"type": "image_url", "image_url": {"url": red_pixel}},
            ],
        }],
        "thinking": False,
        "temperature": 0.7,
        "max_tokens": 256,
    }
    frame_types = []
    answer_text = ""
    t0 = time.time()
    try:
        with httpx.stream("POST", url, json=payload,
                          timeout=httpx.Timeout(connect=10, read=300, write=10, pool=10)) as r:
            r.raise_for_status()
            for line in r.iter_lines():
                if not line or not line.startswith("data: "):
                    continue
                data = json.loads(line[6:])
                ft = data.get("type")
                frame_types.append(ft)
                if ft == "answer_delta":
                    answer_text += data.get("content", "")
                elif ft == "usage":
                    print(f"  usage: {data['usage']}")
                elif ft == "error":
                    print(f"  ERROR: {data['message']}")
        elapsed = time.time() - t0
        print(f"  Frame types: {frame_types}")
        print(f"  Answer ({len(answer_text)} chars): {answer_text[:500]}")
        print(f"  Elapsed: {elapsed:.1f}s")
        ok = "answer_delta" in frame_types and bool(answer_text)
        print(f"  Result: {'PASS' if ok else 'FAIL'}")
        return ok
    except Exception as e:
        print(f"  EXCEPTION: {type(e).__name__}: {e}")
        print(f"  Result: FAIL")
        return False


def test_03_image():
    """测试 03_chat_bot_image (8003) 文生图"""
    print("\n" + "="*60)
    print("TEST 3: 03_chat_bot_image (8003) - 文生图")
    print("="*60)
    url = "http://127.0.0.1:8003/generate"
    payload = {
        "prompt": "一只可爱的橙色小猫,卡通风格",
        "size": "1024x1024",
        "n": 1,
    }
    t0 = time.time()
    try:
        r = httpx.post(url, json=payload, timeout=httpx.Timeout(connect=10, read=300, write=10, pool=10))
        elapsed = time.time() - t0
        print(f"  Status: {r.status_code}")
        data = r.json()
        print(f"  Model: {data.get('model')}")
        print(f"  Prompt: {data.get('prompt')}")
        images = data.get("images", [])
        print(f"  Images count: {len(images)}")
        for i, img in enumerate(images):
            has_url = bool(img.get("url"))
            has_b64 = bool(img.get("b64_json"))
            rp = img.get("revised_prompt") or ""
            print(f"  Image {i}: url={has_url}, b64={has_b64}, revised_prompt={rp[:80]}")
        print(f"  Elapsed: {elapsed:.1f}s")
        ok = r.status_code == 200 and len(images) > 0
        print(f"  Result: {'PASS' if ok else 'FAIL'}")
        return ok
    except Exception as e:
        print(f"  EXCEPTION: {type(e).__name__}: {e}")
        print(f"  Result: FAIL")
        return False


def test_04_video():
    """测试 04_chat_bot_video (8004) 视频生成"""
    print("\n" + "="*60)
    print("TEST 4: 04_chat_bot_video (8004) - 视频生成")
    print("="*60)
    url = "http://127.0.0.1:8004/generate"
    payload = {
        "prompt": "一只小猫在草地上奔跑",
        "quality": "speed",
        "with_audio": False,
        "duration": 5,
        "fps": 30,
        "aspect_ratio": "16:9",
    }
    t0 = time.time()
    try:
        # 1. 提交任务
        r = httpx.post(url, json=payload, timeout=httpx.Timeout(connect=10, read=60, write=10, pool=10))
        elapsed = time.time() - t0
        print(f"  Submit Status: {r.status_code}")
        data = r.json()
        task = data.get("task", {})
        task_id = task.get("id")
        task_status = task.get("task_status")
        print(f"  Task ID: {task_id}")
        print(f"  Task Status: {task_status}")
        print(f"  Submit Elapsed: {elapsed:.1f}s")
        if not task_id:
            print(f"  Result: FAIL (no task id)")
            return False

        # 2. 轮询任务状态
        status_url = f"http://127.0.0.1:8004/status/{task_id}"
        max_polls = 40  # 最多轮询 40 次
        poll_interval = 10  # 每 10 秒轮询一次
        final_status = None
        video_url = None
        for i in range(max_polls):
            time.sleep(poll_interval)
            r = httpx.get(status_url, timeout=httpx.Timeout(connect=10, read=60, write=10, pool=10))
            data = r.json()
            task = data.get("task", {})
            ts = task.get("task_status")
            vr = task.get("video_result", [])
            print(f"  Poll {i+1}: status={ts}, video_result={len(vr)}")
            if ts == "SUCCESS":
                final_status = ts
                if vr:
                    video_url = vr[0].get("url")
                    cover = vr[0].get("cover_image_url")
                    print(f"  Video URL: {video_url}")
                    print(f"  Cover URL: {cover}")
                break
            elif ts == "FAIL":
                final_status = ts
                break

        total_elapsed = time.time() - t0
        print(f"  Total Elapsed: {total_elapsed:.1f}s")
        ok = final_status == "SUCCESS"
        print(f"  Result: {'PASS' if ok else 'FAIL'}")
        return ok
    except Exception as e:
        print(f"  EXCEPTION: {type(e).__name__}: {e}")
        print(f"  Result: FAIL")
        return False


def main():
    results = {}

    # 健康检查
    print("Health checks...")
    for port in [8001, 8002, 8003, 8004]:
        try:
            r = httpx.get(f"http://127.0.0.1:{port}/health", timeout=5)
            print(f"  {port}: {r.json()}")
        except Exception as e:
            print(f"  {port}: FAIL - {e}")

    # 测试 1: 文本聊天
    results["01_chat_bot"] = test_01_chat()

    print("\n--- 等待 30 秒 ---")
    time.sleep(30)

    # 测试 2: 视觉聊天
    results["02_chat_bot_vision"] = test_02_vision()

    print("\n--- 等待 30 秒 ---")
    time.sleep(30)

    # 测试 3: 文生图
    results["03_chat_bot_image"] = test_03_image()

    print("\n--- 等待 30 秒 ---")
    time.sleep(30)

    # 测试 4: 视频生成
    results["04_chat_bot_video"] = test_04_video()

    # 汇总
    print("\n" + "="*60)
    print("SUMMARY")
    print("="*60)
    for name, ok in results.items():
        print(f"  {name}: {'PASS' if ok else 'FAIL'}")
    total = len(results)
    passed = sum(1 for v in results.values() if v)
    print(f"  Total: {passed}/{total} passed")
    if passed == total:
        print("\n  ALL TESTS PASSED")
    else:
        print(f"\n  {total - passed} TEST(S) FAILED")
    return 0 if passed == total else 1


if __name__ == "__main__":
    sys.exit(main())
四、代码讲解
4.1 健康检查
print("Health checks...")
for port in [8001, 8002, 8003, 8004]:
    try:
        r = httpx.get(f"http://127.0.0.1:{port}/health", timeout=5)
        print(f"  {port}: {r.json()}")
    except Exception as e:
        print(f"  {port}: FAIL - {e}")
先检查四个服务是否都在运行。如果某个端口没响应,对应测试会失败但不会中断整个脚本。
4.2 SSE 流式测试(test_01_chat / test_02_vision)
with httpx.stream("POST", url, json=payload, timeout=...) as r:
    r.raise_for_status()
    for line in r.iter_lines():
        if not line or not line.startswith("data: "):
            continue
        data = json.loads(line[6:])
        ft = data.get("type")
        frame_types.append(ft)
        if ft == "answer_delta":
            answer_text += data.get("content", "")
httpx.stream()是上下文管理器,进入后开始流式接收。r.iter_lines()逐行迭代(httpx 自动按\n切分)。line[6:]去掉"data: "前缀(注意是 6 个字符:d-a-t-a-:-空格)。- 收集所有帧类型,判断是否有
answer_delta且有回答文本。
测试 2(视觉)的区别仅在于 payload 包含图片 base64,其余逻辑完全相同。
4.3 文生图测试(test_03_image)
r = httpx.post(url, json=payload, timeout=...)
data = r.json()
images = data.get("images", [])
ok = r.status_code == 200 and len(images) > 0
普通 POST 请求,等待完整响应。判断状态码 200 且 images 列表非空。
4.4 视频生成测试(test_04_video)
# 1. 提交任务
r = httpx.post(url, json=payload, timeout=...)
task_id = r.json().get("task", {}).get("id")

# 2. 轮询
for i in range(max_polls):
    time.sleep(poll_interval)
    r = httpx.get(status_url, timeout=...)
    ts = r.json().get("task", {}).get("task_status")
    if ts == "SUCCESS":
        final_status = ts
        break
    elif ts == "FAIL":
        final_status = ts
        break

ok = final_status == "SUCCESS"
分两步:先提交拿 task_id,再循环轮询。最多轮询 40 次,每次间隔 10 秒(最多 400 秒约 6.7 分钟)。
4.5 汇总报告
for name, ok in results.items():
    print(f"  {name}: {'PASS' if ok else 'FAIL'}")
total = len(results)
passed = sum(1 for v in results.values() if v)
print(f"  Total: {passed}/{total} passed")
return 0 if passed == total else 1
return 0 表示全部通过,return 1 表示有失败。sys.exit(main()) 用返回值作为退出码,方便 CI 判断。
4.6 为什么测试间间隔 30 秒
print("\n--- 等待 30 秒 ---")
time.sleep(30)
智谱免费模型有并发/频率限制,连续调用可能触发限流。间隔 30 秒降低被限概率。
五、运行测试
5.1 前置条件
必须先启动四个后端服务。打开四个终端分别运行:
# 终端 1
uv run python src/01_chat_bot.py

# 终端 2
uv run python src/02_chat_bot_vision.py

# 终端 3
uv run python src/03_chat_bot_image.py

# 终端 4
uv run python src/04_chat_bot_video.py
每个终端看到 Uvicorn running on http://127.0.0.1:800X 即启动成功。
5.2 运行测试
新开一个终端:
uv run python tests/e2e_test.py
5.3 预期输出示例
Health checks...
  8001: {'status': 'ok', 'model': 'glm-4.7-flash'}
  8002: {'status': 'ok', 'model': 'glm-4.6v-flash'}
  8003: {'status': 'ok', 'model': 'cogview-3-flash'}
  8004: {'status': 'ok', 'model': 'cogvideox-flash'}

============================================================
TEST 1: 01_chat_bot (8001) - 文本聊天 SSE 流式
============================================================
  usage: {'prompt_tokens': 20, 'completion_tokens': 5, 'total_tokens': 25}
  Frame types: ['start', 'answer_start', 'answer_delta', 'usage', 'finish', 'done']
  Answer (3 chars): 1+1=2
  Elapsed: 1.5s
  Result: PASS

--- 等待 30 秒 ---

============================================================
TEST 2: 02_chat_bot_vision (8002) - 视觉聊天
============================================================
  ...
  Result: PASS

--- 等待 30 秒 ---

============================================================
TEST 3: 03_chat_bot_image (8003) - 文生图
============================================================
  Status: 200
  Model: cogview-3-flash
  Images count: 1
  Image 0: url=True, b64=False, revised_prompt=一只可爱的橙色小猫...
  Elapsed: 8.2s
  Result: PASS

--- 等待 30 秒 ---

============================================================
TEST 4: 04_chat_bot_video (8004) - 视频生成
============================================================
  Submit Status: 200
  Task ID: 1234567890
  Task Status: PROCESSING
  Submit Elapsed: 1.2s
  Poll 1: status=PROCESSING, video_result=0
  Poll 2: status=PROCESSING, video_result=0
  Poll 3: status=SUCCESS, video_result=1
  Video URL: https://...
  Cover URL: https://...
  Total Elapsed: 35.4s
  Result: PASS

============================================================
SUMMARY
============================================================
  01_chat_bot: PASS
  02_chat_bot_vision: PASS
  03_chat_bot_image: PASS
  04_chat_bot_video: PASS
  Total: 4/4 passed

  ALL TESTS PASSED
六、常见问题
Q1:健康检查全部 FAIL
A:四个服务没启动。按 5.1 先启动它们。
Q2:测试 1/2 返回 422
A:请求体校验失败。检查 payload 字段名是否与后端 Pydantic 模型一致。
Q3:测试 3 返回 500
A:文生图接口异常。看后端终端日志,可能是 API Key 错误或模型名错误。
Q4:测试 4 一直 PROCESSING 直到超时
A:视频生成排队中。延长 max_polls 或 poll_interval,或换 speed 模式。
Q5:测试 4 报 FAIL 但后端日志显示 SUCCESS
A:可能轮询时网络抖动。增加重试逻辑或延长超时。
七、本课小结
你掌握了:
- 用
httpx.stream测试 SSE 流式接口。 - 用普通
httpx.post测试一次性接口。 - 实现视频任务的提交 + 轮询测试。
- 编写汇总报告并用退出码表示结果。
八、项目完成回顾
恭喜!你已经完成了整个项目。回顾一下你学会的:
| 课次 | 技能 |
|---|---|
| 总览 | 项目结构、uv 包管理、.env 配置 |
| 第 1 课 | FastAPI + SSE 流式 + 深度思考 + 前端流式读取 |
| 第 2 课 | 多模态消息 + 图片上传(粘贴/拖拽) + base64 |
| 第 3 课 | 同步阻塞调用线程池 + 文生图 + 图片下载落盘 |
| 第 4 课 | 异步任务 + 轮询 + 图生视频 + 视频播放 |
| 第 5 课 | httpx 流式测试 + 集成测试报告 |
你现在有能力独立编写:
- 基于 FastAPI 的 AI Web 服务。
- SSE 流式聊天前后端。
- 多模态 AI 应用。
- 异步任务型 AI 应用。
- 完整的端到端测试。
九、下一步建议
学完本教程后,你可以尝试:
- 接入更多模型:把
zaiSDK 换成 OpenAI SDK,适配其他模型。 - 持久化存储:把
_TASKS内存表换成 SQLite/MySQL(你的.env里已有 MySQL 配置)。 - 用户系统:加 JWT 认证(
.env里已有 JWT_SECRET 配置)。 - Docker 部署:写 Dockerfile 打包整个项目。
- 前端工程化:把单文件 HTML 升级为 React/Vue 项目。
祝学习愉快!
恭喜你读完全部教程!理论知识固然重要,但真正的成长来自于动手实践。建议你打开终端,从第一课开始逐行敲代码,把四个 AI 服务和测试脚本都跑通,遇到问题再回头查阅本教程——这样你才能真正掌握智谱 AI 免费模型的实战开发能力。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 5
 0
- 0


 已为社区贡献7条内容

所有评论(0)