Meta:具身智能中决策与控制的混淆难题
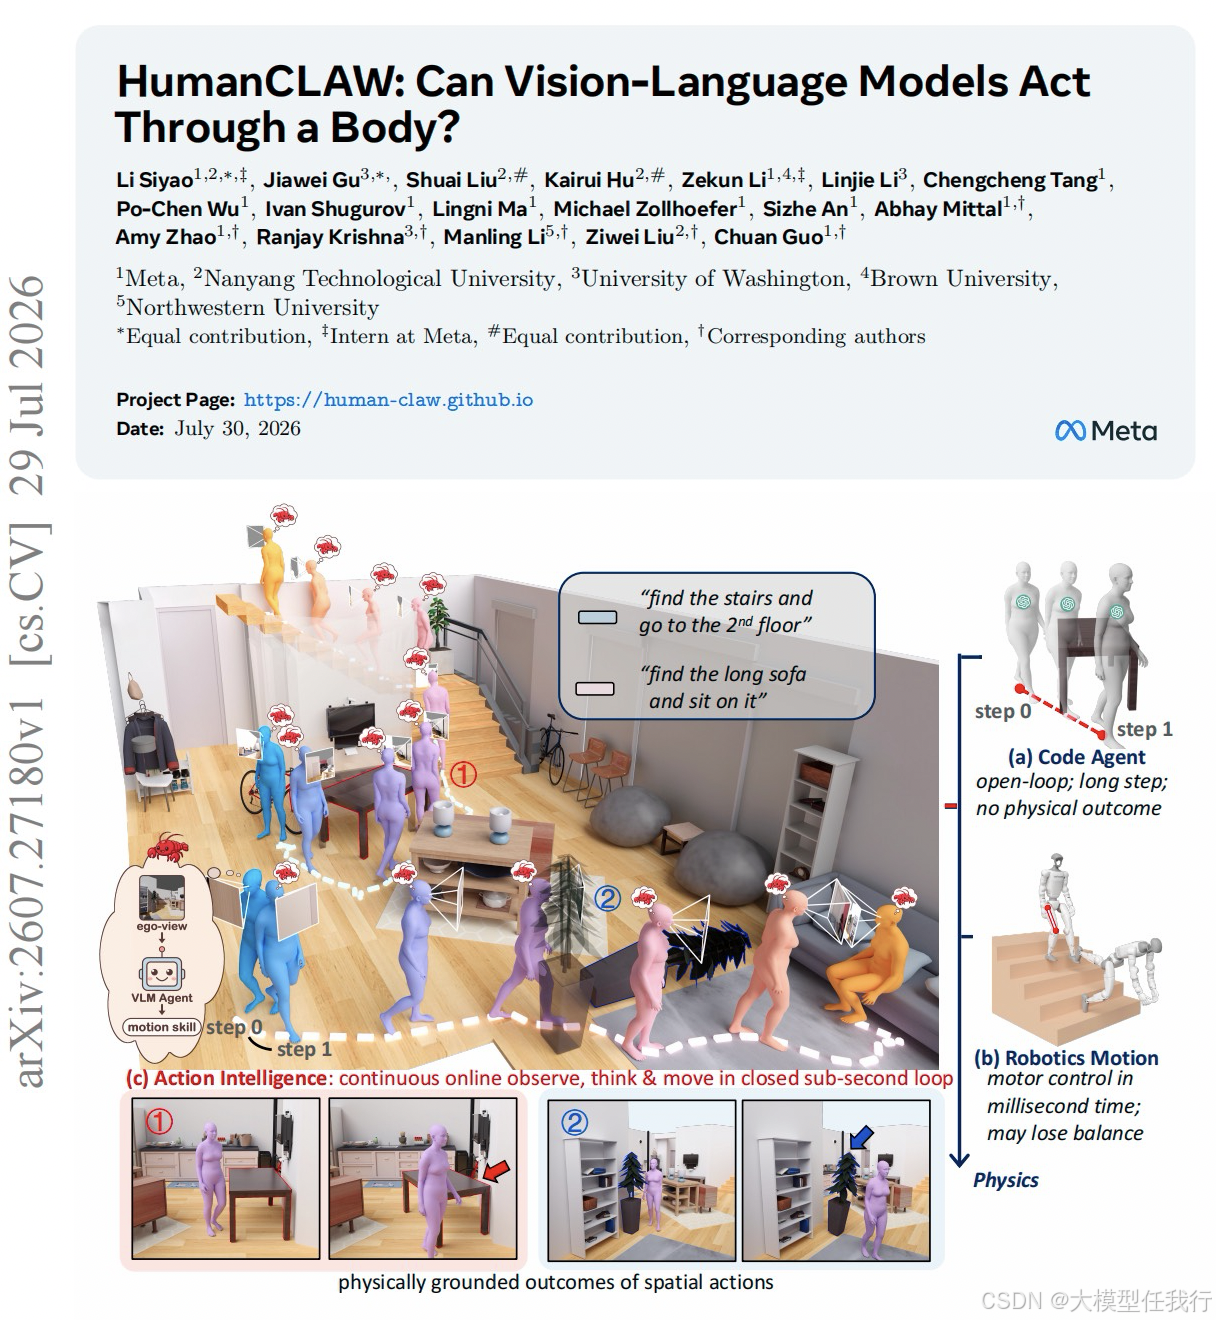
📖标题:HumanCLAW: Can Vision-Language Models Act Through a Body?
🌐来源:arXiv, 2607.27180v1
🛎️文章简介
🔸研究问题:现有视觉语言模型(VLM)能否通过物理身体执行动作,且如何区分是决策错误还是运动控制失败?
🔸主要贡献:论文提出HumanCLAW框架,将高层动作决策与底层运动执行解耦,构建基准测试揭示当前VLM缺乏具身自我意识。
📝重点思路
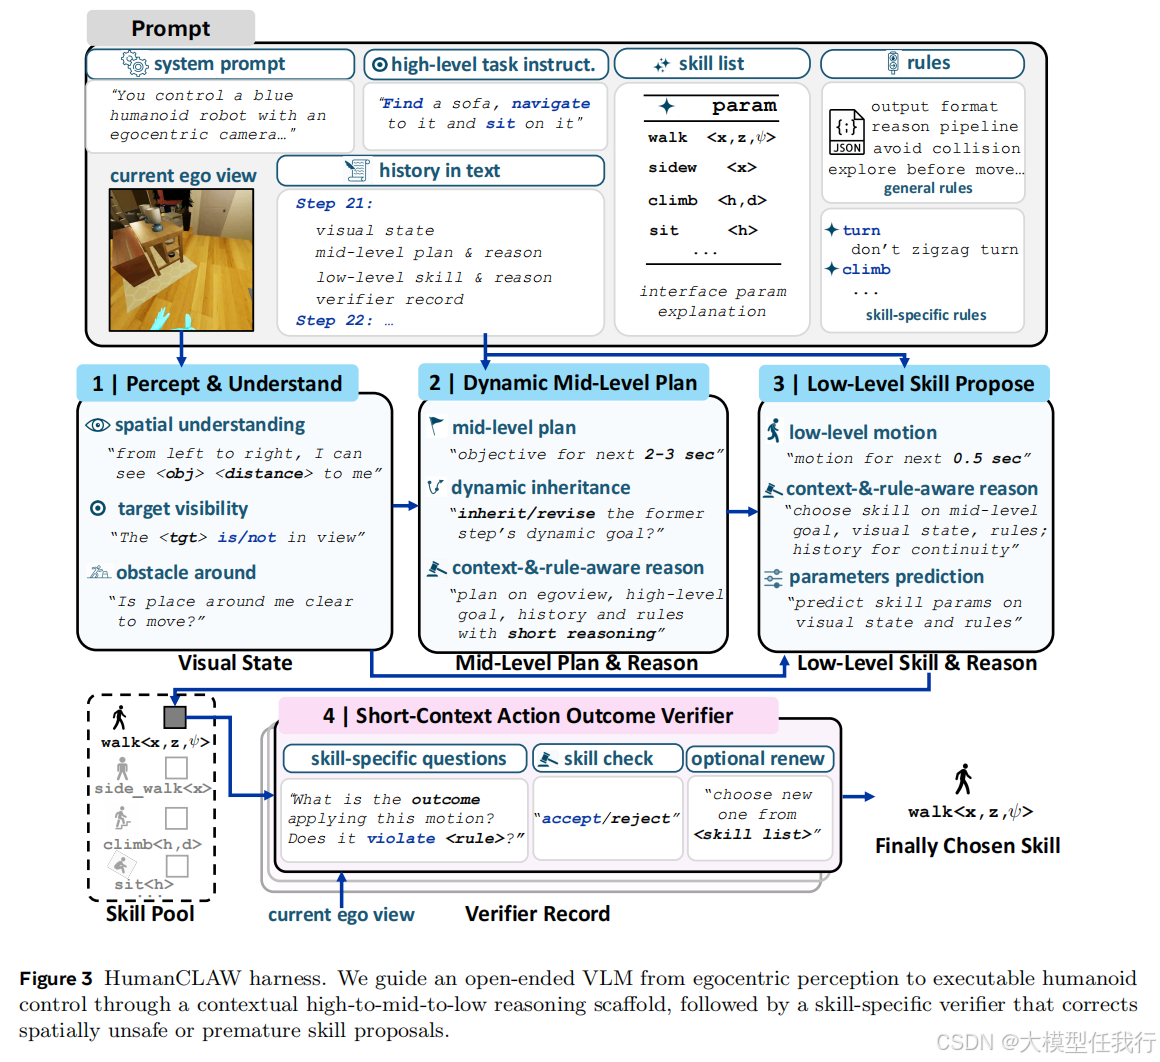
🔸构建解耦评估框架:利用现成VLM作为冻结的决策者,每步输出原子技能指令(如行走、转身),而非直接生成复杂轨迹。
🔸技能条件运动生成:开发基于DiT的运动基座模型和即插即用ControlNet适配器,将VLM的文本技能指令转化为符合物理规律的连续全身运动块。
🔸半物理仿真环境:采用半物理模拟器,保留重力、碰撞等物理后果,但排除平衡丧失和电机跟踪误差,确保失败归因于决策层面。
🔸建立HumanCLAW-Bench:包含1218个长视野第一人称寻找-导航-交互任务,覆盖41个室内场景,评估VLM在闭环中的行动智能。
🔎分析总结
🔸当前VLM无法解决基准:测试9种前沿VLM,最佳模型成功率仅16.8%,多数模型在导航和交互阶段大幅掉队。
🔸感知并非瓶颈:一旦目标进入视野,模型识别准确率极高,主要失败原因在于后续的行动决策。
🔸缺乏具身自我意识:核心缺陷在于模型无法追踪自身身体状态,常出现“空中坐”、撞墙不知停、到达未察觉等空间定位错误。
🔸推理脚手架至关重要:消融实验显示,移除技能验证器会导致导航成功率骤降,而增加历史图像帧数反而可能降低性能,紧凑的文本历史和中级目标推理最有效。
💡个人观点
论文通过“半物理仿真”和“原子技能接口”,解决了具身智能评估中决策与控制混淆的难题。其核心洞察极具启发性:当前VLM虽具备强大的场景理解力,却像“幽灵”一样缺乏对自身身体的本体感觉。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 15
 0
- 0


 已为社区贡献13条内容

所有评论(0)