PyTorch实战:基于深度学习的图像识别分类(附完整代码)
·
目录
1 CIFAR10数据集下载
直接使用代码下载
train_data = torchvision.datasets.CIFAR10(root='../dataset_transforms', train=True, transform=transform, download=True)
test_data = torchvision.datasets.CIFAR10(root='../dataset_transforms', train=False, transform=transform, download=True)
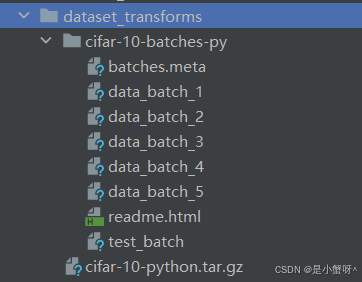
下载之后的文件目录:
2 实操
ps: 以下代码全部写在一个 .py 文件中
(1)数据预处理操作:
# 1.预处理
transform = torchvision.transforms.Compose([
    torchvision.transforms.ToTensor()
])
(2)加载数据集
# 2. 加载数据集
train_data = torchvision.datasets.CIFAR10(root='../dataset_transforms', train=True, transform=transform, download=True)
test_data = torchvision.datasets.CIFAR10(root='../dataset_transforms', train=False, transform=transform, download=True)

print(len(train_data))
print(len(test_data))

train_loader = torch.utils.data.DataLoader(train_data, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(test_data, batch_size=64, shuffle=True)
(3) 构建神经网络模型
# 3.定义模型
class Model(nn.Module):
    def __init__(self):
        super(Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 64, 5, 1, 2)
        self.batchNorm1 = nn.BatchNorm2d(64)
        self.relu1 = nn.ReLU()
        self.maxpool1 = nn.MaxPool2d(2)

        self.conv2 = nn.Conv2d(64, 64, 5, 1, 2)
        self.batchNorm2 = nn.BatchNorm2d(64)
        self.relu2 = nn.ReLU()
        self.maxpool2 = nn.MaxPool2d(2)

        self.conv3 = nn.Conv2d(64, 128, 5, 1, 2)
        self.batchNorm3 = nn.BatchNorm2d(128)
        self.relu3 = nn.ReLU()
        self.maxpool3 = nn.MaxPool2d(2)

        self.conv4 = nn.Conv2d(128, 128, 5, 1, 2)
        self.batchNorm4 = nn.BatchNorm2d(128)
        self.relu4 = nn.ReLU()
        self.maxpool4 = nn.MaxPool2d(2)

        self.flatten = nn.Flatten()
        self.linear1 = nn.Linear(128 * 2 * 2, 128)
        self.relu5 = nn.ReLU()
        self.dropout = nn.Dropout(0.5)  # 添加Dropout层,丢弃率为0.5
        self.linear2 = nn.Linear(128, 10)

    def forward(self, x):
        x = self.conv1(x)
        x = self.batchNorm1(x)
        x = self.relu1(x)
        x = self.maxpool1(x)

        x = self.conv2(x)
        x = self.batchNorm2(x)
        x = self.relu2(x)
        x = self.maxpool2(x)

        x = self.conv3(x)
        x = self.batchNorm3(x)
        x = self.relu3(x)
        x = self.maxpool3(x)

        x = self.conv4(x)
        x = self.batchNorm4(x)
        x = self.relu4(x)
        x = self.maxpool4(x)

        x = self.flatten(x)
        x = self.linear1(x)
        x = self.relu5(x)
        x = self.dropout(x)
        x = self.linear2(x)

        return x


model = Model()

loss = nn.CrossEntropyLoss()  # 损失函数使用交叉熵损失函数
# 优化器: 使用随机梯度下降
optimizer = torch.optim.SGD(model.parameters(), lr=0.14)  # lr:学习率
scheduler = StepLR(optimizer, step_size=10, gamma=0.5)  # 学习率调度器,每10个epoch将学习率减半

# 将模型放在 GPU 上跑
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = model.to(device)

writer = SummaryWriter("../nn_classify_image_logs")  # 创建 SummaryWriter 对象,用于记录训练过程中的数据
(4) 训练模型
# 4.训练模型
def train():
    epochs = 10
    total_train_num = 0
    model.train()
    for epoch in range(epochs):
        for data in train_loader:
            imgs, targets = data
            imgs = imgs.to(device)
            targets = targets.to(device)
            model_predict = model(imgs)
            _, predicted = torch.max(model_predict, 1)
            loss_result = loss(model_predict, targets)

            # 优化模型
            optimizer.zero_grad()
            loss_result.backward()
            optimizer.step()

            total_train_num += 1
            if total_train_num % 100 == 0:
                print("Epoch: {}, Loss: {}".format(epoch + 1, loss_result.item()))
                writer.add_scalar("train_loss", loss_result.item(), total_train_num)  # 记录训练损失
                torch.save(model.state_dict(), './model/model.pth')  # 保存模型参数
                torch.save(optimizer.state_dict(), './model/optimizer.pth')  # 保存优化器参数
                print("模型参数已保存")
                print("优化器参数已保存")
                print("训练完成")
            # 计算预测正确的数量
            # total_train_correct += (predicted == targets).sum().item()
            # total_train_loss += loss_result.item()

        # print("Total train loss: {}".format(total_train_loss))


# train()
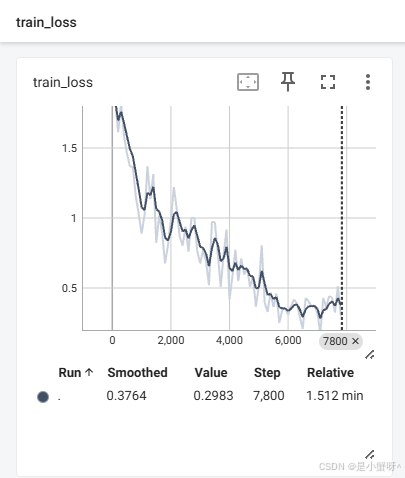
训练时的可视化图像:
(5) 测试模型
# 5.测试模型
def test():
    model.load_state_dict(torch.load('./model/model.pth'))
    model.eval()
    total_test_num = 0
    total_test_correct = 0
    total_test_loss = 0
    with torch.no_grad():
        for imgs, targets in test_loader:
            imgs = imgs.to(device)
            targets = targets.to(device)
            model_predict = model(imgs)
            _, predicted = torch.max(model_predict, 1)
            loss_result = loss(model_predict, targets)
            total_test_num += imgs.size(0)
            total_test_correct += (predicted == targets).sum().item()
            total_test_loss += loss_result.item()

            if total_test_num % 100 == 0:
                print("Test_Nums: {}, Loss: {}".format(total_test_num, loss_result.item()))
                writer.add_scalar("Test Loss", loss_result.item(), total_test_num)
                print("Test Accuracy: {}".format(total_test_correct / total_test_num))  # 该批次预测的准确度
                writer.add_scalar("Test Accuracy", total_test_correct / total_test_num, total_test_num)

        print("Test Total Accuracy: {}".format(total_test_correct / total_test_num))  # 总预测的准确度
        print("Test Total Loss: {}".format(total_test_loss / len(test_loader)))


# test()
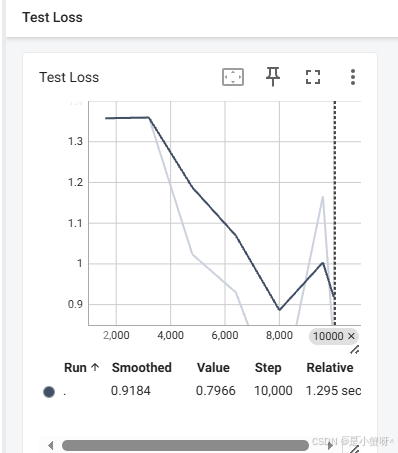
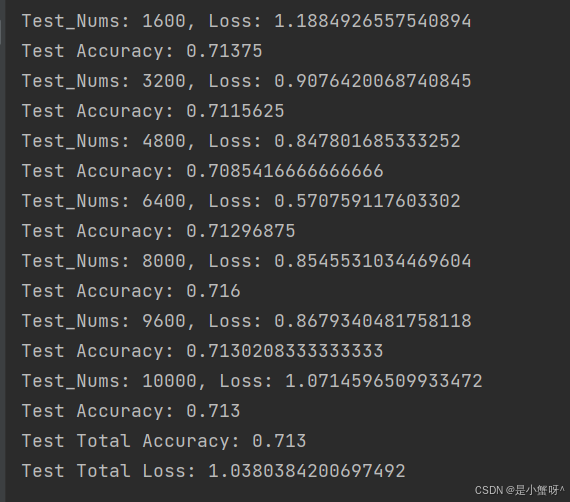
测试时的可视化图像:
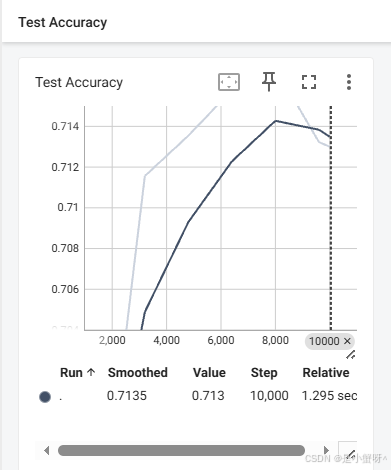
整体的测试精确度才71%左右,较低:
(6)测试自己的图片
# 6.测试自己的图片
def test_my_image():
    model.load_state_dict(torch.load('./model/model.pth'))
    model.eval()  # 设置为评估模式
    # 定义图像预处理
    transform_image = torchvision.transforms.Compose([
        torchvision.transforms.Resize((32, 32)),  # 调整图像大小为 28x28
        torchvision.transforms.ToTensor(),  # 转换为张量并归一化到 [0, 1]
    ])

    # 加载自己的图片
    img = Image.open('./test_images/deer.png')
    img = img.convert('RGB')
    img = transform_image(img)

    img = img.unsqueeze(0)  # 形状变为 [1, 1, 28, 28]
    img = img.to(device)

    class_names = ["airplane", "automobile", "bird", "cat", "deer", "dog", "frog", "horse", "ship", "truck"]
    with torch.no_grad():
        model_predict = model(img)
        _, predicted = torch.max(model_predict, 1)
        print("预测结果为:", class_names[predicted.item()])  # 输出预测结果
        print("真实结果为:deer")  # 输出真实结果


# test_my_image()
总结:该模型预测的准确度仍需改进,欢迎指正,交流学习!
3 附完整代码
import torch
import torchvision
from PIL import Image
from torch import nn
from torch.optim.lr_scheduler import StepLR
from torch.utils.tensorboard import SummaryWriter

# 1.预处理
transform = torchvision.transforms.Compose([
    torchvision.transforms.ToTensor()
])

# 2. 加载数据集
train_data = torchvision.datasets.CIFAR10(root='../dataset_transforms', train=True, transform=transform, download=True)
test_data = torchvision.datasets.CIFAR10(root='../dataset_transforms', train=False, transform=transform, download=True)

print(len(train_data))
print(len(test_data))

train_loader = torch.utils.data.DataLoader(train_data, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(test_data, batch_size=64, shuffle=True)


# 3.定义模型
class Model(nn.Module):
    def __init__(self):
        super(Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 64, 5, 1, 2)
        self.batchNorm1 = nn.BatchNorm2d(64)
        self.relu1 = nn.ReLU()
        self.maxpool1 = nn.MaxPool2d(2)

        self.conv2 = nn.Conv2d(64, 64, 5, 1, 2)
        self.batchNorm2 = nn.BatchNorm2d(64)
        self.relu2 = nn.ReLU()
        self.maxpool2 = nn.MaxPool2d(2)

        self.conv3 = nn.Conv2d(64, 128, 5, 1, 2)
        self.batchNorm3 = nn.BatchNorm2d(128)
        self.relu3 = nn.ReLU()
        self.maxpool3 = nn.MaxPool2d(2)

        self.conv4 = nn.Conv2d(128, 128, 5, 1, 2)
        self.batchNorm4 = nn.BatchNorm2d(128)
        self.relu4 = nn.ReLU()
        self.maxpool4 = nn.MaxPool2d(2)

        self.flatten = nn.Flatten()
        self.linear1 = nn.Linear(128 * 2 * 2, 128)
        self.relu5 = nn.ReLU()
        self.dropout = nn.Dropout(0.5)  # 添加Dropout层,丢弃率为0.5
        self.linear2 = nn.Linear(128, 10)

    def forward(self, x):
        x = self.conv1(x)
        x = self.batchNorm1(x)
        x = self.relu1(x)
        x = self.maxpool1(x)

        x = self.conv2(x)
        x = self.batchNorm2(x)
        x = self.relu2(x)
        x = self.maxpool2(x)

        x = self.conv3(x)
        x = self.batchNorm3(x)
        x = self.relu3(x)
        x = self.maxpool3(x)

        x = self.conv4(x)
        x = self.batchNorm4(x)
        x = self.relu4(x)
        x = self.maxpool4(x)

        x = self.flatten(x)
        x = self.linear1(x)
        x = self.relu5(x)
        x = self.dropout(x)
        x = self.linear2(x)

        return x


model = Model()

loss = nn.CrossEntropyLoss()  # 损失函数使用交叉熵损失函数
# 优化器: 使用随机梯度下降
optimizer = torch.optim.SGD(model.parameters(), lr=0.14)  # lr:学习率
scheduler = StepLR(optimizer, step_size=10, gamma=0.5)  # 学习率调度器,每10个epoch将学习率减半

# 将模型放在 GPU 上跑
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = model.to(device)

writer = SummaryWriter("../nn_classify_image_logs")  # 创建 SummaryWriter 对象,用于记录训练过程中的数据


# 4.训练模型
def train():
    epochs = 10
    total_train_num = 0
    model.train()
    for epoch in range(epochs):
        for data in train_loader:
            imgs, targets = data
            imgs = imgs.to(device)
            targets = targets.to(device)
            model_predict = model(imgs)
            _, predicted = torch.max(model_predict, 1)
            loss_result = loss(model_predict, targets)

            # 优化模型
            optimizer.zero_grad()
            loss_result.backward()
            optimizer.step()

            total_train_num += 1
            if total_train_num % 100 == 0:
                print("Epoch: {}, Loss: {}".format(epoch + 1, loss_result.item()))
                writer.add_scalar("train_loss", loss_result.item(), total_train_num)  # 记录训练损失
                torch.save(model.state_dict(), './model/model.pth')  # 保存模型参数
                torch.save(optimizer.state_dict(), './model/optimizer.pth')  # 保存优化器参数
                print("模型参数已保存")
                print("优化器参数已保存")
                print("训练完成")
            # 计算预测正确的数量
            # total_train_correct += (predicted == targets).sum().item()
            # total_train_loss += loss_result.item()

        # print("Total train loss: {}".format(total_train_loss))


# train()

# 5.测试模型
def test():
    model.load_state_dict(torch.load('./model/model.pth'))
    model.eval()
    total_test_num = 0
    total_test_correct = 0
    total_test_loss = 0
    with torch.no_grad():
        for imgs, targets in test_loader:
            imgs = imgs.to(device)
            targets = targets.to(device)
            model_predict = model(imgs)
            _, predicted = torch.max(model_predict, 1)
            loss_result = loss(model_predict, targets)
            total_test_num += imgs.size(0)
            total_test_correct += (predicted == targets).sum().item()
            total_test_loss += loss_result.item()

            if total_test_num % 100 == 0:
                print("Test_Nums: {}, Loss: {}".format(total_test_num, loss_result.item()))
                writer.add_scalar("Test Loss", loss_result.item(), total_test_num)
                print("Test Accuracy: {}".format(total_test_correct / total_test_num))  # 该批次预测的准确度
                writer.add_scalar("Test Accuracy", total_test_correct / total_test_num, total_test_num)

        print("Test Total Accuracy: {}".format(total_test_correct / total_test_num))  # 总预测的准确度
        print("Test Total Loss: {}".format(total_test_loss / len(test_loader)))


test()

# 6.测试自己的图片
def test_my_image():
    model.load_state_dict(torch.load('./model/model.pth'))
    model.eval()  # 设置为评估模式
    # 定义图像预处理
    transform_image = torchvision.transforms.Compose([
        torchvision.transforms.Resize((32, 32)),  # 调整图像大小为 28x28
        torchvision.transforms.ToTensor(),  # 转换为张量并归一化到 [0, 1]
    ])

    # 加载自己的图片
    img = Image.open('./test_images/deer.png')
    img = img.convert('RGB')
    img = transform_image(img)

    img = img.unsqueeze(0)  # 形状变为 [1, 1, 28, 28]
    img = img.to(device)

    class_names = ["airplane", "automobile", "bird", "cat", "deer", "dog", "frog", "horse", "ship", "truck"]
    with torch.no_grad():
        model_predict = model(img)
        _, predicted = torch.max(model_predict, 1)
        print("预测结果为:", class_names[predicted.item()])  # 输出预测结果
        print("真实结果为:deer")  # 输出真实结果


# test_my_image()

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)