LLaMA-Factory|微调大语言模型初探索(3),qlora微调deepseek记录
前言
上篇文章记录了使用lora微调llama-1b,微调成功,但是微调llama-8b显存爆炸,这次尝试使用qlora来尝试微调参数体量更大的大语言模型,看看64G显存的极限在哪里。
1.Why QLora?
- QLoRA 在模型加载阶段通过
4-bit量化大幅减少了模型权重的显存占用。 - QLoRA 通过 反量化到 BF16 进行训练,在保持计算精度的同时,进一步
节省显存和提高效率。 - QLoRA 在加载、训练、以及权重存储等多个方面都进行了优化,从而有效地
减少了显存使用。
总结:比Lora节省显存!!
2.LLaMA-Factory支持模型

如上图所示,这是LLaMA-Factory所有支持的大语言模型,你可以选择你感兴趣的模型进行微调。
LLaMA-Factory
3.尝试Llama-3.2-3B
-
下载Llama-3.2-3B-Instruct 链接
-
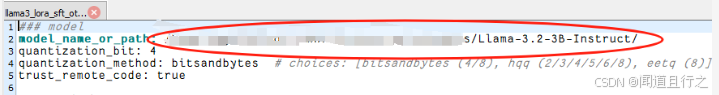
修改examples/train_qlora/llama3_lora_sft_otfq.yaml中的model_name_or_path:
-
开始微调
llamafactory-cli train examples/train_qlora/llama3_lora_sft_otfq.yaml
结果:

从当前的显存使用情况来看,每张显卡的显存使用率在“52%-63%”之间,显然显存并未完全被占用,我们仍有较大的空间可以尝试更高参数量的模型,进行更大规模的实验或训练。
3.尝试deepseek-llm-7b
- 下载deepseek-llm-7b 链接
- 修改examples/train_qlora/llama3_lora_sft_otfq.yaml
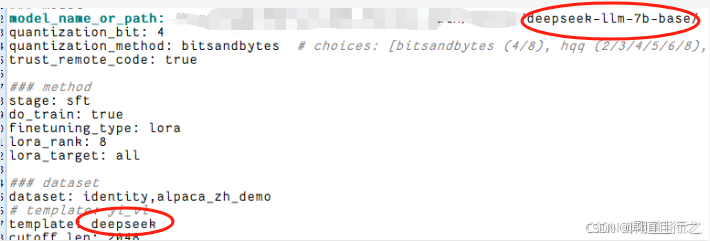
具体的template怎么设置名称,不知道的可以去看src/llamafactory/data/template.py。
- 开始微调
llamafactory-cli train examples/train_qlora/llama3_lora_sft_otfq.yaml
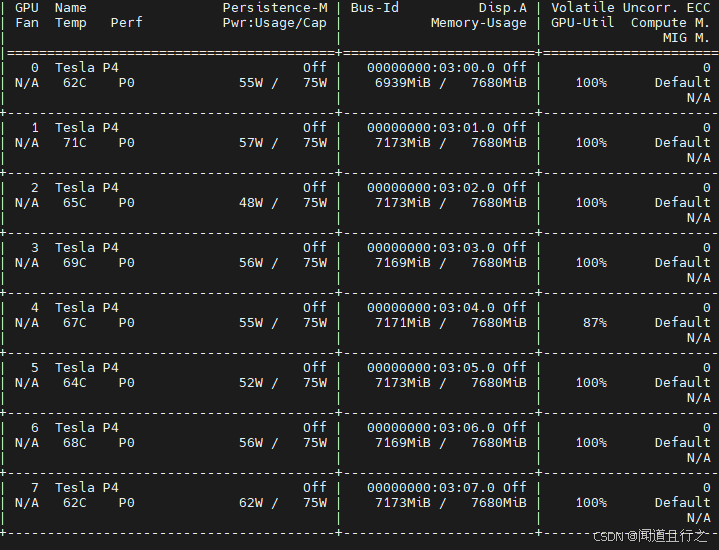
可以看到微调7B的deepseek已经是极限了,再多一点参数显存就会爆。
4.微调过程中的报错
Error1
You need to manually override the PyTorch CUDA version. Please see: "https://github.com/xxx.md
CUDA driver not installed
CUDA not installed
You have multiple conflicting CUDA libraries
Required library not pre-compiled for this bitsandbytes release!
…
bitsandbytes各种报错
解决办法:更新bitsandbytes到最新版本:
# 更新pip到最新版本
python -m pip install --upgrade pip
# 更新bitsandbytes到最新版本
pip install --upgrade bitsandbytes
Error2
微调下列其他模型时报错:AttributeError: ‘NoneType’ object has no attribute ‘image_seqlen’
- llava-1.5-7b
- Yi-VL-6B
解决办法:下载其hf版本,下面是链接: - llava-1.5-7b-hf
- Yi-VL-6B-hf
总结
- 使用
lora微调方法微调1b模型显存占用率甚至大于使用qlora微调3b模型。 - 训练方法
相同的情况下,不同显卡之间的显存使用量通常不完全相同,上述现存使用情况只能作为参考。 - 64g(Tesla P4*8)显存目前测试是只能微调7b模型,微调8b显存会爆掉(
CUDA out of memory)。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 29
 0
- 0


 已为社区贡献3条内容

所有评论(0)