机器学习——决策树
一、什么是决策树
你是否有过这样的经历:纠结要不要买一件衣服时,会依次思考 “价格是否在预算内?”“款式是否喜欢?”“材质是否舒适?”,每一个问题的答案都会引导你走向下一个判断,最终得出 “买” 或 “不买” 的结论。决策树(Decision Tree)正是这样一种模拟人类决策过程的机器学习算法,它将复杂的决策问题拆解为一系列简单的二元或多元判断,最终输出明确的结果。
从结构上看,决策树就像一棵倒置的 “树”:
- 根节点:整个决策的起点,对应最核心的第一个判断问题(比如 “价格≤500 元?”);
- 内部节点:中间的判断步骤,每个节点都代表一个特征的筛选(比如 “款式是休闲风?”);
- 叶节点:决策的终点,对应最终的分类结果(比如 “买”“不买”);
- 分支:每个判断的不同答案(是 / 否、A/B/C),引导着从一个节点走向下一个节点的路径。
举个更直观的例子:用决策树判断 “某动物是否为猫”。根节点可以是 “是否有毛发?”,若答案为 “否”,直接判定为 “非猫”(叶节点);若答案为 “是”,则进入下一个内部节点 “是否有尾巴?”,继续分支判断,直到最终得出结论。这种 “层层筛选” 的逻辑,让决策树既容易理解,又能高效处理分类问题。
二、决策树的核心:如何 “选对” 判断节点?
决策树的关键的是选择最优的特征作为每个节点的判断依据—— 如果选对了特征,能快速缩小范围、提高决策效率;如果选得不好,树会变得冗长,甚至出现 “过拟合”(只适配训练数据,泛化能力差)。
常用的 “特征选择指标” 有 3 个:
- 信息增益(ID3 算法):衡量 “某个特征能减少多少不确定性”。比如判断 “是否为猫” 时,“是否有毛发” 比 “是否会飞” 的信息增益更高(因为绝大多数猫有毛发,而 “会飞” 和 “是猫” 几乎无关),所以优先选 “是否有毛发” 作为节点。
- 信息增益比(C4.5 算法):解决信息增益 “偏爱多分类特征” 的问题。比如 “身份证号” 是多分类特征(每个值唯一),信息增益极高,但显然没有实际意义,信息增益比会对这种特征进行惩罚。
- 基尼系数(CART 算法):衡量 “数据的纯度”,基尼系数越小,数据越纯(比如全是 “猫” 的节点基尼系数为 0)。CART 算法用基尼系数选择最优特征,且只能生成二叉树(每个节点只有 “是 / 否” 两个分支),应用最广泛
三、决策树的构建步骤
构建决策树的步骤如下:
- 准备数据:收集训练数据,包含 “特征”(比如年龄、收入、是否浏览商品详情)和 “标签”(是否购买),确保数据无缺失、无异常。
- 选择根节点:计算所有特征的信息增益 / 基尼系数,选择最优特征作为根节点。
- 分裂分支:根据根节点的特征值分裂分支(比如 “是”“否” 两个分支),每个分支对应一个子集数据。
- 递归构建子树:对每个分支的子集数据,重复步骤 2-3,选择最优特征作为内部节点,继续分裂,直到满足停止条件。
- 停止条件:
- 某个节点的所有数据标签一致(比如全是 “是”),成为叶节点;
- 没有更多特征可用于分裂;
- 节点的数据量过少(避免过拟合)。
四、应用
以已下图片作为数据,来用决策树解决这个问题:
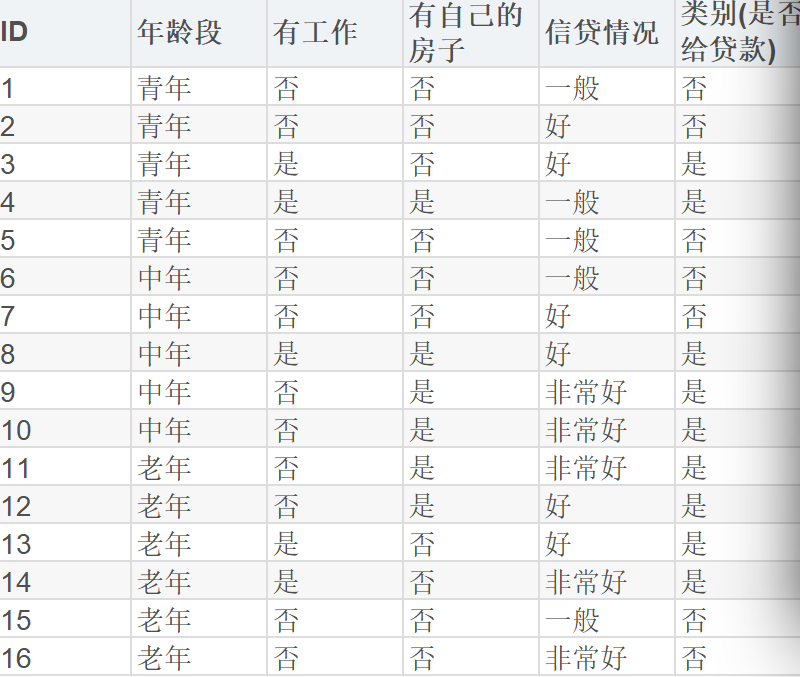
将数据集转化为数字标签:
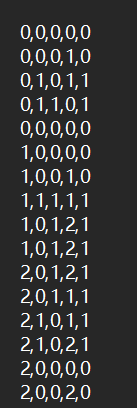
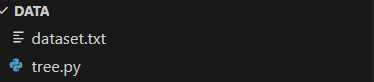
将数据集与代码保存在同一个文件夹中
完整代码:
import math
import pandas as pd
import numpy as np
from collections import Counter

class DecisionTree:
    def __init__(self, criterion='info_gain', max_depth=None):
        self.criterion = criterion  # 'info_gain' or 'gain_ratio'
        self.max_depth = max_depth
        self.tree = None
        self.feature_names = ['年龄段', '有工作', '有自己的房子', '信贷情况']

    def fit(self, X, y):
        self.tree = self._build_tree(X, y, depth=0)

    def predict(self, X):
        return [self._predict_single(x, self.tree) for x in X]

    def _entropy(self, y):
        """计算熵"""
        counter = Counter(y)
        entropy = 0.0
        for count in counter.values():
            p = count / len(y)
            entropy -= p * math.log2(p)
        return entropy

    def _information_gain(self, X, y, feature_idx):
        """计算信息增益"""
        base_entropy = self._entropy(y)

        # 获取该特征的所有取值
        feature_values = [x[feature_idx] for x in X]
        unique_values = set(feature_values)

        # 计算按该特征分割后的条件熵
        conditional_entropy = 0.0
        split_info = 0.0

        for value in unique_values:
            sub_y = [y[i] for i in range(len(X)) if X[i][feature_idx] == value]
            if len(sub_y) == 0:
                continue

            p = len(sub_y) / len(y)
            conditional_entropy += p * self._entropy(sub_y)

            # 计算分裂信息(用于增益率)
            if self.criterion == 'gain_ratio':
                split_info -= p * math.log2(p)

        info_gain = base_entropy - conditional_entropy

        if self.criterion == 'gain_ratio':
            if split_info == 0:  # 避免除零
                return 0
            return info_gain / split_info
        else:
            return info_gain

    def _majority_vote(self, y):
        """多数投票"""
        counter = Counter(y)
        return counter.most_common(1)[0][0]

    def _build_tree(self, X, y, depth):
        """递归构建决策树"""
        # 终止条件
        if len(set(y)) == 1:  # 所有样本属于同一类别
            return y[0]

        if len(X[0]) == 0:  # 没有特征了
            return self._majority_vote(y)

        if self.max_depth and depth >= self.max_depth:
            return self._majority_vote(y)

        # 选择最佳特征
        best_gain = -1
        best_feature = None

        for feature_idx in range(len(X[0])):
            gain = self._information_gain(X, y, feature_idx)
            if gain > best_gain:
                best_gain = gain
                best_feature = feature_idx

        if best_gain == 0:  # 没有信息增益
            return self._majority_vote(y)

        # 构建子树
        tree = {
            'feature': best_feature,
            'feature_name': self.feature_names[best_feature],
            'children': {}
        }

        # 按最佳特征的值分割数据
        feature_values = [x[best_feature] for x in X]
        unique_values = set(feature_values)

        for value in unique_values:
            sub_X = [x[:best_feature] + x[best_feature+1:] for i, x in enumerate(X) if X[i][best_feature] == value]
            sub_y = [y[i] for i in range(len(X)) if X[i][best_feature] == value]

            if len(sub_X) == 0:
                tree['children'][value] = self._majority_vote(y)
            else:
                tree['children'][value] = self._build_tree(sub_X, sub_y, depth + 1)

        return tree

    def _predict_single(self, x, tree):
        """预测单个样本"""
        if isinstance(tree, int):  # 叶节点
            return tree

        feature_value = x[tree['feature']]
        if feature_value in tree['children']:
            return self._predict_single(x, tree['children'][feature_value])
        else:
            # 如果遇到未见过的特征值,返回训练集中最常见的类别
            return 1  # 默认给贷款(根据数据分布调整)

def load_data(filename):
    """加载数据文件"""
    with open(filename, 'r') as f:
        lines = f.readlines()

    data = []
    for line in lines:
        line = line.strip()
        if line:
            values = list(map(int, line.split(',')))
            data.append(values)

    return data

def evaluate_model(y_true, y_pred):
    """评估模型性能"""
    accuracy = sum(1 for i in range(len(y_true)) if y_true[i] == y_pred[i]) / len(y_true)

    # 计算精确率、召回率、F1分数
    tp = sum(1 for i in range(len(y_true)) if y_true[i] == 1 and y_pred[i] == 1)
    fp = sum(1 for i in range(len(y_true)) if y_true[i] == 0 and y_pred[i] == 1)
    fn = sum(1 for i in range(len(y_true)) if y_true[i] == 1 and y_pred[i] == 0)

    precision = tp / (tp + fp) if (tp + fp) > 0 else 0
    recall = tp / (tp + fn) if (tp + fn) > 0 else 0
    f1 = 2 * precision * recall / (precision + recall) if (precision + recall) > 0 else 0

    return {
        'accuracy': accuracy,
        'precision': precision,
        'recall': recall,
        'f1_score': f1
    }

def print_tree(tree, indent=0):
    """打印决策树结构"""
    if isinstance(tree, int):
        print('  ' * indent + f'类别: {tree}')
    else:
        print('  ' * indent + f'特征: {tree["feature_name"]}')
        for value, subtree in tree['children'].items():
            print('  ' * (indent + 1) + f'值 {value}:')
            print_tree(subtree, indent + 2)

def main():
    # 加载数据
    train_data = load_data('dataset.txt')
    test_data = load_data('testset.txt')

    # 分离特征和标签
    X_train = [sample[:-1] for sample in train_data]
    y_train = [sample[-1] for sample in train_data]

    X_test = [sample[:-1] for sample in test_data]
    y_test = [sample[-1] for sample in test_data]

    print("=" * 60)
    print("决策树分类器 - 贷款审批预测")
    print("=" * 60)

    # 使用信息增益
    print("\n1. 使用信息增益作为特征选择标准:")
    print("-" * 40)

    dt_info_gain = DecisionTree(criterion='info_gain')
    dt_info_gain.fit(X_train, y_train)

    # 预测
    y_pred_info = dt_info_gain.predict(X_test)

    # 评估
    metrics_info = evaluate_model(y_test, y_pred_info)

    print(f"准确率: {metrics_info['accuracy']:.3f}")
    print(f"精确率: {metrics_info['precision']:.3f}")
    print(f"召回率: {metrics_info['recall']:.3f}")
    print(f"F1分数: {metrics_info['f1_score']:.3f}")

    print("\n决策树结构:")
    print_tree(dt_info_gain.tree)

    # 使用增益率
    print("\n\n2. 使用增益率作为特征选择标准:")
    print("-" * 40)

    dt_gain_ratio = DecisionTree(criterion='gain_ratio')
    dt_gain_ratio.fit(X_train, y_train)

    # 预测
    y_pred_ratio = dt_gain_ratio.predict(X_test)

    # 评估
    metrics_ratio = evaluate_model(y_test, y_pred_ratio)

    print(f"准确率: {metrics_ratio['accuracy']:.3f}")
    print(f"精确率: {metrics_ratio['precision']:.3f}")
    print(f"召回率: {metrics_ratio['recall']:.3f}")
    print(f"F1分数: {metrics_ratio['f1_score']:.3f}")

    print("\n决策树结构:")
    print_tree(dt_gain_ratio.tree)

    # 详细预测结果
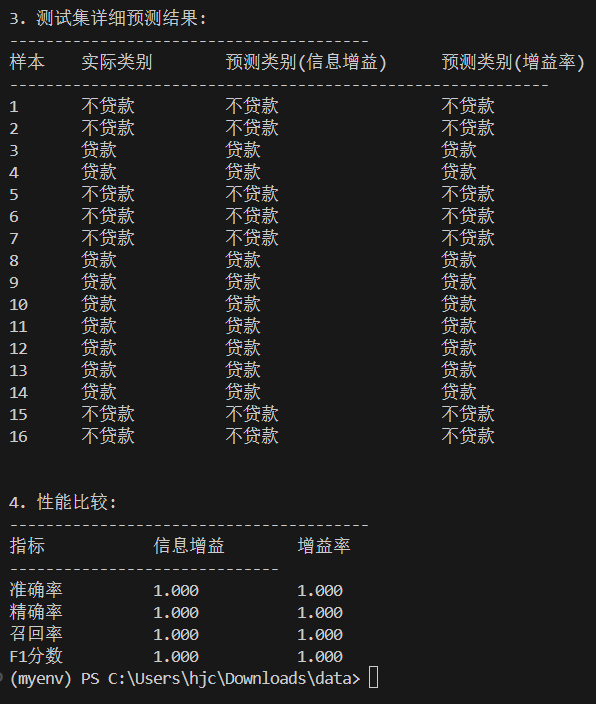
    print("\n\n3. 测试集详细预测结果:")
    print("-" * 40)
    print("样本\t实际类别\t预测类别(信息增益)\t预测类别(增益率)")
    print("-" * 60)

    for i in range(len(X_test)):
        actual = "贷款" if y_test[i] == 1 else "不贷款"
        pred_info = "贷款" if y_pred_info[i] == 1 else "不贷款"
        pred_ratio = "贷款" if y_pred_ratio[i] == 1 else "不贷款"

        print(f"{i+1}\t{actual}\t\t{pred_info}\t\t\t{pred_ratio}")

    # 性能比较
    print("\n\n4. 性能比较:")
    print("-" * 40)
    print("指标\t\t信息增益\t增益率")
    print("-" * 30)
    print(f"准确率\t\t{metrics_info['accuracy']:.3f}\t\t{metrics_ratio['accuracy']:.3f}")
    print(f"精确率\t\t{metrics_info['precision']:.3f}\t\t{metrics_ratio['precision']:.3f}")
    print(f"召回率\t\t{metrics_info['recall']:.3f}\t\t{metrics_ratio['recall']:.3f}")
    print(f"F1分数\t\t{metrics_info['f1_score']:.3f}\t\t{metrics_ratio['f1_score']:.3f}")

if __name__ == "__main__":
    main()
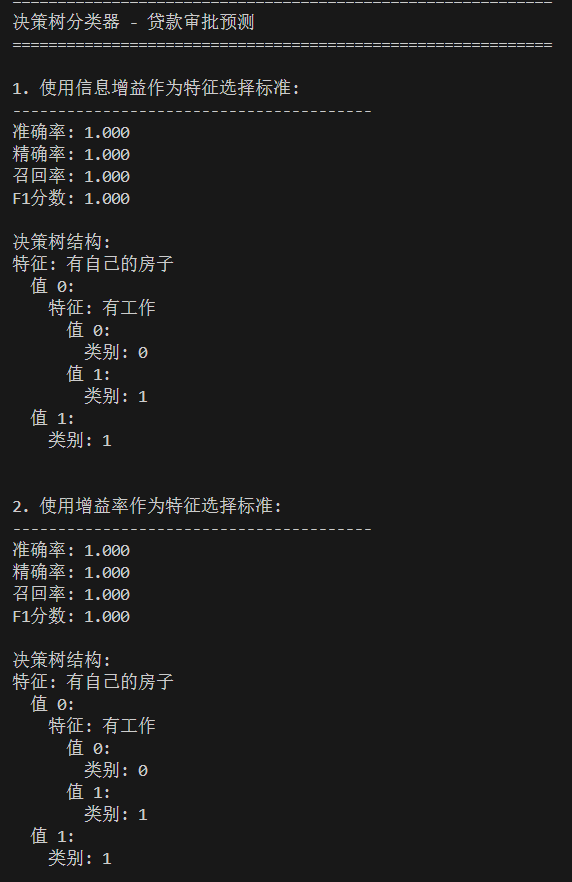
实验结果:
五、总结
决策树的结构就像流程图,即使不是专业人士也可以看懂决策逻辑,方便解释。但容易过拟合,再过度适配训练集后,面对新数据可能预测准确率会降低。个别异常数据可能导致树的结构发生较大变化。
决策树的实现对于新手来说比较友好,可以快速理解“特征选择"“过拟合”“模型优化”等概念。对于资深专业人员来说,决策树也可以起到分类、回归的作用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)