数据结构——单链表(c语言笔记)
1.链式存储结构的定义
与顺序表的“数组顺序存储”不同,链式存储结构用 一组任意的存储单元(可以分散在内存中) 来存放线性表中的元素。
每个存储单元既要存放数据,还要存放指针,用来指向逻辑上相邻的元素。
所以链式存储的基本单元是 结点(Node):
 ┌─────────────────┬─────────────────┐
 │ 数据域(data)     │ 指针域(next)    │
 └─────────────────┴─────────────────┘
2.链式存储和顺序存储对比
| 特点 | 顺序表(数组) | 链表 |
|---|---|---|
| 存储位置 | 连续内存 | 分散内存 |
| 插入/删除 | O(n)(需移动元素) | O(1)(只改指针,若已找到位置) |
| 随机访问 | O(1)(支持下标) | O(n)(只能顺序找) |
| 内存利用 | 必须预分配或扩容 | 按需分配,不浪费空间 |
| 缓存局部性 | 好(访问快) | 差(访问慢) |
3.链式存储的优缺点
优点:
不需要连续空间,内存利用率高;
插入、删除效率高(已知位置时 O(1));
表长不受固定容量限制。
缺点:
节点要多存一个指针,开销大;
随机访问困难(只能顺序遍历);
缓存局部性差,访问速度比顺序表慢。
链表初识
#include<stdio.h>    // 引入标准输入输出库,提供 printf 等函数
#include<assert.h>   // 引入断言库,提供 assert 宏,用来检查指针是否为空
#include<malloc.h>   // 引入内存分配函数 malloc(有些平台推荐用 stdlib.h)

#define ElemType int  // 定义链表中存储的数据类型为 int,以后想换类型只改这里

// 定义链表节点结构体
typedef struct ListNode
{
	ElemType data;           // 节点存储的数据
	struct ListNode *next;   // 指向下一个节点的指针
}ListNode;

// 定义链表类型为指向节点的指针(即链表头指针)
typedef ListNode* List;

// 初始化链表,生成头结点
void InitList(List *head)
{
	*head = (ListNode*)malloc(sizeof(ListNode)); // 分配一个头结点内存
	assert(*head != NULL);                       // 判断是否分配成功
	(*head)->next = NULL;                        // 初始化时链表为空,头结点 next 置为 NULL
}

// 创建链表,生成 10 个节点并存放数据 1~10
void CreateList(List *head)
{
	ListNode *p = *head;  // 临时指针 p 指向头结点
	for(int i=1; i<=10; ++i)   // 循环 10 次,依次生成 1~10 的节点
	{
		// 分配新节点,同时让当前 p 的 next 指向新节点,再让 p 指向新节点(尾插法)
		p = p->next = (ListNode*)malloc(sizeof(ListNode));
		assert(p != NULL);   // 检查内存分配是否成功
		p->data = i;         // 给新节点赋值(1~10)
		p->next = NULL;      // 新节点的 next 先置为空,表示链表结束
	}
}

// 遍历链表并打印数据
void ShowList(List head)
{
	ListNode *p = head->next;   // 从第一个有效节点开始(跳过头结点)
	while(p != NULL)            // 遍历到链表末尾(NULL)为止
	{
		printf("%d-->", p->data); // 打印当前节点数据
		p = p->next;              // 移动到下一个节点
	}
	printf("Nul.\n");           // 打印链表结束标记
}

// 主函数
void main()
{
	List mylist;           // 定义一个链表头指针
	InitList(&mylist);     // 初始化链表,分配头结点
	CreateList(&mylist);   // 创建 10 个节点并存放 1~10
	ShowList(mylist);      // 遍历并打印链表内容
}
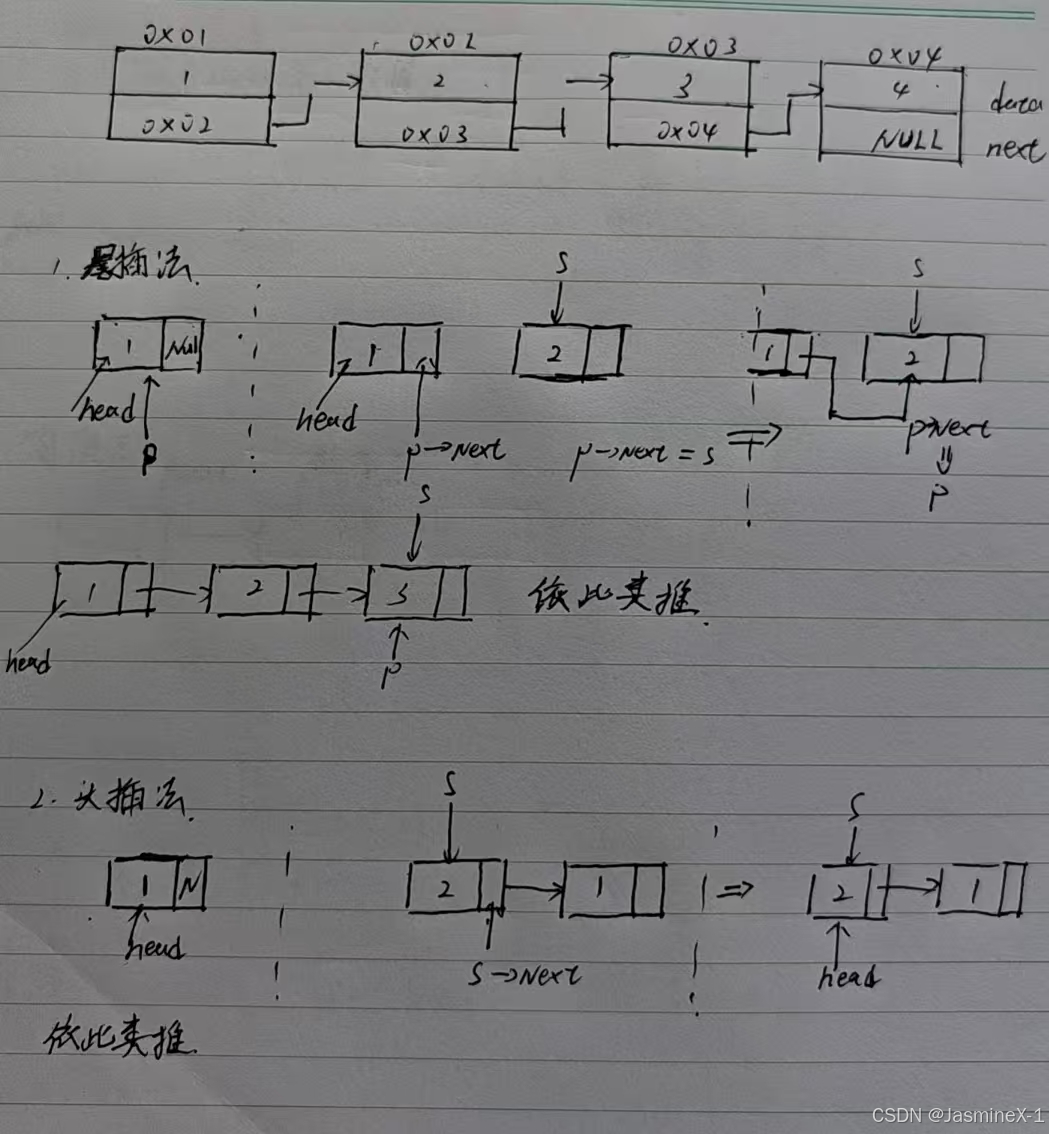
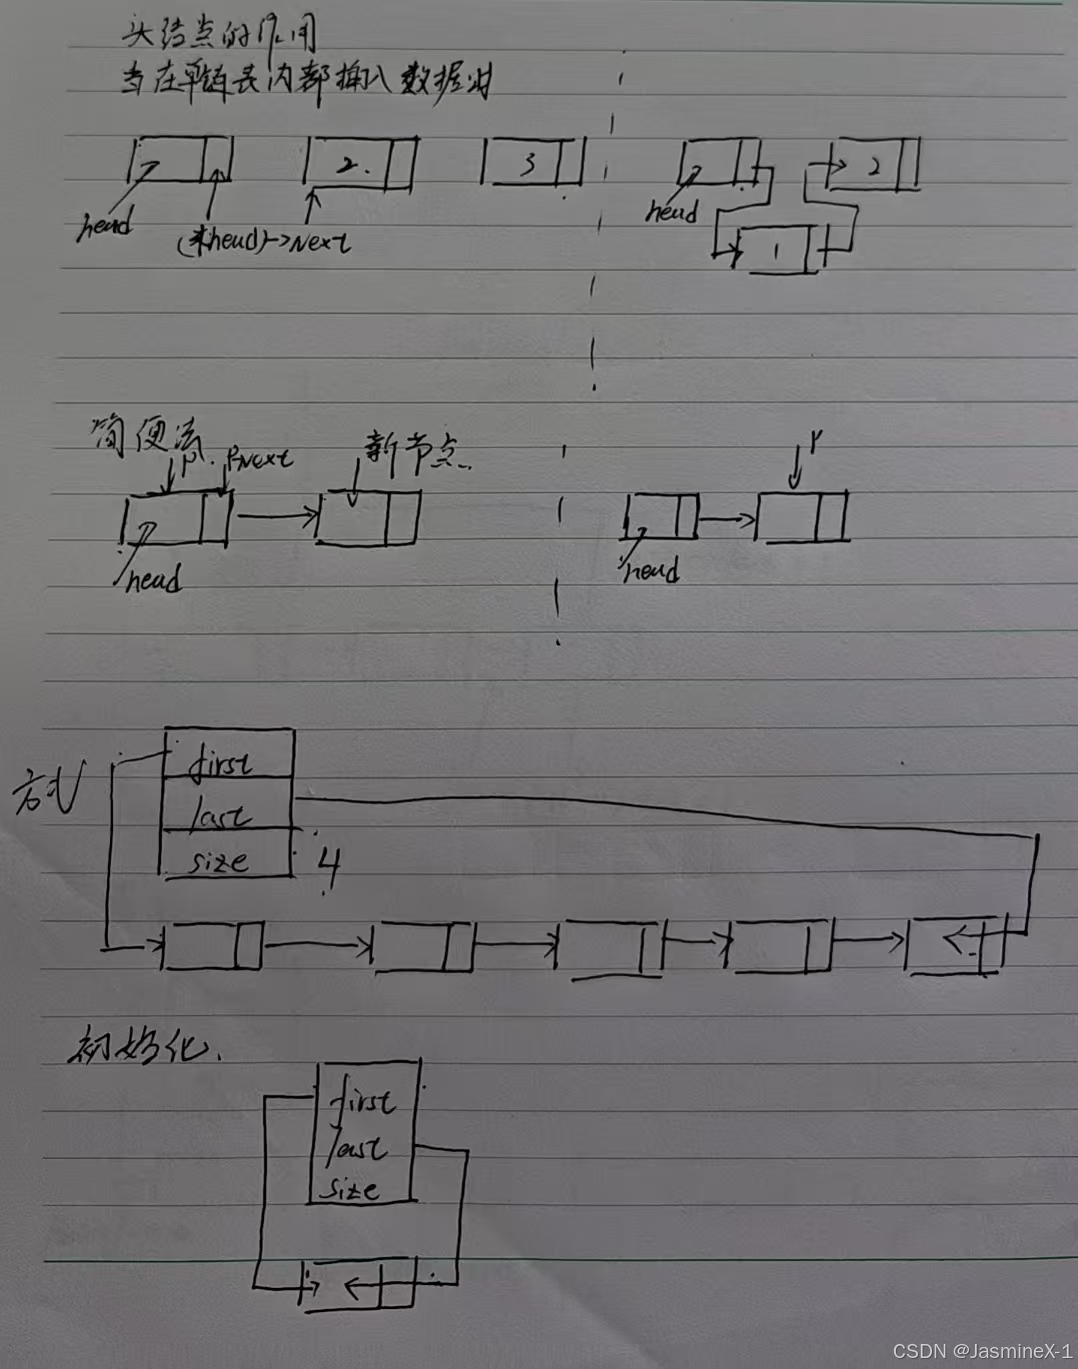
4.单链表详细说明(概念与基本结构)
节点(Node):链表的基本单元,通常包含数据域和指针域(指向下一个节点)。
头指针(head):指向链表第一个节点或哨兵(dummy)节点。
尾指针(tail/last)(可选):指向最后一个节点,便于 O(1) 尾插。
大小(size)(可选):记录当前节点数量,便于边界判断与复杂度分析。
哨兵头(dummy head / sentinel):一个不存实际数据的头结点,使插入/删除边界处理更统一(很多实现推荐使用)
head(dummy) -> node1 -> node2 -> node3 -> NULL
               ↑
             head->next 指向第一个真实节点
SList.h
#ifndef __SLIST_H__          // 防止头文件重复包含的宏定义(如果没定义则定义,已经定义过就跳过)
#define __SLIST_H__

#include<stdio.h>            // 标准输入输出头文件,用于 printf / scanf
#include<malloc.h>           // 内存分配函数 malloc/free
#include<assert.h>           // assert 断言函数,运行时检查指针是否为空等

#define ElemType int          // 定义链表中存放的数据类型为 int,可以通过改这个宏实现泛型效果

/*----------------------------- 结点结构体 -----------------------------*/
// 单链表结点结构
typedef struct Node
{
    ElemType data;            // 数据域,用来存放元素
    struct Node* next;        // 指针域,指向下一个结点
}Node, * PNode;               // Node 是结构体名,PNode 是 Node* 类型别名

/*----------------------------- 链表结构体 -----------------------------*/
// 链表的管理结构(带有头指针、尾指针、元素个数)
// 使用这个结构可以更方便管理整个链表
typedef struct List
{
    PNode  first;             // 指向链表的头结点(通常是一个哨兵结点,不存放实际数据)
    PNode  last;              // 指向链表的尾结点(最后一个有效结点,方便尾插 O(1))
    size_t size;              // 链表中存放的元素个数
}List;

/*----------------------------- 链表操作函数声明 -----------------------------*/

// 初始化链表
void InitList(List* list);

// 尾插:在链表尾部插入一个元素
void push_back(List* list, ElemType x);

// 头插:在链表头部插入一个元素(头结点之后)
void push_front(List* list, ElemType x);

// 打印链表中的所有元素
void show_list(List* list);

// 删除尾结点
void pop_back(List* list);

// 删除头结点之后的第一个结点
void pop_front(List* list);

// 插入一个值(一般是有序插入:比如找到合适位置后插入)
void insert_val(List* list, ElemType x);

// 查找某个值,返回结点指针(没找到返回 NULL)
Node* find(List* list, ElemType key);

// 返回链表长度
int  length(List* list);

// 删除某个值(删除第一个等于 key 的结点)
void delete_val(List* list, ElemType key);

// 排序链表(通常是插入排序或者冒泡排序实现)
void sort(List* list);

// 逆置链表(把链表反转)
void resver(List* list);

// 清空链表(删除所有结点,但保留头结点)
void clear(List* list);

// 销毁链表(释放所有结点,包括头结点)
void destroy(List* list);

/*----------------------------- 迭代器部分(模仿 C++ STL) -----------------------------*/
///////////////////////////////////////////////////////

// 定义迭代器类型(本质就是 Node*,结点指针)
typedef Node* It;

// 申请一个新结点,存放数据 x,返回该结点指针
Node* _buynode(ElemType x);

// 返回指向链表第一个有效元素的迭代器(list->first->next)
It begin(List* list);

// 返回链表结束位置的迭代器(即 NULL,表示终点)
It end(List* list);

// 在 pos 位置前插入一个元素 x
void insert(List* list, It pos, ElemType x);

#endif //__SLIST_H__
main.cpp
#include "SList.h"   // 包含单链表的头文件,里面声明了List结构体、Node结构体,以及各种链表操作函数

int main()
{
    List mylist;              // 定义一个单链表对象 mylist(一般会包含头结点指针和链表长度等信息)
    InitList(&mylist);        // 初始化单链表,使其成为一个空链表(通常会分配头结点,next置NULL)

    ElemType Item;            // 定义一个元素变量,用来存放用户输入的数据
    Node* p = NULL;           // 定义一个结点指针,用于存放查找结果
    int select = 1;           // 控制菜单选择的变量,初始值为1,保证可以进入循环

    // 主循环 —— 菜单交互界面
    while (select)
    {
        // 打印功能菜单
        printf("**************************************\n");
        printf("* [1] push_back      [2] push_front  *\n");
        printf("* [3] show_list      [4] pop_back    *\n");
        printf("* [5] pop_front      [6] insert_val  *\n");
        printf("* [7] find           [8] length      *\n");
        printf("* [9] delete_val     [10] sort       *\n");
        printf("* [11] resver        [12] clear      *\n");
        printf("* [13] destroy       [0] quit_system *\n");
        printf("**************************************\n");
        printf("请选择:>");

        // 输入用户选择
        scanf_s("%d", &select);
        if (select == 0)      // 输入0时退出系统
            break;

        // 根据用户输入执行对应功能
        switch (select)
        {
        case 1: // push_back —— 尾插法
            printf("请输入要插入的数据(-1结束):>");
            while (scanf_s("%d", &Item), Item != -1)   // 输入 -1 结束输入
            {
                push_back(&mylist, Item);  // 将数据插入到链表尾部
            }
            break;

        case 2: // push_front —— 头插法
            printf("请输入要插入的数据(-1结束):>");
            while (scanf_s("%d", &Item), Item != -1)   // 输入 -1 结束输入
            {
                push_front(&mylist, Item); // 将数据插入到链表头部(头结点之后)
            }
            break;

        case 3: // show_list —— 遍历打印链表
            show_list(&mylist);
            break;

        case 4: // pop_back —— 删除尾结点
            pop_back(&mylist);
            break;

        case 5: // pop_front —— 删除头结点之后的第一个结点
            pop_front(&mylist);
            break;

        case 6: // insert_val —— 插入指定值(通常是有序插入)
            printf("请输入要插入的数据:>");
            scanf_s("%d", &Item);
            insert_val(&mylist, Item);
            break;

        case 7: // find —— 查找指定值
            printf("请输入要查找的数据:>");
            scanf_s("%d", &Item);
            p = find(&mylist, Item);       // 返回值是结点指针
            if (p == NULL)
            {
                printf("查找的值在链表中不存在.\n");
            }
            else
            {
                printf("查找的值在链表中存在.\n");
            }
            break;

        case 8: // length —— 返回链表长度
            printf("单链表的长度为:> %d \n", length(&mylist));
            break;

        case 9: // delete_val —— 删除指定值
            printf("请输入要删除的值:>");
            scanf_s("%d", &Item);
            delete_val(&mylist, Item);
            break;

        case 10: // sort —— 排序链表
            sort(&mylist);
            break;

        case 11: // resver —— 逆置链表
            resver(&mylist);
            break;

        case 12: // clear —— 清空链表(保留头结点)
            clear(&mylist);
            break;

        // 如果想彻底销毁链表(包括头结点),可以用 destroy
        // case 13:
        //     destroy(&mylist);
        //     break;

        default: // 输入无效数字时
            printf("输入的命令错误,请重新输入.\n");
            break;
        }
    }

    destroy(&mylist);   // 退出循环后,销毁链表(释放所有结点内存,包括头结点)
}
SList.cpp
初始化
#include "SList.h"

// 初始化单链表
void InitList(List* list)
{
    // 1. 创建一个头结点(哨兵结点)
    // 这里 first 和 last 同时指向这个头结点
    // malloc 分配一个 Node 结点空间
    list->first = list->last = (Node*)malloc(sizeof(Node));

    // 2. 检查内存分配是否成功
    // 如果 malloc 返回 NULL,表示内存分配失败,assert 会终止程序
    assert(list->first != NULL);

    // 3. 设置头结点的 next 指针为空
    // 表示当前链表为空,没有任何实际数据结点
    list->first->next = NULL;

    // 4. 初始化链表长度为 0
    list->size = 0;
}
解释:
头结点的作用
头结点本身不存放实际数据,只作为链表的固定起点。
好处:统一了操作(比如插入、删除时不用单独考虑头结点特殊情况)。
first 和 last
first 指向头结点。
last 也指向头结点(因为一开始链表是空的,尾结点就是头结点)。
size
size = 0,表示链表里没有有效数据结点。
插入时 size++,删除时 size--。
尾插
void push_back(List* list, ElemType x)
{
	insert(list, end(list), x);
}

/*
void push_back(List *list, ElemType x)
{
	//Node *s = _buynode(x);

	Node *s = (Node *)malloc(sizeof(Node));
	assert(s != NULL);
	s->data = x;
	s->next = NULL;


	list->last->next = s;
	list->last = s;
	list->size++;
}
*/
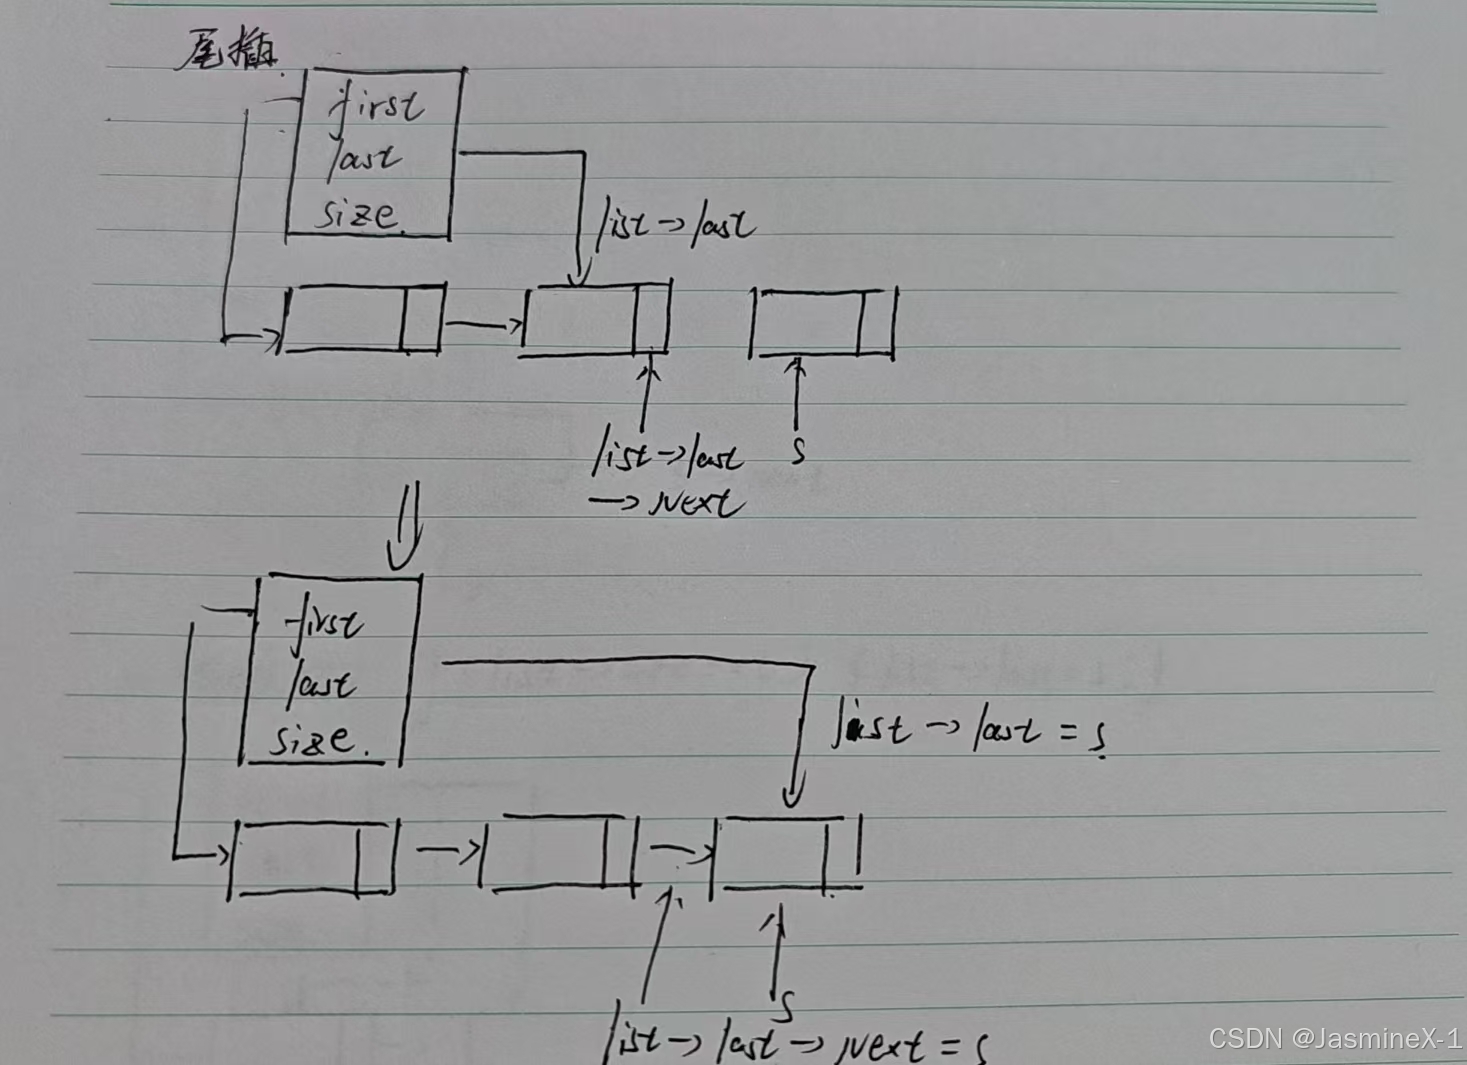
原函数解释:
Node s = (Node )malloc(sizeof(Node));
为新元素申请一个节点的动态内存空间。
assert(s != NULL);
检查内存是否分配成功,如果失败程序会中止。
s->data = x;
将新节点的数据域设置为传入的元素 x。
s->next = NULL;
新节点作为链表的尾结点,它的 next 指针置为空。
list->last->next = s;
把当前尾结点的 next 指针指向新节点。
list->last = s;
更新链表的尾指针,使其指向新加入的节点。
list->size++;
链表元素个数加 1。
头插
void push_front(List* list, ElemType x)
{
	insert(list, begin(list), x);
}

/*
void push_front(List *list, ElemType x)
{
	//Node *s = _buynode(x);

	Node *s = (Node *)malloc(sizeof(Node));
	assert(s != NULL);
	s->data = x;

	s->next = list->first->next;
	list->first->next = s;
	if(list->size == 0)
	{
		list->last = s;
	}
	list->size++;
}
*/
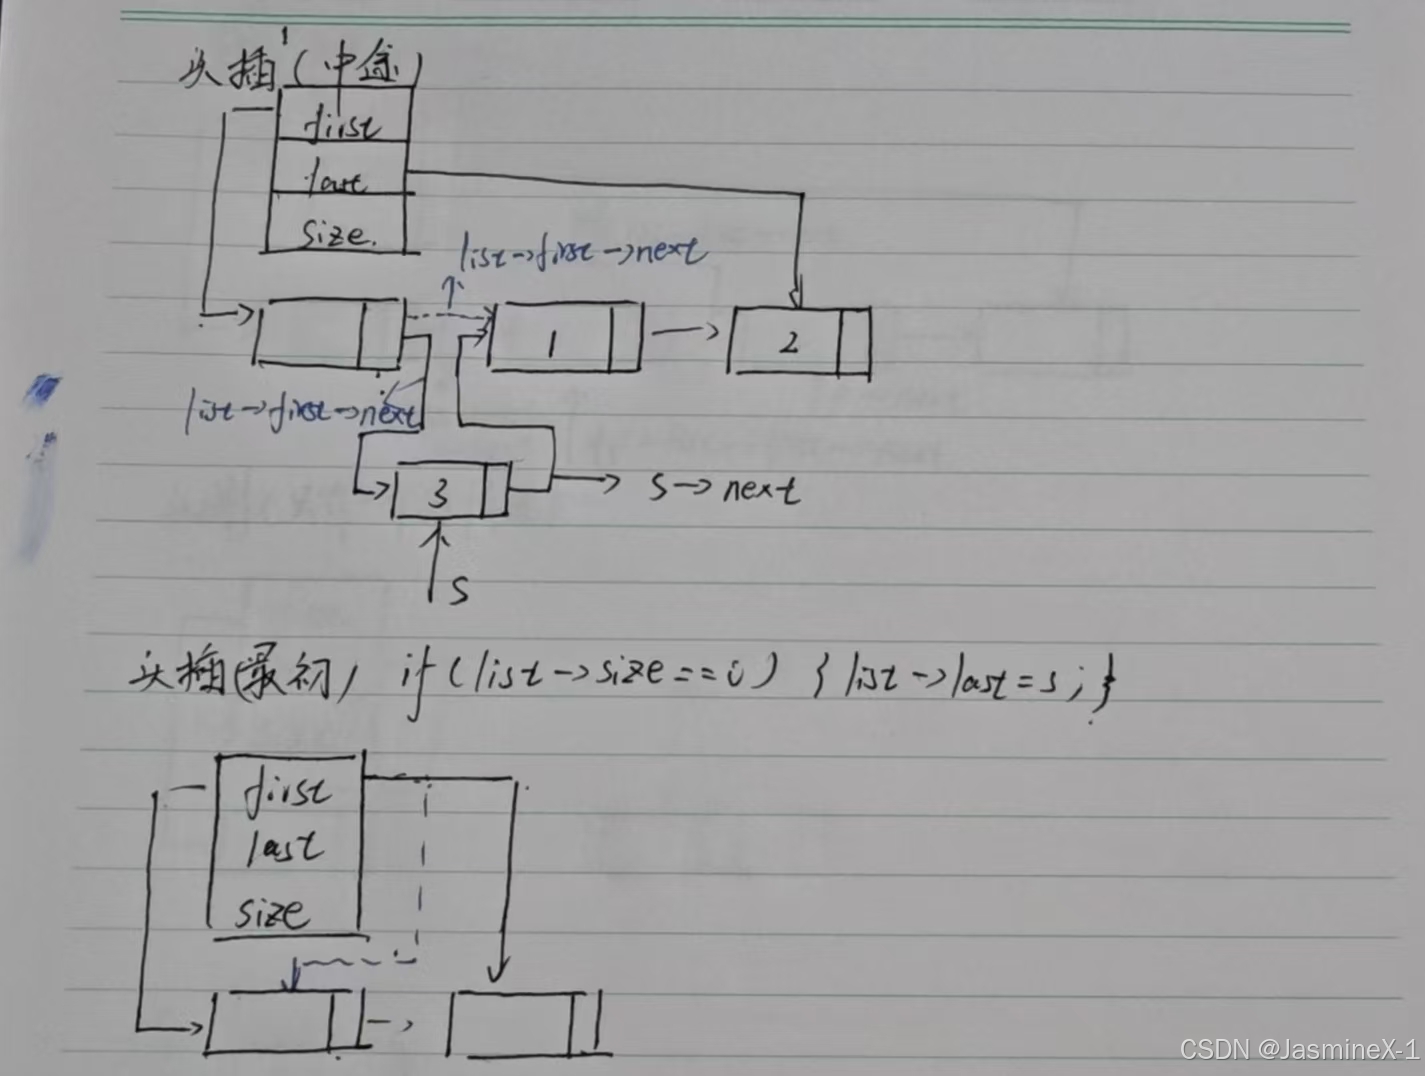
原函数解释:
Node s = (Node )malloc(sizeof(Node));
为新节点申请内存空间。
assert(s != NULL);
检查内存是否分配成功,如果失败程序会中止。
s->data = x;
将新节点的数据域赋值为传入的元素 x。
s->next = list->first->next;
让新节点的 next 指针指向原来头结点后的第一个节点。
list->first->next = s;
把头结点的 next 指针改为指向新节点,新节点就插入到了链表最前面。
if(list->size == 0) { list->last = s; }
如果原来链表为空(没有其他节点),那么插入的这个节点既是第一个,也是最后一个,需要更新尾指针。
list->size++;
链表元素个数加 1。
显示
void show_list(List* list)
{
	Node* p = list->first->next;
	while (p != NULL)
	{
		printf("%d-->", p->data);
		p = p->next;
	}
	printf("Nul.\n");
}
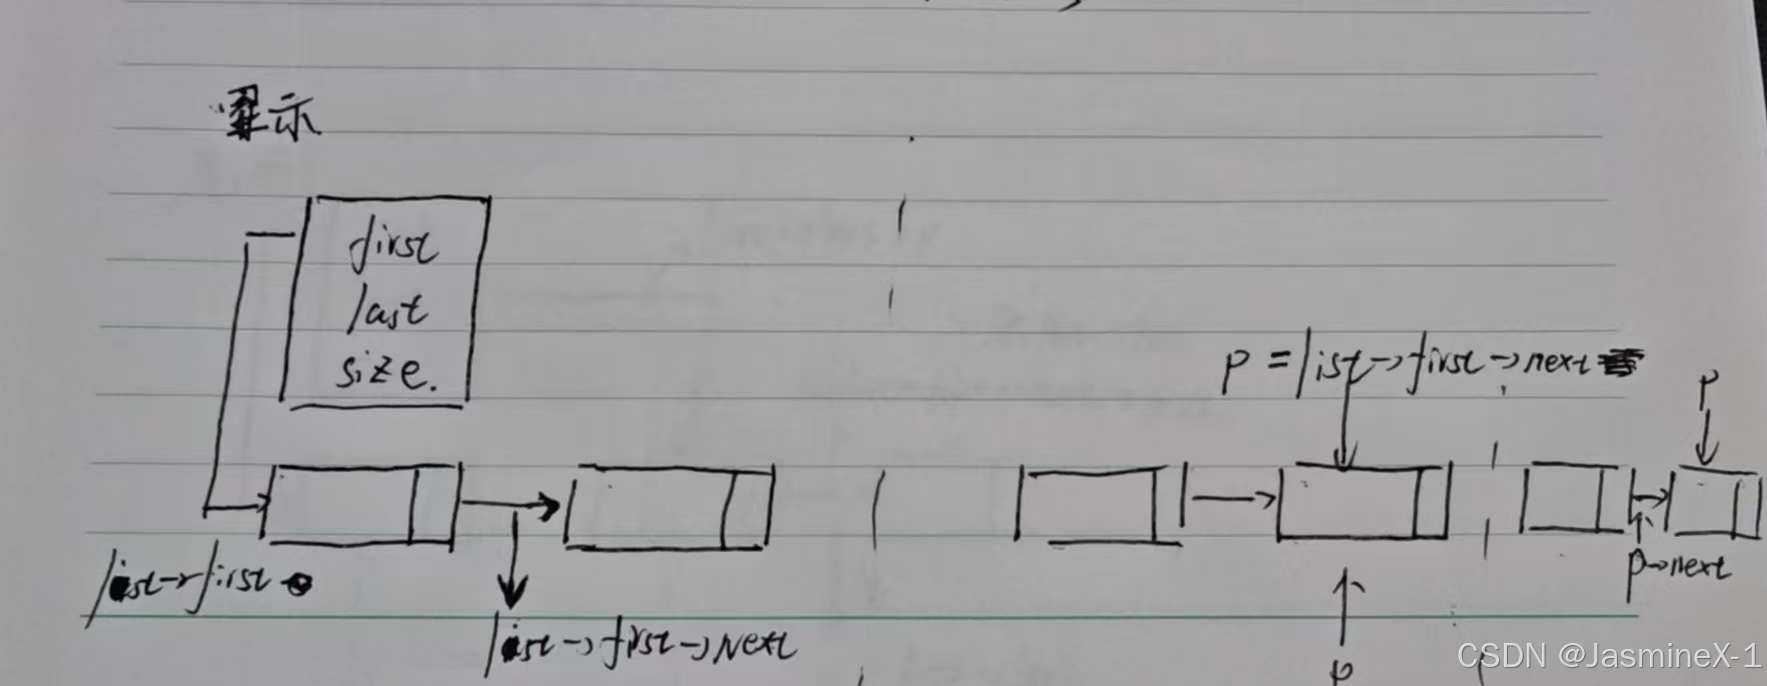
解释:
Node p = list->first->next;
定义一个指针 p,从头结点之后的第一个有效节点开始遍历链表。
while (p != NULL)
当 p 不为空时,说明链表还没有遍历到尾部,继续循环。
printf("%d-->", p->data);
打印当前节点的数据,并用箭头 --> 表示链表连接关系。
p = p->next;
将指针 p 移动到下一个节点,继续遍历。
printf("Nul.\n");
遍历结束后输出 "Nul.",表示链表的末尾(空指针)。
尾删
void pop_back(List* list)
{
	if (list->size == 0)
		return;

	Node* p = list->first;
	while (p->next != list->last)
		p = p->next;

	free(list->last);
	list->last = p;
	list->last->next = NULL;
	list->size--;
}
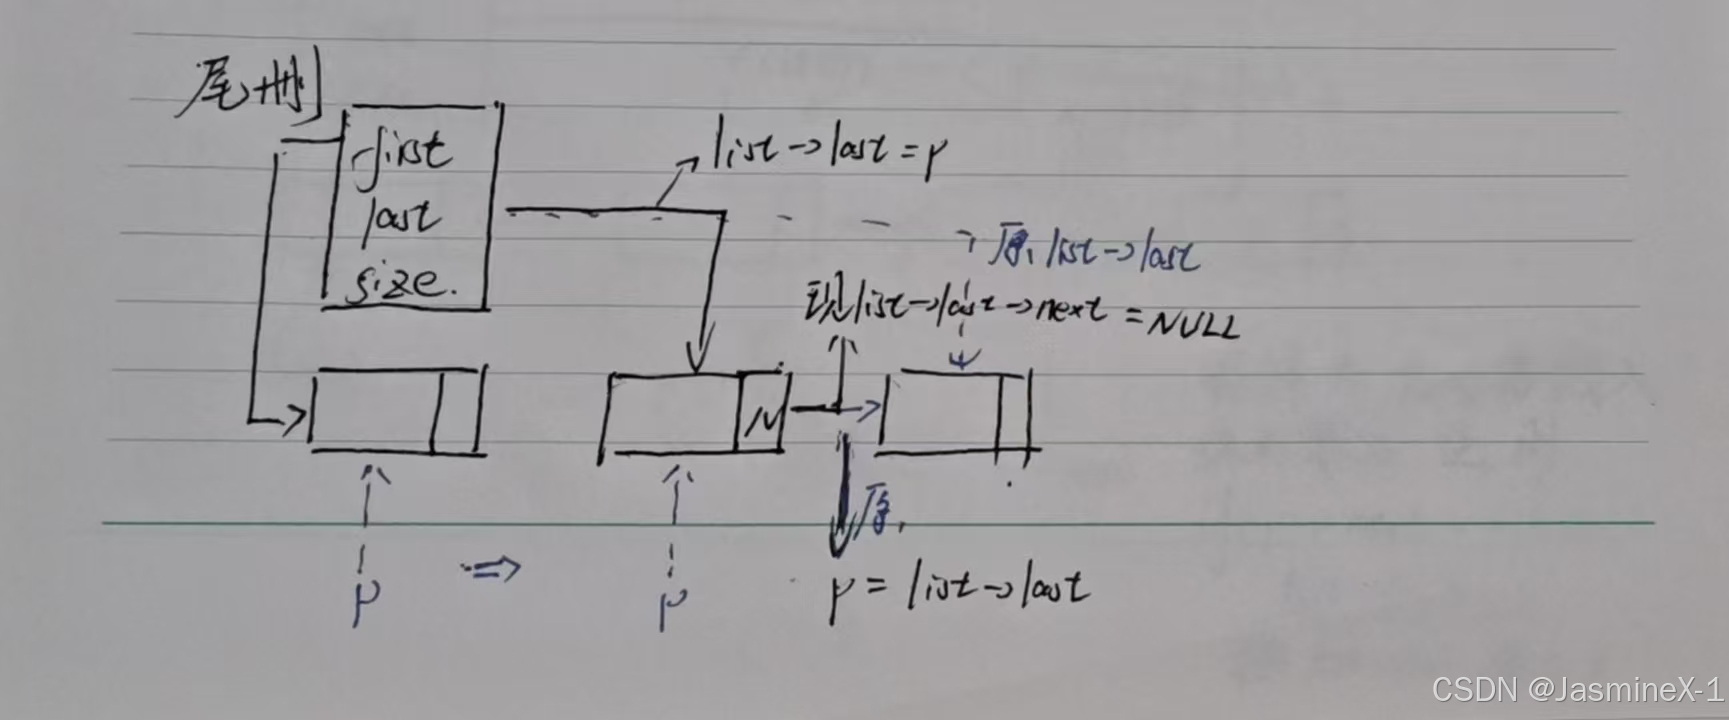
解释:
if (list->size == 0) return;
如果链表为空,没有元素可删除,直接返回。
Node p = list->first;
定义指针 p,从头结点开始,用来寻找最后一个节点的前驱节点。
while (p->next != list->last) p = p->next;
循环遍历链表,直到找到最后一个节点 last 的前一个节点 p。
free(list->last);
释放尾节点的内存空间。
list->last = p;
更新链表的尾指针,让它指向删除后新的尾节点。
list->last->next = NULL;
将新尾节点的 next 置空,表示链表结束。
list->size--;
链表元素个数减 1。
头删
void pop_front(List* list)
{
	if (list->size == 0)
		return;
	Node* p = list->first->next;
	list->first->next = p->next;
	free(p);
	if (list->size == 1)
	{
		list->last = list->first;
	}
	list->size--;
}
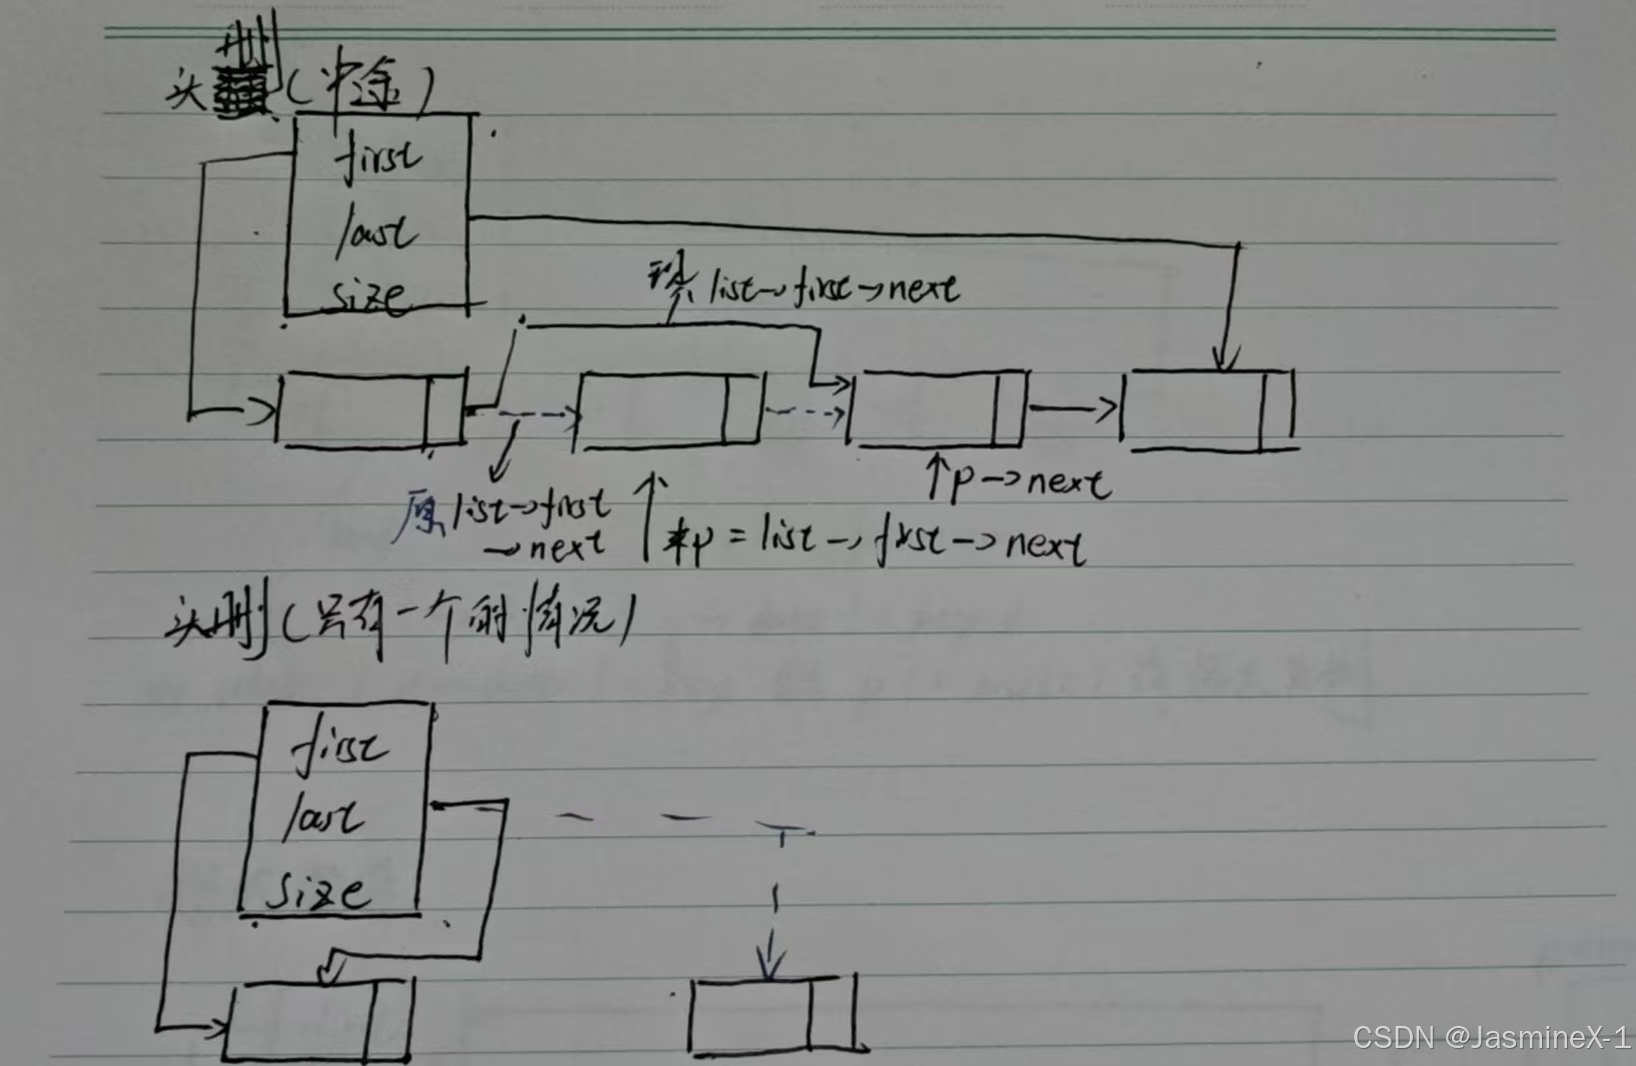
解释:
if (list->size == 0) return;
如果链表为空,没有元素可删除,直接返回。
Node p = list->first->next;*
定义指针 p,指向链表的第一个有效节点(头结点后的第一个节点)。
list->first->next = p->next;
让头结点的 next 指针绕过 p,直接指向第二个节点,把第一个节点从链表中断开。
free(p);
释放第一个节点的内存空间。
if (list->size == 1) { list->last = list->first; }
如果删除前链表只有一个元素,那么删除后链表就为空,此时需要把尾指针 last 重新指向头结点。
list->size--;
链表元素个数减 1。
插入数值
void insert_val(List* list, ElemType x)
{
	Node* s = _buynode(x);
	/*
	Node *s = (Node *)malloc(sizeof(Node));
	assert(s != NULL);
	s->data = x;
	s->next = NULL;
	*/
	Node* p = list->first;
	while (p->next != NULL && p->next->data < x)
		p = p->next;

	if (p->next == NULL)
	{
		list->last = s;
	}

	s->next = p->next;
	p->next = s;
	list->size++;
}
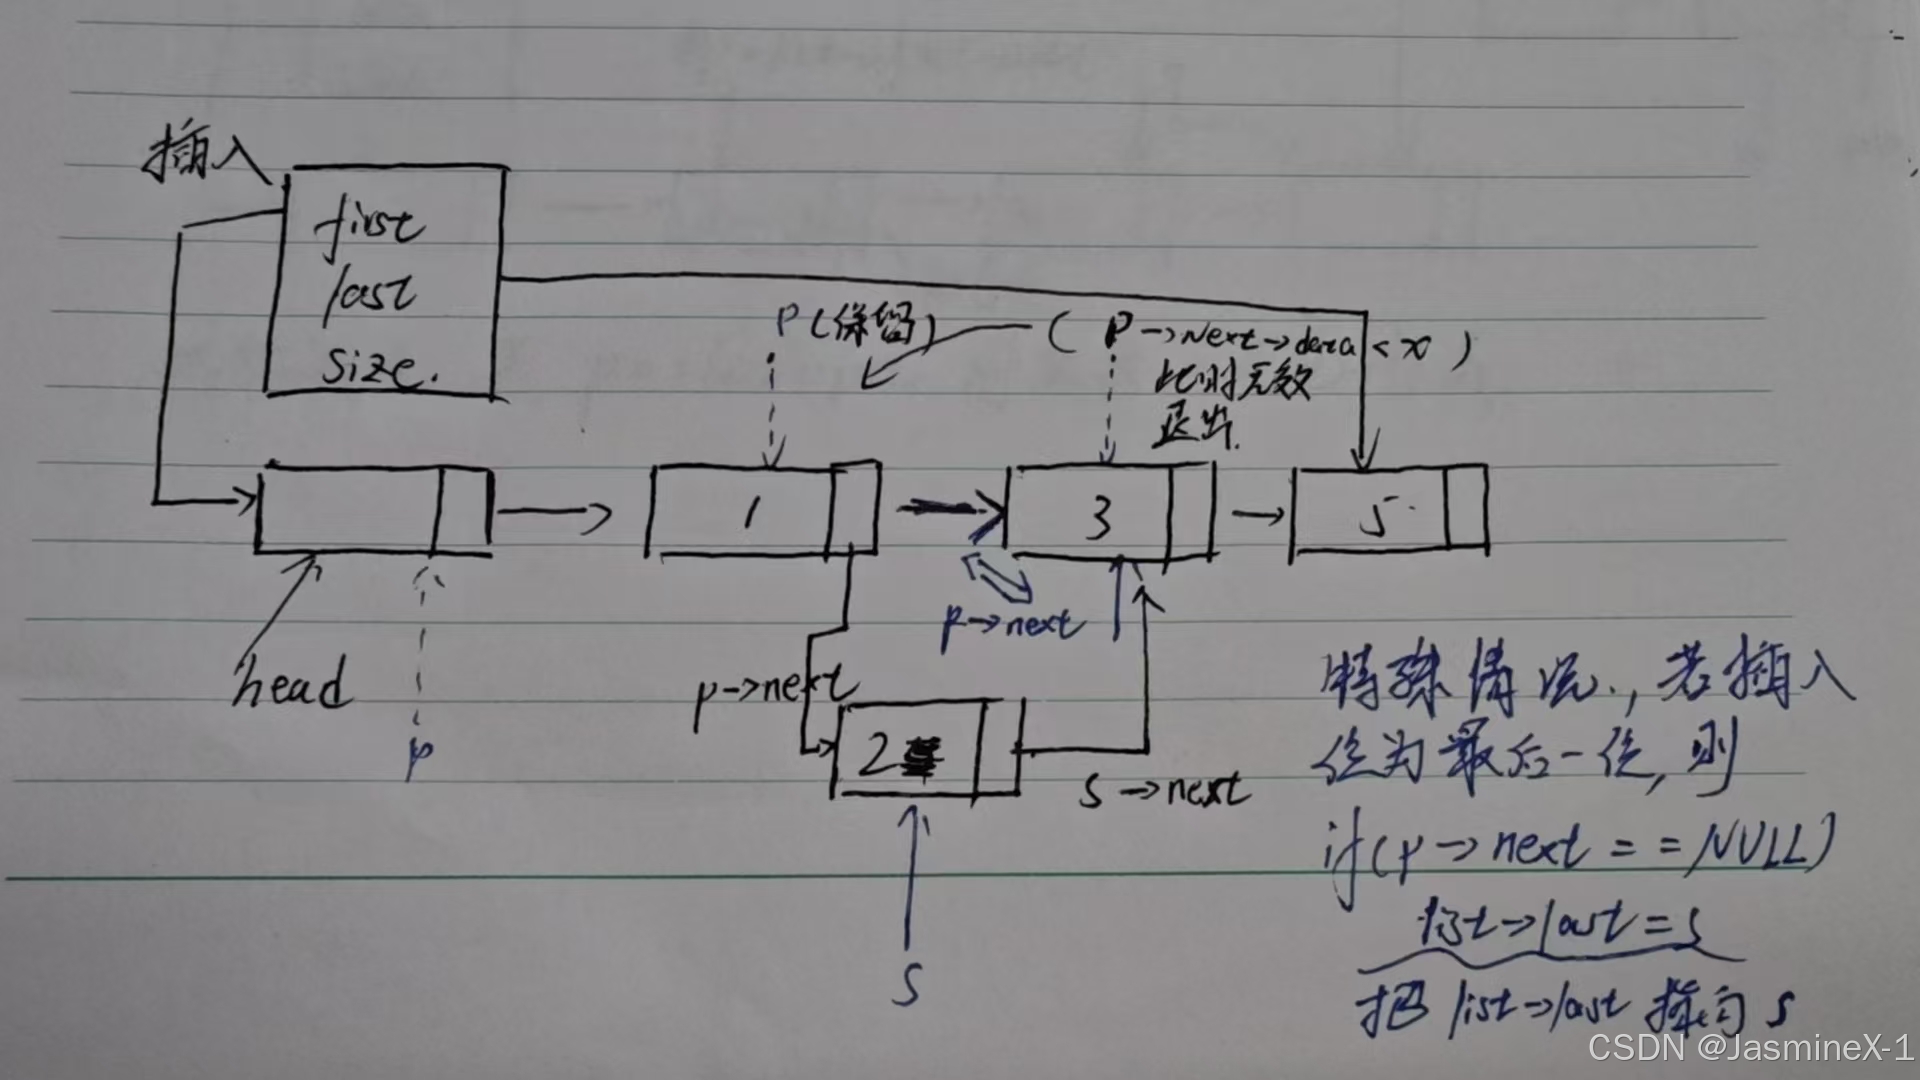
解释:
Node s = _buynode(x);*
调用 _buynode 创建一个新节点,并存放元素 x。
(注:代码中保留了另一种写法,即用 malloc + 初始化来生成新节点)。
Node p = list->first;*
定义指针 p,从头结点开始,用于查找插入位置。
while (p->next != NULL && p->next->data < x) p = p->next;
遍历链表,找到第一个 大于或等于 x 的节点位置,循环结束时 p 指向插入位置的前驱节点。
if (p->next == NULL) { list->last = s; }
如果循环走到链表尾部,说明 x 是最大值,新节点会插到最后一个位置,所以要更新尾指针。
s->next = p->next;
让新节点的 next 指针指向插入位置的后继节点。
p->next = s;
让前驱节点的 next 指针指向新节点,完成插入操作。
list->size++;
链表长度加 1。
查找
Node* find(List* list, ElemType key)
{
	Node* p = list->first->next;
	while (p != NULL && p->data != key) //
		p = p->next;
	return p;
}
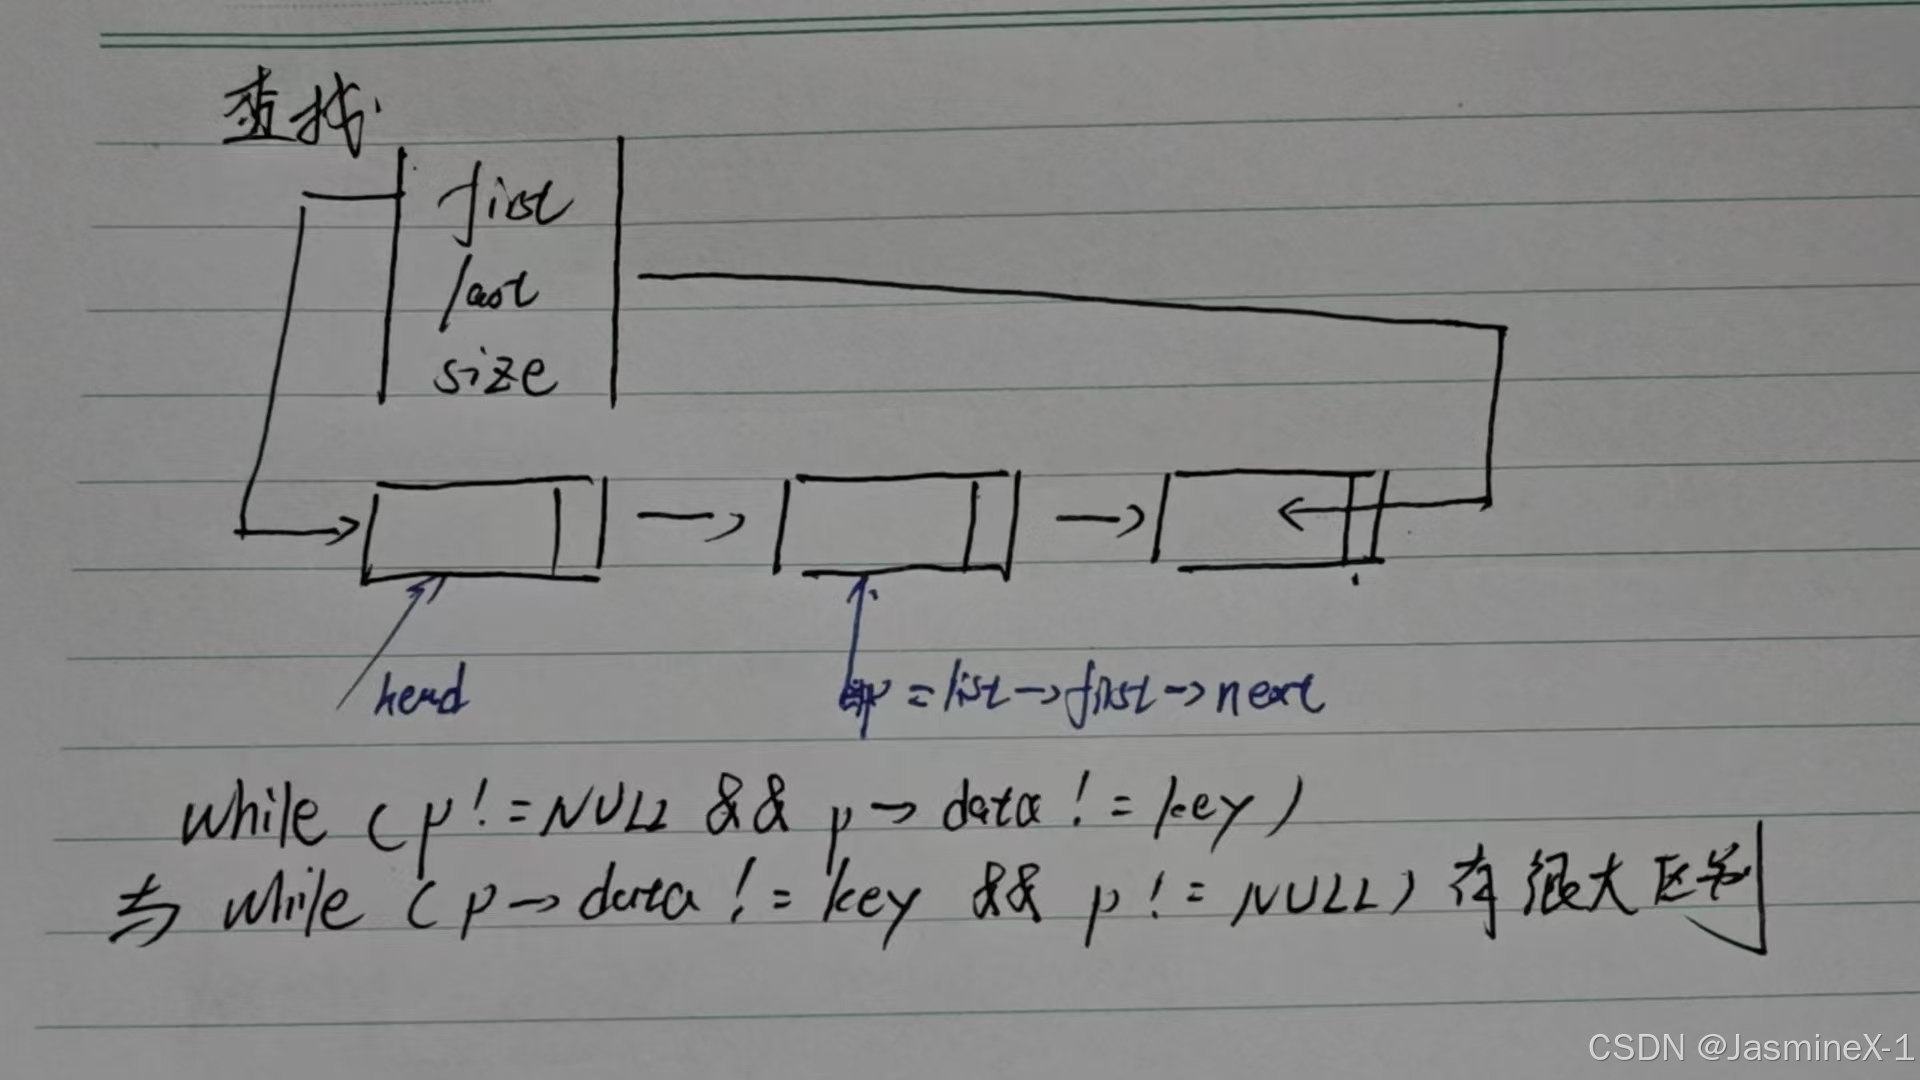
解释:
Node p = list->first->next;*
定义指针 p,从链表的第一个有效节点开始查找。
while (p != NULL && p->data != key) p = p->next;
遍历链表:
如果 p 不为空且当前节点的数据 data 不等于查找值 key,则继续向后移动。
循环结束时有两种情况:
找到值等于 key 的节点,p 指向该节点。
遍历到链表尾部仍未找到,p 变为 NULL。
return p;
返回查找到的节点指针:
如果找到,返回对应节点的地址。
如果没找到,返回 NULL。
注意:while (p != NULL && p->data != key) 和 while (p->data != key && p != NULL) 在语义上是不同的。
while (p != NULL && p->data != key)
先判断 p != NULL,如果 p 已经是空指针,则 不会再去访问 p->data。
这样就避免了对空指针解引用导致的 段错误 (Segmentation Fault)。
while (p->data != key && p != NULL)
先判断 p->data != key。
但是如果 p == NULL,这一步就会尝试访问 NULL->data,直接导致 程序崩溃。
即使后面有 && p != NULL,也来不及执行,因为程序已经访问了非法内存。
int  length(List* list)
{
	return list->size;
}
直接返回链表结构体中维护的成员变量 size,即当前链表中节点的个数。
删除值
void delete_val(List* list, ElemType key)
{
	if (list->size == 0)
		return;
	Node* p = find(list, key);
	if (p == NULL)
	{
		printf("要删除的数据不存在.\n");
		return;
	}

	if (p == list->last)
	{
		pop_back(list);
	}
	else
	{
		Node* q = p->next;
		p->data = q->data;
		p->next = q->next;
		free(q);
		list->size--;
	}
}
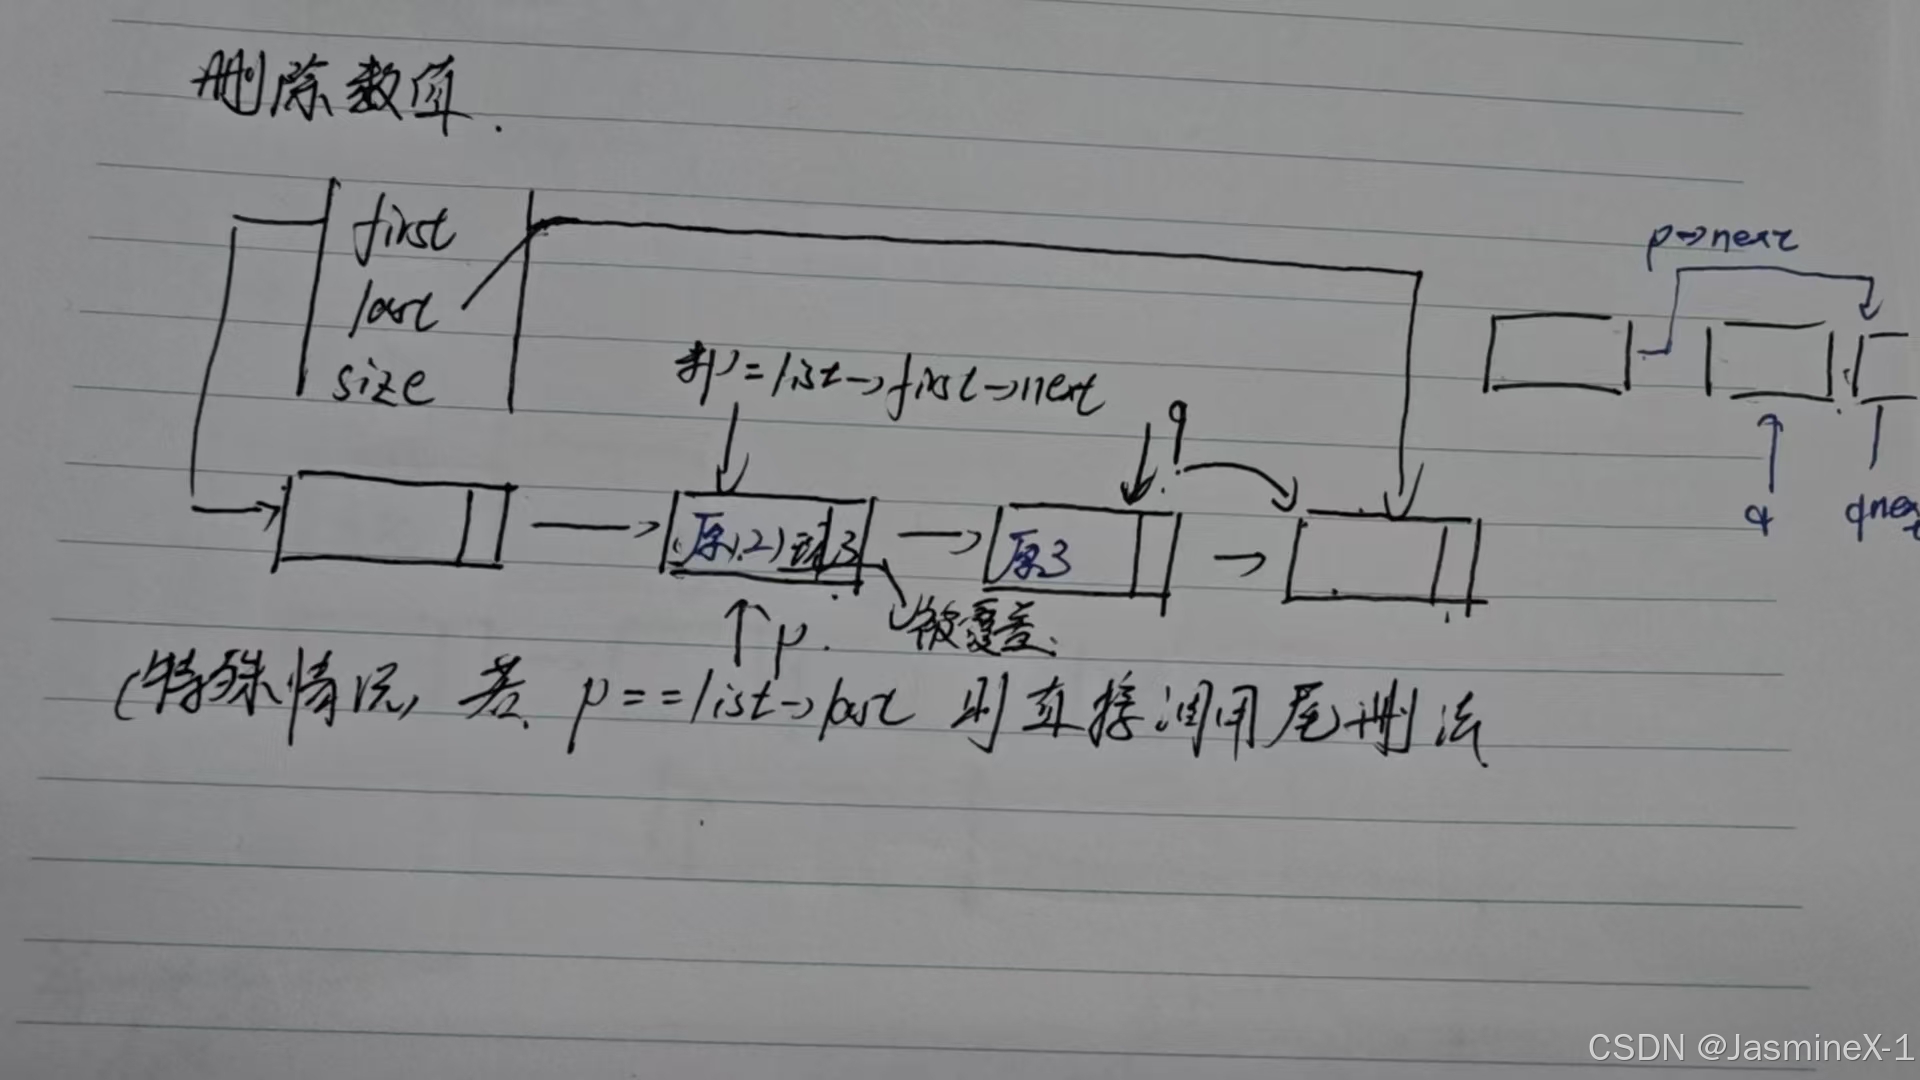
解释:
if (list->size == 0) return;
如果链表为空,直接返回,无需删除。
Node p = find(list, key);*
调用 find 函数查找值等于 key 的节点,返回指针 p。
if (p == NULL) { printf("要删除的数据不存在.\n"); return; }
如果没找到对应的节点,提示信息并返回。
if (p == list->last) { pop_back(list); }
如果要删除的节点是尾结点,直接调用尾删函数 pop_back。
else { … }
否则,采用“复制覆盖”的方式删除节点:
Node q = p->next;*
定义指针 q,指向 p 的下一个节点。
p->data = q->data;
用后继节点的数据覆盖当前节点的数据。
p->next = q->next;
让 p 跳过 q,直接指向 q 的后继节点。
free(q);
释放后继节点 q 的内存空间。
list->size--;
链表元素个数减 1。
排序
void sort(List* list)
{
	if (list->size == 0 || list->size == 1)
		return;

	Node* s = list->first->next;
	Node* q = s->next;

	list->last = s;
	list->last->next = NULL;

	while (q != NULL)
	{
		s = q;
		q = q->next;

		Node* p = list->first;
		while (p->next != NULL && p->next->data < s->data)
			p = p->next;

		if (p->next == NULL)
		{
			list->last = s;
		}

		s->next = p->next;
		p->next = s;
	}
}
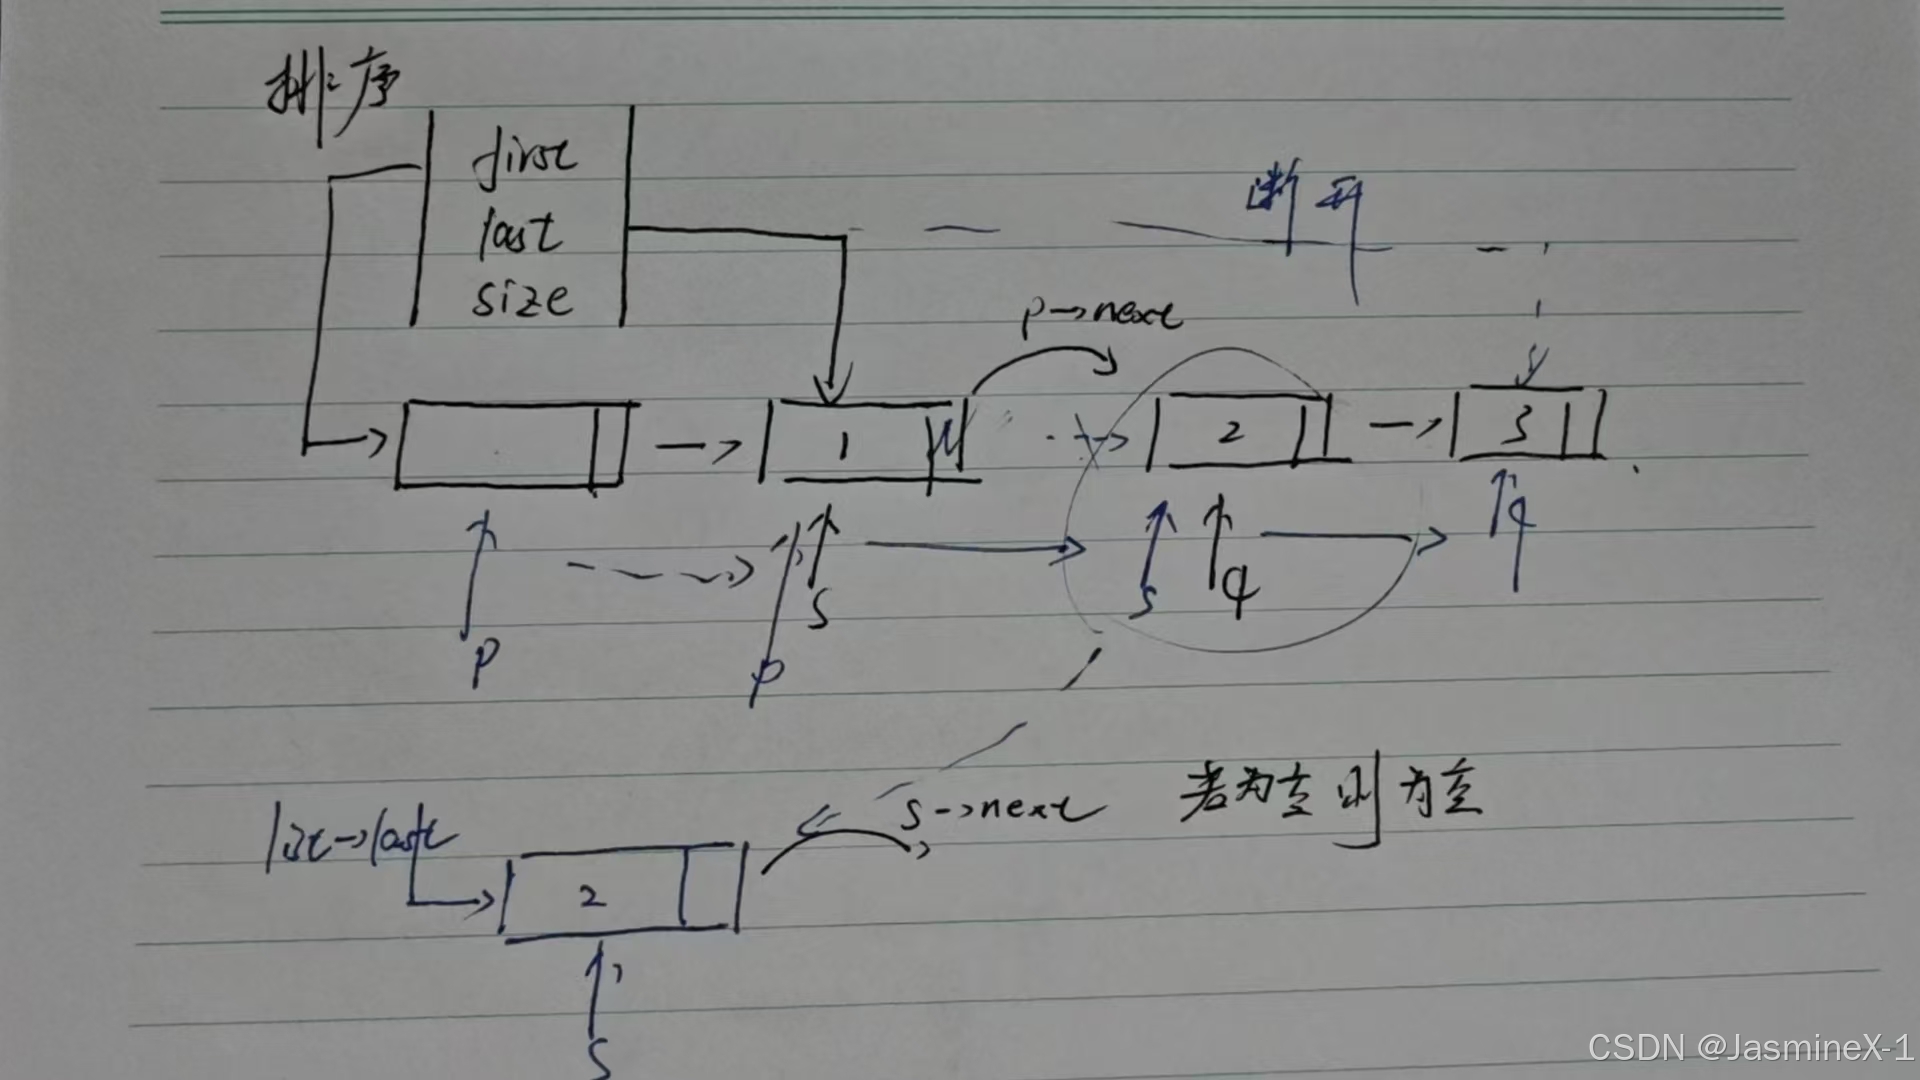
解释:
if (list->size == 0 || list->size == 1) return;
如果链表为空或只有一个节点,不需要排序,直接返回。
Node s = list->first->next;*
s 指向第一个有效节点,表示当前处理的节点。
Node q = s->next;*
q 指向 s 的下一个节点,用于遍历未排序的部分。
list->last = s; list->last->next = NULL;
将链表断开:此时把第一个节点当作已排序部分,并把它设置为新的尾节点,尾指针置空。
进入循环(插入排序的核心):
while (q != NULL)
遍历剩余未排序的节点。
s = q; q = q->next;
从未排序部分取出一个节点 s,并移动 q 到下一个节点。
Node p = list->first;*
p 从头结点开始,准备在已排序部分中找到 s 的插入位置。
while (p->next != NULL && p->next->data < s->data) p = p->next;
遍历已排序部分,找到第一个比 s->data 大的位置,p 就是插入点的前驱节点。
if (p->next == NULL) { list->last = s; }
如果插入位置在尾部,说明 s 最大,更新链表尾指针。
s->next = p->next; p->next = s;
将 s 插入到正确位置:
s->next 指向 p 的后继。
p->next 指向 s。
逆序
void resver(List* list)
{
	if (list->size == 0 || list->size == 1)
		return;

	Node* p = list->first->next;
	Node* q = p->next;

	list->last = p;
	list->last->next = NULL;

	while (q != NULL)
	{
		p = q;
		q = p->next;

		p->next = list->first->next;
		list->first->next = p;
	}
}
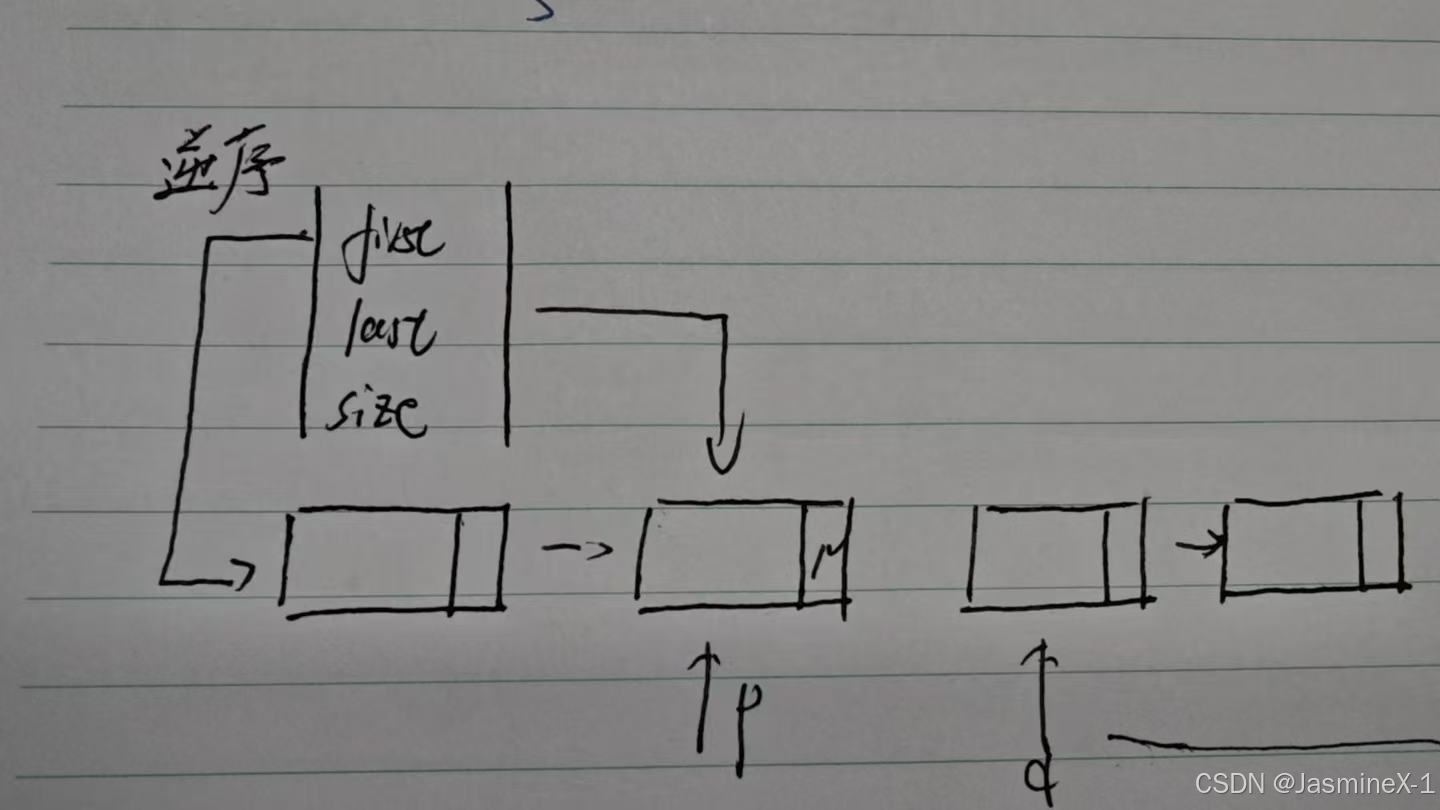
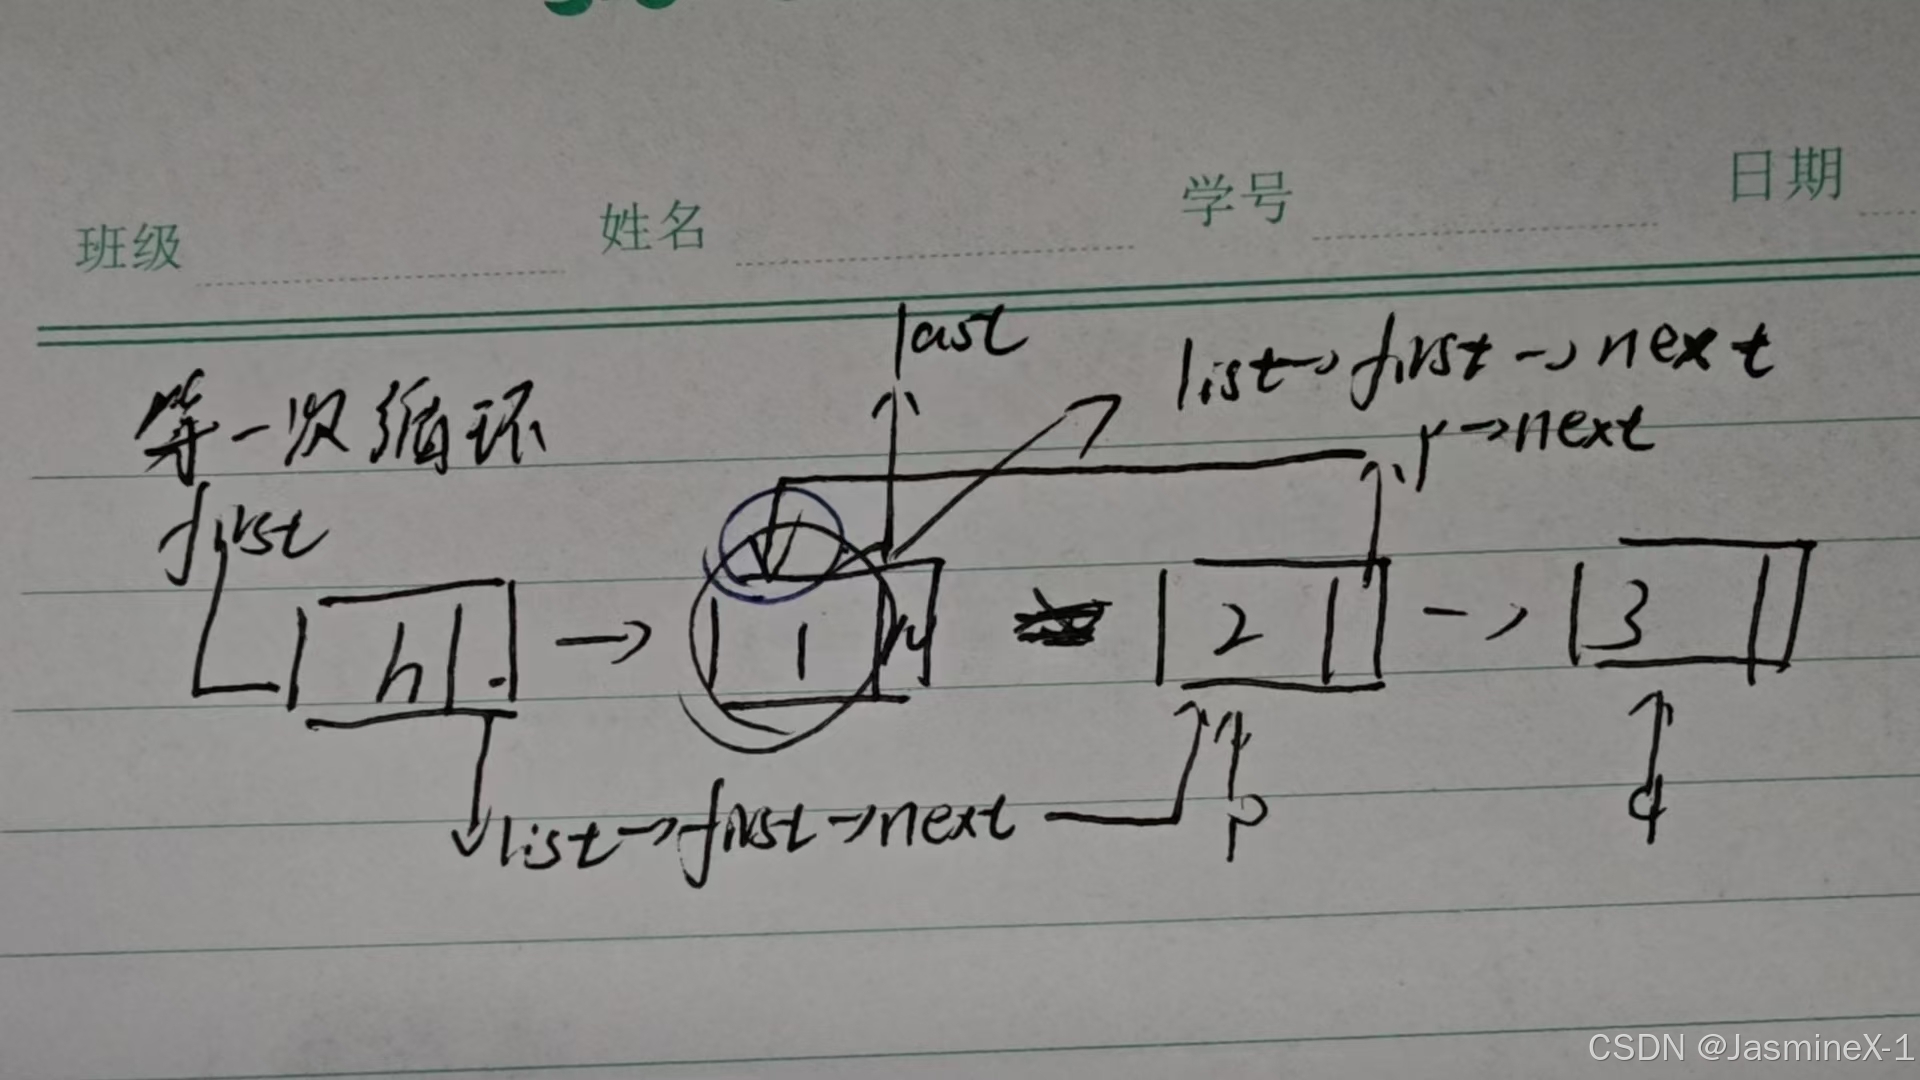
假设链表内容是:
head -> 1 -> 2 -> 3 -> 4 -> NULL
初始状态:
p = 1,q = 2
last = 1,并且 1->next = NULL
链表断开为:
head -> 1 -> NULL      (保存了尾巴)
q = 2 -> 3 -> 4 -> NULL
第一次循环:
p = 2,q = 3
插入到头结点后:
head -> 2 -> 1 -> NULL
q = 3 -> 4 -> NULL
第二次循环:
p = 3,q = 4
插入到头结点后:
head -> 3 -> 2 -> 1 -> NULL
q = 4 -> NULL
第三次循环:
p = 4,q = NULL
插入到头结点后:
head -> 4 -> 3 -> 2 -> 1 -> NULL
清除
void clear(List* list)
{
	if (list->size == 0)
		return;

	Node* p = list->first->next;
	while (p != NULL)
	{
		list->first->next = p->next;
		free(p);
		p = list->first->next;
	}
	list->last = list->first;
	list->size = 0;
}
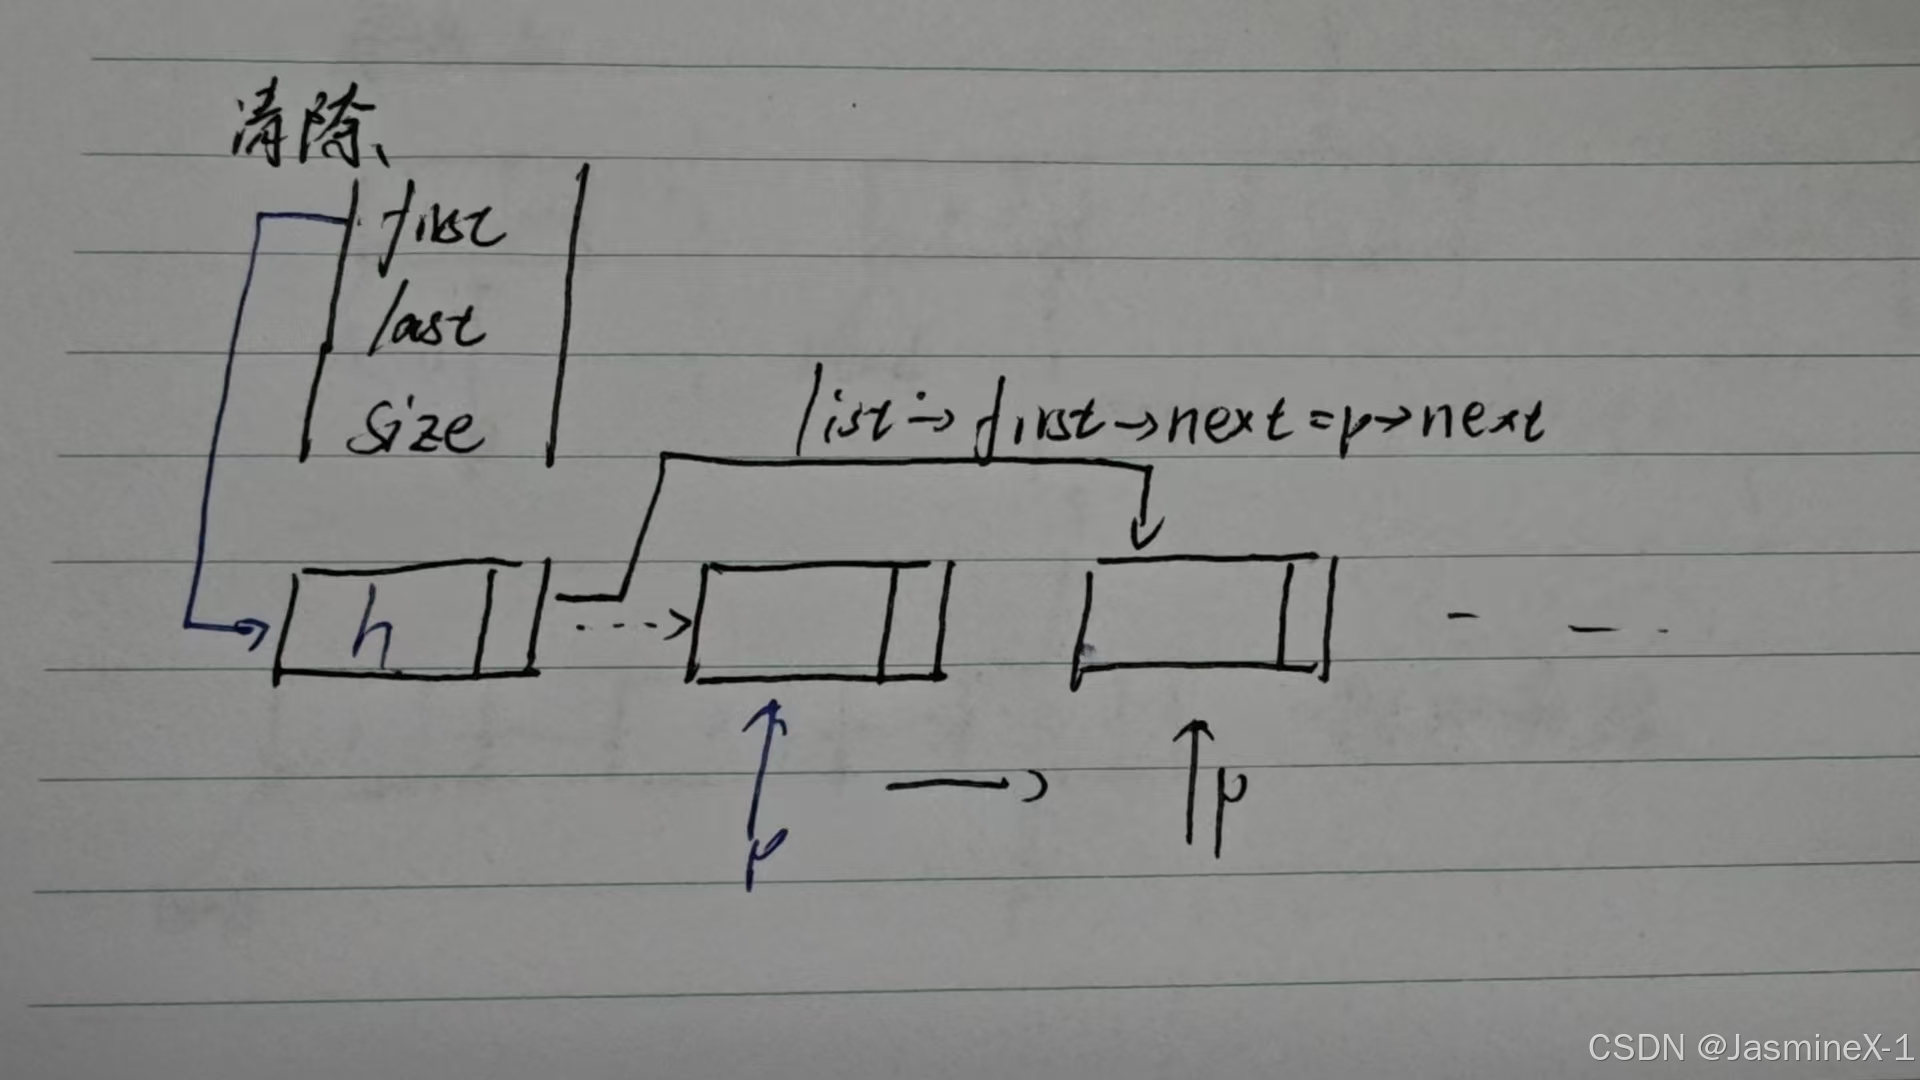
关键点解释:
while 循环释放节点
list->first->next = p->next;
free(p);
p = list->first->next;
这段逻辑很巧妙,它避免了提前保存 p->next。
因为一旦释放了 p,就不能再访问它的 next,所以提前用 list->first->next 保存下一个节点。
最后修复尾指针
当链表清空后,list->last 必须回到头结点,否则链表处于“无效”状态。
size 清零
保证 length(list) 会返回 0,和链表状态一致。
举例
链表初始状态:
head -> 1 -> 2 -> 3 -> NULL
last = 3
size = 3
执行过程:
第一次循环:释放 1
head -> 2 -> 3 -> NULL
p = 2
第二次循环:释放 2
head -> 3 -> NULL
p = 3
第三次循环:释放 3
head -> NULL
p = NULL
结束:
head -> NULL
last = head
size = 0
void destroy(List* list)
{
	clear(list);
	free(list->first);
	list->first = list->last = NULL;
}
解释:
clear(list);
调用 clear 函数释放链表中所有有效节点(头结点之后的节点),并把尾指针指向头结点,大小置 0。
free(list->first);
释放头结点的内存空间。
头结点通常在 InitList 或 malloc 时动态分配,需要单独释放。
list->first = list->last = NULL;
将链表结构的头指针和尾指针置空,避免悬空指针(Dangling Pointer)。
这表示链表已经被完全销毁,不能再访问。
申请空间
Node* _buynode(ElemType x)
{
	Node* s = (Node*)malloc(sizeof(Node));
	assert(s != NULL);
	s->data = x;
	s->next = NULL;
	return s;
}
Node s = (Node)malloc(sizeof(Node));**
为一个新节点动态申请内存空间。
返回的 s 是指向新节点的指针。
assert(s != NULL);
检查内存分配是否成功,如果失败,程序会中止。
s->data = x;
将节点的数据域设置为传入的元素 x。
s->next = NULL;
新节点的 next 指针置空,表示当前节点暂时没有后继。
return s;
返回新创建的节点指针,供链表插入等操作使用。
返回第一或最后一个节点
It begin(List* list)
{
	return list->first->next;
}
It end(List* list)
{
	return list->last->next;
}
返回链表第一个有效节点的指针(头结点后的第一个节点)。
返回尾节点的下一个节点的指针。
插入节点
void insert(List* list, It pos, ElemType x)
{
	Node* p = list->first;
	while (p->next != pos)
	{
		p = p->next;
	}

	Node* s = _buynode(x);
	s->next = p->next;
	p->next = s;
	if (pos == NULL)
		list->last = s;
	list->size++;
}
Node p = list->first;*
定义指针 p 从头结点开始,寻找插入位置的前驱节点。
while (p->next != pos) p = p->next;
遍历链表,直到找到 pos 对应节点的前一个节点 p。
因为单链表无法直接访问前驱节点,所以必须从头结点开始遍历。
Node s = _buynode(x);*
调用 _buynode 创建新节点 s,数据域存放 x,next 初始化为 NULL。
s->next = p->next;
新节点 s 的 next 指向原本前驱节点 p 的后继节点(即 pos)。
p->next = s;
前驱节点 p 的 next 指向新节点 s,完成插入操作。
if (pos == NULL) list->last = s;
如果 pos == NULL,表示在链表末尾插入,需要更新尾指针 last。
list->size++;
链表长度加 1。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 76
 0
- 0


 已为社区贡献1条内容

所有评论(0)