思路
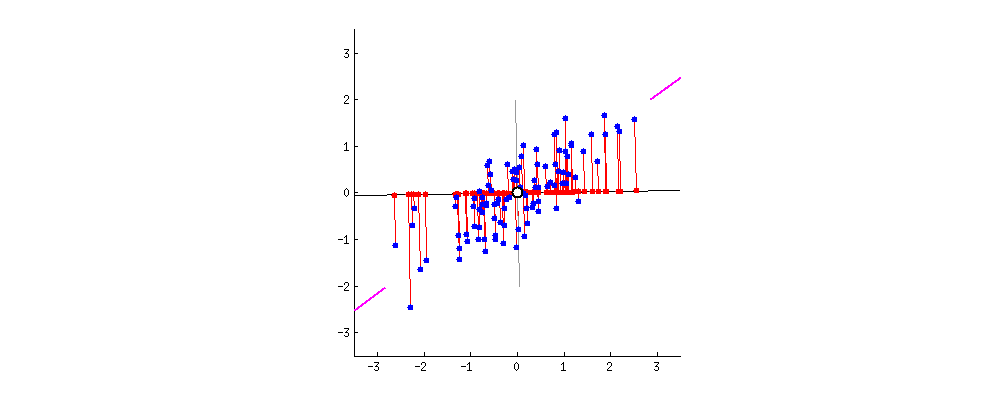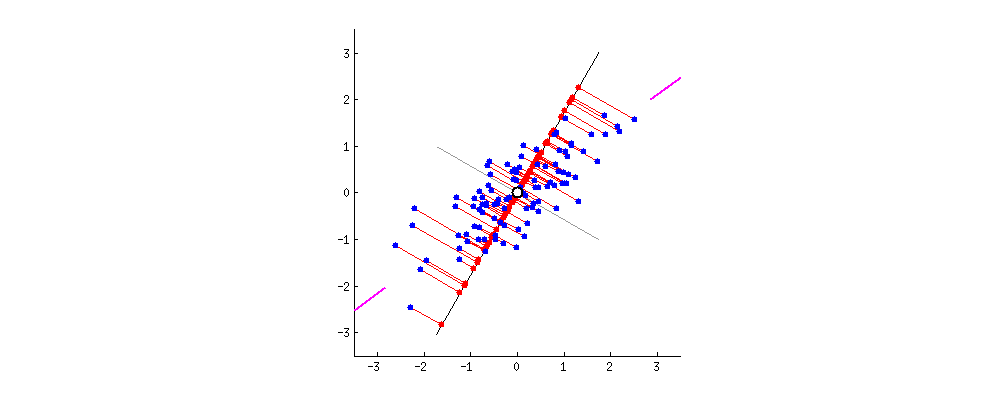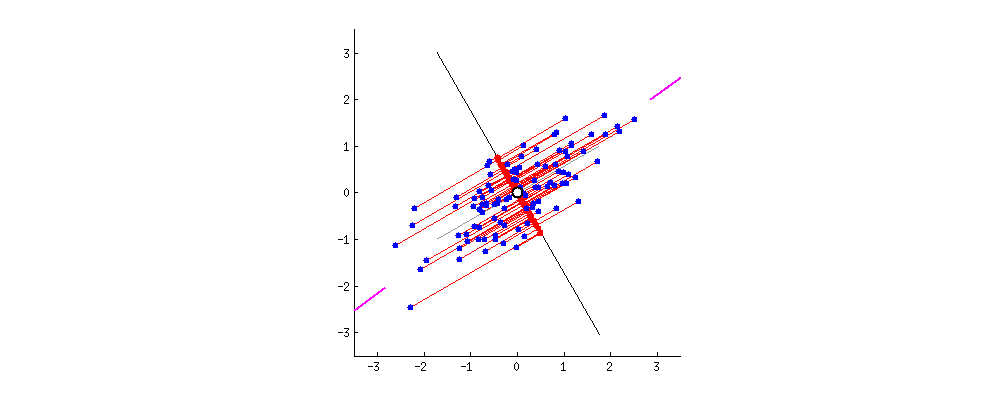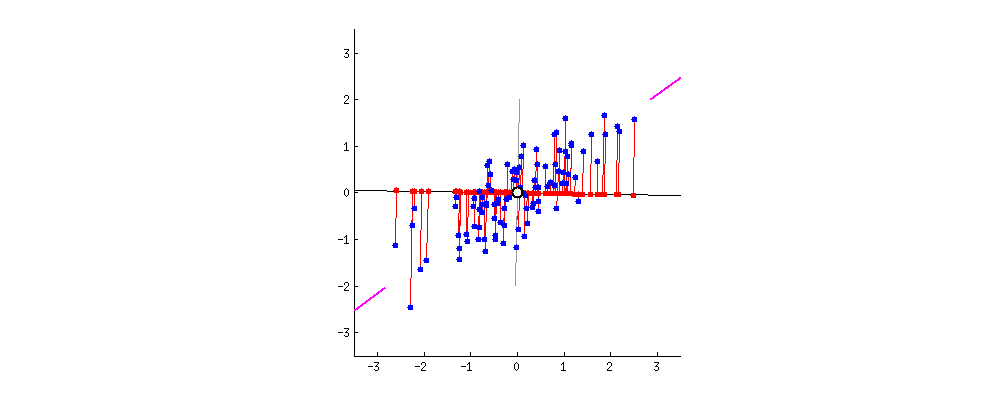
主成分分析、Principal Component Analysis、PCA的推导有很多种途径,我们选择一种,容易理解的来讲解。我们的目的是降维,但是不能胡乱的降,观察下面这组数据:

我们画的是二维情况,但是具体到高维也是可以的。μ<script type="math/tex" id="MathJax-Element-27">\mu</script>是我们目测一个比较好的降维之后的投影方向。但是这只是目测,我们怎么规定这个准则呢?我们规定:
投影之后样本竟可能分散,即样本方差尽可能大。
推导
样本点xi<script type="math/tex" id="MathJax-Element-2">x_i</script>除了可以看成点,还可以看成一条以原点为起点,xi<script type="math/tex" id="MathJax-Element-3">x_i</script>点为终点的向量。样本点xi<script type="math/tex" id="MathJax-Element-4">x_i</script>在坐标轴上的投影长度为:
length=||xi||⋅cos(θ)
<script type="math/tex; mode=display" id="MathJax-Element-5">l ength = ||x_i||\cdot cos(\theta)</script>
其中θ<script type="math/tex" id="MathJax-Element-6">\theta</script>为向量μ<script type="math/tex" id="MathJax-Element-7">\mu</script>和向量x<script type="math/tex" id="MathJax-Element-8">\bf{x}</script>的夹角。我们带入向量内积计算公式得:
length=xi⋅μ||μ||
<script type="math/tex; mode=display" id="MathJax-Element-9">length=\frac{x_i\cdot \mu}{||\mu||}</script>
令||μ||=1<script type="math/tex" id="MathJax-Element-10">||\mu||=1</script>,则可以把这个长度转化成坐标,有在μ<script type="math/tex" id="MathJax-Element-11">\mu</script>坐标轴上新坐标为:
yi=xi⋅μ=xTiμ
<script type="math/tex; mode=display" id="MathJax-Element-12">y_i=x_i\cdot \mu=x_i^{\mathop{T}}\mu</script>
所以在新坐标里样本方差为
1m∑im(yi−y)2
<script type="math/tex; mode=display" id="MathJax-Element-13">\frac{1}{m}\sum_i^m(\bf{y_i}-\bf{y})^2</script>
y<script type="math/tex" id="MathJax-Element-14">\bf{y}</script>是样本均值。我们样本去均值化就方便计算(注:这步去均值化在变换前就可以实施)。所以我们的目标就是:
max 1m∑imyi2=1m∑im(xiTμ)2=1m∑imμTxixiTμ=μT(1m∑imxixiT)μ
<script type="math/tex; mode=display" id="MathJax-Element-15">
\begin{align}
\mathop{max} & \frac{1}{m}\sum_i^m\bf{y_i}^2\\
&=\frac{1}{m}\sum_{i}^{m}\bf{(x_i}^{\mathop{T}}\mu)^2\\
&=\frac{1}{m}\sum_{i}^m\mu^{\mathop{T}}\bf{x_i}\bf{x_i}^{\mathop{T}}\mu\\
&=\mu^{\mathop{T}}(\frac{1}{m}\sum_{i}^m\bf{x_i}\bf{x_i}^{\mathop{T}})\mu
\end{align}
</script>
latex这个
μ<script type="math/tex" id="MathJax-Element-16">\mu</script>实在是加粗不能,凑合看吧,它是个向量。
我把问题写清楚一点:
{max μTMμs.t. μTμ=1
<script type="math/tex; mode=display" id="MathJax-Element-17">
\begin{cases}
max \mu^{\mathop{T}}M\mu\\
s.t. \mu^{\mathop{T}}\mu=1
\end{cases}
</script>
其中M当然等于
(1/m∑mixixiT)<script type="math/tex" id="MathJax-Element-18">(1/m\sum_{i}^m\bf{x_i}\bf{x_i}^{\mathop{T}})</script>啦~
用拉格朗日乘数法解决这个优化问题:
L(μ,λ)=μTMμ−λ(μTμ−1)
<script type="math/tex; mode=display" id="MathJax-Element-19">\mathop{L}(\mu,\lambda)=\mu^{\mathop{T}}M\mu-\lambda(\mu^{\mathop{T}}\mu-1)</script>
∇μL=Mμ−λμ=0
<script type="math/tex; mode=display" id="MathJax-Element-20">\nabla_{\mu}L=M\mu-\lambda\mu=0</script>
得到
Mμ=λμ
<script type="math/tex; mode=display" id="MathJax-Element-21">M\mu=\lambda\mu</script>
至此我们知道啦。搞了半天,
μ<script type="math/tex" id="MathJax-Element-22">\mu</script>是特征向量,
λ<script type="math/tex" id="MathJax-Element-23">\lambda</script>就是对应的特征值啊!
整理与降维
我们回到方差最大化。发现方差为:
μTMμ=λ
<script type="math/tex; mode=display" id="MathJax-Element-24">\mu^{\mathop{T}}M\mu=\lambda</script>
所以特征值越大,我们用对应特征向量作为坐标轴(基)变换后的样本方差也就越大。如果我们选择前k个特征值对应的特征向量,则能达到降维的目的~
降维前:
x=x1⋅v1+x2⋅v2+...+xm⋅vm
<script type="math/tex; mode=display" id="MathJax-Element-25">\mathbf{x}=x^1\cdot \mathbf{ v_1}+x^2\cdot \mathbf{ v_2}+...+x^m\cdot \mathbf{ v_m}</script>
降维后:
y=y1⋅μ1+y2⋅μ2+...+ym⋅μm
<script type="math/tex; mode=display" id="MathJax-Element-26">\mathbf{y}=y^1\cdot \mathbf{ \mu_1}+y^2\cdot \mathbf{ \mu_2}+...+y^m\cdot \mathbf{ \mu_m}</script>
其中上标表示第几维坐标。


 1
 0


 已为社区贡献3条内容

所有评论(0)