机器学习——KNN(K近邻算法)
目录
1、概念理解:
k-nearest neighbors,通过寻找k个距离最近的数据,来确定当前数据值的大小或类别。
理解:K紧邻的K是指距离当前位置最近的K个数据点,K近邻可以用来解决分类问题和回归问题.
回归问题:取到距离当前目标的最近的k个点的值,求平均值
分类问题:取到最近的k个值,统计其中占比最大的类,将要预测的点归为这一类
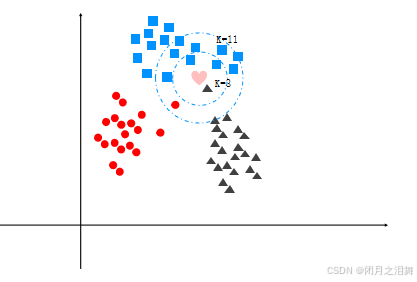
2、k值
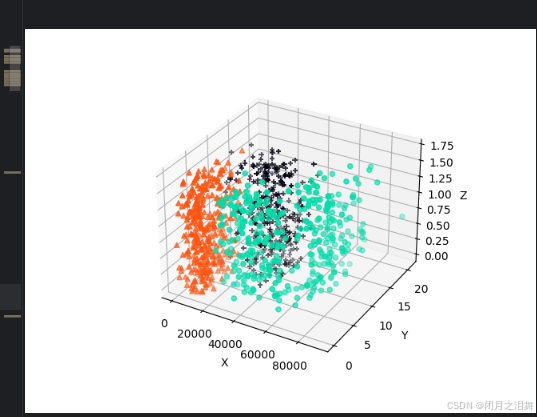
所有相近的数据会聚集在一定的区域内,针对一个新的未知的数据,期望预测它的分类,通过计算当前点与所有数据点之间的距离进行排序,取距离当前点之间的最近的k个值,如果是分类,则
统计这K个值分类中分类占比最多的值;如果是回归,则计算这K个值对应数据的平均值。
3、距离的计算:
欧式距离:二维:a点为(x1,y1),b点为(x2,y2);
三维:a点为(x1,y1 ,z1),b点为(x2,y2 ,z2)
N维:a点为(x11,x12 ,…,x1n),b点为(x21,x22,…,x2n);
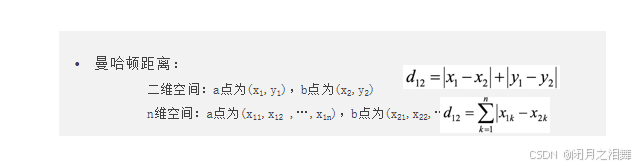
除了最常用的欧式距离,还有许多计算距离的方法,像曼哈顿距离等等。
4、参数分析
class sklearn.neighbors.KNeighborsClassifier(n_neighbors=5, *, weights='uniform', algorithm='auto', leaf_size=30, p=2, metric='minkowski', metric_params=None, n_jobs=None)
(1)n_neighborsint,默认值= 5
默认使用的邻居数量kneighbors查询。
(2)权重:uniform、distance、callable, 默认值为uniform
预测中使用的重量功能。可能的值:
-
uniform:uniform的权重。每两个点之间的都平等加权。
-
distance:权重的点的距离倒数。在这种情况下,与距离远处的邻居相比,查询点的近邻居的影响力更大。
-
callable:一个接受距离数组的用户定义功能,并返回包含权重的相同形状的数组。
(3)算法(algorithm):auto,ball_tree,kd_tree,brute,默认='auto'
用于计算最近邻居的算法:
注意:稀疏输入上的拟合将使用蛮力覆盖此参数的设置。
(4)laf_size:int,默认值= 30
叶子大小传递给Balltree或Kdtree。这可能会影响构造和查询的速度,以及存储树木所需的内存。最佳价值取决于问题的性质。
(5)p:int,默认值= 2
Minkowski度量的功率参数。当p = 1时,这等同于使用曼哈顿_distance(L1),而euclidean_distance(l2)用于p = 2。对于任意p,使用minkowski_distance(l_p)。
(6)metric:str或callable,默认='minkowski'
用于树的距离度量。默认度量是Minkowski,p = 2等于标准的欧几里得公制。如果“预先计算”,则假定X是距离矩阵,并且必须在拟合期间为正方形。 x可能是一个稀疏图,在这种情况下,只有“非零”元素可以被视为邻居。
(7)metric_params:dict,默认值=无
公制函数的其他关键字参数。
(8)n_jobs:int,默认值=无
用于邻居搜索的并行作业数量。 None表示1,除非在joblib.parallel_backend语境。 -1意味着使用所有处理器。
案例:
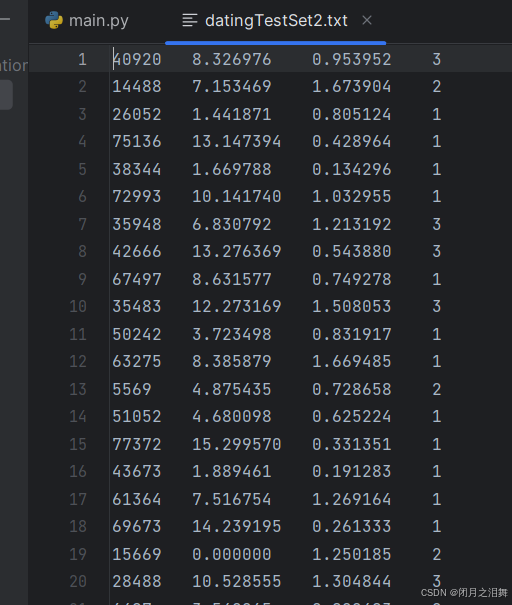
现已存在一个数据文件datingTestSet2.txt ,为历年大学生的调查问卷表 第1列:每年旅行的路程 第2列:玩游戏所有时间百分比 第3列:每个礼拜消耗零食的重量 第4列:学生所属的类别,1表示爱学习,2表示一般般,3表示爱玩。 目的为学生在大学中挑选室友的信息
数据文件分析:总共四列,前三列是大二大三大四的特征,最后一列是标签
利用历史数据-->预测新的数据
# from sklearn.neighbors import KNeighborsClassifier  #从机器学习库sklearn中导入K近邻分类器
#
# data=np.loadtxt("datingTestSet2.txt")#导入数据
#
# X=data[:,0:3]   #表示获取data数据中的每一行,每一列,但是不包含最后一列
# y=data[:,-1]    #表示获取data数据中的每一行,每一列,但是不包含最后一列
# # print(X)
# # print(y)
#
# student=KNeighborsClassifier(n_neighbors=3,algorithm='ball_tree').fit(X,y)  #创建模型对象,并对给出的数据进行训练,
# #predict表示预测。传入一个符合数据特征的测试集合
# print(student.predict([[40000,6,0.5]]))
#
# predict_data =[[9744,11.440364,0.760461],   #4个学生的数据,预测这四个人的类别
#             [16191,0.100000,0.605619],
#             [42377,6.519522,1.058602],
#             [27353,11.475155,1.52862611]]
# print(student.predict(predict_data))

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 28
 0
- 0


 已为社区贡献11条内容

所有评论(0)