机器学习综述(考试整理的)
一 机器学习历史
机器学习源自人工智能。早期的人工智能主要分为两个阶段:一个是逻辑推理,第二个阶段是专家系统。
1 逻辑推理:主要通过数学符号的逻辑来模拟智能。
2. 专家系统:利用各个领域的专家知识建立相应的知识库,利用专家经验知识完成推理和决策。
3. 机器学习算法:在1980年之前,这些机器学习算法都是零碎化的,不成体系。从1980年开始,机器学习才真正成为一个独立的方向。在这之后,各种机器学习算法被大量的提出,得到了快速发展。决策树算法是1980年代到1990年代初期的重要成果,虽然简单,但可解释性强,这使得决策树至今在一些问题上仍被使用。
二 机器学习算法类型
①监督学习:是指在学习的过程当中,所有的数据样本都有对应的标签的机器学习过程。其中监督学习又分为分类和回归两种。
分类:给定一个样本的值,输出该样本的类别。
回归:给定一个样本的值,输出该样本对应的数值。
②无监督学习:是指在学习的过程当中,所有的数据样本都没有对应的标签的机器学习过程。其中聚类与LDA主题提取为目前的代表。
③半监督学习:就是指在学习的过程当中指在学习的过程当中只有一部分数据带有标签,这是一种基于监督学习和无监督学习的一种学习过程。
④强化学习:
三 机器学习的四要素
①数据:机器学习就是解决数据的问题
②模型:根据先验知识以及数学知识建立对应的数学模型来解决问题。
③策略:我们建立好了模型以后就要训练模型,然而策略就决定了我们朝哪个方向训练模型,具体体现为损失函数的制定。
④优化方法:这个可以理解为③的具体求解过程。
四 线性回归
回归(regression)问题是监督学习的一个重要问题。回归用于预测输入变量(自变量)和输出变量(因变量)之间的关系,特别是当输入变量的值发生变化时,输出变量的值野随之发生变化。回归模型正是表示从输入变量到输出变量之间映射的函数。
线性回归是回归中的一种,它的Loss function可以表示为如下: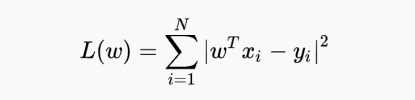
W就是回归函数:Y=w1x1+w2x2+…+wn*xn,其中W就是向量
(w1,w2,w3…w3),W通过直接求导可以算出
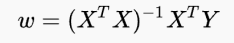
五 模型的过拟合和欠拟合问题
(1)欠拟合:模型拟合程度不高,数据距离拟合曲线较远。具体的表现是在训练集上的效果都很差,也可被称作高偏差。
(2)过拟合:模型在训练集上面表现良好,但是在测试集上表现很差。就是或拟合过度了,也被叫做高方差。
补充:
1偏差 (bias) 定义为模型的期望预测与真实值之间的差异。
2.方差 (variance) 定义为衡量模型对不同数据集的敏感程度
具体的区别可以如下所示:
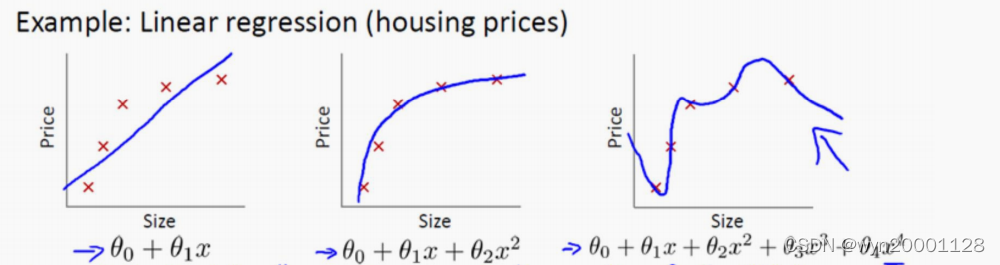
由样本数据可见房价随之面积的增大而增大,且增大的趋势逐渐变小。下面是对每一张图片拟合情况的分析:
①拟合的曲线里数据样本点比较远,可见拟合得程度非常不够。所以属于欠拟合。
②可见拟合的曲线基本穿过数据样本点,且曲线的趋势和数据的趋势也差不多,所以这表示拟合得刚刚好。
③拟合的曲线顺利经过了每个数据样本点,但是,这实际上是一条很扭曲的曲线,它不停上下波动,这不符合趋势,可见拟合过了头。所以属于过拟合
(3)如何在训练中发现过拟合
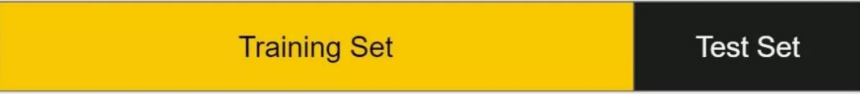
我们可以将初始数据集拆分为单独的训练和测试子集。如果模型在训练集上比在测试集中表现得好得多,那么我们很可能会过拟合。
(4)防止过拟合的方法
①增大数据:复杂的模型训练少量的数据就会过拟合。
②减少模型参数:让模型变得简单一点,不要拟合地太过了。
③正则化
六 交叉验证方法(一种模型效果的验证方法)
交叉验证就是将初始训练数据拆分成多个数据集,使用这些拆分子集来调整模型。
例子:十折交叉验证过程:
1.将数据集分成十份,轮流将其中9份作为训练数据,1份作为测试数据,进行试验。每次试验都会得出相应的正确率。
2. 10次的结果的正确率的平均值作为对算法精度的估计,一般还需要进行多次10折交叉验证(例如10次10折交叉验证),再求其均值,作为对算法准确性的估计。
七 KNN算法
k近邻算法是一种基本的分类算法:k-NN算法假设给定的训练集的实例类别已经确定,对于新来的实例,k-NN算法根据其k个最近邻的训练集实例的类别,通过多数表决等方式对新实例的类别进行预测。
KNN算法的三要素:
①K值的选择 ②分类的决策规则 ③样本间距离的度量方式
k值较小时,整体模型会变得复杂,且对近邻的训练实例点较为敏感,容易出现过拟合。 k值较大时,模型则会趋于简单,此时较远的训练实例点也会起到预测作用,容易出现欠拟合。
下面为KNN算法的损失函数:
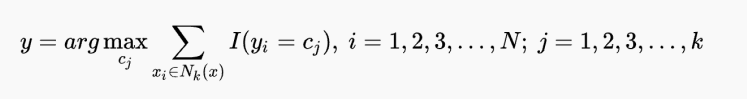
K值的选择:
一般会先选择较小的k值,然后进行交叉验证选取最优的k值。也根据误分类率最小即经验风险最小选择k值
八 朴素贝叶斯算法
朴素贝叶斯算法基本流程:
1.对于给定训练数据集,首先基于特征条件假设学习输入输出的联合概率分布。
2. 预测时基于此模型,对给定的新数据,利用贝叶斯定理求出后验概率最大的输出,作为预测结果。
下面就是朴素贝叶斯的计算方法:
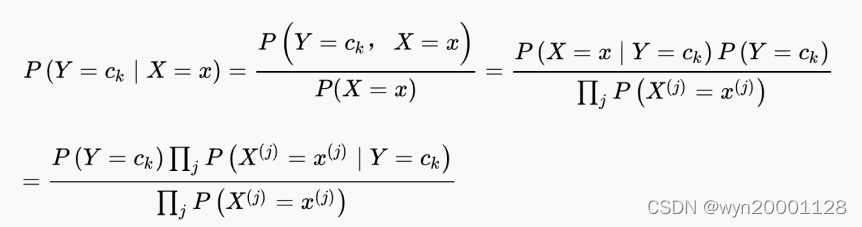
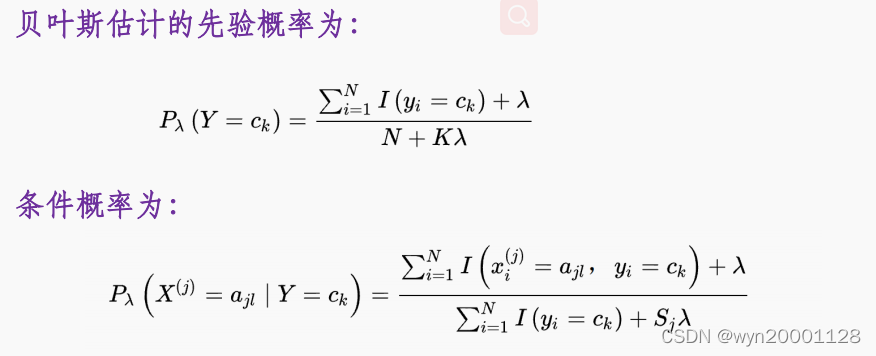
但是有时候下面两个概率会出现0的情况,这样不利于算法的计算,所以要加下面的处理:N为样本综述,K为样本的类别数量,Sj为Y=ck的情况之下属性的类别种类个数,lamda=1的时候就是拉普拉斯平滑
九 决策树算法
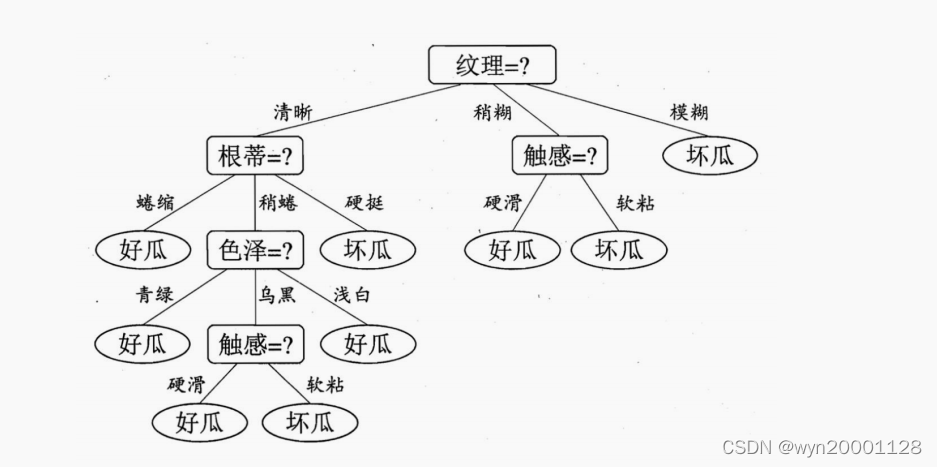
决策树(decision tree)是一个树结构。 其每个非叶节点(内部节点)表示一个特征属性上的测试,每个分支代 表这个特征属性在某个值域上的输出,而每个叶节点存放一个类别。
学习(训练)过程:通过对训练样本的分析来确定“划分属性”。
测试过程:使用决策树进行决策的过程就是从根节点开始,测试待分类 项中相应的特征属性,并按照其值选择输出分支,直到到达叶子节点, 将叶子节点存放的类别作为决策结果。下图就是一颗已经建好的决策树:
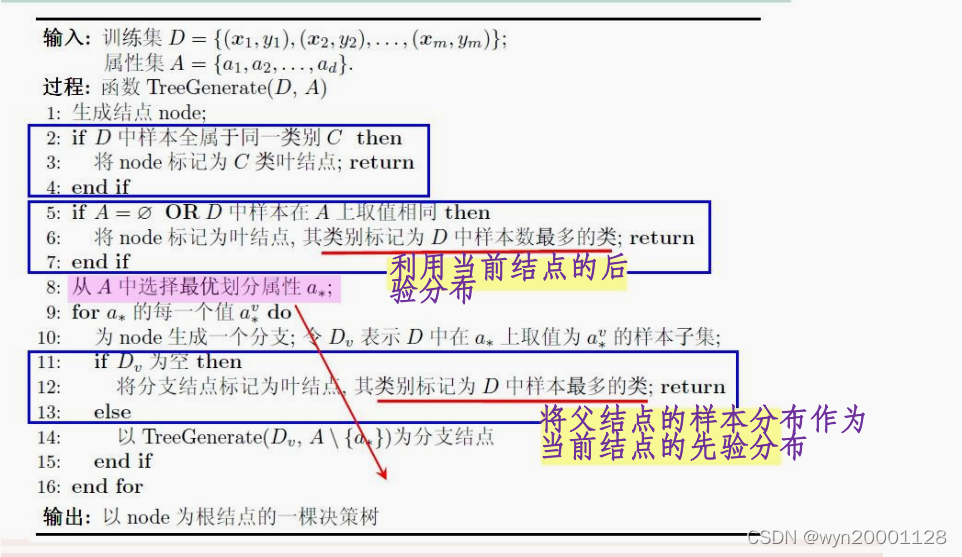
下图就是决策树的构建的递归过程:
停止条件:
(1) 当前结点包含的样本全属于同一类别,无需划分;
(2) 当前属性集为空, 或是所有样本在所有属性上取值相同,无法划分;
(3) 当前结点包含的样本集合为空,不能划分。
从步骤当中我们可以看出来最优属性划分就是关键,我们一般是采用以下几个准则来挑选最佳划分属性,在这个过程中我们希望纯度越来越高:
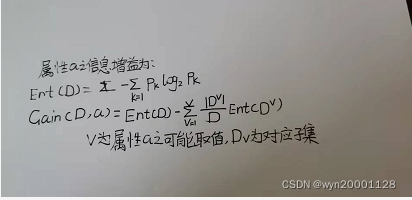
①信息增益:信息增益越大表示使用特征 A 来划分所获得的纯度提升越大,就是说越大越好。具体公式如下:
②增益率:信息增益准则对取值数目较多的属性有所偏好,为了减少这种影响,我们引入了增益率。公式如下:
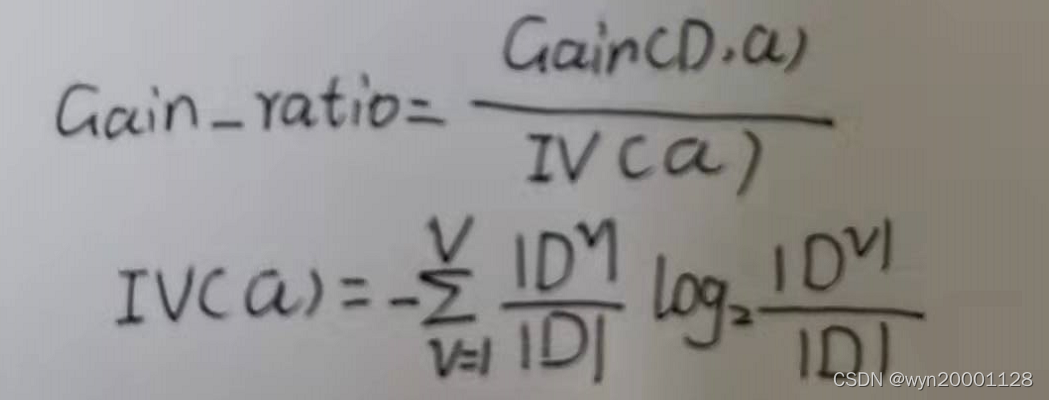
但是增益率准则对可取值数目较少的属性有所偏好。
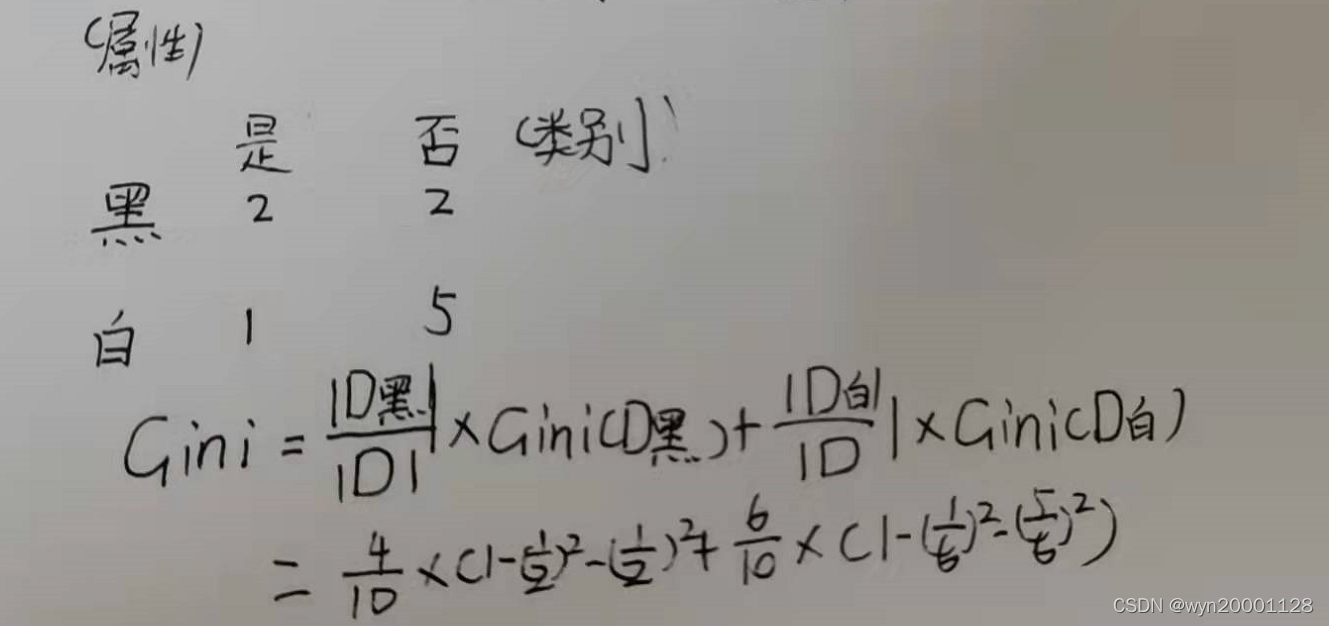
③基尼指数:反映了从数据集中随机抽取两个 样本。其类别不一致的概率。因此基尼指数越小,数据纯度越高。Gini(D) 越小,数据集 D 的纯度越高,所以基尼指数越小,作为划分属性越优秀。属性a的基尼指数计算公式如下:
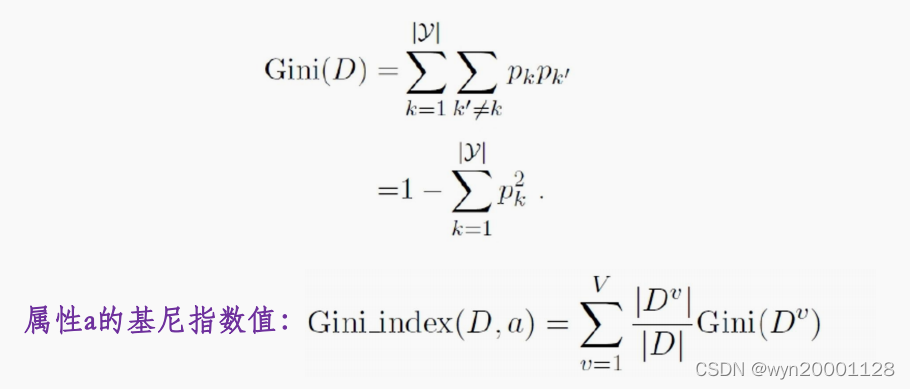
注:Dv是D在属性a上不同取值划分的子集,而基尼指数计算的Pk是子集上面样本取不同类别的概率。具体计算方法如下图所示:
在构建决策树的过程中,剪枝方法和程度对决策树泛化性能的影响更为显著在数据带噪时甚至可能将泛化性能提升 25% 。也就说剪枝可以解决决策树模型的过拟合问题。剪枝策略可以分为预剪枝和后剪枝两种:
①预剪枝:在决策树生成的过程中,对每个节点在划分前先进行估计,若当前的划分不能带来决策树泛化能力的提升,则停止划分并将当前的结点标识为叶子结点。可以使用验证集做到这一点。
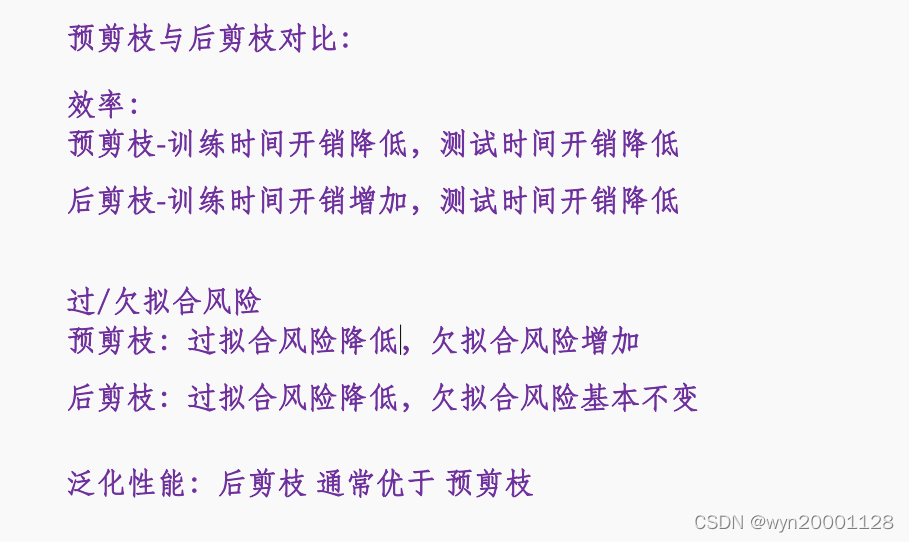
②后剪枝:后剪枝算法是先学习一棵完整的决策树,然后自底向上对非叶子结点进行分析,若该结点对应的子树替换为叶子结点能带来决策树泛化能力的提升,则将改子树替换为叶子结点。下面是两个的对比:相比起后剪枝,预剪枝更容易引起欠拟合,但是后剪枝训练时间增加。
从上面的决策树过程我们可以看出来决策树没有处理连续值属性和缺失值在决策树生成过程中该怎么处理。
①连续值属性:我们遇到连续值属性的时候可取的值有无穷种,所以没有办法继续算法,因此可以采用连续离散化技术。
②缺失值:应用之中常常会出现一个样本的属性缺失。直接舍弃一个样本太可惜了。所以我们在挑选最优属性的时候,如计算属性a的基尼指数的时候,就挑属性a上面没有缺失值的样本值来计算就行。
十 Logistics Regression(训练一个超平面用于分类)
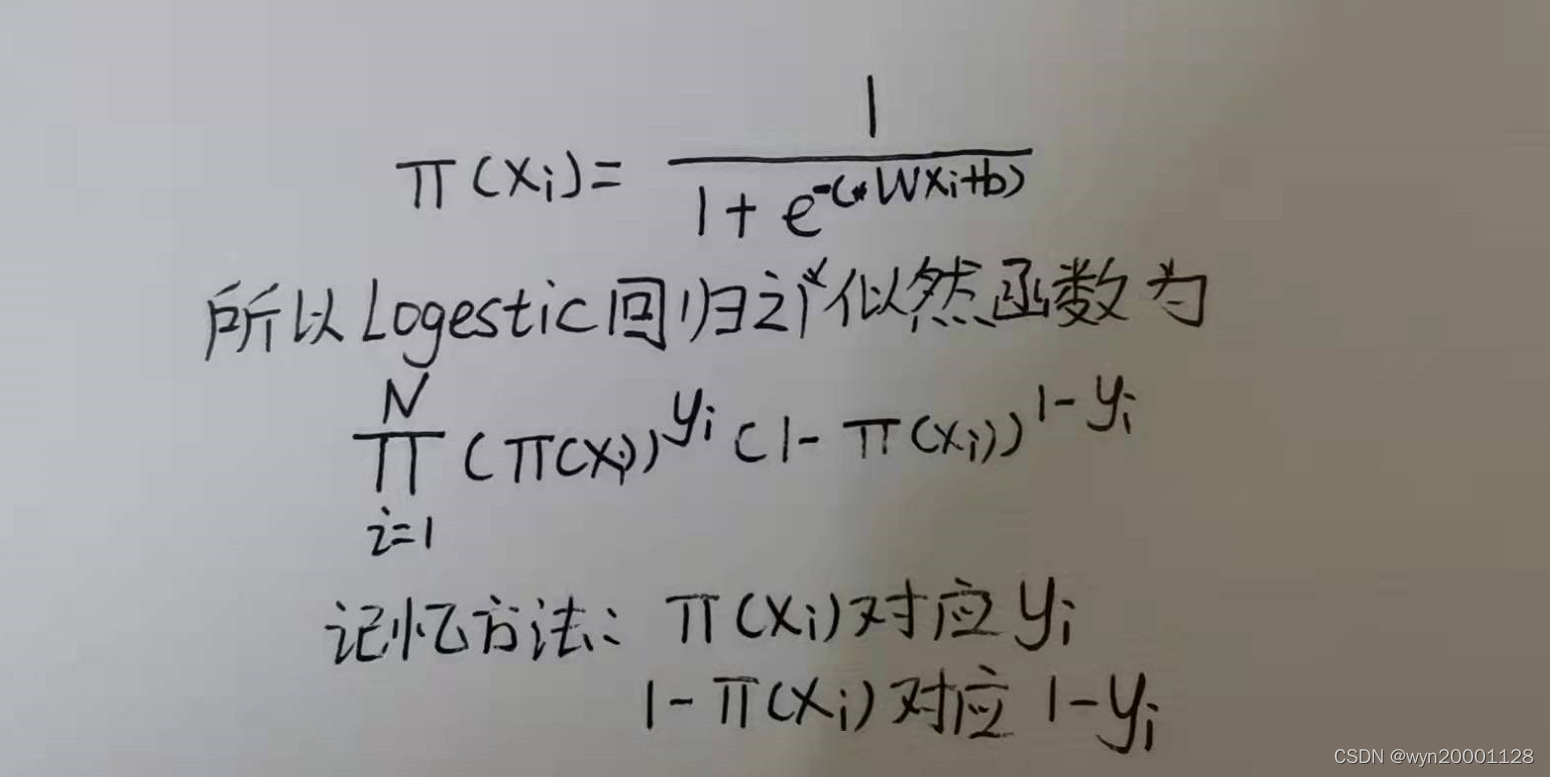
(1)sigmoid函数:
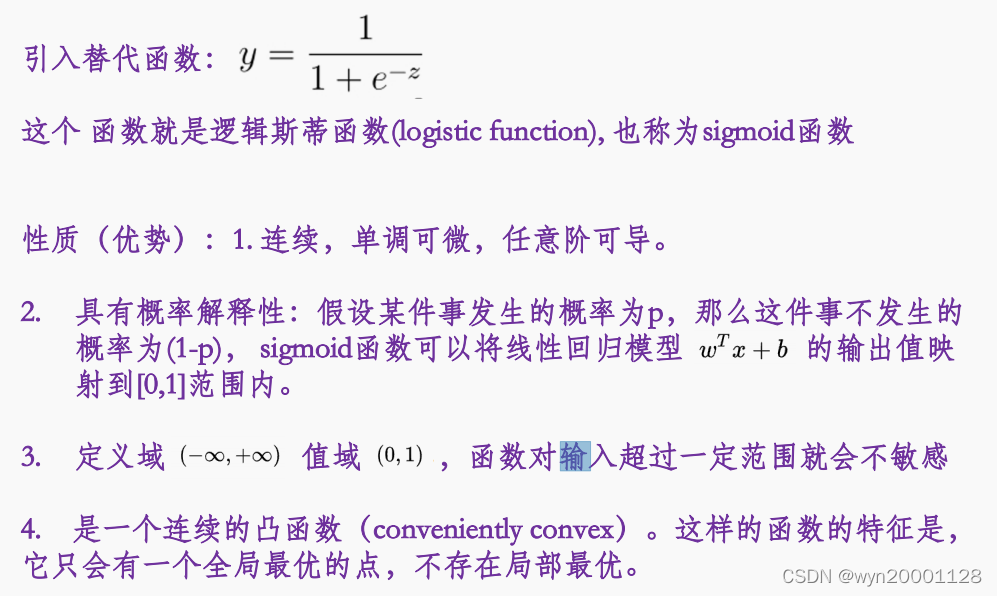
这个函数在Logistic回归里面的形式是:
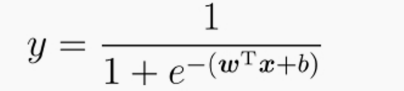
所以似然函数为:
十一 梯度下降算法
优化算法就是要寻找函数取最小值。然而在LR模型中,很难直接解出函数的最小值。梯度下降法(gradient descent)是一种求最小值的代替方法,也是一种常用的一阶(first-order)优化方法,算法通过缓慢地移动函数中的点进行摸索 ,从而找出函数的最小值。梯度下降算法体现在模型的训练当中,就是对Loss函数中的模型的权值W求偏导,优化W让Loss函数最小,具体的式子如下所示(注意有学习率的存在):
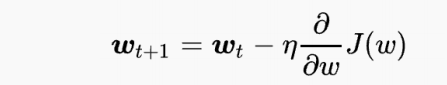
十二 线性判别分析(LDA)
样例投影到一条直线(低维空间)。这条直线满足:
1.减少分类内部之间的差异:类内方差最小化。
2.扩大不同分类之间的差异:类间方差最大化。
推导的过程如下所示:
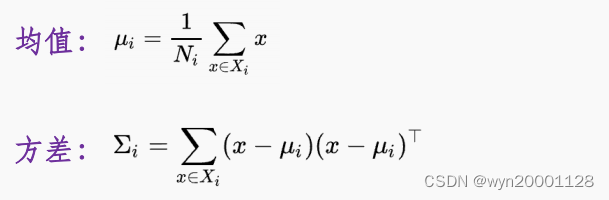
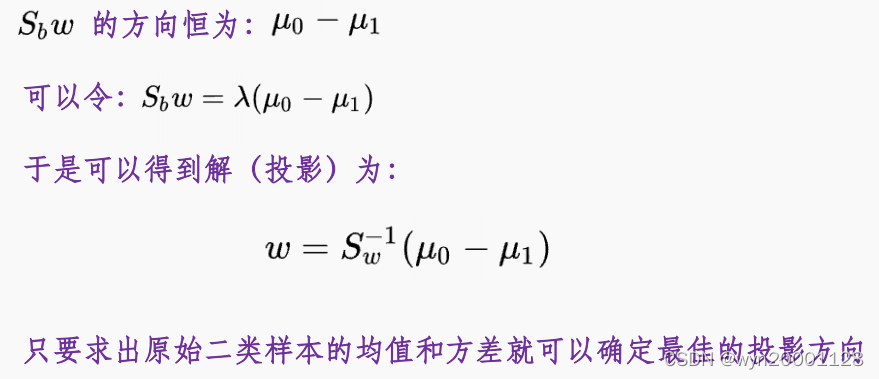
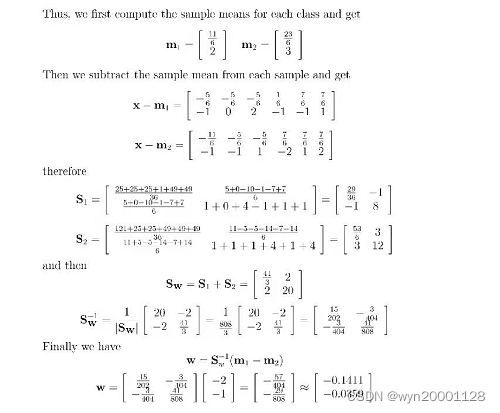
具体的方法如下:(附:m1,m2是向量的均值,X1-m1是m1所对应的向量减去m1后拼接而成的矩阵,S1的主对角线上,第一列是X-m1第一列的方差,第二列是X-m1第二列的方差,副对角线上是X-m1两列的内积.X2-m2,S2也以此类推)
十三 神经元网络
(1)感知机
感知机由输入和输出两层神经元组成,输入层有多个神经元,输出层只有一个神经元。这样的一个感知机可以用来做分类问题。如下图所示: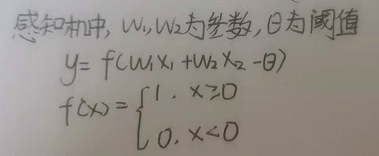
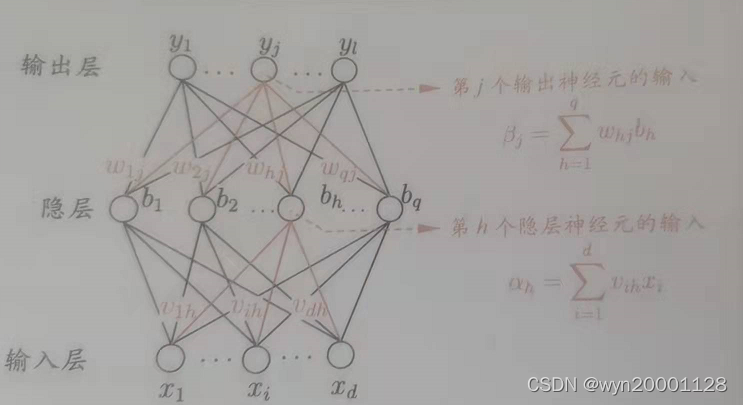
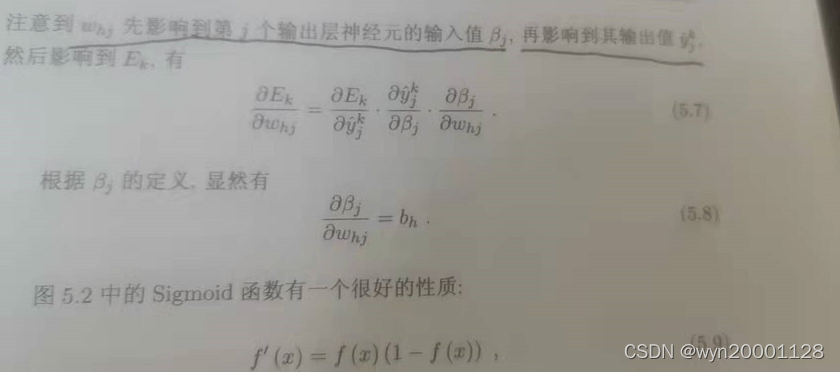
(2)BP神经网络的反向传播过程(每一次经过一个点都要激活函数工作一次)
十四 集成学习
集成学习通过构建并结合多个学习器来完成学习任务用多个弱分类器构成一个强分类器。集成的泛化性能通常显著优于单个学习器的泛化性能。根据集成学习的基学习器不同可以分为同质集成和异质集成。
(1)Boosting算法
Boosting的弱分类器形成是同一种机器学习算法,只是其数据抽取时的权值在不断更新,每次都是提高前一次分错了的数据集的权值,最后得到T个弱分类器,且分类器的权值也跟其中间结果的数据有关。下面以Adaboost为例子说明Boosting算法:
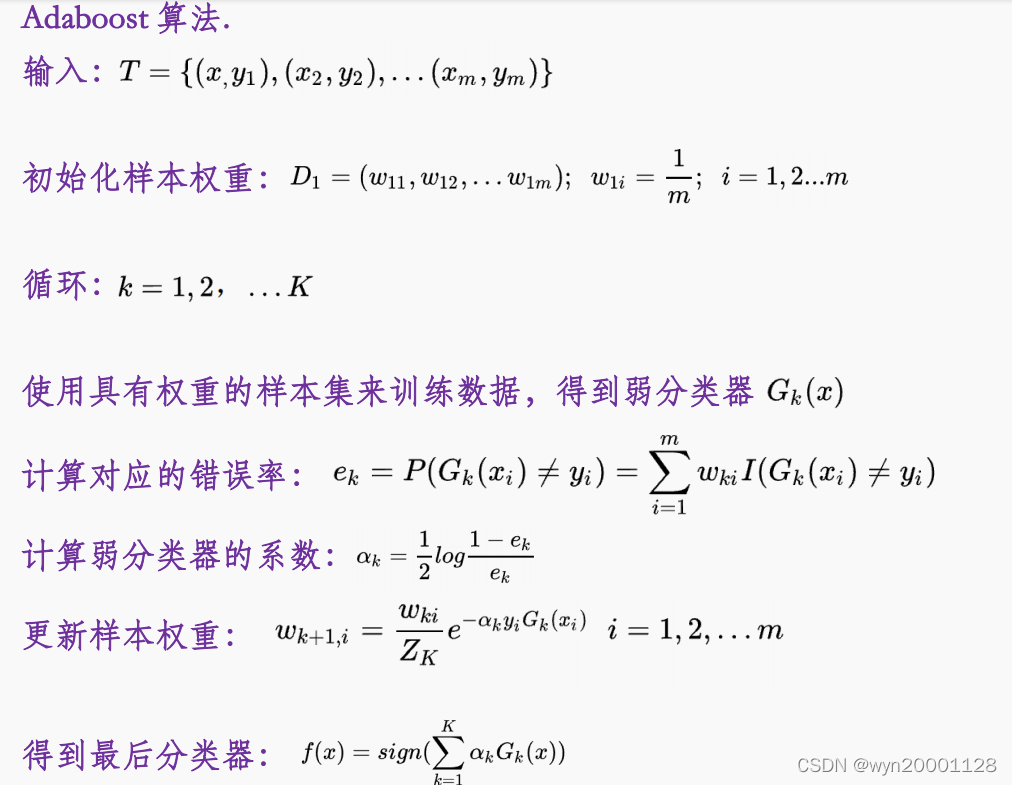
迭代训练弱分类器。在迭代过程中,需要对样本权重进行更新。如果某个样本点已经被准确地分类,那么在训练下一个弱分类器时,就会降低它的权值;相反,如果该个样本点没有被准确地分类,就会提高它的
权值。
将各个弱分类器加权平均得到强分类器。误差率 e 低的弱分类器权重较大,误差率 e 高的弱分类器权重较小。
(2)Bagging 算法
①Bagging算法的3个基本步骤:
从原始样本中随机采样,每轮从原始样本集中有放回的选取n个训练样本
每次使用一份训练集训练一个模型,k 个训练集共得到 k 个基模型
使用k 个基模型进行任务。
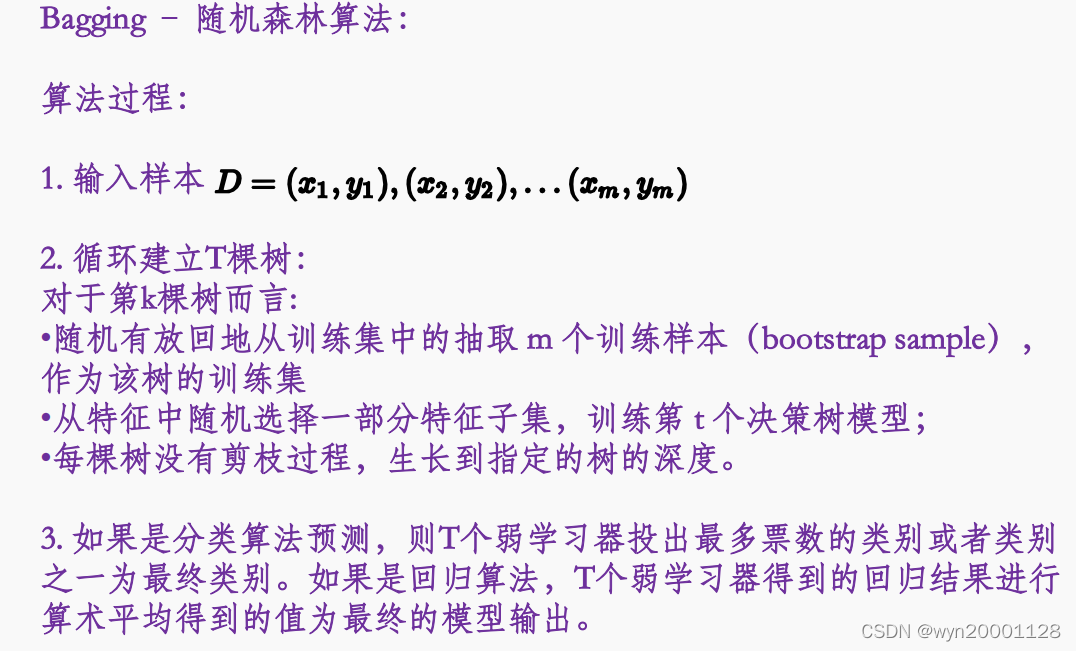
随机森林(Random Forest)是Bagging的一个扩展变体。随机森林算法在以决策树为基学习器构建Bagging的基础上,进一步在决策树的训练过程中引入了随机属性选择。下面是具体的步骤:
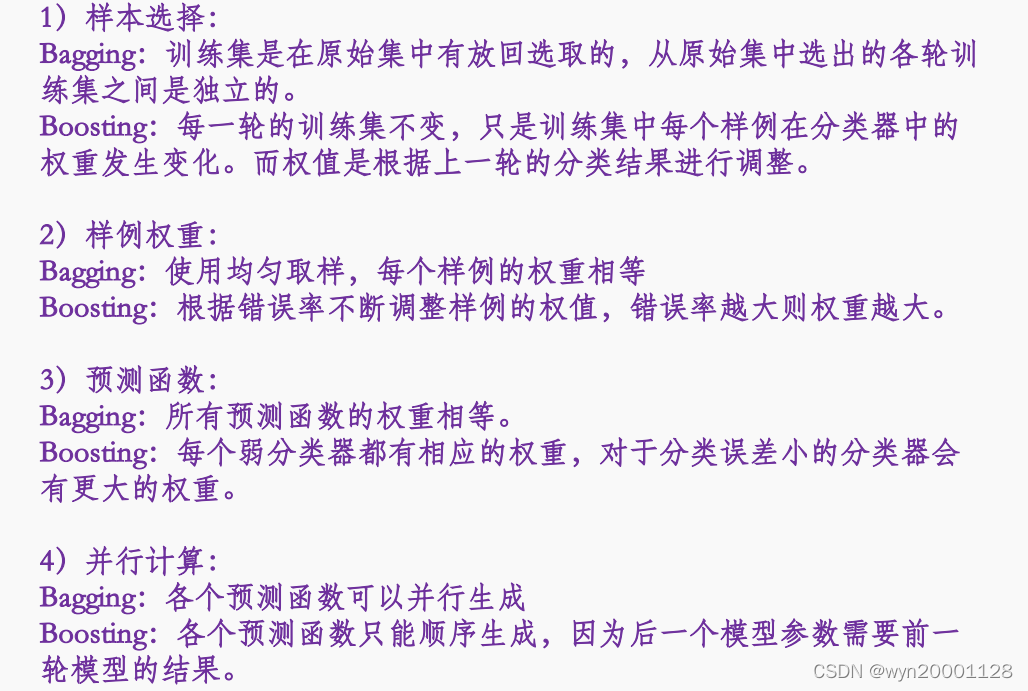
(3)Boosting和Bagging的区别
十五 SVM
(1)最大间隔超平面
为了使分类器的超平面更具鲁棒性,需要会去找最佳超平面,以最大间
隔把两类样本分开的超平面(最大间隔超平面):
1 两类样本分别分割在该超平面的两侧;
2 两侧距离超平面最近的样本点到超平面的距离被最大化了。
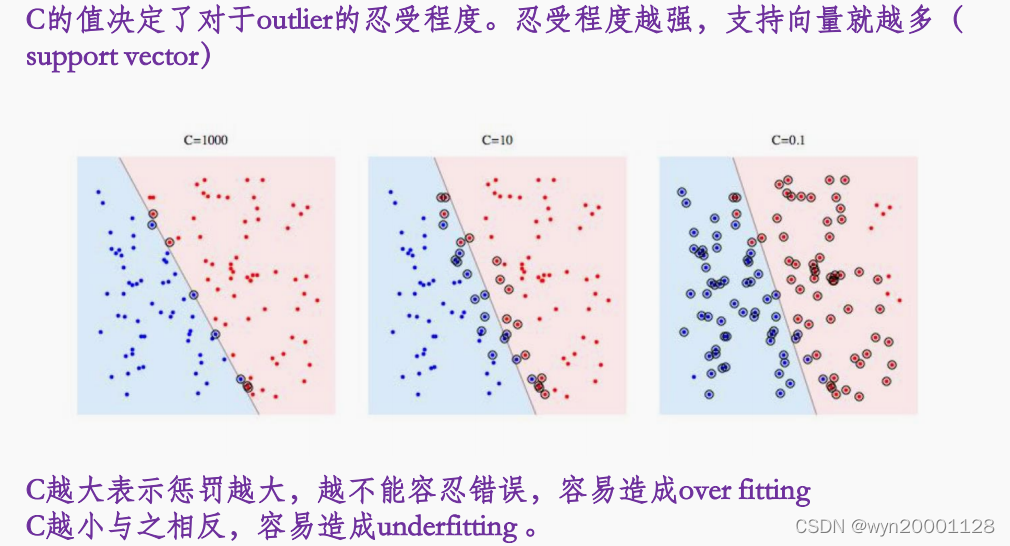
(2)软间隔
(3)核函数
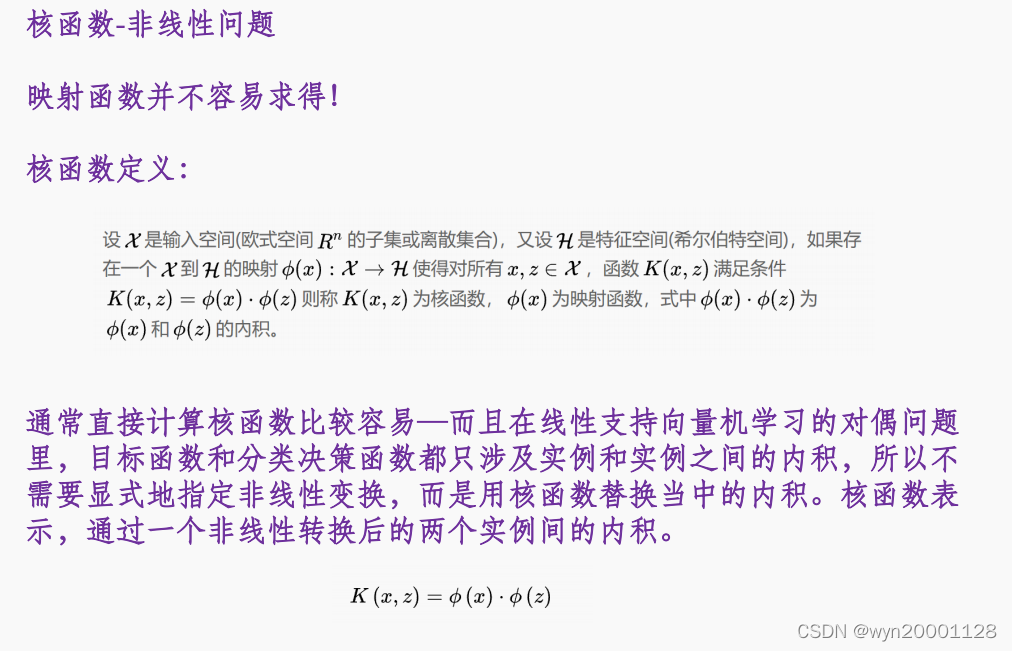
具体的操作过程如下:
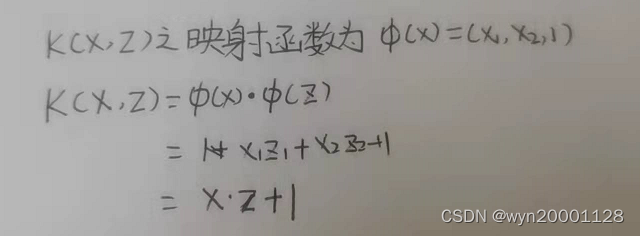
十六 聚类
(1)距离计算
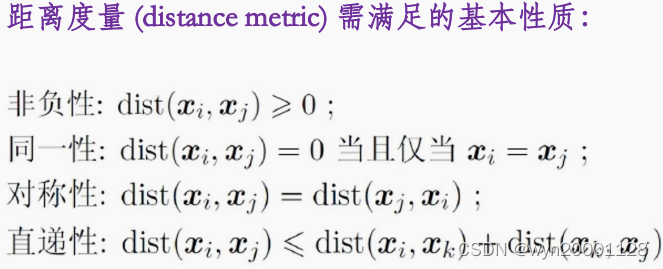
(2)K-means
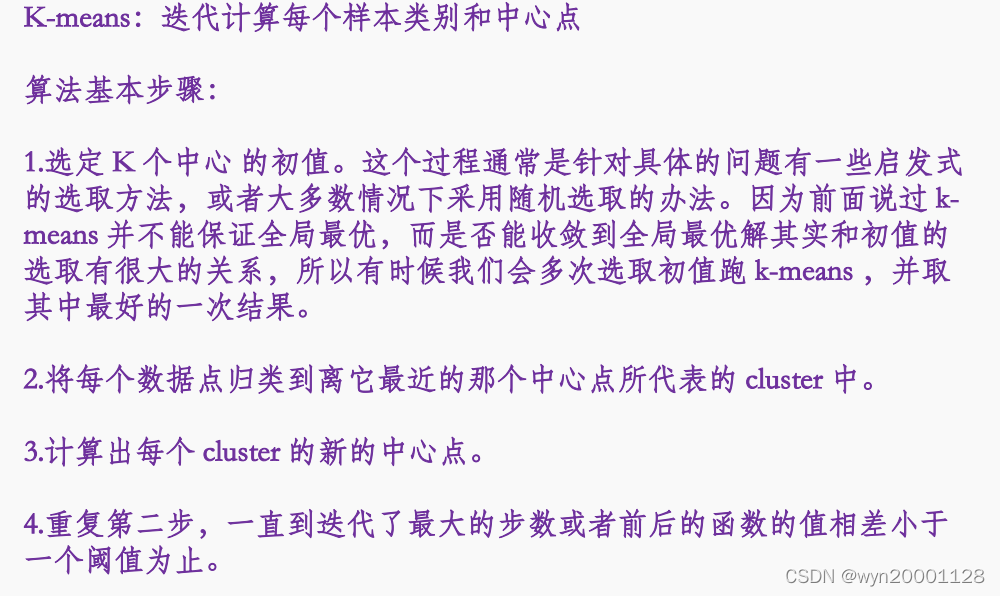
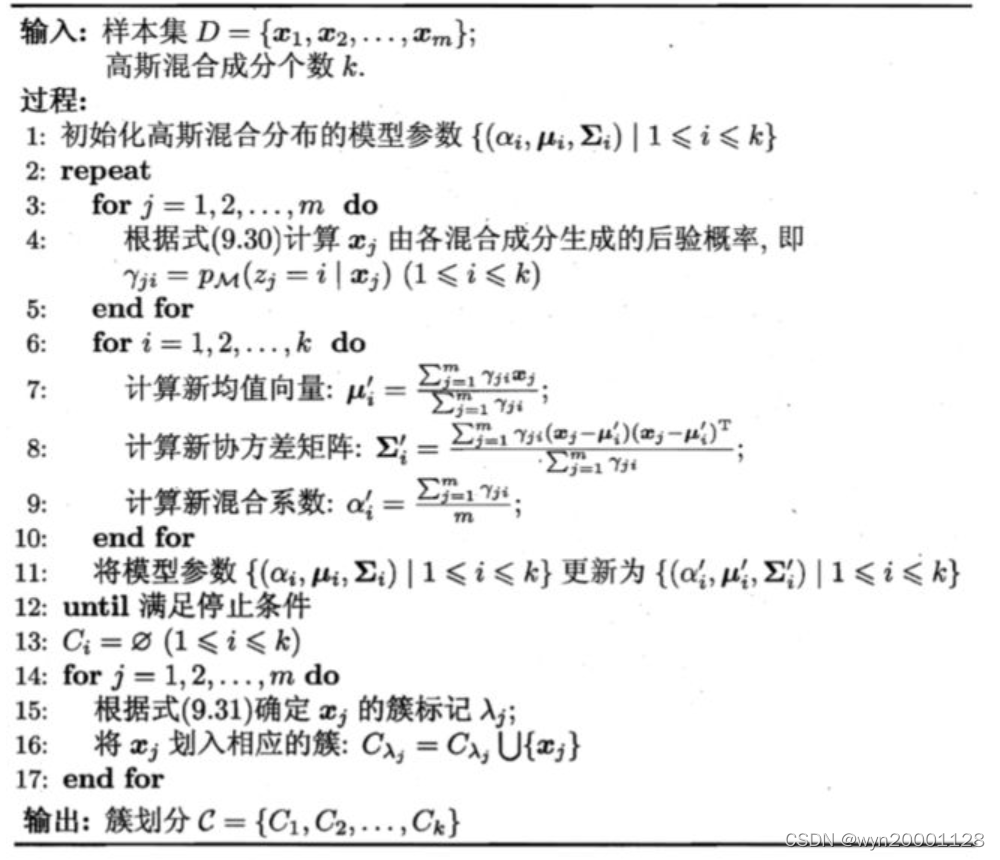
(3)GMM(高斯混合聚类模型)
(4)层次化聚类
通过计算不同类别数据点间的相似度来创建一棵有层次的嵌套聚类树。在聚类树中,不同类别的原始数据点是树的最低层,树的顶层是一个聚类的根节点。
自下而上: 将每个样本分为一类,并计算每个样本两两之间的距离,将距离最近的两个类合并为一个新的类,此时需要计算新类与其它类之间的距离,并在所有距离中再选出距离最短的两个类进行合并,重复此操作直到满足停止条件。
下面是3个计算类与类之间距离的方法:
1 Single Linkage:就是取两个集合中距离最近的两个点的距离作为这两个集合的距离。
2 Complete Linkage:这个则是取两个集合中距离最远的两个点的距离作为两个集合的距离。
3 Group Average:把两个集合中的点两两的距离全部放在一起求一个平均值
(5)DBSCAN:是比较有代表性的基于密度的聚类算法。 DBSCAN能够将足够高密度的区域划分成簇。下面是两个重要概念:
①半径:给定对象半径内的区域称为该对象的邻域;
②密度: 就是半径内圈住的点的个数。
下面是DBSCAN的算法步骤:
1.这时我们给定一个半径/距离ε,任何和核心点的距离小于ε的点都是它的相邻点。
2. 如果某个数据点点附近有足够数量的点,则把这个点看作核心点,开始聚类,且选中的核心点会成为该聚类的第一个点。如果附近的点不够,那算法会把它标记为噪声。
3. 聚类开始后,核心点的相邻点,或者说以该点出发的所有密度相连的数据点会被划分进同一聚类。然后我们再把这些新点作为核心点,向周围拓展ε。
4.重复步骤2和3,直到附近没有可以扩充的数据点为止。即簇的ε邻域内所有点都已被标记为“已访问”。
十六 主成分分析
正交属性空间中的样本点,假设存在使用一个超平面对所有样本进行恰当的表达。 若存在这样的超平面,那么它大概应具有这样的性质:
(1)最近重构性 :样本点到这个超平面的距离都足够近
(2)最大可分性 :样本点在这个超平面上的投影能尽可能分开
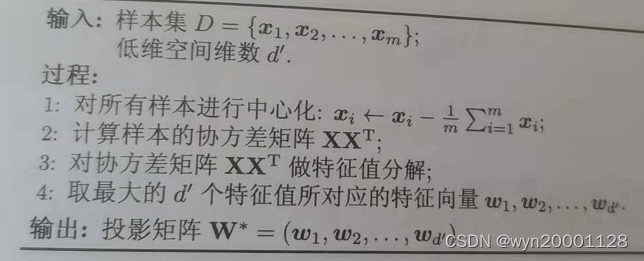
以下是主成分分析的步骤:
十七 特征选择
(1)特征选择的步骤:
①产生初始候选子集 ②评价候选子集的好坏 ③基于评价结果 产生下一个候 选子集
(2)特征选择算法
1 过滤式
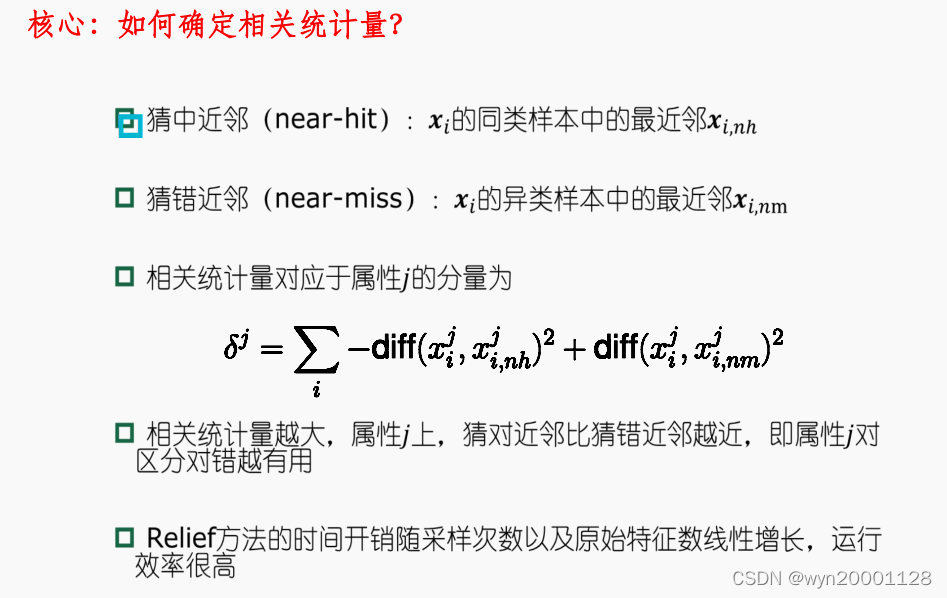
先用特征选择过程过滤原始数据,再用过滤后的特征来训练模型;特征选择过程与后续学习器无关,例如Relief算法。当relief低于某个阈值的时候就把这个特征删除。求某个属性A的Relief的值的步骤:
①初始化Relief为0 ②加上同类样本在属性A上的距离,减去同类样本在属性A上的距离。
(2)包裹式特征选择
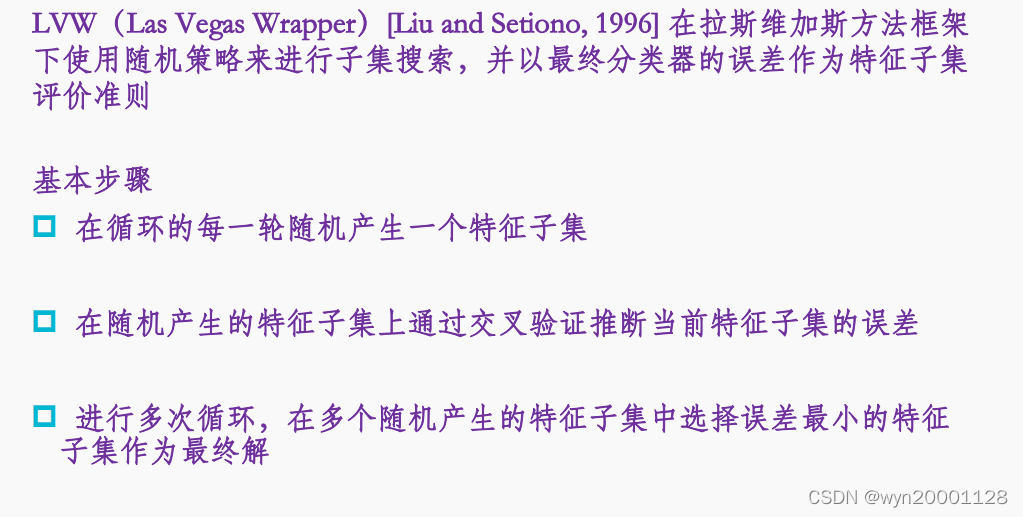
包裹式选择直接把最终将要使用的学习器的性能作为特征子集的评价准则。包裹式特征选择的目的就是为给定学习器选择最有利于其性能、“量身定做”的特征子集。下面是LVM特征选择算法:
(3)嵌入式特征选择算法
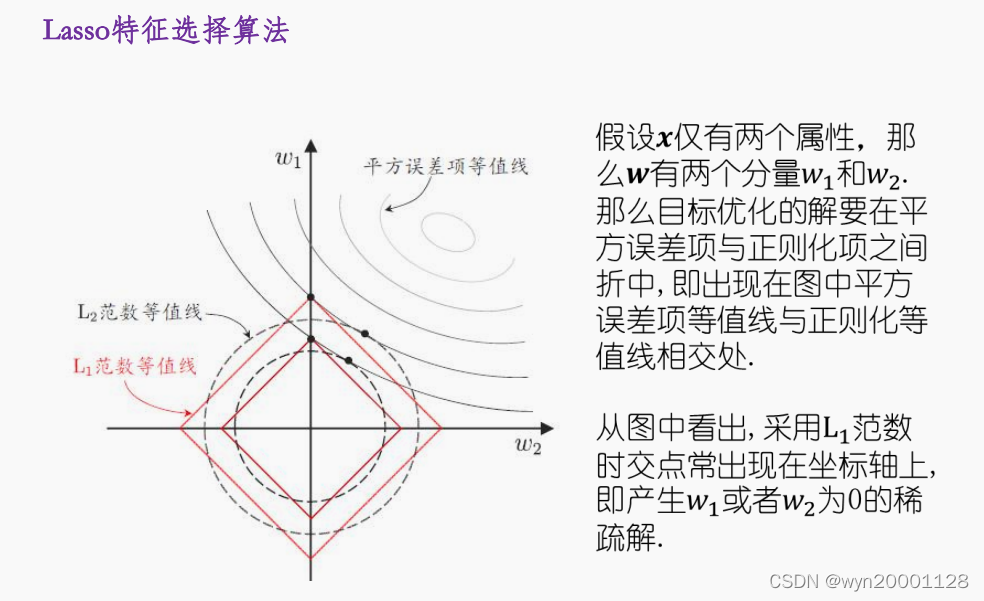
嵌入式特征选择是将特征选择过程与学习器训练过程融为一体,两者在同一个优化过程中完成,在学习器训练过程中自动地进行特征选择。下面以Lasso回归来举例子:
十八 稀疏学习

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)