计算机组成原理——cache
·
3.4cache
出自up主Beokayy传送门
1.局部性原理
- 时间局部性:
- 在最近的未来要用到的信息,很可能是现在正在使用的信息,因为程序中存在循环。
- 空间局部性:
- 在最近的未来要用到的信息,很可能与现在正在使用的信息在存储空间上是邻近的,因为指令通常是顺序存放、顺序执行的。
- 数据也一般是以向量、数组形式簇聚地存储在一起的。
- 时间局部性好,例如数组元素经常被反复访问,例如出现循环指令:
for(i = 0; i <= 9; i++){
    temp = 1;
    for(j = 0; j <= i; j++)
        temp *= a[j];
    sum += temp;
}
- 空间局部性好,即访问顺序与存放顺序一致:
程序A
int func(int a[M][N]){
    int i, j, sum = 0;
    for(i = 0; i < M; i++)
        for(j = 0; j < N; j++)
            sum += a[i][j];
    return sum;
}
程序B
int func(int a[M][N]){
    int i, j, sum = 0;
    for(j = 0; j < N; j++)
        for(i = 0; i < M; i++)
            sum += a[i][j];
    return sum;
}
- 若按行存储,则存储顺序为
a[0][0], a[0][1], a[0][2]……。 - 程序A的访问顺序为
a[0][0], a[0][1], a[0][2]……,程序B的访问顺序为a[0][0], a[1][0], a[2][0]……。故程序A的空间局部性好,程序B的空间局部性差。
2.cache的工作原理
cache的组成


- 为便于cache和主存交换信息,cache和主存会被划分成大小相等的块,每块由若干字节组成。
- 由于cache容量远小于主存容量,故cache中的块数远少于主存中的块数,仅保存主存中最活跃的若干块的副本。
- CPU与cache之间的数据交换以字为单位,cache与主存之间的数据交换以cache块为单位。
cache的命中率
- CPU与访问的信息已被放入cache中的比率即为cache的命中率。
- 命中率
H=Nc/(Nc+Nm):- cache的总命中次数为
Nc。 - 访问主存的次数为
Nm。
- cache的总命中次数为
- cache - 主存系统的平均访问时间
Ta=Htc+ (1-H) tm:- cache命中率为
H。 - 命中时访问cache的时间为
tc。 - 未命中时的访问时间为
tm。
- cache命中率为
CPU在cache中的访问过程

cache地址与主存地址的关系

cache行的内容

- 标记位:
- 和主存地址划分的标记位完全一样,作用是精准匹配cache行和其对应的主存块。
- 有效位:
- 1bit,说明cache中存放的数据是否有效,有效位为1时表示cache行有效。
- 脏位:
- 1bit,使用回写法时才有脏位,脏位为1时表示该cache行中的数据被修改过,替换时需要写回主存。
- 替换算法控制位:
- 随机算法:0bit。
- LRU/FIFO:log2(路数)bit。
3.cache和主存的映射方式
直接映射
- 基本思想:把主存每一块映射到一个固定的cache行中。
- 映射关系:cache行号=主存块号%cache行数。
- 主存地址结构:

- 主存块号被分解成标记字段和cache行号字段,块内地址的划分不变。
- 假设cache共有 2 c 2^c 2c行,主存共有 2 m 2^m 2m块,主存块大小占 2 b 2^b 2b字节,按字节编址,则cache行号占c位,主存块号占m位,块内地址占b位,而标记字段占m - c位。
- 只有标记位相同且有效位为1时,cache才命中。
- cache不命中时,CPU会从主存读出该地址所在的主存块,并把信息送到直接映射对应的cache行中,将有效位置1,并将标记设置为地址中的高t位,同时将该地址中的内容送往CPU。
全相联映射
- 基本思想:主存中的每一块可以装入cache中的任何位置,每一行的标记用于指出该行取自主存的哪一块
- 主存地址结构:

组相联映射
- 基本思想:将cache分为 Q Q Q个大小相同的组,每个主存块可装入固定组中的任意一行。每组有 r r r个cache行,则称为 r r r路组相联。
- 映射关系:cache组号=主存块号%cache组数。
- 主存地址结构:
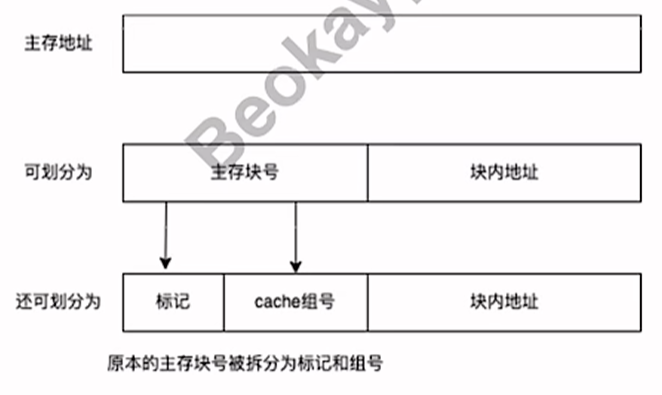
4.cache的替换算法
近期最少使用算法LRU
- 依据局部性原理,选择近期内长久未访问过的cache行作为替换的行
随机算法
- 随机确定替换的cache块
先进先出算法FIFO
- 选择最早调入的cache行进行替换
5.cache写策略
全写法+非写分配法
- 全写法:
- cache写命中时,必须把数据同时写入cache和主存。
- 当某一块需要替换时,不必把这一块写回主存,用新调入的块直接覆盖即可。
- 非写分配法:
- cache写不命中时,只对主存中的块进行修改,而不调入cache。
回写法+写分配法
- 回写法:
- cache写命中时,只把数据写入cache,而不立即写入主存,只有当该块被换出时才写回主存。
- 为了避免不一致隐患,引入脏位(修改位)。若脏位为1,则说明对应cache行中的块被修改过,替换时需要写回主存;若脏位为0,则说明对应cache行中的块未被修改过,替换时无需写回主存。
- 写分配法:
- cache写不命中时,将对应主存块调入cache中,再修改这个cache块

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 16
 0
- 0


 已为社区贡献3条内容

所有评论(0)