登录社区云,与社区用户共同成长
邀请您加入社区
针对目前Type-C接口的普及,许多小家电设备开始采用Type-C接口,这个接口支持正反插,支持功率大,支持的协议全,优点很明显。而且,USB-C还可以使用现在流行的快充技术,让充电器、充电宝、车充等电源输出快充电压给产品供电,无需携带多种充电器。由于目前的快充协议比较多,每家手机厂商都有自己的快充协议,所以就要求USB-C识别芯片XSP18需要支持多种快充协议,这样,无论设备USB-C连接的是哪
本文提出了一种基于HBase的地震数据分析系统,整合Python、Hadoop、HBase、Django和Vue等技术,实现地震数据的采集、处理、分析和可视化。系统从公开数据源获取数据,经MySQL预处理后,利用Pandas等工具建立分析模型,最终通过Vue.js展示多维度的可视化图表,包括震级统计、地理分布、趋势分析等。该系统为地震监测和防灾决策提供数据支持,有助于降低地震灾害损失。
值得庆幸的是,我发现了一个完美的解决方案——Nuclear音乐播放器。这款开源工具打破了平台间的资源壁垒,将分散的音乐内容整合在一个简洁的界面中。最令人惊喜的是,它完全免费且没有任何广告干扰,真正实现了无障碍的音乐享受。自从使用Nuclear后,我的音乐生活变得更加简单美好。无论是工作时的背景音乐,还是休闲时的音乐探索,这款工具都能完美胜任。它彻底解决了我在多个音乐平台间来回切换的烦恼,让音乐回归
鸿鹄 ERP 软件,让您的企业如虎添翼,翱翔于数字化时代的天空!立即联系我们,开启智能管理之旅。
1.背景介绍HBase与Storm集成:HBase与Storm集成与实时计算1. 背景介绍随着数据的增长和实时性的要求,实时计算技术变得越来越重要。HBase是一个分布式、可扩展、高性能的列式存储系统,可以存储大量数据并提供快速访问。Storm是一个分布式实时计算框架,可以处理大量数据并提供实时计算能力。在大数据场景下,HBase和Storm的集成具有很大的价值。本文将从以下几个方...
HBase是一个分布式、可扩展的、非关系型的NoSQL数据库。它是建立在Hadoop HDFS上的一个开源的数据库管理系统。HBase的设计目标是提供高可靠性、高可扩展性、高性能、高延迟、高容错性和高可用性。HBase是一种面向列的数据库,可以处理海量的结构化和半结构化数据。它可以存储大量的数据,并能够快速索引和检索数据,适用于需要高速在线访问大量数据的应用程序。在HBase中,数据按照表格的形式
共享单车之数据分析第1关:统计共享单车每天的平均使用时间
3 ZooKeeper是什么?Zookeeper的应用场景主要有哪些?我的答案:Zookeeper是一个分布式的,开放源码的分布式应用程序协调服务,是Google的Chubby的一个开源的实现。它是集群的管理者,监视着集群中各个节点的状态根据节点提交的反馈进行下一步的合理操作。最终,将简单易用的接口和性能高效、功能稳定的系统提供给用户。主要应用场景为:分布式协调、分布式锁、元数据、配置信息管理、H
packagecom.educoder.bigData.sharedbicycle;importjava.io.IOException;importjava.math.BigDecimal;importjava.math.RoundingMode;importjava.util.ArrayList;importjava.util.Collection;importjava.util.HashMap
个人博客总是访问不了,原文:实时计算应用场景实时计算的概念很难定义,每个人对这四个字的理解可能都不同。个人观点主要分为两块:数据的实时入库和数据的实时计算。数据实时入库的时候,一般都需要对原始数据做一定的处理再入库。能在这个步骤计算尽量在这里完成。 这个类似数据的预算后入库,然后提供直接读取服务。对用户的延时性上最好。然而有一些对数据的计算并不能通过预算解决全部问题,比如搜索。...
Noetra计划在遵循修改后的《外汇及对外贸易法》标准的前提下,向日本企业广泛公开模型,通过自主开发确保安全性,而非依赖外部模型,各参与企业也将根据自身场景利用Noetra大模型开发应用。NVIDIA CEO黄仁勋也出席发布会,称日本产业一线的智慧“是国家的瑰宝,不能失去”,并强调自主驱动机器和机器人的物理AI相关基础设施“应该在日本制造”。至于选择通用模型的原因,主要是由于在网络防御等最先进AI
1.写出“whatever worth doing is worth doing well.”的map和reduce阶段的输入、输出,简述shuffle过程,以及说明如何确保相同单词进入一个reducer中。hadoop的伪分布中名称节点和数据节点可以在一个物理节点上()6 Map任务的数量和reduce任务的数量由什么决定。数据分为 结构化数据、半结构化数据和()第二名称节点解决了单节点错误的问
时序数据库经常应用于机房运维监控、物联网IoT设备采集存储、互联网广告点击分析等基于时间线且多源数据连续涌入数据平台的应用场景,InfluxDB专为时序数据存储而生,尤其是在工业领域的智能制造,未来应用潜力巨大。数据模型1.时序数据的特征时序数据应用场景就是在时间线上每个时间点都会从多个数据源涌入数据,按照连续时间的多种纬度产生大量数据,并按秒甚至毫秒计算的实时性写入存储。传统的RDBMS数据库对
在日常办公中,图片查看是我们经常需要处理的工作内容之一。然而Windows系统自带的图片查看器在应对大尺寸图片时往往显得力不从心,加载等待时间较长;对于WebP、HEIC等新兴图片格式更是无能为力,必须借助第三方工具才能打开。市面上虽然有不少图片查看软件,但要么功能过于臃肿,要么充斥着各种广告,想要找到一款轻便好用的免费工具实属不易。最近在GitHub上发现了一款备受好评的开源项目——ImageG
大数据从入门到实战 - HBase高级特性:过滤器(二)一、关于此次实践1、实战简介2、全部任务二、实践详解1、第1关:常用的专用过滤器2、第2关:同时使用多种过滤器3、第3关:过滤器总结
R 是一种灵活的编程语言,专为促进探索性数据分析、经典统计学测试和高级图形学而设计。R 拥有丰富的、仍在不断扩大的数据包库,处于统计学、数据分析和数据挖掘发展的前沿。R 已证明自己是不断成长的大数据领域的一个有用工具,并且已集成到多个商用包中,比如 IBM SPSS® 和 InfoSphere®,以及 Mathematica。 本文提供了一位统计学家Catherine Dalzel...
汇铭达XSP16是一款高性能Type-C诱骗取电芯片,支持PD3.1全协议及140W大功率输出。该芯片具有全协议兼容(PD/QC/FCP/AFC)、28V/5A高功率输出、UART通信等核心优势,适用于电动工具、工业设备等场景。通过电阻配置或GPIO动态调压,可灵活设置输出电压。XSP16集成度高、体积小,能简化外围电路,是大功率设备和多串锂电池快充的理想解决方案。
HBase+Zookeeper部署及Maven访问(HBase集群实验)
目录一、Kettle整合Hadoop1、 整合步骤2、Hadoop file input组件3、Hadoop file output组件二、Kettle整合Hive1、初始化数据2、 kettle与Hive 整合配置3、从hive 中读取数据4、把数据保存到hive数据库5、Hadoop Copy Files组件6、执行Hive的HiveSQL语句三、Kettle整合HBase1、HBase初始化
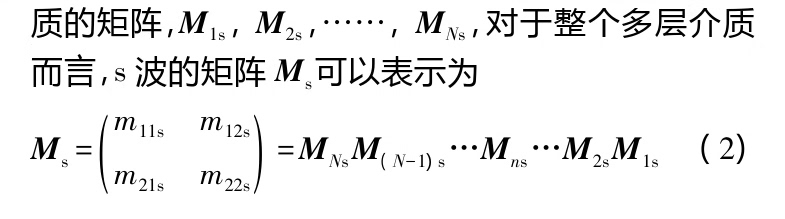
传输矩阵法这玩意儿在光学薄膜设计里就像炒菜时的锅铲,虽然不起眼但没它真不行。最后甩个冷知识:TMM算光子晶体时,记得把结构周期数设到20层以上,否则禁带特征不明显。注意p波处理时多乘的那个n,这可是边界条件决定的,手滑写错的话反射谱会亲妈都不认识。矩阵连乘顺序别搞反了,光学传输是右乘链式结构,跟穿衣服顺序一样从里到外。这出来的彩虹色图谱,专业点的叫法是角度分辨反射谱。厚度为0表示半无限介质,这设计
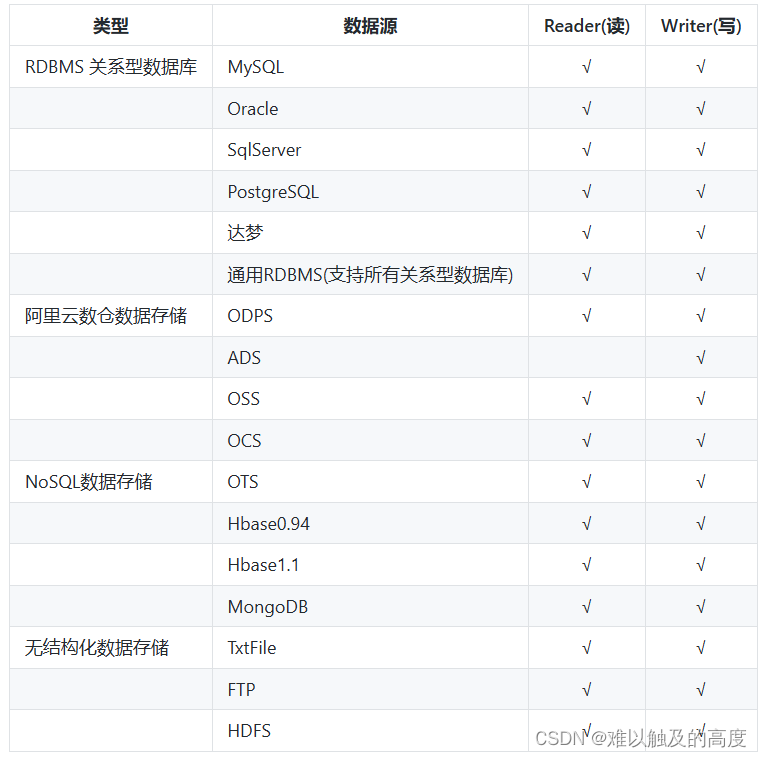
DataX(DataX简介、部署、同步数据)
在SIP项目设计的过程中,对于它庞大的日志在开始时就考虑使用任务分解的多线程处理模式来分析统计,在我从前写的文章《Tiger Concurrent Practice —日志分析并行分解设计与实现》中有所提到。但是由于统计的内容暂时还是十分简单,所以就采用Memcache作为计数器,结合MySQL就完成了访问控制以及统计的工作。然而未来,对于海量日志分析的工作,还是需要有所准备。现在最火的技术词汇莫
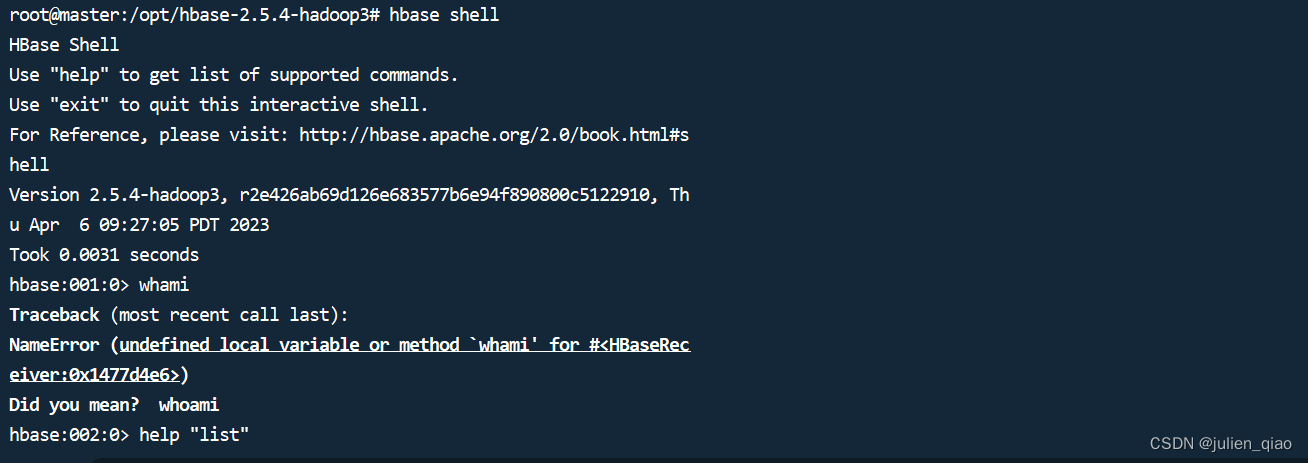
HBase 伪分布式环境搭建
点击下方名片,设为星标!回复“1024”获取2TB学习资源!前面介绍了Hadoop 架构基石 HDFS、统一资源管理和调度平台 YARN、分布式计算框架 MapReduce、数据仓库 Hive、计算引擎 Spark、实时计算流计算引擎 Flink 等相关的知识点,今天我将详细的为大家介绍 大数据 Hadoop 数据库 Hbase 相关知识,希望大家能够从中收获多多!如有帮助,请点在看、转发支持一.
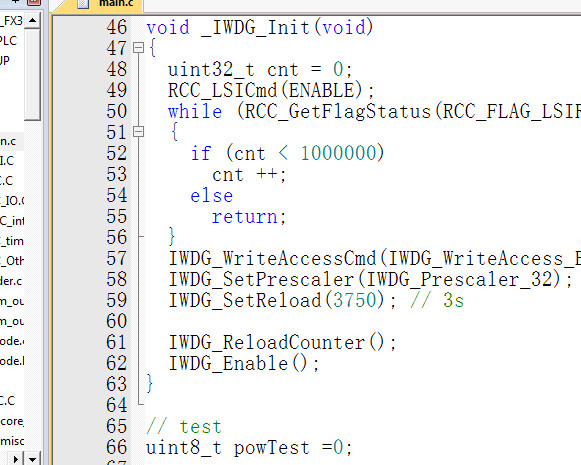
移植的时候注意FX3U的PID指令是自带整定功能的,但需要把采样周期参数改成实际值的1/3左右才能稳定。代码里用了两个定时器接力捕获,实测能识别从1200到115200的所有常用速率。最近在翻仓库的时候发现之前做的FX3U控制器方案还能用,配套的STM32F103源码也挺有意思。FX3U源代码,stm32f103芯片全套源码,可以直接用works2编程直接写入,经济实惠,非常适合参考学习。FX3U
本文介绍了一款基于51单片机的智能扫地小车系统,该系统集成了自动寻迹、障碍物避障和清洁功能。通过超声波传感器检测前方障碍物,红外传感器实现路径跟踪,配合电机驱动模块完成自主导航与清洁任务。系统采用模块化设计,具有良好的可扩展性和稳定性。
package org.geotools.tutorial.quickstart.demo; import org.geotools.data.DataStore; import org.geotools.data.DataStoreFinder; import org.geotools...
Sqoop数据导入第3关:Mysql导入数据至Hive中
1.将数据存到hdfs,字段间 \t 分隔2.进入hbase安装路径3.执行命令/bin/hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.columns=HBASE_ROW_KEY,cf:feats <hbase表名> <hdfs路径>解释:Dimporttsv.columns参数中 cf是hbas
SuperMap支持的几种分布式数据库实操过程
1.背景介绍HBase是一个分布式、可扩展、高性能的列式存储系统,基于Google的Bigtable设计。它是Hadoop生态系统的一部分,可以与HDFS、MapReduce、ZooKeeper等系统集成。HBase的设计目标是提供低延迟的随机读写访问,支持大规模数据的存储和管理。在大数据时代,数据的规模不断增长,数据的存储和管理成为了一大挑战。同时,数据的聚合和统计也成为了数据处理的重要...
/ 数据清洗和处理(如筛选某一列、计算平均值等操作)// 通过Hive查询HBase数据。// 使用Java API查询数据。// 导入数据到HBase。// 创建Hive表。4. 清洗和处理数据。
Hbase数据映射到Hive//新建库 并使用库create database events;use events;//设置变量名为db指向库名 eventsset hivevar:db=events;//设置允许所有的分区列都是动态分区列00000000000000000000set hive.exec.dynamic.partition.mode=nonstrict;//设置允许动态分区功能S
HBase 是一个构建在 Hadoop 文件系统之上的面向列的数据库管理系统。HBase 是一种类似于 Google’s Big Table 的数据模型,它是 Hadoop 生态系统的一部分,它将数据存储在 HDFS 上,客户端可以通过 HBase 实现对 HDFS 上数据的随机访问。不支持复杂的事务,只支持行级事务,即单行数据的读写都是原子性的;由于是采用 HDFS 作为底层存储,所以和 HDF