【NeurIPS 2025】AAWR:用特权传感器在真实世界训练主动感知机器人|从机器人强化学习视角
·
## 摘要
机械臂抓一个放在书架上的玩偶,成功率能从 47% 提到 94%。前提是它先学会把相机移过去找一找,而不是伸手就抓。
AAWR 是 NeurIPS 2025 的一篇真机强化学习论文,核心动作只有一个:训练时让价值网络多看几个传感器,部署时再把它们全部撤掉。这篇内容拆开这个做法,看它在 8 个任务、3 种机器人上把搜索成功率推到什么位置。
**视频讲解**:[点击观看 B 站视频](https://www.bilibili.com/video/BV1oWJU6SE8b)
章节时间轴
00:35 作者介绍
01:00 研究背景与动机
01:41 相关工作
02:04 方法
03:02 理论基础
03:43 实验设计
04:28 实验结果
05:32 π0 交接与主动感知行为
06:32 局限与讨论
06:54 要点总结
07:21 参考文献
[TOC]
## 论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Real-World Reinforcement Learning of Active Perception Behaviors |
| 标题(中文) | AAWR:用特权传感器在真实世界训练主动感知机器人 |
| 作者 | Edward S. Hu\*, Jie Wang\*, Xingfang Yuan\*(\* 共同一作), Fiona Luo, Muyao Li, Gaspard Lambrechts, Oleh Rybkin, Dinesh Jayaraman |
| 机构 | 宾夕法尼亚大学 PAL / GRASP 实验室 · 列日大学 · 加州大学伯克利分校 |
| 会议 | NeurIPS 2025 |
| arXiv | [arXiv:2512.01188](https://arxiv.org/abs/2512.01188) |
| 项目网站 | [penn-pal-lab.github.io/aawr](https://penn-pal-lab.github.io/aawr/) |
## 背景与动机
很多任务里,一帧画面并不包含决策需要的信息。玩偶躲在书架第二层,腕部相机只看得到夹爪和桌面;糖果有没有被夹住,也只有力觉反馈知道。
要解决它,机器人必须先动起来去收集信息。这类行为叫**主动感知**(active perception,用动作换取信息的感知方式)。
模仿学习不太适合这条路。它需要人反复示范「把相机移过去找」,而示范者自己看的是外部视角,操作起来很别扭。
纯强化学习理论上能从交互里学到,但样本效率太低,部分可观测又会进一步放慢它。仿真到现实的迁移也不容易,因为主动感知紧贴传感器特性,深度、触觉、力觉这些观测很难被仿真得足够真实。
前人的工作大致分三类。信息论路线先定一个「不确定性下降」的目标,再去选下一个视角,但这类目标大多与任务无关,还假设视角可以自由选取,在杂乱的桌面操作里并不成立。
用强化学习做真机主动搜索的工作(ICRA 2020 的 Object Finding、IROS 2024 的 RL for Active Search)需要较重的仪器,例如构建任务相关的体积地图。
非对称学习这条线已经很成功,但非对称 actor-critic(RSS 2018)与 RMA(RSS 2021)吃的是模拟器里的海量特权状态;真机上只有少量、还可能带噪的特权观测。
这篇论文的赌注就是:只要把训练期多出来的那几个传感器用对地方,从少量次优示范出发也能训出主动搜索。
## 研究主线:从问题到结论
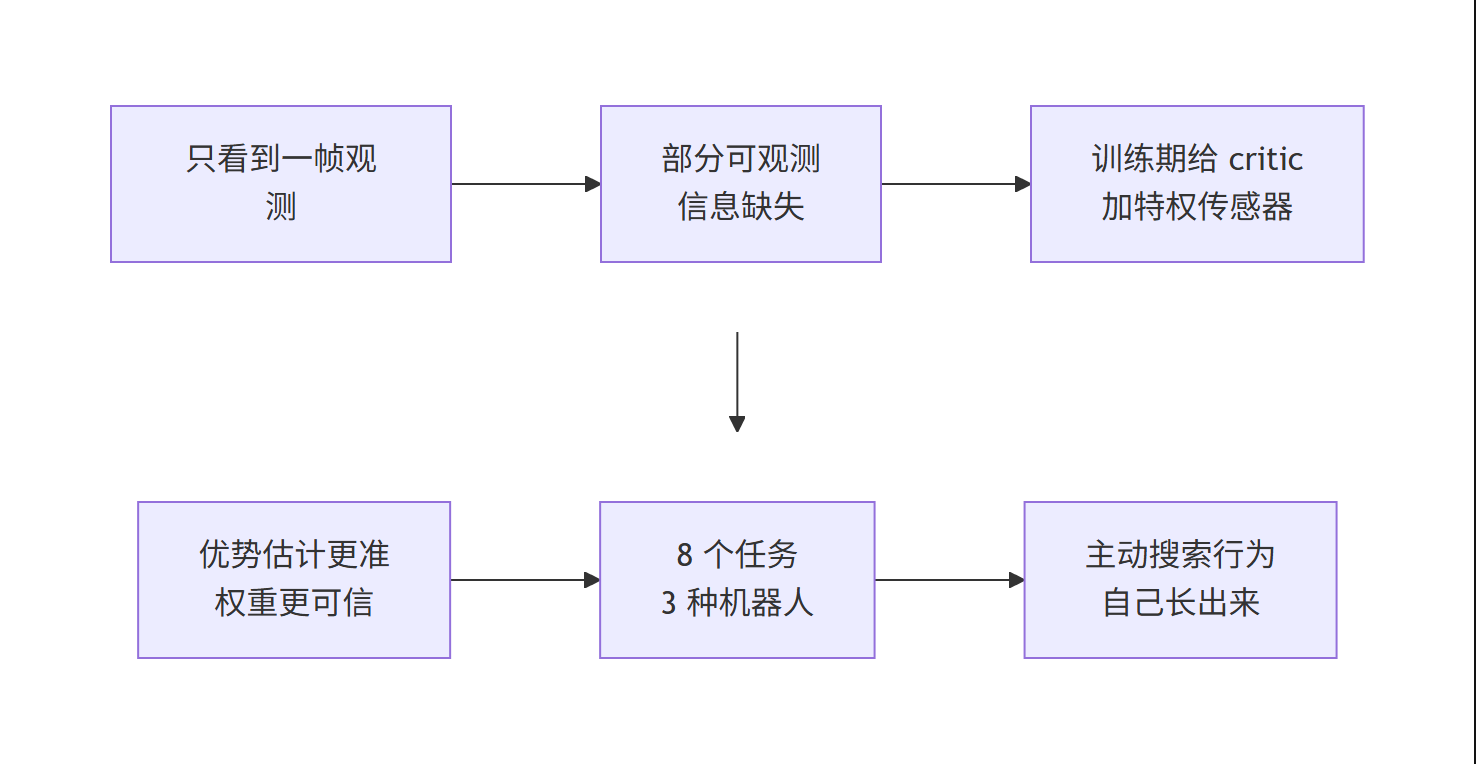
**图 10:研究主线 —— 从「只看到一帧观测」出发,用训练期特权传感器把优势估计做准,最终在 8 个任务、3 种机器人上让主动搜索行为自己长出来。**
## 基准/方法设计
AAWR 的全称是 Asymmetric Advantage Weighted Regression,也就是非对称优势加权回归。
它建立在 AWR 之上。AWR 把策略更新写成一次加权行为克隆,优势越高的动作权重越大:$\mathcal{L}_{\text{AWR}}(\pi)=\mathbb{E}[\exp(A^{\mu}(s,a)/\beta)\log\pi(a\mid s)]$。
AAWR 只改了一处:优势里的状态从「只包含智能体可见的历史摘要 $z$」,变成「再并上训练期才有的环境状态 $s$」,于是目标写作 $\mathcal{L}_{\text{AAWR}}(\pi)=\mathbb{E}[\exp(A^{\mu}(s,z,a)/\beta)\log\pi(a\mid z)]$。
区别在权重从哪来,而不是策略看到什么。策略的输入始终只有部分观测,部署时不需要那几个额外传感器。
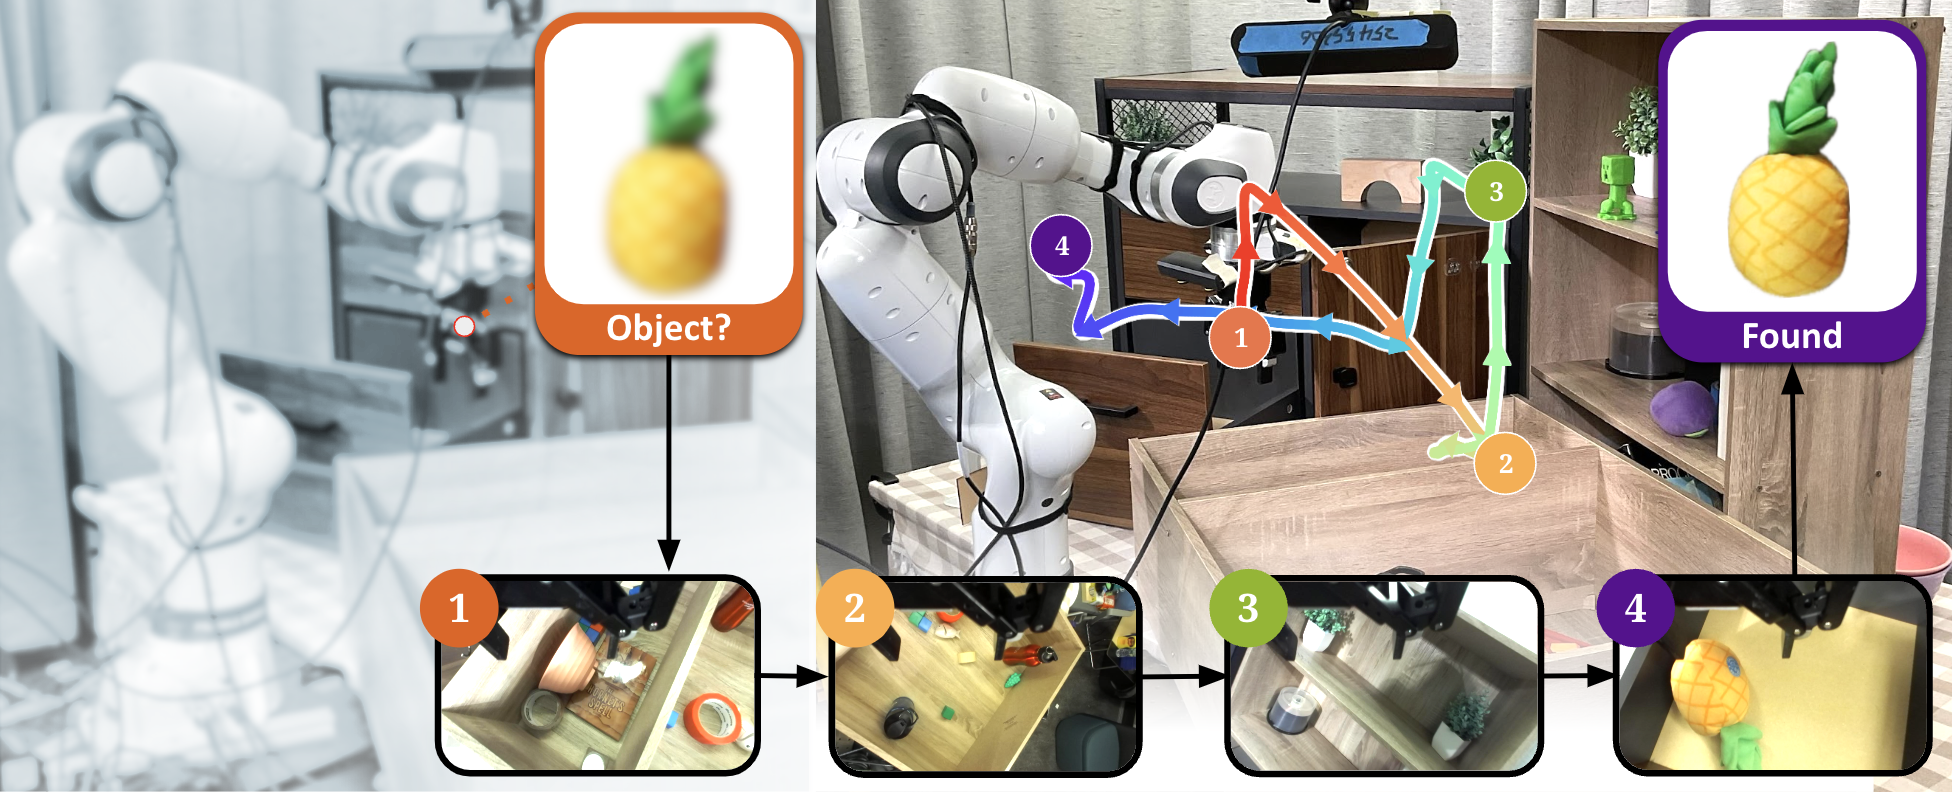
**图 1:论文 Figure 1 —— 左:只有单个腕部相机的机器人在重度遮挡的场景里找不到目标;右:主动感知策略逐个排查可能的藏匿点,最终找到目标物体。**
## 分类全景
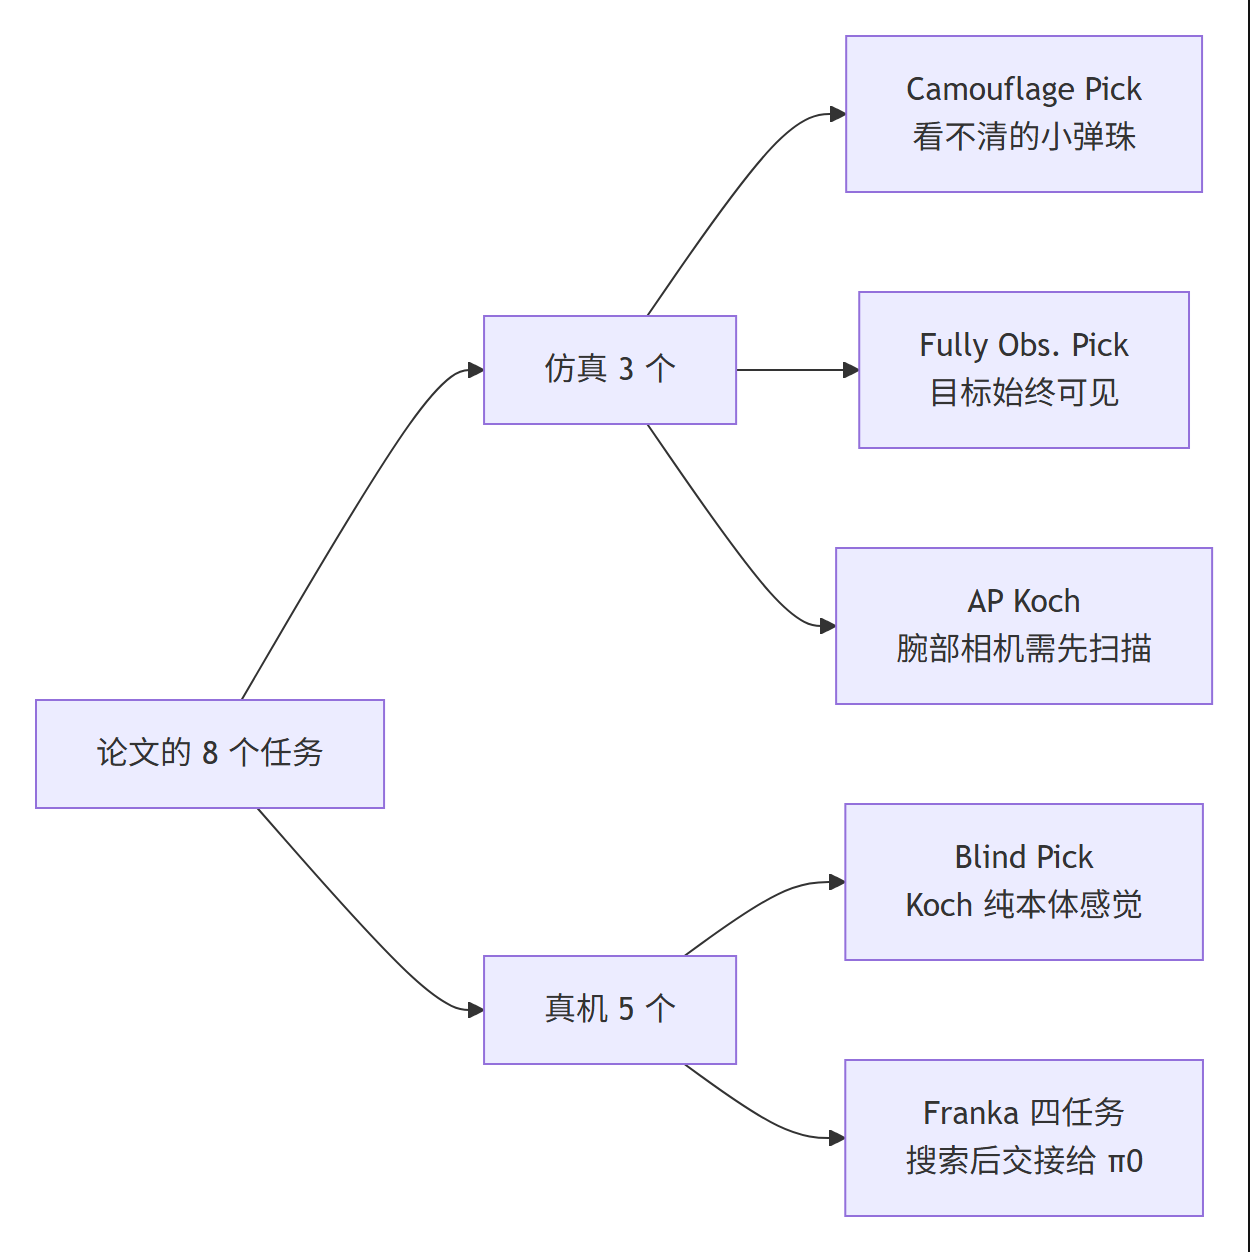
**图 11:任务全景 —— 论文用 3 个仿真任务与 5 个真机任务覆盖不同的部分可观测程度;真机里的 Franka 四任务先搜索、再把控制权交给通用策略 π0。**
## 方法细节
方法落地的细节不多,但每一处都有理由。
**策略看什么。** Franka 上的部分观测是腕部 84×84 的 RGB 图像、最近 6 步末端位置,以及一张占据栅格特征,做法是把历史相机射线投影到机器人坐标系的 XZ 平面,射线经过的格子记为 1。特权侧多一路目标分割掩码。动作是末端笛卡尔与角速度,一次输出 5 步动作块。
**权重怎么算。** critic 用一步时序差分误差训练 $Q$,值函数 $V$ 用期望回归保守地逼近动作价值的最大值:$\mathcal{L}_{V}(\theta)=\mathbb{E}[|\tau-\mathbb{1}\{Q-V<0\}|(Q-V)^{2}]$,期望分位 $\tau$ 越小越惩罚高估。
**数据怎么混。** 训练分两段。先用离线示范更新 $Q,V,\pi$,再让策略在环境里跑、把新数据放进在线缓冲;每个批次一半来自离线、一半来自在线。
**为什么必须非对称。** 把带智能体状态的 POMDP 写成状态为 $(s,z)$ 的等价 MDP,再做带 KL 约束的策略改进、并把策略类限制成只依赖 $z$,拉格朗日松弛后的目标正好是 AAWR。
反过来,只用 $z$ 估计优势的对称版本不能恢复正确解。作者证明特权值函数是 IQL 目标对应 Bellman 方程的不动点,而非特权值函数不是——也就是说,只按可见历史训下去,也训不到正确的目标。
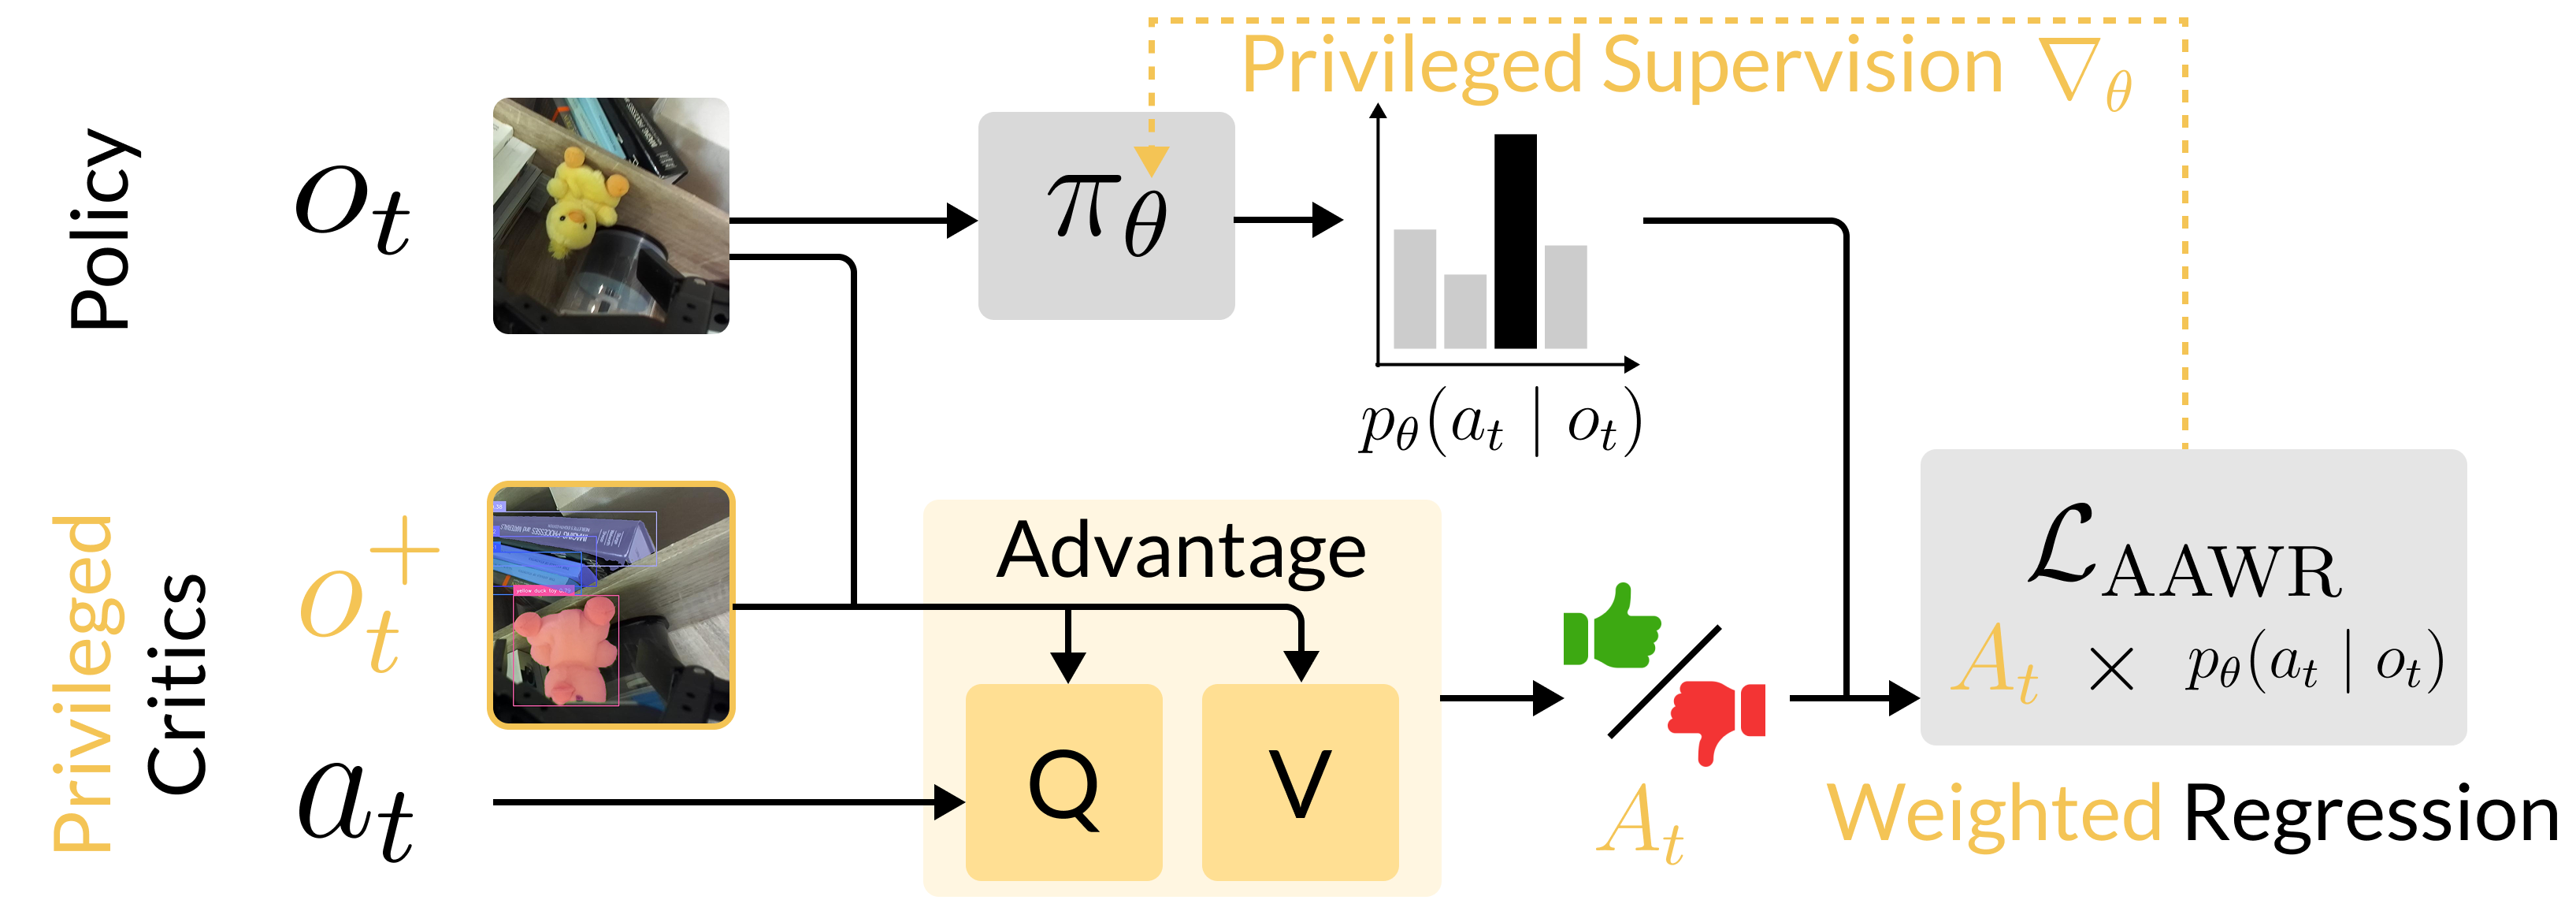
**图 2:论文 Figure 2 —— 上排策略只接收部分观测 $o$;下排仅在训练期可用的特权观测/状态送入 critic 网络估计优势,优势再作为权重进入策略损失。**
## 实验设计与结果
评测分仿真和真机两路。仿真三个任务各跑 10 个随机种子;真机四任务交接实验每个指标统计 18 次试验;Koch 上的盲抓跑 40 次试验。
搜索行为用一个三段式评分衡量:目标出现在画面里给 33 分,移动到目标进入指定区域给 66 分,在里面锁定目标给 100 分。Completion 是切换给通用策略之后的抓取成功率,Steps 记录找到并靠近目标花了多少步。
真机盲抓(Koch)的结果:
| 方法 | 抓取率 | 拾取率 |
|---|---|---|
| 行为克隆 BC | 47% | 41% |
| 离线 AWR(无特权) | 65% | 62% |
| 在线 AWR | 71% | 55% |
| 离线 AAWR | 88% | 71% |
| 在线 AAWR | **94%** | **89%** |
真机交接任务(Bookshelf-P,在书架上找玩偶):
| 方法 | 搜索分 | Completion | 步数 |
|---|---|---|---|
| AAWR | **92.4** | **44.4%** | 36.6 |
| AWR(无特权) | 79.6 | 0.0% | 34.0 |
| BC | 29.9 | 20.0% | 84.0 |
| 通用策略 π0 本体 | 11.0 | 16.7% | 263.3 |
| 穷举藏匿点 | 64.2 | 44.0% | 105.4 |
| VLM+π0 | 31.4 | 27.8% | 322.3 |
数据质量消融(Complex 任务):
| 训练数据 | 搜索分 | Completion | 步数 |
|---|---|---|---|
| 195 条次优示范(成功率 60%) | 54.8 | 20.0% | 121.0 |
| 50 条专家示范(成功率 94%) | **73.2** | **50.0%** | **43.0** |
八个任务的传感器装配差异:
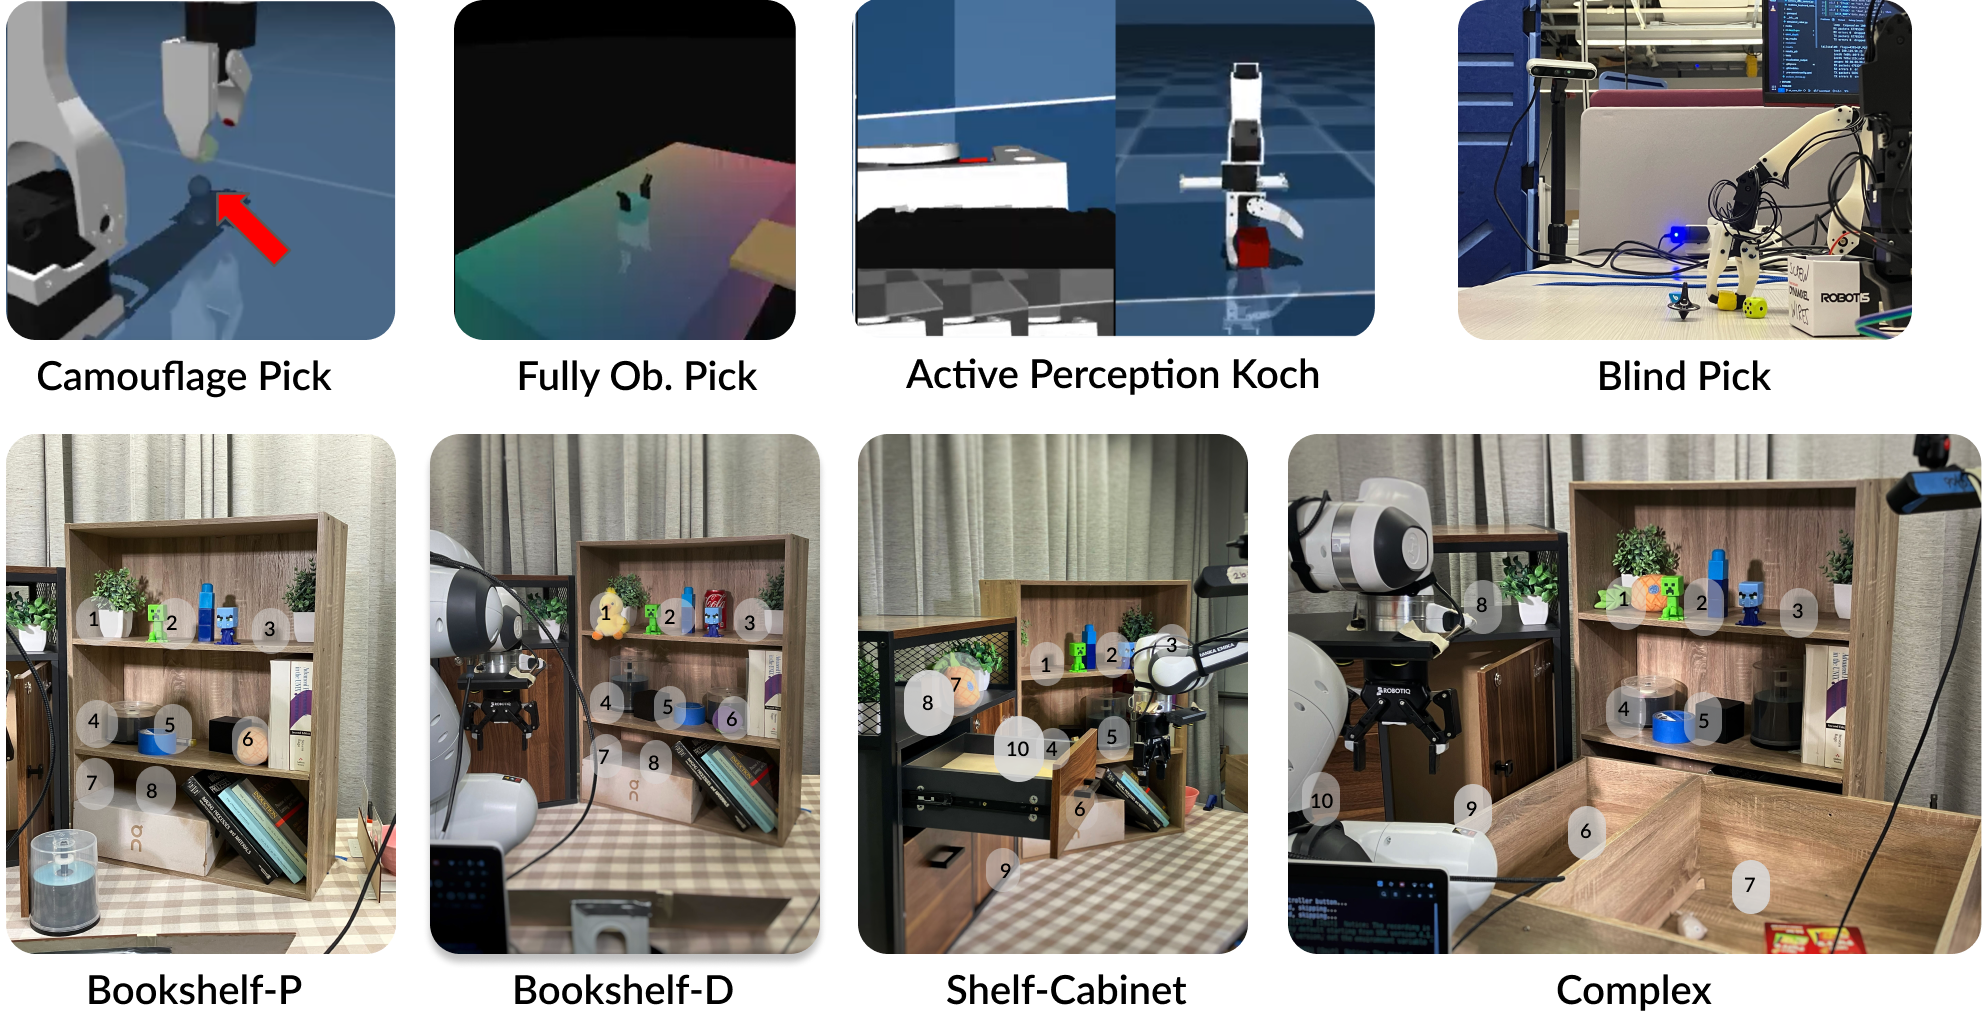
**图 3:论文 Figure 3 —— 8 个环境的传感器装配与任务设置,下排标注了目标物体的藏匿点。**
仿真任务的评估曲线,阴影部分是离线预训练阶段:
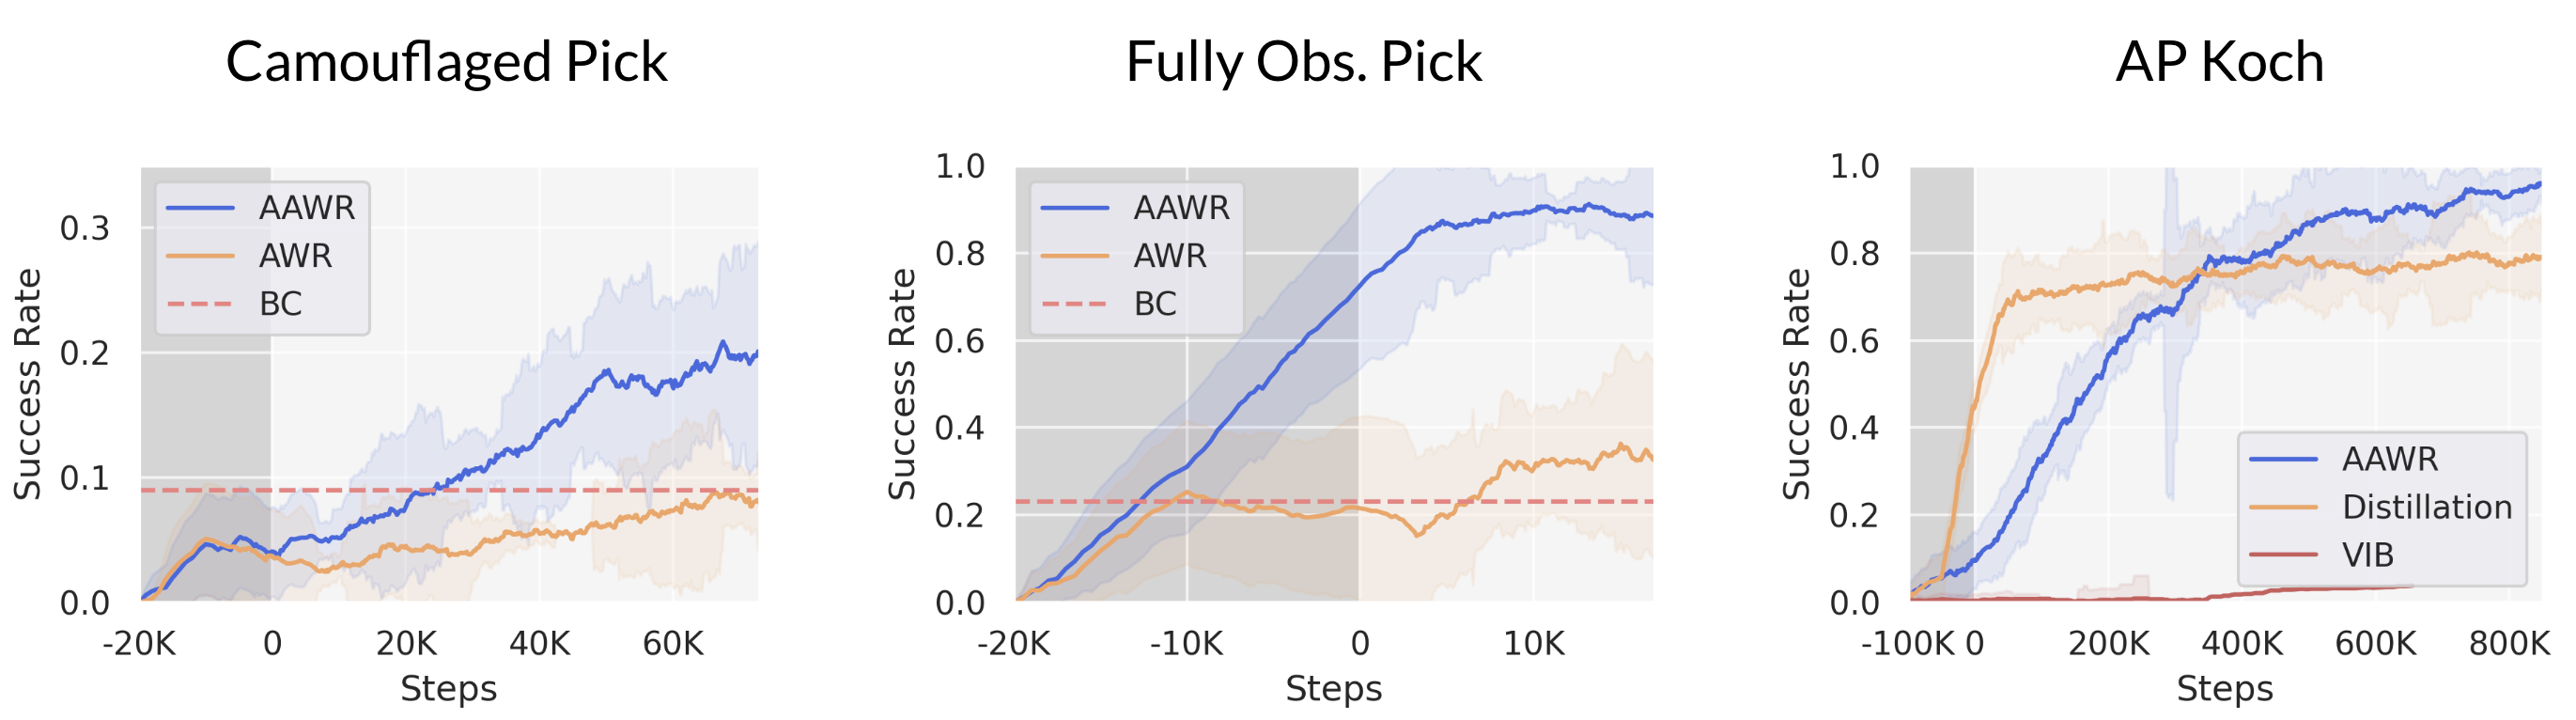
**图 4:论文 Figure 4 —— 仿真实验的评估曲线,每个方法 10 个随机种子。AAWR 在所有仿真任务上均优于基线。**
同一个柜子任务里的 rollout 对比:
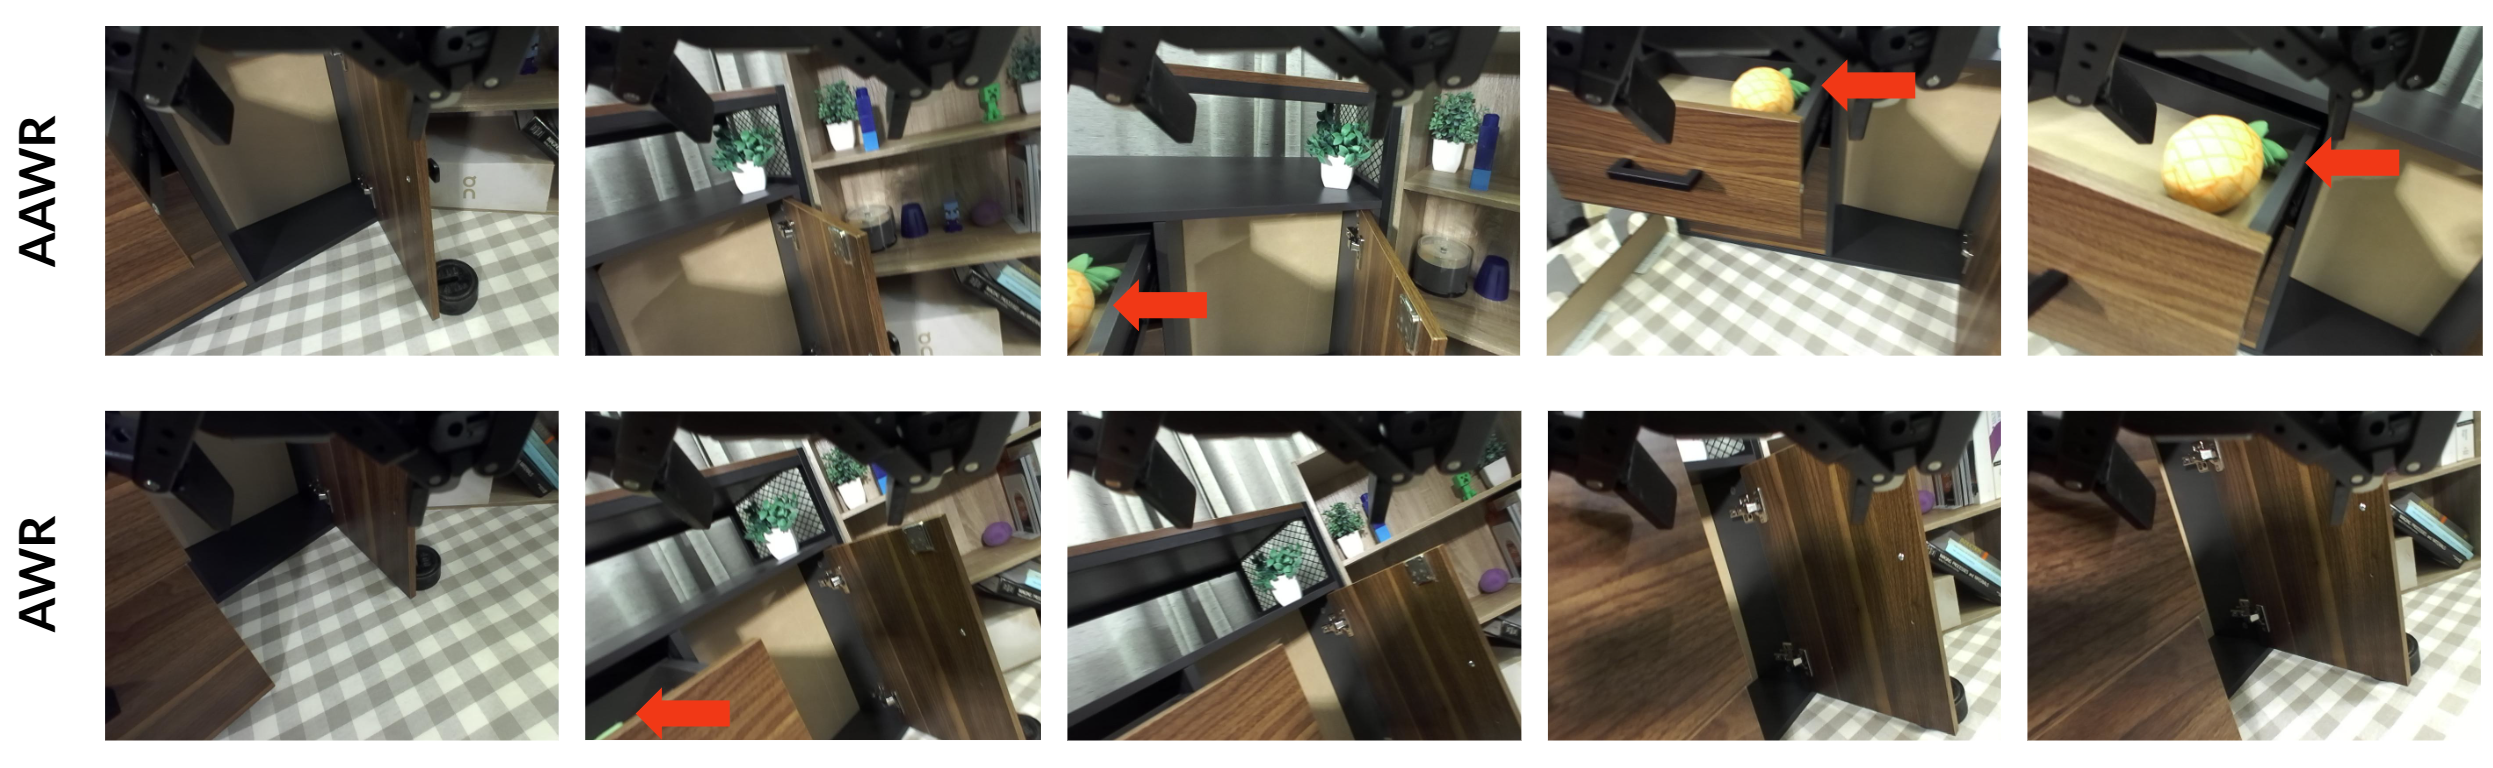
**图 5:论文 Figure 5 —— AAWR 搜索柜子上左区域并锁定目标(红箭头),AWR 只瞥见一眼就漂走。**
搜索评分的三段标准:
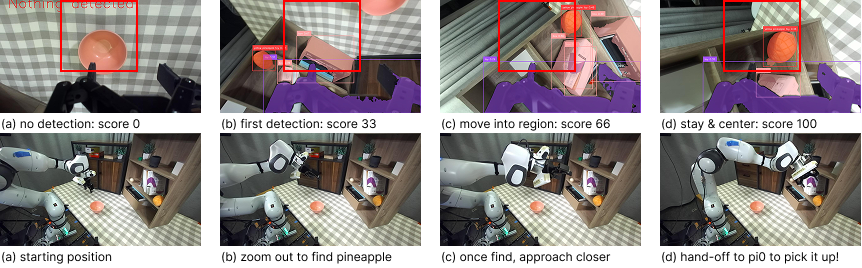
**图 6:论文附录图 —— Search 指标的三段评分:看到目标给 33%,移动到目标落入目标区域给 66%,在区域内锁定目标给 100%。**
失败分解,以及真机系统的完整流程:
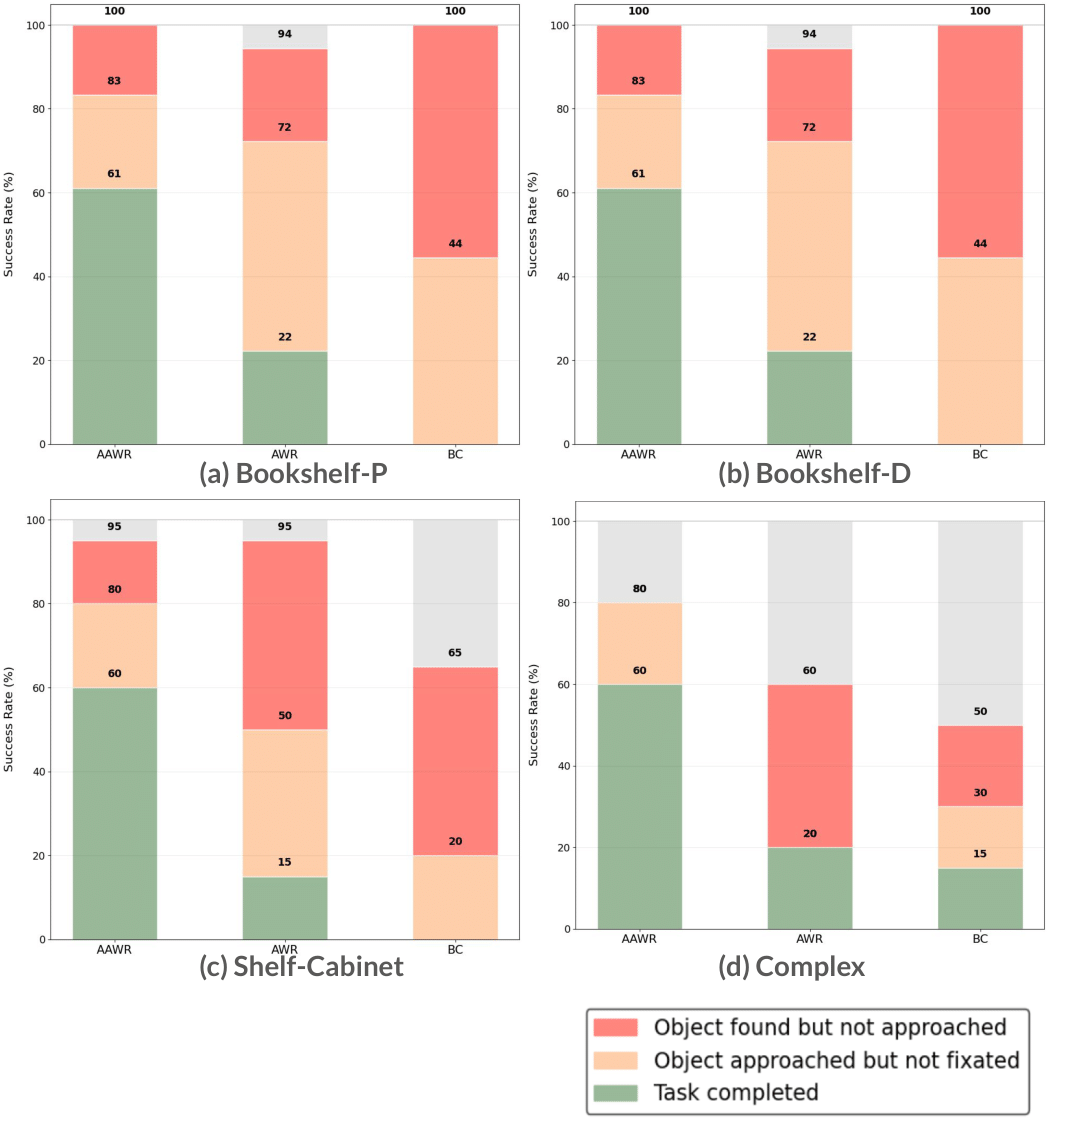
**图 7:论文附录图 —— 四个任务上 AAWR/AWR/BC 的失败分析,AAWR 完成全部三段的次数最多。**
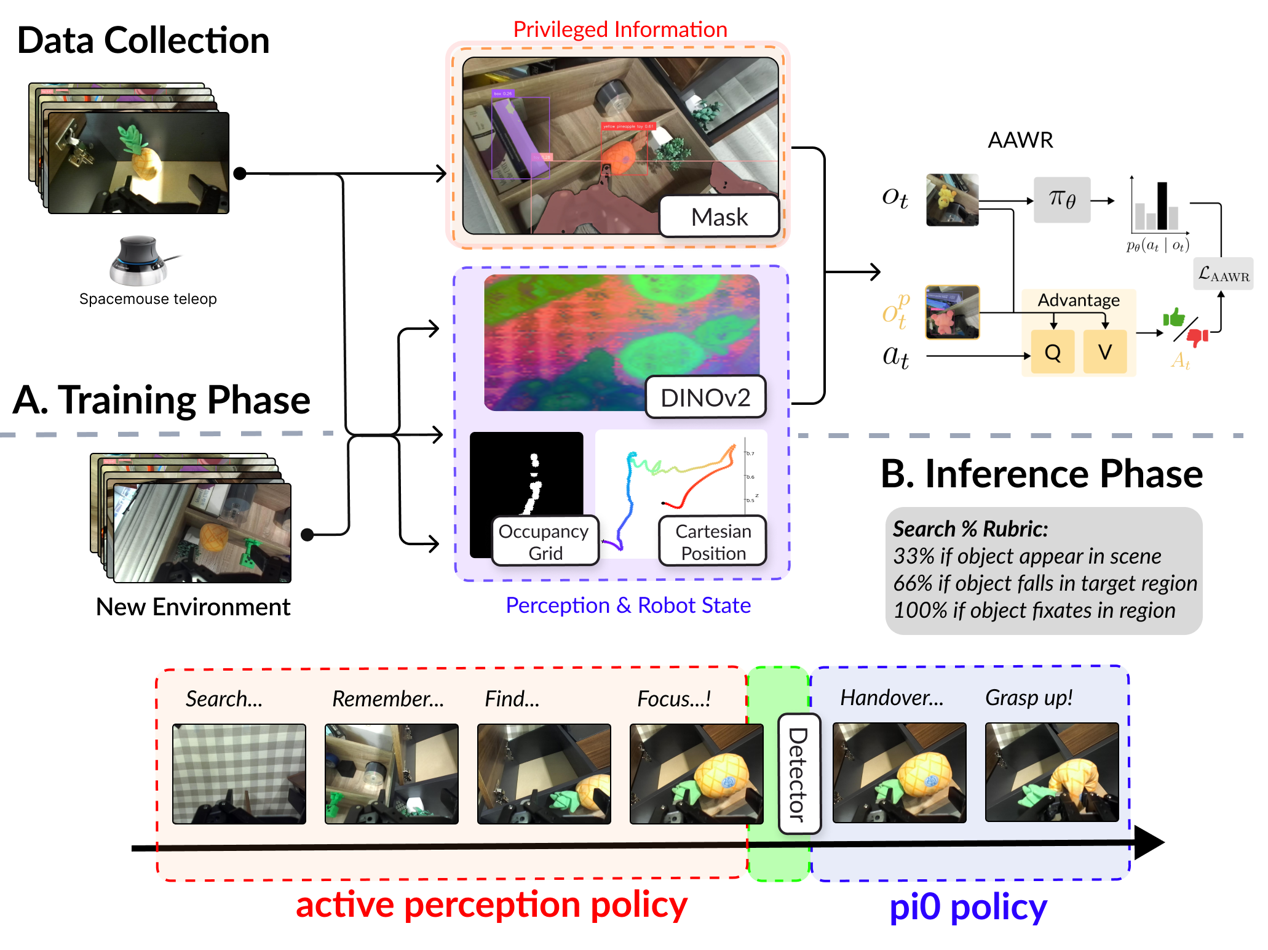
**图 8:论文附录图 —— 上半部分通过遥操作采集离线轨迹并用 AAWR 训练,下半部分评测时只运行无特权搜索策略,找到目标后交给通用策略。**
仿真 Koch 任务上的行为对比:
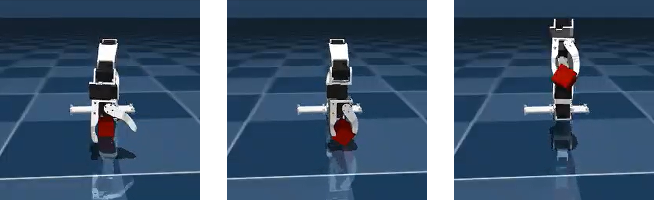
**图 9:论文附录图 —— AAWR 主动扫描工作区后抓取;Distillation 学到直奔中心的次优策略;VIB 在没有特权信息的评测期退化。**
## 结果对比总结
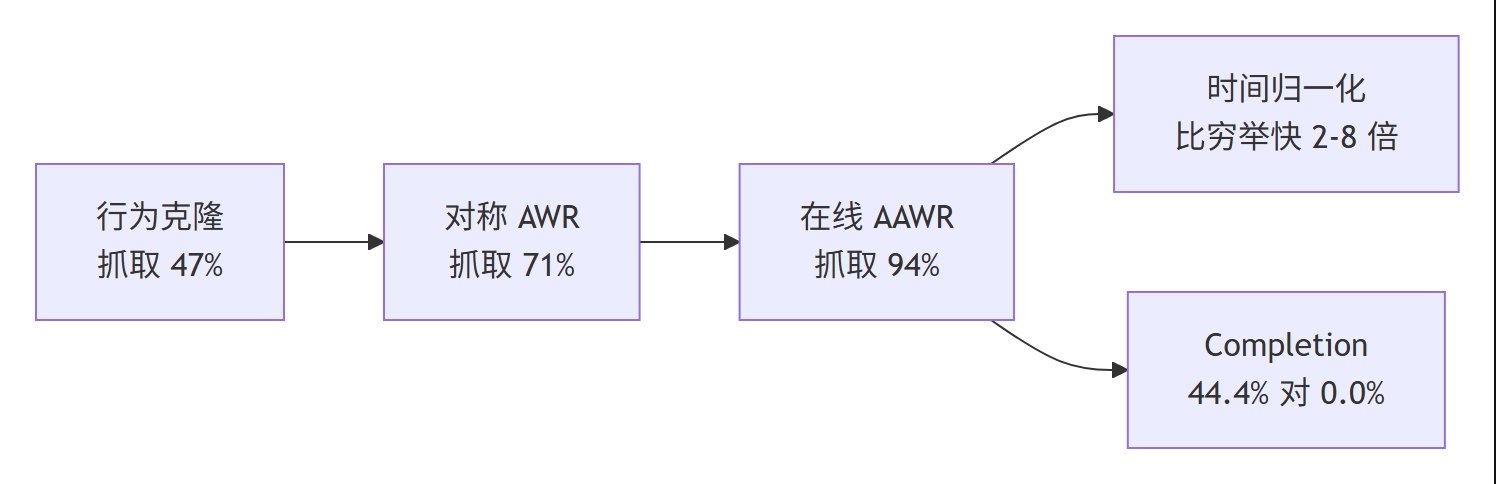
**图 12:结果阶梯 —— 从行为克隆的 47% 到在线 AAWR 的 94%;同一份实现只换 critic 的输入,交接完成率就从 0.0% 提到 44.4%。**
## 关键发现
- 真机盲抓上,在线 AAWR 的抓取率 94%、拾取率 89%,行为克隆只有 47% 与 41%。
- 书架交接任务里,AAWR 搜索分 92.4、Completion 44.4%;同样实现的对称 AWR 搜索分 79.6,但 Completion 是 0.0%。
- 穷举藏匿点的 Completion 44.0% 与 AAWR 接近,但步数 105.4 是 AAWR 的 36.6 的约 3 倍;按时间归一化后,AAWR 在 4 个交接任务上比穷举快 2–8 倍。
- 仿真任务里 AAWR 相对 AWR 与 BC 分别约 2 倍与 3 倍;连全观测任务也有增益,作者推测是因为非特权 critic 必须先自己从像素里学出物体位置。
- 数据质量比数量更重要:50 条专家示范(成功率 94%)好过 195 条次优示范(成功率 60%),搜索分从 54.8 升到 73.2。
- 奖励可以带噪:有一个任务的总错标率 68.8%,AAWR 仍然学到了有效的搜索行为。
## 局限性
- 目前靠「搜索策略 + 切换到通用策略」的组合,而不是把主动感知行为直接微调进通用策略。
- 特权信息的形式是预先指定的(检测框、分割掩码),论文没有做表示学习来自动挑选有用特征。
- 任务规模有限,每个任务的示范量不超过 250 条,时程也较短;长时程下信息获取会复合,可扩展性还没有验证。
- 训练期仍然需要额外的特权传感器与检测、分割管线,奖励本身也依赖这条管线。
## 常见问题(FAQ)
### 我要复现这篇论文需要什么硬件?
真机一侧是 DROID 装配(Franka Panda 机械臂 + Robotiq 2F-85 夹爪 + 腕部 ZED Mini 相机)或开源的 Koch v1.1 五自由度机械臂加一个 RealSense 深度相机。训练期还需要一个能给出检测框与掩码的开放词汇检测器,论文用的是 DINO-X 与 GroundedSAM。
### AAWR 和普通 AWR 差在哪?
只差 critic 与 value 的输入。AWR 只用智能体可见的历史摘要估计优势,AAWR 把训练期才有的环境状态也并进优势估计。论文里两者是同一套实现,因此对比是受控的。
### 它和 RMA 这类非对称方法有什么不同?
RMA 这类方法依赖模拟器里海量的特权状态转移。AAWR 面向真机上少量、可能带噪的特权观测,并且在目标函数层面给出了推导,说明为什么非对称是必要的。
### 真机训练要跑多少数据?
四个 Franka 交接任务只做 10 万步离线训练,没有在线阶段。Koch 上的盲抓是 2 万步离线加 1200 个在线转移,大约 40 到 50 个回合。
### 部署时还需要那几个额外传感器吗?
不需要。部署只运行策略,输入是腕部图像、最近 6 步末端位置和占据栅格特征,特权传感器全部撤掉。
### 什么情况下它会失效?
论文没有验证长时程任务。另外奖励和特权标签都来自检测、分割管线,标注噪声大的任务上搜索分会明显更低。
## 参考链接
- 论文 arXiv 摘要页:[arXiv:2512.01188](https://arxiv.org/abs/2512.01188)
- 项目网站(含全部任务的视频):[penn-pal-lab.github.io/aawr](https://penn-pal-lab.github.io/aawr/)
- AWR 原始论文:[Advantage-Weighted Regression](https://arxiv.org/abs/1910.00177)
- AWAC:[Accelerating Online RL with Offline Datasets](https://arxiv.org/abs/2006.09359)
- 非对称 actor-critic 的理论刻画:[A Theoretical Justification for Asymmetric Actor-Critic Algorithms (ICML 2025)](https://proceedings.mlr.press/v267/lambrechts25a.html)
- 同方向的后续工作(无机器人示范的主动感知操作):[ActiveUMI](https://arxiv.org/abs/2510.01607)
---
> 给大家推荐一款自用写文献综述、无虚构文献的 AI:
>
> 🌟 **复旦大学 FudanNLP 团队自研 [切问学术](https://qiewenpaper.com/zh?utm_source=bzkol&utm_content=baishi)**
>
> 官网:[qiewenpaper.com](https://qiewenpaper.com/zh?utm_source=bzkol&utm_content=baishi)
>
> 覆盖 **3.6 亿篇**可溯源真实中英文文献,能自动整合文献观点生成规范综述
>
> 还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
---
> **🍀后记🍀**
>
> 博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
>
> **🌸讨论QQ群**:[白拾的小屋](https://qun.qq.com/universal-share/share?ac=1&authKey=Suzrb5NKb9KulvZxFC8EMFvcd6jgVp%2B%2BnTG8h351HWQorXVfvI1n5QwEX5dlJyTh&busi_data=eyJncm91cENvZGUiOiI3NTAzNjU3MDAiLCJ0b2tlbiI6IlpFL2xLaGYxdXU4cWJPT2dJTkY3aExnWHNaQ1UrL3NJbWprenhLZitWUHVVNmhIR1M5SkZrS09SWmxKNlRreksiLCJ1aW4iOiIyMjc1OTYwNDg2In0%3D&data=hgymRnqgtjQPGoBKhZ8cEyznp0CMLWfCbG4rfiWIADCArVXw50a7c-Q4MWU2Eq3dwOUjG19hamAWQQU4lY-cOQ&svctype=4&tempid=h5_group_info) (750365700)
>
> **⭐B站账号**:[白拾的物理AI组会](https://space.bilibili.com/98639326)(活跃于知识区和动画区)
>
> **✨GitHub主页**:[YhbCode000](https://github.com/yhbcode000)(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献91条内容

所有评论(0)