【ICRA 2025】U-GRAPH:主动「二次猜测」,用不确定度引导的旋转主动感知估计任意物体的质心|从机器人触觉感知视角
·
## 摘要
机器人抓起一个没见过的瓶子,如果不知道重心在哪,东西很容易在手里打转。U-GRAPH 是 ICRA 2025 的一篇论文,它把「用一次力/力矩读数直接反算重心」换成「先猜一次,再让模型自己指出该往哪个方向转,然后猜第二次」,在 12 件日常物体上把逐轴平均误差做到 7.30 毫米,而传统解析解是 9.27 毫米。最关键的差距在竖直方向:解析解平均 13.67 毫米,它只要 7.95 毫米。这件事和做机器人的读者直接相关——质心估不准,抓取点和抓取力就只能靠人工一点点试出来。
**质心**(center of mass)是物体重量的等效作用点,机器人抓住它附近才稳。
**视频讲解**:[点击观看 B 站视频](https://www.bilibili.com/video/BV1tdJC6pEPu)
**章节时间轴**
- 00:37 作者介绍
- 01:24 研究背景与动机
- 02:56 相关工作
- 03:47 方法
- 07:13 实验设计
- 09:09 实验结果
- 11:18 消融与深入分析
- 12:56 系统实现与权衡
- 13:59 局限与讨论
- 14:50 要点总结
- 15:46 参考文献
[TOC]
## 论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Learning to Double Guess: An Active Perception Approach for Estimating the Center of Mass of Arbitrary Objects |
| 标题(中文) | 主动「二次猜测」:用不确定度引导的旋转主动感知,估计任意物体的质心 |
| 作者 | Shengmiao Jin、Yuchen Mo、Wenzhen Yuan |
| 机构 | 伊利诺伊大学厄巴纳-香槟分校(UIUC)RoboTouch Lab |
| 会议 | ICRA 2025 |
| arXiv | [arXiv:2502.02663](https://arxiv.org/abs/2502.02663) |
| 项目网站 | [double_guessing](https://leumasnij.github.io/double_guessing/) |
## 背景与动机
抓得稳不稳,很大程度取决于抓取点离质心有多远。这个距离越大,物体越容易绕着抓取点转,打滑和掉件基本都从这里来。
论文引用的两项工作把这件事说得很直接:握持姿态的选择和抓取点的位置,会决定带特定属性物体的抓取是否成功。
最直觉的解法叫**解析解**。用腕部**力/力矩传感器**(F/T sensor,能同时读出三个方向的力和绕三个轴的力矩)的读数,直接反算质心位置:$r_{CoM} = (\tau \times F) / |F|^2$,其中 $\tau$ 是力矩读数、$F$ 是力读数。
这条路有两个硬伤。第一个是噪声:传感器本身有测量噪声,物体在手里还会轻微打滑,误差会直接进结果里。
第二个更本质。当夹爪竖直向下抓住物体时,竖直方向的质心偏移几乎不产生力矩。也就是说读数里根本没有这项信息,单次测量从原理上就估不到竖直方向。
既有的研究各自解决了一部分。McGovern 等人在 2019 年的 IROS 论文里,靠在仿真中堆叠随机形状物体学习质心;2022 年他们又和 Xiao 一起,在真机上用扭矩传感估计餐具的质心。Hyland 等人在 IROS 2023 用反复推挤的办法求出二维质心。
主动触觉感知这条线离本文更近。TANDEM3D 用主动探索做三维物体识别,Uttayopas 等人用主动触觉区分物体属性。但这些工作的动作空间是离散的,任务也基本是分类。
这篇论文要做的是连续动作空间上的回归:在 $2\pi \times 1\pi$ 的旋转范围里挑朝向,输出三维质心。它设了三个基线来对照,定义如下表。
| 基线 | 做法 | 切掉的设计要素 |
|---|---|---|
| 解析解 | 用 $r_{CoM} = (\tau \times F) / |F|^2$ 从 F/T 读数反算,只在默认朝向使用 | 整个学习式估计 |
| 单次抓取 | 只跑流水线第一段,用一次读数推断质心 | 第二次测量 |
| 随机旋转 | 同样测两次、同样融合,但第二个朝向随机选 | 动作的信息量 |
## 研究主线:从问题到结论
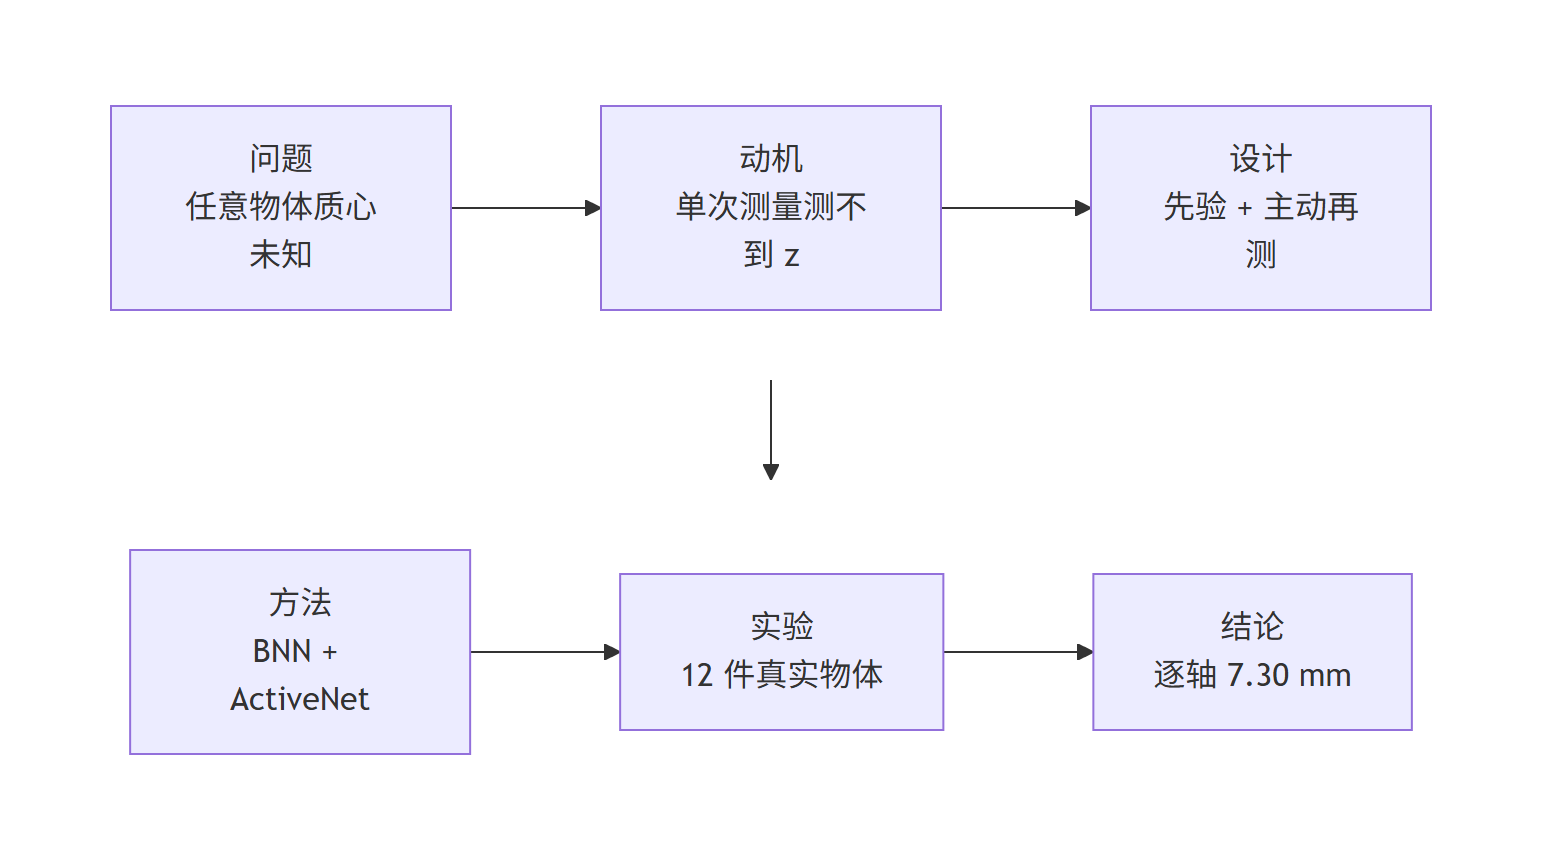
**图 8:研究主线(Mermaid 流程图)。从「单次测量测不到竖直方向」这个动机出发,走到先验加主动再测的设计,再到 12 件真实物体的逐轴 7.30 毫米。**
## 基准/方法设计
整套设计的核心是两次测量。第一次抓取给出质心的先验估计,同时给出这次估计有多不确定;第二次抓取的位置不是固定的,而是由第一步的不确定度推出来的。
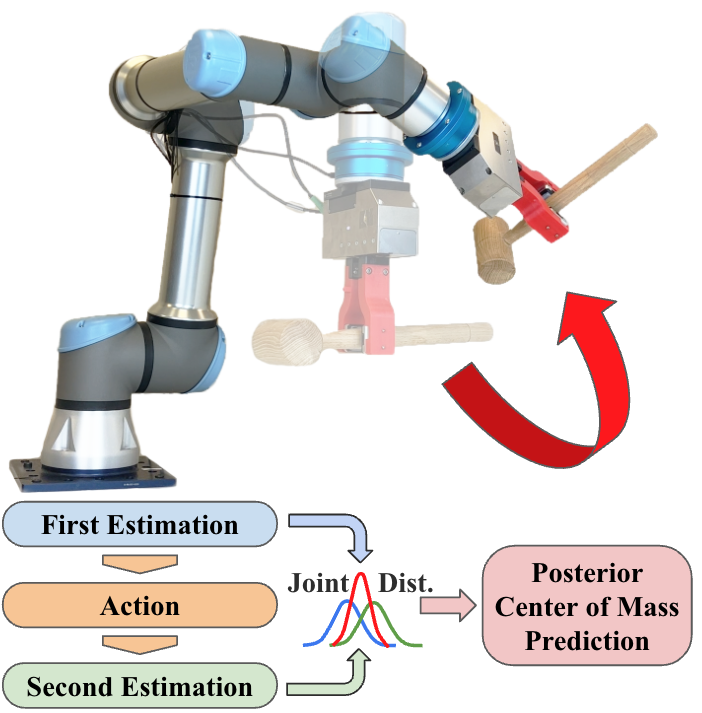
**图 1:U-GRAPH 总览(论文 Fig. 1)。先用第一次 F/T 读数得到质心先验,再推断一个能改善估计的新旋转朝向,执行后取第二次读数并融合。**
**贝叶斯神经网络**(BNN,Bayesian Neural Network)在这里的作用是同时给出估计值和它的标准差。普通网络只输出一个数,没法回答「再测一次能好多少」。
**ActiveNet** 是负责挑动作的网络。它拿到的输入是先验的均值、先验的标准差,以及一个候选动作,输出的是这个动作的分数。
推理时,系统在 $50\times 50$ 的动作网格上为每个候选朝向打一次分,挑分数最低的那个执行。
## 分类全景
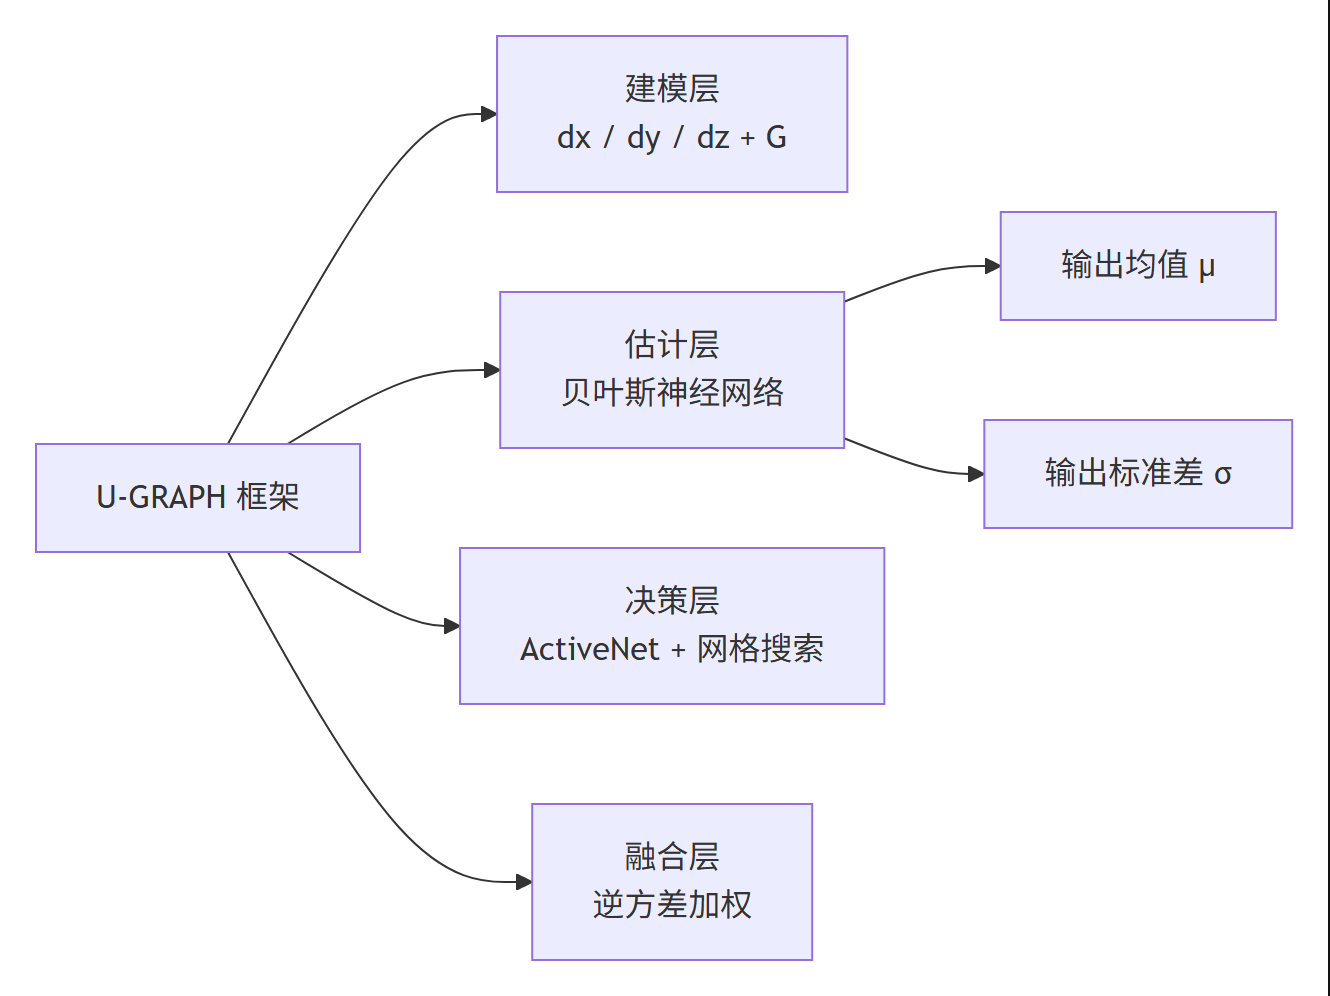
**图 9:框架全景(Mermaid 图)。建模层定义 dx/dy/dz 与重力,估计层用贝叶斯神经网络同时输出均值和标准差,决策层用 ActiveNet 加网格搜索挑朝向,融合层按逆方差加权合并两次测量。**
## 方法细节
质心的估计目标被拆成世界坐标系下的三个位移,分别是横向两个和竖直一个,再加上作用于物体的重力。整篇要回归的就是这三个偏移量。
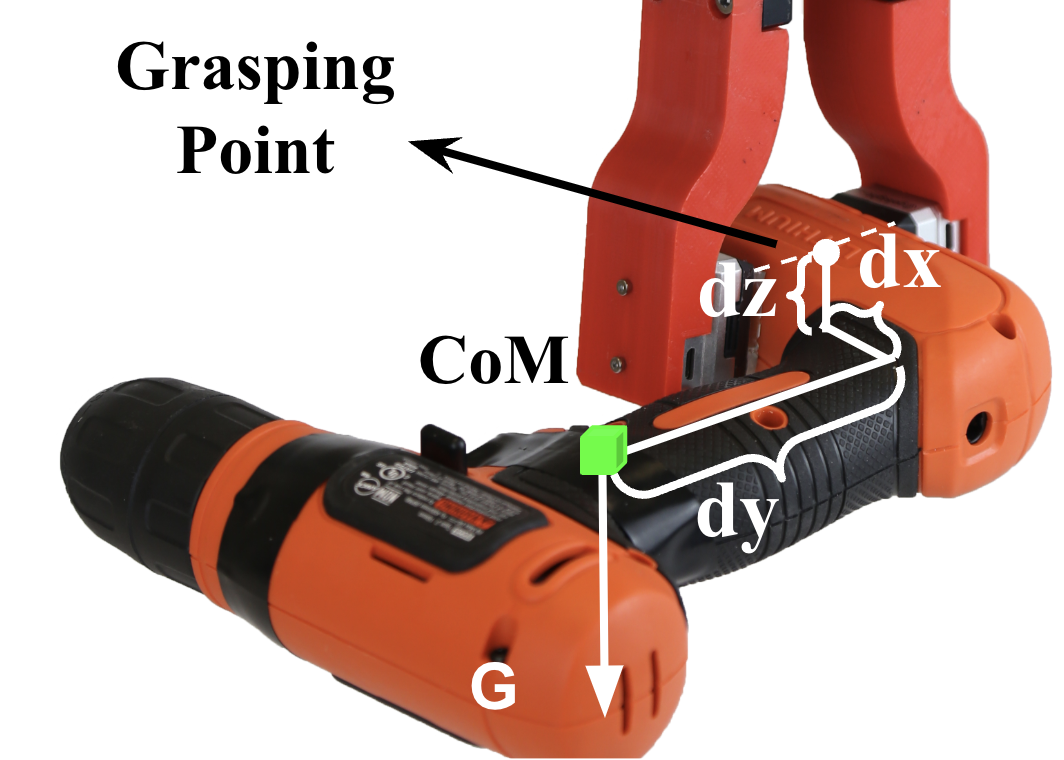
**图 2:质心的简化物理模型(论文 Fig. 2)。抓住物体后,质心用世界坐标系下的三个位移描述,估计质心等价于回归这三个偏移量。**
为什么必须用贝叶斯网络。解析解只能给点估计,无法回答「再测一次能好多少」,而主动感知恰恰需要这个量来挑动作。
贝叶斯网络学的是每个节点权重的后验分布,预测时对分布求期望,期望的方差就是这次估计的不确定度。
精确计算这个期望需要无穷多个网络的集成。实际做法是用**马尔可夫链蒙特卡洛**(MCMC)采样近似,再用**哈密顿蒙特卡洛**(HMC)与 No-U-Turn 采样器避免低效的随机游走,自动决定采样步数。
为什么不让网络直接回归一个最优动作。能让误差变小的朝向通常不止一个,显式回归唯一最佳会忽略掉其余同样好的峰,所以改成给每个动作打分再取最小。
分数的定义很有意思:执行某个候选旋转之后,贝叶斯网络的估计误差是多少,这个误差就是该动作的分数。训练标签由数据自动算出,不需要人工标注。
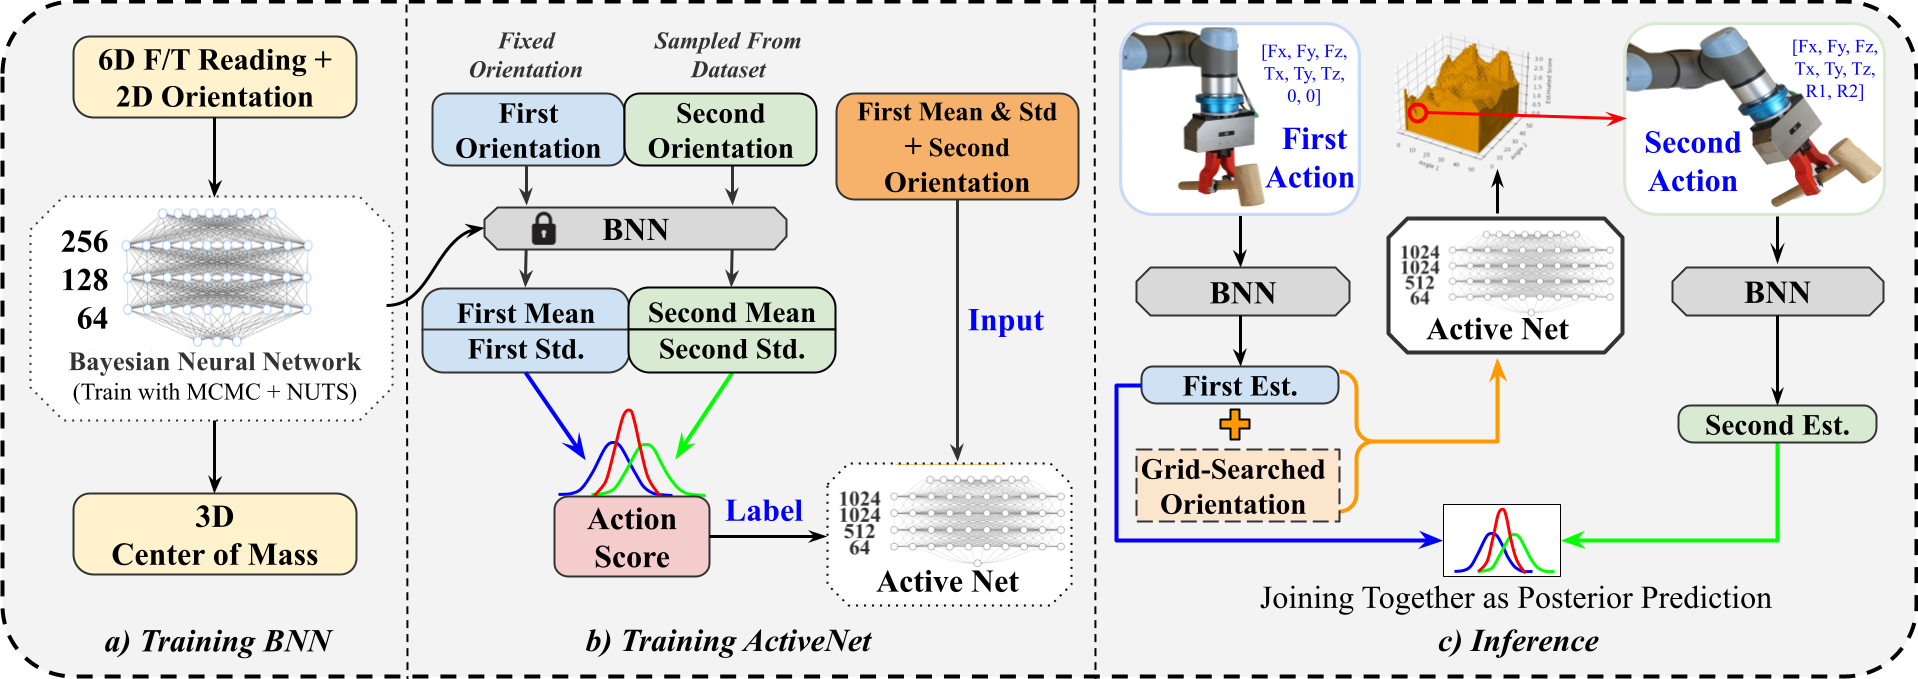
**图 3:U-GRAPH 的三张流程图(论文 Fig. 3)。a) 贝叶斯网络用 MCMC 与 NUTS 迭代训练;b) ActiveNet 的标签来自「把候选旋转喂给 BNN、看估计误差」;c) 推理时先验、选动作、再测一次、最后融合。**
融合这一步假设两次测量都是对质心的独立高斯观测,按逆方差加权合成后验:$\mu_{\text{final}} = \frac{\mu_1/\sigma_1^2+\mu_2/\sigma_2^2}{1/\sigma_1^2+1/\sigma_2^2}$。标准差小的那次自动拿到更大的权重。
动作空间只有两个自由度:感知期间其余关节锁死,第一个朝向固定为夹爪竖直向下,第二个朝向在水平方向 $2\pi$、竖直方向 $1\pi$ 的范围内搜索。
## 实验设计与结果
硬件是一台六自由度的 UR5e 机械臂,腕部装了 Nordbo 的六轴力/力矩传感器,采样率 1000 Hz,末端是 Weiss 的两指夹爪。
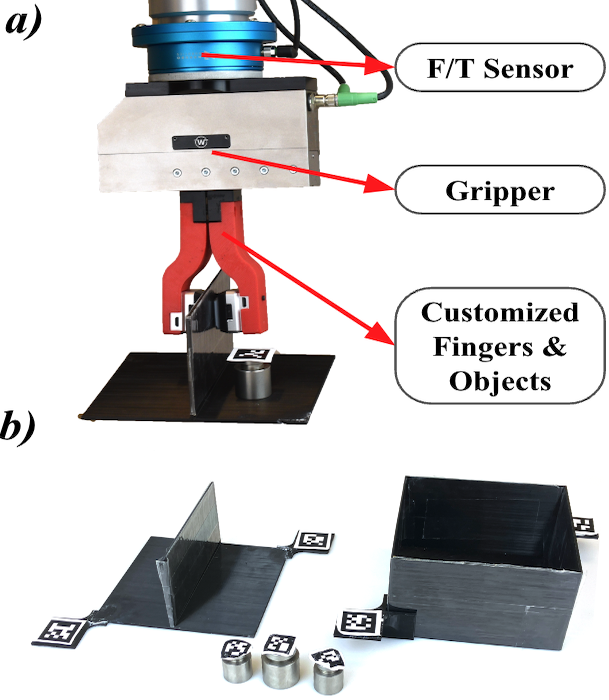
**图 4:数据采集平台与自制物体(论文 Fig. 4)。左图标出 F/T 传感器与夹爪的安装位置;右图是两件三维打印物体,都贴了 AprilTag 用于自动标注真值。**
训练物体只有两件自制的三维打印件,尺寸都是 $15\times 15\times 8$ 厘米。一件重 127.36 克、从中心抓,另一件重 185.36 克、从侧面抓,再配两个 100 克和一个 200 克的标准砝码随机放置。
采集流程全自动:顶置相机识别 AprilTag 算出真实质心与可抓区域,随机采样一个抓取点,机械臂抓起来后转到 100 个朝向记录读数。一共 204 次抓取,用了大约 150 小时。
评测分成两组。第一组是同款物体换配重,五种配重每种随机抓 5 次,真值用和训练一样的顶置相机加标签。第二组是 12 件日常真实物体,人工指定抓取点,真值靠逐轴平衡量出来,每件物体做 5 种抓取配置。
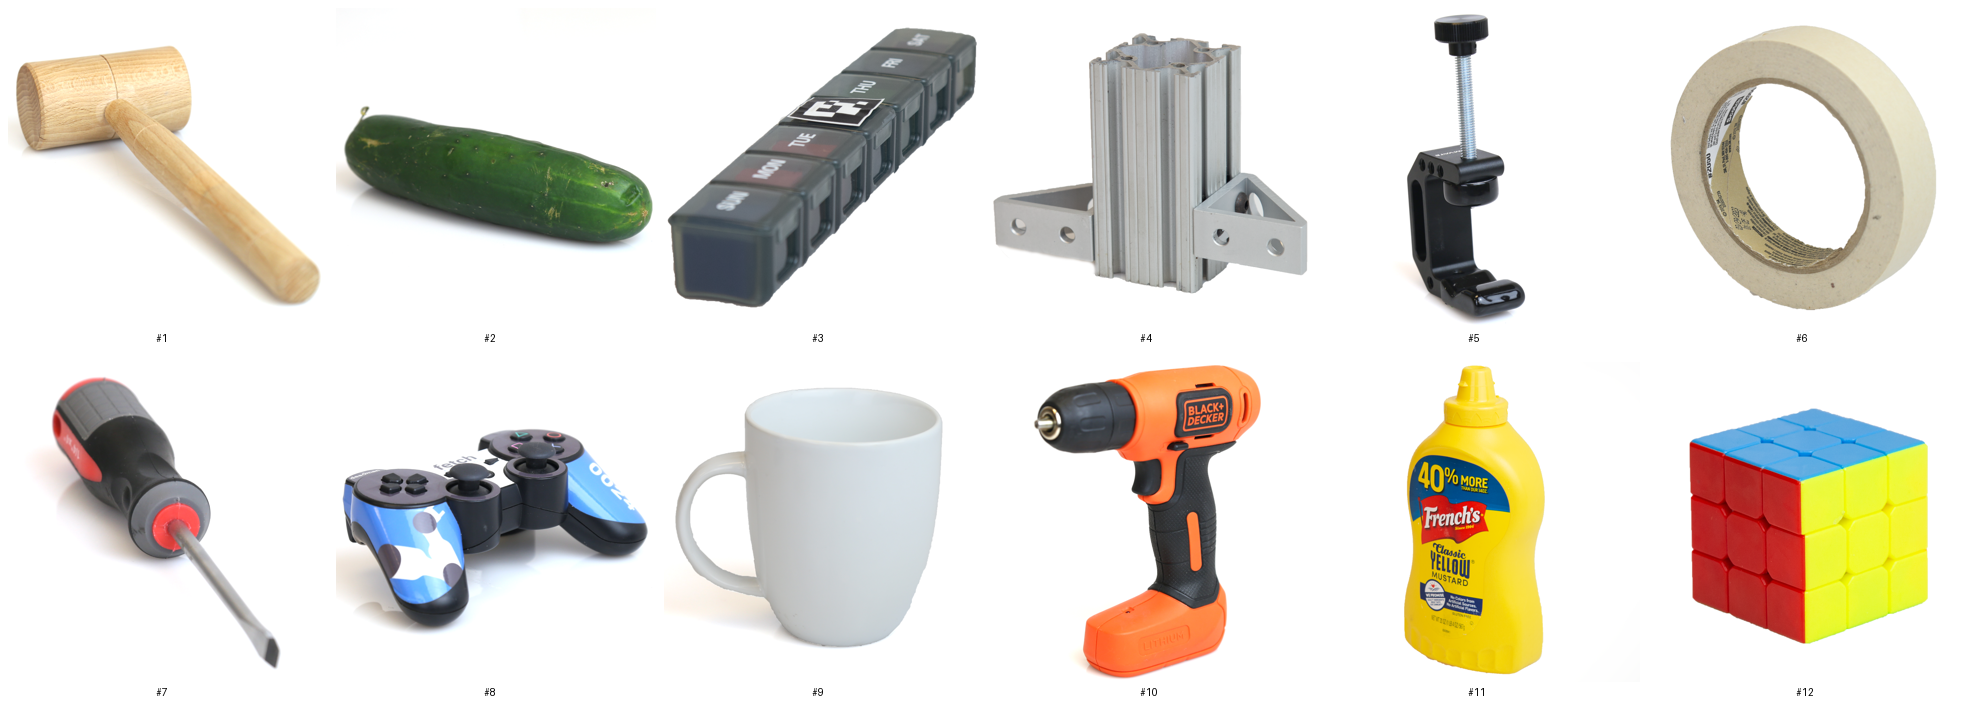
**图 5:测试用的 12 件日常真实物体(论文 Tab. 1 的 #1–#12)。重量从 43.4 克到 613.2 克,最大尺寸从 56 毫米到 285 毫米,最后三件的重量落在训练分布之外。**
下表是把论文表格里 12 件物体、3 个轴的误差共 36 个数字逐轴取平均之后的结果。论文本身没有报告这四个平均值,是本文按它的逐物体结果算出来的。
| 方法 | X (mm) | Y (mm) | Z (mm) | 36 轴均值 (mm) |
|---|---|---|---|---|
| **U-GRAPH(本文)** | **7.71** | 6.24 | **7.95** | **7.30** |
| 解析解 | 8.95 | **5.20** | 13.67 | 9.27 |
| 随机旋转 | 13.59 | 13.51 | 14.12 | 13.74 |
| 单次抓取 | 15.76 | 13.38 | 13.96 | 14.36 |
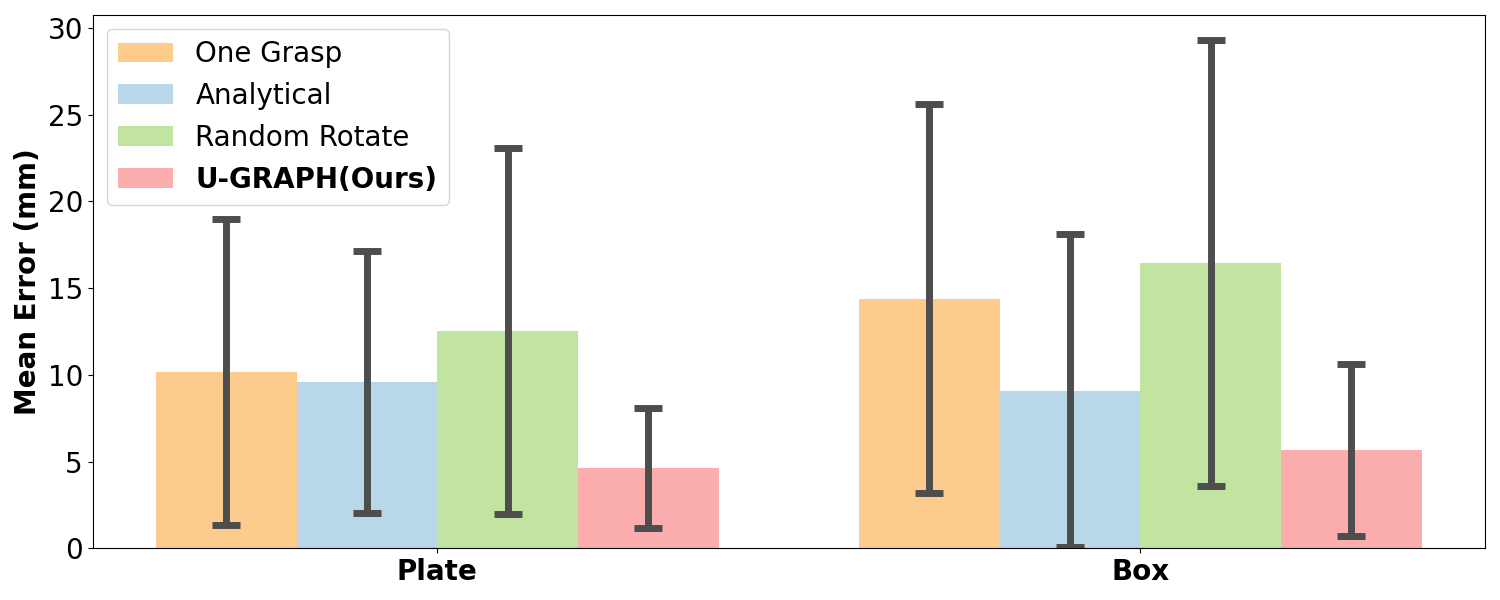
**图 6:自制训练物体换配重后的误差(论文 Fig. 5)。柱为平均误差、误差棒为平均标准差,U-GRAPH 在五种配重配置上都最低。**
竖直方向的表现最能说明问题。解析解的平均竖直误差是 13.67 毫米,随机旋转 14.12 毫米,单次抓取 13.96 毫米,三者几乎一样。U-GRAPH 把它压到 7.95 毫米,而且 12 件物体一件不落全都有改善。
论文自己的口径是:在 12 件测试物体里有 10 件精度最优。逐轴数一遍,U-GRAPH 在 5 件物体上做到三轴全优,另外 3 件两轴最优,剩下 4 件只有一轴最优。
失分集中在三件重量落在分布外的物体上。把它们单看,横向误差会涨到 11.8 到 13.5 毫米。
重量实验把这一件事单独隔离出来做。拿第 11 件物体(那瓶芥末酱),每次都抓在同一个位置,只改贴在质心附近的标准砝码总量。训练数据覆盖的重量区间是 127.36 到 585.36 克。
| 配重 (g) | X (mm) | Y (mm) | Z (mm) |
|---|---|---|---|
| 43.4(分布外,太轻) | 12.1 | 7.4 | 10.1 |
| 244.6(分布内) | 5.0 | 6.1 | 6.4 |
| 446.2(分布内) | 6.1 | 4.4 | 5.6 |
| 648.1(分布外,太重) | 15.6 | 12.7 | 13.2 |
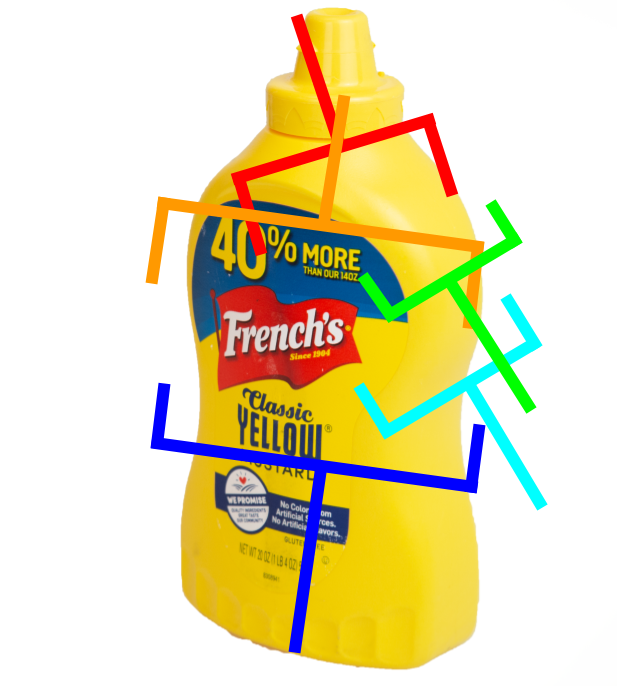
**图 7:配重消融的抓取位置(论文 Fig. 7 左图)。全程固定同一抓取位置,只改变标准砝码总量,把重量这一个变量隔离出来。**
分布内两档的三个轴误差都在 4.4 到 6.4 毫米之间,两端各掉到 10 到 15 毫米。物体太轻,力/力矩信号压不过噪声;物体太重,抓取本身就不稳,更容易打滑。
12 件物体的完整数据(尺寸、重量、三轴误差、三轴中最优的轴数)放在论文附录的表里:三轴全优 5 件、两轴最优 3 件、一轴最优 4 件。
## 结果对比总结
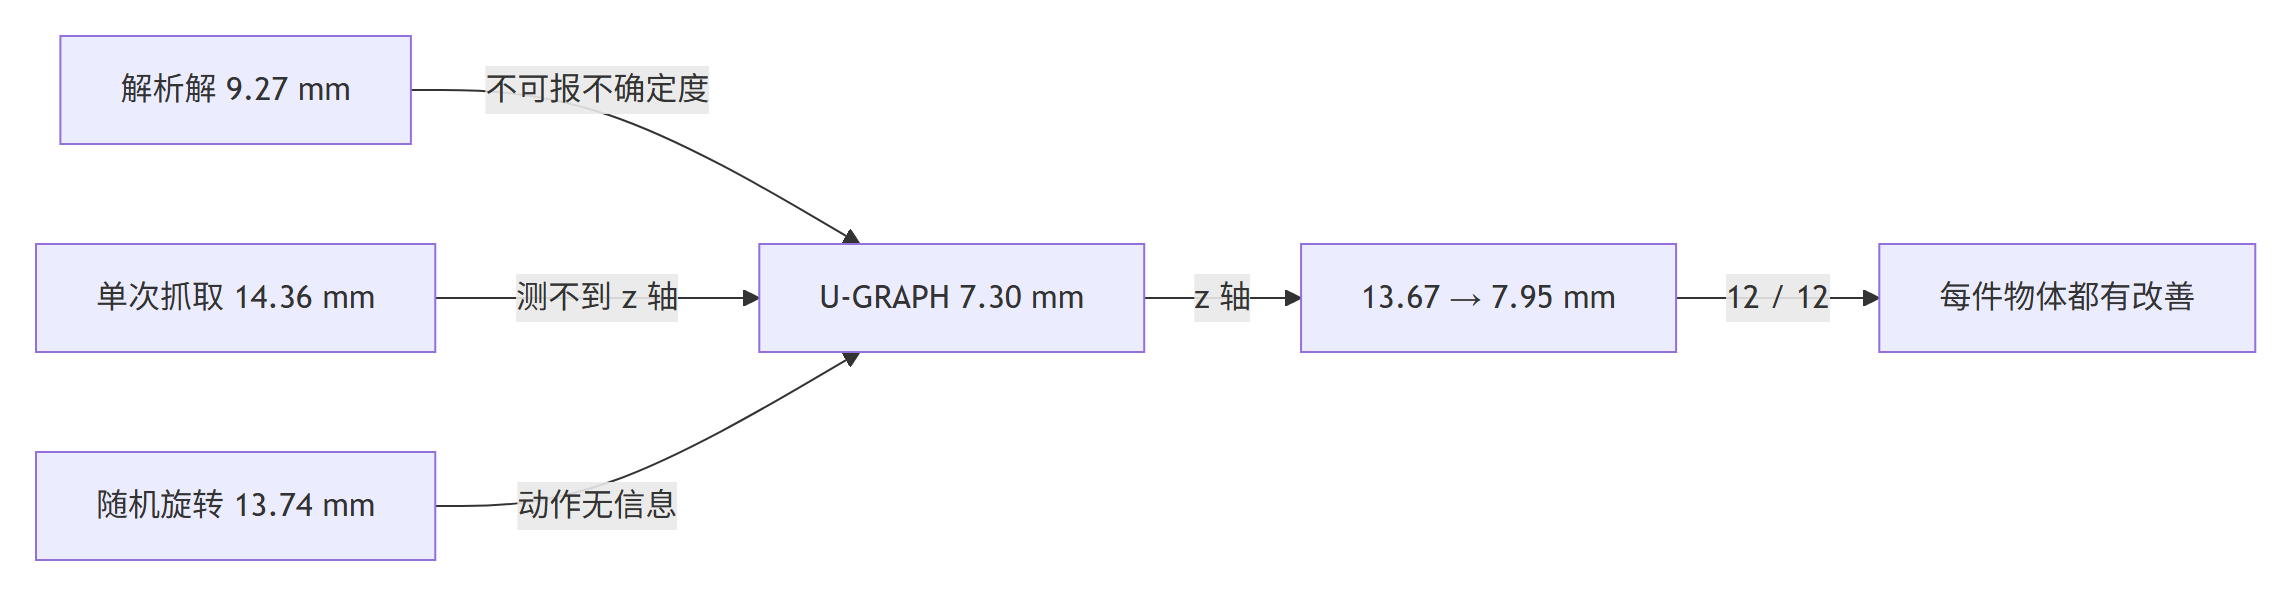
**图 10:结果对比总结(Mermaid 图)。解析解 9.27 毫米、单次抓取 14.36 毫米、随机旋转 13.74 毫米,U-GRAPH 7.30 毫米;竖直方向从 13.67 毫米降到 7.95 毫米,12 件物体全部改善。**
## 关键发现
- 竖直方向的收益是结构性的:解析解平均 13.67 毫米,U-GRAPH 7.95 毫米,12 件物体全部改善,最大的一件从 19.4 毫米降到 5.0 毫米。
- 第二次测量本身不够,动作必须带信息:随机旋转同样测两次、同样用贝叶斯融合,横向误差反而涨到 13.59 与 13.51 毫米。
- 单次竖直接握测不到竖直方向:解析解 13.67 毫米与单次抓取 13.96 毫米几乎同级,说明这不是模型好坏的问题。
- 逐轴平均 7.30 毫米,比解析解 9.27 毫米低约 21%,比随机旋转 13.74 毫米低约 47%。
- 泛化的边界由数据分布决定:分布内两档配重误差 4.4 到 6.4 毫米,43.4 克与 648.1 克两端掉到 10 到 15 毫米。
- 训练成本主要在数据:204 次抓取、100 个朝向、约 150 小时,模型本身只有几百个隐藏单元量级。
## 局限性
作者对边界写得很坦白。这是一套两次动作的框架,论文的目标是证明这类预测框架能改善质心估计,而不是宣称解决了整个问题。
大打滑仍然处理不了。物体重、或者质心明显偏离抓取点时会滑动,这是当前失败的主要来源。作者的计划是在指尖加装 GelSight 传感器,把打滑从干扰变成可以测量的量。
重量超出训练区间会退化。太轻的物体信号压不过噪声,太重的物体抓不稳,两端都不容易扩数据。
因为优化的是总误差,逐轴精度不是目标,单轴确实可能不如解析解。论文里物体的横向误差就出现过解析解 3.2 毫米优于本文 6.8 毫米的情况。
还有一个容易被忽略的点:两批实验的真值口径不一样。训练物体靠顶置相机加 AprilTag,真实物体靠夹爪逐轴平衡,两种真值的噪声量级不同。
## 常见问题(FAQ)
### 这套方法在真机上跑要什么硬件?
一台六自由度机械臂加一颗腕部六轴力/力矩传感器就够了。论文用的是 UR5e 加 Nordbo 的传感器和三指夹爪,采样率 1000 Hz,模型推理在单臂工作站上完成。
### 它和解析解到底差在哪?
差的不是公式精度,而是信息量。竖直接握时竖直方向的质心偏移不产生力矩,解析解拿不到这项信息,只能靠噪声去猜。换一个朝向之后再测一次,这项信息才第一次进入观测。
### 为什么不干脆多测几次求平均?
论文只做两次,作者把它当成必须成立的最小规模。多测几次会遇到两个新问题:多少次最优没有答案,而且多次相关的观测会让逆方差融合出来的后验过度自信。
### 我要复现需要多少数据?
训练集是 204 次抓取、每次 100 个朝向,合计 18,893 条力/力矩读数,采集大约 150 小时。这是整套流程里最贵的一环,模型训练本身反而很快。
### 为什么只在两件物体上训练还能迁移?
因为模型只学「力/力矩读数加朝向」到「质心偏移」这条映射,物体的几何、摩擦、密度都不在输入里。反过来这也解释了为什么重量超出训练区间就会退化。
## 参考链接
- 论文 arXiv 摘要页:[arXiv:2502.02663](https://arxiv.org/abs/2502.02663)。
- 项目主页(含视频与补充材料):[leumasnij.github.io/double_guessing](https://leumasnij.github.io/double_guessing/)。
- 第一作者主页:[Shengmiao Jin](https://leumasnij.github.io/)。
- 实验室与论文列表:[UIUC RoboTouch Lab](https://www.robotouchlab.com/)。
- 概率编程库 Pyro:[pyro.ai](https://pyro.ai/)。
- 视觉触觉传感器 GelSight:[gelsight.com](https://gelsight.com/)。
---
看完这篇,值得记住的一句话是:质心估计的瓶颈不在算得准不准,而在拿到的信息够不够。下一步可以沿着两条线读——一条是同一实验室把打滑从干扰变成测量量的触觉表征工作,另一条是用不确定度驱动动作选择的其他物理属性估计任务。
---
> 给大家推荐一款自用写文献综述、无虚构文献的 AI:
>
> 🌟 **复旦大学 FudanNLP 团队自研 [切问学术](https://qiewenpaper.com/zh?utm_source=bzkol&utm_content=baishi)**
>
> 官网:[qiewenpaper.com](https://qiewenpaper.com/zh?utm_source=bzkol&utm_content=baishi)
>
> 覆盖 **3.6 亿篇**可溯源真实中英文文献,能自动整合文献观点生成规范综述
>
> 还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
---
> **🍀后记🍀**
>
> 博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
>
> **🌸讨论QQ群**:[白拾的小屋](https://qun.qq.com/universal-share/share?ac=1&authKey=Suzrb5NKb9KulvZxFC8EMFvcd6jgVp%2B%2BnTG8h351HWQorXVfvI1n5QwEX5dlJyTh&busi_data=eyJncm91cENvZGUiOiI3NTAzNjU3MDAiLCJ0b2tlbiI6IlpFL2xLaGYxdXU4cWJPT2dJTkY3aExnWHNaQ1UrL3NJbWprenhLZitWUHVVNmhIR1M5SkZrS09SWmxKNlRreksiLCJ1aW4iOiIyMjc1OTYwNDg2In0%3D&data=hgymRnqgtjQPGoBKhZ8cEyznp0CMLWfCbG4rfiWIADCArVXw50a7c-Q4MWU2Eq3dwOUjG19hamAWQQU4lY-cOQ&svctype=4&tempid=h5_group_info) (750365700)
>
> **⭐B站账号**:[白拾的物理AI组会](https://space.bilibili.com/98639326)(活跃于知识区和动画区)
>
> **✨GitHub主页**:[YhbCode000](https://github.com/yhbcode000)(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献86条内容

所有评论(0)