千亿赛道洗牌!数据标注产业换挡,垂类标注迎来红利期
从“人工点点点”到千亿级产业,从数据标注到高质量数据集建设,数据产业正在经历一场深刻的换挡升级。
“算力决定下限,数据决定上限”——这已成为AI行业的核心共识。中国信通院人工智能研究所樊威博士在近日的“极致人才”栏目中提到:数据标注是对原始数据进行加工、赋予语义的过程,是数据资源转化为模型可用训练数据的关键环节,直接决定了模型能力上限。今天的标注已经从人力密集走向人机协同、自动预标注、智能审核、专家校验的工程化流程,产业正从“建设期”迈入“实施期”,进入规模化扩张阶段。
今年8月,国家数据局宣布在32个城市布局第二批数据标注先行先试工作。首批7个国家级数据标注基地已形成覆盖医疗、工业、教育等行业的高质量数据集335个,赋能121个国产大模型研发,带动产值超83亿元。业内共识愈发清晰:数据标注已不是AI后台的“杂活儿”,而是决定智能上限的战略性产业。
作为深耕这一领域多年的实践者,淘丁数科正是这场变革的亲历者与推动者。
行业大变局
传统标注正在萎缩,知识型标注迎来爆发
很多人依旧认为数据标注就是简单重复劳动。但真实产业早已迭代:人机协同成为主流,AI 预标注、智能审核承接大量重复性工作。机器替代的只是操作,人的专业判断、领域知识才是不可替代的核心。
当下行业呈现明显结构性分化:低端简单标注产能过剩,医疗、金融、法律等垂直领域知识型标注缺口巨大。 高质量数据集的核心在于准确性、一致性、多样性、可溯源。想要达到这一标准,绝非靠人力堆量,而是考验企业的智能工具、专家资源、全流程质量管控以及合规交付能力。
政策持续加持下,数据标注作为激活数据要素、赋能 AI 产业、带动数字就业的关键赛道,垂直行业定制数据集,成为大模型后训练时代最大增长引擎。
何为高质量数据集
淘丁医疗标注案例给出具象答案
高质量数据集的核心标准:准确性、一致性、多样性、可溯源,全部依托严苛的标注质量管理体系。大模型进入后训练时代,指令数据、行业垂直数据需求爆发,行业高端标注成为全新增长极。
这些概念听起来抽象,樊威博士以淘丁数科皮肤病 AI 数据集项目作为典型样本拆解高质量背后的高知识密度。
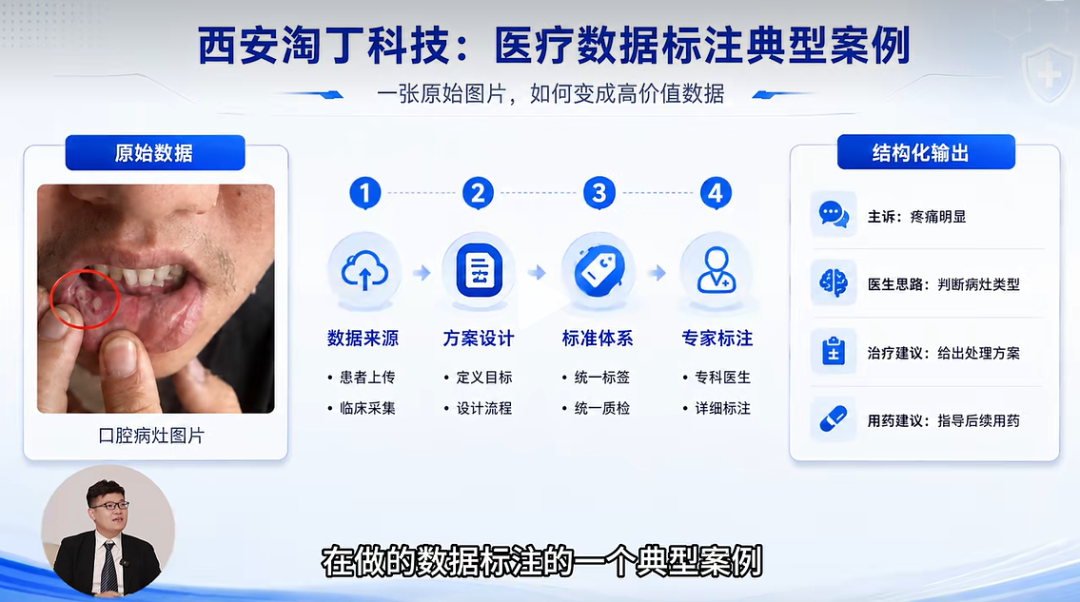
一张普通皮肤病图片,原始素材本身无法赋能 AI。完整链路包含数据来源筛选、定制方案设计、标准体系搭建、专家参与标注全流程。 项目邀请医院皮肤科专科医生参与标注工作。日常门诊问诊一张病症图片用时不足一分钟,但单张图片精细化标注需要30‑90 分钟。医生完整输出主诉、治疗方案、用药建议、复诊建议等全套专业信息,把临床专业知识沉淀进数据集。
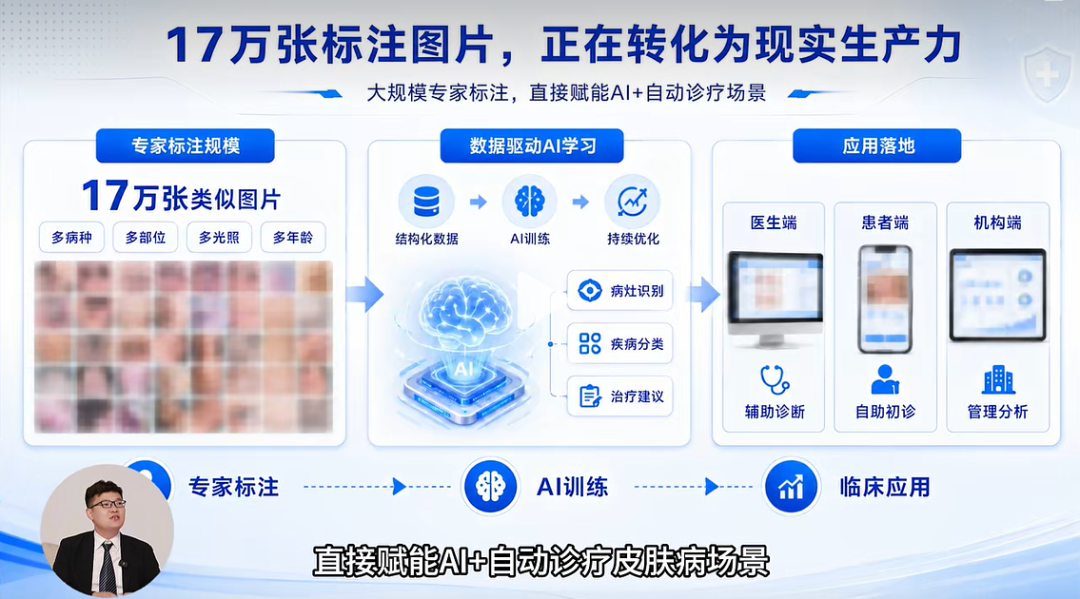
通过完成 17 万张皮肤病图像的专家级标注,数据集直接落地赋能皮肤病 AI 自动诊疗场景,让静态的数据真正转化为现实生产力。
这正是高质量标注的内核:不是机械框选打点,而是把行业专家的知识、经验注入数据。
未来已来
淘丁数科锚定高质量数据集新赛道
展望未来,樊威博士判断:产业形态向技术密集型升级,行业数据标注将成为主战场。
当产业从“量”的扩张走向“质”的跃升,淘丁数科以扎实的行动回应了这一趋势。作为国内领先的AI数据服务与解决方案提供商、国家级高新技术与专精特新企业,公司已从本土数据标注企业,转型升级为高质量数据集建设与智能应用服务商。
在医疗标注这一高知识密度赛道,淘丁数科构筑起坚实的行业壁垒:组建了300余名全职医学专家标注团队,并通过众包平台招募了2万多名三甲医院主治以上医生作为在线众包医学专家。依托自研的“淘丁精标云数据平台”,采用AI预标注、专家标注、质检三级质控体系,构建起从数据采集、清洗、脱敏、标注、质检到交易的全流程医疗数据服务闭环。同时跻身《人工智能数据标注产业图谱—2026》,服务多家头部大模型企业,成为医疗AI数据领域的核心供应商。
与此同时,淘丁数科正前瞻性布局具身智能数据服务这一赛道。公司已形成从方案设计、多源数据采集、质检、标注到最终交付的端到端全流程服务能力,覆盖工业制造、家庭服务、仓储物流、医疗康养等多元应用场景。这一核心差异化业务破解了人形机器人等交互训练数据匮乏的行业瓶颈,已支撑起零售场景具身智能数据采集等多个商业化项目落地。
被替代的只是简单的重复,不可替代的是人的知识与判断。 从医疗数据的高知识密度标注,到具身智能的前沿数据采集,淘丁数科致力于构建高质量数据集与数据采集基础设施,在这场千亿级产业变革中持续深耕,为AI产业筑牢不可替代的数据地基。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)