Whole-Body UMI——通过实时运动生成将手部UMI操作轨迹补全到全身运动:不用脚踝追踪器,直接两个umi开干
前言
如原论文所说,为人形机器人收集全身操作演示大多依赖遥操作,其成本高且难以扩展。Universal ManipulationInterface(UMI)提供了一种可扩展的数据采集范式,但仅使用末端执行器轨迹不足以确定人形机器人的全身协同,因此无法满足全身示范数据的采集需求
- 为此,作者提出 Whole-Body UMI(WB-UMI),一种与任务无关、实时、并以末端执行器为条件的运动生成器,通过共享的末端执行器接口,将全身协同学习与任务语义学习解耦
- 扩散策略(diffusion policy)从原生 UMI 示范中学习,而 WB-UMI 则独立地从重定向的动作捕捉数据中学习,在任务特定数据采集阶段无需使用身体追踪器或配对的图像–全身演示
说白了,关键如下图所示
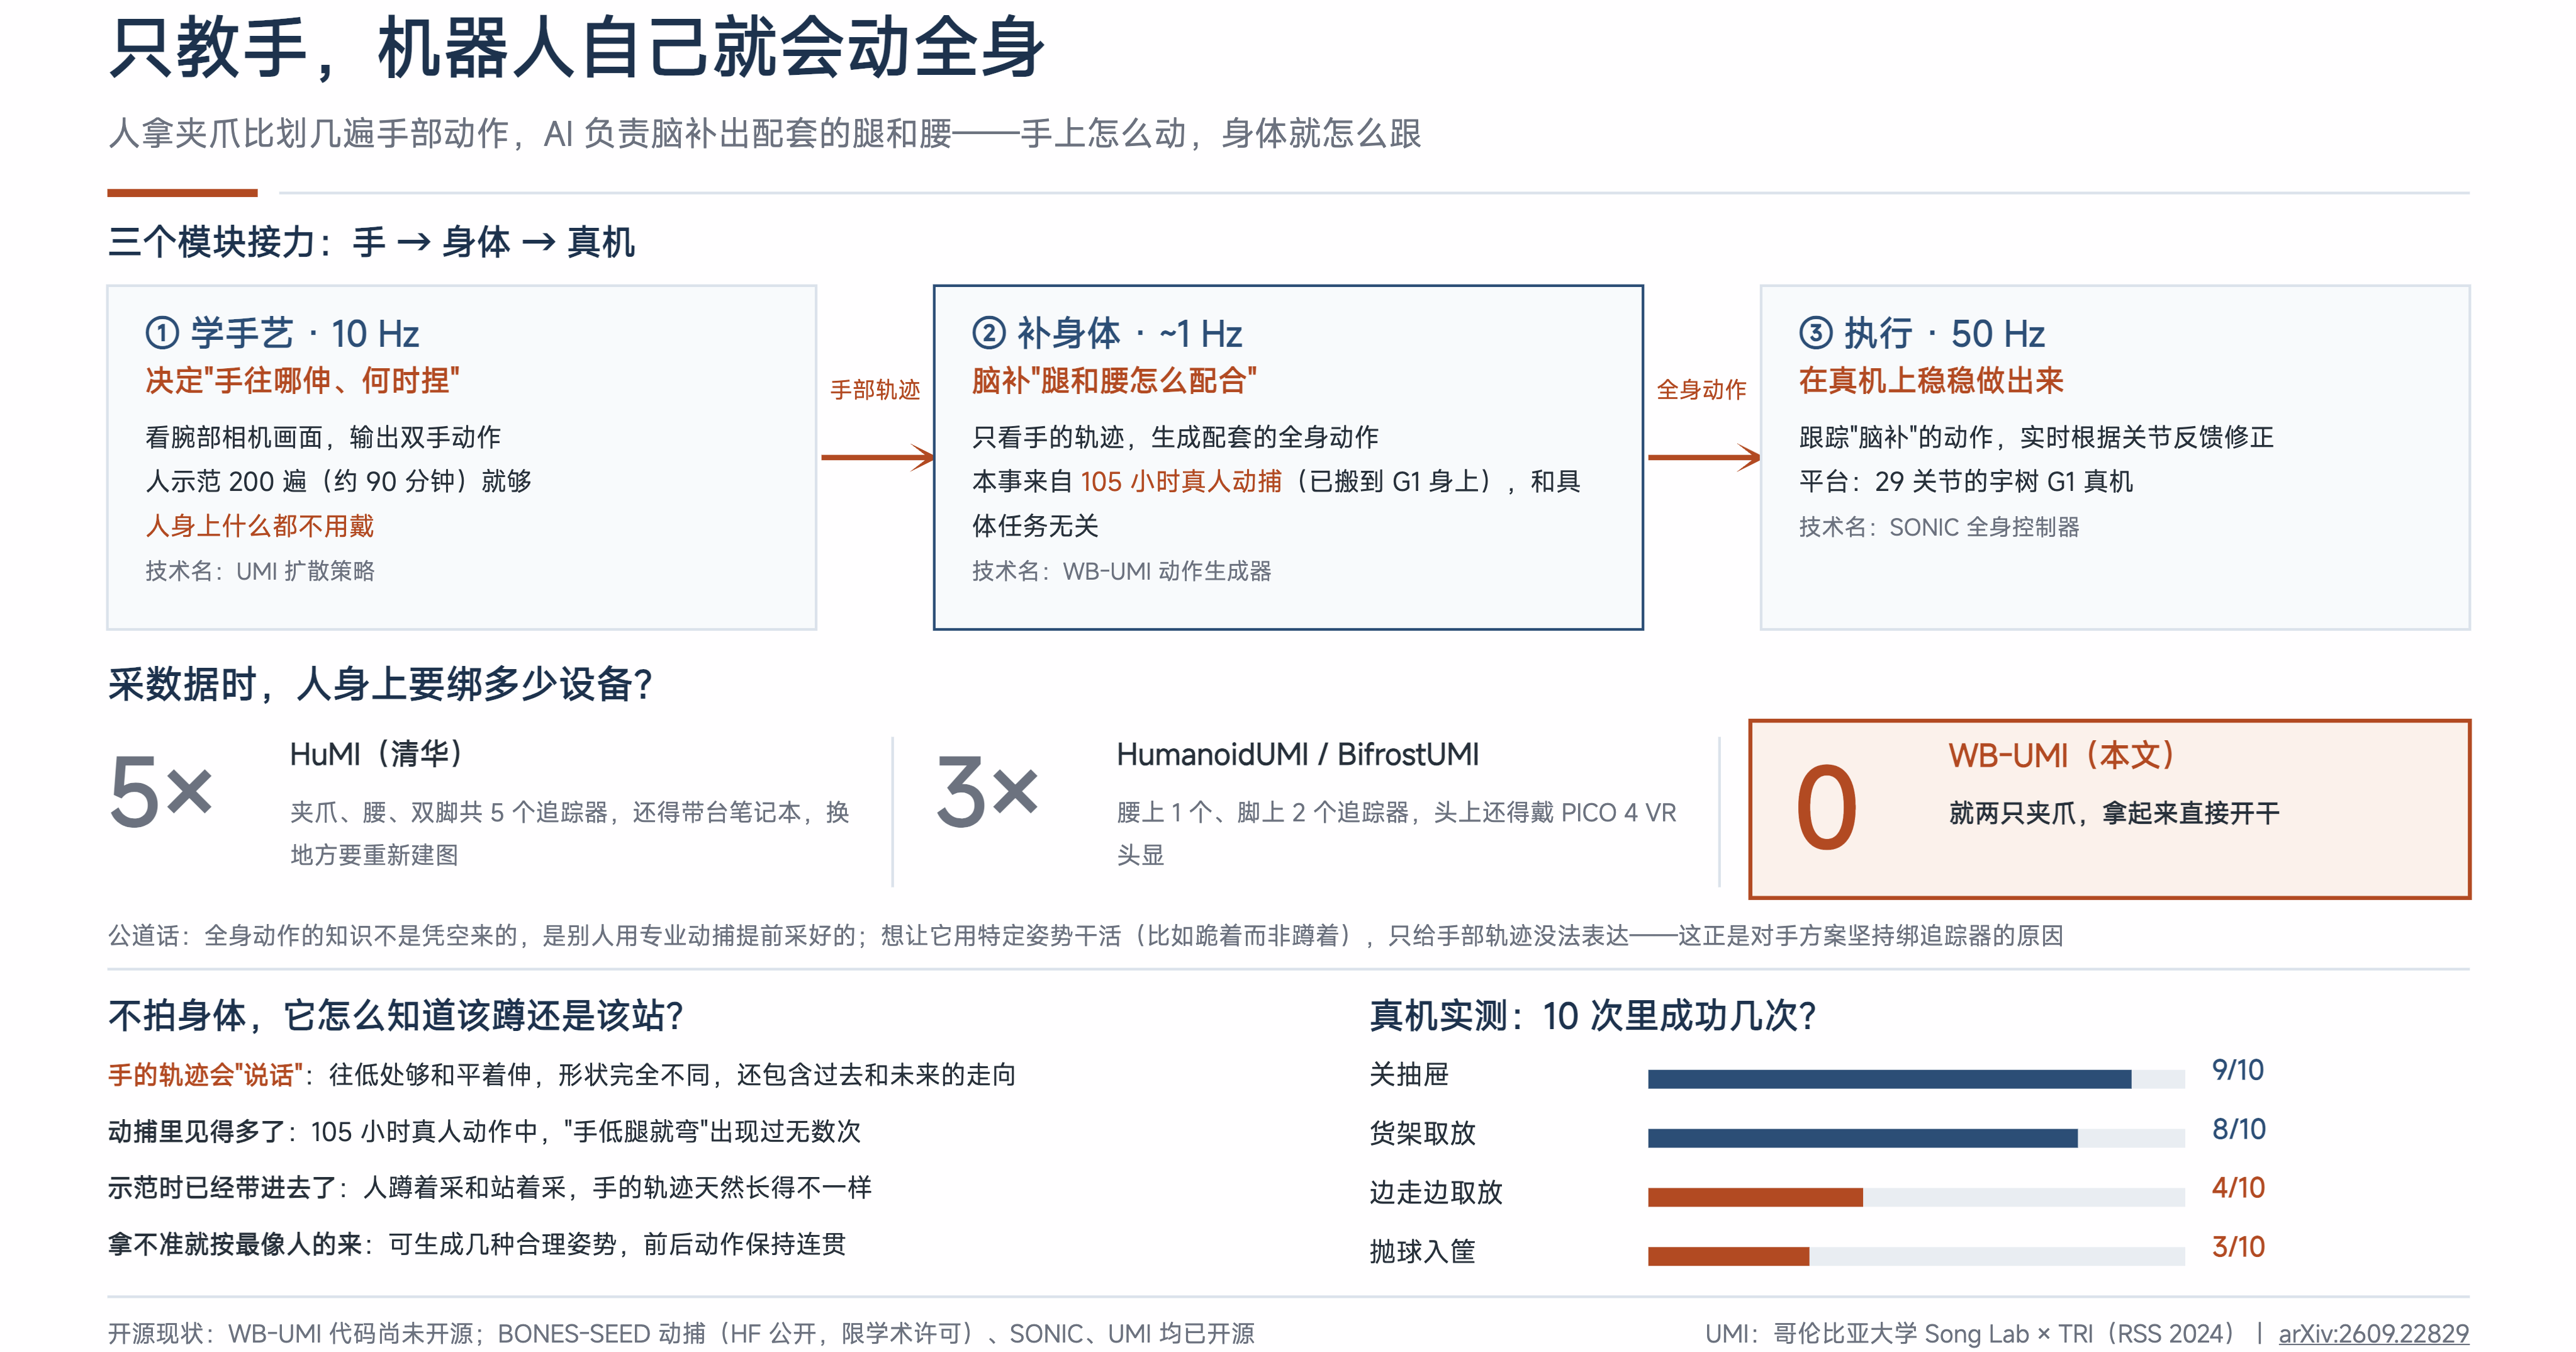
你可能还没意识到 这个工作的创新性,我再帮大家强调一下
- 该工作 只用了两个原装umi采集数据
你可能会疑问,WB-UMI 除了手部数据外,还视频拍摄了人的行为数据么,不然怎么重定向到G1上
妙的是,没有
任务数据采集环节完全不需要任何人体视频或身体追踪设备
即在采集任务数据的环节,WB-UMI 把整套全身追踪装备都摘掉了——不戴 VR 头显,不绑腰部追踪器,不踩脚踝追踪器,人就拿两个 UMI 夹爪直接比划

- 当我用umi去桌子上 抓取东西的时候,系统怎么知道去补全的身体,是要蹲着的,还是直立着不蹲着的
巧的是:WB-UMI 的输入不是"手现在在哪",而是 EE 轨迹的时空序列(位置+朝向),还包括过去 8 帧历史和未来 32 帧的稀疏前瞻
轨迹是平直地伸到 1.2 米高处,还是俯冲下去到 0.3 米处,这本身就是完全不同的信号
回想一下人类行为:人伸手去够地上的东西时,几乎不会直挺挺站着只用胳膊够——会屈膝下蹲或弯腰。这些(手部轨迹, 全身动作)的配对在 105 小时动捕数据里出现了无数次,相当于动捕数据 给了模型充分的先验知识
WB-UMI 训练的就是条件分布 p(全身动作 | EE轨迹, 身体历史),所以
看到"手持续下降且前移"的轨迹,生成下蹲就是最大概率的补全;
第一部分 Whole-Body UMI: Transferring UMI Manipulation Skills to HumanoidWhole-Body Manipulation via Real-Time Motion Generation
1.1 引言与相关工作
1.1.1 引言
现有的大多数人类数据采集范式都依赖远程操作,通过针对具体任务的全身示范来获得全身协调,这一过程费时费力、成本高昂且难以大规模扩展
Universal Manipulation Interface(UMI)能够以可扩展、无需机器人介入的方式收集以任务为中心的末端执行器(End-Effector, EE)示范数据 [1],为降低数据采集负担提供了一种极具前景的途径
- 然而,末端执行器(EE)轨迹只规定了任务意图,但从根本上对类人机器人全身协同的约束不足:同样的 EE 轨迹可以通过不同的身体姿态和脚步位置来实现。因此,如何仅利用 UMI 数据生成合理且有效的全身协同,仍然是一个尚未解决的开放性难题
- 现有方法通常在 UMI 上增加身体追踪器,然后结合手工设计约束的逆运动学(IK)来获得协调的全身运动 [2],[3]
这一流程提供了直接的协同监督,但也带来了两大局限:
1)额外设备:用户除了手持 UMI 设备外,还必须佩戴并标定多个追踪器,从而削弱了 UMI 的便捷性
2)可扩展性有限:尽管带追踪器的 UMI 相比远程操控提高了数据采集效率,但仍然需要针对具体任务的全身示范。这种依赖在本质上仍然是扩大量大而多样的全身协同数据采集的瓶颈
那,能否利用 UMI 的无机器人采集范式,来避免代价高昂的全身示范,从而实现可扩展的在同一时间实现类人机器人全身操控?
- 作者的核心思路是:通过一个共享的末端执行器(EE)轨迹接口,将任务语义学习与全身协调学习解耦
因此,来自1 Zhejiang University; 2 Hong Kong Embodied AI Lab; 3 Mondo Robotics; 4 The Chinese University of Hong Kong 的研究者提出了 Whole-Body UMI(WB-UMI)
这是一种与任务无关、实时的、以 EE 条件为输入的运动生成器,其基于动作捕捉数据(mocap)独立训练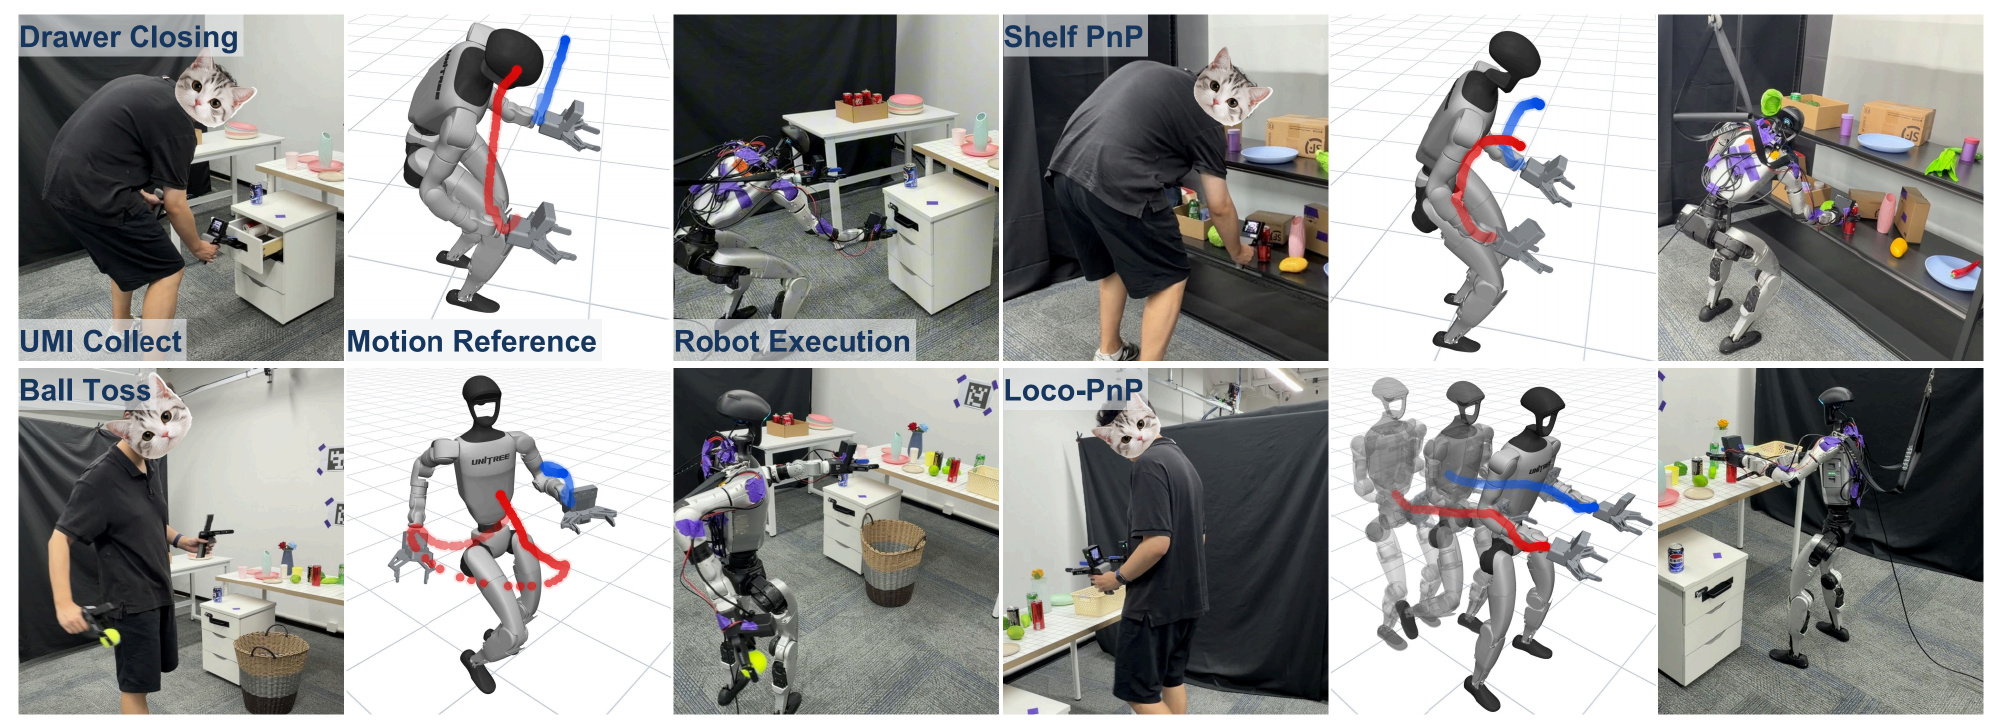
- 在作者的层级结构中(图 2(a))
一个在原生 UMI 示教数据上训练的扩散策略(Diffusion Policy, DP)用于预测EE 轨迹。WB-UMI 将这些轨迹与融合后的全身历史状态结合起来,为一个通用的全身控制器(Whole-Body Controller, WBC)生成显式的全身参考动作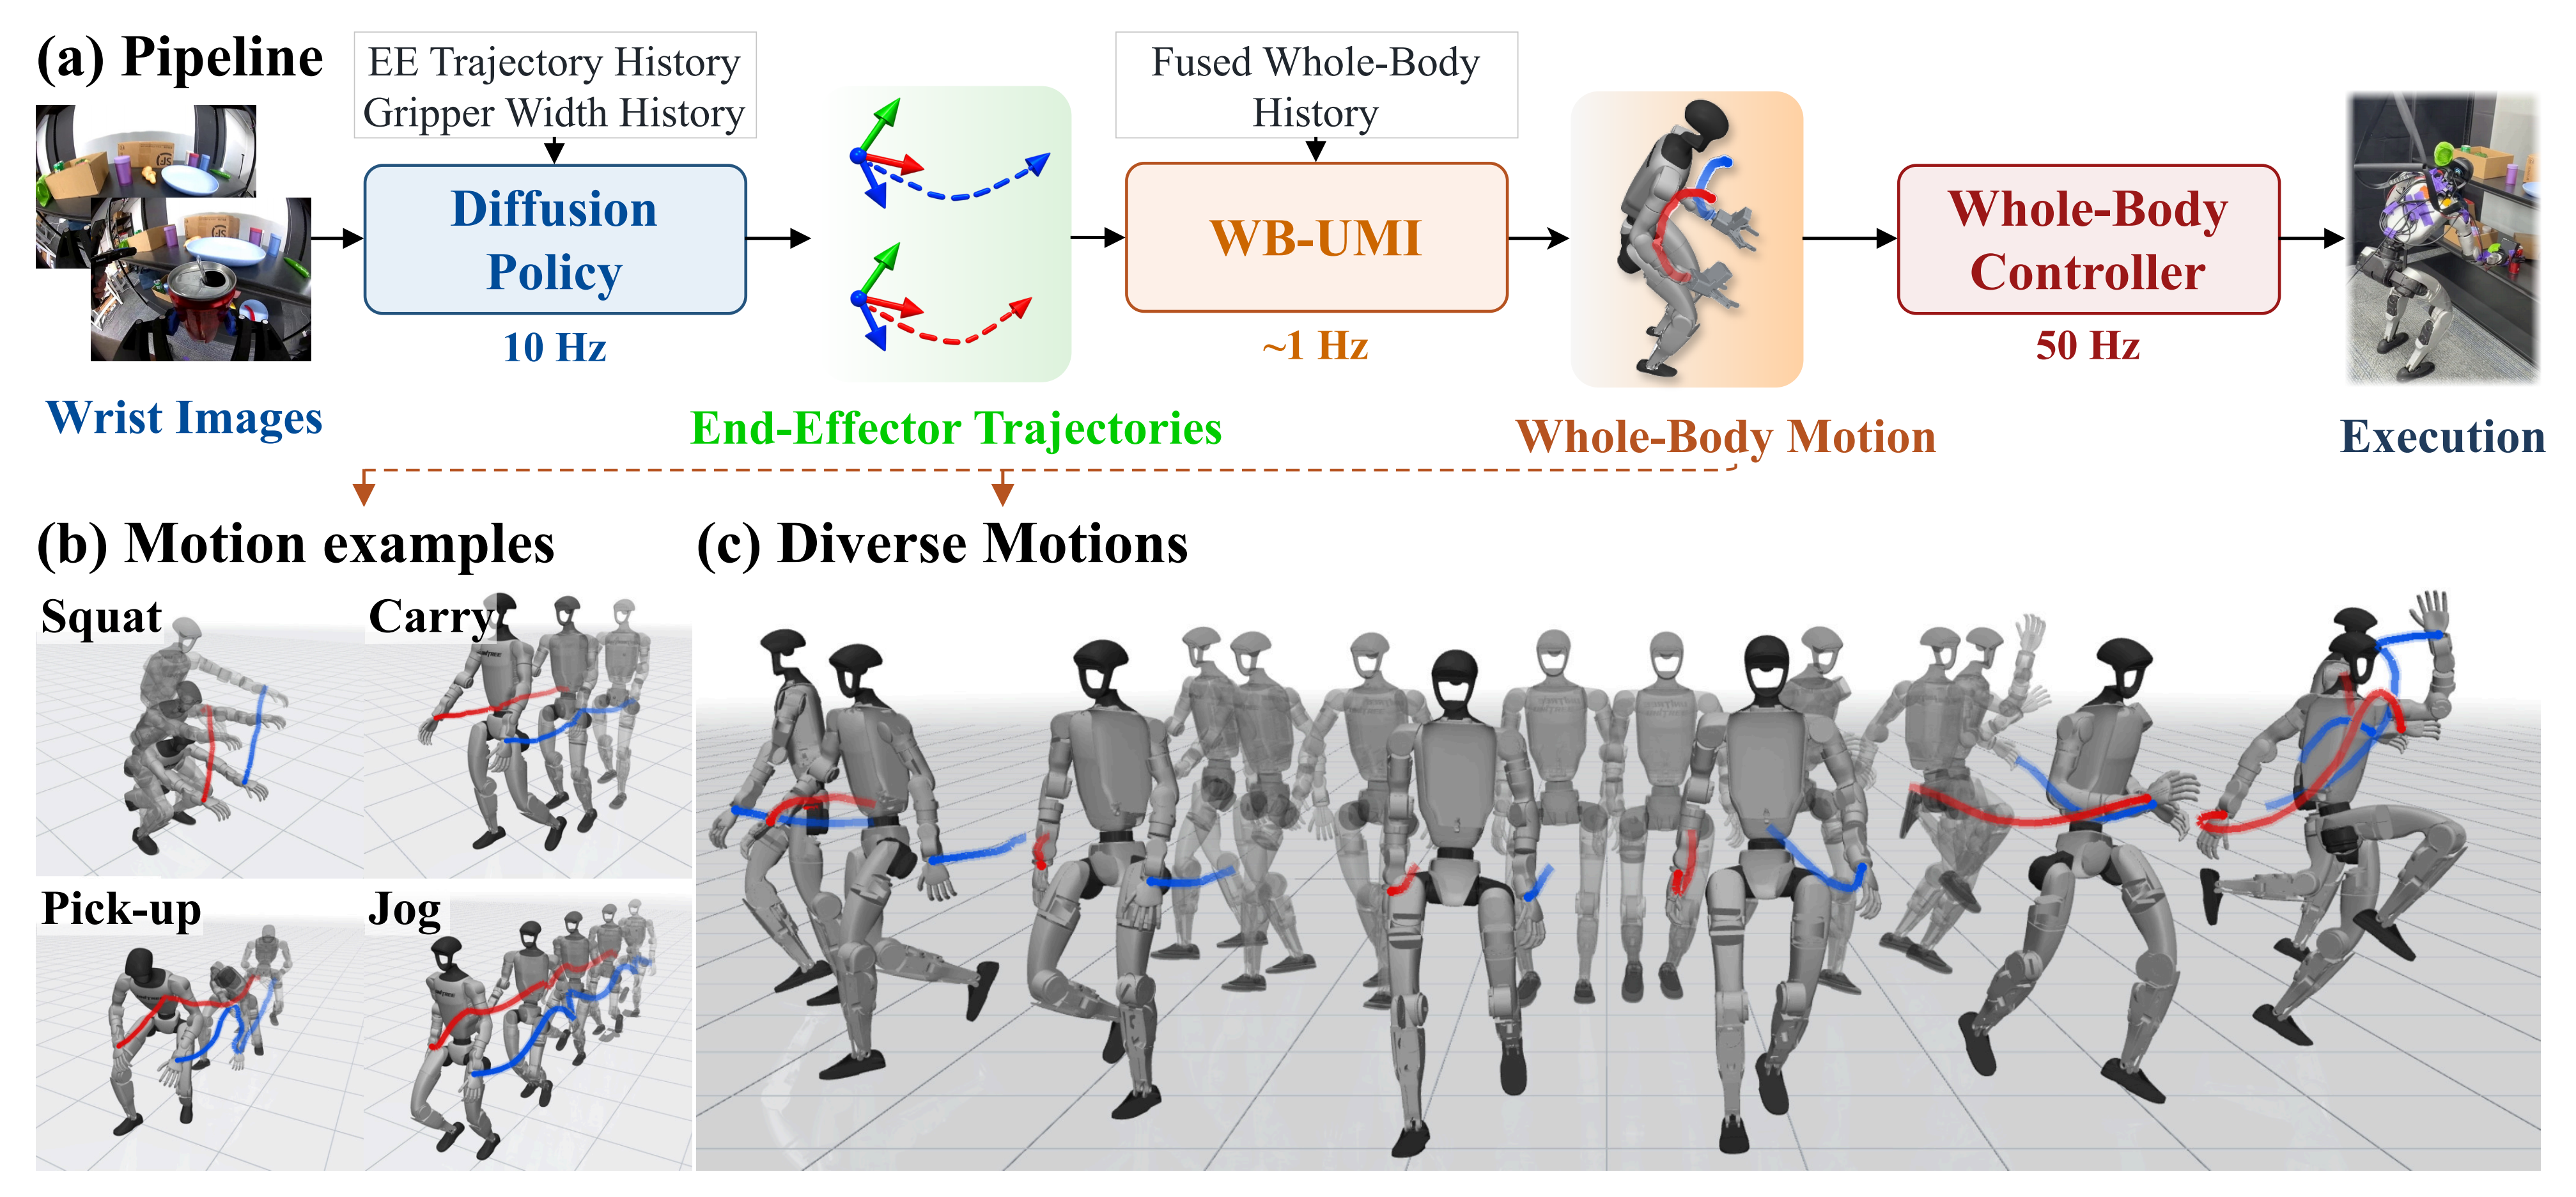
该层级结构将任务语义学习与全身执行相连接,而无需额外采集任务特定的、成对的全身动作数据,并在四项任务上得到验证,实现了实时的闭环执行(图1)
1.1.2 相关工作
首先,对于UMI 与类人全身控制之间的鸿沟
用于人形操作的示范数据集在获取任务语义以及全身协调方式上有所不同。遥操作在人工引导下记录成对的图像—全身协调数据 [4]–[6],从而获得以机器人为原生载体的示范数据
- 然而,采集此类数据既费力又昂贵,并且难以在多样化环境中进行大规模扩展
UMI [1],[7] 则是改为采集腕部安装的图像以及直接利用来自人类示范的末端执行器(EE)轨迹,为应对可扩展性挑战提供了一种前景可观的方法
这种无机器人参与的数据采集范式已经被拓展应用到四足操作臂控制器 [8],以及双臂移动操作机器人[9],从而证明了 UMI 接口的有效性 - 然而,对于高自由度、浮动基的人形机器人 [10],仅依靠 EE 轨迹会使全身运动约束不足。近期的无机器人接口通过在记录 EE 轨迹的同时记录骨盆和足部运动,并随后通过逆运动学(IK)[2]、[3] 将这些稀疏关键点进行重定向,从而弥补了这一空白
这类接口在保持无机器人采集的同时,提供了用于重定向和控制的身体目标
然而,它们的协调数据仍然必须与任务示范一并采集
相比之下,WB-UMI 从已有的动作捕捉数据中学习一个可复用的全身运动先验,从而将全身协调性的学习与基于 UMI 的任务特定示范解耦开来,同时保留了 UMI 原生的仅基于 EE 的采集接口
其次,对于条件化运动生成
- 生成模型从动作捕捉数据中学习可重用的全身运动先验,从而支持多样化的合成以及对新条件的适应[11],[12]
在此基础上,空间控制利用这些先验,使生成的运动能够遵循给定的目标。扩散采样过程中的引导可强制施加全局轨迹或稀疏关节位置约束 [13],[14] - 在此基础上,可控性也被扩展到带有稀疏和稠密关节位置约束的掩码运动模型[15]
直接条件化模型将位置和朝向目标整合进生成过程,从而支持用于运动创作的灵活关键帧与轨迹 [16] - 时间连续性为在线应用带来了一个互补的挑战。自回归生成器根据历史信息合成连续的短时运动片段,以适应不断变化的指令 [17]
更大上下文的模型还会在当前预测窗口之外,条件化到未来目标 [18]。最新的人形系统将语言条件的连续生成与低层跟踪相结合,用于真实机器人执行[19]
对于 UMI 迁移,生成器必须在适应执行误差的同时,跟随预测的末端执行器(EE)位置与姿态轨迹。WB-UMI 结合原生的仅 EE 条件、稀疏前视(look-ahead)上下文以及测量状态反馈,在无需额外未来身体关键点目标的情况下,在线生成显式的全身参考(见表 I)
上表表I 体现了运动生成器能力
EE-only:仅末端执行器(EE),具有独立的世界空间位置/旋转约束,而无需额外的未来身体目标
Real-time:已报告具备交互式实时生成能力
Stream.:可连续生成运动片段
FB:基于测量状态的反馈。*通过推理阶段(inference-time)优化实现空间控制
最后,对于全身控制
- 经典的全身控制(WBC)通常依赖分层二次规划(QP),在运动学和动力学约束下协调多个任务[20], [21]
已经为仿真角色和类人机器人开发了基于强化学习(RL)的运动跟踪器 [22]–[24]
进一步扩展运动数据和策略容量,使得通用型 WBC成为可能,从而能够跟踪未见过的动作,并通过单一策略支持多种指令接口 [25] - 在通用跟踪的同时,行为基础模型通过共享潜在表示来拓展任务规格运动、目标和奖励的表示形式 [26] 以及统一的运动指令接口 [27]
相较之下,WB-UMI 将仅含末端执行器(EE-only)的 UMI 指令转换为针对预训练通用型 WBC 的显式全身参考
1.2 Whole-Body UMI的完整方法论
1.2.0 问题形式化与系统概览
- 假设可以获取原生的 UMI 任务示范、一个独立的重定向动作捕捉(mocap)数据集,以及一个全身控制器,但没有针对具体任务的全身示范
- 给定观测历史
,由腕部 RGB 图像和本体感受测量组成,作者希望获得一个闭环系统,该系统能够实时生成协调一致的全身动作,使类人机器人仅依赖末端执行器层面的任务示范(即没有关于未来其他身体关键点目标的标注),就能完成任务特定的全身操作
如图 2(a) 所示,作者的三层系统结构示意图以及相关组件的说明如下:
- 首先,在原生 UMI 示范数据上训练的DP,会将观测映射为末端执行器(EE)的轨迹以及夹爪开合宽度
- 然后,独立基于动作捕捉(mocap)训练的WB-UMI,将这些 EE 轨迹与融合后的全身历史信息相结合,以生成显式的全身运动学参考
- 最后,预训练的SONIC [25](在此作为全身控制器 WBC)跟踪这些参考以执行动作
控制器的反馈会更新观测与全身历史信息,用于后续的预测
1.2.1 WB-UMI:实时基于EE条件的生成
在给定全身历史信息和 EE(运动事件)未来轨迹的情况下,WB-UMI 能在无需额外未来身体关键点目标的前提下,推断出协调一致的全身运动

- 作者以自回归方式,将长时域的运动生成为一系列短且固定长度的运动基元序列[19],从而能够在 EE 目标不断变化时,实现连续的实时更新。每个运动基元都包含 F 帧未来帧,并以 H 帧历史帧作为条件:
其中,提供与 Sbody 对齐的末端执行器(EE)条件,
,而
提供稀疏的前瞻(look-ahead)上下文
- 然后,作者记
两个基本单元(primitive)构成一个 2F 帧的运动片段
下表表 II 给出了符号定义
图 3 对模型进行了概述
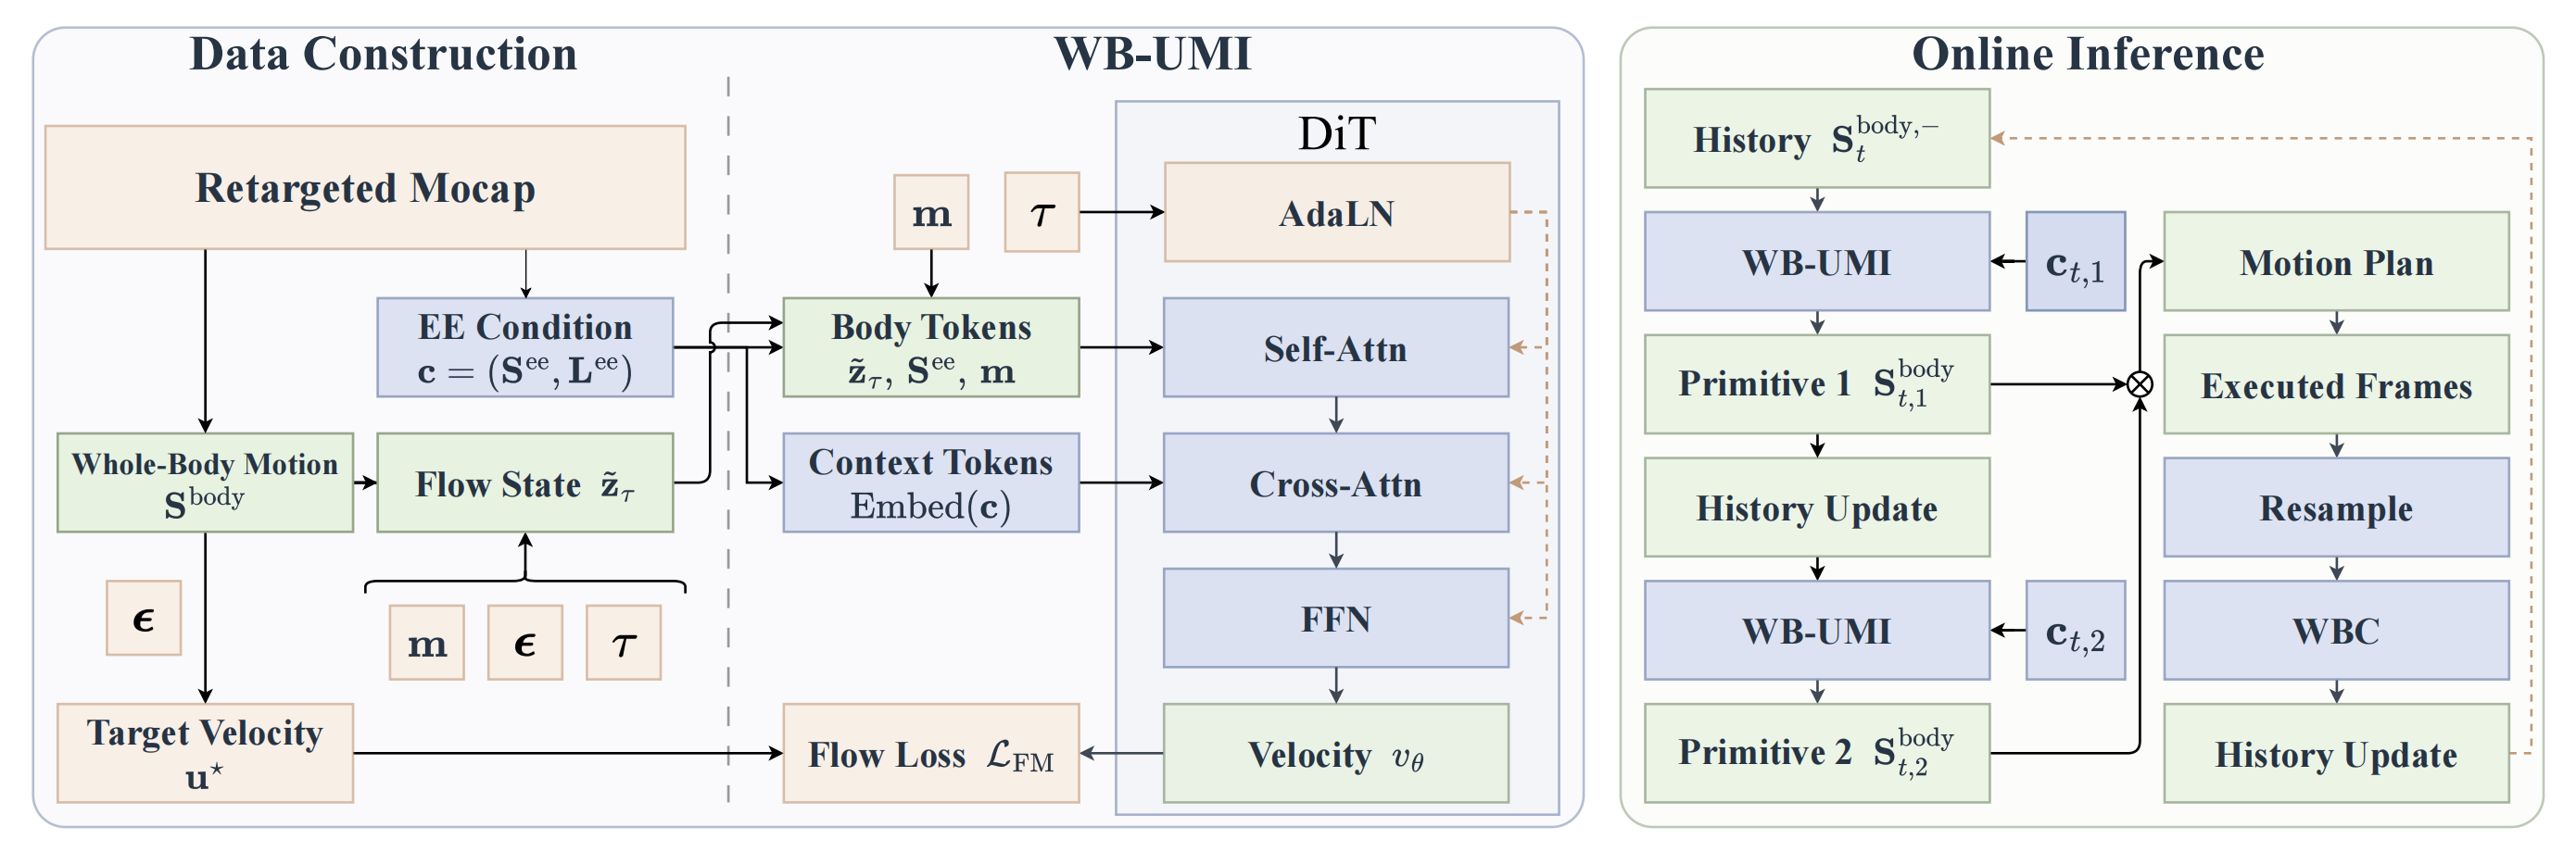
首先,对于数据构建

- 在训练过程中,作者完全基于重定向的G1动作捕捉数据[28]构建配对的全身状态
和末端执行器(EE)条件
,并通过正向运动学(FK)提取末端执行器轨迹
表III总结了这两种表示方法——即全身状态和末端执行器(EE)状态的表示
全身状态
- 初始高度和朝向锚点
两种表示形式都以每个片段的首个历史帧为锚定点。根部平面运动和末端执行器(EE)位移是相对于各自的初始位置来度量的,并通过乘以初始根部偏航角的逆(逆向旋转)进行旋转对齐
EE 的旋转是相对于其初始朝向给出的,而朝向锚点则在初始根部朝向坐标系中表示。这种局部化的表述降低了对全局位置放置的依赖
在推理阶段,DP 提供的末端执行器(EE)轨迹会延伸到当前运动基元之外。与当前生成帧对齐的轨迹片段作为跟踪目标,而较远、可靠性较低的预测则被稀疏采样为前瞻上下文,用于传达运动意图。由此得到的 EE条件为:
其次,对于训练
作者在相邻原语对上使用掩码条件流匹配(maskedconditional flow matching)来训练 WB-UMI。在训练过程中,作者逐步用由第一个原语生成的运动替换第二个原语的真实历史(ground-truth history)

对于每个原语,作者在流时间上使用高斯噪声
构造输入:
其中,历史片段保持不变,而未来片段则在时从纯噪声线性过渡到
时的真实运动。二值掩码 m 用1标记历史帧,用0标记未来帧
条件 DiT vθ 使用两个 EE 条件分支(图 3)来预测光流速度。它将每个身体 token 由 的一帧和时间对齐的 EE 特征
组成。自注意力用于建模这些 token 之间的时间依赖关系,而交叉注意力则提供对完整 EE 上下文 c 的访问
作为辅助监督,作者使用预测的速度来估计无噪的未来:
- 流匹配损失(flow-matching loss)将每个 primitive 的未来速度与目标流速度
进行监督:
其中期望是对训练窗口、流动时间以及噪声取的
对于下面所有的辅助损失,和
表示两个 primitive 的拼接的真实未来序列与干净估计
EE 目标在帧级对齐,几何比较则使用统一的坐标系 - 状态损失(state loss)将重建误差与根部一致性组合在一起:
其中促使根部位置精确且根部运动在内部保持一致
- EE 损失将通过 FK 得到的相对姿态与按帧对齐的目标进行比较:
其中用于惩罚预测
与目标
之间的朝向误差
- 且使用以下方式监督身体姿态、速度和加速度(定义为公式8)
其中给出关节姿态,包括接触时足底的位置,而
和
分别计算身体特征的一阶和二阶帧差分。时间项强调根部运动和基本动作的边界
- 脚支撑由下式监督
其中,是预测得到的足部速度,
表示记录或预测的接触,
是对已记录足部接触标签的预测概率
- 故,最终整个的训练目标为
最后,对于推理

对于每个原始数据,作者固定 和
,将未来片段初始化为 ϵ,并使用
从 τ = 0 到 1 以八个均匀的欧拉步长进行积分。为了生成
,作者采用
的最后 H 帧作为历史信息,并将末端执行器窗口向前推进 F 帧以得到
然后在共享的局部坐标系中重复相同的采样过程
1.2.2 一体化部署系统
图4展示了异步规划与执行的循环
- 为了在机器人运动过程中保持末端执行器(EE)目标不变,作者将每个相对 DP 预测锚定在其源观测对应的手部位姿上:
其中是该观测时刻的手部位姿,
是预测的相对 EE 位姿。WB-UMI 使用这些带锚定的目标以及当前的全身历史信息来生成新的运动参考
- 一旦该参考准备就绪,便会裁剪掉已无法再执行的前缀部分,并将剩余的参考与当前正在执行的运动进行平滑融合:
其中,是在执行时间上将输入参考 q_new 与当前激活参考 q_old 对齐的帧偏移量,混合权重 w_j则从 0 逐渐增加到 1
重新规划每次前进F_planner 帧,第二个基本动作则起到预览作用。在每个规划边界处,控制器反馈会确认当前激活的参考以及回放进度 - 随后,作者更新全身历史,用于下一次 WB-UMI 的生成
其中,和
分别为按时间和坐标对齐的测量历史和参考历史。反馈掩码
选择测量通道(包括关节和底座倾斜),其余位置保留参考值
// 待更

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献128条内容

所有评论(0)