当数据不再是石油,具身智能数据产业的真实困局
2025年到2026年,中国的机器人数据训练场建得比机器人本身还快。中国信通院数据显示,截至2026年6月底,全国已建成启用超过70家训练场,另有46家在建或规划。
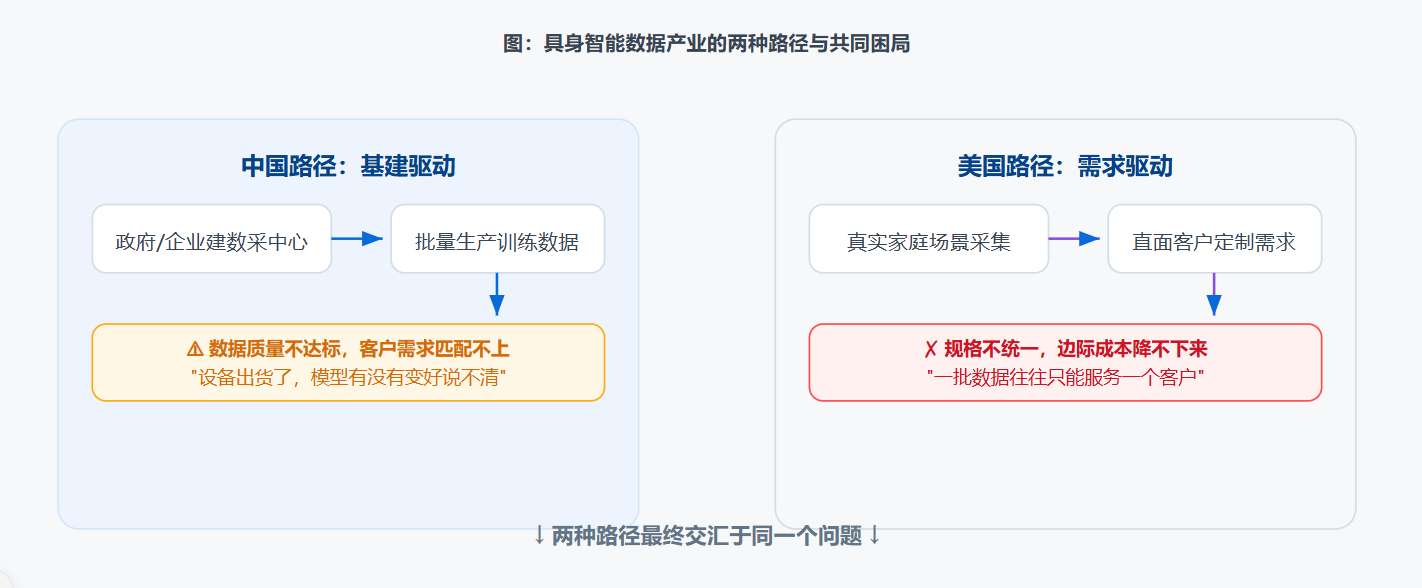
但规模不等于需求。北京首个人形机器人数据训练中心一度停摆,原运营方撤离、百台机器人被清空,接手团队给出的理由很直接:原有数据质量不达标。这不是个别现象。第一财经的调查披露,部分数采项目靠"当地企业买设备、机器人厂商回购数据"形成内循环——设备出货了,项目验收了,但数据到底有没有让模型变好,谁也说不清。
大洋彼岸,一条几乎同时发生的轨迹。成立于2024年的美国创业公司Eidon AI,拿着350万美元种子轮融资,招募采集者进入真实家庭,记录洗衣、清洁、做饭等日常劳动,试图用"真实场景"这个卖点打开机器人数据市场。一年后,公司关闭,1274小时、超过9TB的数据被开源。
两个极端样本:一边是政府驱动的快速建场,一边是VC驱动的需求切入。殊途同归,都没跑通。
机器人明明缺数据,生产数据的公司为什么反而活不下去?
数据这门生意,难在哪里
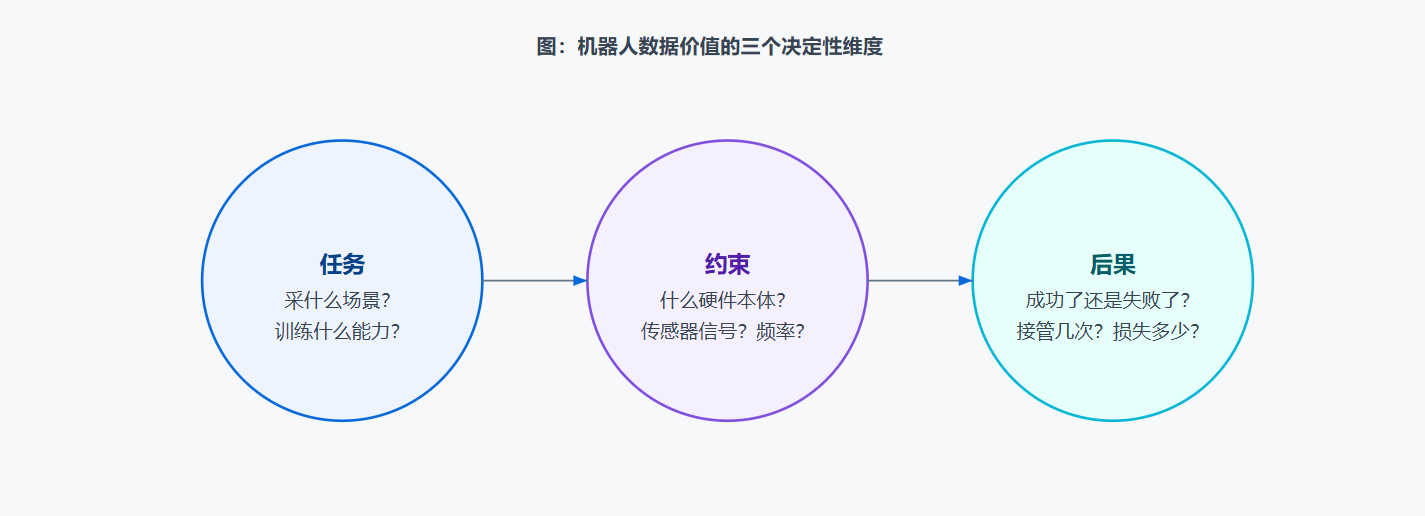
Eidon的联合创始人Sam Padilla在关停复盘里写得坦诚:机器人数据不是均质商品。它的价值取决于任务分布、机器人本体和末端执行器、传感器信号、记录频率、标注方式和使用权限。任何一项发生变化,都可能触发重新采集。
采集时漏掉一类信号,事后没法补。为了适配新客户更换设备,投入会增加,旧数据还可能随之贬值。
窗口期可能只有一到三年。第三方承担重资产和非标成本,一批数据却往往只能服务一个客户,很难像软件产品那样反复销售。规模扩大,边际成本也未必下降。
国内数采中心面临的是同一笔账。作为公共基础设施,它们可以承担预训练、硬件标定和基础动作练习;但要作为独立数据供应商活下去,就必须能回答三个问题:这份数据让哪个模型、在哪项任务上、提升了多少。
"小时数和轨迹条数是产能,任务结果和客户付费才决定价值。数据一旦离开模型和工作结果,就很难单独定价。"
核数聚在服务客户的实践中反复验证了这一点。客户要的不是"多少小时的数据",而是"这批数据能不能让我的模型在特定场景下准确率提升X个百分点"。这就要求数据服务商不能只做采集,必须打通从场景搭建、多维采集、精准标注到质量验证的全链条。
好数据长在任务里
什么样的现场才值得采集数据?
一个场景是否有训练价值,取决于它能提供哪一层的"真实"。第一层是物理真实——光线、摩擦、遮挡,数采中心通过环境模拟可以复现。第二层是任务真实——节拍、良率、连续运行,这需要产线级别的协作。第三层是结果真实——报废、接管、降速和停机,只有真实生产能给出。
数采中心能稳定复刻的,主要是第一层。它可以设计一次抓取失败,却没法复制这次失败对整条生产线的连锁反应,也不会为停线和交付延期承担真金白银的成本。
五个条件,筛出值得进入的现场
1、任务真实
不是为参观、融资或宣传搭出来的演示工位,而是产线上每天都在跑的生产任务。
2、指标明确
成功率、节拍、人工接管次数、停机时间、良率、单次任务成本——至少有一项能持续测量。
3、变化有限且重复
完全固定的任务不需要机器人,完全混乱的环境给不了可比较的反馈。适合学习的是中间地带。
4、失败可控
机器人犯错以后,有人接管;错误能记录下来,成为下一轮训练的材料。工厂天然具备这套纠错链路。
5、能力可复制
一个工位获得的能力,要能迁移到其他工位、厂区或企业的同类任务。否则每换一个客户都要重来一遍,收入增长最终被工程师人数锁死。
具身智能数据不能只停留在"采集了多少小时",而要从一开始就对接客户的真实任务场景。核数聚的具身智能数据解决方案覆盖了从场景搭建、多维采集、精准标注到定制化数据集交付的全链路——客户拿到的不是一堆原始视频,而是一套按任务维度组织的、标注精度达99.5%以上的训练数据包。
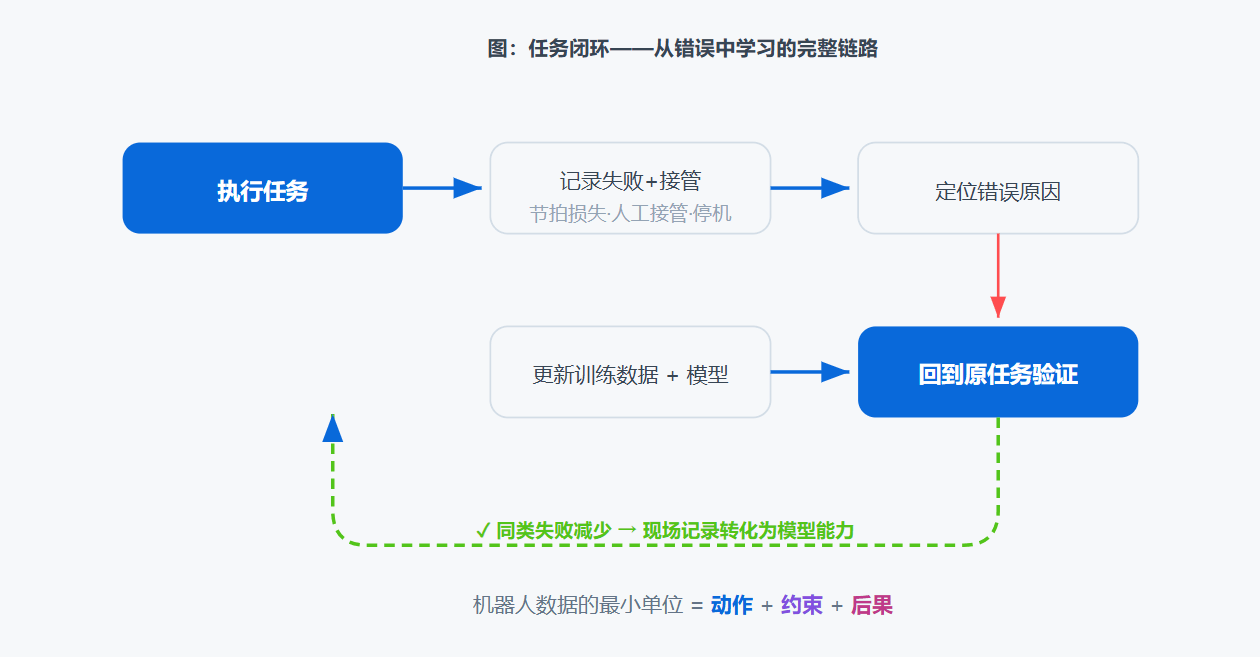
这个闭环也重新定义了什么是"一份合格的训练数据"。摄像头画面、关节角度、末端轨迹,只能说明一个动作怎样完成,却回答不了它在什么约束下行动、造成了什么后果。能支撑交付的训练记录,必须把约束与后果一并写清:任务节拍、允许误差和停机条件是约束;成功率、质量损失、人工接管和故障恢复是后果。
机器人数据的最小单位,因此是动作 + 约束 + 后果。
核数聚怎么做:从卖数据到造"数据底座"
理解了数据价值的三个维度,再来看核数聚的业务逻辑,会发现它走的是一条规避"纯采集公司陷阱"的路径。
核数聚把自己定位为"AI数据资源与服务提供商",不做单一的采集生意,而是围绕数据采集、智能标注、模型服务三大核心平台,覆盖具身智能、智能驾驶、语音语言和大模型四个领域。
全链条,而不是单环节
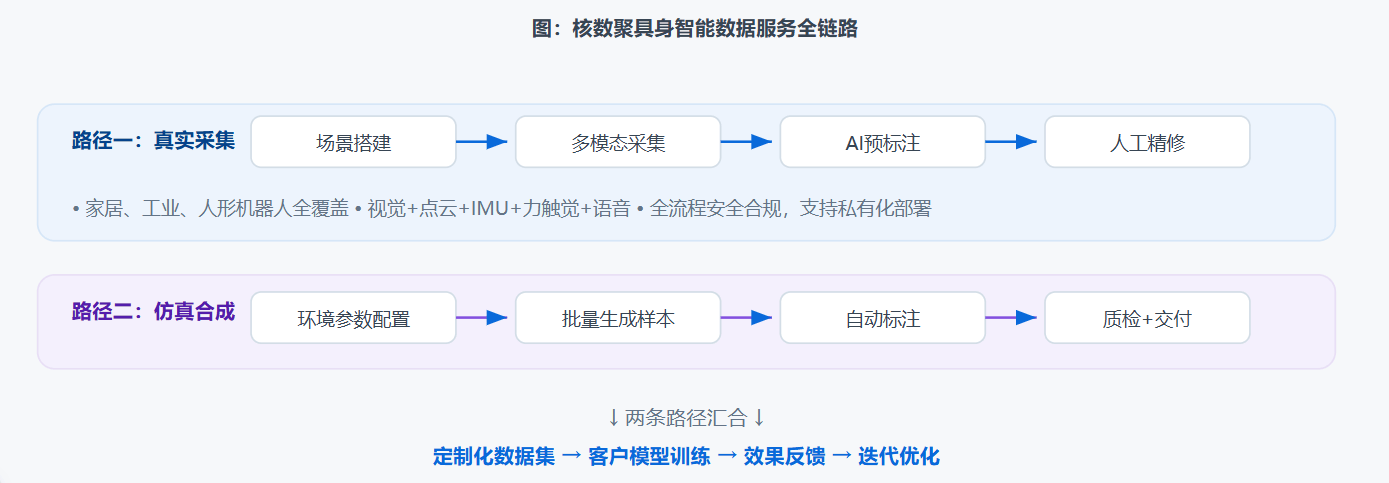
纯采集商最怕的"客户用完就走"问题,核数聚用全链条服务来对冲。从场景搭建、多维数据采集、AI预标注+人工精修、质量管控到定制化数据集交付,客户拿到的是一套完整的训练数据包,而不是一堆需要自行处理的原始素材。
关键差异:从"真实场景采集"到"仿真+真实"双路径
核数聚在具身智能数据上的一个核心策略是"真实场景采集+仿真场景合成"双路径。真实采集解决"物理真实"——光线、摩擦、遮挡;仿真合成解决"任务多样"——用可控环境批量生成不同光照、不同布局、不同物体组合的训练样本。
这条路直接回应了前面提到的核心难题:单靠真实采集,成本和交付速度打不过客户自建团队;单靠仿真,又搞不定物理层面的细节噪声。双路径结合,让核数聚既能保证数据质量,又能在规模交付上保持弹性。
质控不只是"多查几遍"
标注精度99.5%这个数字背后,是一套全链路质控体系:从标注规范的细粒度定义、过程管控的实时抽检,到多级质检的交叉验证。核数聚的质控逻辑和任务闭环的底层逻辑一致——只有把质量信息反馈回模型训练,标注才不只是"画框",而是在帮机器人学会干活。
标注规范制定 → 标注员培训 → AI预标注辅助 → 人工精修 → 初审质检 → 交叉复审 → 终审抽检 → 质量报告 + 模型训练反馈。每一个环节出错,都有明确的归因路径和修正流程,而不是简单的"返工"。
活下来的逻辑:不要只卖数据,要帮机器人学会工作
回到最初那个问题:机器人明明缺数据,生产数据的公司为什么反而活不下去?
答案不在于"该不该做数据生意",而在于"怎么做"。纯粹的采集生意注定脆弱,因为数据的价值不由采集量定义,而由它所驱动的任务结果定义。Eidon的关闭和北京数采中心的停摆,本质上是同一类失败:数据脱离了任务反馈,就成了没有定价锚点的商品。
数采中心可以教会机器人动作,任务闭环才能教会它工作。但这场仗还有后半程:如果现场经验沉淀不成可复用的能力,机器人也许学会了干活,机器人公司仍然没办法赚钱。
优必选创始人周剑把标准定得更直白:只有找到合适的应用场景、让人形机器人真正发挥作用、客户愿意买单,才算实现量产闭环。
按这个标准,闭环是否成立需要两份答卷:
A:客户侧的改善
工厂的成功率、节拍、良率和任务成本有没有变好?没有改善,项目只是演示。
B:供给侧的沉淀
机器人企业有没有积累出可复用的技能和交付工具?没有沉淀,做的仍是一次性集成生意。
这正是核数聚试图走通的路。不满足于做"数据搬运工",而是通过全链条服务、双路径采集、全模态覆盖和体系化质控,把自己嵌入客户的训练迭代循环。客户每跑一圈训练闭环,核数聚就跟着产出一轮高质量数据——交付的不只是一个数据集,而是一个可持续运转的数据底座。
"数据不再是地里挖出来的石油,用完就没了。真正值钱的数据,是长在任务里的庄稼——种下去,收回来,还能再种。"
2026年,具身智能数据产业走到了一个分水岭。快速建起来的产能正在被市场筛选,能不能跑通"数据—模型—任务"这个三角,将决定谁留下来,谁成为下一家Eidon。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献25条内容

所有评论(0)