具身智能的数据困局:为什么说数据闭环才是机器人落地的分水岭
最近跟几个做具身智能的团队聊天,发现焦虑的点出奇地一致——不是算法不够好,不是硬件跟不上,而是数据到底怎么搞。
你去看 Google DeepMind 的 RT-2,它混合了网页和机器人数据;Open X-Embodiment 跨了22种机器人本体复用轨迹;NVIDIA 的 GR00T 路线图里塞进了互联网视频、遥操作和仿真合成;Physical Intelligence 的 RECAP 则把自主执行、任务结果和人工纠正一起接回训练。每家的配方看着都不一样——但剥掉数据规模和模型差异,它们底层共享同一个逻辑:让策略先在真实机器人上跑起来,让执行留下可判断的结果,让反馈推动下一轮更新,再部署回去。
听起来简单,做起来全是坑。这篇文章不聊高大上的概念,就掰扯一个朴素的问题
要让机器人真正学会干活,数据闭环最少需要接通哪些环节?而在这个链条上,一家靠谱的数据服务商到底能帮你省掉多少弯路?
一、冷启动:第一个动作从哪里来?
多团队做机器人,第一反应就是"先搞数据"。但容易被忽略的问题是——你采集的数据里,到底有没有"可执行的动作"?
这里说的不是"把杯子放进抽屉"这种语义层面的理解,而是更底层的东西:机械臂关节要转多少度?夹爪什么时候闭合?碰到意料之外的阻力怎么办?摄像头看到的画面和关节状态之间,差了哪些中间步骤?
这些问题,光靠看人类操作的视频是答不上来的。你需要的是观测、动作、时序和执行结果连在一起的完整轨迹。
目前行业里最直接的做法是遥操作——操作者戴 VR 手柄或通过主从机械臂实时控制机器人完成任务,系统沿途记录相机画面、关节或末端状态、控制指令和任务结果。Google 的 DROID 项目就是用这个思路,在564个场景里用统一硬件采了7.6万条演示轨迹。这不是"机器人动过的视频",而是目标本体的"观测—动作—结果"配对轨迹。
当然,遥操作成本高、对人力和硬件要求也高,不是所有团队都玩得起。UMI(Universal Manipulation Interface)就另辟蹊径——让人类手持带相机的夹爪直接操作,不经过机器人,再通过算法把人和机器人的动作差异对齐。看起来很美,但这里有个绕不过去的现实:最终训练出来的策略,还是得回到真机上验收。逆运动学能不能解?末端轨迹物理上能不能执行?仿真里完美的路径,到了真实摩擦和时延面前会不会崩溃?这些都得真机说了算。
真机采集的门槛比很多人想的高得多——硬件、场地、人员、合规,缺一个都跑不动。核数聚在苏州、青岛、芜湖、慈溪自建了具身训练场,采用"真实场景采集+仿真场景合成"双路径,已经入驻了宇树、智元、魔法原子、鹿明、科沃斯等头部具身企业。150多名专职采集人员常年驻场,把"去哪采、谁来采、怎么采"这套苦活累活标准化了。不管是遥操作、UMI还是Ego视角采集,团队不需要从零搭建基础设施。
二、部署之后:一次执行必须留下能判断的结果
冷启动把模型送上了机器人,你以为最难的部分过去了?其实真正的麻烦才刚开始。
当机器人进入试点场景,数据才第一次变得比演示更贴近问题本身。因为这时候它会暴露训练集里从来没出现过的失败:夹爪偏了几厘米,金属反光让视觉失效,动作延迟导致接触时机错过,或者机器人明明完成了动作,却没有拿到任务结果。
这时候只保存成功视频,数据飞轮等于空转。
真正可用的部署记录,至少要回答三个问题:
第一,任务到底完成了没有?第二,如果没完成,在哪一步出了问题?第三,人有没有接管或纠正?
Physical Intelligence 的 RECAP 在这个方向上走得很具体:它先用一个通用 VLA 模型做起点,在机器人上收集自主 rollout、任务结果和在线人工纠正,然后把这些新数据接回训练。这恰恰说明了一个容易被误解的事实:自主经验、结果反馈和人类介入,在复杂真实任务里是可以同时成为训练信号的。不是"AI 终于可以无人值守自学一切",而是"人在关键时刻介入的那一下,恰好是最值钱的数据"。
这也解释了遥操作通道的第二种用途。冷启动阶段,它用来采集完整的真机示范;部署之后,它帮操作者在策略刚要翻车的时候接管,同时把"原来这里应该这么修正"的高价值样本留下来。从人工遥控到完全无人,不是拨一个开关,而是一段逐步缩小接管范围、同步积累异常处理经验的过程。
三、失败必须有去处:从日志到能力的最后一公里
很多团队把"数据回流"理解成把日志上传到数据湖就完事了。但实际上,日志回到数据湖,不等于它回到了能力里。
一条失败要能推动下一轮改进,首先得搞清楚它属于哪一类问题:是目标物体或场景根本没覆盖?还是相机、动作、坐标之间的对齐出了问题?是策略不理解任务?还是控制器在接触瞬间来不及修正?或者压根是仿真里的物理参数写错了?不同答案对应完全不同的去处——补数据、重训策略、修控制器、改场景,或者把这次失败固定成下一轮的回归测试。
举个例子:机器人因为金属杯面反光抓偏了。团队不能只把失败视频丢回训练集了事。它需要保留当时的相机画面、动作序列和策略版本,确认是视觉定位的问题还是控制执行的问题,然后补充对应的训练样本,再把同类反光场景加到回归测试里。新版本只有在这些测试上通过了,才能重新上线部署。这时候,一次失败才算完整走完了飞轮。
这一步看起来不如"又采了多少小时数据"好宣传,但它才是飞轮有没有抓地力的关键。没有版本、任务条件和结果标签,失败只是一段录像;有了它们,失败才会变成下一次训练必须跨过去的门槛。
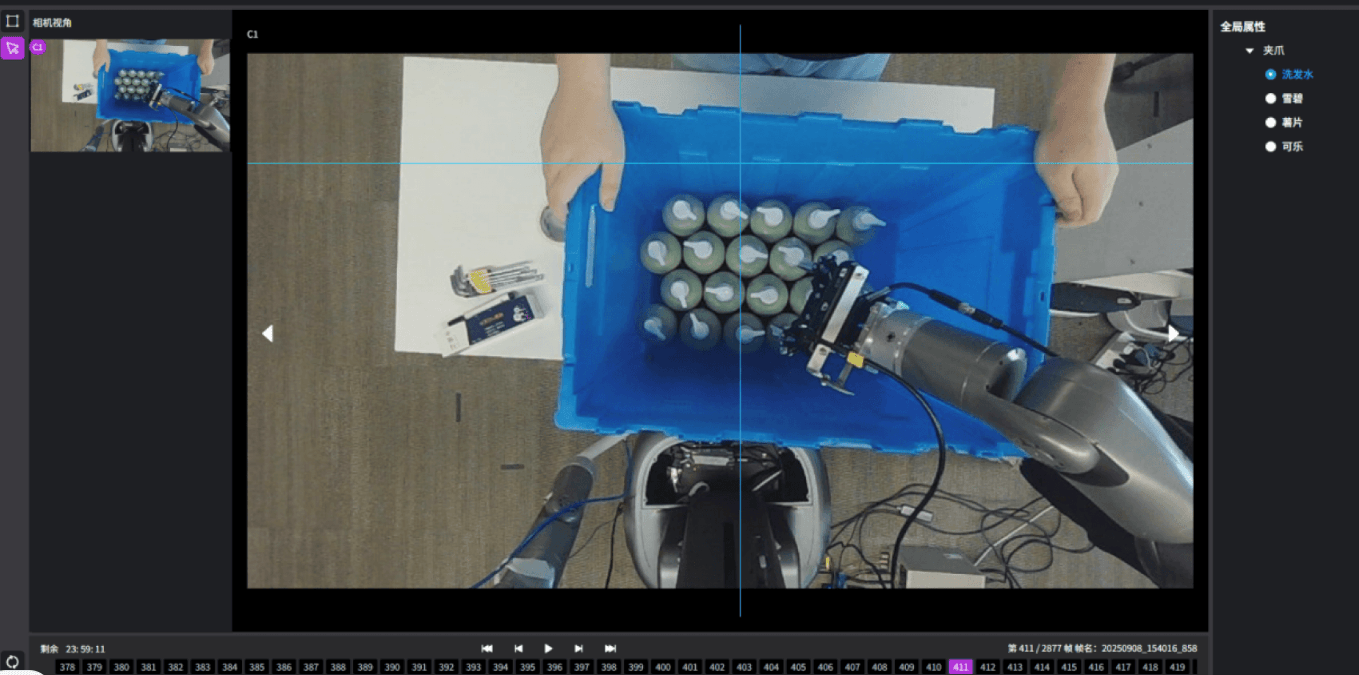
高质量标注不只是"画框"。具身智能需要的标注覆盖2D图像、3D点云、视频时序、物体交互关系,甚至力触觉数据。核数聚采用 AI 预标注+人工精标的人机协同模式,全链路质量控制体系保证标注精度达到99.5%以上。更重要的是,他们理解不同任务(分拣、上料、质检)对标注的侧重点完全不同——2D辨视觉、视频追动作、3D定空间,数据标注要能直接匹配机械臂的夹爪等核心部件,才能真正降低算法落地的成本。
四、闭环加速器:人类视频、跨本体和仿真该放在什么位置?
最小闭环能转,不等于机器人已经通用了。同一台机器人在同一张桌子上反复做同一件事,不会自动长出泛化能力。
这个行业里,人类视频(Ego/Exo)、跨本体数据和仿真经常被当成"数据来源越多越好"的注解,但它们的真正角色更像是闭环加速器——它们可以从冷启动阶段就参与,也可以在部署暴露缺口后再补充。它们不是闭环能闭合的必要条件,但会影响覆盖面、扩展速度和采集成本。
Open X-Embodiment 把21家机构、22种机器人的数据合在一起用,报告了跨本体的正迁移——不同身体的经验确实能互相帮忙。但它也提醒我们,跨本体不是把数据倒进同一个桶就行,动作空间、观察视角、任务分布的差异必须被统一处理。
第一视角(Ego)人类视频的价值也类似。它能扩展物体和场景的覆盖范围,但到底能不能提供动作监督,取决于你是否额外恢复了手部或物体轨迹、坐标和时序。EgoMimic 的论文里明确说,加上人类数据后,机器人对新物体和新场景的泛化确实变好了——但这条路是"人类数据补广度、机器人数据做物理锚点",不是取消真机数据的宣言。
仿真就更不用说。它能批量制造"还没见过"的情况,补充难以重复的初始条件和危险工况。但它没法替你证明,目标机器人在真实接触、时延和噪声下也能完成任务。
核数聚的做法是"真实场景采集+仿真场景合成"双路径并行。真实采集解决物理锚点的问题——摩擦、时延、力反馈,这些仿真模拟不出来的东西;仿真则负责放大规模、覆盖长尾。
两者不是替代关系,是互补关系。
同时,核数聚的多模态采集能力覆盖了视觉、点云、IMU、力触觉、语音等多种数据类型,这意味着客户不需要为不同类型的数据分别找不同供应商——数据格式、标注规范、质量标准可以在一个体系里统一。
五、手感的差距:为什么数据服务"工业化"比想象中难
聊完理论,说点实在的。
具身智能这个赛道这两年热得发烫,做数据服务的公司也冒出来不少。但真正把具身数据服务做到"工业化交付"级别的,说实话并不多。
难点在哪?具身智能的数据需求跟传统 CV 和 NLP 完全不是一个量级。你得懂机器人运动学,你得理解不同采集方式(遥操作、UMI、Ego)的技术差异和适用场景,你得有真实的物理场地和设备,你还得有一套能同时处理2D图像、3D点云、视频时序和交互关系标注的多模态流水线。更重要的是,你得在几百人的团队规模下保持标注精度的一致性——这不是招几个标注员就能解决的问题。
核数聚在这行干了15年多,客户名单里放着乐聚、鹿明、智元、简智、它石、Momenta、博世、思必驰这些名字。苏州训练场现在常驻150多名专职采集人员,项目周期常年滚动,累计交付数据量超过40TB+。这些数字背后是一整套从需求确认、实地采集、筛选脱敏到规整质检交付的标准化流程——说起来不性感,但恰恰是行业最缺的基础能力。
六、资源不是堆出来的,是串起来的
回到开头那个问题:一个最小可运行的具身数据闭环到底需要什么?
答案不是一份固定数据清单,而是环节真正接通:
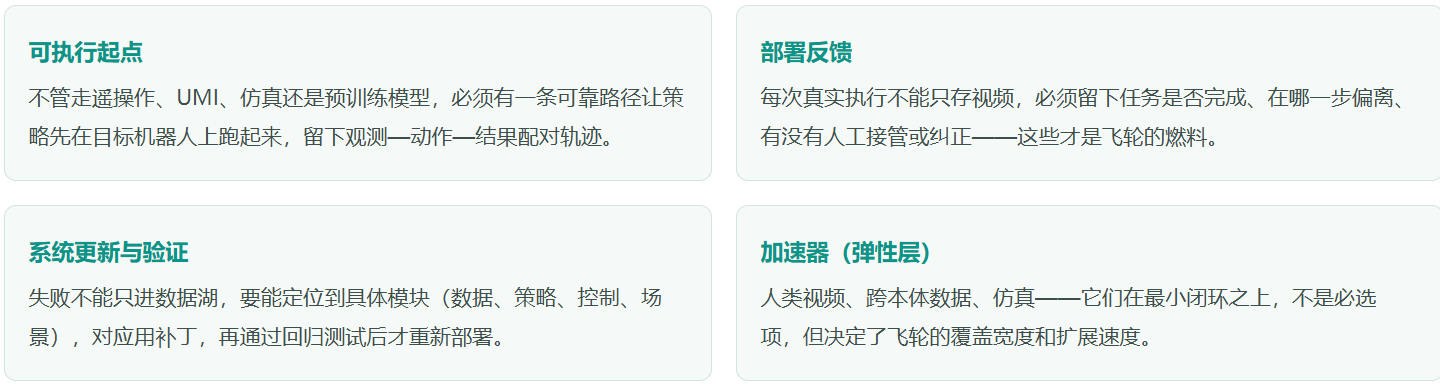
行业头部玩家的公开路线已经说明,并不存在统一的训练配方。但不管配方怎么变,让每一次执行都留下足以改变下一版系统的证据——这件事没有捷径。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献27条内容

所有评论(0)