梳理MDP、Bellman 方程、RL、PPO之间的关系
1907年,俄国数学家马尔可夫Markov提出了“序贯决策”问题,1957 年,由 Richard Bellman 正式建立了 MDP 的数学模型框架,并以 Markov 命名。MDP是对“序贯决策”问题的数学描述,其形式为:
五元组 M=⟨S,A,P,R,γ⟩
S:状态集合
A:动作集合
P(s′∣s,a):状态转移概率
R(s,a):奖励函数
γ:折扣因子
五元组完整刻画了“环境与智能体交互的规则”,并假设未来只依赖当前状态这一概念,但本身不包含任何“怎么算”的信息。MDP 像一张地图:标出了所有城市(状态)、道路(状态)、过路费(奖励)。
有了地图就需要研究怎么走最好,1960 年,Richard Bellman 提出 Bellman 方程,作为求解 MDP 问题的具体方法,它用MDP的五元组构建了一个递归方程,以此定义了价值函数。其核心思想为:一个状态的价值 = 即时奖励 + 折扣后的未来价值。Bellman 方程像一条导航规则:“到目的地的总成本 = 本段路费 + 从下一站出发的最优成本”。其数学形式为:Vπ(s)=Ea∼π,s′∼P[R(s,a)+γVπ(s′)]
有了地图(MDP)、有了导航规则(Bellman 方程),接下来的目标是找最优路线(最优策略π∗) ,这等价于求解 Bellman 最优性方程:
V∗(s)=amax[R(s,a)+γs′∑P(s′∣s,a)V∗(s′)]
如何在 MDP 框架下求解 Bellman 方程的最优解,科学家提出了不同的策略。1989年 Sutton 提出时序差分学习(TD Learning),1989年 Watkins 提出 Q-learning,1992年 Williams 提出 REINFORCE,自此RL正式成为一个独立领域。
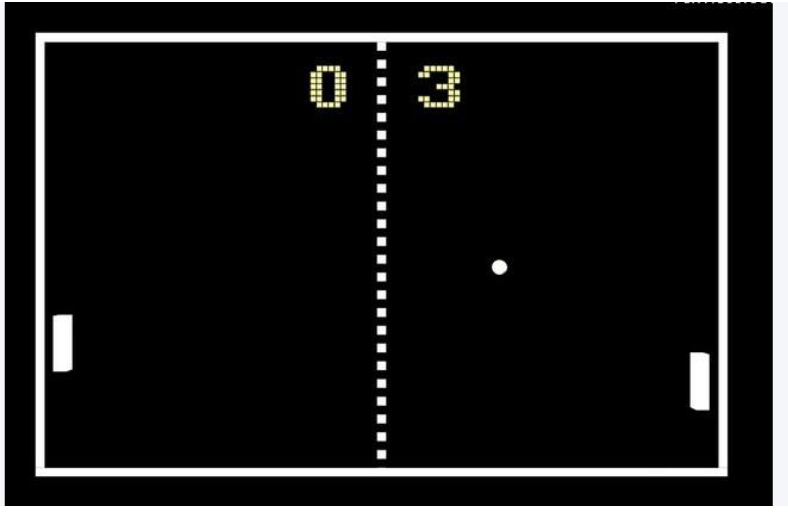
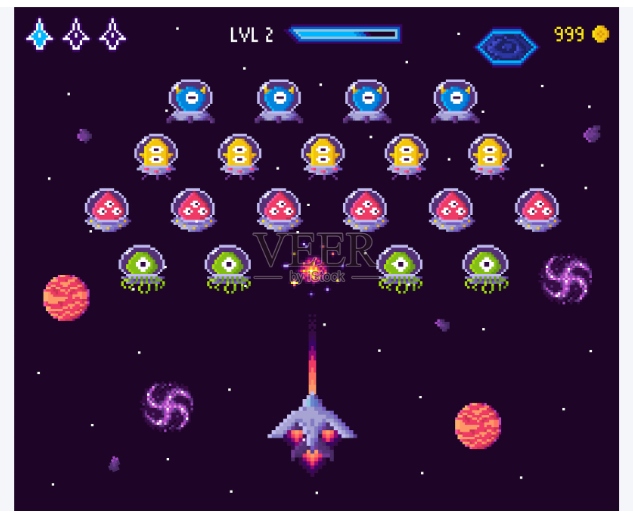
2017 年OpenAI 的 Schulman 等人提出PPO(论文 Proximal Policy Optimization Algorithms)。它属于深度强化学习(DRL)的方法,是策略梯度(Policy Gradient)方法大家族中的一员。PPO一开始试验用于玩Atari 游戏(离散动作,视觉输入),比如《Pong》
《Asteroids》
PPO之后用于机器人的训练(连续动作控制),训练出的人形机器人在模拟环境中学会了奔跑、跳跃。
在 PPO 之前,离散和连续任务通常要用不同算法,PPO 用同一套框架两边都做到了有竞争力的水平,被广泛应用在机器人领域。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)