《VLA系列》Evo-Depth 技术解析与复现指南:用隐式深度增强轻量 VLA
Evo-Depth 技术解析与复现指南:用隐式深度增强轻量 VLA
论文地址:Evo-Depth: A Lightweight Depth-Enhanced Vision-Language-Action Model(NeurIPS 2026)
开源地址:https://github.com/MINT-SJTU/Evo-Depth
核心要点:空间对齐、多视角隐式 深度特征
摘要
Vision-Language-Action(VLA)模型可以根据图像和自然语言生成机器人动作,但纯 RGB 的二维表征在抓取、对齐、放置等空间敏感任务中常常不够可靠。Evo-Depth 的思路是:不引入深度相机、点云或重型几何模型,而是从多视角 RGB 中抽取紧凑的隐式深度特征,再通过轻量的 FiLM 调制注入视觉语言表征,最终由 Flow Matching 动作专家生成连续动作块。
这套设计由三部分组成:
- IDEM:以 Depth Anything 3(DA3)的多视角特征作为隐式深度表征;
- SEM:将深度特征变成逐通道的缩放与偏移参数,以 FiLM 方式增强视觉语言特征;
- PAT:用三阶段渐进对齐训练,依次对齐动作、空间与全模型。
论文报告模型仅约 0.9B 参数,在 MetaWorld、VLA-Arena、LIBERO、LIBERO-Plus 上取得较强表现;真实机器人实验报告 3.2 GB 显存、12.3 Hz 推理频率及 90% 平均成功率。本文结合仓库代码,说明其算法逻辑、源码落点和复现路径。
1. 要解决的问题
传统 VLA 的输入通常是 RGB 图像、语言指令与机器人状态。其困难在于 RGB 虽能识别“是什么”,却不总能稳定判断“在哪里、相距多远、是否对齐”。这会直接影响以下场景:
- 精确抓取:末端与物体的距离、姿态和遮挡关系;
- 精细放置/堆叠:目标容器、杯口或插槽的相对位置;
- 多视角一致性:固定相机与腕部相机提供的信息需要统一;
- 扰动泛化:相机位置、物体布局、背景和光照变化。
现有路径各有代价:
| 路径 | 优点 | 局限 |
|---|---|---|
| 纯 2D VLA | 简单、高效 | 空间关系弱 |
| 显式深度/点云 | 几何信息直接 | 需额外传感器,受噪声、标定和重建影响 |
| 重型隐式几何模型 | 无需额外传感器 | 训练和部署成本较高 |
| Evo-Depth | RGB-only,空间增强,轻量部署 | 仍依赖多视角质量,强接触/严重遮挡仍具挑战 |
核心定位: Evo-Depth 并不试图在控制阶段显式重建完整三维场景,而是学习对动作决策有用的“隐式空间线索”。
2. 整体框架
给定时刻 t t t 的多视角图像 { I t i } i = 1 N \{I_t^i\}_{i=1}^{N} {Iti}i=1N、语言指令 L t L_t Lt 和机器人状态 s t s_t st,模型预测未来动作块 A t A_t At:
A t = f Evo-Depth ( { I t i } , L t , s t ; θ ) A_t=f_{\text{Evo-Depth}}(\{I_t^i\}, L_t, s_t; \theta) At=fEvo-Depth({Iti},Lt,st;θ)
论文原始架构图
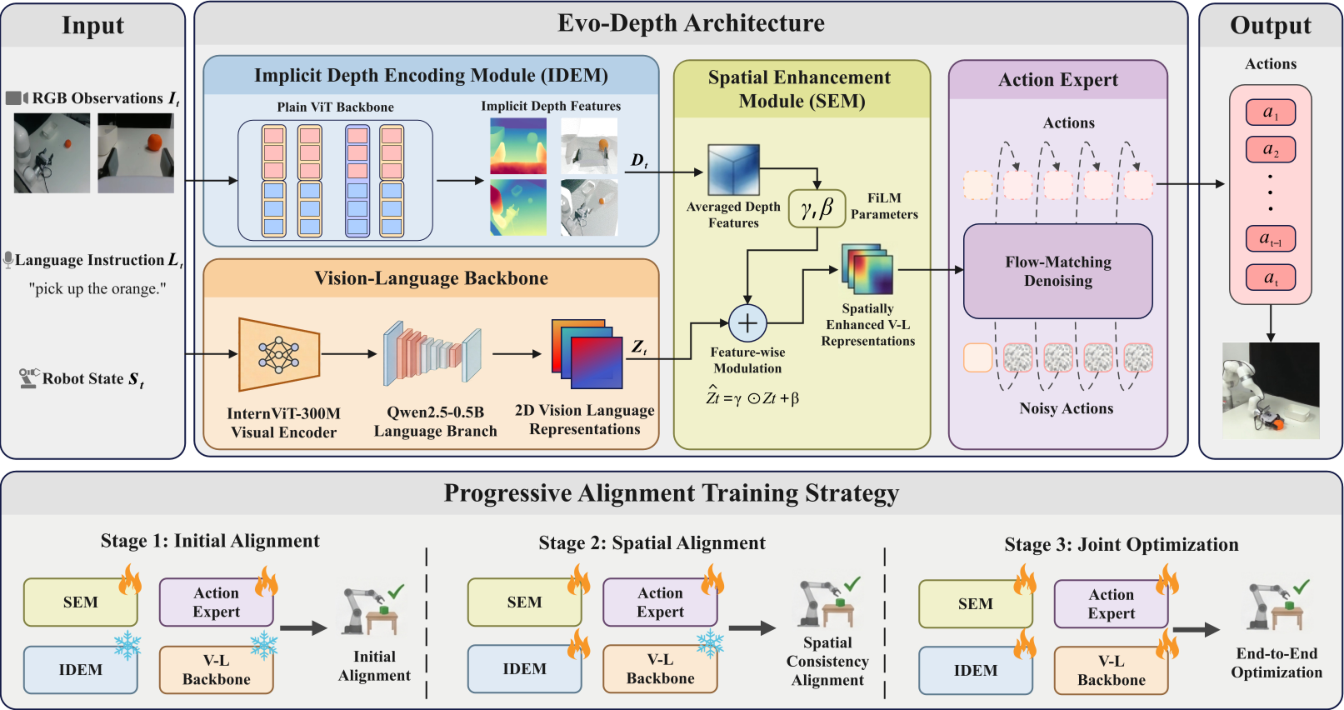
图源:论文 Figure 2,Evo-Depth Overall Architecture。该图同时展示 IDEM、视觉语言骨干、SEM、Flow-Matching Action Expert,以及三阶段 Progressive Alignment Training。
2.1 思维导图
2.2 模块与源码索引
| 模块 | 作用 | 核心源码 |
|---|---|---|
| 顶层策略 | 串联 VLM、深度分支和动作头 | Evo_depth/scripts/Evo_depth.py |
| IDEM + SEM | DA3 特征、投影和 FiLM 融合 | Evo_depth/model/internvl3/internvl3_embedder_da3.py |
| DA3 封装 | 提取多视角 DPT embedding | Evo_depth/model/depth_anything_3/depth_anything_v3.py |
| 动作专家 | Flow Matching Transformer | Evo_depth/model/action_head/flow_matching.py |
| 训练循环 | 损失、优化器、保存/恢复 | Evo_depth/scripts/train.py |
| 数据集 | LeRobot 读取、归一化、padding/mask | Evo_depth/dataset/lerobot_dataset_pretrain_mp.py |
| 部署服务 | checkpoint 加载、推理、WebSocket | Evo_depth/scripts/Evo_depth_server.py |
3. IDEM:从 RGB 提取隐式深度
论文中的 Implicit Depth Encoding Module(IDEM)从多视角图像中得到深度感知表示:
D t = f IDEM ( { I t i } ) D_t=f_{\text{IDEM}}(\{I_t^i\}) Dt=fIDEM({Iti})
论文使用一个约 0.13B 参数的 ViT,并从任意视角深度预训练模型初始化。其思想是前段以视角内注意力保持局部结构,后段逐渐引入跨视角信息交换,使 token 学到物体布局、相对关系和跨视角一致性。
工程实现细节
DAV3Module加载depth-anything/da3-base。- 调用 DA3 内部的
_get_dpt_embeddings,取的是 latent DPT embedding,不是导出的深度图。 image_mask指定真实视角;无效的 padding 图像不参与深度特征聚合。- 因而“深度”是服务于动作的隐式表征,而不是一个需要可视化或标定的米制深度输出。
重点: 这正是 Evo-Depth 对部署友好的原因。它复用 RGB 输入和预训练空间先验,而不改变机器人侧的传感器协议。
4. VLM 与 SEM:把空间线索注入语义表征
4.1 视觉语言骨干
工程采用 OpenGVLab/InternVL3-1B:视觉部分编码每个视角,文本和图像 token 共同送入语言模型。实现中仅保留语言模型前 14 层,并将 lm_head 变为恒等映射。
这样得到的不是文本生成 logits,而是适合控制的隐藏表征:
Z t = f VLM ( { I t i } , L t ) Z_t=f_{\text{VLM}}(\{I_t^i\},L_t) Zt=fVLM({Iti},Lt)
图像会先缩放到
448
×
448
448\times448
448×448。输入提示词被组织为多个 Image-i: <image> 段,再拼接任务语言;对应的图像 token 会被视觉 embedding 替换。训练中一般保留 token 序列,推理可按配置返回 CLS 表征。
4.2 SEM:FiLM 而非重融合
直接拼接深度 token 会扩大上下文;使用 cross-attention 虽有效但更重。Evo-Depth 使用 Spatial Enhancement Module(SEM):
- 将 DA3 特征从 1536 维投影到 VLM 隐空间的 896 维;
- 对深度 token 做平均池化,形成全局描述 g t g_t gt;
- 预测两个 896 维向量 γ , β \gamma,\beta γ,β;
- 对 VLM 表征逐通道调制。
( γ , β ) = f mod ( g t ) , Z ^ t = γ ⊙ Z t + β (\gamma,\beta)=f_{\text{mod}}(g_t),\qquad \hat Z_t=\gamma\odot Z_t+\beta (γ,β)=fmod(gt),Z^t=γ⊙Zt+β
这在代码中对应 DPTLinearFilM 和 apply_film。
重点: SEM 让二维视觉语言语义仍然是主干,而深度只提供互补的、低开销的空间偏置。论文消融也指出,此方式优于简单 concat,并优于更重的 cross-attention 融合。
5. 动作专家:Flow Matching 动作块生成
Evo-Depth 不把动作离散化成 token,而是将未来连续动作序列作为生成对象。默认训练配置为:
- 动作预测长度:
horizon = 50; - 统一动作维度:
per_action_dim = 24; - 状态维度:
state_dim = 24; - 动作 Transformer:8 层。
不同机器人实际维度不同时,数据集和客户端通过 action_mask 屏蔽补齐维度。例如 LIBERO 使用前 7 维,MetaWorld 的示例使用前 4 维。
5.1 条件建模
动作头将当前机器人状态编码为状态 token,拼到空间增强 token 后:
C = [ Z ^ t ; StateEncoder ( s t ) ] C=[\hat Z_t;\text{StateEncoder}(s_t)] C=[Z^t;StateEncoder(st)]
带噪动作序列经过动作编码器与位置编码后,与条件上下文
C
C
C 执行 cross-attention。动作编码器和 MLP 支持 embodiment_id,为跨机器人形态训练预留了类别专属参数路径。
5.2 Flow Matching 训练与推理
设真实动作块为 A A A、均匀噪声为 ϵ \epsilon ϵ,先采样 τ ∼ Beta ( 2 , 2 ) \tau\sim\text{Beta}(2,2) τ∼Beta(2,2),再构造中间动作:
A τ = ( 1 − τ ) ϵ + τ A A_\tau=(1-\tau)\epsilon+\tau A Aτ=(1−τ)ϵ+τA
模型预测把 A τ A_\tau Aτ 推向真实动作的速度场,训练目标为:
L = ∥ v θ ( A τ , Z ^ , s ) − ( A − ϵ ) ∥ 2 2 \mathcal{L}=\left\|v_\theta(A_\tau,\hat Z,s)-(A-\epsilon)\right\|_2^2 L= vθ(Aτ,Z^,s)−(A−ϵ) 22
源码在训练循环中显式计算 target_velocity = actions_gt - noise,并用 action_mask 修正 padding 维度的损失权重。
推理时从随机动作开始,进行 N N N 次 Euler 更新:
A ( k + 1 ) = A ( k ) + 1 N v θ ( A ( k ) , Z ^ , s , k / N ) A^{(k+1)}=A^{(k)}+\frac{1}{N}v_\theta(A^{(k)},\hat Z,s,k/N) A(k+1)=A(k)+N1vθ(A(k),Z^,s,k/N)
服务端默认 N=50。最终得到
50
×
24
50\times24
50×24 动作块,客户端并不一定全部执行,而是执行前若干步后重新观察,形成 receding-horizon control(滚动时域控制)。
6. Progressive Alignment Training:为何分三阶段训练
直接同时训练预训练 VLM、预训练深度编码器和随机初始化的动作模块,容易让表征空间互相干扰。Evo-Depth 的渐进对齐策略如下:
| 阶段 | 可训练模块 | 目标 |
|---|---|---|
| Stage 1:Initial Alignment | SEM + Action Expert | 让新模块先适应冻结的预训练 VLM/深度特征 |
| Stage 2:Spatial Alignment | IDEM + SEM + Action Expert | 将 DA3 空间特征对齐到动作任务,VLM 仍稳定 |
| Stage 3:Joint Optimization | VLM + IDEM + SEM + Action Expert | 端到端微调,实现完整协同 |
在 Evo_depth/train.sh 中,这三阶段通过 --finetune_vlm、--finetune_da3、--finetune_action_head 控制;Stage 2 和 Stage 3 用上一阶段 checkpoint 初始化,并设置 --resume_pretrain 重置学习率进度。
训练超参数遵循:AdamW、线性 warmup、cosine decay、梯度裁剪 1.0、图像增强。论文给出的代表性 MetaWorld 设置为 batch size 16、448 分辨率、动作长度 50、Stage 1/2/3 分别 5k/10k/120k steps。
重点: 分阶段训练不是纯粹的训练技巧,而是使“预训练空间知识”逐步变为“任务相关空间知识”的关键机制。
7. 数据与输入协议
7.1 训练数据
数据加载器以 LeRobot 格式读取:
dataset/
  meta/tasks.jsonl
  meta/episodes.jsonl
  meta/episodes_stats.jsonl 或 meta/stats.json
  data/*/*.parquet
  videos/<chunk>/<view>/episode_*.mp4
每个训练样本包括:
- 当前时刻的多视角图像;
- 由
task_index查得的自然语言指令; - 当前
observation.state; - 从当前时刻开始的未来
action_horizon个动作; - 图像、状态和动作的有效位 mask;
- robot embodiment ID。
状态与动作根据各数据集的 min/max 归一化到 [ − 1 , 1 ] [-1,1] [−1,1];不同视角数量、状态维度、动作维度均 padding 到配置上限。默认上限见 Evo_depth/dataset/config.yaml:3 视角、24 维状态、24 维动作。
7.2 在线推理协议
服务端要求 JSON 请求中含以下字段:
{
  "image": ["view_1", "view_2", "view_3"],
  "state": ["robot state"],
  "prompt": "task instruction",
  "image_mask": [1, 1, 0],
  "action_mask": [1, 1, 1, 1, 1, 1, 1, 0]
}
其中 image 实际是 uint8 像素数组,服务端固定解码并缩放为
448
×
448
448\times448
448×448;image_mask 表示有效相机位;action_mask 表示机器人实际可执行的动作维度。服务器用 checkpoint 中的 norm_stats.json 对状态归一化、对输出动作反归一化。
8. 复现指南
8.1 环境安装
git clone https://github.com/MINT-SJTU/Evo-Depth.git
cd Evo-Depth/Evo_depth

conda create -n evo_depth python=3.10 -y
conda activate evo_depth
pip install -r requirements.txt
MAX_JOBS=64 pip install -v flash-attn --no-build-isolation
pip install --no-build-isolation git+https://github.com/nerfstudio-project/gsplat.git@0b4dddf04cb687367602c01196913cde6a743d70
需要 NVIDIA GPU。论文训练使用 A100;README 的实际部署评测以单独 benchmark 环境配合主模型服务进行。
8.2 下载权重并启动模型服务
从 README 列出的 Hugging Face 仓库下载匹配 benchmark 的 checkpoint。checkpoint 目录必须包含:
checkpoint.json
config.json
norm_stats.json
mp_rank_00_model_states.pt
启动服务:
conda activate evo_depth
cd Evo_depth
export EVO_DEPTH_CKPT_DIR=/path/to/checkpoint
export EVO_DEPTH_SERVER_PORT=9000
python scripts/Evo_depth_server.py
Windows PowerShell 等价写法:
$env:EVO_DEPTH_CKPT_DIR = "D:\path\to\checkpoint"
$env:EVO_DEPTH_SERVER_PORT = "9000"
python scripts/Evo_depth_server.py
服务监听 ws://127.0.0.1:9000。评测客户端的 server_url 必须与此一致。
8.3 运行仿真评测
每类评测依赖独立环境,原因是 LIBERO、MetaWorld 和 VLA-Arena 的 Python/Torch 依赖不完全兼容。建议保持“模型服务环境”和“环境客户端”分离。
| Benchmark | 客户端目录 | 典型命令 |
|---|---|---|
| LIBERO | LIBERO-evaluation/ | bash ./test_libero.sh ./logs libero_spatial ws://127.0.0.1:9000 |
| LIBERO-Plus | LIBERO-PLUS-evaluation/ | bash ./test_libero_plus.sh ./logs libero_spatial camera |
| MetaWorld MT50 | Metaworld-evaluation/ | bash ./test_metaworld.sh |
| VLA-Arena | VLA-Arena-evaluation/ | bash ./test_vla_arena.sh |
详细环境依赖、下载地址及参数在 README.md 中维护。优先确认以下三项:
- checkpoint 与 benchmark task suite 对应;
- 客户端的
server_url与服务端端口一致; - 客户端的视角顺序、状态构造和
action_mask与训练数据一致。
8.4 用自己的数据训练
- 将数据转换为 LeRobot 目录结构;
- 编辑 Evo_depth/dataset/config.yaml,填写数据路径和
view_map; - 保持
max_views、max_state_dim、max_action_dim与训练命令的state_dim、per_action_dim兼容; - 修改 Evo_depth/train.sh 中的
dataset_config_path、save_dir、resume_path; - 从 Stage 1 到 Stage 3 顺序训练。
最小化检查清单:
meta/tasks.jsonl的task_index能映射到语言文本;- 视频目录与
view_map中的视角名字一致; episodes_stats.jsonl可生成正确的 min/max 统计;- state/action 的真实维度不超过 24;
- 部署端使用同一训练集统计量进行归一化。
9. 结果如何理解
论文报告的代表性仿真结果为:MetaWorld 84.4%、VLA-Arena 41.1%、LIBERO 95.4%、LIBERO-Plus 69.6%。真实机器人三项任务平均成功率为 90.0%。这些数字应结合各 benchmark 的难点理解:
- MetaWorld 的高难度拆分强调精细空间协调;
- LIBERO 的
spatial和long强调语言空间关系与长时序执行; - VLA-Arena 包含 distractor、extrapolation 和 long-horizon 维度;
- LIBERO-Plus 直接测试相机、机器人、语言、光照、背景、噪声和布局扰动。
论文消融给出三个重要结论:
- 去掉隐式深度模块后,在相机、机器人和布局扰动上下降明显;
- 三阶段对齐优于一阶段或两阶段训练,尤其有助于长时序任务;
- SEM 的 FiLM 融合优于 concat,也优于更重的 cross-attention 变体。
结论: Evo-Depth 的增益不只是“多一个视觉编码器”,而是来自“空间先验 + 低扰动融合 + 渐进对齐”三者的配合。
10. 实践限制与排错重点
- 输入协议是强约束。 服务端当前固定接收 3 个图像槽位;即使只有一个或两个相机,也要传入 dummy 图像并通过
image_mask标明无效位。 - mask 不能省略。
action_mask同时影响动作采样、推理过程和训练损失;错误 mask 会使 padding 维污染控制。 - 归一化必须随 checkpoint。 不能用另一数据集的 min/max 替换
norm_stats.json。 - 多视角顺序必须稳定。 训练时的外部相机/腕部相机排序应与在线请求完全相同。
- 模型仍非完整三维规划器。 强接触、物体被遮挡、易滚动目标、插装容差很小等任务依旧可能失败。
11. 总结
Evo-Depth 提供了一条实用的空间增强 VLA 路径:用 DA3 的多视角隐式表征获取深度线索,用 FiLM 在不显著增加 token 和计算量的前提下增强 InternVL3 表征,再用 Flow Matching 生成连续动作块。其工程价值在于,它把空间感知提升建立在 RGB、多视角和预训练表征之上,而不要求额外三维硬件或显式点云流程。
对于希望将 VLA 用于桌面抓取、放置与堆叠的实践者,最值得复用的并不是某个单独模块,而是这一组合原则:让几何表征提供空间先验,让语义表征保持主导,再以渐进训练完成二者到控制策略的对齐。
分享完成~

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献58条内容

所有评论(0)