VLA 系统学习第 17 课:正式进入 ACT——为什么需要 CVAE、潜变量 z 和 KL Loss?
第十六课标准答案
上一课我们已经从 Transformer 的内部结构,走到了一个能预测 Action Chunk 的 Encoder–Decoder Policy。
现在先解决 9 道题,然后正式进入 ACT:Action Chunking with Transformers。
1. 为什么 Encoder 的输出叫 Memory?是不是电脑内存?
不是电脑的 RAM。
在 Transformer Encoder–Decoder 架构中,Memory 通常指 Encoder 对输入信息进行上下文编码后产生的特征序列。
例如:
\[ M=\operatorname{Encoder}(X) \]
这里的 \(M\) 包含 Encoder 对 Observation 的编码结果,供后续 Decoder 通过 Cross-Attention 查询。
可以理解成:
Encoder 把观察信息整理好,Decoder 再根据自己的 Query,从这些特征中读取所需信息。
Memory 不一定具有跨时间长期保存的能力。在我们上一课的模型中,每次 Forward 都会根据本次输入重新计算。
2. Observation [B,4,10] 经过 Linear 和 Encoder 后是什么 Shape?
首先:
state_proj = nn.Linear(10, 64)tokens = state_proj(obs)
因为 Linear 作用于最后一维:
\[ [B,4,10]\rightarrow[B,4,64] \]
随后 Transformer Encoder 通常保持形状:
\[ \boxed{M:[B,4,64]} \]
虽然 Shape 不变,但是每个 Token 已经经过 Self-Attention 和 FFN 处理。
3. 为什么 Encoder 有 4 个 Token,不代表 Decoder 只能输出 4 个?
因为 Encoder Memory 的序列长度与Decoder Query 的序列长度可以不同。
例如:
\[ M:[B,4,64] \]
而我们给 Decoder 准备:
\[ Q:[B,8,64] \]
Cross-Attention 让 8 个 Query 分别读取 4 个 Memory Token 的信息,得到 8 个输出位置。
因此:
\[ \boxed{\text{Decoder输出长度由Query长度决定}} \]
在这种并行预测结构中,8 个 Query 可以对应 8 个未来动作位置。
4. Action Query 是真正的 7 维 Action 吗?
不是。
Action Query 是 Decoder 内部使用的查询表示,例如:
\[ q_i\in\mathbb R^{64} \]
它本身不是关节角、末端位置或者电机命令。
需要经过 Decoder 和 Action Head:
\[ [B,8,64] \xrightarrow{\text{Action Head}} [B,8,7] \]
才得到模型所定义的 7 维 Action Prediction。
注意:不同实现对 Query 的组织方式可能不同,不能认为所有 ACT/VLA 模型都使用完全相同的 Query 结构。
5. 为什么 Cross-Attention Score 是 [B,8,4]?
因为:
\[ Q:[B,8,64] \]
\[ K:[B,4,64] \]
转置 K:
\[ K^T:[B,64,4] \]
因此:
\[ QK^T: [B,8,64]\times[B,64,4] \]
得到:
\[ \boxed{[B,8,4]} \]
其中 8 是 Query 数量,4 是 Key 数量。
每一行都在回答:
当前这个 Action Query 对 4 个 Observation Memory Token 分别有多高的关注程度?
6. Decoder 的 Self-Attention 和 Cross-Attention 有什么区别?
Self-Attention 让 Decoder 自己的 Action Query Token 之间交换信息:
\[ [B,8,64]\rightarrow[B,8,64] \]
Cross-Attention 则让 Action Query 从 Encoder Memory 中提取信息:
\[ Q_{\text{action}} \quad\text{与}\quad K_{\text{memory}},V_{\text{memory}} \]
二者的核心差别是信息来源。
Self-Attention 处理目标侧内部关系;Cross-Attention 建立目标侧与输入侧的关系。
7. tgt=queries 是不是 Expert Action?
不是。
在上一课的教学代码中:
action_features = self.decoder( tgt=queries, memory=memory)
tgt 是传给 Decoder 的目标侧特征序列,即当前使用的 Action Queries。
训练时的 Expert Action 另外存在:
expert_actions
它用于构造监督信号、计算 Loss,并不会因为变量名叫 tgt 就自动变成 Decoder 输入。
8. 为什么 [B,8,64] 经过 nn.Linear(64,7) 得到 [B,8,7]?
因为 Linear 只修改最后一维:
\[ 64\rightarrow7 \]
前面的 Batch 和 Action Query 数量保持不变:
\[ \boxed{[B,8,64]\rightarrow[B,8,7]} \]
所以一次输出 8 个动作,每个动作 7 维。
9. 为什么上一课的 TinyActionChunkPolicy 还不是完整 ACT?
因为它只是一个教学用的确定性 Transformer BC Policy:
\[ Observation \rightarrow Encoder \rightarrow Decoder \rightarrow Action\ Chunk \]
它缺少 ACT 原方法中的重要机制,特别是:
-
用专家 Action Sequence 参与训练的 CVAE 潜变量分支;
-
潜变量 \(z\) 的分布学习及 KL 正则化;
-
训练与推理阶段不同的潜变量处理;
-
原方法针对视觉和机器人状态设计的具体输入结构;
-
动作块重叠预测时可采用的 Temporal Ensembling。
所以我们已经理解了 ACT 所需的 Transformer 基础,但还没有理解完整 ACT 的训练方法。
接下来就处理这个缺口。
VLA 系统学习第 17 课:正式进入 ACT——为什么需要 CVAE、潜变量 \(z\) 和 KL Loss?
论文与代码基础:Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(Tony Z. Zhao 等,2023) · ACT 官方 GitHub
这一课开始,我们不再只讲通用 Transformer,而是把之前的 Behavior Cloning、Action Chunk、Encoder–Decoder、Loss 和 Backward 连接到 ACT 的真实方法中。
一、为什么普通 BC 即使预测 Action Chunk,也可能遇到困难?
我们已经知道,最普通的 Behavior Cloning 是:
\[ \hat a_t=\pi_\theta(o_t) \]
上一课进一步扩展为:
\[ \hat A_t=\pi_\theta(o_t) \]
其中:
\[ A_t=[a_t,a_{t+1},\ldots,a_{t+K-1}] \]
表示一段未来 Action。
现在考虑一种情况:两个专家从相同或非常相近的 Observation 出发,却采用两条不同的合理轨迹。
例如物体正好挡在前面,机械臂可以从左侧绕过去,也可以从右侧绕过去。
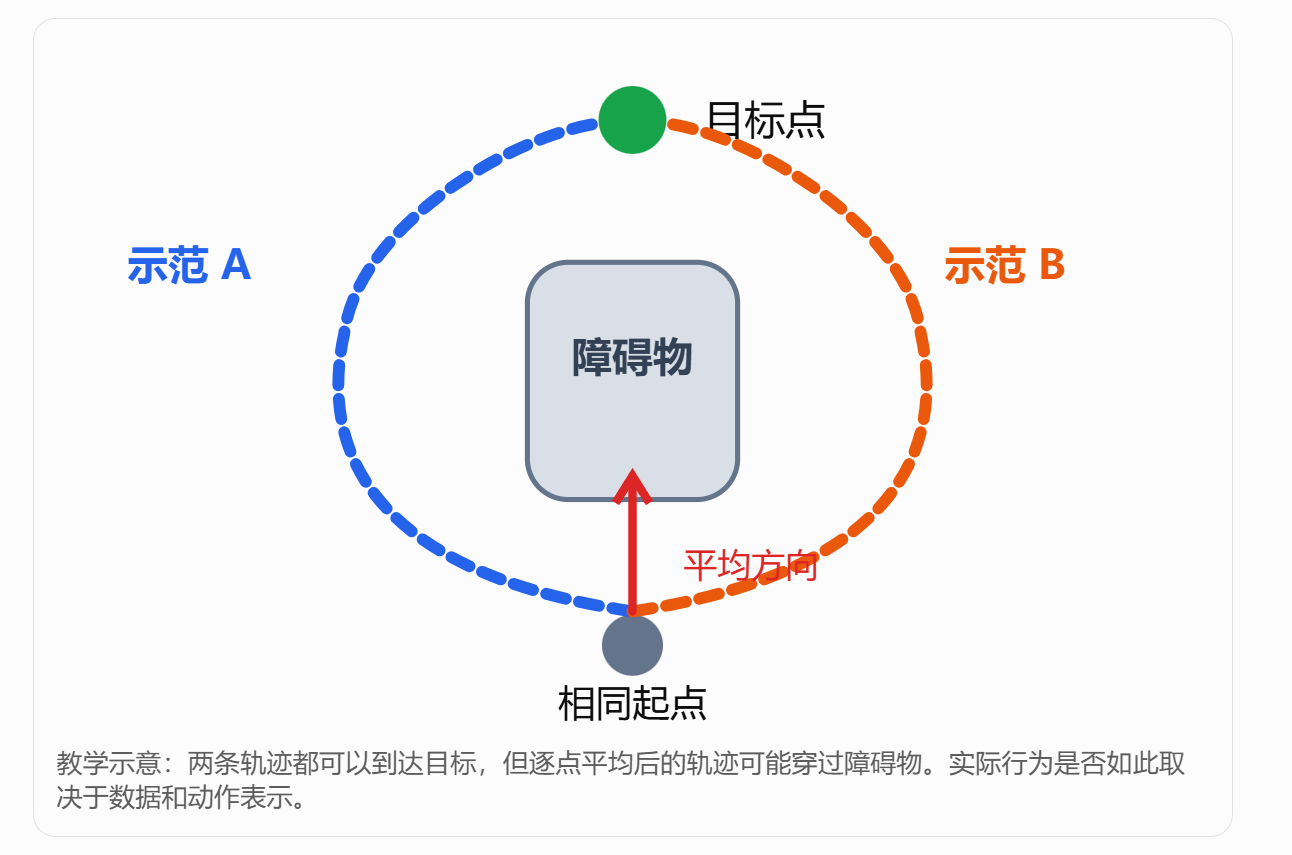
为了把问题简化到最容易计算的程度,假设某一个时刻存在两种合理动作:
\[ a^{(1)}=-1 \]
\[ a^{(2)}=+1 \]
含义分别是向左和向右。
如果模型只能对相同的 Observation 输出一个固定数值:
\[ \hat a=f_\theta(o) \]
并且使用 MSE:
\[ L=\frac12[(\hat a+1)^2+(\hat a-1)^2] \]
展开得到:
\[ L=\hat a^2+1 \]
当:
\[ \hat a=0 \]
时,Loss 最小。
但问题是:
\[ \boxed{\hat a=0} \]
既不是“向左”,也不是“向右”,而是两个动作的中间值。
这就是在多模态示范数据中,确定性回归预测可能出现的平均化问题。
这里需要严谨区分:上面的推导针对 MSE。对于 L1,最优解不一定唯一,但它同样没有明确机制保证模型选择一条完整、一致的动作模式。
ACT 原论文也明确把人类示范的可变性作为引入生成式模型的一个重要动机。
现在真正需要解决的是:
在同样 Observation 下存在多种合理 Action Chunk 时,模型能否获得额外的信息,区分不同的示范方式?
二、CVAE 的核心想法:除了 Observation,再给模型一个潜变量 \(z\)
我们之前的确定性 Policy 是:
\[ \hat A=\pi_\theta(o) \]
也就是说,输入 \(o\),输出一段预测动作。
ACT 引入一个新的变量:
\[ z \]
于是 Policy 变成:
\[ \boxed{ \hat A=\pi_\theta(o,z) } \]
这个 \(z\) 通常称为:
Latent Variable,潜变量。
它是一个模型内部的向量,不是另一个相机,不是机器人关节位置,也不是语言指令。
可以把它理解成:
让模型有机会使用一份额外的内部信息,表示当前 Action Sequence 的某些变化因素。
ACT 论文把它解释为动作序列的 style variable,也就是动作风格变量。
例如概念上:
\[ z_1\rightarrow\text{某一种动作执行方式} \]
\[ z_2\rightarrow\text{另一种动作执行方式} \]
但要注意,这只是帮助理解的例子,不能直接认为 \(z_1\) 就等于“左绕”,\(z_2\) 就等于“右绕”。
真实的潜变量没有预先规定的语义,模型可能学习到不同的内部因素,也可能没有充分利用它。
1. \(z\) 是一个什么 Shape?
假设我们人为设定:
\[ D_z=4 \]
那么一个样本的潜变量为:
\[ z\in\mathbb R^4 \]
例如:
\[ z=[0.2,-0.6,1.1,0.3] \]
如果:
\[ B=32 \]
则:
\[ z:[32,4] \]
这里的 4 是潜变量维度,不是 Action Dimension,也不是 Transformer 的 Embedding Dimension。
在作者官方 detr/models/detr_vae.py 中,存在:
self.latent_dim = 32
也就是说,当前核实的这份 ACT 实现使用 32 维潜变量,而不是我们教学示例中的 4 维。
2. 现在问题来了:训练时 \(z\) 从哪里来?
不能简单地说:
随便创建一个随机向量就行。
因为我们希望这份 \(z\) 与专家示范中的动作差异建立联系。
ACT 的方法是:训练阶段使用一个额外的 Encoder,读取专家 Action Chunk 和当前机器人关节状态,生成潜变量的分布参数。
因此需要明确区分两条计算链。
训练时的潜变量分支
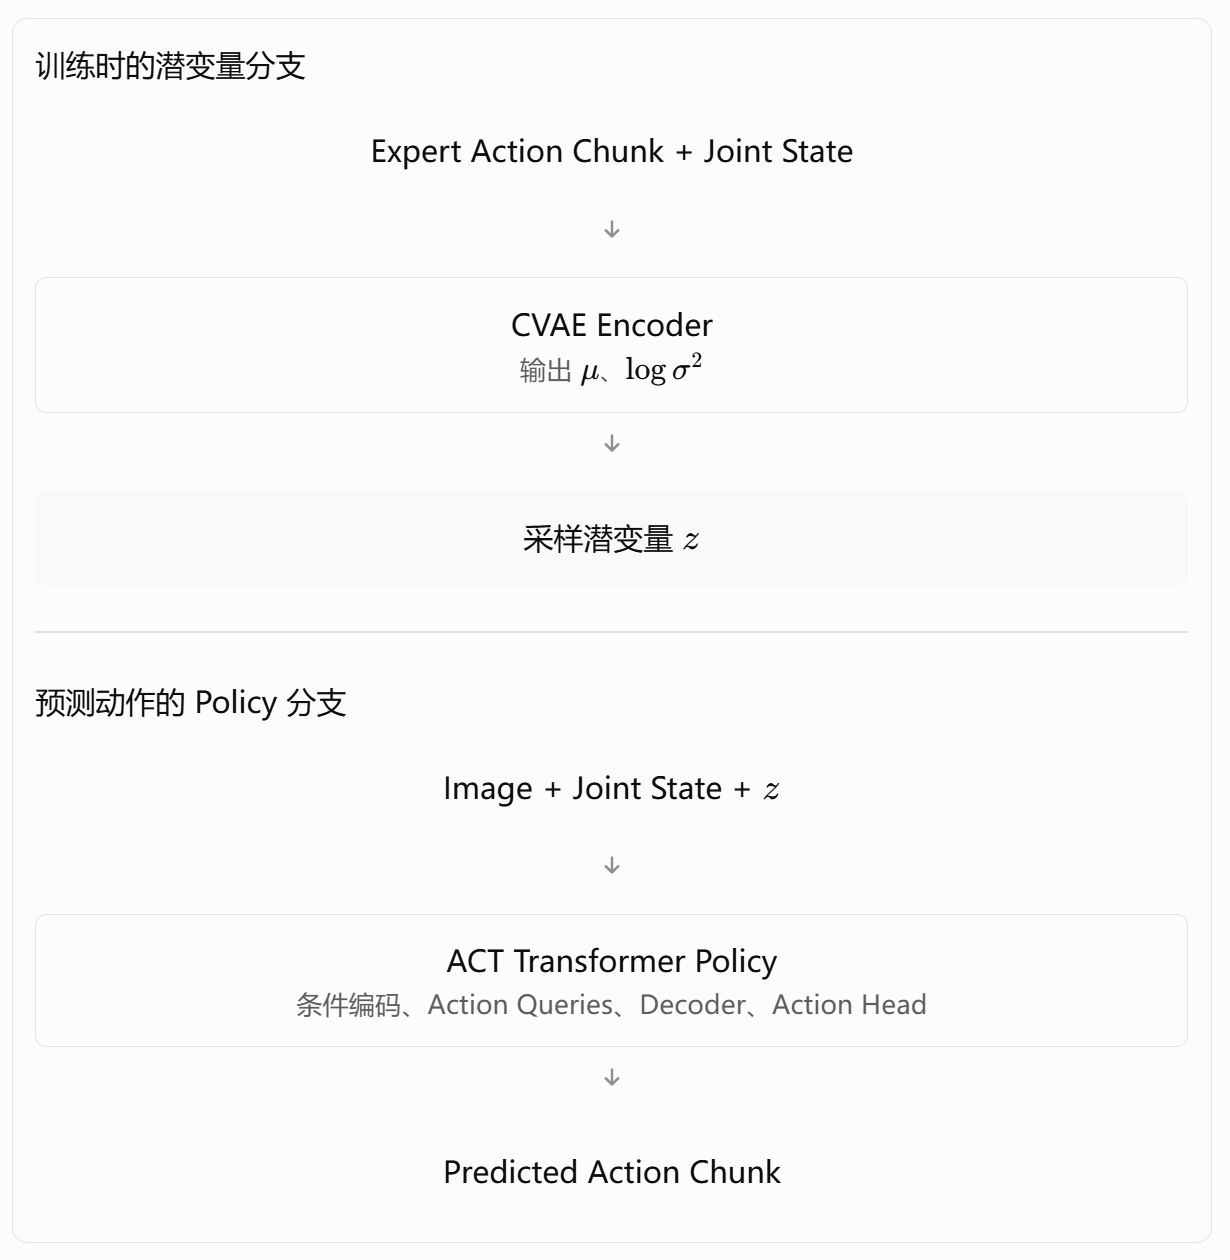
这两条分支会在训练期间联合工作。
第一条负责从示范中学习潜变量分布;第二条利用 Observation 和 \(z\) 预测动作。
这里必须特别强调:ACT 的 CVAE Encoder 与用于处理图像、状态的 Transformer Encoder 不是同一个概念。 它们属于架构中的不同部分,承担不同职责。原论文和官方实现都能核实这一设计。
三、为什么 Encoder 不直接输出一个 \(z\),反而要输出 \(\mu\) 和 \(\sigma\)?
这是理解 VAE 与普通 Autoencoder 区别的关键。
普通 Encoder 可以直接写成:
\[ z=f_\phi(A,o) \]
也就是输入一段示范动作,直接输出一个固定的 \(z\)。
但 VAE 的 Encoder 不是直接预测一个确定的潜变量,而是预测一个概率分布。
ACT 使用的是高斯形式的潜变量分布:
\[ \boxed{ q_\phi(z\mid A,q) = \mathcal N(\mu,\operatorname{diag}(\sigma^2)) } \]
其中:
-
\(A\):专家 Action Chunk;
-
\(q\):当前关节状态;
-
\(\mu\):高斯分布的均值向量;
-
\(\sigma^2\):各维度的方差;
-
\(\operatorname{diag}\):将各维方差放在协方差矩阵对角线上;
-
\(\phi\):CVAE Encoder 的可训练参数。
为什么使用分布?
因为模型不再把每条示范压缩为一个完全固定的编码点,而是学习一套可以采样的潜在表示。
1. 先用一个数字理解高斯分布
假设:
\[ \mu=2 \]
\[ \sigma=0.5 \]
意思是分布中心在 2,标准差为 0.5。
每次采样可能得到:
\[ z_1=1.8 \]
\[ z_2=2.3 \]
\[ z_3=1.9 \]
这些都是示意值。
真正重要的是:Encoder 决定分布的位置和宽度,随后我们从这个分布中取样。
2. 为什么代码中不是 sigma,而是 logvar?
你在 ACT 官方代码中会看到:
mu = latent_info[:, :self.latent_dim]logvar = latent_info[:, self.latent_dim:]
这里:
\[ logvar=\log(\sigma^2) \]
意思是方差的自然对数。
使用 logvar 的一个好处,是网络可以输出任意实数,再通过指数函数还原出严格为正的方差。
如果:
\[ \log(\sigma^2)=0 \]
那么:
\[ \sigma^2=e^0=1 \]
于是:
\[ \sigma=1 \]
而一般情况下:
\[ \boxed{ \sigma=\exp\left(\frac{logvar}{2}\right) } \]
因为:
\[ \log(\sigma^2)=2\log\sigma \]
所以:
\[ \log\sigma=\frac{logvar}{2} \]
再取指数,就得到了标准差。
3. 代码中的 \(\mu\) 和 logvar 怎么得到?
我们先使用一个简单教学示例。
假设:
\[ B=2,\quad K=8,\quad D_a=7,\quad D_s=10,\quad D_z=4 \]
则:
\[ state:[2,10] \]
\[ actions:[2,8,7] \]
为了暂时避开复杂的 Transformer Encoder,我们先把动作序列展平成一个向量:
flat_actions = actions.flatten(start_dim=1)
那么:
\[ [2,8,7]\rightarrow[2,56] \]
再把 State 拼进去:
encoder_input = torch.cat( [state, flat_actions], dim=-1)
于是:
\[ [2,10]+[2,56]\rightarrow[2,66] \]
现在使用一个 MLP:
style_encoder = nn.Sequential( nn.Linear(66, 64), nn.ReLU(), nn.Linear(64, 8))
为什么输出 8?
因为需要同时生成两组 4 维数字:
\[ \mu:[2,4] \]
\[ logvar:[2,4] \]
所以总共需要:
\[ 2D_z=8 \]
个输出。
运行:
latent_info = style_encoder(encoder_input)mu, logvar = torch.chunk( latent_info, chunks=2, dim=-1)
这里 torch.chunk(..., chunks=2, dim=-1) 的作用,就是把最后一维平均分成两块:
\[ [2,8]\rightarrow[2,4]+[2,4] \]
所以:
mu.shape# [2, 4]logvar.shape# [2, 4]
这已经完整解释了:
为什么 ACT 的 CVAE Encoder 最后需要输出两倍的 Latent Dimension。
这里的 MLP 是教学替身。真实 ACT 使用 Transformer Encoder 处理示范动作序列,而不是简单将动作全部展平。
四、有了 \(\mu\) 和 logvar,怎么得到 \(z\)?——Reparameterization Trick
我们已经让 Encoder 预测了一个概率分布。
但现在还要从这个分布中采样:
\[ z\sim\mathcal N(\mu,\sigma^2) \]
如果把采样直接当成一个不可微的黑盒,训练时就不容易把梯度从 Decoder 传回 Encoder 的分布参数。
于是 VAE 使用:
Reparameterization Trick,重参数化技巧。
它的核心式子非常值得记住:
\[ \boxed{ z=\mu+\sigma\odot\epsilon } \]
其中:
\[ \epsilon\sim\mathcal N(0,I) \]
符号 \(\odot\) 表示逐元素相乘。
这个公式的思想是:
把随机性放到一个独立的噪声 \(\epsilon\) 中,而把 \(\mu\) 和 \(\sigma\) 放在可微的确定性计算路径里。
例如:
\[ \mu=2,\quad\sigma=0.5,\quad\epsilon=-0.4 \]
得到:
\[ z=2+0.5\times(-0.4)=1.8 \]
这样我们仍然能从目标高斯分布中采样,但 \(z\) 对 \(\mu\) 和 \(\sigma\) 的运算关系是明确的。
代码非常短:
std = torch.exp(0.5 * logvar)eps = torch.randn_like(std)z = mu + std * eps
torch.randn_like(std) 会生成一个与 std Shape 相同的标准正态随机 Tensor。
假设:
\[ mu:[2,4] \]
\[ logvar:[2,4] \]
那么:
\[ std:[2,4] \]
\[ eps:[2,4] \]
最后:
\[ \boxed{z:[2,4]} \]
这也与 ACT 官方 reparametrize() 中使用的数学结构一致。
现在第一条训练分支已经走通:
\[ \boxed{ Expert\ Action\ Chunk + Joint\ State \rightarrow Encoder \rightarrow (\mu,logvar) \rightarrow z } \]
下一步,就是用这个 \(z\) 生成 Action Chunk。
五、为什么 Decoder 已经有 \(z\),还需要 KL Loss?
现在我们已经知道,CVAE Encoder 可以利用专家动作生成:
\[ z:[B,D_z] \]
之后 Policy 使用:
\[ \hat A=\pi_\theta(o,z) \]
预测动作。
但这里出现一个重要问题:
既然 Encoder 已经看到了专家动作,那它会不会直接把专家动作的信息编码进 \(z\),使 Decoder 只需要“照着抄”?
如果完全不限制 \(z\),确实可能出现这个问题。
训练时,Encoder 可以依赖 Expert Action 生成特别有针对性的编码,使 Decoder 很容易重建专家动作。
但推理时没有 Expert Action!
于是训练时非常好用的潜变量,在推理时可能根本无法得到。
因此需要限制潜变量分布。
这就是 KL Loss 的意义。
1. 什么是 Prior?
在 ACT 中,我们希望潜变量的分布接近一个简单的标准正态分布:
\[ \boxed{ p(z)=\mathcal N(0,I) } \]
这里的 \(p(z)\) 叫 Prior,先验分布。
可以理解成我们提前规定:
希望潜变量大体处在一个标准化、可预测的分布空间中。
而 Encoder 根据示范动作预测的是:
\[ q_\phi(z\mid q,A) \]
它叫近似后验分布。
训练时希望两者不要相差太远:
\[ q_\phi(z\mid q,A) \approx p(z) \]
于是引入:
\[ D_{\mathrm{KL}}(q_\phi\|p) \]
KL Divergence,KL 散度。
它用于衡量两个概率分布之间的差异。它不是普通欧氏距离,而且通常不对称。
2. KL Loss 的数学公式
对 ACT 使用的对角高斯分布,其 KL 可以写为:
\[ \boxed{ L_{\mathrm{KL}} = \frac12 \sum_{i=1}^{D_z} \left( \mu_i^2+ e^{logvar_i} -1-logvar_i \right) } \]
先不要被公式吓到。
这里每一项都有明确意义:
\[ \mu_i^2 \]
对均值偏离 0 产生惩罚。
\[ e^{logvar_i} \]
就是该维度的方差:
\[ \sigma_i^2 \]
而其余项一起构成完整的高斯 KL 表达式。
如果:
\[ \mu_i=0,\quad logvar_i=0 \]
那么:
\[ \sigma_i^2=1 \]
恰好对应标准正态分布。
此时这一维 KL 为:
\[ \frac12(0+1-1-0)=0 \]
因此 KL Loss 会约束 Encoder 输出的潜变量分布不要任意偏离先验。
3. PyTorch 中怎么算?
我们已经有:
mu.shape# [B, Dz]logvar.shape# [B, Dz]
可以写:
kl_per_dim = -0.5 * ( 1 + logvar - mu.pow(2) - logvar.exp())kl_loss = kl_per_dim.sum(dim=-1).mean()
这与官方代码中 kl_divergence() 的核心公式一致。
这段代码的数据流是:
\[ [B,D_z] \rightarrow \text{每一维KL} \rightarrow [B,D_z] \]
再通过:
sum(dim=-1)
对每个 Sample 的全部潜变量维度求和:
\[ [B,D_z]\rightarrow[B] \]
最后通过:
mean()
求 Batch 平均:
\[ [B]\rightarrow[] \]
得到一个标量 KL Loss。
六、现在终于能看懂完整 ACT Loss
到这里我们有了两个不同的目标。
第一个是希望模型预测的 Action Chunk 接近专家动作:
\[ L_{\mathrm{recon}}(\hat A,A) \]
这叫:
Reconstruction Loss,重建损失。
第二个是希望潜变量分布不要任意偏离标准正态先验:
\[ L_{\mathrm{KL}} \]
所以完整训练目标为:
\[ \boxed{ L_{\mathrm{total}} = L_{\mathrm{recon}} + \beta L_{\mathrm{KL}} } \]
其中:
\[ \beta \]
用于控制 KL 正则化强度。
如果:
\[ \beta \]
太小,潜变量可能携带大量只在训练时容易获取的动作信息,使推理时与训练时的潜变量使用方式出现不匹配。
如果:
\[ \beta \]
太大,模型可能倾向于忽略 \(z\),导致潜变量难以表达不同示范之间的变化。这种情况与 VAE 中的 Posterior Collapse(后验坍塌)问题有关。
所以 KL 的作用并不是:
越小越好、越接近标准正态越好。
而是要在动作重建能力和潜变量正则化之间取得平衡。
一个必须说明的论文与代码差异
这里我核对到了一个值得专门标记的地方:
【来源冲突】 ACT 原论文的训练算法伪代码中,重建项写为 MSE;但作者官方 GitHub 的 policy.py 里,ACTPolicy 实际计算的是 L1 Loss + KL Loss。
官方代码的关键表达是:
all_l1 = F.l1_loss( actions, a_hat, reduction="none")l1 = ( all_l1 * ~is_pad.unsqueeze(-1)).mean()loss = l1 + kl_weight * kl
这里 is_pad 也是我们之前学过的 Mask。
Padding 位置不应该被当成真实专家动作,因此代码先对无效位置的误差进行屏蔽。
另外,当前代码是在屏蔽后对完整 Tensor 求 mean(),所以 Padding 位置仍然影响平均值的分母;这与“只除以有效元素数量”的另一种 Masked Mean 写法并不完全等价。
以后我们做官方复现时应严格检查这个细节,而不是擅自替换。
七、训练时使用专家 Action,推理时为什么能没有专家 Action?
这是整节课最重要的逻辑,必须彻底打通。
训练阶段
数据集中有:
\[ (o_t,A_t) \]
所以:
\[ A_t \]
不仅可以用来计算 Loss,还可以送入 CVAE Encoder,获得:
\[ \mu,\quad logvar \]
然后通过重参数化获得:
\[ z \]
预测:
\[ \hat A_t=\pi_\theta(o_t,z) \]
最后联合训练 Encoder 与 Policy。
推理阶段
真实运行时只有:
\[ o_t \]
没有未来专家动作:
\[ A_t \]
因此无法运行那个依赖专家 Action Chunk 的 CVAE Encoder。
原始 ACT 的处理方式很明确:
\[ \boxed{z=0} \]
即使用标准正态先验:
\[ \mathcal N(0,I) \]
的均值作为潜变量。
这不是猜测。ACT 论文和官方 detr_vae.py 都明确使用这一处理。
因此:
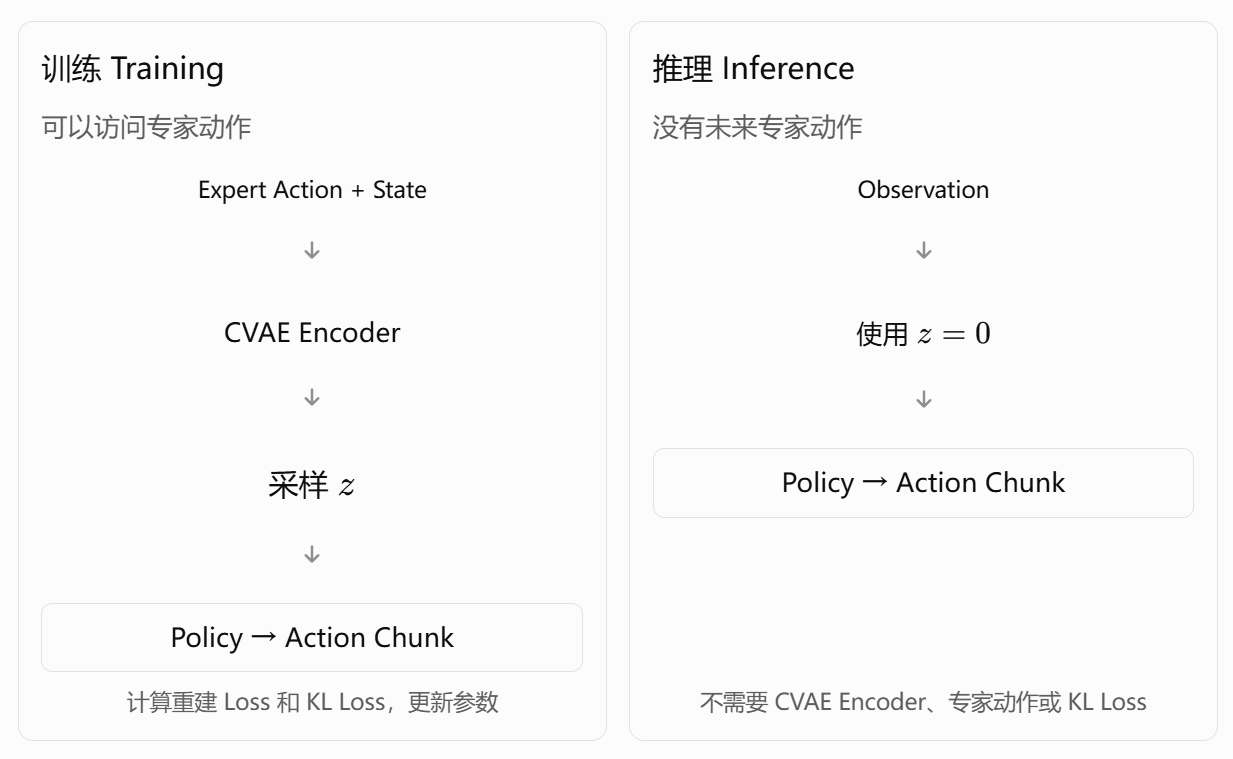
这里也暴露出一个值得思考的局限:
ACT 使用 CVAE 的动机之一是建模示范变化,但原始 ACT 在推理时固定 \(z=0\),并不是每次都随机抽取不同的动作风格。
因此不能简单宣称“原始 ACT 推理时能根据 \(z\) 自动随机选择多条完整轨迹”。这需要具体检查模型如何利用潜变量,以及实际推理机制。
八、用最小 PyTorch 代码把 CVAE 的训练与推理贯通
现在把前面分散的代码连接起来。
为了教学方便,以下模型使用 MLP 替代真实 ACT 的 Transformer CVAE Encoder 和视觉 Policy。它的目标只是让你看清楚 Expert Actions → \(\mu,\logvar\) → \(z\) → Predicted Actions → Loss 这一条链。
import torchimport torch.nn as nnimport torch.nn.functional as Fclass MiniChunkCVAE(nn.Module): def __init__(self): super().__init__() self.chunk_size = 8 self.action_dim = 7 self.z_dim = 4 # State + Action Chunk -> mu、logvar self.style_encoder = nn.Sequential( nn.Linear(10 + 8 * 7, 64), nn.ReLU(), nn.Linear(64, 2 * self.z_dim) ) # State + z -> Predicted Action Chunk self.action_decoder = nn.Sequential( nn.Linear(10 + self.z_dim, 64), nn.ReLU(), nn.Linear(64, 8 * 7) ) def forward(self, state, actions=None): B = state.shape[0] if actions is not None: # 训练:利用专家动作得到潜变量分布 flat_actions = actions.flatten(start_dim=1)
这份代码中的 forward() 有两条不同路径。
训练时:
\[ state:[2,10] \]
\[ actions:[2,8,7] \]
先展平并拼接:
\[ [2,10]+[2,56]\rightarrow[2,66] \]
经过 Style Encoder:
\[ [2,66]\rightarrow[2,8] \]
拆成:
\[ \mu:[2,4],\quad logvar:[2,4] \]
再采样:
\[ z:[2,4] \]
把 State 和 \(z\) 拼接:
\[ [2,10]+[2,4]\rightarrow[2,14] \]
经 Decoder:
\[ [2,14]\rightarrow[2,56] \]
重新 reshape:
\[ \boxed{pred\_actions:[2,8,7]} \]
推理时: 不再传入 actions,所以 if actions is not None 条件不成立,直接设置:
\[ z=[0,0,0,0] \]
然后继续使用同一个 Action Decoder 预测动作。
如何真正训练它?
model = MiniChunkCVAE()optimizer = torch.optim.Adam( model.parameters(), lr=1e-3)state = torch.randn(2, 10)expert_actions = torch.randn(2, 8, 7)optimizer.zero_grad()pred, mu, logvar = model( state, expert_actions)recon_loss = F.l1_loss( pred, expert_actions)kl_loss = -0.5 * ( 1 + logvar - mu.pow(2) - logvar.exp()).sum(dim=-1).mean()beta = 0.01loss = recon_loss + beta * kl_lossloss.backward()optimizer.step()
注意:这里的随机数据只用于验证代码调用和 Tensor Shape,没有真实机器人示范语义。
代码中最重要的是这句:
pred, mu, logvar = model(state, expert_actions)
它告诉你:
当前执行的是训练路径,因此模型可以利用专家 Action 计算后验潜变量。
随后:
loss = recon_loss + beta * kl_loss
联合约束动作重建与潜变量分布。
最后:
loss.backward()
计算包括 Style Encoder 和 Action Decoder 在内的可训练参数梯度。
再:
optimizer.step()
更新这些参数。
推理时怎么调用?
model.eval()with torch.no_grad(): pred, mu, logvar = model(state)print(pred.shape)
预期:
torch.Size([2, 8, 7])
并且此时:
mu is Nonelogvar is None
因为根本没有执行 CVAE Encoder 分支。
现在训练与推理的区别终于不只是理论描述,而是直接体现在:
model(state, expert_actions)
与:
model(state)
这两个调用方式上。
九、回到 ACT 官方代码:对应哪些真实模块?
我们已经可以把刚才的教学实现映射到作者的真实仓库,而不需要一下子阅读几百行。
下面这些位置均来自核实过的 detr/models/detr_vae.py 及 policy.py。
|
我们学的概念 |
ACT 官方代码 |
|---|---|
|
CVAE Encoder |
|
|
专家 Action Projection |
|
|
当前关节状态 Projection |
|
|
聚合示范序列 |
|
|
预测分布参数 |
|
|
取出均值 |
|
|
取出对数方差 |
|
|
重参数化采样 |
|
|
将 \(z\) 投影到模型特征空间 |
|
|
动作预测 |
|
|
重建与 KL Loss |
|
还有一个非常容易忽略的 Shape 细节:真实 ACT 的 CVAE Encoder 将一个 CLS Token、一个当前关节状态 Token 和 \(K\) 个专家 Action Token 拼在一起。
因此总 Token 数是:
\[ \boxed{K+2} \]
例如:
\[ K=8 \]
则:
\[ [CLS,q,a_0,\ldots,a_7] \]
总共有:
\[ 10 \]
个 Token。
注意官方文件中相邻的部分行内注释写作 seq+1,但根据实际 torch.cat 的输入数量,正确的总长度是 \(K+2\)。这也是为什么真实 GitHub 审读不能只看注释,要结合 Tensor 操作本身判断。
另外,原始 ACTPolicy 在 policy.py 中还直接实现了 __call__(),而不是我们教学代码采用的常规 forward()。这与你之前专门研究的 Python 魔术方法有关。它是该仓库实际存在的实现选择,不应误认为所有 PyTorch Policy 都要这样写。
第十七课整章回看
这节课真正建立起来的因果链是:
\[ \boxed{ \text{人类示范可能有多种合理轨迹} \rightarrow \text{确定性BC可能难以统一拟合} \rightarrow \text{引入潜变量}z \rightarrow \text{CVAE} } \]
训练阶段:
\[ \boxed{ (q,A) \rightarrow CVAE\ Encoder \rightarrow (\mu,logvar) \rightarrow z } \]
然后:
\[ (o,z) \rightarrow Policy \rightarrow \hat A \]
使用:
\[ \boxed{ L_{\mathrm{total}} = L_{\mathrm{recon}} + \beta L_{\mathrm{KL}} } \]
进行联合训练。
推理阶段:
\[ \boxed{ o+z=0 \rightarrow Policy \rightarrow \hat A } \]
不再需要专家 Action,也不需要 CVAE Encoder。
这就是原始 ACT 中 CVAE 的核心训练与推理逻辑。
第十七课自测
1. 为什么相同 Observation 对应多条合理专家轨迹时,普通确定性 MSE 回归可能出现平均化问题?
2. ACT 中的 \(z\) 是机器人真实状态吗?它具体属于什么?
3. 如果 \(D_z=32\),为什么 latent_proj 常需要输出 \(64\) 维数字?
4. \(\mu\)、\(\sigma\)、logvar 分别是什么意思?为什么:
\[ \sigma=\exp(0.5\,logvar) \]
5. Reparameterization Trick 为什么要写成:
\[ z=\mu+\sigma\odot\epsilon \]
而不是把采样当成不可微黑盒?
6. Reconstruction Loss 和 KL Loss 分别希望模型学会什么?
7. 为什么训练时的 CVAE Encoder 可以读取 Expert Action Chunk,而推理时不能?
8. 原始 ACT 推理时把 \(z\) 设置成多少?这是否意味着它推理时会随机选择不同风格?
9. 为什么 ACT 中存在两种不同意义上的 Encoder?分别负责什么?
10. 如果:
\[ B=32,\quad K=8,\quad D_a=7,\quad D_z=4 \]
请说明专家 Action Chunk、潜变量 \(z\) 和最终预测动作各自的 Shape。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 2
 0
- 0


 已为社区贡献29条内容

所有评论(0)