具身智能赛道升温,数据产业先迎来一轮“换挡”
如果说过去十年的人工智能,主要解决的是“看懂、听懂、读懂”,如今人工智能可以真正进入物理世界,理解环境,并完成动作。
从识别一个杯子,到伸手抓起杯子;从判断桌面上有哪些物体,到完成整理、搬运、装配;从“知道应该怎么做”,到“真正把事情做完”。看似只是从认知走向执行,但这也意味着训练数据也在发生根本变化。
传统任务中训练数据,很多都可以被抽象为:输入 → 标签 / 答案。一张图片对应一个类别,一个问题对应一个答案。但具身智能面对的是完全不同的数据逻辑。
机器人执行“拿起杯子并放到托盘中”的任务时,不仅要识别杯子,还要判断位置、机械臂状态、接近角度、抓取时机、移动路径,以及动作完成后的结果。如果第一次抓取失败,还要知道问题出在哪里、下一步如何调整。
因此,具身智能真正需要的数据,正在从静态的“结果数据”转向连续的“过程数据”。一条完整的数据轨迹,往往可能同时包含视觉图像、深度信息、点云、关节状态、末端位姿、动作指令、力觉或触觉反馈、任务状态以及执行结果。更重要的是,这些信息还需要在同一时间轴上准确对齐。
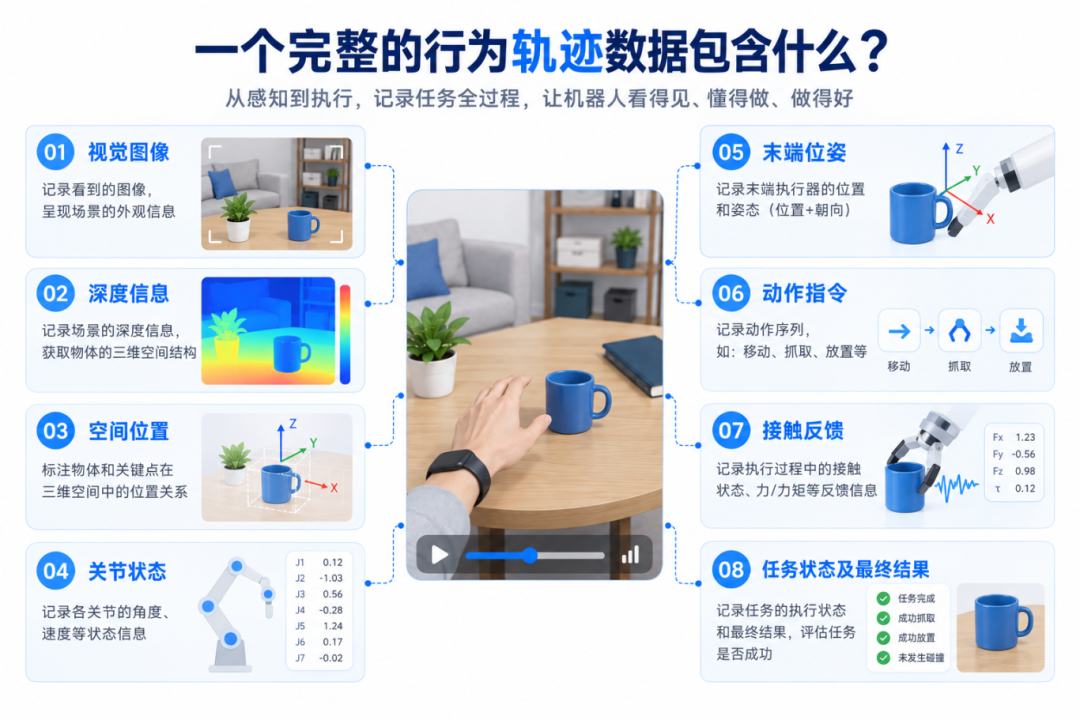
这意味着,具身智能数据生产已经不再只是“采视频、打标签”,而是一项涉及多源采集、多模态同步、时序对齐、轨迹切分和质量控制的系统工程。
依托既有的数据服务能力,淘丁数科正围绕多源数据采集、多模态数据同步、高端数据标注及AI后训练基础设施建设,持续完善具身智能数据服务生态。
在传统数据处理任务中,一张图片、一段文本,往往就可以构成一个相对独立的训练样本。
但具身智能时代,真正有价值的数据,通常不再是一帧画面,而是一整段连续的任务轨迹。这些信息不是彼此独立的,而是在时间轴上持续变化、相互影响。
从看到目标、规划动作、执行抓取、感知反馈,再根据结果决定下一步动作——这整个过程,本身才是一条完整的数据链路。
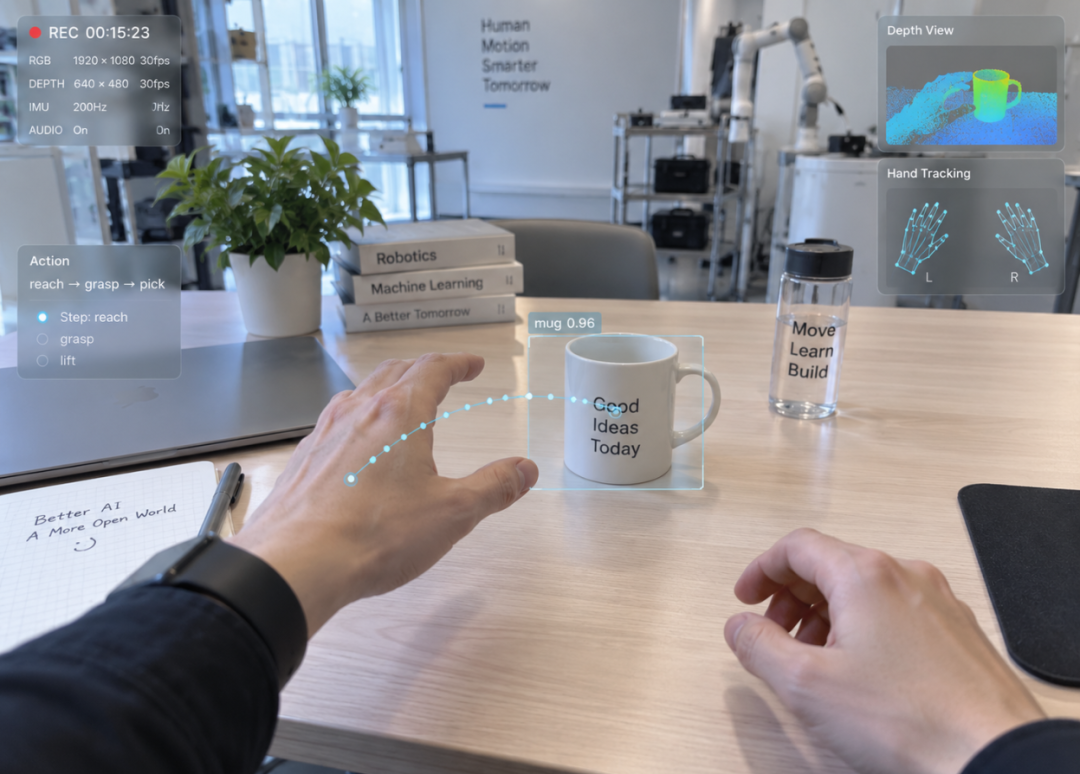
因此,高质量具身智能数据必须解决的不只是“采到了什么”,还包括:不同模态是否同步、动作与环境变化是否对应、轨迹是否完整、关键节点是否准确、任务结果是否可追溯。
这使具身智能数据生产从传统的“采集+标注”,升级为一套更复杂的多源数据采集 → 多模态同步 → 时序对齐 → 轨迹切分 → 行为理解 → 质量控制的数据工程体系。
对于淘丁数科而言,这也是业务能力向具身智能领域延伸的重要方向。淘丁数科正在进一步面向具身智能场景,强化连续任务轨迹、多模态行为数据以及模型训练数据的生产和加工能力。
具身智能数据还有一个明显特点:不是采得越多,价值就一定越高。如果大量数据都是高度重复、环境单一、任务简单的成功案例,那么它对模型能力提升的价值,未必高于数量更少但复杂度更高、覆盖更广的数据。
现实世界中,机器人会面对物体位置偏移、光照变化、目标遮挡、材质变化、碰撞、抓取失败等大量非标准情况。
因此,真正高价值的数据不仅包括成功轨迹,还包括:失败轨迹、异常轨迹、纠错轨迹和恢复轨迹。这些数据能够告诉模型:什么情况下策略容易失效、错误发生在哪一步、失败后应该继续、回退,还是重新规划。
因此,具身智能的数据价值判断,也正在从“数量”转向场景覆盖度、任务复杂度、有效动作密度、失败样本质量和边界场景覆盖。
围绕这一变化,淘丁数科也在持续强化高价值样本筛选、难例挖掘、异常轨迹识别和数据质量分层等能力,让原始轨迹进一步转化为真正适合模型训练的数据资产。
随着具身智能模型进入真实训练和部署阶段,数据生产模式也在变化。传统模式通常是:定义任务 → 采集数据 → 完成标注 → 数据交付。未来更有效的模式,则会逐步形成:
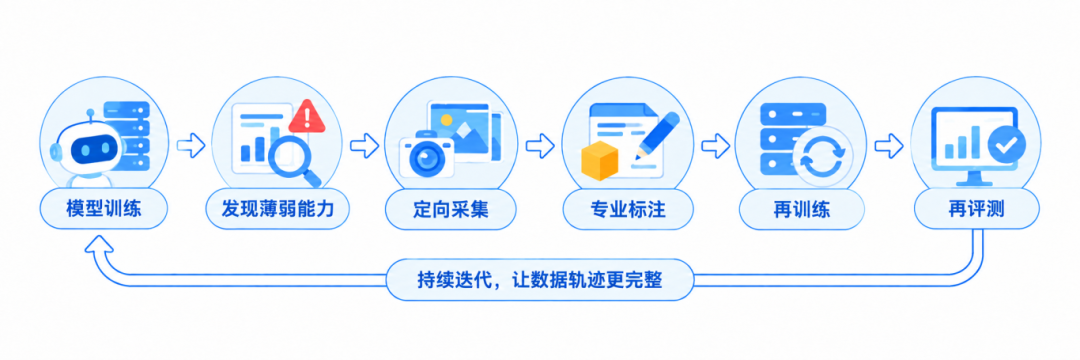
如果机器人在某类抓取任务中频繁失败,就围绕特定材质、姿态、遮挡条件进行补采;如果缺乏异常恢复能力,就重点补充“失败—调整—恢复成功”的完整轨迹。
这与淘丁数科始终坚持的“模数共振”理念高度一致:模型发现问题,数据定向补强;高质量数据再反哺模型。由此,数据生产从一次性交付,进一步走向围绕模型能力持续迭代。
从“看懂世界”到“动手做事”,具身智能数据带来的变化,不仅是机器人能力的提升,更是AI训练数据体系的重构。
数据正在从静态样本走向动态轨迹,从结果数据走向过程数据,从批量交付走向持续迭代。
对淘丁数科而言,这也意味着业务正在进一步向具身智能训练核心环节延伸:从多源数据采集到多模态数据同步,从通用标注到高端数据标注,
从一次性交付到模型反馈驱动的数据闭环。
当人工智能真正开始进入现实世界,“数据”也正在从告诉机器世界是什么,走向教会机器如何成为世界的一部分。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)