ENPIRE——Agent 驱动、补齐自动反馈的自我改进(具身RSI的代表之一):自动成败验证、自动复位、无人值守的策略迭代
前言
最近几个月,RSI很火,学术圈就喜欢造新词,其实RSI也不是突然来的
- 包括π*0.6论文最后也提到,针对RECAP系统,尚未实现完全自动化:它依赖于人工标注和人为干预来提供奖励反馈、操作干预以及回合重置

补充一下:通过本博客中的此文《π∗0.6——通过RL框架RECAP微调流式VLA π0.6:先基于示教数据做离线RL预训练,再SFT(即IL微调),最后在线RL后训练(与环境自主交互,从经验数据中学习,且必要时人工干预)》可知,在通过π*0.6做真机RL迭代的时候,数采时还需通过人工打标(标注成/败)的方式,给予模型反馈 - 那对于一些不那么复杂的任务,是否可以做到自动给奖励反馈呢
事实上,还真有
π*0.6论文最后再次提到,已有多项相关研究探索了自动化这些环节的方法
比如[84]R3L(2020年的工作):其让机器人在真实世界"无需手工设计复位、只靠机载感知、无需手工奖励函数"地持续学习,最终三指灵巧手完全无人干预学会多种视觉技能
但它的 “自动奖励、复位机制、安全约束” 全是人手工为每个任务搭的系统工程,而且只解决 "怎么无人跑起来",不涉及自动改进训练算法
而本文要介绍的ENPIRE的质变在于
- 连"搭建自动化设施"这件事本身也自动化了(coding agent 按任务合成验证器/复位程序/安全约束,人工只给几分钟示范+指标要求),并且多了 Evolution 模块去迭代训练算法本身

- 其与π*0.6的本质区别如下
『当然了,具身 RSI 的天然优势是"物理执行反馈"可以自动拿到,所以 ENPIRE 类工作把可程序验证 + 可程序复位当作能否进入自动闭环的分水岭——能过的走 agent 环,过不去的(柔性体、液体、长程任务)目前还是 RECAP 式人工兜底最通用』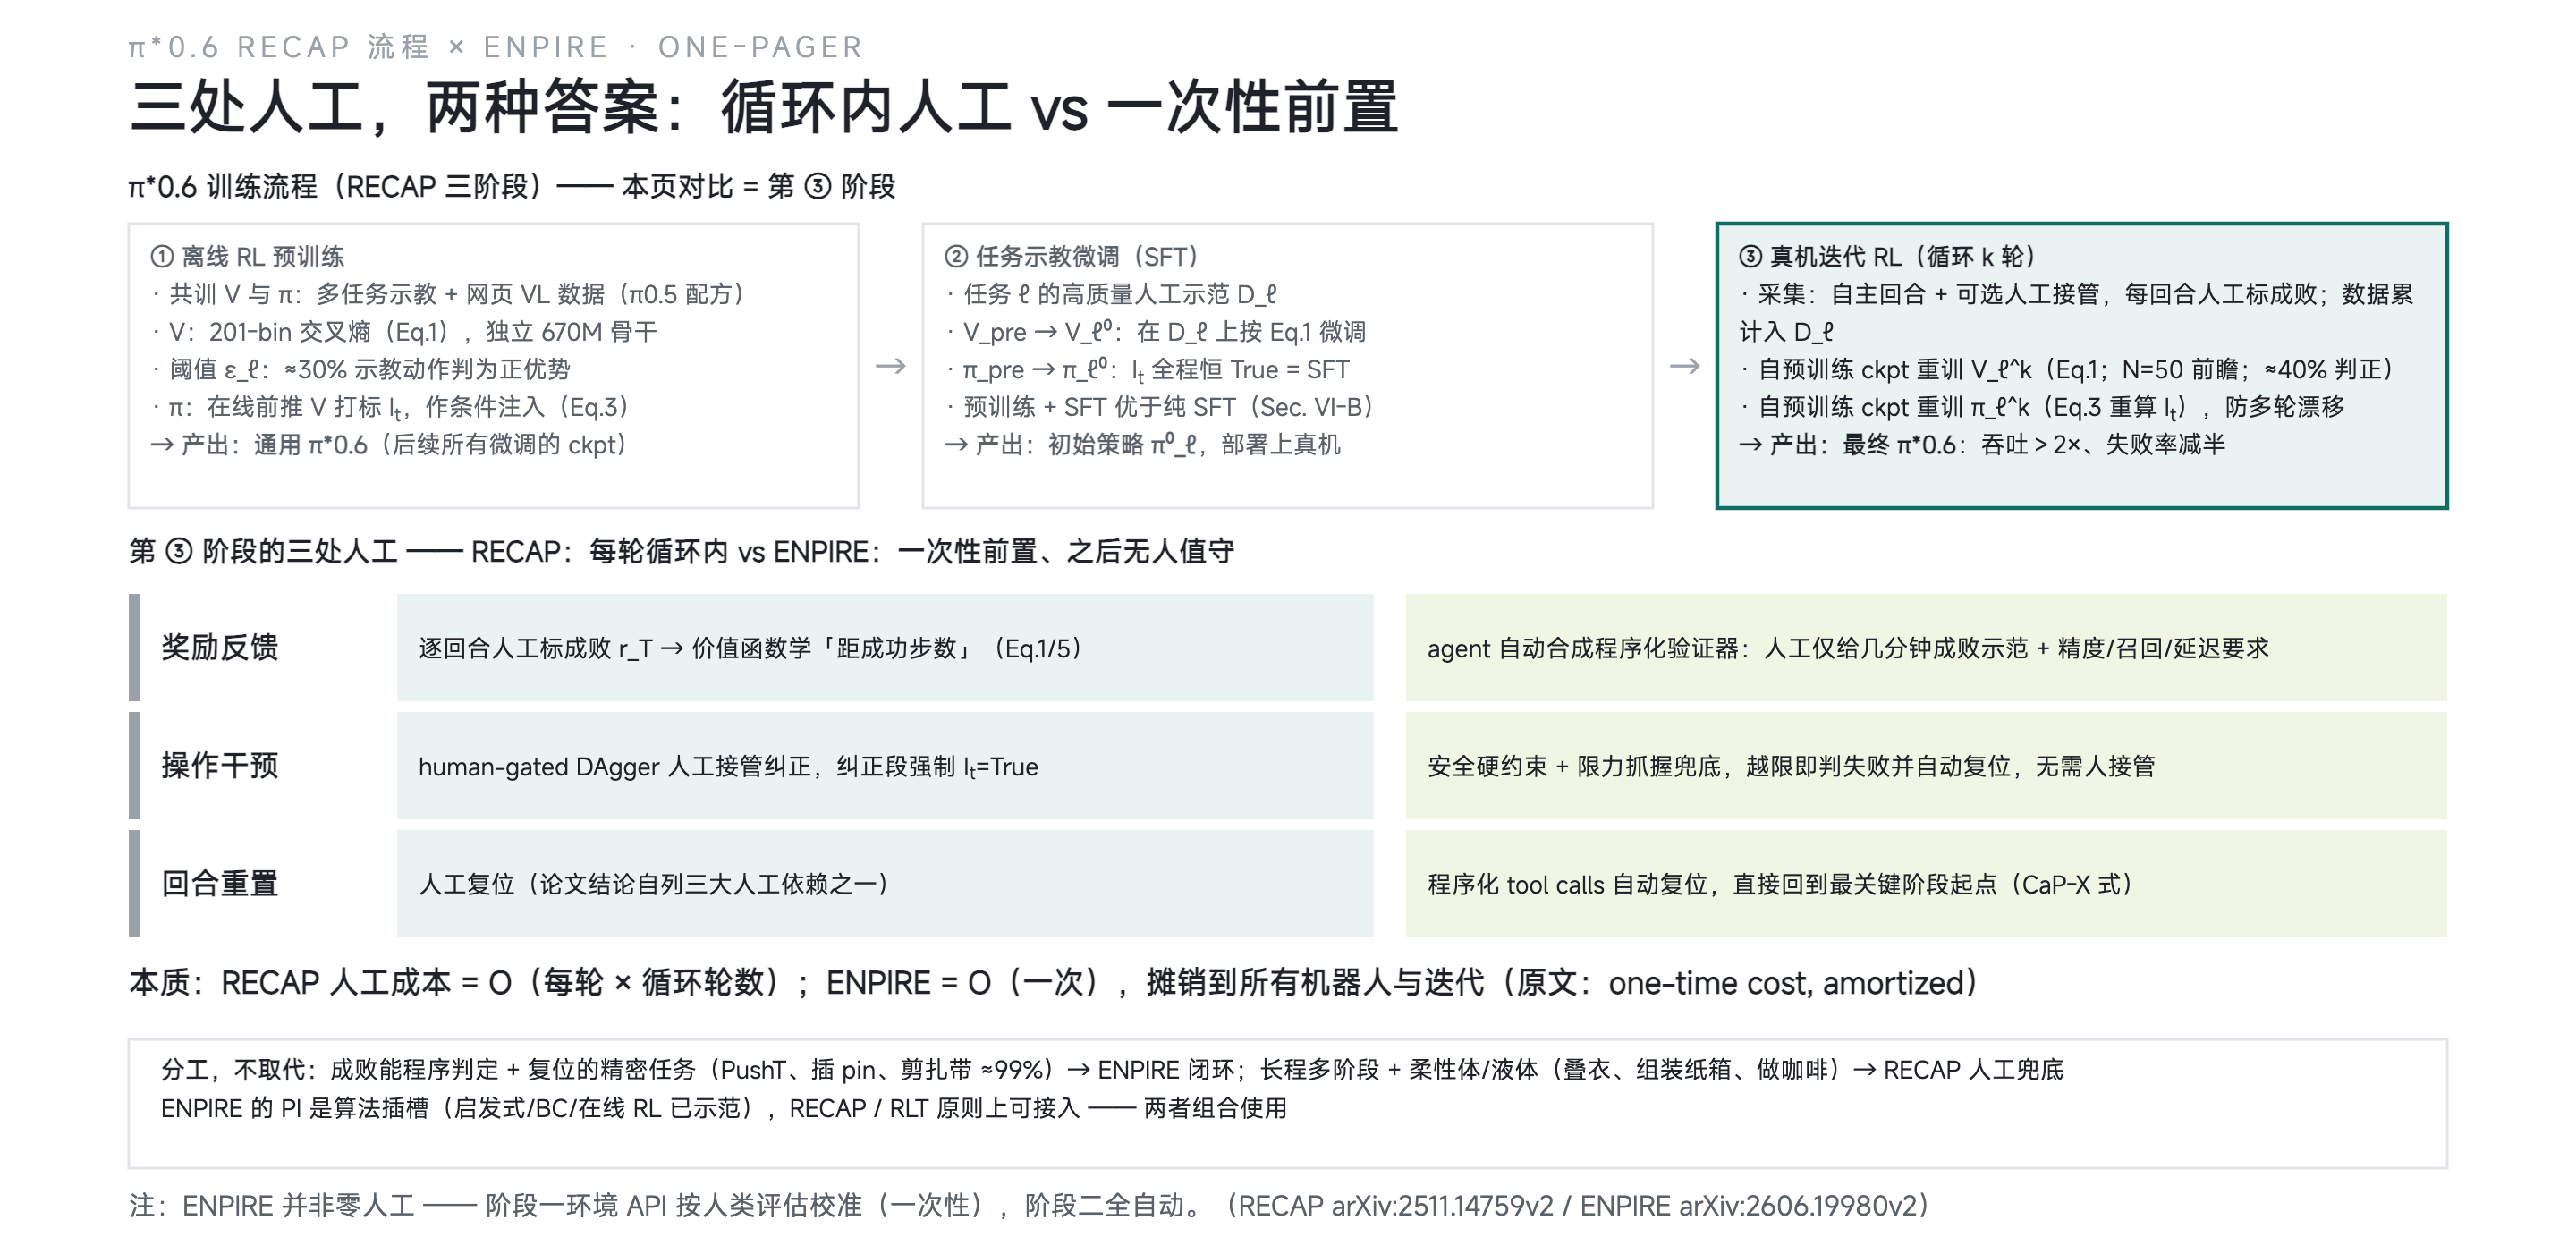
进一步而言,ENPIRE是一个面向编码智能体的控制框架,通过四个核心模块具体实现这一物理反馈流程:
- Environment 模块(EN),用于自动重置与结果验证;
- Policy Improvement 模块(PI),用于启动策略改进;
- Rollout 模块(R),用于在单个或多个并行运行的真实机器人上评估策略;
- 以及 Evolution 模块(E),在该模块中,编码智能体分析日志、查阅文献、改进训练基础设施与算法代码,以应对各类失败模式
这个闭环系统将真实世界的机器人学习转化为一个可控的优化过程,由智能体进行管理,从而最大程度减少人类参与,同时在不同训练方案与智能体变体之间实现公平的消融对比
本文预计10.10日睡觉之前 更新完毕
- 且近期会再解读几篇RSI的最新必读paper,以成为一个系列,然后找机会实践其中一两个
- 再下一个系列是手搓一米二人形(如果你也有意手搓人形,欢迎私我,加入我们深圳具身团队,一起干)系列,博客 + 视频号 + 落地服务 + 硬件产品,越发成为行业不可忽略力量
第一部分 ENPIRE: Agentic Robot Policy Self-Improvement in theReal World
1.1 引言与相关工作
1.1.1 引言
在迈向通用物理智能的道路上,自动学习灵巧操作技能一直是一个重大障碍。当前最前沿的策略训练方法虽然极其高效,但在数据收集、带复位的评估以及算法调参与更新的整个生命周期中,仍然需要人类在幕后参与(19; 20; 24)。随着现实世界策略学习规模的扩大,人类对策略改进过程的“看护”劳动不可避免地成为限制机器人获得灵巧能力速度的关键因素之一
由编码智能体驱动的最新自主研究(22)(autoresearch)进展,为实现算法改进自动化展示了一条前景可观的路径。然而,当作者将这一范式扩展到自动化现实世界的策略学习时,会出现独特的挑战
- 首先,编码智能体缺乏一套用于在物理世界中进行闭环假设检验的现实世界环境接口,而这需要实现策略的自动化部署、评估以及场景重置
- 其次,当在机器人集群规模上扩展 autoresearch的吞吐量时,如何在保持资源利用效率的同时选择和验证假设,仍是一个尚未解决的开放问题
为了解决这些挑战,来自1 NVIDIA、2 CMU、3 UC Berkeley的研究者提出了 ENPIRE

- 其paper地址为:ENPIRE: Agentic Robot Policy Self-Improvement in the Real World
- 其项目地址为:research.nvidia.com/labs/gear/enpire
其github地址为:github.com/NVlabs/ENPIRE
具体而言,这是一种智能体调度框架,利用一组自主的环境接口,实现可扩展的实体自动化研究(physical autoresearch)『ENPIRE 先通过工具调用,根据人类反馈构建一个具备自动复位与自动验证机制的环境。接着,编码代理(coding agent)调用环境 API 开展自研究(auto research),并基于真实世界的奖励信号采用爬山法逐步提升策略的成功率』
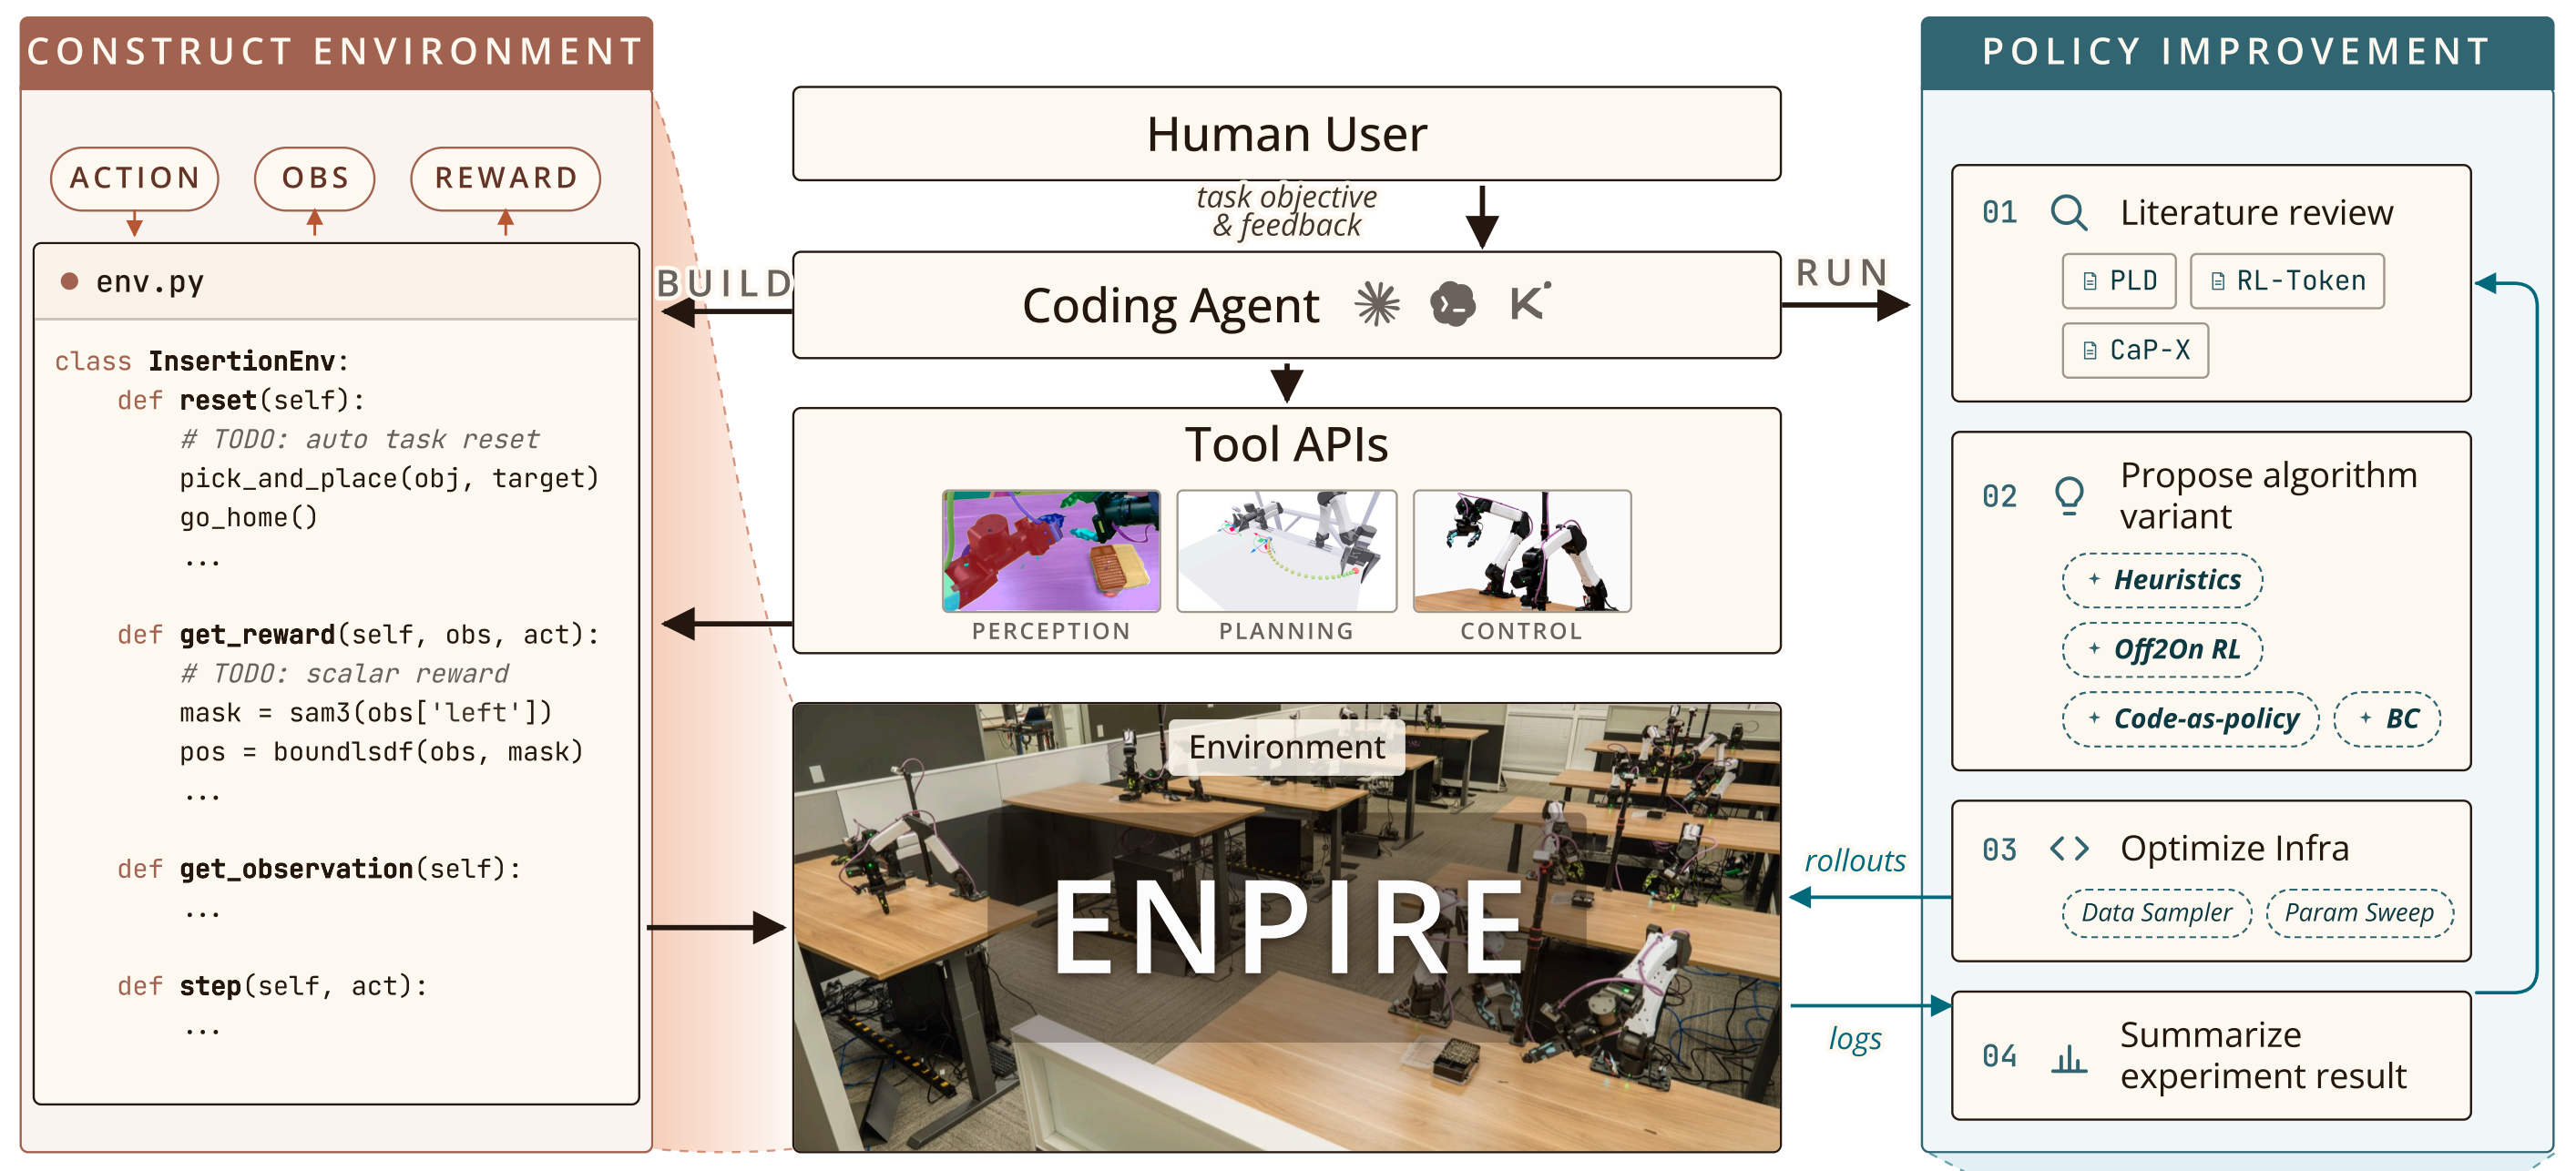
进一步,ENPIRE 将灵巧操作技能的获取分解为两个自动化研究过程
- 在第一阶段(EN in ENPIRE),编码智能体根据人类反馈构建一个自主环境接口
通过这一初始研究闭环,智能体实现并优化一套程序化的工具调用,用于为特定任务建立安全边界、自动复位以及(自动)验证流程
它们在离线条件下一次性优化,仅需一次性部署成本;一旦定型,这些接口就作为不可变的 API,在后续阶段被反复复用 - 第二阶段(PIRE in ENPIRE)则过渡到一个完全自主的自动化研究过程,在这一阶段,编码智能体基于真实世界反馈不断改进策略
在完全由环境自动化验证信号指引的条件下,智能体自主探索和优化多种方法论,在无需人工干预的情况下最大化真实世界任务的成功率
1.1.2 相关工作
首先,对于编码智能体与作为策略的代码
这一系列工作建立在一个核心抽象之上——可执行代码即代理的动作:模型生成程序,运行时返回结构化反馈,然后循环迭代
- Code-as-Policies(25)和 ProgPrompt(41)在机器人领域中首次提出了这种形式,将感知和技能 API 组合成任务规划
而视觉推理则将同样的组合思想扩展到视觉模块上『42-ViperGPT,其让模型生成并执行 Python 代码来组合视觉模块,以完成可解释的视觉推理 』
后续研究将单次生成扩展为由执行反馈驱动的多轮循环——包括
“推理—行动(reason-and-act)”轨迹『51-ReAct,将语言模型的推理轨迹与外部动作交替结合,使智能体能够依据环境反馈进行多轮执行』
自我批判与迭代修复
32-Self-Refine: Iterative Refinement with Self-Feedback,即让模型对自己的输出进行自我批评和迭代修改,在不额外训练的情况下改进结果;
40-Reflexion: Language Agents with Verbal Reinforcement Learning,即让语言智能体把失败经验写成反思记忆,并在后续尝试中利用这些经验改进决
推理时搜索(52-Tree of Thoughts: Deliberate Problem Solving with Large Language Models,即将语言模型推理组织成可搜索的思考树,从而提升复杂问题的求解能力)
以及
学习到的工具调用(37-Toolformer,即训练语言模型自主决定何时、如何调用外部工具,并把工具返回结果纳入后续推理)
————
Wang 等人(45-Executable Code Actions Elicit Better LLM Agents,即论证可执行代码比纯语言更适合作为智能体动作,因为每一步都可以被运行时直接验证)指出,与自然语言相比,代码是一种更强的动作表示,因为每一步都可以在运行时验证
另一条平行的研究线索则形式化agent—计算机接口,即一个沙箱化的 shell,agent可以在其中读取、运行和调试代码,如今已成为前沿编程产品的基础(3-Introducing Claude Opus 4.7;33;35-OpenAI Codex) - 在机器人领域,早期的 code-as-policy 系统暴露的是高层次、由人类设计的 API——封闭形式的技能、以语言为条件的抓取原语以及可供性评分器
比如1-Do as I Can, Not as I Say: Grounding Language in Robotic Affordances,即SayCan 将语言模型的任务分解能力与机器人可供性评分结合,使智能体选择当前真正可执行的高层技能
从而让智能体负责分解任务,而不是合成底层控制
Wang 等人 (44-Voyager: An Open-Ended Embodied Agent with Large Language Models,即在 Minecraft 中通过自动课程、自我验证和可复用技能库,实现接近零成本的开放式具身探索) 通过自验证和一种试验几乎零成本的自动化课程设置,扩展了一个可复用的 Minecraft 技能库;
Fu 等人『15-CaP-X: A Framework for Benchmarking and Improving Coding Agents for Robot Manipulation,即面向机器人操作评测并改进编码智能体,发现多轮反馈、技能合成和集成采样可以提升操作可靠性)』则发现
相比仅依赖底层原语,多轮反馈、技能合成以及集成式采样能够提升操作任务的可靠性
一个相关方向是利用 LLM 来合成辅助训练信号:
奖励函数
31-Eureka,即让大语言模型生成并迭代奖励函数代码,再利用大规模仿真训练结果自动改进奖励设计;
49-Text2Reward: Reward Shaping with Language Models for Reinforcement Learning,即用语言模型根据任务描述生成密集奖励函数,为强化学习提供可训练的辅助信号
53-Language to Rewards for Robotic Skill Synthesis,即将自然语言任务描述转化为奖励函数,再据此合成和训练机器人技能
以及
其次,对于具身智能体的自我改进
一个自我改进循环需要每次试验足够廉价,才能在大规模上反复进行;不同系统之间的主要差异在于,每一次试验会向智能体返回什么
- Ellis 等人(13-DreamCoder,即通过 wake-sleep 学习机制,把已解决的程序合成任务沉淀为可复用的子程序库,奠定“技能随经验积累”的自我改进范式)确立了后续工作所依托的保留模式:每完成一个合成任务,就将命名子程序添加到不断扩展的库中,而这在执行开销几乎为零的前提下是可行的
Wang 等人(44-Voyager)把这一思路带入具身场景,将成功信号替换为 LLM 自我验证和自动课程生成——同样可行,是因为在 Minecraft 中进行 rollout 的成本几乎为零 - Yu 等人(53)、Ma 等人(31-Eureka)以及 Xie 等人(49-Text2Reward)返回的不是技能,而是“奖励”:LLM 提出一个稠密奖励函数,用该奖励训练策略,然后再根据训练统计信息对奖励进行修订——在 Eureka 中,这一循环依靠每分钟数千次 Isaac Gym rollout 得以闭合
Ma 等人(30-DrEureka)则通过合成的 domain-randomization 参数进一步靠近真实硬件,但仍然只在仿真中迭代,仅在修订停止后才部署到现实系统;
在实验设置层面,Wang 等人(46-RoboGen)在仿真中生成新任务和新资产,而Ahn 等人(2-AutoRT)协调的是移动机器人集群,用于离线数据收集,而不是在循环内部进行迭代
在所有这些情况中,循环都是在一种低成本的“基底”上闭合,而真实机器人执行仅作为从模拟到现实(sim-to-real)的迁移或数据采集的目标,从不作为迭代的媒介
作者保留这些技能累积和回报生成机制,但将循环直接运行在硬件上,此时约束资源不再是算力,而是智能体可使用机器人的配额
最后,对于自主研究智能体与科学发现
本部分最终的研究工作实现了对研究闭环本身的自动化,最好的理解方式,是结合实验被启动的媒介一起阅读
- 在 LLM 出现之前,自主系统已经能够在真实实验室硬件上完成“假设—实验”闭环
9-A Mobile Robotic Chemist,即展示了可在真实化学实验室中自主移动并执行实验的移动机器人,实现硬件上的假设—实验闭环
23-Functional Genomic Hypothesis Generation and Experimentation by a Robot Scientist,即早期“机器人科学家”系统,可自动生成功能基因组学假设并执行相应实验
到了 LLM 时代,这类系统则改为对数字化研究闭环实现端到端自动化
26-The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery,即尝试让 AI 自动完成从提出研究想法、实验到论文写作的开放式数字科研闭环
38-AgentRxiv,即探索多个自主科研智能体之间的协作,使研究成果能够被共享、复用和继续推进
39-Agent Laboratory: Using LLM Agents as Research Assistants,即将 LLM 智能体用作科研助手,自动化文献调研、实验执行和报告撰写等数字科研环节
50-The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search,即在 AI Scientist 『详见本博客中的解读《让AI写论文——全流程全自动的AI科学家:基于大模型提炼idea、写代码、做实验且最终写成论文》』的基础上引入智能体树搜索,以实现接近研讨会论文水平的自动化科学发现
而最近一支研究线路又通过实验室自动化
6-Autonomous Chemical Research with Large Language Models,即让大语言模型调用化学工具和自动化实验平台,自主设计并推进化学研究流程
29-Augmenting Large Language Models with Chemistry Tools,即通过接入化学计算与实验相关工具,增强语言模型处理化学研究任务的能力
或
由人类执行的湿实验验证(16-A Multi-Agent System for Automating Scientific Discovery,即用多智能体系统自动化科学发现流程,并由人类执行湿实验验证,属于从数字科研回到物理科学的一条路线),重新切入物理科学领域 - 评测也体现了这一数字化侧重:MLE-bench(11)对机器学习工程智能体及其资源扩展能力进行打分,而对 SWE-bench(21)的分析则警示,性能提升可能更多反映数据污染,而非真实能力提升
由此产生两个空白:
1.2 ENPIRE的完整方法论
总之,作者提出了一种用于让编码智能体在物理世界中执行自动化研究的测试框架设计。该流程被分解为两个阶段:基于人类反馈的环境构建(EN in ENPIRE)以及基于真实世界反馈的自动策略改进(PIRE in ENPIRE)
1.2.1 阶段一:基于人类反馈的环境构建
为了使编码智能体能够开展自主的物理自我研究,作者首先需要将物理交互与反馈抽象为一种对智能体友好的结构化环境。这一环境应包含任务相关的安全约束以支持长期运行、用于反馈与奖励/责任分配的实时自动化验证流程,以及确保快速迭代的稳健自动复位机制
为提升系统可靠性,智能体通过过程化工具调用来构建环境 API,并根据人类评估结果不断改进其实现。人类投入仅为一次性成本,随后在下节(对应于原论文第2.2节)所述的自动策略改进过程中,这一成本将被摊销到所有机器人上的全部实现之中
首先,对于硬安全约束
作者将机器人的构型空间和运动学行为限制在安全的操作范围内。这些安全区域既足以完成任务,又作为硬性约束存在:一旦违反这些限制,将立即判定任务失败并触发自动重置
这样既为真实环境中的交互提供了安全防护,同时也作为回合终止或截断的触发来源
其次,对于自动化验证
- 在真实世界实验中,机器人学习需要依据传感器输入进行实时验证,以量化实验进展
为尽量减少人工工程工作量,编码智能体负责通过过程式工具调用合成一个二值奖励函数,用于区分任务结果
在仅给定几分钟的成功与失败示范的情况下,这些智能体利用视频和本体感知(proprioception)记录,在降低处理时延的同时最大化预测准确率评分 - 例如,autor esearch 会为插销任务发现一个鲁棒的奖励函数,该函数基于视觉对齐、末端执行器高度以及力估计
。编码智能体在 Fig. 4 所示的扎带(zip-tie)插入任务中也展现了其设计依赖感知的奖励函数的能力『扎带插入的回报函数。通过裁剪和图像分割来(自动)检测扎带带身是否穿过扎带头部。考虑了两个相机视角以防止误报』

如原论文附录A.2. 基于自研究驱动的奖励设计所说
- Autoresearch 可以用于自动化设计奖励函数
该流程仅在两个步骤中需要人工投入:
第一,收集几分钟具有代表性的成功与失败示范;
第二,指定奖励设计需求,包括目标精度、召回率以及推理延迟
作为一个示例,作者让智能体构建一个视觉奖励函数,用于检测扎带是否已经扣紧。为了进行评估,作者录制了几分钟带有成功和失败标签的扎带扣紧快照,作为一个沙盒化且保留的评估集——智能体可以研究这些失败案例,但不能在测试集上进行训练,也不能修改度量计算方式
智能体通过提示搜索自主探索 SAM3 API,调节裁剪区域和深度阈值以抑制背景噪声,并通过转换为 ONNX、对计算图进行编译以实现多目标同时前向推理,从而满足 150 ms 的延迟预算
其决策逻辑最终收敛到一个双视图几何测试,如图 4 所示
一个简化的实现见代码片段 3
代码片段 3:双视角扎带验证。将顶部和右侧摄像机视角结合起来,通过几何测试判断扎带的绑带是否穿过扎带头,从而防止仅依赖单一视角时出现的误报
- 自主式研究并不限于视觉奖励;编码智能体可以构造混合奖励函数,将多种传感模态融合在一起,包括本体感受以及末端执行器力估计
举例来说,图9展示了一个由系统自主设计的用于插销任务的奖励函数
该奖励综合了视觉对准、插入深度以及接触力信号『销钉插入任务的奖励函数。智能体提出了一种混合验证策略,将销钉尖端与孔位的视觉对准、由本体感知信号估计的插入深度,以及末端执行器扭矩检测进行融合』


最后,对于自动复位
- 一旦某个任务完成或失败,智能体就会执行一系列工具调用,将环境恢复到其初始状态
对于高接触任务,作者借鉴 CaP-X (15) 中的思路,使用过程化的工具调用,并利用模块化操作技能将环境直接重置到任务中最具挑战性的阶段起点
通过将机器人精确地定位在关键动作(例如插入销钉、安装 GPU、或抓取剪刀)的起始时刻,作者就能有策略地将学习系统的注意力集中在这些对精度要求极高的瓶颈环节上 - 安全约束、自动化验证以及自动化重置共同构成了他们的环境模块(即 ENPIRE 中的 EN)
策略还会接收视觉-本体感受传感器输入,并向机器人控制器提交动作指令,这些指令与作者的奖励函数一起构成了 Rollout 模块(即 ENPIRE 中的 R)
在构建完成后,代码生成代理可以通过不可变的 Gym API (7) 访问这些模块,从而获得反馈信号和调试信息,以实现策略的自动化改进
如原论文附录A.1. 自主复位所示
- 作者展示了在给定任务规格的前提下,编码智能体可以通过组合感知与规划 API 来综合生成具有长时间跨度的复位函数,这些 API 包括
代码片段 1:工具 API:SAM3 多目标分割。从所选相机视角中检测所有查询对象的实例,并返回每个实例的掩膜、置信度评分以及反投影得到的三维质心
以及
在执行过程中,这些复位函数会消费实时 RGBD 数据流和本体感受状态,两者结合用于实现鲁棒的目标物体定位、抓取位姿生成以及运动规划
编码智能体还可以控制和读取夹爪的力矩信号,这些信号可作为触觉反馈的替代;
作者发现,这些信号对于检测滑移以及在对精度要求极高的操作任务中控制抓取力度至关重要- 借助这些 API 工具,编码代理可以综合出多种感知技能,例如语义分割和 3D 边界框生成,以及多种操作技能,包括抓取与放置、物体重新定向、定位以及双臂交接
通过将这些技能与失败检测和重试机制进行组合,可以构造对真实世界扰动具有鲁棒性的长时间跨度复位(reset)函数
代码片段 2 展示了 GPU 插拔任务的一个具体示例:
代码片段 2:重置策略:GPU 插入恢复。使用 SAM3 精确定位主板和目标插槽,以经过扭矩验证的夹持力抓取并拔出 GPU,然后通过 cuRobo 的无碰撞交接,将其运送到停泊姿态
在该任务中,智能体依次调用基于 SAM3 的目标定位、基于 RANSAC (14) 和 OBB (17) 的 3D 边界框估计、扭矩验证抓取,以及基于 cuRobo 的无碰撞交接,将这些步骤串联成一个完整的复位流水线
中间语义分割结果和边界框输出的可视化见图 8


1.2.2 阶段二:基于真实世界反馈的自动化策略改进
第二阶段利用自动化研究来为特定任务训练一个策略。在初始化时,编码智能体会接收到任务描述,其最终目标是通过自主试验最大化该任务的成功率。为此,智能体被授予对一个精简训练代码库的写入权限,该代码库支持基础的端到端策略训练以及基于代码的策略综合
首先,对于一个激励性示例
- 以插销任务为例来演示这一过程:策略需要将插销插入到间隙只有 4mm 的紧配合孔中(图 2)
在这一自动化研究阶段,智能体通过一个策略改进模块(PIinENPIRE)运行,在其中查阅相关文献以生成洞见、提出假设,并直接修改训练代码——例如行为克隆或强化学习(RL)算法——从而根据真实世界的自动验证结果来优化性能 - 为了收集丰富的证据,智能体调用环境 API,在多次 rollout 过程中记录机器人轨迹、视频录制以及回报信号,并检查这些统计数据以指导后续的持续改进
其次,对于通过多智能体扩展加速自动化研究
- 虽然自动复位和验证机制提高了单一部署循环的可扩展性,但通过启动并行的、多智能体的去中心化协作协议,还可以进一步加速物理层面的自动化研究
该协议在 N 台实体机器人上部署 N 个智能体,以异步方式测试 N 个假设。每个智能体都从同一套基线策略训练代码库分支出来,并通过 Git 自主协作,以扩展该进化模块(EinPIRE)
在无人为干预的情况下,智能体会自发地从其他智能体中“挑拣”(cherry-pick)、复制或合并成功的训练配方,以优化其代码搜索
————
作者指出,实证上,他们观察到,随着并行的“智能体-机器人”对数量的扩展,用于发现高成功率策略配方的实际耗时被大幅缩短,如图 3 所示
即ENPIRE 使最先进的编码智能体能够在 Push-T 和 Pin Insertion 任务上实现自主策略改进。ENPIRE 还能随资源规模扩展:随着机器人智能体工作进程数量的增加,实现相同任务性能所需的实际运行时间会减少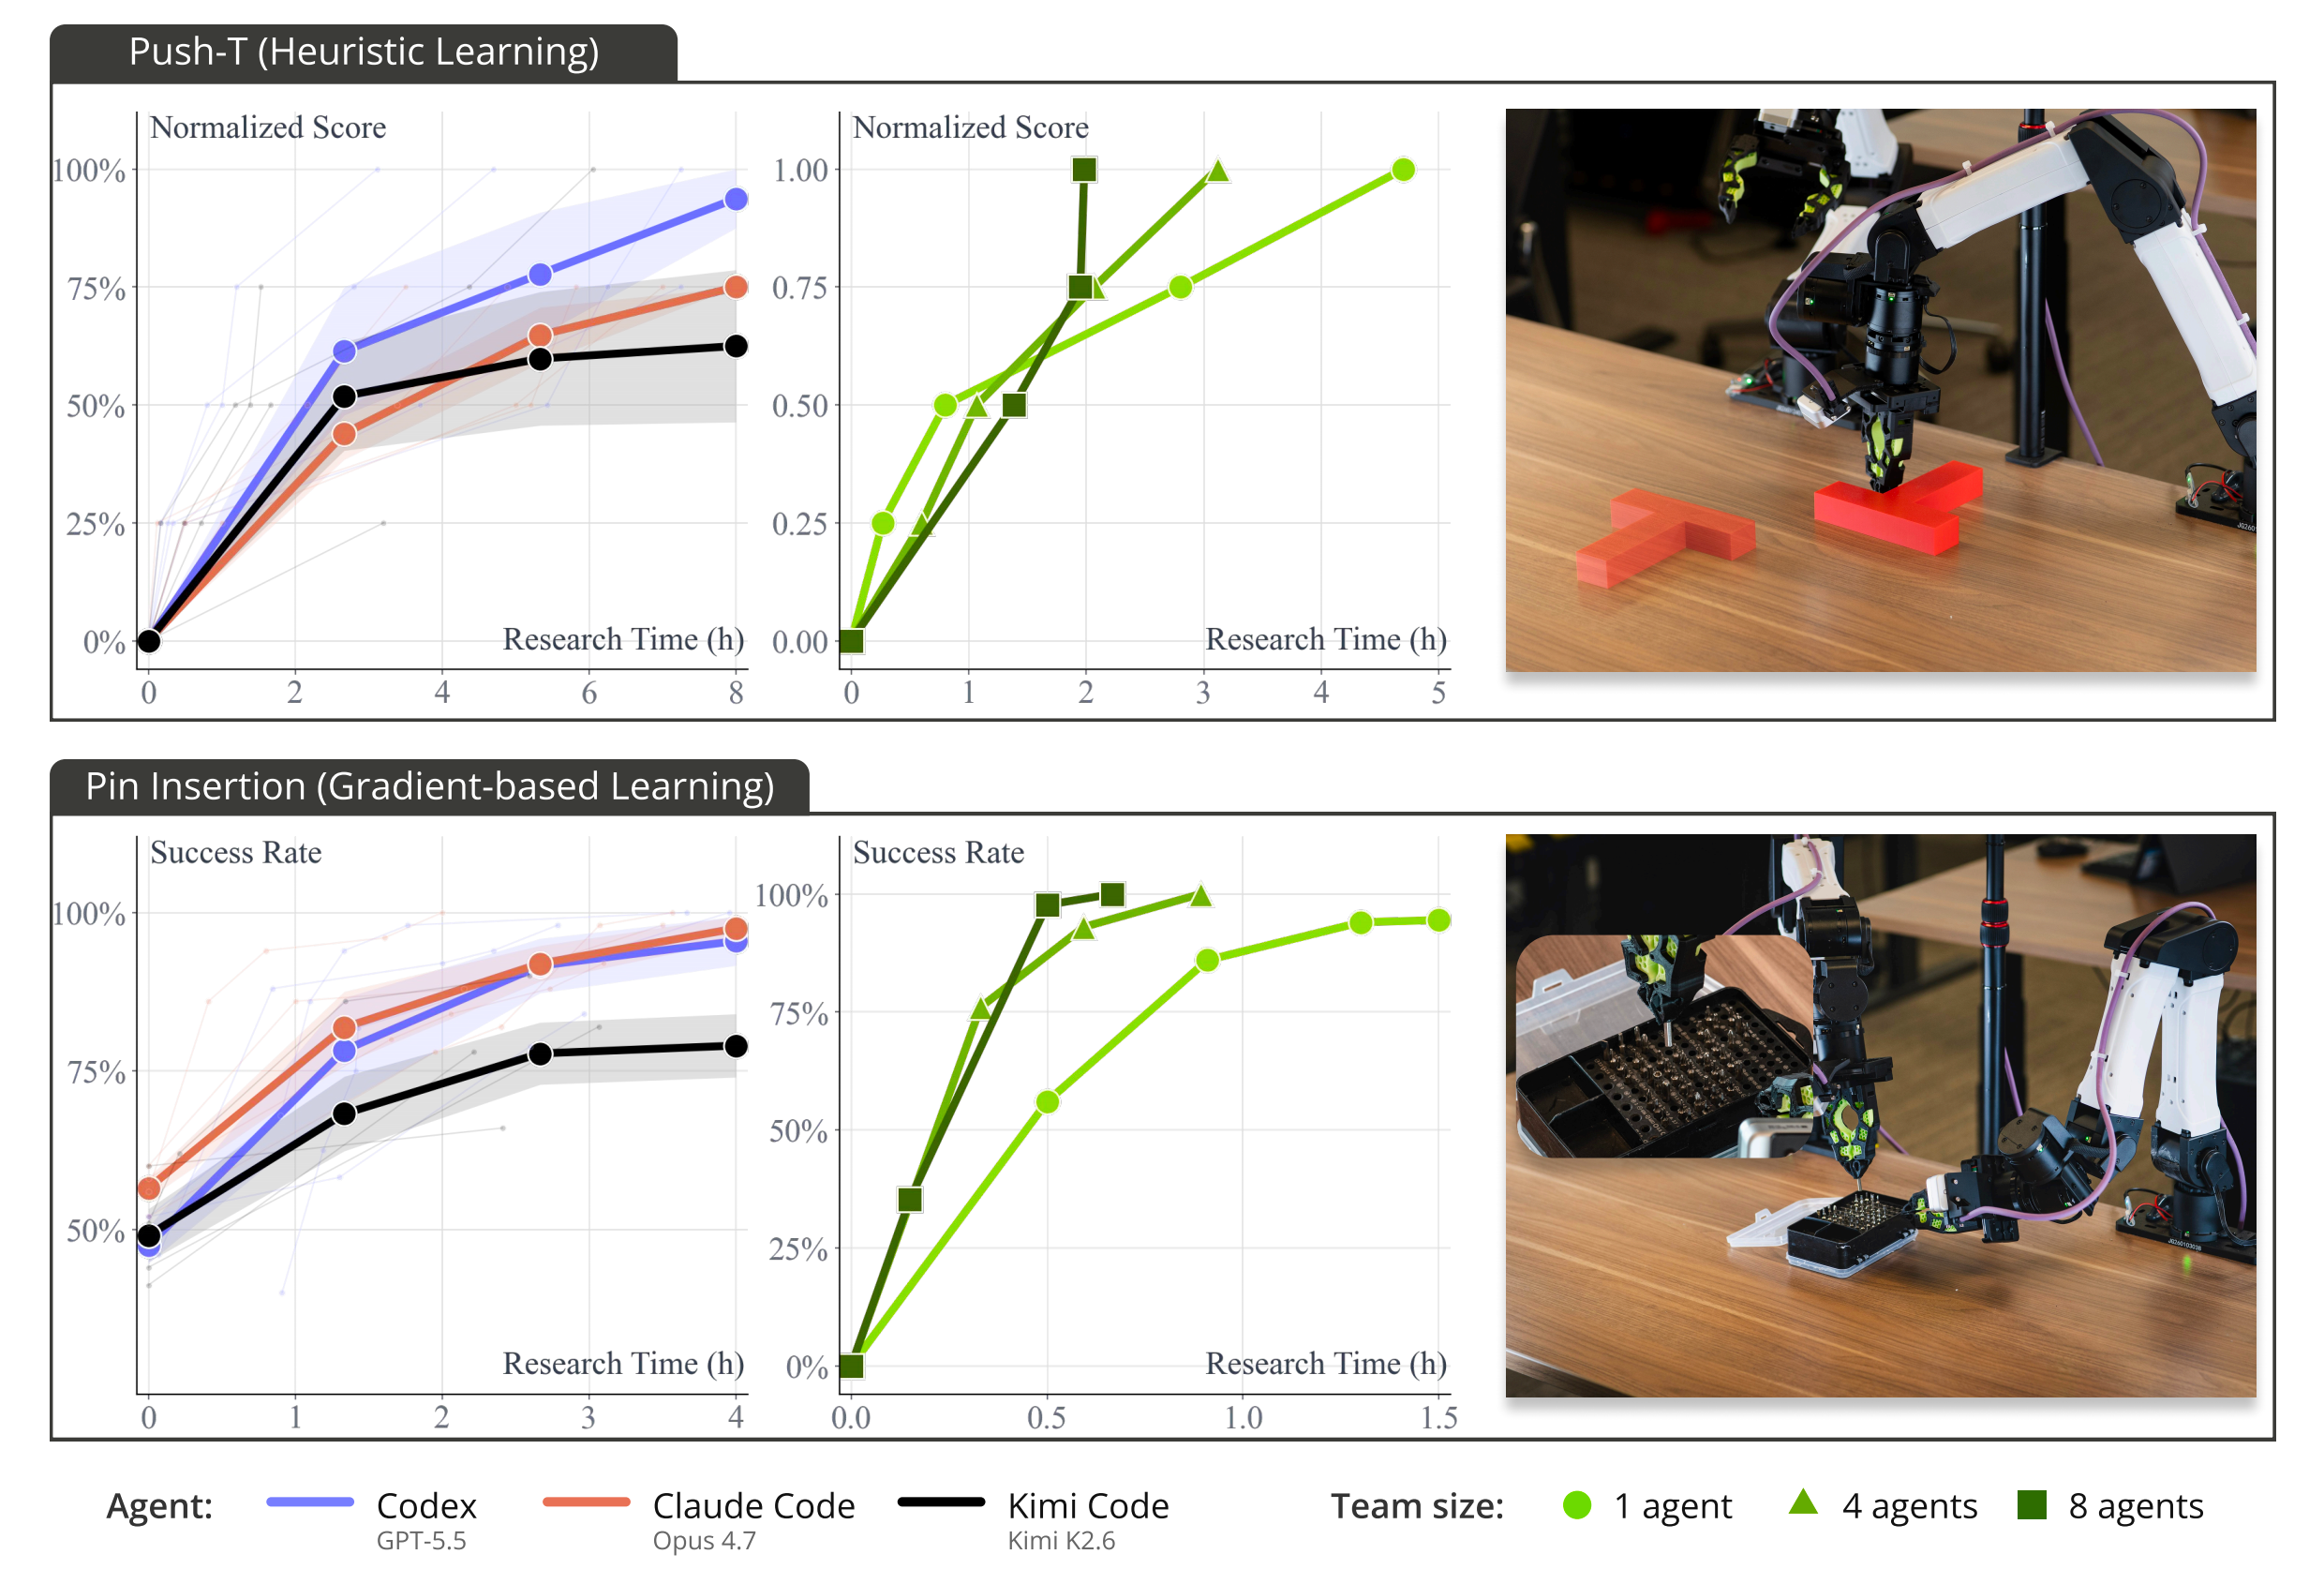
- 为量化编码智能体将其分配到的物理资源转化为研究进展的效率,作者提出了两种补充任务级结果的利用率指标
一个在资源上完全饱和的智能体会将这两个指标都推向 1;但在实际中,对于作者评估的任何前沿编码智能体,这两个指标都没有达到该值
为了衡量一个智能体团队将tokens 转化为成功机器人策略的效率,作者将平均 token 利用率(MTU)定义为整个机群在自动化研究过程中消耗的平均 token 数。然后计算 token-成功比,以体现任务学习的 token 使用效率
关于随着智能体团队规模变化,机器人与 token 利用率如何变化的实证结果如图 7 所示『量化代理的资源利用情况。将代理数量从 1 扩展到 8 会提高 GPU 利用率和 token 消耗,但会降低单个机器人的资源占用率』
1.3 实验
作者宣称,ENPIRE 是一个功能强大且可扩展的智能自主研究框架
- 首先,ENPIRE 在环境构建完成后支持自主策略学习
- 其次,ENPIRE 的成功率收敛速度会随机器人和 token 资源的增多而提升
且作者重点关注以下灵巧操作任务,这些任务都需要基于感知反馈进行精确且快速响应的控制:
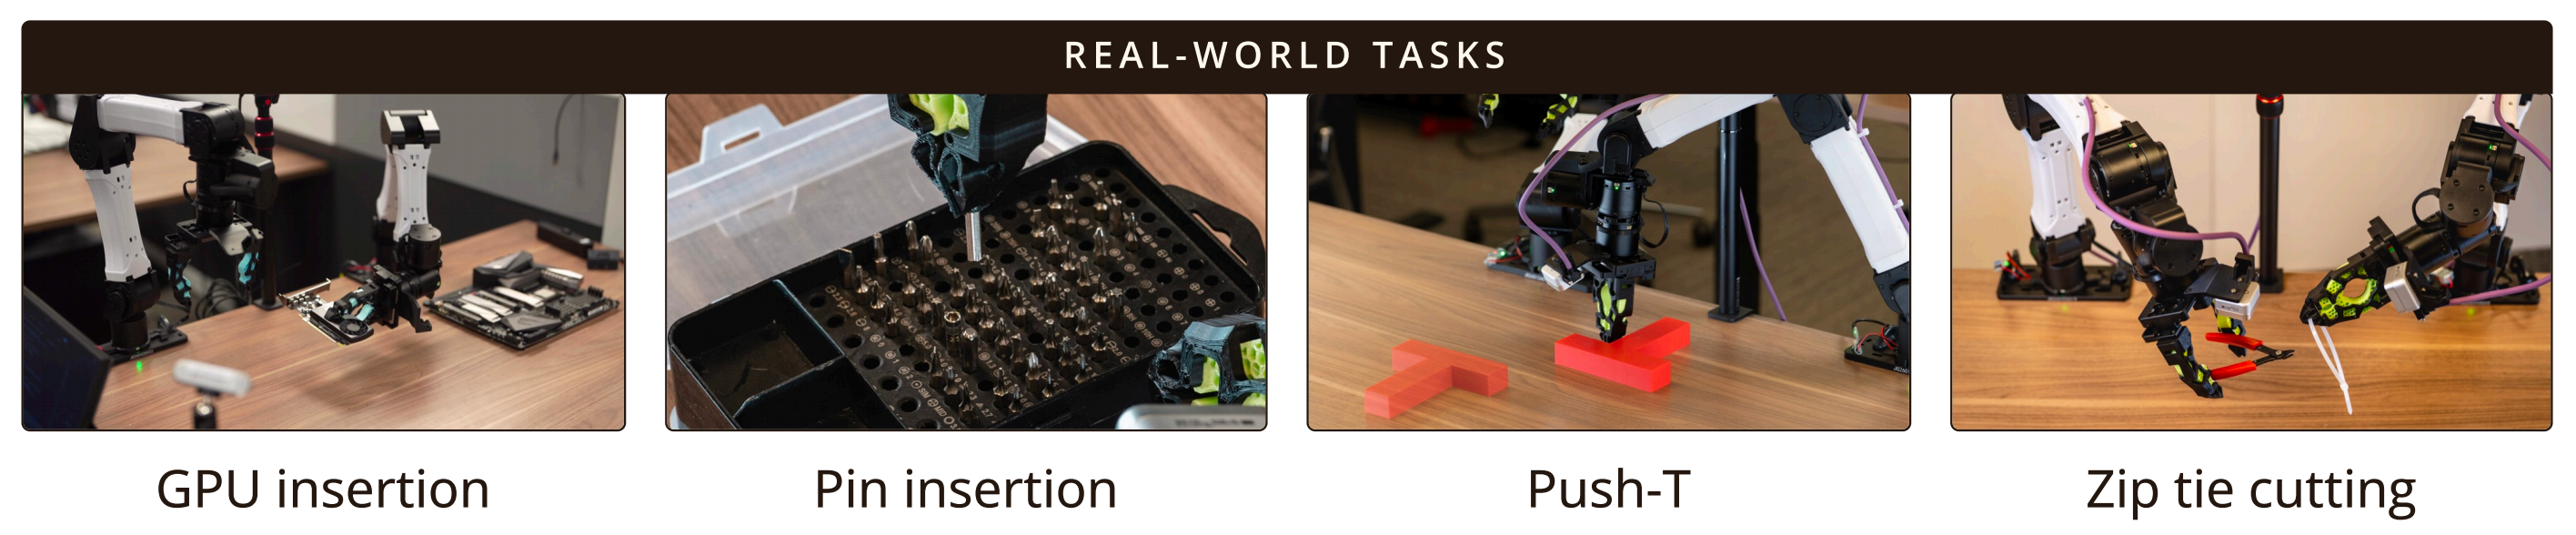
- GPU-insertion(GPU 插装),机器人将 GPU 芯片插入主板上狭窄的插槽;
- Pininsertion(插销),机器人通过将销插入直径为 4mm 的孔中来整理针盒;
- Push-T(12),机器人通过非抓取式(non-prehensile)运动将一个 T 形积木对齐到目标区域
- 以及 Ziptie-cutting(扎带剪切),机器人抓取并合拢剪刀以剪断扎带的尾部
图 2 给出了这些任务的可视化示意
作者将成功率度量为:在给定固定重试次数(此处为 8 次)的前提下,在一次完整 rollout 中完成任务的概率。不同于基于独立同分布(i.i.d.)的 best-of-N 采样度量方式(其中每次尝试都是相互独立的),作者的重试是在“观察到前一次失败之后”进行的,这意味着他们的度量同时刻画了在环境不确定性下的精度以及“上下文内恢复能力”(in-context recovery)
作者强调,对于高度灵巧的任务而言,不仅一次性成功的精度重要,恢复能力同样关键,它反映了在真实世界中实现可靠部署所需的鲁棒性
且使用 ENPIRE 在多种策略学习范式下开展自动化研究。编程智能体可以自由选择多种方法及其组合来解决任务,包括
- 端到端神经网络训练方法(例如行为克隆(BC)(36)
- 或真实世界强化学习(RL)(18))
- 以及无梯度学习方法(例如启发式学习 (47) 和基于代码的策略综合 (25))
至于真实机器人平台是双臂 6 自由度的 YAM 机器人。在物理自动化研究实验中,作者对三种编程智能体进行了基准测试,分别是:使用 GPT-5.5 xhigh 的 Codex (35)、使用 Opus 4.7 High 的 Claude Code (3),以及使用 Kimi K2.6 thinking 的 Kimi Code (33)
1.3.1 自主研究用于启发式学习
作者在最简单的场景下测试了 ENPIRE 推动自动策略改进的能力:通过综合感知和控制工具调用 (25),学习启发式方法 (47)
为此,作者构建了一个真实世界的 Push-T 环境,并配套搭建了其仿真环境以便进行对比
- 如图 5 和图 3 所示,所有编码智能体在仿真环境中都能够通过启发式学习成功解决 Push-T 任务『在仿真环境中的自主启发式学习。在 Gym-PushT (10) 基准测试上,Claude Code(橙色)和Codex(蓝色)在大约 2 小时内即可达到 95% 的成功率,而 Kimi K2.6 Code(黑色)则需要大约两倍的时间』

然而,现实世界环境要困难得多,导致三个智能体的其中两个都会失败。虽然模拟器在物理规律上具有一致性和可预测性,适合进行低方差的假设检验,但真实世界的条件却是非确定性且随时间变化的:诸如机器人动力学、接触摩擦和物体运动等因素本身就不那么可预测,并且会在不同实验和不同硬件之间发生变化 - 为了提升在真实世界中的稳健性,在后续的任务中,作者鼓励智能体去探索并甚至结合多种学习方法,这些方法涵盖启发式算法与基于梯度的学习,以应对真实部署中各种边缘情形
且作者还提议扩展物理智能体团队的规模,以在多样且非确定性的真实物理环境中检验相关假设
1.3.2 基于梯度策略改进的自动研究
除了支持启发式学习之外,ENPIRE 还能够在精度要求极高的任务——销钉插入(如图 3 所示)中训练端到端策略
在该任务中,编程智能体需要在真实环境评估中连续成功 50 次。智能体测试了多种用于改进策略的方法,包括行为克隆(Behavior Cloning,BC)、利用在线 rollout 数据聚合的迭代式 BC,以及带有 BC 正则项的在线、离线和离线到在线(offline-to-online)强化学习(RL)
智能体还调整了诸如 batch size、actor-critic 策略更新频率以及 BC 项超参数等参数
1.3.3 在机器人集群上扩展策略学习
作者进一步研究:在保持目标任务性能不变的前提下,增加机器人和智能体的数量是否能够减少达到该性能所需的wall-clock时间
作者为每台机器人分配一个编码智能体,并在这一整套机器人集群上设置相同的环境接口、奖励函数和重置机制
然后在 Push-T 和插销(pin insertion)任务中考虑由 1 台、4 台和 8 台机器人组成的集群规模
- 在 Push-T 任务中,将智能体数量从 1 个扩展到 8 个,可以将达到 1.0 归一化得分所需的时间从大约 5 小时缩短到 2 小时左右
- 在插销任务中,将智能体数量从 1 个扩展到 8 个,可以将达到近乎完美成功率所需的时间从 1.5 小时以上缩短到约 40 分钟
这表明 ENPIRE 能够通过分布式假设选择,将额外的机器人资源有效转化为更快速的策略改进
在多智能体设置中,ENPIRE 还可以利用基于代码的策略,在重置时自动执行域随机化。例如,与以往工作 (48) 相比,GPU 插入过程中的空间配置变化范围要大得多,从而带来更强的策略鲁棒性
1.3.4 通过具身持续学习迁移自研究经验
作者宣称,他们观察到,多智能体物理自研究所累积的洞见同样可以迁移到相似的、全新的灵巧操作任务中。在完成插销任务的自主探索阶段后,对智能体进行提示,以用于记录和反思其训练配方的演化过程
且作者宣称,当他们为 GPU 插入任务启动新一轮自动化研究(autoresearch)时,将这些知识附加到新任务的指令中,可以使编程智能体取得较高的成功率。附录中提供了详细分析
1.3.5 ENPIRE 发现基于代码的策略与 VLA 之间的协同效应
超越端到端或启发式训练,ENPIRE 可以自动将视觉-语言-行动模型(VLA)(8) 与过程化工具调用相集成,以完成长时序操作任务
- 在 RoboCasa365 模拟器 (34) 中,智能体通过使用运动规划和检测工具,在抓取前先在物体上方悬停,从而提高了 GR00T VLA (5) 的成功率
- 且作者宣称,已成功将这一策略迁移到真实世界场景中,如图 2 所示
智能体学会先在剪刀上方悬停,然后抓取剪刀,并剪断扎带
1.3.6 量化智能体资源利用率
图 7 总结了 ENPIRE 在销钉插入任务中针对单智能体、四智能体和八智能体机群的资源随规模变化行为
- 且作者报告了平均机器人利用率(MRU)和 GPU 利用率,二者的定义如上文(1.2.2 阶段二:基于真实世界反馈的自动化策略改进)所述
- 此外,作者测量平均Token 利用率(MTU),其定义为每分钟消耗的 Token 数量
且作者进一步测量“成功所需 Token 数”和“成功所需时间”,分别量化完成自动化研究(auto research)目标所需的 Token 预算和实际wall-clock time
1.4 局限性
1.4.1 机器人和计算资源未被充分利用
- 在阅读日志、编写代码、调试或等待语言模型底座响应时,编码智能体并未充分利用机器人资源
此外,随着机器人数量的扩展,MRU 会下降,而 GPU 的活跃利用率却会上升(图 7a) - 与单机器人配置相比,由于智能体活动形式的差异,智能体团队会将更多时间花在汇总同伴分支上,而较少时间真正用于操作机器人
编码智能体还可能无法启动足够的并行训练会话来充分耗尽 GPU 资源
1.4.2 随着集群规模增大,Token 成本呈超线性增长
随着集群规模的增加,Token 使用量的增长速度快于理想的线性趋势
- MTU 在最多四个智能体时仍与线性预测值接近,但在八个智能体时急剧上升(图 7b)
- 获得一个成功策略所需的 Token 总预算表现出相同趋势,其增长速度远快于相应的壁钟时间(wall-clock time)缩短速度(图 7c)
因此,增大集群规模实际上是在用 Token 效率换取策略更快改进:更大的集群能更早达到成功,但需要不成比例地更高的Token 预算
// 待更

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 1
 0
- 0


 已为社区贡献130条内容

所有评论(0)