VLA 实战手册(一)从零到把模型跑在自己的机器人上
参考:清华科协 2026 暑培《具身智能:从 VLA 到 World Action Model》讲义(../90_清华科协暑培2026_*.pdf)、LeRobot 官方文档、openpi 官方 README,以及 ../ 目录下的论文。
这本手册怎么读
该内容针对的情况:
1.完全不知道VLA是什么
2.知道概念,想快读跑起来
3.集成传感器雷达等
4.模型跑起来了但不够好
5.遇到不认识的词等
一共有如下几章内容进行:
1.用"五个问题"定位 VLA;它物理上是什么;输入输出是什么
2.看懂任何一张 VLA 架构图:视觉塔、语言底座、动作头;离散 vs 连续动作;动作块与三个 horizon
3.现在能拿到的模型、框架、数据集、仿真器、硬件要求;选型建议
4.示范数据长什么样;数据金字塔;LeRobotDataset 格式;怎么录;多少条够
5.SmolVLA 和 π0/π0.5 两条微调流水线;关键超参;归一化陷阱;怎么判断训好了
6.推理循环;策略服务器;动作块怎么执行;延迟预算;MCU 在哪一层;安全
7.新增一路观测的两条路;遥操作设备;跨本体动作适配
8.模仿学习之后:DAgger、人工接管、RL 的现实用法
9.分阶段清单、常见坑、自测题
第 1 章 VLA 是什么
VLA(Vision-Language-Action model)是一种神经网络模型。它接收摄像头画面(Vision)和一句自然语言指令(Language),直接输出机器人接下来一小段时间的动作(Action)。
它不是平台、框架、算法库或方法论。平台是 PyTorch、LeRobot、openpi 这些代码;方法论是"端到端""模仿学习"这些思想。VLA 是这些工具和思想最终产出的那个东西——硬盘上几百 MB 到几 GB 的权重文件,加载进显卡之后,喂进去图和文字,吐出来一串数字。
1.2 它取代了什么
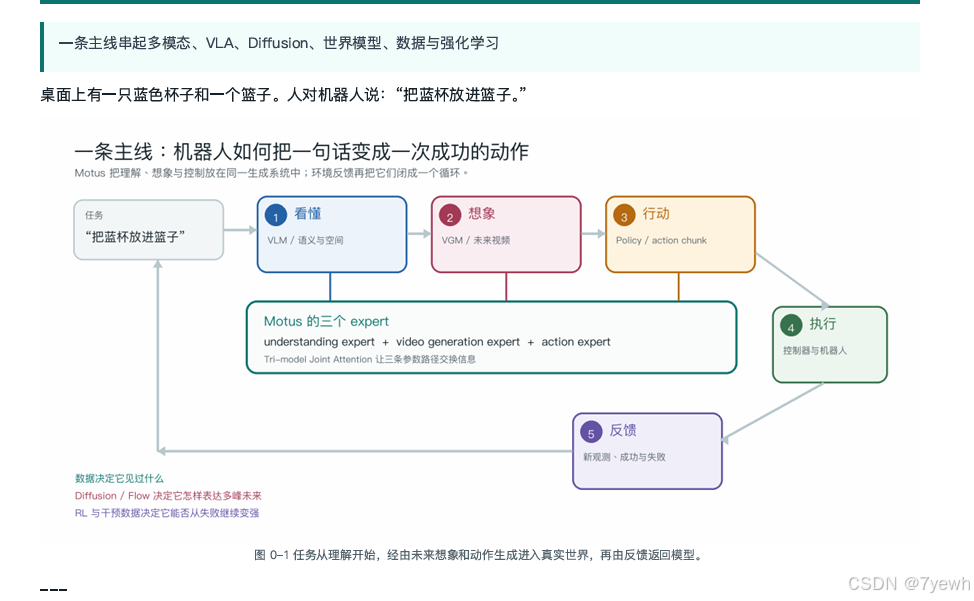
以"把蓝色杯子放进篮子"为例:
传统流水线(每一块都是人写的程序,换任务要重写)
相机 → 目标检测(找杯子)→ 位姿估计(杯子在哪、朝向)→ 抓取规划(手从哪抓)
→ 运动规划(臂怎么过去不碰东西)→ 逆运动学(关节角)→ 控制器 → 电机
VLA(一个模型,换任务换句话)
相机画面 + "把蓝杯放进篮子" + 当前关节角 → [ VLA ] → 未来 1 秒的关节目标序列 → 控制器 → 电机
中间一整串人写的模块被一个模型吃掉了。代价是:模型是黑盒,它为什么这么动说不清;它只会做训练数据覆盖过的事,没见过的情况靠"举一反三"的程度决定成败。
1.3 用"五个问题"给 VLA 定位
清华暑培讲义里有个很好的框架:围绕同一个任务,机器人可以问五个不同的概率问题,每个问题对应一类模型。记号:当前画面 o,指令 l,未来 k 步动作 a,未来视频 v。
| 机器人在问什么 | 数学上在建模 | 这类模型叫什么 | 在任务里的含义 |
|---|---|---|---|
| 现在该怎么动 | p(a | o, l) | VLA / 策略(policy) | 从画面和指令直接生成一段动作 |
| 执行这组动作会看到什么 | p(v | o, a) | 世界模型(World Model) | 预测动作造成的视觉后果 |
| 已知画面这样变了,动作可能是什么 | p(a | o, v) | 逆动力学模型(IDM) | 从状态变化反推动作 |
| 任务成功时未来画面长什么样 | p(v | o, l) | 视频生成模型(VGM) | 生成语言条件的视觉计划 |
| 能不能让画面和动作一起生成 | p(v, a | o, l) | 世界-动作模型(WAM,如 Motus) | 同时约束"看起来合理"和"真的可执行" |
本手册只讲第一行。 其他四行是 2025–2026 年的前沿方向,知道它们存在、知道它们和 VLA 的区别就够了。特别注意:世界模型不输出动作,它预测未来画面;VLA 输出动作。两者可以配合(用世界模型造训练数据、或让 VLA 先在脑子里预演),但是两种模型。
1.4 它物理上是什么
一个 VLA 交付给你的时候,就是一个目录:
smolvla_base/ ← Hugging Face 上下载下来的样子
├── config.json ← 网络结构超参(多少层、动作维度、输入哪些相机)
├── model.safetensors ← 权重,450M 参数 ≈ 0.9 GB(bf16)
├── train_config.json ← 训练时用的配置
└── ...
π0 是 3.3B 参数(约 6.6 GB),OpenVLA 是 7B(约 14 GB)。这就是为什么推理要显卡、微调要大显存。
1.5 输入输出到底是什么
以 SmolVLA(LeRobot 官方小模型)为例,一次推理:
输入(一个 Python 字典):
| 键 | 内容 | 形状 |
|---|---|---|
observation.images.front | 正面相机当前帧 | 3×H×W,uint8 或归一化 float |
observation.images.wrist | 腕部相机当前帧(可选,可多路) | 3×H×W |
observation.state | 机器人当前本体状态:关节角 / 末端位姿 / 夹爪开度 | 一维向量,如 6 或 7 维 |
task | 语言指令 | 字符串 "Grasp a lego block and put it in the bin." |
输出:
| 键 | 内容 | 形状 |
|---|---|---|
action | 未来 n 步的动作目标 | n × 动作维度,如 50 × 6(50 步 × 6 关节) |
动作的物理含义由你的数据集决定:数据里录的是关节角,模型输出的就是关节角;录的是末端位姿增量,输出的就是增量。模型本身不知道"关节"是什么,它只是学会了"这样的画面 + 这句话 → 这样一串数字"的映射。
1.6 "语言"在里面真正的作用
初学者常以为 L 只是"多了一路文字输入"。实际上有两层:
-
下任务。没有语言通道,一个模型只能做训练时固定的那一件事;有了语言,同一个模型靠换指令做很多件事。
-
接入互联网知识。VLA 的底座是一个已经读过海量互联网图文的大模型(VLM,如 PaliGemma、Qwen-VL、Llama+SigLIP)。机器人数据只是在这个底座上续训。所以 VLA 认识没在机器人数据里出现过的物体、听得懂没训练过的说法——这些是从互联网来的。
这是 2023 年 RT-2 之后机器人突然"开窍"的根本原因:不是加了语言输入,而是整个底座换成了懂世界的大模型。
1.7 它怎么被训练出来
主流 VLA 的训练方式是模仿学习(行为克隆):人示范几十到几百遍,录下"画面 + 指令 + 当时人让机器人做的动作",模型学"看到这种画面听到这句话就该做这个动作"。
不是强化学习那种让机器人自己瞎试、撞坏东西慢慢学。RL 在 VLA 里是可选的后续精调,第 8 章讲。
训练分两级:
| 级别 | 谁做 | 数据量 | 产出 |
|---|---|---|---|
| 预训练 | Google / PI / HF / NVIDIA 这类机构 | 几千到上万小时、几十种机器人 | 基座模型(base checkpoint),你下载的就是它 |
| 微调 | 你 | 自己机器人上 50~几百条示范 | 适配你的机器人和任务的模型 |
你几乎永远不会从零预训练一个 VLA。你的工作是:下载基座 → 录自己的数据 → 微调 → 部署。
第 2 章 VLA 的内部结构 —— 看懂任何一张架构图
2.1 三个部件
所有 VLA 都是下面这三块的变体:
相机画面 ──► [① 视觉编码器] ──► 视觉 token
语言指令 ──► 文本 tokenizer ──► 文本 token
本体状态 ──► 线性层 ──► 状态 token
通过,得到
[② 多模态骨干 (VLM)] ──► 语义特征 ──► [③ 动作头] ──► 动作块
| 部件 | 干什么 | 常见选择 | 类比 |
|---|---|---|---|
| ① 视觉编码器 | 把图像切成 16×16 的小块(patch),每块变成一个向量(token) | SigLIP、DINOv2、ViT;OpenVLA 把 SigLIP+DINOv2 两个拼起来 | 眼睛 + 视神经 |
| ② 多模态骨干 | 一个 Transformer,让视觉 token、文本 token、状态 token 互相"看",提炼出"场景里有什么、要干什么" | PaliGemma(π0/SmolVLA)、Llama 2(OpenVLA)、Qwen-VL、Eagle(GR00T) | 大脑皮层 |
| ③ 动作头 | 把骨干的输出变成具体的动作数字 | 离散 token 头 / 扩散头 / flow-matching 动作专家 | 运动皮层 |
token 这个词贯穿始终:Transformer 只处理"一串向量",所以图像、文字、关节角都要先变成向量序列。一张 224×224 图 → 196 个视觉 token;一句话 → 十几个文本 token;7 个关节角 → 1 个状态 token。它们拼成一串送进骨干。
2.2 动作头的两大流派
这是不同 VLA 之间最本质的区别,也是读论文时最容易晕的地方。
流派 A:离散动作 token(自回归)
把每个动作维度的取值范围切成 256 格,动作变成"第 137 格"这样的整数,当作一个"字"让语言模型像写文章一样一个字一个字吐出来。
-
代表:RT-2、OpenVLA
-
优点:不改语言模型结构,完全复用 VLM 的训练基础设施
-
缺点:一个 7 维动作要吐 7 个 token,50 步动作块要吐 350 个 token,慢;每维独立离散化切断了维度之间的关联;256 格精度有限
流派 B:连续动作生成(扩散 / flow matching)
把动作块当成一个整体的连续向量(比如 50 步 × 7 维 = 350 个数),用生成模型"从噪声中逐步去噪"出来。
-
代表:Diffusion Policy(纯扩散)、π0 / π0.5 / SmolVLA(flow matching)、GR00T N1(扩散)、RDT-1B(扩散 Transformer)
-
优点:一次生成整段平滑轨迹,快;能表达多峰分布("从左绕"和"从右绕"都是对的,不会输出两者的平均撞上障碍物)
-
缺点:需要一个额外的"动作专家"网络;推理要跑多步去噪(通常 10 步左右)
为什么要生成模型而不是直接回归? 讲义 3.1 节讲得很清楚:如果用 MSE 回归,数据里一半从左绕一半从右绕,模型学到的是均值——正好撞上障碍物。生成模型保留了"多个可行答案",每次采样落到其中一个。
中间路线
-
FAST(π0-FAST 用的):把连续动作块做 DCT 变换再压缩成少量 token,让自回归模型也能高效输出高频动作。
-
OpenVLA-OFT:保留 OpenVLA 结构但改成并行解码 + L1 连续回归 + 动作块,速度快 26 倍。
-
VLA-0:动作直接写成文本数字字符串让 VLM 输出,不加任何特殊头,居然也能 SOTA——提醒我们"动作头的形式可能没那么关键,数据和底座更关键"。
实用结论:2025 年之后新项目基本都选流派 B。你微调 SmolVLA 或 π0 时,动作头已经定好了,不用自己选;但要知道推理时它会跑约 10 步去噪,这决定了延迟。
2.3 动作块(action chunk)与三个 horizon
VLA 不是每一帧算一个动作,而是一次吐未来一段动作。这里有三个必须分清的时间长度:
时间轴 ──────────────────────────────────────────────►
│◄── To ──►│◄──────── Tp ────────►│
│ 观测历史 │ 预测的动作块(如 50 步)│
│◄─ Ta ─►│
│ 实际执行│ 然后重新观测、重新预测
| 符号 | 名字 | 含义 | 典型值 | 调大会怎样 | 调小会怎样 |
|---|---|---|---|---|---|
| To | observation horizon | 喂给模型几帧历史 | 1~2 帧 | 更多上下文,更慢 | 没有记忆 |
| Tp | prediction horizon | 一次预测多少步 | 50 步(π0 在 50 Hz 下 = 1 秒) | 轨迹更连贯 | 更频繁重规划 |
| Ta | execution horizon | 预测的里面实际执行几步 | 10~25 步 | 反馈变慢、对突发不敏感 | 推理压力大、动作可能不连续 |
这是滚动时域控制(receding horizon):预测 Tp 步,只执行前 Ta 步,然后读新观测再预测。Ta 是部署时最重要的可调参数之一,第 6 章再讲。
2.4 把主流模型放进这个框架
| 模型 | ① 视觉 | ② 骨干 | ③ 动作头 | 参数量 | 一句话特点 |
|---|---|---|---|---|---|
| RT-2 (2023) | ViT | PaLI-X / PaLM-E | 离散 token | 55B | VLA 概念起点,闭源 |
| OpenVLA (2024) | SigLIP + DINOv2 | Llama 2 7B | 离散 token,256 格 | 7B | 第一个完整开源 VLA |
| Octo (2024) | 小 CNN | 自己的小 Transformer | 扩散头 | 93M | 模块化,加传感器方便 |
| π0 (2024) | SigLIP(在 PaliGemma 里) | PaliGemma 3B | flow matching 动作专家 300M | 3.3B | 当前开源最强范式 |
| π0.5 (2025) | 同上 | 同上 | 同上 + 高层子任务推理 | 3.3B | 开放世界泛化 |
| SmolVLA (2025) | SigLIP(在 SmolVLM 里) | SmolVLM2,只用前半层 | flow matching 动作专家 | 450M | 消费级显卡可微调 |
| GR00T N1 (2025) | Eagle VLM | 同上 | 扩散头 | 2B | 双系统,人形全身 |
| RDT-1B (2024) | SigLIP | 扩散 Transformer | 扩散 | 1.2B | 双臂,物理可解释统一动作空间 |
读架构图时的检查清单:
-
找到视觉编码器是哪个(决定输入分辨率和画面理解能力)
-
找到骨干是哪个 VLM(决定语言理解和互联网知识来源)
-
动作头是离散还是连续(决定速度和精度)
-
动作块多长、什么频率(决定控制特性)
-
本体状态怎么进去的(通常是一个线性层变成 token,拼在后面)
-
有没有"双系统"(GR00T、Helix 那种慢 VLM + 快动作头分开跑)
2.5 一个容易忽略的部件:归一化
动作和状态进模型之前都要归一化(减均值除标准差,或缩放到 [-1, 1])。这些统计量随数据集走:
-
LeRobot 存在
meta/stats.json -
openpi 存在
norm_stats.json,训练前要跑compute_norm_stats.py
这是微调时最常见的翻车点(第 5 章详述):某个维度在数据里几乎不动(比如一个很少用的关节),标准差接近 0,归一化后数值爆炸,训练 loss 发散。
归一化的原图如下:
原因一:不同维度的数值尺度差太多,神经网络会"偏心"
神经网络的第一层是矩阵乘法:输出 = W × 输入 + b。如果一个维度是 ±180、另一个是 0~1,那么前者对输出的影响天然大 180 倍——不是因为它更重要,纯粹因为数字大。梯度也一样:大数值维度的梯度大,小数值维度的梯度几乎为零,训练时模型拼命学关节角、基本忽略夹爪。而夹爪开合恰恰是抓取成败的关键。归一化后所有维度都变成"均值 0、标准差1"左右的数,模型对每个维度一视同仁,该学哪个由数据决定,而不是由你用什么单位决定。
原因二:输出端——模型要生成的目标也得在"舒服的范围"
VLA 的动作头是 flow matching / 扩散,它的工作方式是"从标准高斯噪声(均值 0 方差1)逐步变成目标动作"。这个过程的数学设计默认目标分布和噪声分布在同一个尺度上。如果目标动作是 200~600 毫米,而噪声是 ±1,模型要学会把 ±1 的东西拉到400,非常别扭,训练慢且不稳。先把动作归一化到 ±1 附近,去噪过程就自然了,推理时再反归一化回毫米。离散 token 流派(OpenVLA)也一样:它要把每个维度切成 256 格,必须先知道这个维度的最小最大值,否则没法切。那个"最小最大值"就是归一化统计量。
原因三:预训练和微调要对得上
基座模型是在别人的数据上预训练的,它内部已经形成了"归一化后的数值 → 动作含义"的映射。你微调时如果不归一化、或者用了不同的统计量,等于把一套新的数值含义硬塞给它,预训练学到的东西大半作废。openpi 文档里专门有一节讲"复用预训练的 norm stats",就是为了让你的机器人和它预训练集里的同款机器人共享同一套数值语义,微调收敛更快。
正常维度归一化后都在 ±2 以内,这个维度突然蹦出9.9。更极端的情况,某个关节整条数据集几乎没动,标准差 0.001,一个微小抖动 0.05 归一化后就是 50,直接把 loss 炸飞。这就是 openpi troubleshooting 里说的"检查 q01、q99、std"——它用 1% 和 99% 分位数代替最大最小值,就是为了抗这种极端值,但标准差太小时依然救不了,只能手动改大或者让关节在录数据时动起来。
第 3 章 生态地图 —— 现在能拿到什么、该选什么
截至 2026-10。这个领域半年一变,具体版本号以官方仓库为准,但分类框架不会变。
3.1 四类东西
基座模型(权重)下载来微调 【SmolVLA, π0, π0.5,OpenVLA, GR00T N1.x,Octo, RDT-1B, Dexora】
训练/推理框架(代码)跑命令的地方【 LeRobot (HF) ,openpi (PI) ,openvla / openvla-oft,Isaac GR00T】
数据集 预训练用/参考格式【Open X-Embodiment,DROID, BridgeV2,AgiBot World ,RoboTwin, LIBERO 数据】
仿真/评测 没硬件时验证流程【LIBERO ,SimplerEnv,RoboTwin 2.0 ,RoboCasa, ManiSkill】
3.2 基座模型对比(能开源下载的)
| 模型 | 参数 | 推理显存 | 微调显存 | 框架 | 适合谁 | 不适合 |
|---|---|---|---|---|---|---|
| SmolVLA | 450M | ~4 GB | 单张消费级卡(RTX 3090/4090 可) | LeRobot | 入门首选;单臂桌面任务;SO-100/101 这类低成本臂 | 复杂长程任务、双臂 |
| π0 / π0.5 | 3.3B | >8 GB (4090) | LoRA >22.5 GB (4090);全量 >70 GB (A100/H100) | openpi(JAX 为主,PyTorch 版不支持 LoRA) | 要效果最好;有 A100 或多卡 | 只有一张 12 GB 卡 |
| OpenVLA / OFT | 7B | ~16 GB | LoRA 约 24 GB+ | openvla 仓库 | 学术对比基线;大量安全/评测研究用它 | 实时性要求高(原版慢) |
| Octo | 93M | <2 GB | 很小 | octo 仓库(JAX) | 想自己加传感器模态、改结构做研究 | 语义理解弱(骨干小) |
| GR00T N1.5 / N1.6 | 2~3B | RTX 3080+ | 24 GB+ | Isaac GR00T | 人形、全身、NVIDIA 生态;官方有 SO-101 后训练教程 | 纯桌面臂(过重) |
| RDT-1B | 1.2B | ~8 GB | 24 GB+ | rdt 仓库 | 双臂(ALOHA 类) | 单臂简单任务 |
| Dexora | — | — | — | 自带 | 双臂双灵巧手 | 没灵巧手 |
选型三句话:
-
第一次跑,选 SmolVLA + LeRobot。文档最全、硬件门槛最低、从录数据到部署一条命令链打通。
-
要效果,选 π0.5 + openpi。但要有 A100 级显卡或接受远程推理。
-
做人形 / 全身,选 GR00T;做双灵巧手,看 Dexora / GR-Dexter。
3.3 框架对比
| LeRobot | openpi | Isaac GR00T | |
|---|---|---|---|
| 维护方 | Hugging Face | Physical Intelligence | NVIDIA |
| 语言 | PyTorch | JAX(主)+ PyTorch(部分) | PyTorch |
| 数据格式 | LeRobotDataset v3(事实标准) | 也用 LeRobotDataset | 自己的格式 + LeRobot 转换 |
| 内置模型 | ACT、Diffusion Policy、π0、π0.5、SmolVLA、VQ-BeT 等 | π0、π0-FAST、π0.5 | GR00T 系列 |
| 录数据 | lerobot-record(支持 SO-100/101、Koch、ALOHA、LeKiwi 等) | 不管录,只管训和推 | 有自己的工具 |
| 训练 | lerobot-train | scripts/train.py | 自己的脚本 |
| 推理 | lerobot-rollout(直接驱动机器人) | serve_policy.py 策略服务器 + websocket 客户端 | 自己的 |
| 系统 | Linux / macOS(录数据) | 只测过 Ubuntu 22.04 | Linux |
| 包管理 | pip / conda | uv | pip |
LeRobotDataset 是整个生态的"通用货币":openpi 也吃它,GR00T 能转它,HF Hub 上几千个数据集都是它。第 4 章专门讲。
3.4 数据集(预训练用,或当格式参考)
| 数据集 | 规模 | 机器人 | 用途 |
|---|---|---|---|
| Open X-Embodiment (OXE) | 100 万+ 轨迹,22 种机器人 | 多种 | 几乎所有基座的预训练来源 |
| DROID | 76k 轨迹,564 个场景 | Franka | 泛化性好,π0-DROID 检查点来源 |
| BridgeData V2 | 60k 轨迹 | WidowX | 小臂桌面任务经典 |
| AgiBot World | 100 万+ 轨迹 | 智元人形 | 国内最大开源 |
| RoboTwin 2.0 | 仿真生成 | 双臂 | 国内,仿真数据 |
lerobot/svla_so100_pickplace | 50 条 | SO-100 | SmolVLA 官方微调示例,格式参考 |
3.5 仿真与评测(没硬件时的验证场)
| 仿真器 | 特点 | 什么时候用 |
|---|---|---|
| LIBERO | 130 个任务,4 个套件,VLA 论文标配 benchmark | 验证微调流程通不通;和论文对数 |
| SimplerEnv | 真实-仿真对齐,可评 OXE 预训练模型零样本 | 评基座模型本身 |
| RoboTwin 2.0 | 双臂,国内,带数据生成 | 双臂任务 |
| ManiSkill 3 | GPU 并行,快 | 大规模仿真数据 |
| DexJoCo | MuJoCo 灵巧手 | 灵巧手任务 |
注意:仿真里跑通 ≠ 真机能用。仿真的价值是验证"数据格式 → 训练 → 推理"这条链路没有 bug,以及快速对比不同配置。真机效果只能真机测。
3.6 硬件(低成本入门平台)
| 平台 | 价格量级 | 自由度 | LeRobot 支持 | 说明 |
|---|---|---|---|---|
| SO-100 / SO-101 | ¥1000~2000 一对(主从) | 6 | 原生 | HF 官方推荐,3D 打印 + 飞特舵机 |
| Koch v1.1 | 类似 | 6 | 原生 | SO-100 的前身 |
| LeKiwi | 加底盘 | 6 + 移动 | 原生 | 移动操作 |
| ALOHA / ALOHA 2 | ¥数万 | 双臂 14 | 支持 | 双臂标杆 |
"主从臂"(leader/follower):LeRobot 默认的遥操作方式。人手动掰主臂,从臂跟着动,录的是从臂的关节角。这就是最便宜的"遥操作设备"。你的 EMF 手套是另一种遥操作设备(第 7 章)。
3.7 显卡怎么办
| 你有什么 | 能做什么 |
|---|---|
| 没有 N 卡 | SmolVLA 用 Google Colab 免费 T4 微调(官方有 notebook);推理用 CPU 勉强可以但很慢 |
| RTX 3060 12 GB | SmolVLA 微调(batch 调小);π0 推理勉强 |
| RTX 4090 24 GB | SmolVLA 随便训;π0 推理 + LoRA 微调 |
| A100 80 GB | π0 / π0.5 全量微调 |
| 云 GPU(AutoDL、阿里云等) | 按小时租 A100,微调一次几十块钱 |
远程推理是现实选择:模型跑在机房 / 云上的显卡,机器人旁边只放一台小电脑(甚至树莓派)通过 websocket 收动作。openpi 原生支持,延迟增加几十毫秒。
3.8 信息源
-
Hugging Face LeRobot 文档:huggingface.co/docs/lerobot
-
openpi 仓库:github.com/Physical-Intelligence/openpi
-
LeRobot Discord:遇到报错最快的地方
-
论文追踪:arXiv cs.RO,关键词 VLA / vision-language-action
-
模型对比表:roboticscenter.ai/tools/vla-models-comparison
-
国内:具身智能之心、RoboTwin 社区

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)