从去餐厅猜口味到智能决策:贝叶斯推断的餐厅故事
从猜口味到智能决策:贝叶斯推断的餐厅故事
举例:第一次去一家餐厅,不确定好不好吃,但看到门口排长队,就觉得“应该不错”。这种“根据新信息不断更新判断”的思考方式,其实就是贝叶斯推断的核心思想。
一、 贝叶斯定理的诞生:逆概率的追问
18世纪,英国有一位名叫托马斯·贝叶斯的牧师。他不仅对神学感兴趣,还痴迷于数学。他思考了一个问题:如果知道了一个事件的结果,能否反推出导致这个结果的原因的概率?
举个例子:当时人们已经知道,如果一枚硬币是均匀的,抛10次出现7次正面的概率可以用数学算出来(这叫“正向概率”)。但贝叶斯想的是:如果抛了10次,出现了7次正面,这枚硬币是均匀的概率是多少? 这就是“逆概率”问题。
把这个思想放到餐厅故事里:假设一家餐厅的菜品如果好吃,那么顾客排队的概率是90%(正向概率)。但如果看到一家餐厅门口排长队,这家餐厅真正好吃的概率是多少?这就是贝叶斯要解决的逆概率问题。贝叶斯生前没有发表这个想法,直到他的朋友在他去世后将论文公之于众。后来,数学家拉普拉斯独立发现了同样的原理,并将其推广。这就是我们今天熟知的贝叶斯定理。
二、 公式背后的故事:先验、似然与后验
贝叶斯定理的公式看起来很简单:
P(θ∣D)=P(D∣θ)P(θ)P(D) P(\theta|D) = \frac{P(D|\theta)P(\theta)}{P(D)} P(θ∣D)=P(D)P(D∣θ)P(θ)
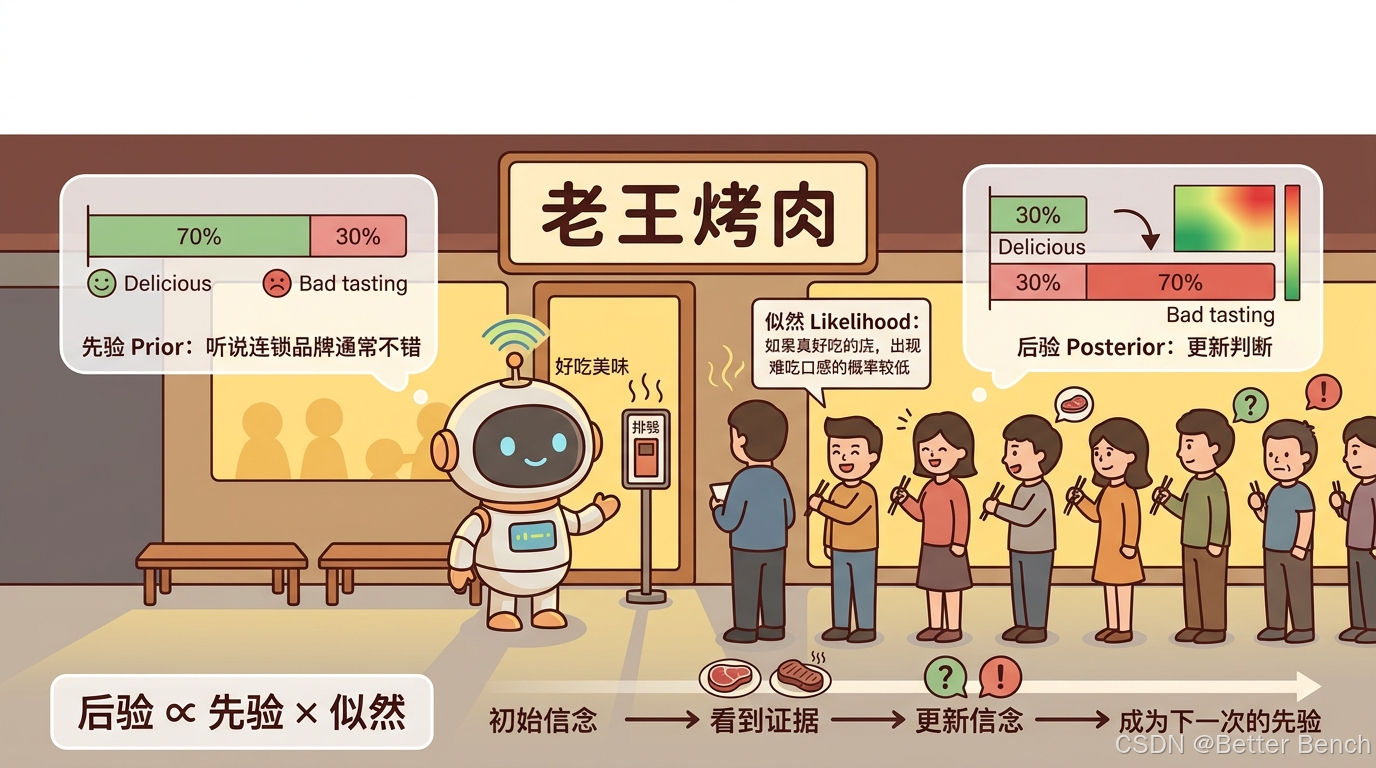
但每一个符号背后,都藏着一段“信念更新”的故事。我们用一个“智能送餐机器人评价餐厅”的故事来拆解。假设机器人需要判断“老王烤肉”这家店好不好吃(参数 θ\thetaθ 表示“好吃”或“难吃”),它收集的数据 DDD 是“吃到的第一口肉很柴”。
1. 先验(Prior)P(θ)P(\theta)P(θ):初始信念
在去“老王烤肉”之前,机器人听说这是一家全国连锁品牌。根据以往对连锁餐厅的统计,这类餐厅好吃的概率是70%。机器人把这个经验总结成一个概率分布,这就是先验。它代表了在看到任何新数据之前,对未知参数的信念。
零基础理解:先验就是“先入为主”的想法,但这个想法是有依据的(比如历史数据、品牌口碑)。
2. 似然(Likelihood)P(D∣θ)P(D|\theta)P(D∣θ):证据的说服力
机器人点了一份招牌烤肉,吃了一口(传感器数据),发现肉质很柴,调味一般。如果这家餐厅真的好吃(参数为“好吃”),那么吃到这么柴的肉的可能性只有10%。这个“在已知参数下,观测到数据的概率”就是似然。它衡量了数据对参数的支持程度。
零基础理解:似然就像是在说:“如果这家餐厅真的好吃,那么眼前这个难吃的证据出现的可能性有多大?”
3. 后验(Posterior)P(θ∣D)P(\theta|D)P(θ∣D):更新后的信念
机器人把先验(连锁品牌70%好吃)和新数据(第一口很柴,且好吃餐厅出次品概率10%)结合起来,得到了更新后的信念:这家餐厅好吃的概率从70%降到了30%。这就是后验。
零基础理解:后验就是“吃”进了新证据后的判断,它比先验更准确,因为它既包含了经验,又包含了当前的数据。
4. 归一化常数 P(D)P(D)P(D):让概率加起来等于1
分母 P(D)P(D)P(D) 是一个归一化因子,确保“好吃”和“难吃”的概率总和等于1。在实际计算中,它往往很难直接求出来,但这并不妨碍使用近似方法。
三、 为什么需要贝叶斯推断?—— 与频率学派的对比
有人可能会问:“为什么不直接用数据算一个平均值,而非要搞这么复杂?”
这涉及到统计学中两大流派的分歧:
- 频率学派:认为参数是一个固定的值。他们通过大量重复实验,用频率来估计概率。比如,让机器人去这家餐厅吃10次,如果有8次难吃,就断定它难吃。如果只吃了1次难吃,频率学派可能觉得没法下结论。
- 贝叶斯学派:认为参数本身就是一个随机变量。他们愿意把“先验知识”纳入计算。比如,即使机器人第一次吃觉得难吃,但因为它是连锁品牌(先验),机器人不会一棍子打死,而是给出一个概率分布,认为“可能今天厨师状态不好,再试一次好吃的概率仍有30%”。
贝叶斯推断的优势:在数据稀缺、噪声大、或者需要持续学习的场景下(比如机器人探索新餐厅),它能把人类经验(先验)和数据(似然)完美融合,得到更稳健的结论。
四、 当公式算不出来时:近似推断的故事
理想情况下,如果先验和似然都是简单的分布,后验可以解析求解。但现实中,影响餐厅口味的变量太多(食材、厨师、时间、心情),真实的后验分布极其复杂,根本写不出公式。
这时候,故事的主角就变成了近似推断。有两种主流方法:
1. 变分推断(Variational Inference, VI):找一个“替身”
真实的后验分布像一个形状怪异的石头。变分推断的做法是:用一个简单的、熟悉的形状(比如一个高斯钟形曲线)去尽可能贴近那块石头。然后通过优化算法,调整简单形状的参数,让它和真实后验越像越好。
- 优点:速度快,适合大规模数据。
- 缺点:毕竟是近似,可能会丢失一些细节。
2. 马尔可夫链蒙特卡洛(MCMC):用“随机点餐”画地图
MCMC 的思路更暴力:机器人在餐厅里随机点餐,走足够长的时间后,它点过的菜品口味就能勾勒出这家餐厅口味的完整轮廓。著名的 Metropolis-Hastings 算法就是干这个的:如果下一道菜比当前的菜好吃,就接受;如果难吃,也有一定的概率接受(以探索新菜品)。
- 优点:精度极高,理论上能还原任何后验。
- 缺点:计算慢,需要点很多道菜才能收敛。
五、 贝叶斯推断在机器人学习中的实际应用
现在,让我们把目光投向真实世界,看看贝叶斯推断是如何在餐厅场景中大显身手的。
1. 状态估计:卡尔曼滤波(Kalman Filter)
想象一个送餐机器人在餐厅里穿梭。它通过轮子转动(先验)和摄像头看到的地标(似然)来估计自己的位置。每次收到新数据,就相当于用贝叶斯公式更新一次位置(后验)。这就是卡尔曼滤波,它是贝叶斯推断在线性高斯假设下的完美解析解,高效且稳定,是现代控制系统的基石。
2. 贝叶斯逆强化学习(Bayesian IRL)
想象一个机器人观察人类食客在餐厅的行为(比如排队、点菜、给小费),试图推断人类的“奖励函数”(比如“好吃最重要”还是“环境最重要”)。贝叶斯 IRL 把奖励函数当作未知参数,用贝叶斯推断从专家演示中找出最可能的奖励函数,并且还能给出奖励的不确定性。这样,机器人就知道哪些行为是“必须学的”,哪些是“可以变通的”。
3. 离线强化学习中的分布约束
假设机器人从之前人类收集的餐厅评价数据中学习如何推荐菜品。为了防止机器人推荐数据集中没有的奇怪菜品(比如“烤肉配冰淇淋”),算法会用一个 KL 散度(一种分布距离)来约束学习策略与行为策略的分布距离。这本质上就是在做贝叶斯推断:把人类常点的菜(行为策略)当作先验,学习策略(推荐新菜)当作后验,强制它们不能差太远,从而避免“分布偏移”导致的崩溃。
六、 总结:贝叶斯思维的核心
贝叶斯推断不仅仅是一堆公式,它更是一种持续学习、不断修正的思维方式。它的思维链条可以概括为:
- 提出初始信念(先验:听说这家连锁品牌不错)
- 收集新证据(数据:第一口肉很柴)
- 用证据更新信念(似然 → 后验:好吃概率从70%降到30%)
- 后验变成新的先验,继续学习(下次来这家餐厅,30%就是新的起点)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献31条内容

所有评论(0)