深度误差降低87.7%!浙大高飞团队TADreamer:让两栖机器人先“脑补”再校准
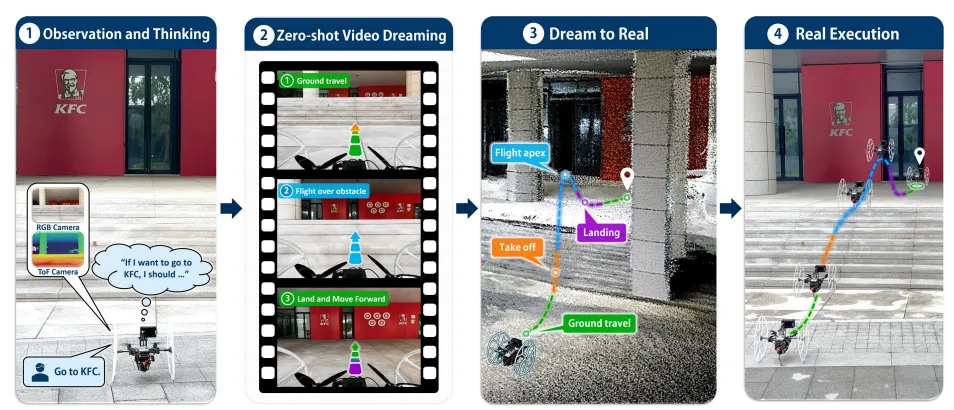
「把“想象推演”和“实测校准”拆开」
目录
空地两栖机器人最核心的决策不是避障,而是判断眼前的地形到底该走还是该飞。草地可以碾过去,台阶必须起飞,但几何地图只看高度,分不清这两者的区别。
浙大高飞团队提出的TADreamer,把“想象”和“实测”拆开:
用视频生成模型推演完整行动过程,再用机载ToF点云做两级几何校准,把想象视频里的路径转化为真实尺度下的可执行航点。
整套系统零样本部署,在7组室内外真实场景完成实机验证,平均绝对深度误差比NavDreamer降低87.7%,实现语言指令驱动下地面行进、越障起飞、降落接续的完整两栖导航流程。
01 两栖机器人导航现存的现实矛盾
1.1 现有三类主流方案的短板
空地两栖导航不只是找一条无碰撞路径,还要同步决策行进模式:什么时候走地面,什么时候起飞越障。现有技术路线各有明显短板:
- 纯几何规划方案 依靠深度、点云地图做碰撞检测。只能识别几何高度,缺少语义理解。草地、缓坡在几何上会被判定为障碍物,触发不必要起飞;柔性帘子这类几何障碍物实际可以通行,却不敢靠近。模式切换完全依赖几何阈值,缺少对场景意图的理解。
- VLM语义增强导航 利用视觉大模型评估可通行性,输出地标、目标点或者更新占据地图。能够读懂语言指令和场景语义,但缺少时序推演能力,无法完整想象“先地面行驶、起飞越障、再降落”这一套连续多模式运动序列。只能输出离散目标,不能得到完整想象轨迹。
- 视频想象类导航(NavDreamer) 生成视频来推演未来导航画面,把视频重建得到航点交给规划器。但生成视频存在两大硬伤:一是单目重建尺度模糊;二是存在轴相关各向异性畸变,X/Y/Z不同坐标轴缩放系数不一样,单一全局尺度因子无法对齐真实世界,想象出来的轨迹尺度错乱,直接拿去执行会发生碰撞。
TADreamer的核心取舍:不直接信任生成视频自带几何,把视频仅作为语义‑运动想象源;真实度量信息由机载ToF实测点云提供。VLM负责生成、筛选、修正想象视频;再通过两阶段配准校准,修正重建点云的各向异性缩放、旋转和平移,得到物理上可信的航点与地面/飞行模式标签,再下发规划器执行。
02 TADreamer完整技术链路
整套流水线分为VLM引导视频生成与迭代筛选、视频几何重建、两阶段点云尺度配准校准、模式感知轨迹生成四大模块。文中零‑shot含义为:VLM、视频生成模型、DA3深度重建模型全部使用预训练权重,不做导航任务专项微调。
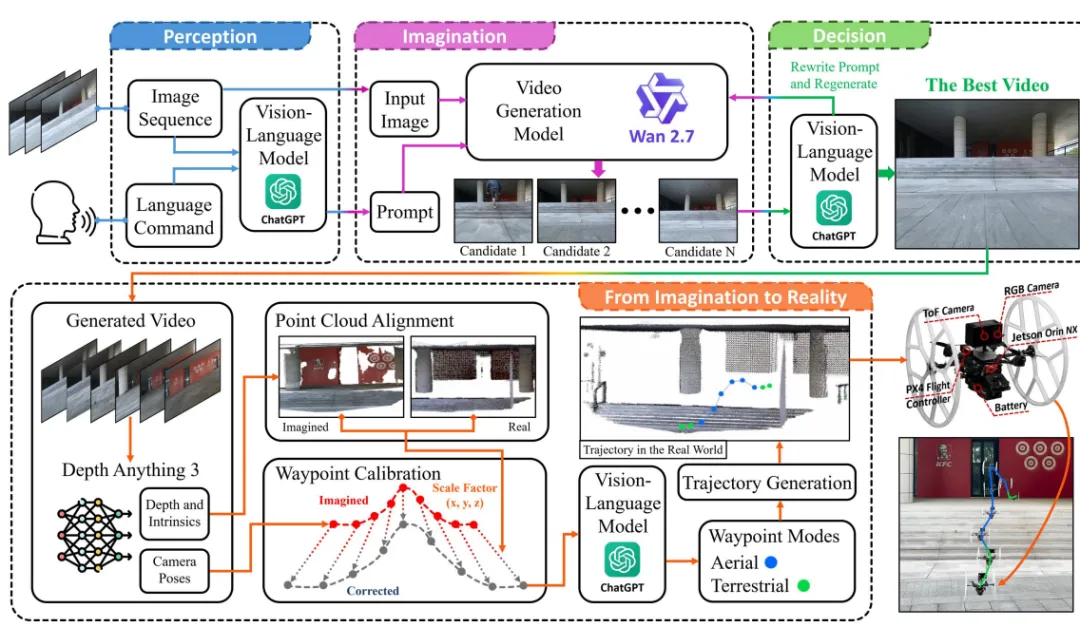
图 | TADreamer系统整体架构总览
2.1 VLM感知与导航提示词生成
机器人获取第一人称RGB观测画面、人类自然语言指令。VLM结合预定义语义模板,输出导航提示词。
自然语言指令一般只讲目标,缺少运动时序细节;VLM的作用就是把模糊指令翻译成视频生成需要的、带阶段与模式信息的完整描述。
2.2 带纠错反馈的导航视频生成
选用Wan2.7文生视频模型,以机器人当前首帧图像作为视觉条件,组合导航提示词、通用生成约束提示词。 每一轮使用不同随机种子生成n条候选视频,VLM做有效性评估:输出每条视频是否可用,同时记录具体失效原因,比如物体莫名移动、镜头异常缩放、出现无关人物。
实验中每轮生成5条候选,设置最大生成轮数限制,控制算力开销。VLM标记的起飞降落时间,只用来划分航点模式,不是机器人真实起飞降落的执行时刻。
2.3 基于实测点云的两阶段尺度校准
这是整篇工作核心创新。用Depth Anything3(DA3)对选中想象视频逐帧重建,得到想象点云与相机轨迹航点。重建出来的点云存在未知的各向异性缩放、旋转、平移偏差,需要和机载ToF得到的实测度量点云做配准。
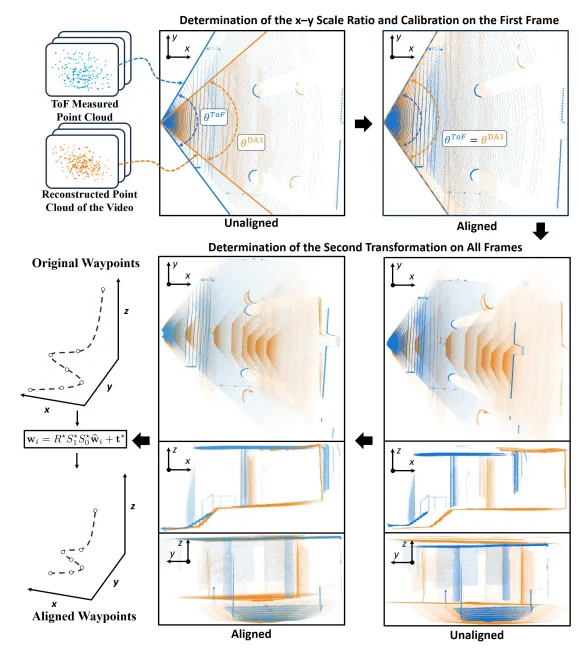
图 | 两阶段配准流程:视场初始化+全点云各向异性配准
- 第一阶段:视场约束初始化 利用第一帧想象重建和实测点云的水平视场角,算出XY平面轴比例,做带约束尺度ICP。只优化水平、垂直尺度,不更新旋转和平移,为第二阶段配准提供一个不错的初值,避免ICP陷入局部最优。
- 第二阶段:无约束各向异性配准 放开XY轴比例约束,同时优化X/Y/Z三轴独立尺度因子、旋转矩阵R、平移向量t。目标函数最小化想象点云和实测点云之间对应点距离。
两轮变换复合,作用在原始想象航点上,输出校准之后、处在真实度量坐标系下的航点集合,同时保留每个航点自带的地面/飞行模式标签。
这里需要客观理解指标含义:这套配准的误差降低,是在校准观测帧上测算得到,代表想象几何和当前观测场景对齐;不等于视频全部内容的每一处细节都完全和现实一致,远处、被遮挡区域依旧会存在想象幻觉。
2.4 模式感知轨迹生成
经过校准的航点依旧会存在局部非线性几何错误,尤其障碍物后方被遮挡的想象区域。不会直接硬跟踪原始航点。 系统把带模式标签的航点作为参考线索,输入两栖机器人专用规划器,结合机载实时实测点云地图,生成满足动力学约束、避障约束的平滑连续轨迹:地面模式启用无侧滑非完整运动约束;飞行模式下偏航角可以独立控制,最后下发底层PX4控制器执行。
03 真实世界多场景实验
一共7个室内外真实场景,覆盖斜坡、草地、台阶越障、目标定位、障碍物绕行等工况。机器人硬件搭载RGB‑ToF感知单元,DA3深度重建跑在RTX4080,规划模块运行机载Jetson Orin‑NX。
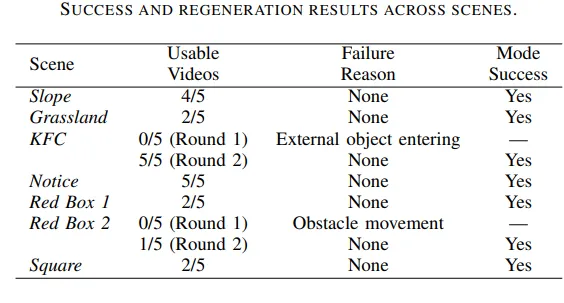
表1 各场景视频生成成功率与再生结果统计表
7个场景里面,5个场景第一轮就产出可用视频;KFC、Red Box2首轮全部视频不合格,VLM识别到“出现移动物体、障碍物异常运动”,加入对应的纠错提示词之后,第二轮拿到合格视频。所有最终选中视频,VLM给出的起飞/降落模式标签全部和人工评估参考保持一致。
指标边界解读:VLM筛选并不完全等价人类专家,部分场景VLM选出最优候选和操作员主观偏好并不完全一致,需要留意工程上的人工兜底机制。
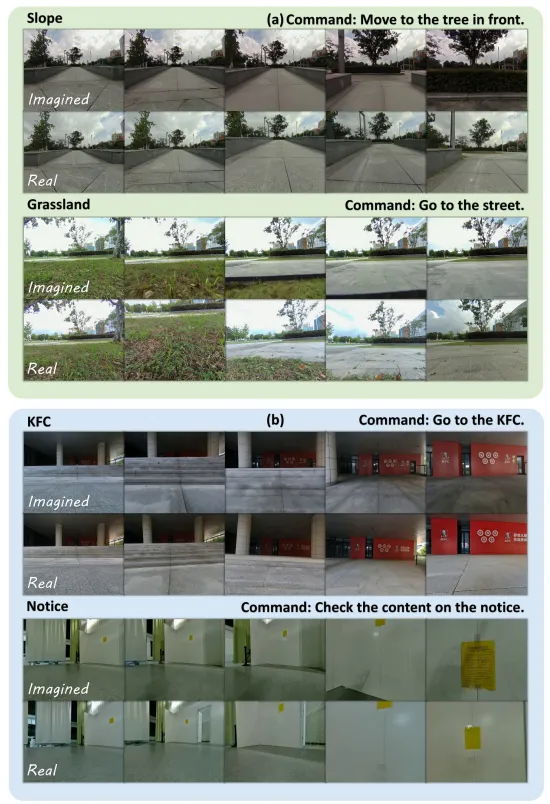
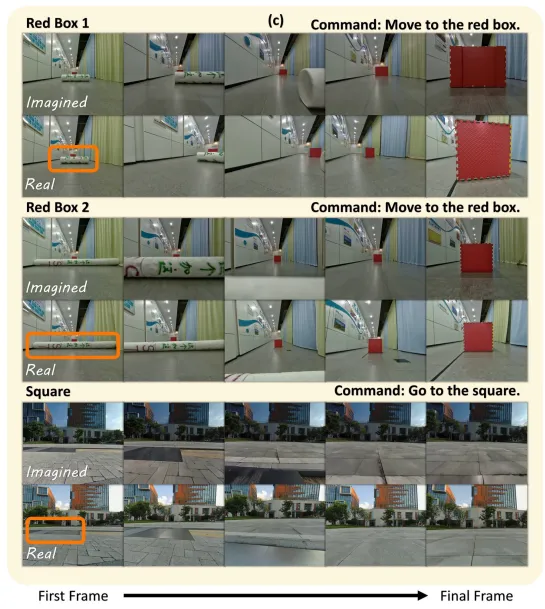
图 | 7个真实场景想象视频首末帧与真实执行对比
在全部7个测试场景:对比NavDreamer,平均绝对深度误差MADE降低87.7%,平均相对深度误差MARDE降低86.3%;对比直接DA3重建,MADE降低79.97%,MARDE降低75.50%。室内近距离场景误差整体更低;草地、广场这类室外大尺度场景误差会明显抬升。
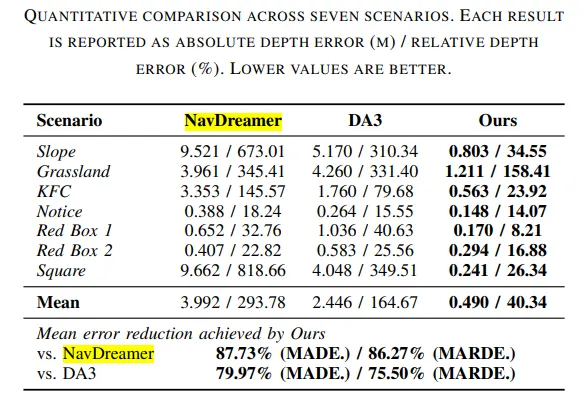
表2 深度误差定量对比,MADE单位m,MARDE单位%,数值越低越好
几何驱动基线只看高度,草地、缓斜坡直接判定为障碍,全程起飞;TADreamer依靠想象视频带来的语义理解,识别地形可以地面行驶,选择地面模式,契合两栖机器人节能优先的设计目标。
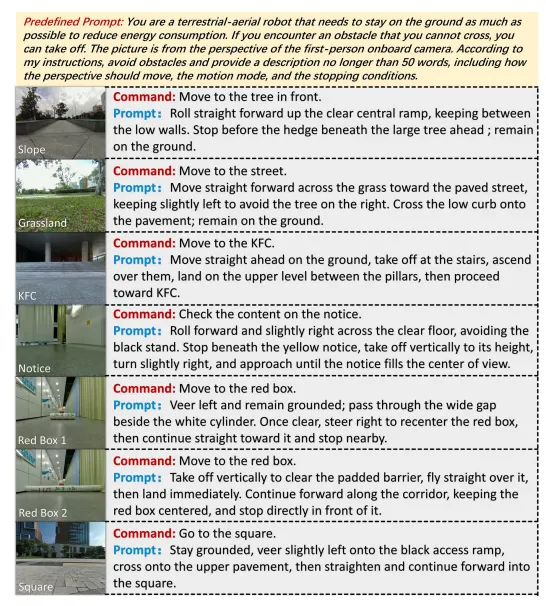
图 | 几何规划基线与TADreamer路径对比
04 写在最后
TADreamer给空地两栖机器人导航提供了一条有意思的实现路径:生成视频只用来做语义和运动时序想象,而不是直接拿来当真实几何。针对视频重建普遍存在的各向异性尺度畸变,设计两阶段点云配准流程,把想象航点对齐到实测度量空间,再交由规划器结合真实环境做安全避障。
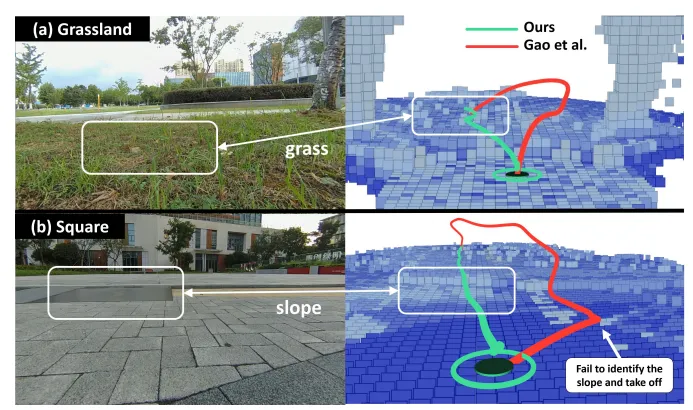
图 | 草地与广场场景下规划得到的路径
在7个室内外真实两栖任务上验证了这套流水线的可行性,相比NavDreamer深度误差大幅下降。但这套方案不是银弹,性能上限受限于文生视频模型本身质量,动态场景、闭环重规划还属于待探索方向。
它的启发在于:不要完全信任生成模型输出的几何,把“想象推演”和“实测几何校准”拆开,或许是利用生成式AI做机器人决策的一条务实思路。
参考论文:
论文标题:TADreamer: Zero‑Shot Language‑Guided 3D Navigation for Terrestrial‑Aerial Bimodal Robots via Video Imagination
论文链接:https://arxiv.org/pdf/2609.19824

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献231条内容

所有评论(0)