图灵奖双雄彻底决裂!杨立昆怒撕大模型是“高级搜索引擎”,辛顿苏茨克维绝地反杀。 符号层面的条件概率
图灵奖双雄彻底决裂!杨立昆怒撕大模型是“高级搜索引擎”,辛顿苏茨克维绝地反杀
当全世界都在为大语言模型的每一次迭代狂欢、把会写代码的聊天机器人奉为“硅基新神”时,一个最不该唱反调的人,当头泼下了一盆冰水。
这个人是杨立昆(Yann LeCun)。
2018年图灵奖得主、深度学习三巨头之一、前Meta首席AI科学家。
在一场备受瞩目的炉边谈话中,杨立昆语惊四座。
他把如今风头无两的 ChatGPT 和各类大模型(LLM),扔进了一条冰冷的技术演进史里:印刷术、图书馆、互联网、搜索引擎。
他的核心结论冷酷而毒辣:“大模型极其有用,但本质上,它们依然只是信息检索系统。
它们压缩并调取了人类曾经创造的知识,但绝非通往人类水平智能的坦途。”
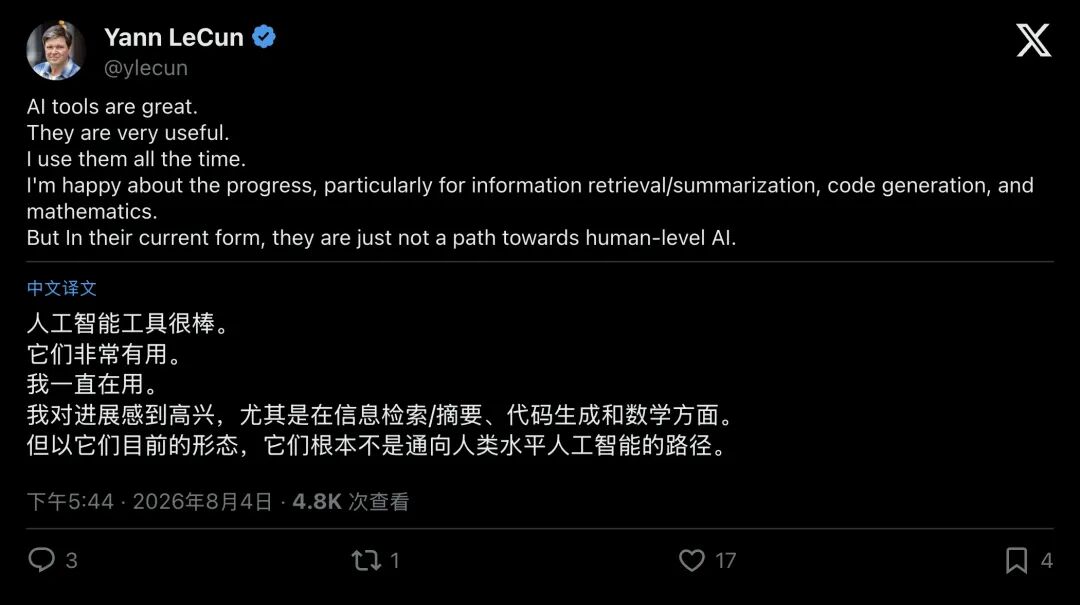
▲ 杨立昆发帖直言:AI工具极其实用,但当前形态绝非通往人类水平智能的道路
此话一出,整个科技界瞬间炸开了锅
杨立昆进一步抛出了一个让大模型支持者难以反驳的现实悖论:
“为什么一个系统能轻而易举通过最严苛的律师资格考试、拿下奥林匹克数学竞赛金牌,却做不出一个像样的家用保洁机器人?为什么它无法像一个17岁的人类少年那样,仅仅经过20小时的练习,就能在复杂的真实世界里学会开车?”
这究竟是图灵奖得主的清醒预警,还是老派宗师在新浪潮面前的固步自封?
紧接着,同样手握图灵奖的杰弗里·辛顿(Geoffrey Hinton),以及OpenAI灵魂人物伊利亚·苏茨克维(Ilya Sutskever),以极其硬核的底层理论发起了正面反扑。
一场关乎“什么是思考、什么是智能”的AI世纪大论战,在这一刻彻底拉开大幕。
01刺破泡沫:大模型不过是“交互式超级百科”?
杨立昆对大模型的审判有着深厚的理论基石,依托于他沉淀多年的一套严密认知框架。
在2026年印度 AI Impact Summit 峰会上,杨立昆面对镜头直言不讳:人类之所以对现在的 AI 产生神化心理,是因为犯了致命的“拟人化偏见”。
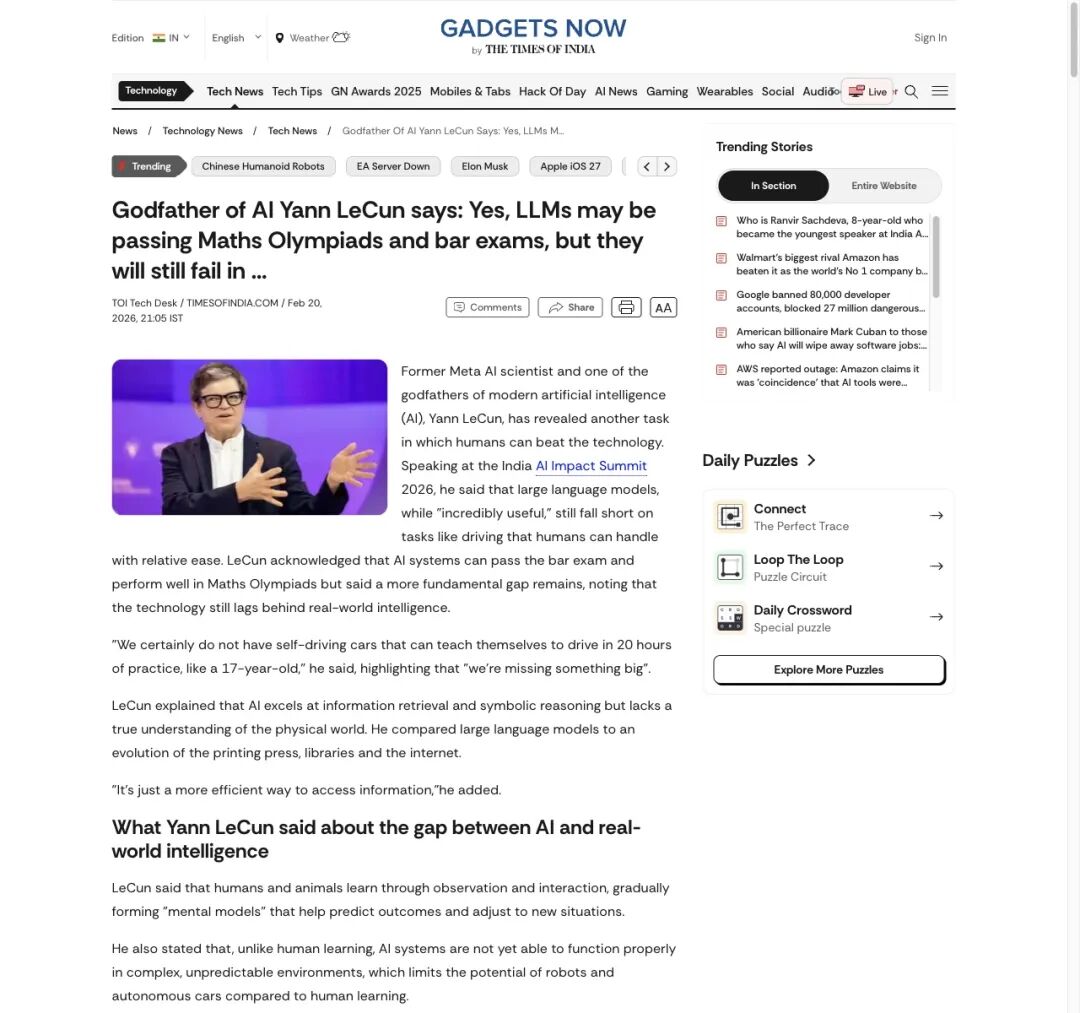
▲ 《印度时报》头条报道:大模型能赢下奥数与律师考试,但在现实任务中依然束手无策
你看到屏幕对面的AI引经据典、出口成章,甚至能把量子力学写成优美的十四行诗,你就以为它拥有了独立的灵魂。
但在杨立昆眼里,这背后的底层逻辑极其机械:
- 知识的搬运工
:模型并没有创造新的科学规律,它只是把互联网上数以万亿计的人类既有知识进行了极高密度的数学压缩。
- 符号层面的条件概率
:在代码生成和特定数学解题中,模型展现出的所谓“推理”,本质上仍然是在符号规则极其明确的离散空间里进行排列重组。
- 历史的连续演进
:从十五世纪的活字印刷术,到现代公共图书馆,再到谷歌搜索引擎,人类的技术一直在做同一件事,提高知识分发与检索的效率。大语言模型,只是这条技术传送带上的最新一环。
科技自媒体 Big Brain AI 随后将这段访谈剪辑发出,并在配文中重重划出重点:“它压缩的是此前由人类生产的事实性知识。”
杨立昆本人随即赶到评论区,仅仅敲下了一行冰冷的回应:
“正是如此。人们高估实用机器的智能,早已屡见不鲜。”
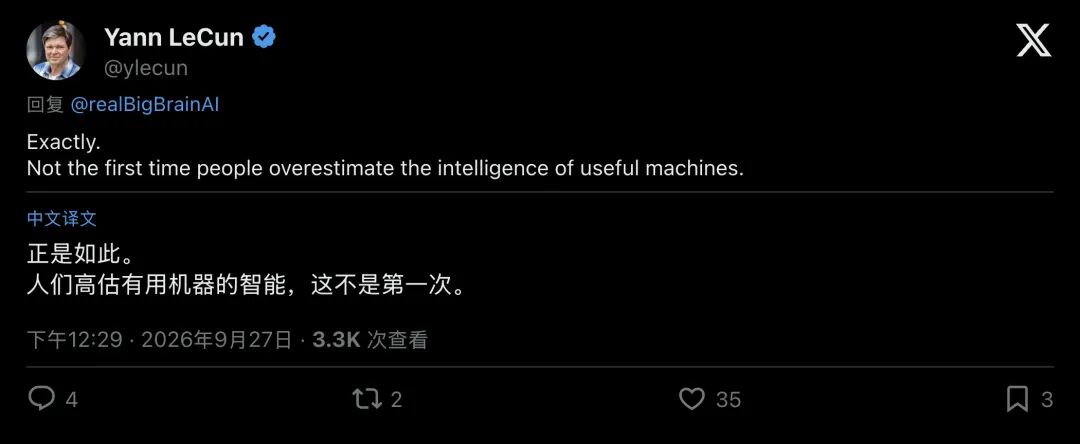
▲ 杨立昆公开回应:人们高估实用机器的智能早已屡见不鲜
这番言论迅速引发了舆论海啸
支持者大呼解气,认为杨立昆终于戳破了硅谷资本精心编织的 AGI 泡沫;
但反对者同样情绪激烈,甚至有 AI 专家公开怒斥杨立昆“穿着皇帝的新衣,完全不懂现代人工智能的质变”。
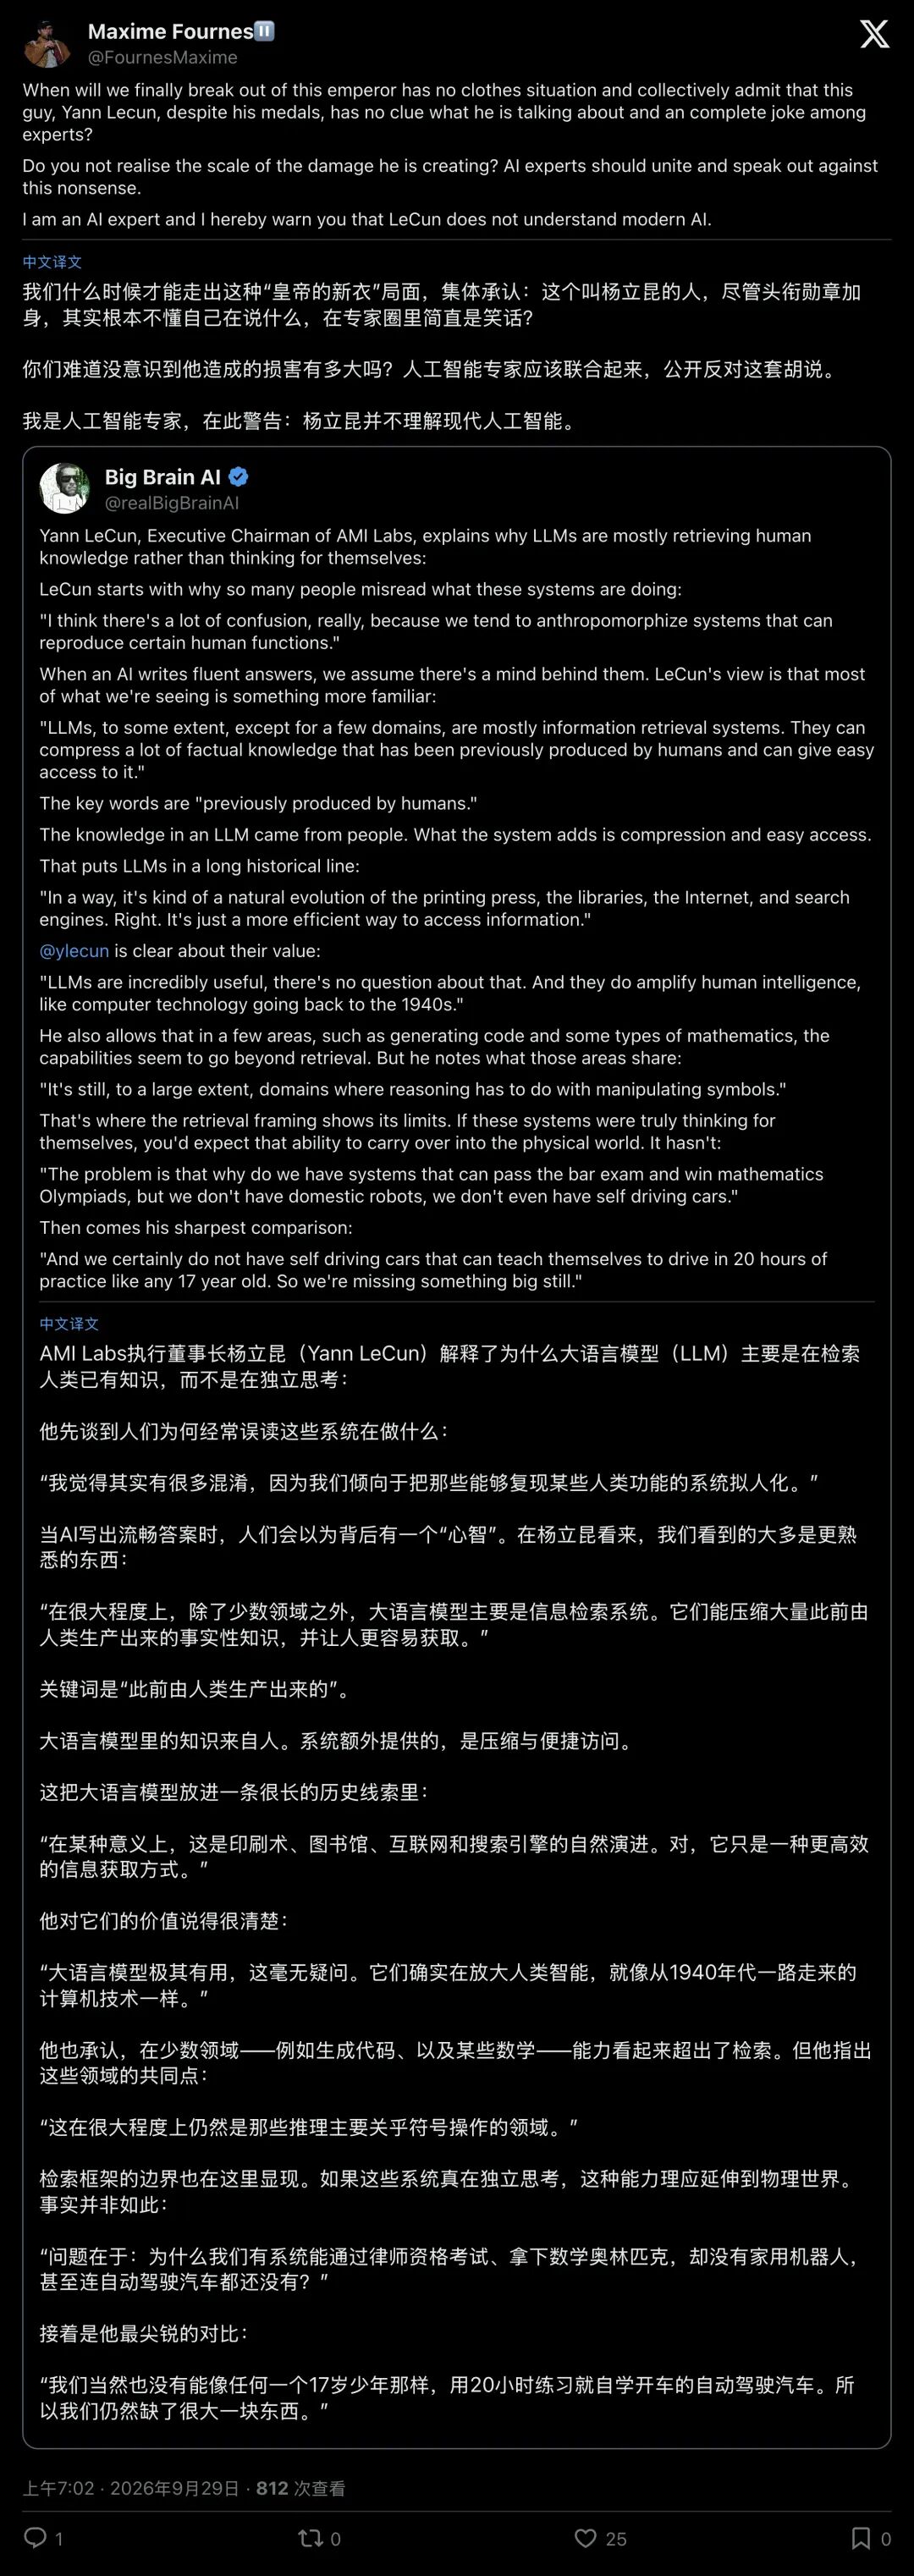
▲ 有反对者公开质疑杨立昆,称其根本不懂现代AI的发展逻辑
杨立昆到底看到了什么常人忽视的致命缺陷,才敢如此笃定地断言“现有路线走不通”?
02致命死穴:真实世界远比“语言的牢笼”复杂
杨立昆的核心论据,藏在一个看似微不足道、却直击痛处的对照里:物理世界的感知与行动。
在今天,大模型可以在几秒钟内读完十万字文献并写出精美摘要。
但在物理现实中,哪怕是一只猫、一只老鼠对重力、摩擦力、空间距离的本能反应,当今最顶尖的机器人系统都无法企及。
这就是经典的符号落地难题(Symbol Grounding Problem):
语言只是人类对现实世界的高度抽象和低维切片。
真实世界是连续的、高维的、充满无法预测的物理噪音的。
人类的大部分智能,根本不需要通过语言来习得。
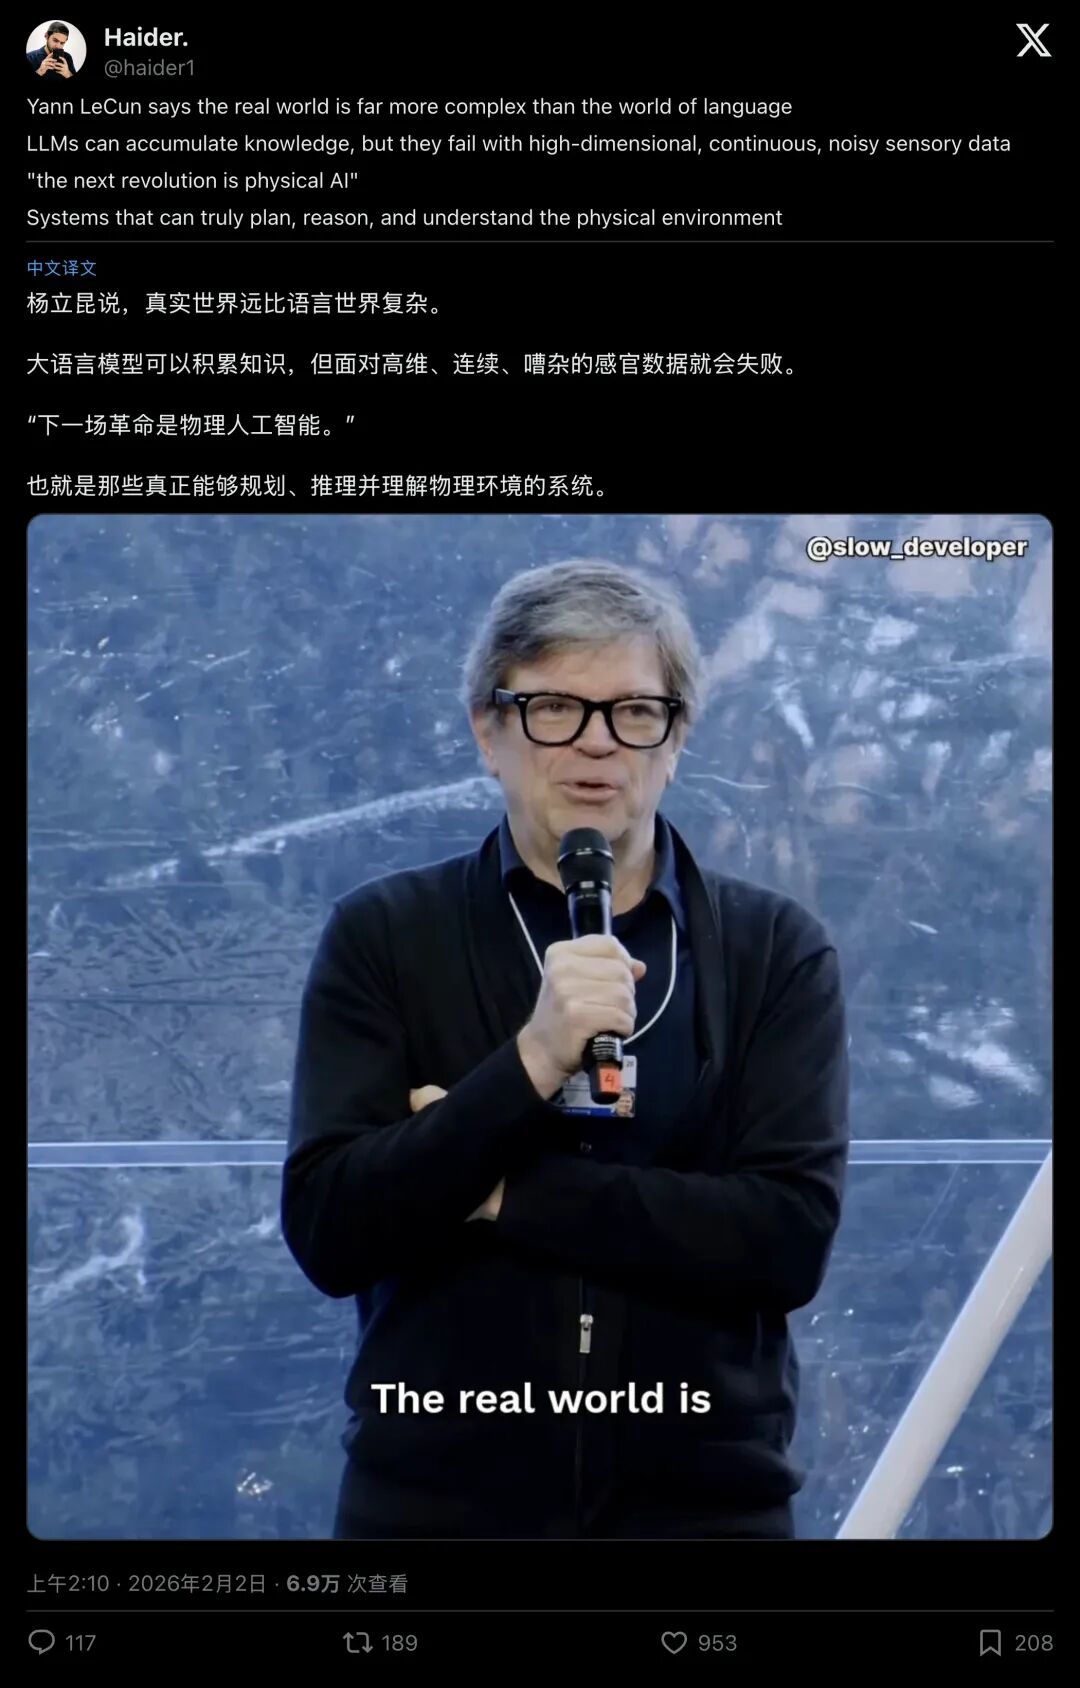
▲ 杨立昆强调:真实世界远比语言复杂,下一场革命是物理AI
一个婴儿未曾研读过《牛顿力学》,但在无数次推倒积木、跌跌撞撞的摸索中,大脑已自然建立起一张世界模型(World Model),直观理解松手物体会下落、玻璃会破碎、遮蔽视线并不代表物体消失。
而当前基于 Transformer 架构的大模型,完全是在没有物理实体的文本世界里“闭门造车”。
它们靠着统计规律猜测“下一个词是什么”(Next-Token Prediction)。
杨立昆断言:纯靠自回归预测下一个词,系统永远无法形成对物理因果的稳健常识,更无法自主发明新事物。
离开 Meta 后,杨立昆创立了 AMI Labs,全面深耕联合嵌入预测架构(JEPA)与物理人工智能(Physical AI)。
他跳出纯文本的死胡同,转而让机器师法生物,直接从连续视觉流与物理交互中提炼因果规律。
在杨立昆看来,大模型拥趸选错了通往通用智能的终极路径。
然而,大模型阵营的开拓先驱们,绝不可能咽下这口气。
03绝地反扑:辛顿与苏茨克维的神级反驳
如果大模型真的只是“高级自动补全”,它凭什么能写出前所未见的程序?
凭什么能解答从未在训练集中出现过的复合谜题?
深度学习之父杰弗里·辛顿(Geoffrey Hinton)率先开火,直击杨立昆论点的逻辑软肋。
辛顿指出,把大模型贬低为“搜索引擎”的人,犯了一个极其严重的常识性错误:将训练目标的形式,与模型为了达成该目标所必须具备的内在能力混为一谈。
辛顿的反击极富哲理且一针见血:
“为了精准预测句子里的下一个词,模型被迫在神经网络深层构建起对真实世界因果逻辑的深刻理解。”
如果只是机械检索,你无法解释为什么模型能把两个完全风马牛不相及的概念融合得天衣无缝。贬称大模型是自动补全,就如同指着人类大脑说‘这只是一堆遵循物理化学定律放电的离子通道’一样荒谬!
如果说辛顿是从认知哲学发起突袭,那么 OpenAI 前首席科学家伊利亚·苏茨克维(Ilya Sutskever),则从信息论与计算理论的高度,给出了降维打击般的辩护。
在一次深度访谈中,苏茨克维提出了名震学界的“世界投影论”:
1. 语言作为低维信道,立体映射着物理法则、社会秩序与人类心智,绝非凭空悬浮的孤岛。
人类在文本中写下的每一句话,背后都深深锚定着现实世界的运转法则。
2. 压缩即智能(Compression is Intelligence)。
根据算法信息论,要把整个人类文明浩瀚的万亿级文本,压缩进几个G或几十G的神经网络有限权重里,模型绝对不可能靠死记硬背。
唯一的数学解,就是模型必须提炼出生成这些文本的底层元规则与现实发生器!
3. 预测下一幕,等于模拟整个宇宙
苏茨克维举了一个极具冲击力的例子:在一本硬核推理小说里,要准确预测凶手在最后一页自白前的“下一个词”,模型必须在隐层空间里全程追踪所有嫌疑人的心理状态、作案时间线、物理空间轨迹以及逻辑谎言。
这哪里是检索?
这分明是在神经网络内部运行了一台高精度的现实模拟器!
04终极分水岭:AI到底是一面镜子,还是一颗大脑?
这场图灵奖得主之间的顶峰对决,撕开了当今人工智能乃至整个人类认识论最深邃的一道裂痕:
- 杨立昆代表的“感知落地派”认为:没有肉身感知与物理接地的符号操作,终究是无源之水。大语言模型无论做多大,充其量只是一面无限清晰、能够完美倒映人类历史文明的多棱反射镜
。它能极其高效地放大人类智能,但镜子本身不会思考。
- 辛顿与苏茨克维代表的“表征涌现派”坚信:数学与概率的连续空间拥有超越人类想象的魔力。当无监督学习的规模突破某个物理临界点,高维特征空间的统计外推,就必然会自发涌现出跨越符号与现实界限的超级世界模型
。
这场对决早已超越了单纯的工具优劣之争。
所有人(包括杨立昆在内)都毫无争议地承认,大模型是人类有史以来最强大的生产力工具之一。
这场争锋的焦点在于:人类距离那个具备真实世界常识、能够独立洞悉未知科学法则、自主决断的硅基智能,究竟还有多远?
我们是在沿着正确的阶梯飞速登月,还是在试图把一棵树种得无限高来触碰星辰?
技术史的迷人之处,恰恰在于没有人能在当下宣判终局。
但在两派大师火花四溅的交锋之中,有一件事已经无比确定:
在这场智能定义的终极博弈里,人类对机器的每一次凝视与解构,最终照见的,都是我们自身心智的本质谜题。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献146条内容

所有评论(0)