Story-Flicks:输入一个故事主题,AI自动生成图像配音字幕并合成高清短视频全解析
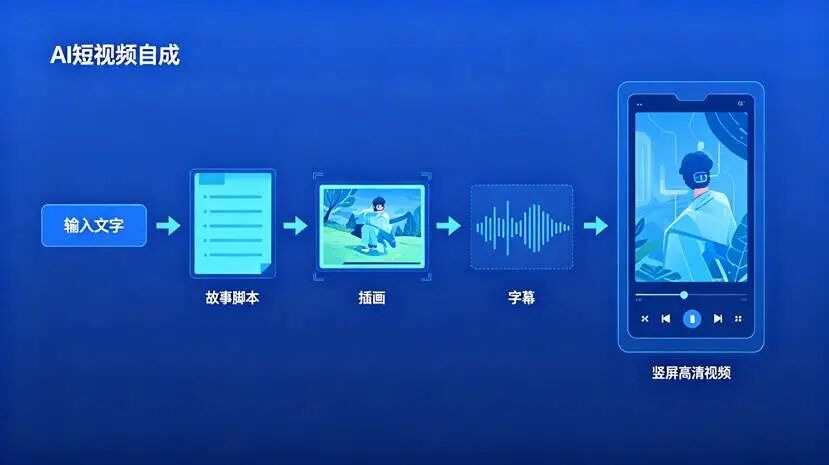
做一条 30 秒的故事短视频,传统流程要多久?先写脚本,再找或画配图,然后录音、剪辑、对齐字幕、配背景音乐、导出——一个熟练的内容创作者,至少需要两三个小时;一个不熟悉剪辑软件的普通人,可能折腾一整天还出不了片。
这正是 AI 视频自动化要解决的问题。2025 年初,开发者 alecm20 在 GitHub 开源了 story-flicks 项目:你只需要输入一个故事主题,比如"学会画画的孤独机器人""月亮上的环形山是怎么来的""夏夜的两只萤火虫",系统就会自动调用大语言模型写脚本、调用扩散模型逐镜生图、调用 TTS 引擎配音、自动生成字幕,最后把图像、旁白、字幕、背景音乐合成为一条1080P 高清短视频。整个过程30 秒到 2分钟,全程无需打开剪辑软件。
本文将从短视频生产的真实痛点出发,完整拆解 story-flicks 的五阶段 AI 流水线、每一环的模型选型与工程实现、前后端技术栈、Docker 部署与 REST API 二次开发、应用场景、已知局限与优化方向,并与商业SaaS 和其他开源方案做横向对比,帮助内容创作者、开发者和技术团队判断:这套"一句话生成成片"的开源方案,能不能进入你的工作流。
一、Story-Flicks 是什么:一句话生成高清故事视频
Story-Flicks 是一个基于多模态大模型的开源 AI 视频生成工具,代码托管在 GitHub(仓库名 alecm20/story-flicks),采用 MIT 许可证,允许免费使用、修改与二次分发。它的核心定位是"文本到视频的自动化流水线":用户提供故事主题,系统自动完成脚本、图像、配音、字幕、合成五个环节,输出可直接发布的短视频。
先明确三个容易混淆的边界:
|
问题 |
准确答案 |
|
它是视频生成大模型吗? |
不是。它本身不训练模型,而是编排(orchestrate)现有的 LLM、扩散模型、TTS 引擎,把它们串成一条自动化流水线 |
|
它和 storyflick.ai 是一回事吗? |
不是。storyflick.ai 是月费约 29 美元起的商业 SaaS 平台;story-flicks 是 MIT 开源、可本地部署的项目,两者产品形态、数据隐私与成本结构完全不同 |
|
它生成的是"AI 动态视频"吗? |
核心形态是"AI 图像 + 配音 + 字幕 + 转场运动"合成的图文故事视频(Ken Burns 推拉摇移让静态图动起来),并非逐帧生成的文生视频 |
它的五大核心功能对应视频生产的五个环节:
|
功能模块 |
做什么 |
背后的能力 |
|
文本生成 |
把主题扩写为分段落的故事脚本 |
大语言模型(LLM) |
|
图像生成 |
为每个故事片段生成对应高清插画 |
扩散模型(FLUX / Stable Diffusion / DALL·E) |
|
音频合成 |
把脚本文字转为自然语音旁白 |
TTS 语音合成(Edge TTS / Azure / OpenAI) |
|
字幕添加 |
自动生成并嵌入字幕,可导出 SRT |
时间轴对齐 + 字幕渲染 |
|
视频合成 |
把图、音、字幕、BGM 合成为 MP4 |
MoviePy / FFmpeg 时间线组装 |
二、为什么需要它:传统短视频生产的五重成本
要看懂 story-flicks 的价值,先要看清手工制作一条故事短视频,成本到底花在哪里。
①脚本成本:把一个灵感变成有起承转合的分镜脚本,需要文案能力与时间。对非专业创作者,这一步就足以劝退。
②画面成本:每个分镜都要配图。找图库要翻几小时且有版权风险,自己画需要设计能力,用 AI 画图则要逐张写提示词、逐张生成、逐张筛选。
③配音成本:真人录音需要安静环境、配音功底和反复重录;请配音演员则是按条计费。
④剪辑成本:把图片、配音、字幕、音乐在剪辑软件里对齐时间轴,是最耗时的机械劳动。字幕尤其痛苦——需要逐句听打、逐句拖时间轴。
⑤一致性与迭代成本:想改一句旁白,往往意味着重新录音、重新对齐、重新导出。一次小修改牵动整条时间线。
|
环节 |
手工制作 |
Story-Flicks 自动化 |
|
脚本 |
手写,30 分钟以上 |
输入主题,LLM 秒级生成、可改 |
|
配图 |
找图/画图,数十分钟到数小时 |
按分段自动逐镜生成 |
|
配音 |
真人录音或付费配音 |
TTS 一键合成,多音色多语言 |
|
字幕 |
逐句听打、手动对齐 |
随脚本与配音自动生成、烧录 |
|
合成 |
剪辑软件手动拼时间线 |
自动组装输出 1080P MP4 |
|
迭代 |
改一处牵动全片 |
改文本后重新渲染即可 |
本质上,story-flicks 把视频生产从"手工串行的手艺活"变成了"参数驱动的流水线":人只负责提供创意主题和做最终决策,机械劳动全部交给模型与程序。
三、整体架构:一条五阶段 AI 流水线
Story-Flicks 的工程本质,是一条"输入一次、串行加工、一次输出"的多模态流水线。理解这条流水线,就理解了整个项目。
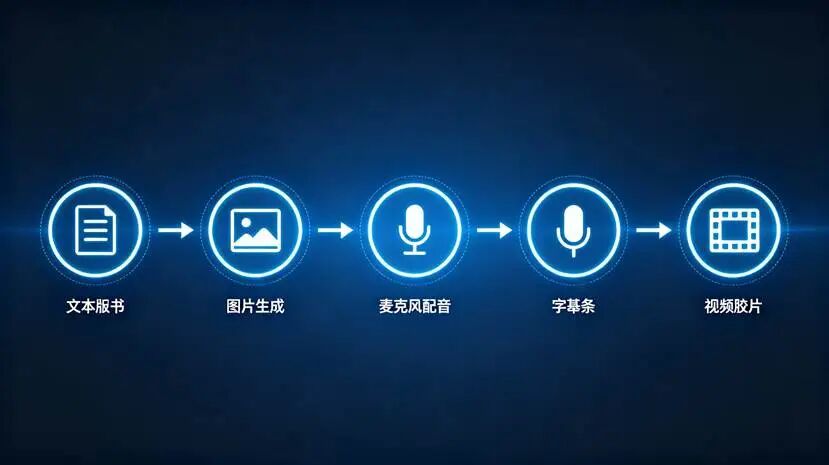
五个阶段环环相扣:文本脚本、图像生成、麦克风配音、字幕条、视频胶片。
3.1 输入层:四个关键参数
用户在 Web 界面只需要提供四类输入:故事主题(一句话或一段话)、语言(中文/英文等)、音色风格(男声、女声、童声、机器人声等)、分段数量(约等于场景数量,决定视频长度与画面数)。分段数越多,每个镜头承载的文字越少、画面越细腻,但生成时间和API 成本也越高。
3.2 加工层:五阶段串行流水线
|
阶段 |
输入 |
处理 |
产物 |
|
① 脚本生成 |
主题、分段数、语言 |
LLM 扩写并切分为 N 个片段 |
结构化分镜脚本(JSON) |
|
② 图像生成 |
每个片段的画面描述 |
扩散模型逐段生成高清图 |
N 张场景插画 |
|
③ 语音合成 |
每段旁白文本、音色 |
TTS 逐段合成语音 |
N 段音频及时长 |
|
④ 字幕对齐 |
文本、音频时长 |
按时间轴生成字幕 |
字幕轨 / SRT 文件 |
|
⑤ 视频合成 |
图、音、字幕、BGM |
时间线组装、转场、编码 |
1080P MP4 成片 |
3.3 技术栈分层
|
层级 |
技术选型 |
职责 |
|
后端 |
Python 3.10 + FastAPI |
REST API、任务队列、文件读写与流水线调度 |
|
LLM 桥接 |
OpenAI / DeepSeek / 阿里云 / Ollama / 硅基流动 |
文本生成,支持云端 API 与本地模型 |
|
图像桥接 |
DALL·E 3、阿里云 FLUX、FLUX.1-dev、Stable Diffusion |
场景插画生成 |
|
语音桥接 |
OpenAI TTS、Azure TTS、Edge TTS |
旁白配音 |
|
前端 |
React + Ant Design + Vite |
Web 操作界面、进度展示、预览下载 |
|
部署 |
Docker + docker-compose |
一键容器化部署 |
这套架构最值得借鉴的设计是"桥接层":文本、图像、语音三个模态都抽象成统一接口,背后接哪家模型由配置文件决定。这意味着你可以在 GPT-4o、DeepSeek、本地 Ollama 之间自由切换,在 FLUX 与 DALL·E 3 之间按成本和画质权衡,而不用改业务代码。
四、阶段一:LLM 如何把主题变成分镜脚本
流水线的第一环,是让大语言模型把一句主题扩写为结构化脚本。这一步看似简单,实则决定了整条流水线的上限——脚本不好,后面的图、音、字幕再好也救不回来。
4.1 两次生成:先写故事,再写画面
工程上通常是"两段式提示词"。第一次,LLM 根据主题、语言和分段数,生成有起承转合的故事正文,并按要求切分为 N 个片段;第二次,针对每个片段,LLM 再生成一段适合图像模型理解的"画面提示词"(image prompt),描述场景、角色、构图、色调、风格。文本叙事与视觉描述分开生成,是因为两者的语言逻辑不同:给人读的旁白要口语化、有情绪,给扩散模型读的提示词要具体、可视化、风格统一。
4.2 结构化输出是流水线的前提
脚本不是一段纯文本,而是结构化数据(通常是 JSON 数组,每个元素包含旁白文本、画面提示词、片段序号)。正因为结构化,后续程序才能逐段调用图像接口、逐段合成语音、逐段对齐时间轴。这也是所有"AI内容流水线"的通用范式:让 LLM 输出机器可解析的结构,而不是只能给人看的散文。
4.3 模型选型:云端与本地两条路
|
方案 |
代表模型 |
优势 |
代价 |
|
云端 API |
GPT-4o、DeepSeek、Kimi、通义 |
质量高、免运维、速度快 |
按 token 付费、数据出域 |
|
本地部署 |
Ollama(如 qwen2.5:14b) |
零 API 成本、数据不出本机 |
需要本地算力、质量取决于模型规模 |
对隐私敏感或需要批量生产的团队,"本地 Ollama 跑文本 + 云端 API 跑图像"是常见的混合策略:把成本和隐私要求高的文本环节留在本地,把最吃算力的图像环节交给专业服务。
五、阶段二:扩散模型逐镜生图
第二环是为每个片段配一张高清插画,这是决定视频"卖相"的环节。
5.1 图像模型选型对比
|
模型 |
特点 |
适合场景 |
|
FLUX.1-dev |
提示词遵循度高、细节丰富、开源可本地部署 |
追求画质与风格统一的主力选择 |
|
Stable Diffusion |
生态成熟、LoRA 与 ControlNet 丰富、完全本地 |
需要自定义风格、角色一致性的进阶用户 |
|
DALL·E 3 |
语义理解强、开箱即用、云端调用 |
快速验证、提示词细节复杂的场景 |
|
阿里云 FLUX |
国内访问稳定、合规、按量计费 |
国内团队的省心选择 |
5.2 最大的工程挑战:跨镜头一致性
逐镜生图有一个天然难题:同一个主角,在第 1 镜和第 5 镜长得不一样。扩散模型每次生成都是独立的,角色形象、画风、色调容易漂移。常见的缓解手段有四种:①在每条画面提示词里固定同一套"风格前缀"(如统一画风、统一色调、统一镜头语言);②用同一颗随机种子或参考图(image-to-image)约束;③借助 LoRA 微调固定角色;④引入角色板/参考图机制(这也是项目路线图中"角色一致性"功能的方向)。
5.3 失败重试与分辨率控制
图像接口可能超时、返回不合规内容或生成失败。工程化流水线必须内置自动重试与失败标记;分辨率则通过环境变量控制(如默认1080P,显存紧张时降到720P)。这些细节决定了流水线能否"无人值守"地批量跑通。
六、阶段三:TTS 语音合成旁白
第三环是把脚本文字变成自然语音。TTS(Text-to-Speech,文本转语音)的质量,直接决定视频"听感"是否专业。
6.1 三类 TTS 方案对比
|
方案 |
特点 |
成本 |
适合 |
|
Edge TTS |
微软免费神经语音,音色多、自然度高、纯 CPU 可跑 |
免费 |
个人与批量生产的默认选择 |
|
Azure TTS |
企业级、情感与韵律控制强、稳定性高 |
按字符付费 |
商业项目、追求播音级质感 |
|
OpenAI TTS |
多语言、接口统一、与 LLM 同账号体系 |
按字符付费 |
已在用 OpenAI 生态的团队 |
Edge TTS 是这类开源流水线的"零成本兜底":不需要 GPU、不需要 API Key,一行命令就能合成,中文有 zh-CN-XiaoxiaoNeural、zh-CN-YunxiNeural 等数十种神经音色,还支持语速(rate)、音调(pitch)调节。这也是 story-flicks 能做到"免费本地跑"的关键一环。
6.2 音频时长是时间轴的"主时钟"
一个容易被忽略的工程细节:每段语音合成后会得到精确的音频时长,这个时长就是后续视频时间轴的主时钟——每张图展示多久、字幕何时出现何时消失,都由对应旁白的时长决定。以音频为锚点对齐画面和字幕,是整条流水线能自动运转的核心机制。
七、阶段四:字幕自动生成与时间轴对齐
第四环是字幕。短视频平台上,超过八成用户会在静音状态下刷视频,字幕不是锦上添花,而是必需品。
7.1 两种字幕技术路线
一种是"脚本即字幕":因为旁白文本本来就是 LLM 生成的,不需要再用 ASR(语音识别)从音频里反推文字,直接把已知文本按音频时长切分、打上时间戳即可,准确率天然 100%,这是"生成式流水线"相比"先录音再识别"路线的独特优势。另一种是导出标准 SRT 字幕文件,方便在专业剪辑软件里二次调整。
7.2 字幕烧录与样式
成片字幕有两种存在方式:烧录(hardcode,直接渲染进画面,任何播放器都能看到)和外挂(SRT 文件,可开关、可替换)。story-flicks 默认烧录以保证各平台一致显示,同时可导出 SRT。字体、字号、描边、位置等样式在前端样式文件中配置,以适配竖屏(1080×1920)与横屏(1920×1080)两种画幅。
八、阶段五:视频合成与时间线组装
最后一环,是把图像、旁白、字幕、背景音乐组装成一条 MP4。这一环主要依赖 MoviePy 与 FFmpeg。
8.1 组装逻辑
程序按片段顺序,为每张图创建一个视频片段,片段时长等于对应旁白时长;在片段上叠加字幕、拼接旁白音轨;片段之间加入转场;整条时间线铺一层背景音乐并做音量闪避(BGM ducking,旁白出现时自动压低BGM);最后一次性编码输出。为避免多次重编码导致的音画漂移,工程上常用FFmpeg 的concat-demuxer 做单次拼接,编码时优先调用NVENC 硬件加速,失败再回退libx264 软件编码。
8.2 让静态图"动起来":Ken Burns 效果
纯静态图片切换会显得呆板,项目路线图中加入了 Ken Burns 效果(缓慢的推、拉、平移与缩放),让画面产生电影感的运动。这是图文类 AI 视频提升质感的通用手法,成本极低、观感提升明显。
8.3 竖屏与横屏
|
画幅 |
分辨率 |
目标平台 |
|
竖屏 9:16 |
1080×1920 |
抖音、快手、视频号、Reels、Shorts |
|
横屏 16:9 |
1920×1080 |
B 站、YouTube、公众号、课堂与企业宣传 |
输出时长通常在 15-60 秒之间,由分段数和旁白长度共同决定,正好覆盖短视频平台流量最集中的时长区间。
九、部署实战:3 分钟本地跑通
Story-Flicks 提供手动与 Docker 两种部署方式,下面是完整流程。
9.1 获取代码
git clone https://github.com/alecm20/story-flicks.git,进入项目目录。
9.2 配置模型密钥
进入 backend 目录,复制环境变量模板 cp .env.example .env,然后按"每个模态选一个供应商"的原则填写。一个最小配置示例:文本用 OpenAI、图像用阿里云,分别填入对应 API Key 与模型名(如 text_llm_model=gpt-4o、image_llm_model=flux-dev)。想完全免费本地跑,则文本选 Ollama、图像选本地 FLUX(通过 ComfyUI 接入)、语音选 Edge TTS。
9.3 方式 A:手动启动
后端建议用 Python 3.10 虚拟环境,安装依赖后用 uvicorn main:app --reload 启动(默认127.0.0.1:8000);前端另开终端进入frontend 目录,npm install 后npm run dev(默认localhost:5173)。浏览器打开前端地址即可使用。
9.4 方式 B:Docker 一键部署
更省心的方式是 docker-compose up --build,容器会同时拉起前后端,打开localhost:5173 即可,无需在本机配置Python 与Node 环境。这也是服务器长期运行、团队内部共享时的推荐方式。
9.5 REST API:把它嵌入你自己的系统
后端暴露了简洁的 REST 契约,这意味着 story-flicks 不只是一个网页工具,更是一个可被调用的"视频生成服务"。核心接口:
POST /api/v1/generate,请求体包含 theme(主题)、segments(分段数)、voice(音色,如 en-US-AriaNeural)、language(语言),返回一个任务 ID;随后轮询 GET /api/v1/status/{job_id},直到状态变为 completed,即可拿到成片 MP4 的地址。基于这套接口,可以把它接入 Discord 机器人、内容管理系统、定时批量生产任务、教学平台插件等。
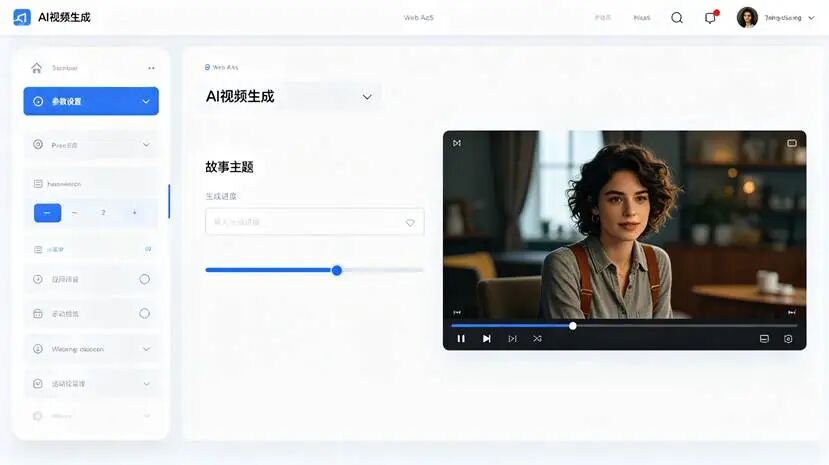
Web 界面:左侧选模型与音色,中间输入主题与分段数,右侧预览并下载成片。
十、操作流程:从主题到成片的四步
|
步骤 |
操作 |
说明 |
|
1. 选择模型 |
下拉选择文本供应商、图像供应商、音色风格 |
按成本、画质、隐私需求组合 |
|
2. 输入主题 |
填写故事主题,拖动滑块设定分段数 |
分段越多画面越细、耗时越长 |
|
3. 等待生成 |
进度条实时滚动日志 |
通常 30-120 秒,取决于分段数 |
|
4. 预览下载 |
内置播放器预览,一键下载 MP4 |
不满意可改文本后重新渲染 |
一个实用技巧:在最终渲染前,可以先让 LLM 只生成脚本,人工润色旁白(尤其要修正 TTS 容易读错的专有名词、数字和多音字),确认无误后再进入图像与合成环节,能显著降低返工率。
十一、应用场景:不止"做着玩"
|
场景 |
目标用户 |
典型用法 |
|
教育与语言学习 |
教师、培训机构 |
为学生批量生成一分钟睡前故事、双语绘本视频、知识点动画 |
|
内容创业 |
自媒体、矩阵号运营 |
批量产出童话、寓言、冷知识、历史故事类无真人出镜视频 |
|
营销推广 |
品牌、电商、运营 |
把产品卖点转成竖版广告短片、活动预热视频 |
|
游戏与动画 |
独立游戏开发者 |
快速生成过场动画分镜与剧情样片 |
|
家庭与亲子 |
家长 |
以孩子为主角定制专属童话,多语言朗读 |
|
文博与科普 |
博物馆、科普机构 |
把展品说明、科普词条自动转为微纪录片 |
对于需要日更甚至一日多更的内容矩阵,story-flicks 的真正价值是"可复制的产能":把创意变成可批量执行的参数,一个人就能维持过去需要一个小团队才能支撑的更新频率。
十二、已知局限与工程对策
任何自动化工具都有边界,story-flicks 也不例外。看清局限,才能用好它。
|
问题 |
成因 |
对策 |
|
图像忽略提示词细节 |
单段承载信息过多 |
增加分段数让提示词更细粒度,或换用 DALL·E 3 |
|
角色跨镜头不一致 |
扩散模型逐镜独立生成 |
固定风格前缀、参考图约束、LoRA 微调,等待角色一致性功能 |
|
TTS 读音异常 |
多音字、专有名词、数字 |
渲染前人工编辑脚本,替换为谐音或注音写法 |
|
显存占用高 |
本地扩散模型吃显存 |
Docker 加 --gpus all,或把 IMAGE_RESOLUTION 降到 720P |
|
云端 API 限流 |
免费额度或并发限制 |
轮换密钥,或改用本地 Ollama + 本地 FLUX |
|
画面是"图文视频" |
并非逐帧文生视频 |
用 Ken Burns 运镜与转场增强动感;需要真动态画面可外接视频模型 |
需要特别强调:story-flicks 生成的是"AI 插画 + 旁白 + 字幕 + 运镜"的故事短片,而不是像 Sora、可灵这类逐帧生成的文生视频。两者不是替代关系——前者胜在快、稳、便宜、可控,适合批量叙事;后者胜在真实动态与复杂镜头,适合高成本精品。
十三、横向对比:开源、商业 SaaS 与手工链路
|
维度 |
Story-Flicks(开源) |
商业 SaaS(如 storyflick.ai) |
手工剪辑链路 |
|
成本 |
软件免费,仅付模型 API(可全免费本地跑) |
订阅制,约 29 美元/月起 |
软件订阅 + 大量人力时间 |
|
数据隐私 |
可完全本地部署,数据不出域 |
数据上传至服务商云端 |
本地,但依赖人工 |
|
模型自由度 |
多供应商可切换、可接本地模型 |
平台内置模型,不可替换 |
自由,但需自己拼装 |
|
上手门槛 |
需要一点部署能力(Docker 可降低) |
注册即用,门槛最低 |
需要剪辑与多工具能力 |
|
可定制性 |
开源可改,REST API 可集成 |
受平台功能限制 |
最高,但效率最低 |
|
适合人群 |
开发者、团队、批量生产者 |
不想折腾的普通创作者 |
追求精细控制的专业剪辑师 |
十四、发展趋势:从"一键成片"到"角色一致的自动制片厂"
从项目路线图与行业方向看,这类工具正在沿三条线演进。
①运镜电影化:Ken Burns 推拉摇移、自动转场、多镜头语言,让静态插画视频越来越接近动态影像;②角色一致性:通过参考图、LoRA、角色板机制,让同一角色贯穿全片,解决图文视频最大的违和感;③流水线智能化与一体化:脚本、分镜、图像、配音、字幕、发布逐步打通,甚至一键分发到多个短视频平台,并支持声音克隆、自动字幕样式等高级能力。
更宏观地看,story-flicks 代表了一种值得注意的工程范式:不追求自己造一个全能大模型,而是做"模型的编排者"——用统一接口把多个专业模型组织成自动化流水线。这种"编排层"思路,正在被复制到文章转视频、AI 漫剧、知识科普、电商带货视频等越来越多的内容生产场景。
总结
Story-Flicks 用一条五阶段流水线,回答了"一个人如何批量生产故事短视频"这个问题:LLM 负责把主题变成结构化分镜脚本,扩散模型负责逐镜生图,TTS 负责自然配音,时间轴程序负责字幕对齐,MoviePy/FFmpeg负责最终合成。人只需要提供一个主题、做几个选择、等一两分钟。
对内容创作者,它是把数小时手工劳动压缩到几分钟的效率工具;对开发者,它的"桥接层 + REST API + Docker"架构是学习多模态流水线编排的优秀开源范本;对团队和企业,它提供了一条数据不出域、成本可控、可深度定制的视频自动化路径。
当然,它不是万能的:角色一致性、真动态画面、TTS 生僻读音仍是需要人工兜底的环节。但当"输入一句话,输出一条片"从演示变成稳定可复现的流水线,内容生产的门槛已经被永久改变了。下一个被自动化的,或许就是你现在还在手工剪辑的那条视频。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献8条内容

所有评论(0)