【CoRL 2026】BiCICLe:面向双臂操作的多智能体上下文学习|从多智能体具身操作视角
摘要
本文解读 CoRL 2026 论文《Bimanual Robot Manipulation via Multi-Agent In-Context Learning》。该论文提出 BiCICLe(Bimanual Coordinated In-Context Learning),通过融合双臂 leader-follower 动作分解、离散化文本观测与多智能体上下文学习,让完全冻结、不做任何参数更新的大语言模型仅凭 10 条演示完成双臂协调操作,其特别之处在于用 follower 对 leader 轨迹的显式条件化取代了高维联合动作预测。实验表明 BiCICLe 在 TWIN 基准 13 个双臂任务上取得 70.5% 平均成功率,比最强的免训练基线高 6.1 个百分点,并超过 ACT(5.9%)、PerAct²(16.8%)、$\pi_0$-keypose(43.7%)等多个监督方法;在 TWIN 之外的 2 个新任务上平均 54.5%(微调基线仅 10.0%),并在真实双臂 Franka Panda 上取得 53.3% 成功率。这说明训练无关的上下文学习策略已可与监督方法同场竞争,为少样本双臂操作提供了重要借鉴。
视频讲解:点击观看 B 站视频
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Bimanual Robot Manipulation via Multi-Agent In-Context Learning |
| 标题(中文) | BiCICLe:面向双臂操作的多智能体上下文学习 |
| 作者 | Alessio Palma、Indro Spinelli、Vignesh Prasad、Luca Scofano、Yufeng Jin、Georgia Chalvatzaki、Fabio Galasso |
| 机构 | Sapienza University of Rome(PINlab)/ TU Darmstadt(PEARL Lab)· Hessian.AI · Robotics Institute Germany |
| 会议 | CoRL 2026 |
| arXiv | https://arxiv.org/abs/2604.20348 |
| 项目网站 | https://alesspalma.github.io/bicicle |
背景与动机
双臂操作是通用机器人系统的关键能力:端托盘、拧瓶盖这类任务要求两条臂同步位置、姿态甚至接触力。这种协调远比单臂控制困难——一条臂的定位误差会迫使另一条臂补偿,误差迅速累积;同时关节动作空间急剧膨胀,两臂之间还需要严格的时间同步。因此模仿学习与离线强化学习通常依赖大规模、任务专用的数据集来捕捉这些依赖(如 ACT 需要逐任务遥操作演示,AnyBimanual 需要在大规模数据上迁移单臂策略,$\pi_0$-keypose 与 3DFA 更是要在多任务数据上微调视觉语言模型)。
上下文学习(ICL)提供了另一条路径:把场景序列化为文本,让大语言模型直接预测机器人动作,从而免去配对的图像-动作数据集。RoboPrompt(ICRA 2025)与 KAT(RSS 2024)已在单臂操作上验证了这条路径,KAT 用 DINO-ViT 关键点做动作 token,RoboPrompt 则用物体坐标的文本表示直接预测关键位姿。但把 ICL 直接搬到双臂并不成立:作者指出,把两条臂的命令拼成一条联合 $\mathbb{Z}^{14}$ 序列会抬高 token 长度与每步模式复杂度,使模型产出不连贯的计划;而把两条臂当成互不通信的独立智能体(Dual Agent)又会丢掉协调,例如一条臂在另一条臂尚未就位时就发起交接。在多智能体路线里,RoCo(ICRA 2024)让每个机器人对应一个 LLM 智能体、先自然语言辩论再由集中式规划器执行,但它依赖语言协商与显式的任务约束校验,并非直接预测动作。BiCICLe 的定位正是这两端之间:保留单臂的低维预测格式,用一条显式条件化通道把协调性重新接回来。
从技术脉络看,这条路线经历了三段迁移:2020 年上下文学习被提出,证明少样本提示即可适配新任务而无需梯度更新;2022–2023 年语言模型以高层规划器身份进入机器人领域(SayCan、Code as Policies),负责技能编排、执行仍交给技能库;2024–2025 年研究转向让文本或关键点上下文直接预测关键位姿(KAT、RoboPrompt),并开始在真机上验证上下文模仿(ICRT)与检索式视觉策略(RICL)。BiCICLe 在 2026 年把这套范式推进到双臂:按顶会创新模式框架(ResearchStudio-Idea, arXiv 2607.04439)分析,它同时命中"通过条件化适配而非重训练"(冻结模型 + 条件信号注入)、"分解并委托求解器"(把联合预测拆给两个各司其职的智能体)与"重新表述为可解对象"(把双臂协调重述为空间 token 上的序列补全加一条条件化通道)三种模式,因此既给出结构性洞察,也提供了可复用的免训练接口。
研究主线:从问题到结论
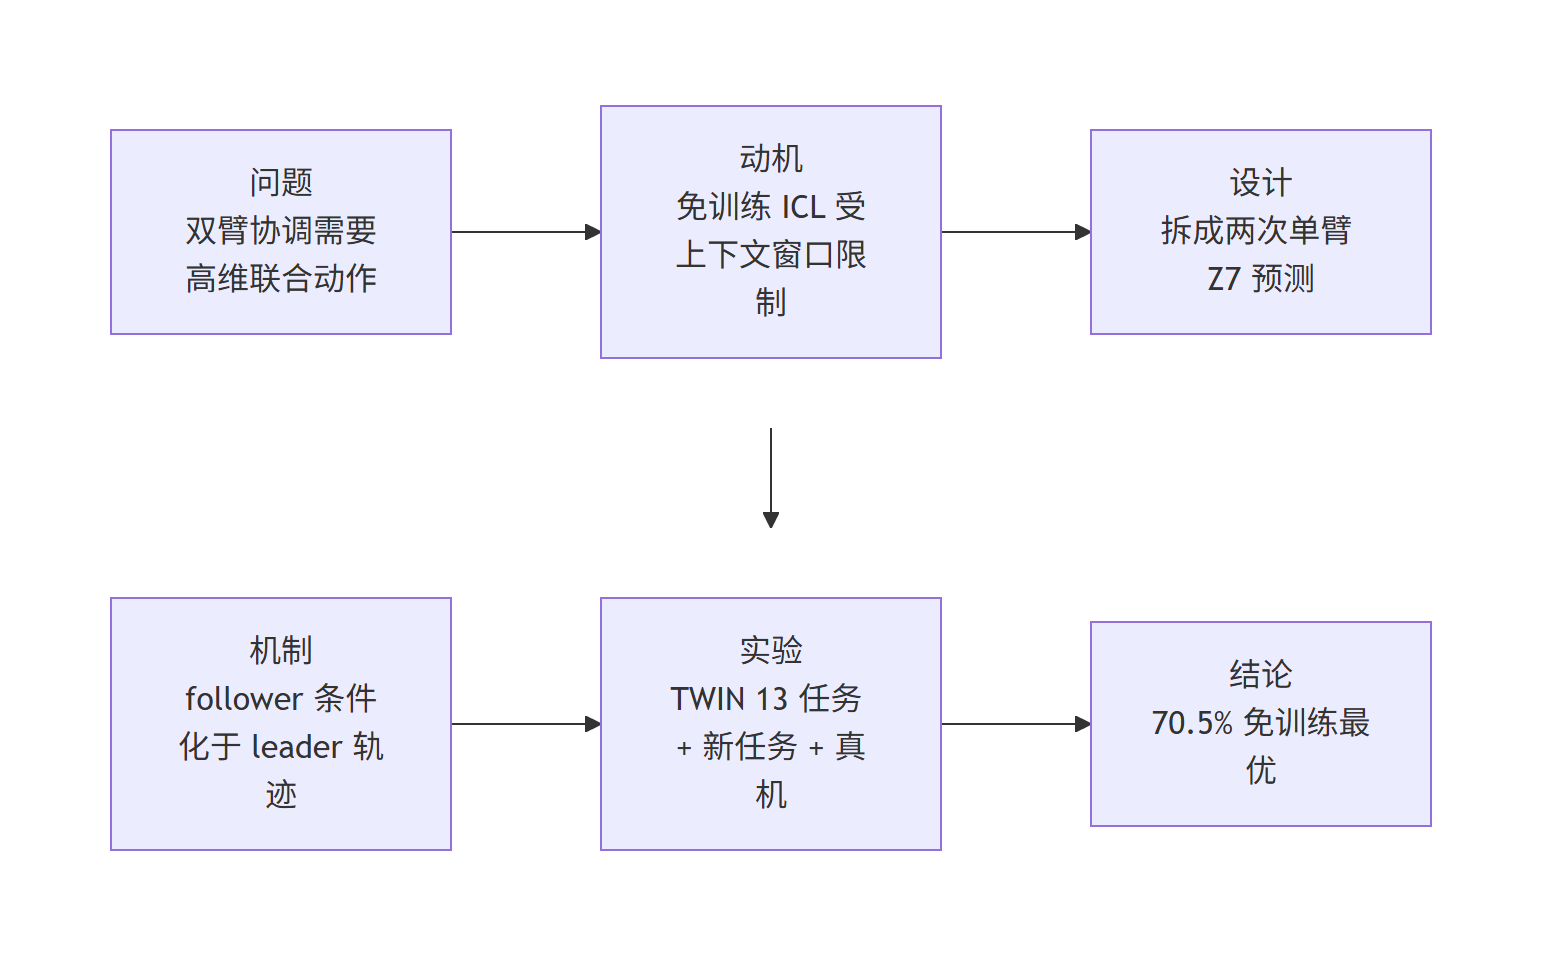 图 5:BiCICLe 的研究主线(Mermaid 流程图)——从双臂协调带来的高维联合动作问题出发,经免训练上下文学习的上下文窗口限制、leader-follower 分解设计、follower 条件化机制与三类实验,收敛到 70.5% 免训练最优的结论。
基准/方法设计
方法的核心是把双臂控制表述为两个 LLM 智能体的顺序协作,并把全部状态与动作离散化为文本 token。
动作表示:单臂动作是 7 元组 $a \in \mathbb{Z}^{7}$,包含 3 个体素位置索引、3 个姿态索引与 1 个二值夹爪状态;两臂拼接得到联合动作 $\mathbb{Z}^{14}$。位置被映射到工作空间内的 $100^3$ 体素网格,姿态按 $5^\circ$ 分箱得到 72 个离散值。
观测表示:每步观测是物体名到离散坐标的字典 $o = {obj_j: [x_j, y_j, z_j]}$。物体坐标由 6 路 RGB-D 相机的分割掩码点云融合得到:先做 0.02 m 体素降采样(Prune)再取质心,避免深度更密的视角主导估计。作者发现把物体朝向也写进观测反而降低性能,因此默认只保留位置。
上下文提示:每条演示表示为「观测 $\rightarrow$ 双臂关键位姿动作序列」,取 $N{=}10$ 条演示与测试观测拼接成 prompt,其中不含任何任务文字描述——目标需要模型自己从演示的模式中推断出来。
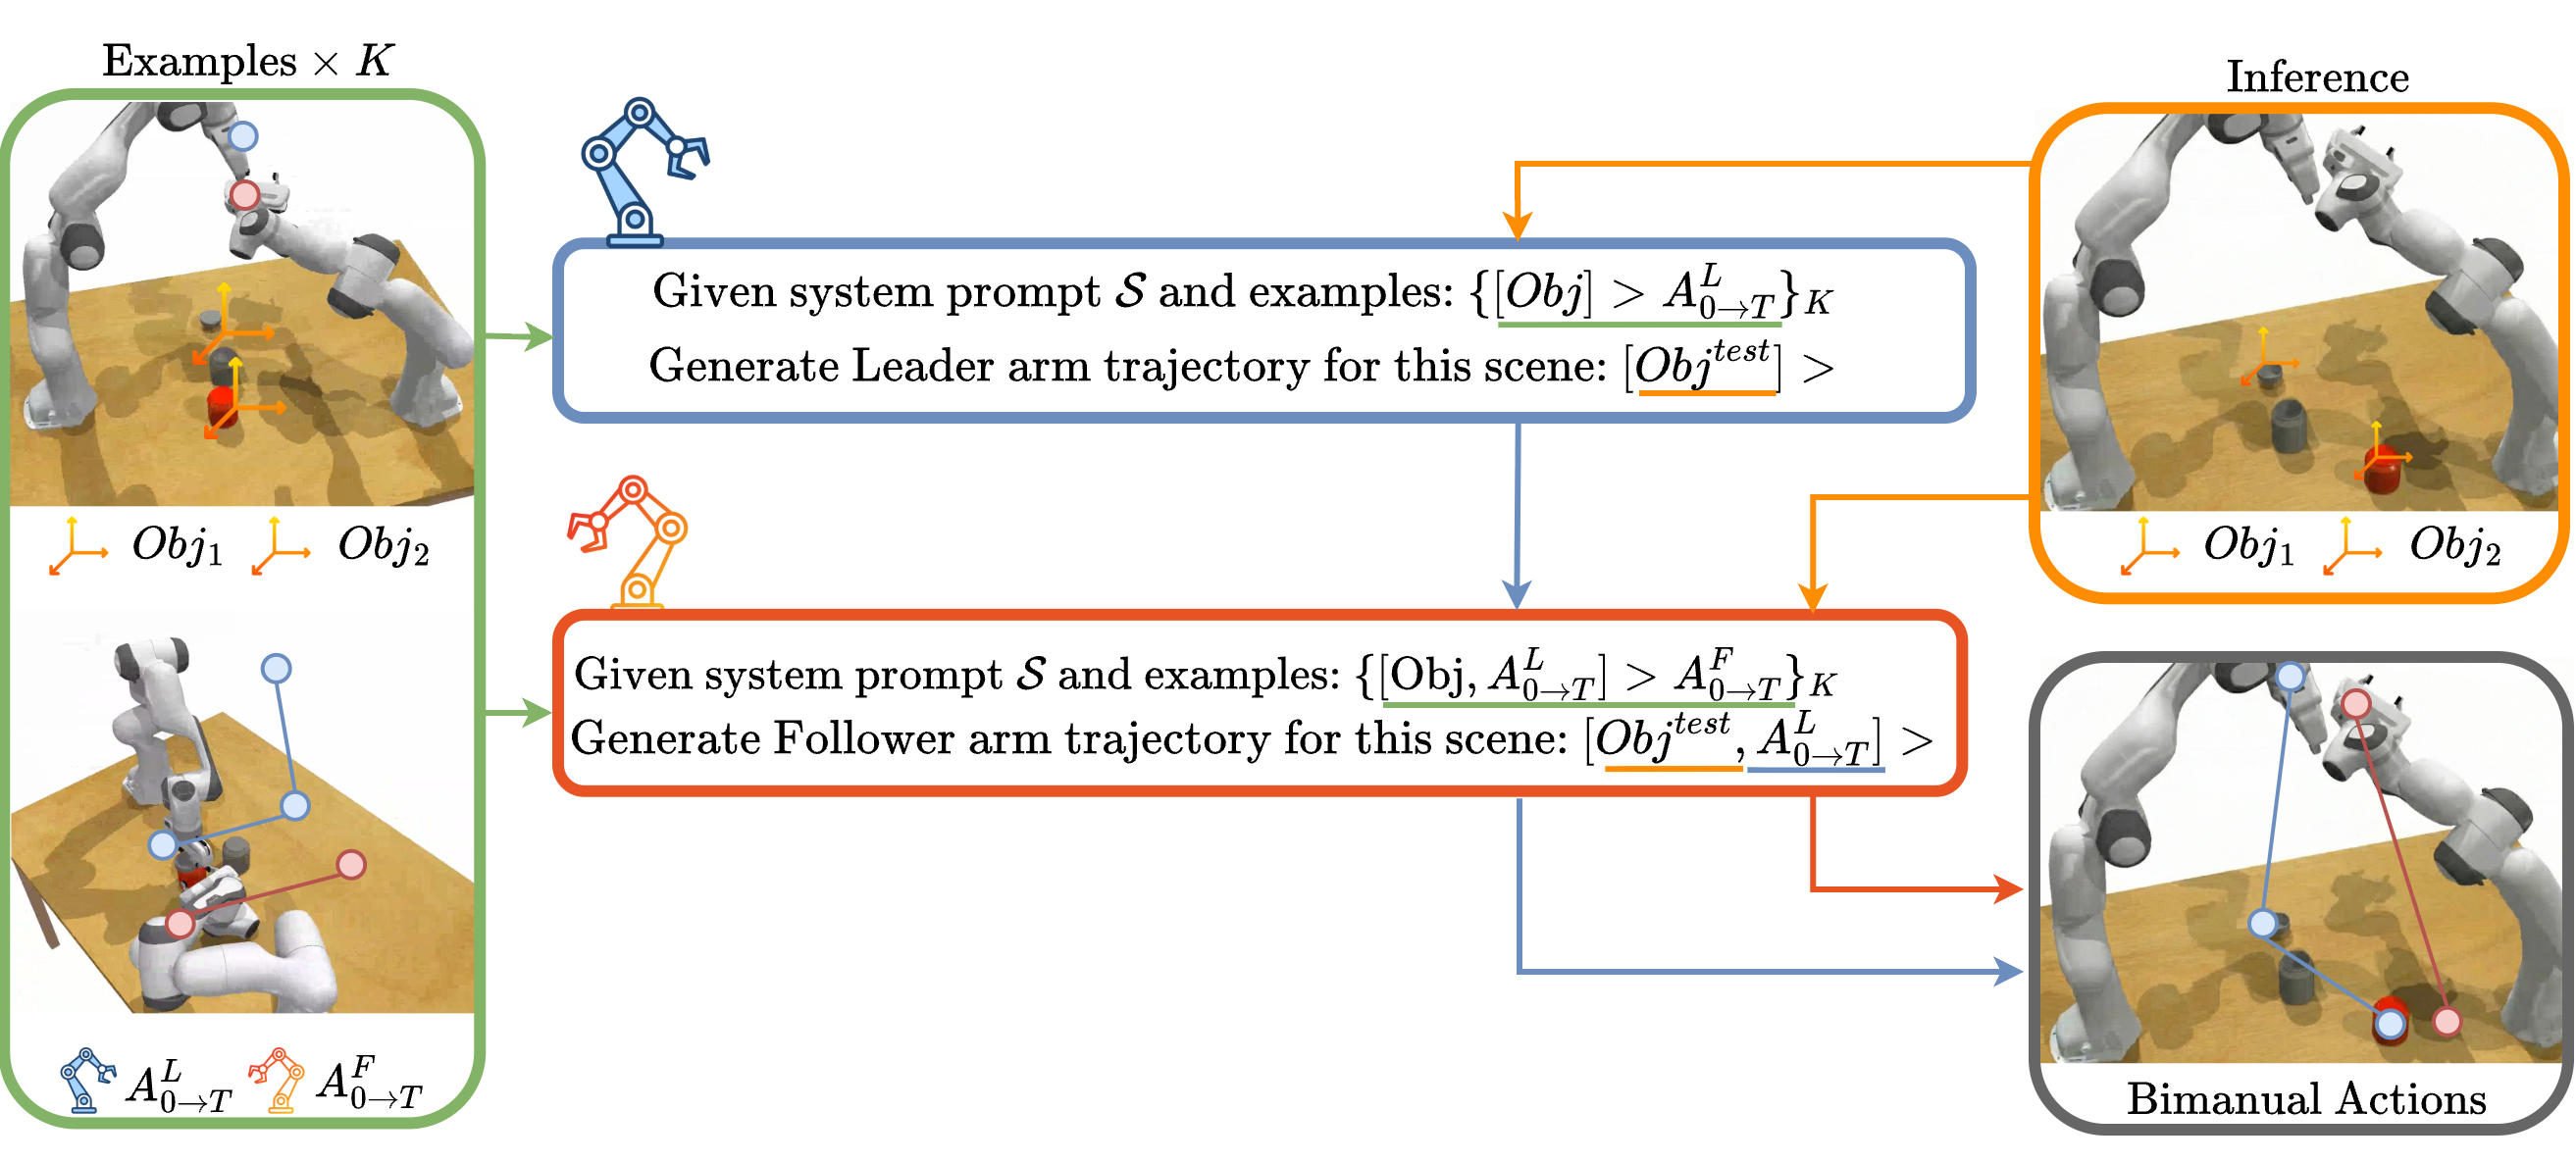 图 1:BiCICLe 框架总览。左侧把双臂演示序列化为观测与动作的文本序列以构造 in-context prompt;右侧推理时先由 Leader 智能体预测完整轨迹,Follower 再以 Leader 的计划为条件预测自身动作,无需任何任务特定训练。
分类全景
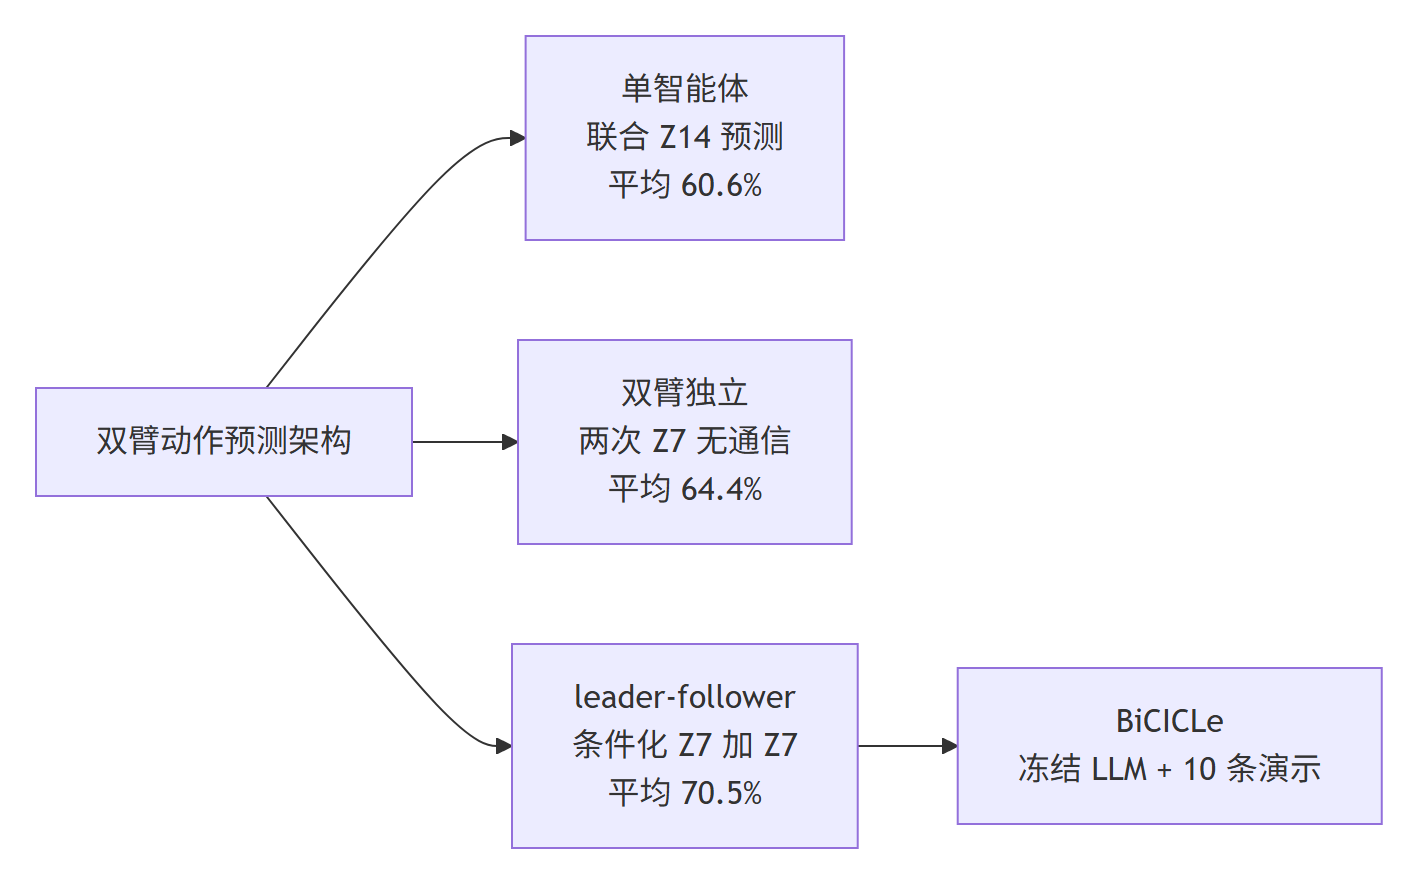 图 6:双臂动作预测架构分类(Mermaid 树状图)——单智能体联合 $\mathbb{Z}^{14}$ 预测平均 60.6%,双臂独立两次 $\mathbb{Z}^{7}$ 无通信平均 64.4%,leader-follower 条件化预测平均 70.5%;BiCICLe 属于第三类,用冻结 LLM 与 10 条演示实现。
方法细节
两个阶段构成完整的双臂预测:
Phase 1 · Leader 预测:指定一条臂为 leader,把双臂演示裁剪成单臂格式,只保留 leader 的动作;leader 智能体接收系统提示、单臂 ICL 演示与测试观测,输出自己的完整轨迹。
Phase 2 · Follower 条件化:把 leader 的动作作为 leader_arm 条目写进观测字典,形成增强观测。在演示侧填入 leader 的动作真值,在测试侧则填入 leader 的预测轨迹,follower 因此能看到伙伴的完整计划再决定自己的动作序列。这一条条件化通道是全文的关键:消融实验显示,只做顺序分解而不传 leader 计划(Sequential Arms)只能达到 65.0%,比完整方法低 5.5 个百分点。
动作合成:两段轨迹按臂别拼回双臂序列;若长度不同,较短的一条重复其最后一个动作补齐。执行沿用逐关键帧的闭环策略,动作队列清空就重新观测与重规划,每个 episode 预算 25 个环境步。
臂别选择:默认右臂担任 leader。把左右互换后平均成功率只差 1.3 个百分点(70.5% 对 69.2%),说明这个设计对臂别几乎不敏感;残余差异主要来自任务本身的手性(多数任务由右臂承担主操作)。
值得强调的是,方法不增加单个智能体的动作维度,也不要求臂间对话:协调性完全由 follower 对 leader 轨迹的条件化承担,因此仍然是免训练、低 token 预算的。
实验设计与结果
评测协议:仿真采用 TWIN 基准(RLBench 的双臂扩展,13 个任务)与 CoppeliaSim 中的双臂 Franka Panda,6 路 128×128 RGB-D 相机;每任务 100 条训练演示与 100 条测试演示,关键帧按夹爪状态变化、关节零速与 episode 终止等启发式抽取。免训练方法报告 3 次运行 × 100 episodes 的均值与标准差,全部方法使用 GPT-5-mini。
主结果(13 任务平均成功率 %)
| 方法 | 类型 | Handover | Lift Tray | Pick Plate | 平均 |
|---|---|---|---|---|---|
| RoboPrompt-SA | 免训练(联合 $\mathbb{Z}^{14}$) | 83.7 | 58.7 | 44.0 | 60.6 |
| RoboPrompt-DA | 免训练(双臂独立) | 82.7 | 79.3 | 61.0 | 64.4 |
| XGBoost | 免训练(上下文拟合) | 37.0 | 48.7 | 33.0 | 49.1 |
| BiCICLe | 免训练(leader-follower) | 94.3 | 83.0 | 65.3 | 70.5 |
| 3DFA | 监督(多任务微调,文献值) | 89.0 | 94.7 | 69.7 | 85.1 |
BiCICLe 把免训练方法的最强平均成功率推到 70.5%,比 RoboPrompt-DA 高 6.1 个百分点,比在上下文上拟合的 XGBoost 高 21.4 个百分点;同时也超过多个逐任务监督训练的策略:ACT(5.9%)、PerAct²(16.8%)、$\pi_0$-keypose(43.7%)、AnyBimanual(32.0%)。
消融与推理成本(13 任务平均 / Lift Ball 单 episode,含 API 往返)
| 变体 | 成功率 (%) | Tokens (k) | 中位耗时 (s) |
|---|---|---|---|
| RoboPrompt-DA | 64.4 | 17.5 | 43.3 |
| Sequential Arms(去掉条件化) | 65.0 | -- | -- |
| BiCICLe | 70.5 | 21.5 | 125.3 |
| + Conversation(多轮精修) | 57.5 | 73.8 | 278.2 |
| + Best-of-N(5 采样 + 打分) | 71.2 | 180.7 | 149.7 |
分布外泛化(TWIN 之外的新任务,成功率 %):Close Jar 61.0、Take Item Out of Box 48.0,平均 54.5;而用同样 10 条演示微调 80,000 步的 3DFA 全量微调只有 10.0%,LoRA 版 15.0%。
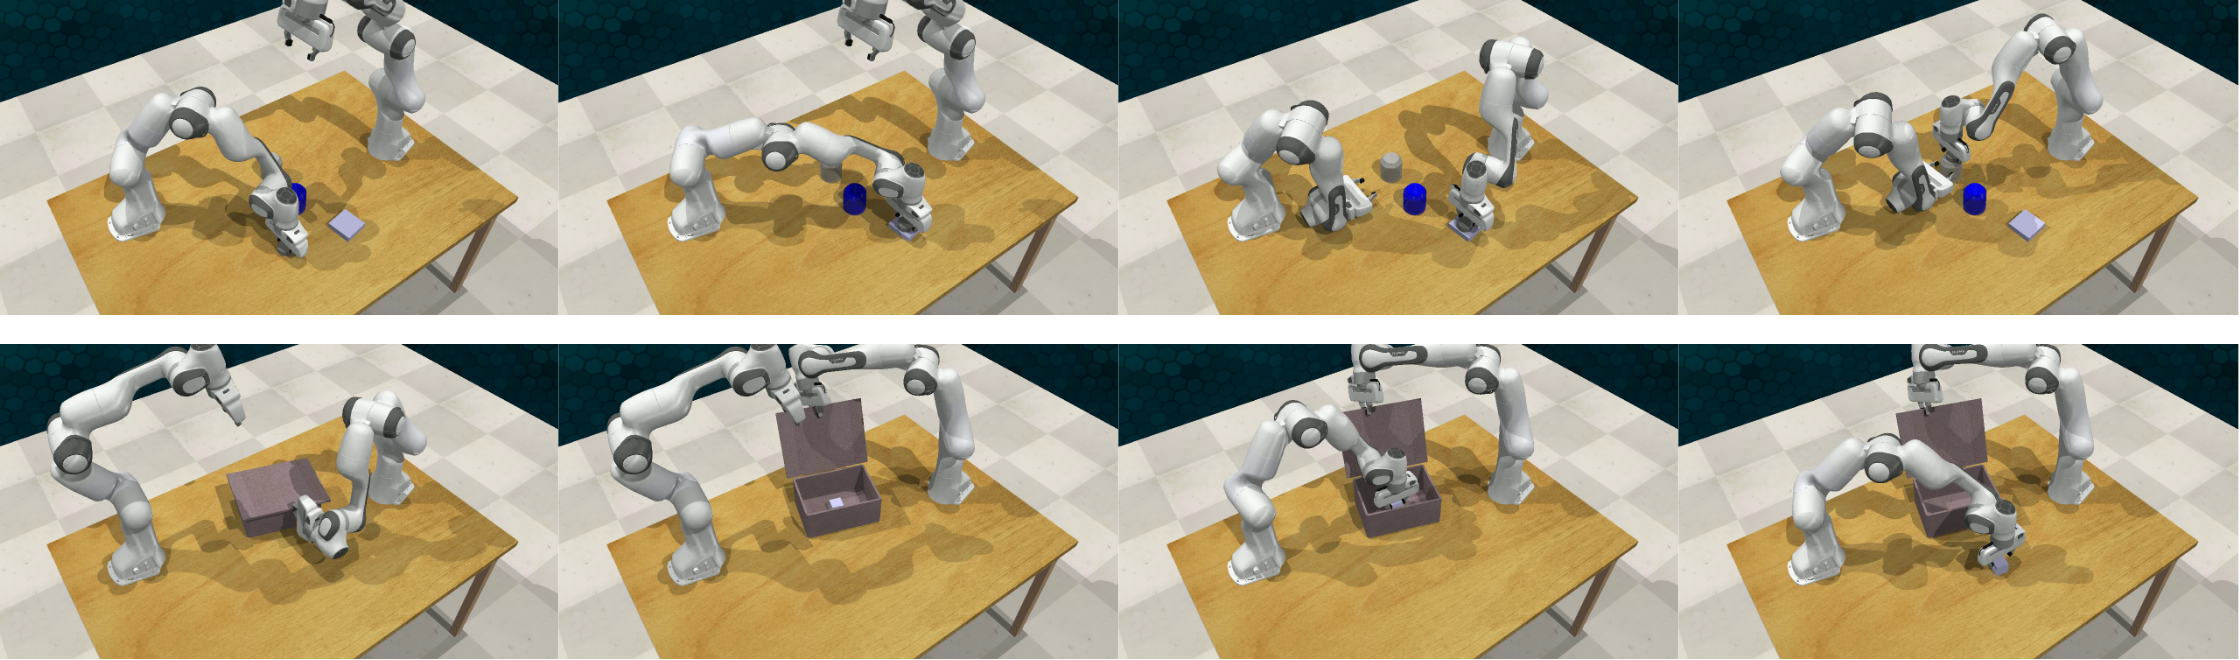 图 2:TWIN 之外的两个泛化任务。上为 Close Jar(一臂递盖并按住罐身、另一臂取盖对准罐口),下为 Take Item Out of Box(一臂掀盖、另一臂抓取盒内物体并置于桌面)。
真实世界部署(每个任务 10 次试运行,成功率 %)
| 方法 | Lift Box | Open Pot | Cleanup | 平均 |
|---|---|---|---|---|
| KAT-DA | 40.0 | 20.0 | 10.0 | 23.3 |
| RoboPrompt-DA | 30.0 | 40.0 | 30.0 | 33.3 |
| BiCICLe | 60.0 | 40.0 | 60.0 | 53.3 |
真机实验使用两台 Franka Panda Research 3 与眼镜视角的 ZED X 相机,每任务采集 15 条动觉演示,物体位姿由 FoundationPose 估计并额外加入偏航角,预测的 6D 位姿与夹爪状态经 MoveIt 执行。
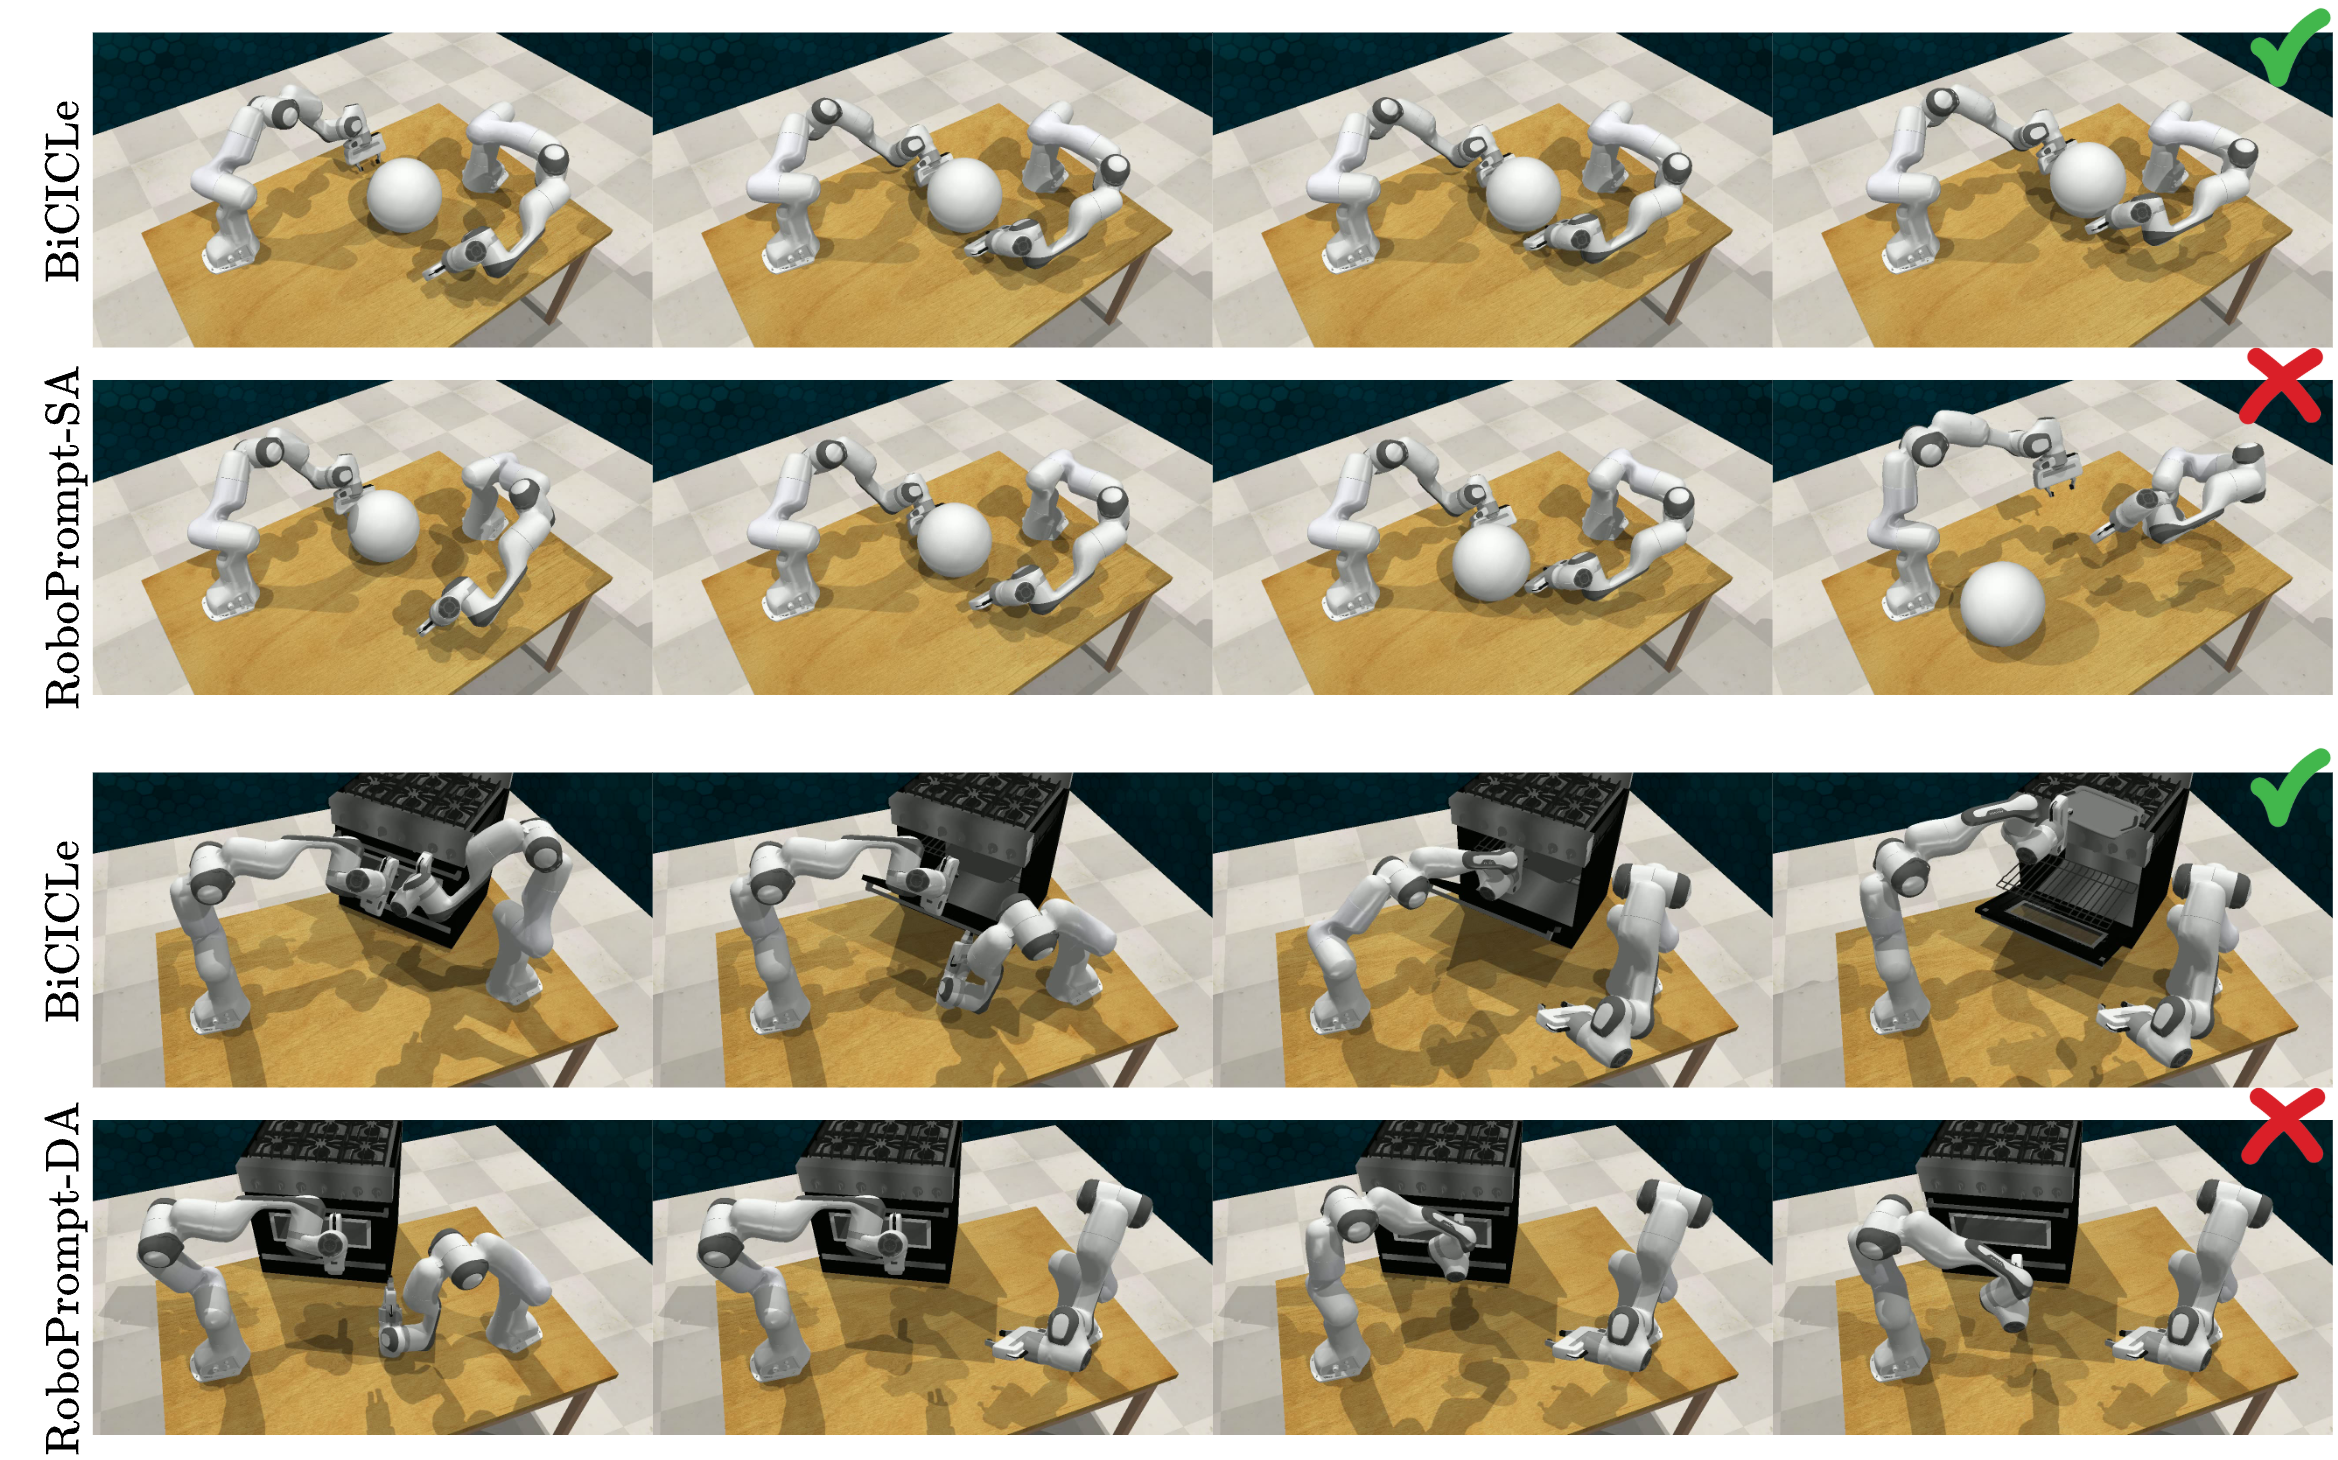 图 3:定性对比。上两行为紧耦合对称的 Lift Ball(对比 RoboPrompt-SA,单智能体高维预测导致单臂精度不足、球滚落桌面),下两行为松耦合的 Tray Oven(对比 RoboPrompt-DA,无信息共享导致开门的臂尚未到位时另一臂已伸入烤箱而碰撞)。
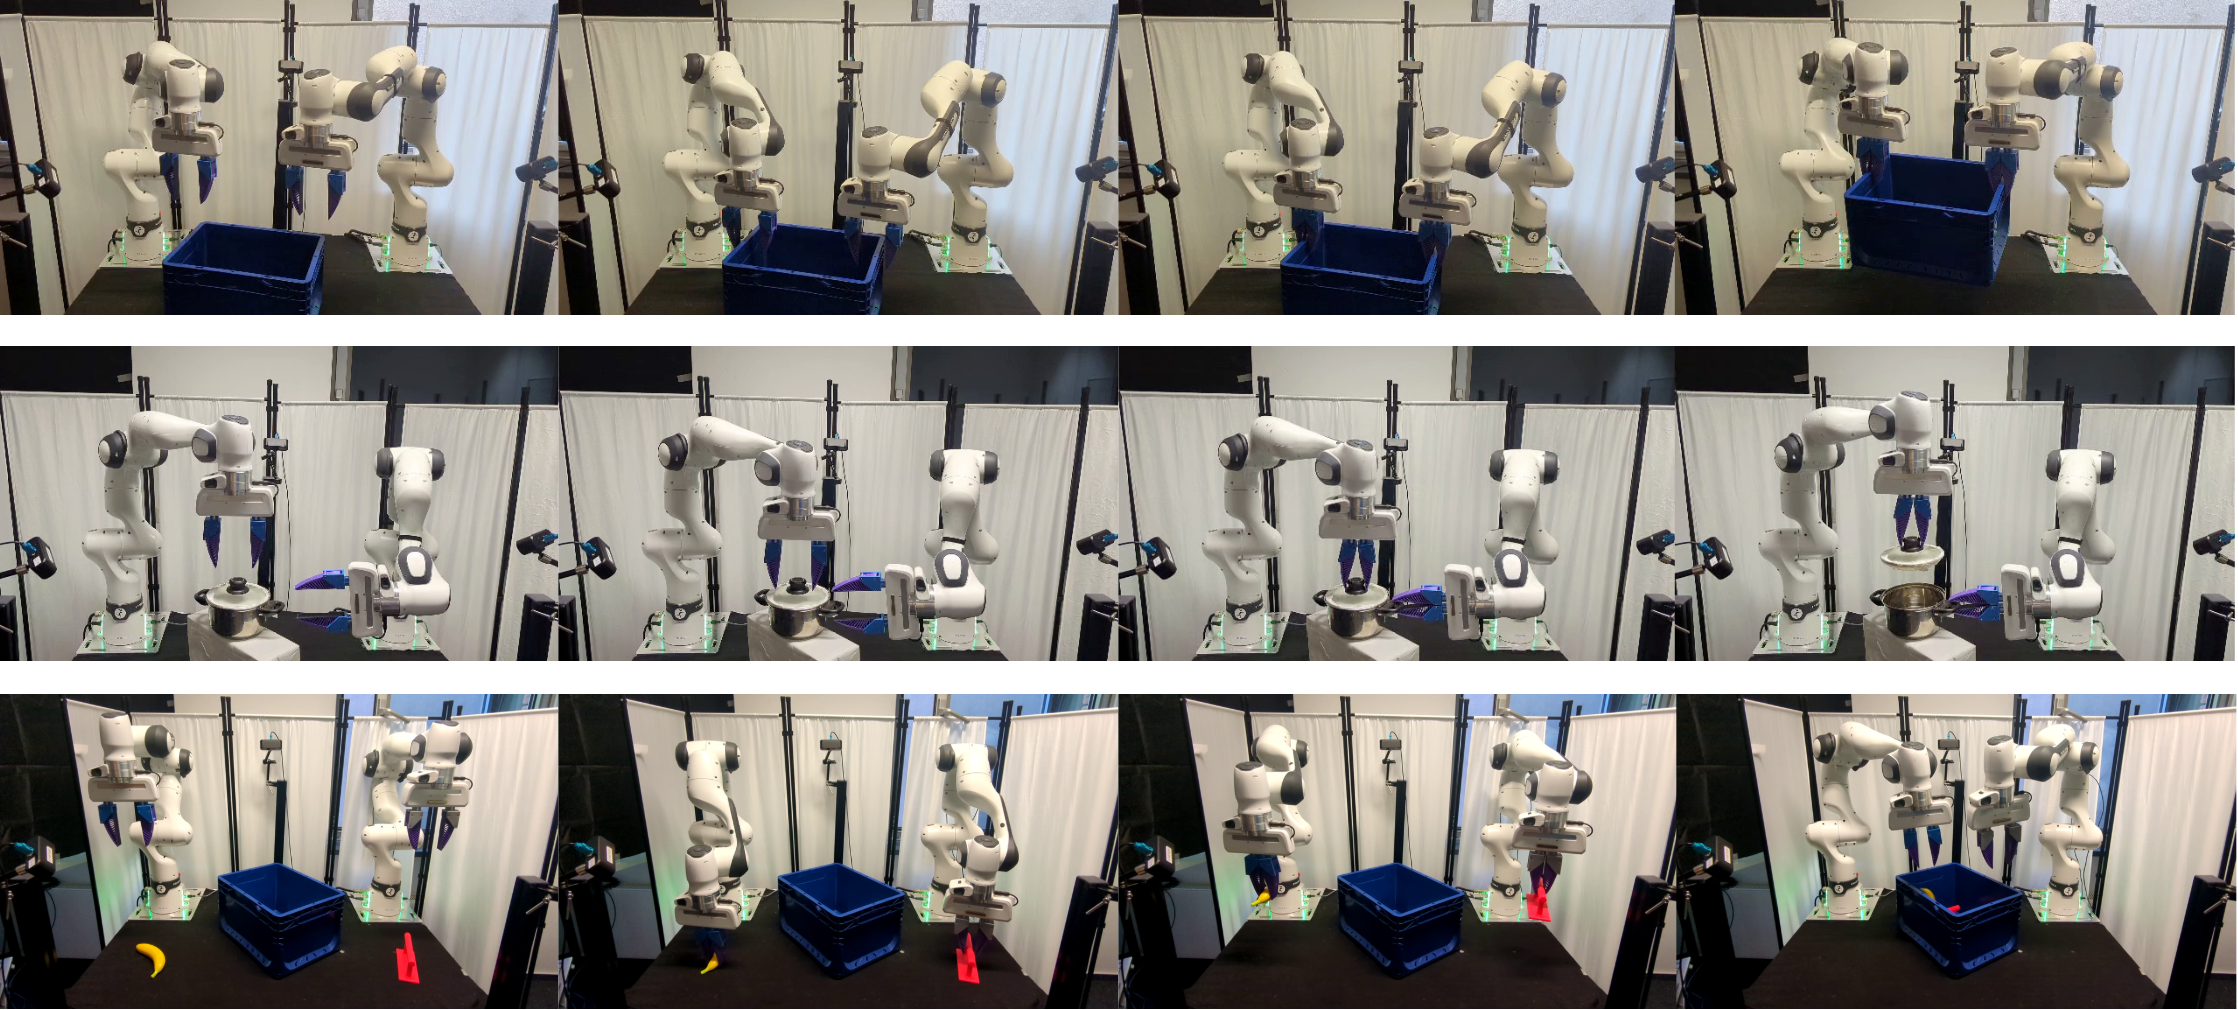 图 4:真机上的任务执行。上为 Lift Box、中为 Open Pot、下为 Cleanup;同一套基于位姿的上下文学习接口在没有任何硬件特定重训的情况下迁移到物理双臂系统。
结果对比总结
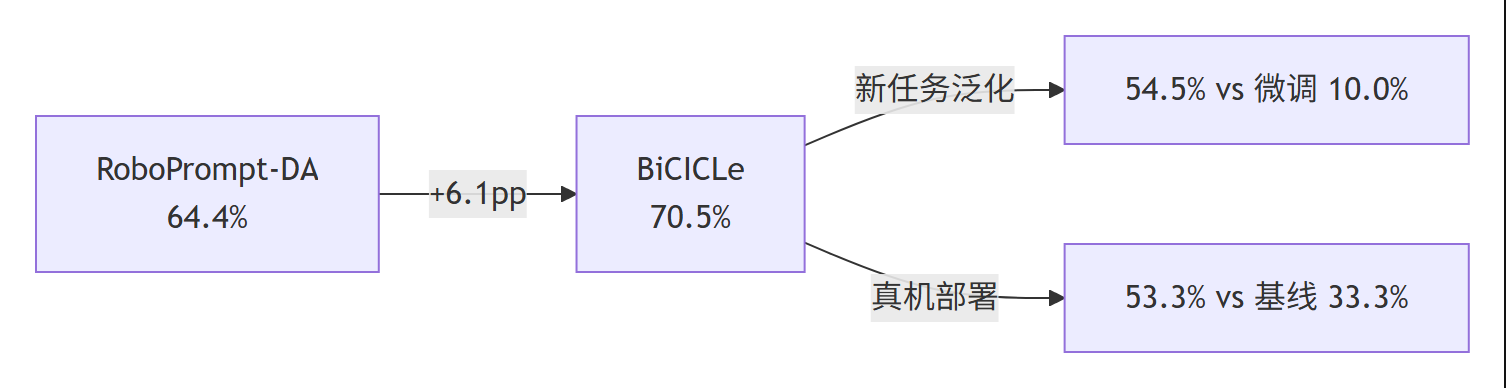 图 7:结果对比总结(Mermaid 流程图)——BiCICLe 相比最强免训练基线 RoboPrompt-DA 提升 6.1 个百分点(64.4% → 70.5%),新任务泛化 54.5% 对微调基线 10.0%,真机部署 53.3% 对基线 33.3%。
关键发现
- 条件化是真正的杠杆:只把预测顺序化(Sequential Arms)得到 65.0%,与双臂独立基线的 64.4% 几乎持平,但加上 follower 对 leader 轨迹的条件化后跃升到 70.5%,增益 5.5 个百分点——说明价值来自协调通道,而非单纯把动作维度砍半。
- 免训练策略足以与监督方法竞争:13 任务平均 70.5% 超过 ACT(5.9%)、PerAct²(16.8%)、$\pi_0$-keypose(43.7%)与 AnyBimanual(32.0%);在分布外新任务上 54.5% 对微调版本的 10.0%,差距 5.5 倍。
- 表征比感知更重要:基于 DINO-ViT 关键点的 KAT 系列平均只有 17.4%–20.3%,即便拿到 RGB 与深度图的 VLM-LF 也只有 13.4%,说明离散化的语义物体坐标比外观关键点包含更多对协调有用的信息。
- 结构化先验比堆采样划算:Best-of-N 用 5 次采样加 LLM 打分,只把平均从 70.5% 提到 71.2%(+0.7 个百分点),代价是 token 预算从 21.5k 涨到 180.7k(8.4 倍);多轮对话式精修反而把成功率拉到 57.5%。
- 对骨干规模不敏感:换成开源的 Qwen 2.5 7B 后,BiCICLe(配 Best-of-N)仍有 56.5%,高于最强基线 RoboPrompt-SA 的 51.9%,方法排名保持一致。
- 感知细节影响有限但有指向性:把观测从 3 个位置 token 扩到 6 个(加入欧拉角)平均降到 65.2%(-5.3 个百分点);点云聚合方式从逐视角平均改为体素降采样后取质心,平均质心误差从 5.83 cm 降到 3.45 cm(改善 41%)。
- 写作上的可读性设计:论文用具体场景开场(端托盘、拧瓶盖),再用双重否定定位空白——拼接成一条联合序列会产出不连贯计划,把两臂当作独立智能体同样不可行;最后以仿真成绩、新任务泛化与真机部署三重兑现收束。措辞上以实测结果陈述贡献,并主动说明监督对比行"仅作文献参照而非匹配比较"(provide literature reference points rather than matched comparisons);需要留意的是摘要中真机性能更强的表述只在与弱基线比较时成立(53.3% 对 33.3% / 23.3%)。
局限性
论文主动列出四类局限:
- 感知假设偏强:仿真里用真值分割掩码挑选物体点,物体中心仍由 RGB-D 点云估计;真机上退化为在野位姿估计,误差会直接进入观测。
- 离散关键位姿的精度天花板:最弱的三个任务分别是 Straighten Rope(34.3%)、Pick Laptop(29.0%)与 Tray Oven(36.0%),对应细密连续接触、薄物体抓取与受限多步操作。把体素网格加密到 $200^3$、姿态分箱降到 $2.5^\circ$ 后,这四个困难任务只从 36.5% 提升到 39.3%,说明瓶颈不只来自量化误差,接触动力学与长时程重规划同样受限。
- 链式结构的可扩展性:上下文窗口与接口延迟限制了演示数量与可行任务时长(Lift Ball 上 21.5k tokens、中位 125.3 s/episode);顺序两臂链条在更大的团队中可能让后续智能体过度受制于前序预测。
- 真机精度瓶颈:粗离散下抓取位姿容易错位,小把手或部分遮挡的物体对位姿估计噪声敏感,是 53.3% 之外剩余失败的主要来源。
作者给出的方向是借鉴 RoCo 等多智能体规划器,把单一链条换成任务相关的协调图:智能体交换候选子目标,只对紧耦合的伙伴做条件化,并在提交动作前做一次轻量一致性检查。
常见问题(FAQ)
BiCICLe 需要训练吗?
不需要。语言模型全程冻结,新任务只通过提示中的 10 条演示与 leader_arm 条件通道注入,没有任何梯度更新,也不需要任务专用数据集。
为什么不让一个模型直接预测双臂动作?
双臂联合动作是 $\mathbb{Z}^{14}$ 的高维序列,直接预测会同时抬高 token 长度与每步模式复杂度,实验证实单智能体版本平均只有 60.6%;反过来让两臂完全独立又会丢掉协调,例如交接任务掉到 82.7%。BiCICLe 用两次 7 维预测加一条条件化通道同时解决这两个问题。
它和视觉语言动作模型(VLA)是什么关系?
作者明确说明它不是 VLA 的替代品:BiCICLe 是结构化关键位姿预测器,输入是物体中心点的离散坐标,输出稀疏的末端目标,执行交给运动规划器;VLA 则直接消费图像输出连续动作块。在 TWIN 上最相关的对照是 $\pi_0$-keypose(43.7%)。
左右臂谁当 leader 影响大吗?
很小。默认右臂为 leader 时平均 70.5%,换成左臂为 69.2%,只差 1.3 个百分点;残余差异主要出现在右臂天然承担主操作的任务上。
多轮对话式精修为什么没帮助?
因为精修会系统性破坏 leader 的预测:夹爪状态被反转、空间坐标的相位结构塌缩为单一取值、甚至出现跨臂坐标泄漏(leader 的 $x$ 漂移到 follower 工作区的特征值)。实验里这个变体平均只有 57.5%,token 预算却是基线方法的 3.4 倍。
真机上要改什么?
只替换两个外围模块:用 FoundationPose 做物体位姿估计(并额外加入物体偏航角),用 MoveIt 执行预测的 6D 位姿;语言模型、提示结构与动作离散化协议都保持不变。
参考链接
- 论文 arXiv 摘要页:https://arxiv.org/abs/2604.20348
- 项目主页:https://alesspalma.github.io/bicicle
- RoboPrompt:Yin et al., In-Context Learning Enables Robot Action Prediction in LLMs, ICRA 2025(https://arxiv.org/abs/2410.12782)
- KAT:Di Palo & Johns, Keypoint Action Tokens Enable In-Context Imitation Learning in Robotics, RSS 2024(https://arxiv.org/abs/2403.19578)
- TWIN 双臂基准:Grotz et al., TWIN: Two-handed Intelligent Benchmark for Bimanual Manipulation, ICRA 2025(https://www.semanticscholar.org/CorpusID:281094284)
- 双臂操作分类学:Krebs & Asfour, A Bimanual Manipulation Taxonomy, RA-L 2022(https://doi.org/10.1109/LRA.2022.3196158)
- 3DFA 监督基线:Gkanatsios et al., 3D FlowMatch Actor: Unified 3D Policy for Single- and Dual-Arm Manipulation, 2025(https://arxiv.org/abs/2508.11002)
- RoCo 多智能体协调:Mandi, Jain & Song, RoCo: Dialectic Multi-Robot Collaboration with Large Language Models, ICRA 2024(https://arxiv.org/abs/2307.04738)
- 创新模式框架:Zhao, Huang et al., ResearchStudio-Idea(1,947 篇顶会论文的创新模式分析), 2026(https://arxiv.org/abs/2607.04439)
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群:白拾的小屋 (750365700)
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 0
 0
- 0


 已为社区贡献75条内容

所有评论(0)