LeRobot SO-101 机械臂从底层控制到 VLA 视觉语言动作模型完整实操复盘:π0.5 LoRA 微调
Task6:基于 SO-101 数据微调 π0.5
前面已经完成了 SO-101 的遥操作、数据采集和 Diffusion Policy 训练。本次继续尝试 π0.5,使用已有的 LeRobot 数据,通过 LoRA 微调让预训练模型适应自己的机械臂任务。
整个流程仍然是:准备数据 → 检查输入输出 → 加载预训练模型 → 微调 → 保存 checkpoint → 实机测试。不同之处在于,这次需要同时处理图像、机器人状态和任务文字,并在部署时正确加载 LoRA 权重。
本文的命令按固定版本的 LeRobot 源码重新整理,作为复现参考;原始命令未完整保留,下面的起步参数没有在本次 RTX 4090 环境中重新实测。最后的训练曲线和实机现象来自第六周实验记录,不能视为下方参考参数产生的结果。
一、任务介绍与实验环境
本次使用 SO-101 机械臂,训练设备为 RTX 4090。Mac 负责连接机械臂和摄像头,服务器负责训练与模型推理。远程部署继续使用前文的链路:
Mac:采集相机图像和机械臂状态,发送观测、接收动作
    ↕ SSH 隧道
服务器:加载策略,根据观测生成动作
π0.5 属于视觉语言动作模型。对本文任务而言,可以把一次策略调用理解为:输入当前画面、机械臂状态和任务描述,输出后续一段时间的动作。
LoRA 则用于减少微调时需要更新的参数:保留基础模型,在部分层上训练较小的适配器。基础权重仍需加载,图像和动作的计算也仍然占用显存,所以选择 LoRA 后,batch size 和相机数量依然需要根据设备调整。LeRobot PEFT 说明
二、沿用前文的数据集
示例使用前文公开的数据集 feng0724821/so101_test_record。任务描述为:
Place the bottle next to the national flag
即把瓶子放到国旗旁边。为了便于复现,本文固定数据 revision 为 e78431cbd96856c32822adc73f94ead78ea3d4a1,该版本包含:
- 50 个 episode,共 26,710 帧,采集频率为 30 FPS。
- 一路腕部相机
observation.images.wrist,视频分辨率为 640×480。 - 六维机械臂状态
observation.state和六维动作action。 - LeRobot Dataset v3.0 格式,视频编码为 AV1。
这里的一个 episode 对应一段示范轨迹;一帧则包含某个时刻的状态、动作及对应图像,二者不能混为一谈。数据集元数据
状态和动作的维度顺序均为:
shoulder_pan.pos
shoulder_lift.pos
elbow_flex.pos
wrist_flex.pos
wrist_roll.pos
gripper.pos
前五维对应机械臂关节位置,最后一维对应夹爪。这里不是末端的六维位姿。训练时保留数据原有的动作语义,部署时使用一致的关节顺序、校准和单位,不根据数值范围自行转换成角度或弧度。
这个公开版本与后续实验需要区分:第五周报告记录过扩充到 80 段的数据,第六周还涉及双摄采集的方块、盒子任务。本文用前文公开的单摄版本讲解训练流程,后面单独讨论第六周的部署现象。
三、准备训练环境并检查数据
以下命令在 RTX 4090 所在的 Linux 服务器执行。建议建立独立环境,避免与前文 Diffusion Policy 的依赖互相影响。
conda create -n lerobot-pi05 python=3.12 -y
conda activate lerobot-pi05
conda install -c conda-forge ffmpeg=7.1.1 -y

git clone https://github.com/huggingface/lerobot.git lerobot-pi05
cd lerobot-pi05
git checkout e0d50211ef236143ae867228662b7dfaba554f02
python -m pip install -e ".[pi,peft,training]"

nvidia-smi
python -c 'import torch; print(torch.__version__, torch.cuda.is_available())'
其中,pi 安装 π 系列模型依赖,peft 提供 LoRA 支持,training 安装训练相关依赖。固定源码版本是为了让后面的参数名、数据处理和 checkpoint 加载方式保持一致。torch.cuda.is_available() 应输出 True。该版本依赖配置
π0.5 使用 PaliGemma tokenizer。先在 Hugging Face 完成 google/paligemma-3b-pt-224 的访问授权,再执行 hf auth login 登录自己的账号。π0.5 官方说明
1. 下载基础模型
在 LeRobot 仓库目录执行:
export SO101_DATASET="feng0724821/so101_test_record"
export SO101_REVISION="e78431cbd96856c32822adc73f94ead78ea3d4a1"
export PI05_BASE_DIR="$PWD/../pi05_models/pi05_base"

python - <<'PY'
import os
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="lerobot/pi05_base",
    revision="b211f3d44c36b6acfcf7ae94a64e8e96f75a64ba",
    local_dir=os.environ["PI05_BASE_DIR"],
)
PY
repo_id 指定基础模型,revision 固定模型版本,local_dir 指定本地保存位置。后续训练直接读取 PI05_BASE_DIR,方便保证训练和 adapter 重载使用同一份基础权重。重新打开终端时,需要再次设置这三个环境变量。
2. 读取一条数据检查字段
沿用前文的数据检查方式,先确认当前环境能读数据、解码视频,再启动训练:
python - <<'PY'
import os
from lerobot.datasets.lerobot_dataset import LeRobotDataset

ds = LeRobotDataset(
    os.environ["SO101_DATASET"],
    revision=os.environ["SO101_REVISION"],
    video_backend="pyav",
)
print("episodes:", ds.num_episodes)
print("frames:", ds.num_frames)
print("fps:", ds.fps)
print("cameras:", ds.meta.camera_keys)

sample = ds[0]
for key in ("observation.images.wrist", "observation.state", "action"):
    print(key, tuple(sample[key].shape), sample[key].dtype)
print("task:", sample["task"])
assert sample["observation.state"].shape == (6,)
assert sample["action"].shape == (6,)
for key in ("observation.state", "action"):
    assert {"q01", "q99"} <= ds.meta.stats[key].keys()
PY
预期核对到 50 段、26,710 帧、30 FPS,以及单路 wrist。视频读取后通常变为通道在前的 (3, 480, 640) 张量;状态和动作均为 (6,)。
其中,video_backend="pyav" 指定解码后端,后面的训练也保持一致;sample["task"] 是送入模型的任务文字。最后的断言检查状态和动作是否带有 q01、q99,即 1% 和 99% 分位数。π0.5 默认使用这些统计量进行归一化,这份数据已经包含,不必为了切换模型重复计算。已保存的统计量
四、启动 LoRA 微调
下面给出完整训练入口。第一次执行时,先按本节末尾的方法改成 100 步试跑,确认链路正常后再使用完整训练设置。
mkdir -p outputs/train_logs
set -o pipefail

lerobot-train \
  --dataset.repo_id="$SO101_DATASET" \
  --dataset.revision="$SO101_REVISION" \
  --dataset.video_backend=pyav \
  --dataset.eval_split=0.1 \
  --policy.type=pi05 \
  --policy.pretrained_path="$PI05_BASE_DIR" \
  --policy.device=cuda \
  --policy.dtype=bfloat16 \
  --policy.gradient_checkpointing=true \
  --policy.chunk_size=50 \
  --policy.n_action_steps=10 \
  --policy.optimizer_lr=1e-4 \
  --policy.scheduler_decay_lr=1e-5 \
  --policy.scheduler_warmup_steps=500 \
  --policy.scheduler_decay_steps=10000 \
  --peft.method_type=LORA \
  --peft.r=16 \
  --peft.lora_alpha=32 \
  --accelerator.mixed_precision=bf16 \
  --batch_size=1 \
  --num_workers=2 \
  --steps=10000 \
  --save_freq=1000 \
  --log_freq=10 \
  --eval_steps=1000 \
  --max_eval_samples=128 \
  --env_eval_freq=0 \
  --policy.push_to_hub=false \
  --wandb.enable=false \
  --output_dir=outputs/train/pi05_so101_lora \
  2>&1 | tee outputs/train_logs/pi05_so101_lora.log
其中,各组参数的作用如下。
1. 数据与模型参数
dataset.repo_id、dataset.revision:指定数据集及版本,避免仓库更新后示范数量、相机字段发生变化。dataset.eval_split=0.1:按 episode 留出 10% 数据。该版本会为这份单任务数据留下末尾 5 段做验证,其余 45 段训练,避免同一段轨迹被随意按帧切开。policy.type=pi05:选择 π0.5 策略。policy.pretrained_path:加载基础模型权重。配合policy.type使用时,输入输出字段从当前数据集解析,因此仍使用observation.images.wrist,不用为了套别的示例改成image或补出双摄。
SO-101 的六维动作由模型内部适配,不需要手工把数据改成其他机器人的七维动作。特征解析与加载实现
2. LoRA 参数
peft.method_type=LORA:启用 LoRA 微调。peft.r=16:设置低秩适配器的秩,影响可训练参数量和适配容量;增大后不一定能提高实机效果。peft.lora_alpha=32:控制 LoRA 更新的缩放。普通 LoRA 使用alpha/r,这里为 2,但不能把它直接理解成学习率。
当前 π0.5 默认在动作专家的部分注意力投影,以及动作、时间投影上加入适配器。基础权重被冻结,这不是全参数训练。新建训练时使用 peft 参数即可,不要额外把用于加载已有 adapter 的 policy.use_peft 设置为 true。π0.5 默认适配层
3. 显存和数据加载参数
policy.device=cuda:使用服务器 GPU。policy.dtype=bfloat16和accelerator.mixed_precision=bf16:分别设置模型计算精度和训练自动混合精度。policy.gradient_checkpointing=true:用反向传播时的部分重计算换取较低的激活显存。batch_size=1:每次处理一个样本,作为 24GB 显存环境的起点。num_workers=2:使用两个数据加载进程,主要影响 CPU 侧读取速度和内存。
本例没有开启梯度累积。先通过 100 步试跑观察显存占用;更换相机数量或模型实现后,也要重新检查。运行配置
4. 动作长度与学习率
chunk_size=50:模型一次预测 50 个时间步的动作。n_action_steps=10:使用标准select_action接口时,执行其中 10 步后请求新预测。它不会把训练目标的长度改成 10,远程服务如果有独立动作队列,还要看服务端实现。optimizer_lr=1e-4:设置峰值学习率。scheduler_warmup_steps=500:前 500 步逐渐提高学习率。scheduler_decay_steps=10000、scheduler_decay_lr=1e-5:在给定训练长度内按调度衰减到较低学习率。steps=10000:本轮训练的迭代次数,不是采集了 10,000 段轨迹,也不是 10,000 个 epoch。
调整学习率和训练长度时,同时观察训练、验证 loss,并保留几个阶段的 checkpoint 做实机比较。π0.5 参数定义
5. 日志、验证与保存
log_freq=10 表示每 10 步打印训练信息;save_freq=1000 表示每 1000 步保存 checkpoint;eval_steps=1000 表示每 1000 步计算保留数据上的 loss。max_eval_samples=128 限制验证样本数量,适合快速观察趋势,但不能代表完整五段验证轨迹的表现。这个流程仍使用数据集已有的全量统计量,也不应称为严格独立的泛化评估。
env_eval_freq=0 关闭仿真环境评估;policy.push_to_hub=false、wandb.enable=false 让模型和日志保留在本地。2>&1 | tee ... 同时显示并保存标准输出和错误信息,方便后续排查。训练配置
6. 先做 100 步试跑
复制上面的训练命令,将 steps、save_freq、scheduler_decay_steps 改为 100,scheduler_warmup_steps 改为 5,eval_steps 改为 0。输出目录和日志名称分别换成 outputs/train/pi05_so101_smoke、outputs/train_logs/pi05_so101_smoke.log。
试跑主要检查预训练权重能否加载、数据能否进入模型、loss 是否为有限值,以及能否完成反向传播和保存。确认日志出现 All keys loaded successfully!;若出现 Returning model without loading pretrained weights,先解决权重加载问题,不能因为训练开始输出 loss 就继续。权重加载实现
通过后,再用正式目录运行完整命令。每个新实验使用独立输出目录,保留对应日志,便于比较参数变化。
五、检查 checkpoint 并恢复训练
训练输出在 outputs/train/pi05_so101_lora/,最新 checkpoint 可以通过 checkpoints/last/ 找到:
checkpoints/last/
├── pretrained_model/
│   ├── adapter_config.json
│   ├── adapter_model.safetensors
│   ├── config.json
│   ├── train_config.json
│   ├── policy_preprocessor.json
│   ├── policy_postprocessor.json
│   └── 处理器关联的统计量文件
└── training_state/
其中,adapter_model.safetensors 保存 LoRA 权重,adapter_config.json 记录适配器配置及基础模型位置,处理器文件保存预处理、归一化等信息,training_state 保存继续训练需要的状态。last 指向最新保存结果,并不表示实机效果最好。checkpoint 保存实现
LoRA checkpoint 仍依赖基础模型,不能只拷贝一个 adapter 权重文件就部署。尤其本文使用本地基础模型目录,迁移服务器时要同时保留基础权重,并检查 adapter 中记录的路径。
如果训练中断,使用保存的训练配置恢复:
lerobot-train \
  --config_path=outputs/train/pi05_so101_lora/checkpoints/last/pretrained_model/train_config.json \
  --resume=true
这里 config_path 指向原训练配置,resume=true 恢复已有训练状态。它与仅加载权重开始一轮新训练不同,也不等于自动延长已经完成的训练计划。
六、推理前先做离线检查
接入机械臂前,可以先取数据集的一条观测,在服务器检查“图像和状态 → 模型 → 六维动作”的链路。以下代码不连接机械臂:
python - <<'PY'
import os
from pathlib import Path
import torch
from lerobot.configs import PreTrainedConfig
from lerobot.datasets.lerobot_dataset import LeRobotDataset
from lerobot.policies import make_policy, make_pre_post_processors

ckpt = Path("outputs/train/pi05_so101_lora/checkpoints/last/pretrained_model")
ds = LeRobotDataset(
    os.environ["SO101_DATASET"],
    revision=os.environ["SO101_REVISION"],
    video_backend="pyav",
)
cfg = PreTrainedConfig.from_pretrained(ckpt)
cfg.pretrained_path = ckpt
cfg.pretrained_revision = None
cfg.device = "cuda"
assert cfg.use_peft
policy = make_policy(cfg, ds_meta=ds.meta).eval()
policy.reset()
pre, post = make_pre_post_processors(
    cfg,
    pretrained_path=ckpt,
    preprocessor_overrides={"device_processor": {"device": "cuda"}},
)
sample = ds[0]
obs = {k: v for k, v in sample.items() if k.startswith("observation.") or k == "task"}
with torch.inference_mode():
    action = post(policy.select_action(pre(obs)))
print("action shape:", tuple(action.shape))
print("action:", action)
assert tuple(action.shape) == (1, 6)
assert torch.isfinite(action).all()
PY
其中,make_policy 负责组合加载基础模型和 adapter;pre 使用训练保存的处理器整理观测,post 将模型输出转换回机器人的动作尺度;(1, 6) 表示一个样本对应六维动作。代码通过只能说明离线调用链正常,不能说明动作已经准确。策略与处理器工厂
继续采用 Mac 客户端和服务器推理时,也要检查服务端是否使用兼容 LoRA 的加载方式。本文固定版本中的旧 async_inference/policy_server.py 直接调用策略类的 from_pretrained(),没有经过上述 PEFT 加载分支,因此不能只把旧命令里的 checkpoint 换成 adapter 目录。旧服务端加载入口
原实验的服务端修改记录没有完整保留,这里不拼接一条未经验证的远程部署命令。迁移时应先让服务正确加载模型与处理器,再核对相机字段、关节顺序和控制频率。
七、第六周的训练结果与实机问题
下面是第六周汇报中保存的训练曲线:
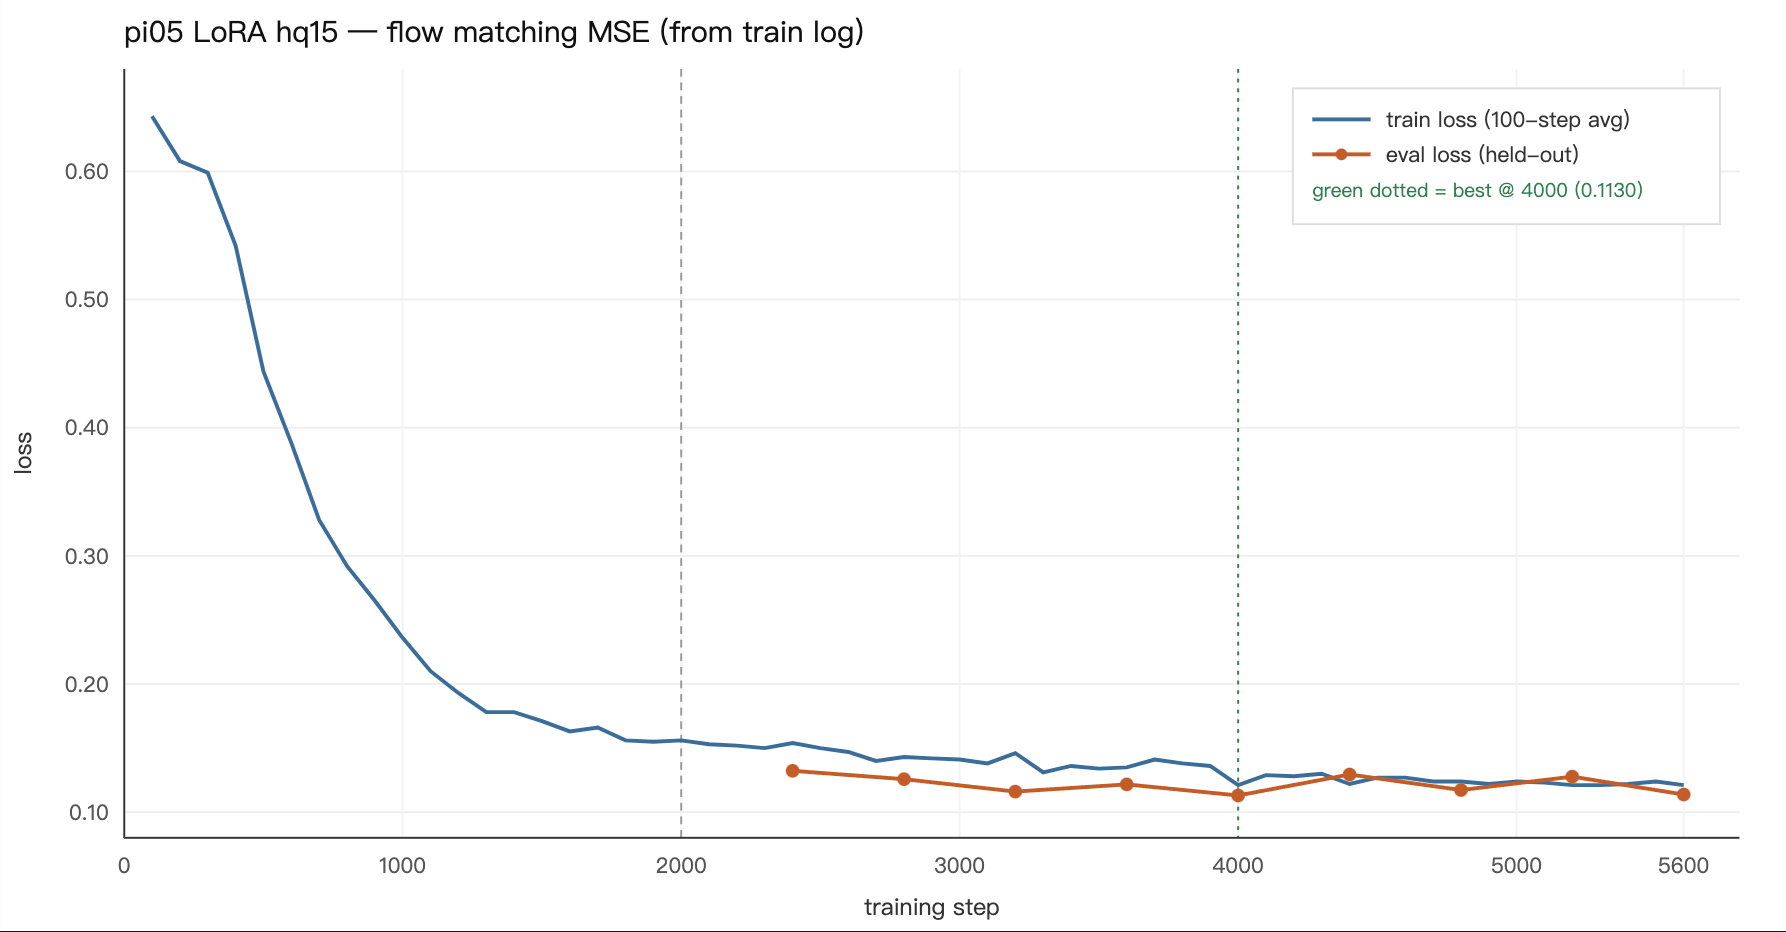
训练 loss 从约 0.64 下降到 0.12 附近,图中标注的最佳验证点为第 4000 步,验证 loss 为 0.1130,曲线展示到了约 5600 步。这个结果可用于筛选待测试的 checkpoint,但不能直接换算成实机成功率,也没有记录能确认最终部署的就是第 4000 步模型。实验周报第 118 页
现有记录未保留这张曲线对应的完整数据版本,因此不据此比较单摄与双摄训练效果,也不把它标作前面公开 50 段数据的训练结果。
1. 双摄训练与单摄推理不一致
当时双摄采集的数据包含两个视角,但 Mac 通过扩展坞同时接入两个摄像头时会出现卡死,推理只能保留腕部 wrist 相机。实际现象是模型能看到蓝色方块,却难以定位盒子。
当时的排查记录认为,缺失相机通路被填成了黑图,输入与训练时的双摄画面不一致;同时腕部视野主要覆盖夹爪附近,没有有效看到桌面上的盒子。具体的填图和屏蔽行为取决于代码版本,但这个现象说明检查时需要查看模型真正收到的画面,不能只看客户端能否连接、服务器是否输出动作。
双摄训练后,简单删除一路摄像头不会自动得到适合单摄的策略。后续应先固定硬件配置,保证采集和推理的视角一致,并让目标物体和放置区域获得足够的视觉覆盖。实验周报第 117 页
2. 单视角实验仍有动作震荡
另一组实验使用单视角采集的数据。把物体放在视野中心时能够跑通任务,但动作仍有明显震荡,执行时间也较长。现有记录不足以把原因完全归到训练不足、过拟合或网络延迟上,需要分别检查数据覆盖、模型输出、通信耗时和动作执行过程。
下一轮可以固定物体初始位置做重复测试,再逐步改变位置,记录每次是否完成、完成时间以及失败阶段;同时比较不同 checkpoint。周报没有给出完整的成功次数和测试次数,本文因此只保留观察到的现象。实验周报第 118 页
这次实验已经跑通 π0.5 微调和实机调用。继续提高效果时,优先解决相机输入的一致性和任务视野,再通过重复测试判断需要增加什么样的数据、调整哪些训练参数。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)