两层嵌套的 U:U²-Net 如何不靠预训练,把显著性抠到发丝?
U²-Net 是一种为显著性目标检测设计的两层嵌套 U 型结构网络,它通过创新的 RSU 残差子块在不依赖预训练骨干网络的情况下,从零训练即可达到 SOTA 性能,并因其出色的细节捕捉能力成为 rembg 等背景移除工具的核心模型。
一、要解决什么问题?
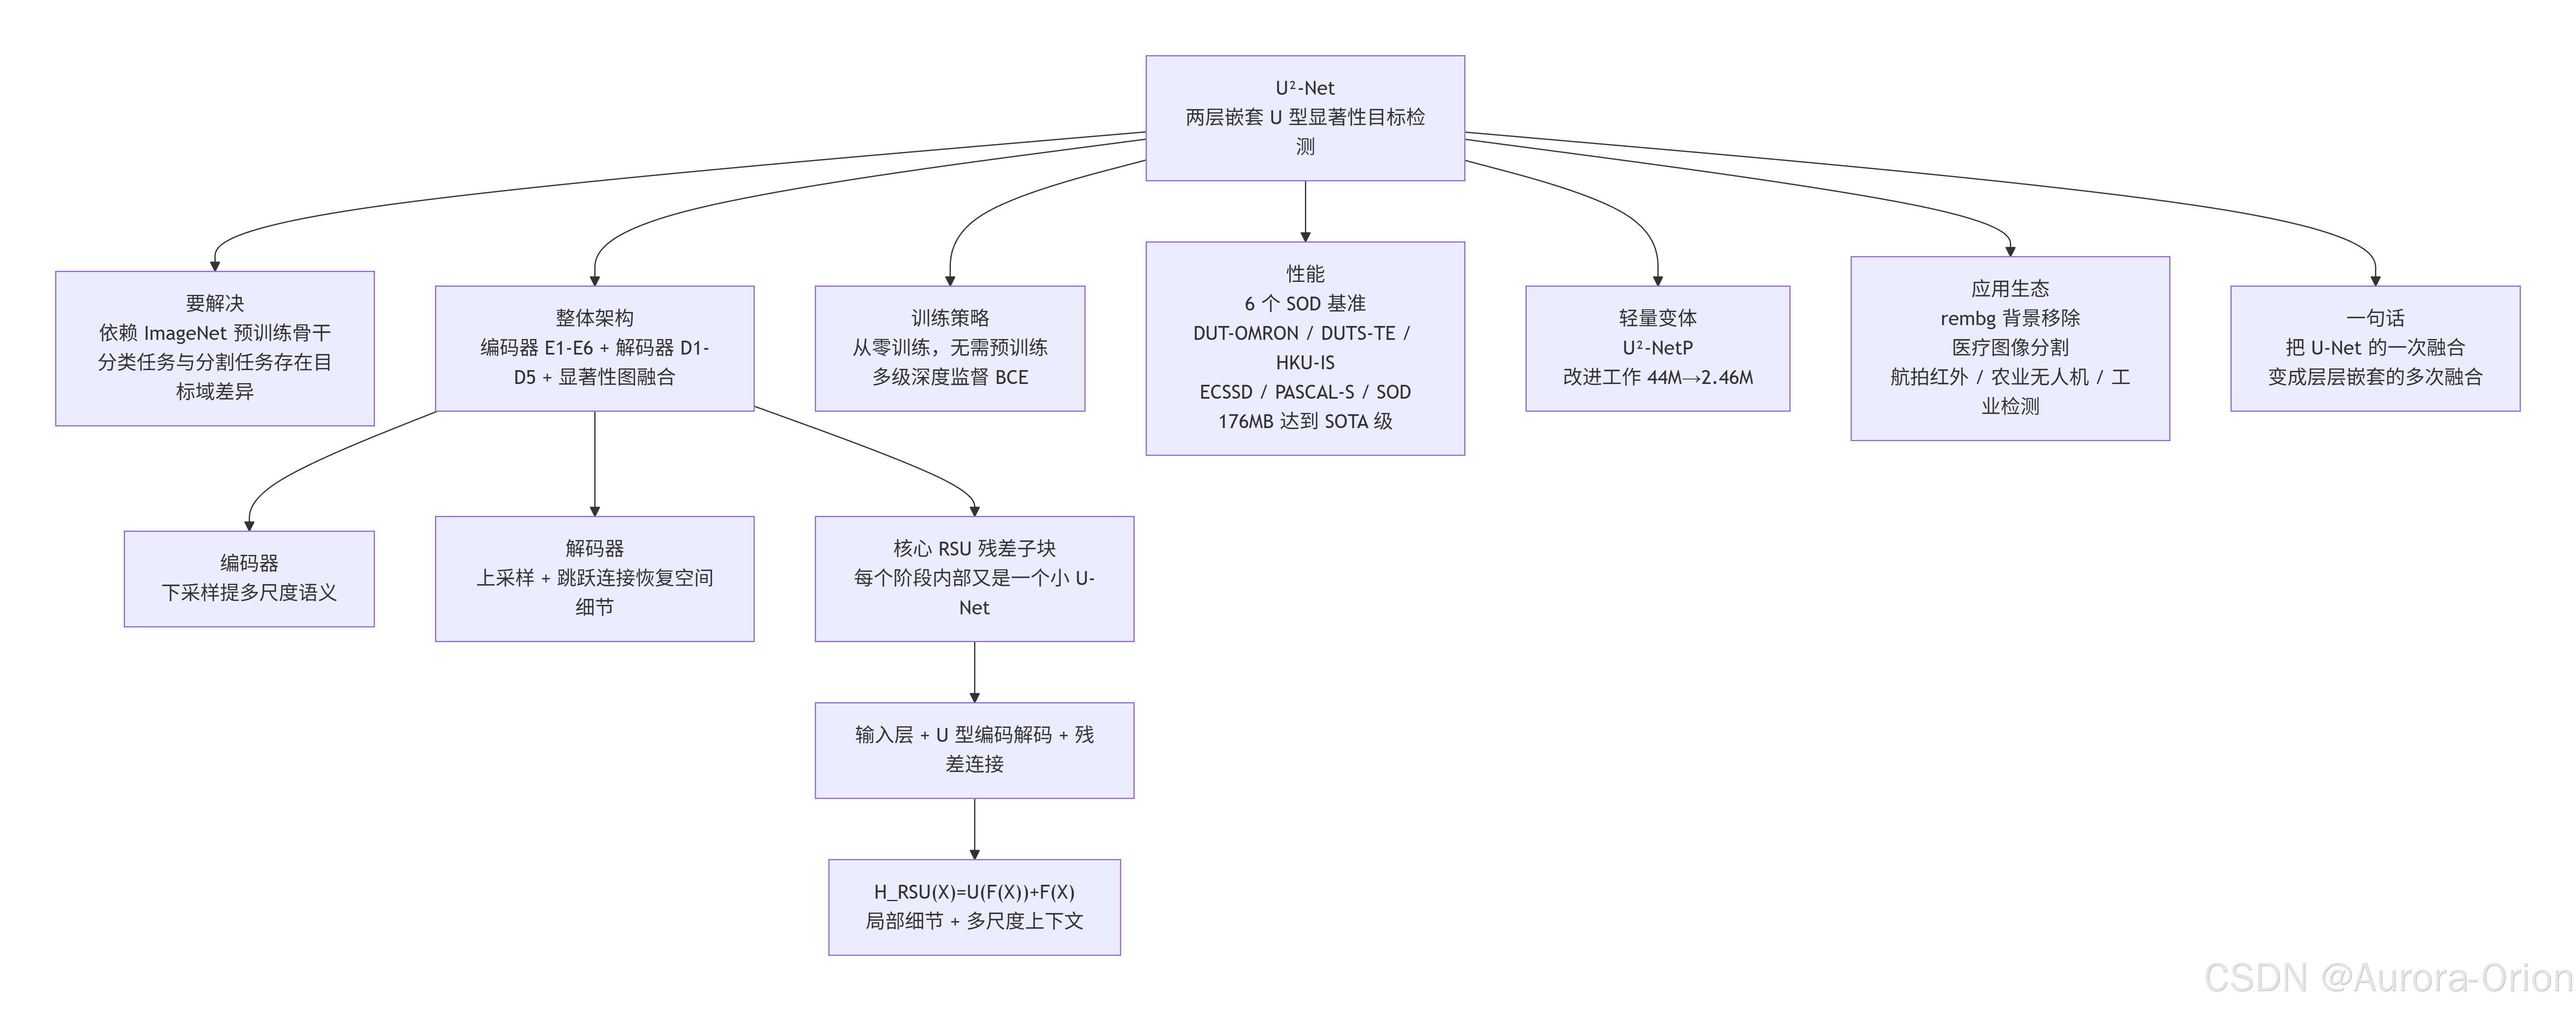
显著性目标检测(Salient Object Detection, SOD)的目标是分割出图像中最吸引人的目标或区域。传统方法通常依赖在 ImageNet 上预训练的骨干网络(如 VGG、ResNet)来提取特征,但这存在两个问题:一是预训练模型参数量大、计算成本高;二是预训练任务(图像分类)与分割任务之间存在目标域差异。
U²-Net 的出发点很直接:能否设计一个无需预训练、从零训练就能达到 SOTA 的轻量级网络? 为此,作者提出了一种两层嵌套的 U 型结构,让网络在编码器和解码器的每一个阶段内部都嵌入一个小的 U-Net,从而在多个尺度上反复进行局部细节与全局语义的融合。
二、核心架构
2.1 整体结构
U²-Net 的整体是一个经典的编码器-解码器(Encoder-Decoder) 架构,由 6 个编码器阶段(E1–E6)、5 个解码器阶段(D1–D5)和一个显著性图融合模块组成。
编码器每个阶段通过下采样逐步降低分辨率、增加通道数,捕获从局部细节到全局语义的多尺度特征。解码器通过上采样逐步恢复分辨率,并与编码器对应阶段的特征进行跳跃连接(Skip Connection) 以保留空间细节。
2.2 核心创新:RSU 模块
U²-Net 最核心的创新是 RSU(Residual U-block) 模块。每个编码器和解码器阶段都由一个 RSU 模块构成,而每个 RSU 模块内部又是一个小型的 U 型结构。
RSU 模块由三部分组成:
| 组件 | 作用 |
|---|---|
| 输入层 | 收集局部特征并变换通道数 |
| U 型编码-解码结构 | 提取和编码多尺度上下文信息 |
| 残差连接 | 将输入特征与 U 型结构输出相加 |
残差连接的形式化表达为:
H_RSU(X) = U(F(X)) + F(X)
其中 F(X) 提取局部上下文特征,U(F(X)) 提取多尺度特征,两者相加使 RSU 同时保留局部细节和多尺度全局信息。
RSU 模块的参数用 RSU-L(C_in, M, C_out) 表示,其中 L 是编码器层数(层数越大,对大尺度信息的处理能力越强),M 是中间层通道数。这种设计使得 U²-Net 可以灵活控制每个阶段的感受野和容量。
2.3 与 U-Net 的关键区别
| 维度 | U-Net | U²-Net |
|---|---|---|
| 结构 | 单层 U 型 | 两层嵌套 U 型 |
| 跳跃连接 | 编码器→解码器直接拼接 | 每个 RSU 内部也有跳跃连接 |
| 预训练 | 常依赖 ImageNet 预训练 | 无需预训练,从零训练 |
| 参数量 | 较小 | 原始约 44M,较大 |
| 多尺度融合 | 单一尺度层次 | 多尺度重复融合 |
三、性能表现
3.1 基准数据集
U²-Net 在 6 个常用 SOD 基准数据集上进行了评估:
| 数据集 | 图像数 |
|---|---|
| DUT-OMRON | 5,168 |
| DUTS-TE | 5,019 |
| HKU-IS | 4,447 |
| ECSSD | 1,000 |
| PASCAL-S | 850 |
| SOD | 300 |
3.2 关键指标
原始 U²-Net 模型大小为 176.3 MB,在多个数据集上达到与预训练骨干网络方法相当甚至更优的性能。与 U-Net 相比,U²-Net 实现了 92.77% 的召回率(U-Net 为 85.21%),损失降低了约 3.75 个百分点。
3.3 轻量化版本:U²-NetP
作者还提出了轻量版 U²-NetP,与 U²-Net 架构相同但减少了各阶段特征图数量(如 En_5 从 512 降至 64),参数量大幅压缩,适合边缘部署和实时应用。
四、应用场景
4.1 背景移除与抠图
这是 U²-Net 最广泛的应用。rembg 是一个基于 U²-Net 的 Python 背景移除库,通过 ONNX Runtime 运行预训练的 U²-Net 模型,输入图像输出 RGBA 格式的抠图结果(默认模型即为 u2net)。它支持 CPU、CUDA、CoreML 等多种后端。
4.2 图像编辑与自动抠图
一项专利将 U²-Net 与 Swin Transformer 级联,构建端到端自动抠图网络:U²-Net 负责生成三分图(trimap)的语义分割,Swin Transformer 负责精细抠图,最终得到 alpha matte 用于前景替换和图像编辑。
4.3 医疗图像分割
U²-Net 被广泛应用于医疗影像分割,包括:
-
皮肤病变分割:用于肿瘤区域的精准识别
-
显微镜图像显著性检测:改进版本模型大小从 168 MB 降至 72.5 MB(减少 56.85%),预测精度从 92.24% 提升至 97.13%
-
细胞幻灯片分析:改进版在 600 张临床细胞幻灯片上达到 mIoU 88.3%,相比原始 U²-Net 提升 33.2%
4.4 航拍与红外图像
U²-Net 生成的显著图可用于红外航拍图像的行人检测增强。在 ComNet 数据集上,显著图通过通道替换或加权融合方式增强热红外图像,使行人目标区域更加突出。
4.5 农业无人机影像
基于 U²-Net 的水稻丛影像去背模型,可用于无人机空拍影像的去背处理,去除土壤、杂草等背景噪声,突出作物区域。
4.6 工业检测
U²-Net 被用于卫星图像中低层建筑的提取,配合 Focal Loss 解决前景像素与背景像素严重不平衡的问题。
五、改进与变体
原始 U²-Net 参数量较大(约 44M),在实时或边缘部署场景下计算成本较高。学术界和工业界提出了大量改进方案:
| 改进方向 | 代表方法 | 核心思路 |
|---|---|---|
| 轻量化 | MNSEg-Net | 用紧凑残差 U-Net 块替代原始 RSU,参数量从 44M 降至 2.46M,FLOPs 降低一个数量级以上 |
| 注意力增强 | SCCA-U2Net | 在特征提取阶段引入分离坐标通道注意力,F1-score 提升 0.8% |
| 多尺度融合 | U²-Net_MFF | 多尺度特征信息融合,精度、召回率、MIoU、F1 均有提升 |
| 深度可分离卷积 | DPSAU2-Net | 用残差深度可分离 U 块增强局部纹理提取,在多个医疗数据集上超越 TransUNet |
| Ghost 卷积 | 显微镜 SOD 改进 | 用 Ghost 卷积和简单金字塔池化实现轻量化 |
六、训练策略
6.1 损失函数
原始 U²-Net 使用 BCE Loss,并对每个解码器阶段的输出都进行深度监督,形成多级损失融合。具体做法是将 d0–d6 共 7 个输出分别与标签计算 BCE Loss,然后加权求和。
改进工作引入了更丰富的损失组合,例如 SSIM Loss + IoU Loss + BCE Loss 的融合,以及 Dice Loss + Focal BCE Loss 的加权组合。
6.2 优化器与超参数
使用 Adam 优化器,初始学习率 1e-3,betas=(0.9, 0.999)。训练时进行数据增强,包括随机颜色变换、裁剪、翻转、仿射变换等。
七、口述总结
“U²-Net 是 2020 年发表在 Pattern Recognition 上的显著性目标检测网络,核心创新是两层嵌套的 U 型结构和 RSU 残差子块。传统 SOD 方法依赖 ImageNet 预训练骨干,U²-Net 证明从零训练也能达到 SOTA。它的整体是编码器-解码器,每个阶段都由 RSU 模块构成,而 RSU 内部又是一个小的 U-Net,通过残差连接把局部细节和多尺度上下文融合起来。在 DUT-OMRON、DUTS-TE 等 6 个基准数据集上,它用 176MB 的模型达到与预训练方法相当的性能。工程上最出名的应用是
rembg库,它是 Python 生态里最常用的背景移除工具,默认模型就是 U²-Net。后来大量工作对它做轻量化改进,比如把参数量从 44M 降到 2.46M,同时保持分割精度。面试里如果被追问,我会强调:RSU 是 U²-Net 的灵魂,它让网络在每个尺度上都做一次完整的编码-解码,而不是只在最顶层做一次。”
八、一句话收束
U²-Net 的本质是把 U-Net 的“一次融合”变成“层层嵌套的多次融合”。 每一次 RSU 内部的编码-解码都在不同尺度上重新审视图像,使得网络无需预训练就能同时把握“整体在哪里”和“边缘长什么样”。这也是它成为 rembg 默认模型、并在医疗、农业、航拍等领域广泛落地的根本原因。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 4
 0
- 0


 已为社区贡献259条内容

所有评论(0)