《VLA系列》TurboVLA 技术解读:用直接 V+L→A 路径实现实时机器人控制
TurboVLA 技术解读:用直接 V+L→A 路径实现实时机器人控制
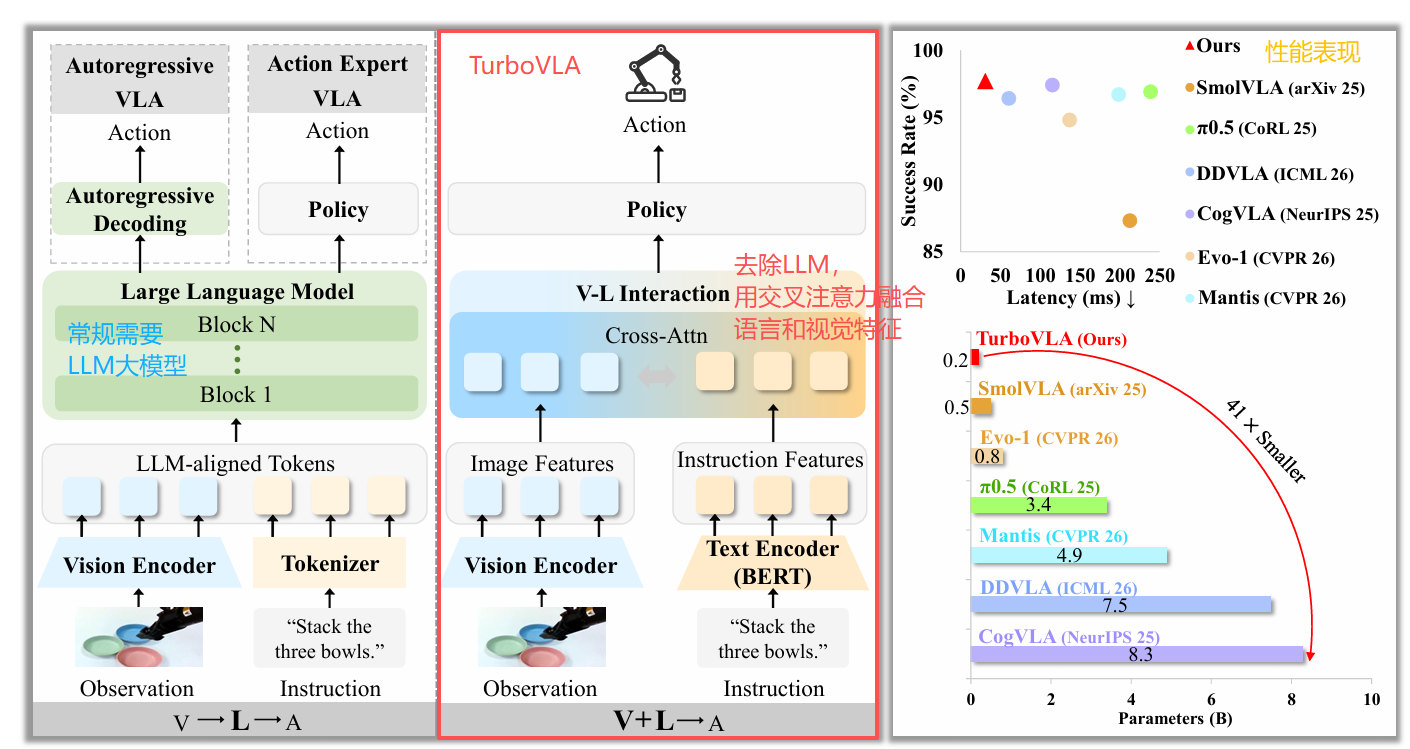
关键:TurboVLA 并非把大语言模型简单缩小,而是移除了“大型生成式语言模型作为视觉到动作中枢”的路径。它用 DINOv3、BERT、轻量双向跨模态交互和 ACT 动作解码器,直接完成 V + L → A V+L\rightarrow A V+L→A,在执行级操作中换取更低时延和显存占用。
1. 整体框架
如下图所示,TurboVLA的结构图。
- 输入: 多视角图像、文字指令和机器人当前状态分别进入 DINOv3、BERT 与状态 MLP。
- 融合: 图中央的双向 cross-attention 交叉注意力 让视觉定位与指令相关的区域,也让指令结合当前场景完成 grounding。
- 输出: 融合 token 与状态 token 交给 ACT decoder,并行预测未来 H H H 步连续动作。
其对应的抽象计算流程如下:
1.1 视觉分支:保留空间与视角信息
- 实现位置:turbovla/models/vision_encoder.py。
- DINOv3 输出最后一层 hidden states;实现会移除 CLS/register 等前缀 token,只保留 patch token。
- 每个相机视角单独编码;之后加入可学习的视角 embedding。RoboTwin 配置额外使用可学习 patch 位置 embedding。
- LIBERO 使用 DINOv3 ViT-B、两视角、 256 × 256 256\times256 256×256 输入;RoboTwin 使用 ViT-L、三视角、 224 × 224 224\times224 224×224 输入。
这意味着视觉 token 不只是“整图语义向量”,而是保留了可供语言查询的空间位置。语言中的“左侧红色杯子”等描述可在后续注意力层中选择相关 patch。
1.2 语言分支:轻量但不是静态文本标签
- 实现位置:turbovla/models/text_encoder.py。
- 每次前向传播都在线执行
AutoTokenizer和 BERT,输出 token 级特征,再线性投影到共享的 256 256 256 维隐藏空间。 - 论文配方冻结 BERT 参数并强制保持 eval 模式,但训练文本投影层;因此语言表征稳定,控制模块可学习如何使用它。
- 对 LIBERO,项目用固定或按指令分组的 padding 长度,使 checkpoint 对应的 token 布局保持一致。
重点:BERT 的职责是保留动作执行相关的语义,不负责生成文字、拆分子任务或进行长链推理。
1.3 双向视觉-语言交互:模型真正的创新落点
实现位置:turbovla/models/components/fusion.py 与 turbovla/models/turbovla.py。每一层同时执行:
V
(
l
)
=
V
(
l
−
1
)
+
Attn
v
←
l
(
V
(
l
−
1
)
,
L
(
l
−
1
)
)
V^{(l)}=V^{(l-1)}+\operatorname{Attn}_{v\leftarrow l}(V^{(l-1)},L^{(l-1)})
V(l)=V(l−1)+Attnv←l(V(l−1),L(l−1))
L
(
l
)
=
L
(
l
−
1
)
+
Attn
l
←
v
(
L
(
l
−
1
)
,
V
(
l
−
1
)
)
L^{(l)}=L^{(l-1)}+\operatorname{Attn}_{l\leftarrow v}(L^{(l-1)},V^{(l-1)})
L(l)=L(l−1)+Attnl←v(L(l−1),V(l−1))
- 视觉查询语言:让每个图像 patch 带上当前任务语义,例如“抓取”还是“放到”。
- 语言查询视觉:让指令 token 感知场景中实际出现的对象、属性和空间布局。
- 每层融合后,文本还经过 self-attention;默认堆叠 6 6 6 层。
- 交互模块由 GroundingDINO 的特征增强权重初始化,减少从机器人示范数据从零学习对齐的负担。
论文消融显示,这不是可有可无的装饰:LIBERO 上直接拼接仅为 96.3 % 96.3\% 96.3%,单向交互为 96.8 % / 97.2 % 96.8\%/97.2\% 96.8%/97.2%,双向交互达到 97.6 % 97.6\% 97.6%;RoboTwin 上无交互为 82.58 % 82.58\% 82.58%,双向交互为 88.06 % 88.06\% 88.06%。
| 指标 | TurboVLA | 说明 |
|---|---|---|
| 参数量 | 0.2B | 无 LLM,整体小一个数量级 |
| LIBERO 平均成功率 | 97.6% | 与 LLM 中心的大模型相当 |
| 推理延迟 | 31.2 ms(32 Hz) | RTX 4090 实测 |
| 推理显存 | 0.9 GiB | 消费级显卡可部署 |
1.4 状态与动作头:一次预测完整动作段
实现位置:turbovla/models/action_head.py。
StateProjection将当前关节/末端状态经 MLP 投影为 N s = 2 N_s=2 Ns=2 个状态 token。- 将状态 token 拼到融合后的视觉、语言 token 后,作为 decoder memory。
ACTDecoder持有 H H H 个可学习 action query。每个 query 对应 chunk 中的一个时刻。- 三层 Transformer decoder 并行生成全部动作,三层 MLP 变成动作维度,最后经
tanh得到 [ − 1 , 1 ] [-1,1] [−1,1] 的归一化动作。
因此模型不是一个动作一个动作地自回归生成,而是一次计算:
A ^ t = [ a ^ t , a ^ t + 1 , … , a ^ t + H − 1 ] ∈ R H × d a \hat A_t=[\hat a_t,\hat a_{t+1},\ldots,\hat a_{t+H-1}]\in\mathbb R^{H\times d_a} A^t=[a^t,a^t+1,…,a^t+H−1]∈RH×da
LIBERO 使用 d a = 7 , H = 12 d_a=7,H=12 da=7,H=12;RoboTwin 使用双臂 d a = 14 , H = 50 d_a=14,H=50 da=14,H=50。
2、模型结构:一次前向的完整流程
各模块要点(与后文命令参数的对应关系):
| 模块 | 关键配置 | 训练策略 | 初始化来源 |
|---|---|---|---|
视觉编码器 | DINOv3 ViT-B,双视角分别编码,patch token + 视角 embedding | 全量解冻微调,BF16 autocast(权重保持 FP32) | facebook/dinov3 预训练 |
| 文本编码器 | BERT base,在线编码(无文本特征缓存),固定 padding 长度 21 | 冻结(freeze_text_encoder=True) | google-bert 预训练 |
交互模块 | 6 层 ×(双向交叉注意力 + 文本自注意力),hidden 256 / inner 1024 | 训练 | GroundingDINO 的 feature enhancer(--pretrained_init_ckpt 的作用) |
| 动作头 | 状态 8 维→2 token;12 个 action query;3 层 Decoder | 训练 | 随机初始化 |
3. 训练与推理流程
3.1 训练:带 chunk mask 的行为克隆
LIBERO 训练主入口为 experiments/libero/train.py,实际训练器为 turbovla/training/trainer.py。目标函数是:
L = ∑ i , j , k m i j ∣ A ^ i j k − A i j k ∗ ∣ ∑ i , j , k m i j \mathcal L=\frac{\sum_{i,j,k}m_{ij}|\hat A_{ijk}-A^*_{ijk}|}{\sum_{i,j,k}m_{ij}} L=∑i,j,kmij∑i,j,kmij∣A^ijk−Aijk∗∣
其中 m m m 屏蔽 episode 末尾的填充动作。LIBERO 的不足 12 12 12 步 chunk 会以最后一个动作补齐,但不参与损失;这避免了边界 padding 污染行为克隆。
训练配置要点:
| 项目 | LIBERO | RoboTwin 2.0 |
|---|---|---|
| 视觉骨干 | DINOv3 ViT-B | DINOv3 ViT-L |
| 相机数 | 2 | 3 |
| 动作/状态维度 | 7 / 8 | 14 / 14 |
| 动作 horizon | 12 | 50 |
| 训练步数 | 40k | 150k |
| 有效 batch size | 128 | 512 |
| 优化器 | AdamW | AdamW |
| EMA 衰减 | 0.999 | 0.999 |
RoboTwin 训练配置位于 experiments/robotwin/configs/taskbalanced_all50.yaml:50 个任务均匀采样,且每个任务内部 Randomized:Clean 采样比为 10 : 1 10:1 10:1。
3.2 评估和部署:chunk 执行并不等于每步都重新观察
LIBERO 的策略封装在 turbovla/evaluation/policy.py:
- 将环境图像旋转、按 DINOv3 统计量归一化。
- 从末端位姿、轴角和夹爪状态构造 8 8 8 维 state,并标准化。
- 调用模型得到 12 × 7 12\times7 12×7 动作 chunk。
- 前六维按数据集 min/max 反归一化;第七维按正负号转换为夹爪开合命令。
- 在默认协议下执行完整 chunk,再重新观测并规划。
重要取舍:动作 chunk 降低策略调用次数,但也使 chunk 内成为开环控制。论文在 LIBERO 中发现 H = 12 H=12 H=12 最好: H = 8 / 10 / 12 / 15 H=8/10/12/15 H=8/10/12/15 的平均成功率为 96.8 % / 97.3 % / 97.6 % / 96.7 % 96.8\%/97.3\%/97.6\%/96.7\% 96.8%/97.3%/97.6%/96.7%。更长的预测窗口不必然更好,因为视觉反馈变少了。
RoboTwin 路径通过 StarVLA runtime 和 WebSocket policy server 对接仿真器,允许模型服务与仿真器使用不同 Python 环境。
4. 为什么它快:架构收益与工程收益要分开看
架构层面的收益
- 不经过数十亿参数的 LLM/VLM 主干。
- BERT、DINOv3、融合器与动作 decoder 都是固定深度前向计算。
- ACT query 并行预测动作 chunk,没有 token-by-token 自回归动作解码。
- 融合维度仅为 256 256 256,交互层为 6 6 6 层。
已在仓库体现的工程手段
- 冻结模块时使用
torch.no_grad(),避免无用的激活和梯度。 - CUDA 上支持 BF16 autocast。
- RoboTwin 配置请求 Flash Attention 2;不可用时会回退到 SDPA/默认 attention。
- 训练侧使用 pinned memory、persistent workers、梯度累积和 EMA。
论文数字的正确解读
论文的 31.2 ms 31.2\text{ ms} 31.2 ms 对应约 32 32 32 Hz,测量定义是:单张 RTX 4090、batch size 1、GPU 已驻留输入、完成一个动作 chunk 的稳态策略前向;不包含传感器采集、CPU 预处理、数据传输、网络通信或机器人执行。因此它是本地策略推理频率,不是端到端机器人控制频率。
论文还报告结合 CUDA Graph replay、数据转换和内存分配优化后达到
7.42
ms
7.42\text{ ms}
7.42 ms。当前仓库的核心路径可见 BF16/SDPA/Flash Attention 支持,但未包含 CUDAGraph 或 torch.compile 的可复用实现;复现该
7.42
ms
7.42\text{ ms}
7.42 ms 结果需要自行补足论文所述 runtime 优化与一致的测量脚本。
5. 总结-思路流程
6. 复现指南
参考我这篇博客:《VLA系列》TurboVLA 复现指南:0.2B小模型 | 32 Hz | 显存<1 GB 全量微调
6.1 准备两套环境
项目建议 LIBERO 与 RoboTwin 使用独立的 Python 3.10 环境,因为二者依赖的仿真器与运行时不同。
# LIBERO
conda create -n turbovla-libero python=3.10 -y
conda activate turbovla-libero
pip install torch==2.3.1 torchvision==0.18.1 --index-url https://download.pytorch.org/whl/cu121
pip install -e ".[libero]"

# RoboTwin
conda create -n turbovla-robotwin python=3.10 -y
conda activate turbovla-robotwin
pip install -e ".[robotwin]"
pip install flash-attn==2.7.4.post1 --no-build-isolation
此外需独立安装 LIBERO 与 RoboTwin 2.0 仿真器;后者评测环境可以与模型服务环境分离。
6.2 下载外部模型和数据
仓库不包含模型权重、DINOv3、BERT、GroundingDINO 初始化权重或 benchmark 数据。先下载发布 checkpoint 与归一化元数据:
pip install -U huggingface_hub
hf download H-EmbodVis/TurboVLA --local-dir pretrained/TurboVLA
还需准备:
- DINOv3 ViT-B(LIBERO)或 ViT-L(RoboTwin);
bert-base-uncased;- GroundingDINO Swin-T OGC checkpoint;
- LIBERO 的四个
no_noopsRLDS 数据集,或 RoboTwin 的 Clean/Randomized 转换数据。
检查点:路径必须与命令参数一致;默认倾向离线加载。只有显式传
--allow_hf_download时 LIBERO 路径才允许 Hugging Face 下载。
6.3 复现 LIBERO 训练
论文配方:4 张 RTX 4090、每卡 batch 8、梯度累积 4,因此全局 batch 是 4 × 8 × 4 = 128 4\times8\times4=128 4×8×4=128;训练 40k step、warmup 10k step。
torchrun --nproc_per_node=4 experiments/libero/train.py \
  --dataset_dir data/libero/libero_10_no_noops/1.0.0 \
  --dataset_dirs "data/libero/libero_10_no_noops/1.0.0,data/libero/libero_goal_no_noops/1.0.0,data/libero/libero_object_no_noops/1.0.0,data/libero/libero_spatial_no_noops/1.0.0" \
  --stats_path experiments/libero/configs/libero_all4_stats.json \
  --stats_key libero_all4_no_noops \
  --dinov3_path /path/to/dinov3-vitb \
  --bert_path /path/to/bert-base-uncased \
  --pretrained_init_ckpt /path/to/groundingdino_swint_ogc.pth \
  --batch_size 8 \
  --grad_accum_steps 4 \
  --max_steps 40000 \
  --checkpoint_dir outputs/libero
务必显式传入 --max_steps 40000:论文配方是 40k,但训练器的 CLI 默认值是 80k;不覆盖会得到不同的训练预算。
评估单一 suite:
python experiments/libero/evaluate.py \
  --ckpt_path pretrained/TurboVLA/checkpoints/libero/libero_object.pth \
  --dinov3_path /path/to/dinov3-vitb \
  --bert_path /path/to/bert-base-uncased \
  --stats_path experiments/libero/configs/libero_all4_stats.json \
  --stats_key libero_all4_no_noops \
  --task_suite_name libero_object \
  --num_trials_per_task 50 \
  --chunk_size 12 \
  --num_open_loop_steps 12 \
  --precision bf16 \
  --result_json_path outputs/evaluation/libero_object.json
要与论文平均值严格对齐,需评测四个 suite、每 task 50 条 rollout,共 4 × 10 × 50 = 2000 4\times10\times50=2000 4×10×50=2000 次试验,并使用 EMA checkpoint。
6.4 复现 RoboTwin 训练与评估
export ROBOTWIN_DATA_ROOT=/path/to/converted/RoboTwin
export BERT_MODEL_PATH=/path/to/bert-base-uncased
export TURBOVLA_INIT_CKPT=/path/to/groundingdino_swint_ogc.pth
export DINOV3_MODEL_PATH=/path/to/dinov3-vitl
export CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7

RUN_ID=turbovla_robotwin_all50_taskbalanced_150k \
  bash scripts/robotwin/train.sh
论文配方使用 8 张 H100、每卡 64、全局 batch 512、150k step。评估时启动模型服务与 RoboTwin 仿真:
export ROBOTWIN_PATH=/path/to/RoboTwin
export STARVLA_PYTHON=/path/to/policy-env/bin/python
export ROBOTWIN_PYTHON=/path/to/robotwin-env/bin/python

bash scripts/robotwin/evaluate.sh \
  /path/to/steps_150000_ema_pytorch_model.pt
论文报告按 Clean 和 Randomized 各 50 个任务、每任务 100 次 rollout,即每种设置各 5000 次试验;使用未见过的任务指令。
7. 结果、亮点与边界
值得关注的结果
| 场景 | 论文报告结果 | 应如何理解 |
|---|---|---|
| LIBERO | 97.6 % 97.6\% 97.6% 成功率, 0.2 0.2 0.2B, 31.2 ms 31.2\text{ ms} 31.2 ms, 0.9 GiB 0.9\text{ GiB} 0.9 GiB | 轻量 V+L→A 可达到强执行性能 |
| RoboTwin 2.0 | 88.06 % 88.06\% 88.06%, 0.4 0.4 0.4B, 43.4 ms 43.4\text{ ms} 43.4 ms | 方法可扩展到三视角双臂控制 |
| 真实 AgileX Piper | 87.5 % 87.5\% 87.5% 平均成功率 | 论文报告的 4 个桌面任务结果 |
方法亮点
- 表示路径更短:避免大语言模型成为每次控制推理的固定成本。
- 语言与视觉真正交互:双向 cross-attention 的收益由两个 benchmark 的消融支持。
- 动作输出连续且并行:无需离散 action token 化,也没有自回归解码延迟。
- 架构有清晰分工:DINOv3 提供空间视觉,BERT 提供指令语义,融合器负责 grounding,ACT 负责控制序列。
适用边界
- 更适合“明确指令下的执行级操作”,不针对“收拾房间”这类需要目标拆分和高层推理的开放任务。
- action chunk 存在开环执行区间,对快速变化、接触不确定性强或视觉反馈频繁变化的任务需要缩短 horizon 或加入重规划策略。
- 性能数字依赖特定 GPU、输入分辨率、动作 horizon 和论文定义的测量范围,不能直接等同于真实机器人端到端频率。
8. 代码阅读入口
| 目的 | 入口 |
|---|---|
| 主模型与融合调度 | turbovla/models/turbovla.py |
| DINOv3 视觉 token | turbovla/models/vision_encoder.py |
| 在线 BERT 编码 | turbovla/models/text_encoder.py |
| 双向视觉语言注意力 | turbovla/models/components/fusion.py |
| ACT 状态投影与动作头 | turbovla/models/action_head.py |
| LIBERO 训练 | turbovla/training/trainer.py |
| LIBERO 评测预后处理 | turbovla/evaluation/policy.py |
| RoboTwin 完整配置 | experiments/robotwin/configs/taskbalanced_all50.yaml |
参考
分享完成~

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 0
 0
- 0


 已为社区贡献56条内容

所有评论(0)