第10讲 · 机器人感知与 ROS2:Intelligent Robotics SDK
系列:《高通 NPU 边缘 AI 实战:从芯片架构到开发板落地》
从零到一 · 高通 Dragonwing 边缘 AI 12 讲
数据口径:本讲数值凡标注[官方](厂商公开规格)、[推算](基于架构的估算)、[实测](仅给测量方法、不替你出数字)。估算不冒充实测。
本讲定位:第 08、09 讲你已能在犀牛派 A1(QCS6490)上做实时视觉检测、并把它接入连续音视频流。但机器人不是"一个检测程序"——它是一堆节点协作的系统:相机节点出图、感知节点出目标、定位节点出位姿、决策节点出指令、控制节点动轮子/机械臂。本讲解决:如何把你装好的 NPU 推理,封装成机器人系统里一个标准、可复用的感知节点。
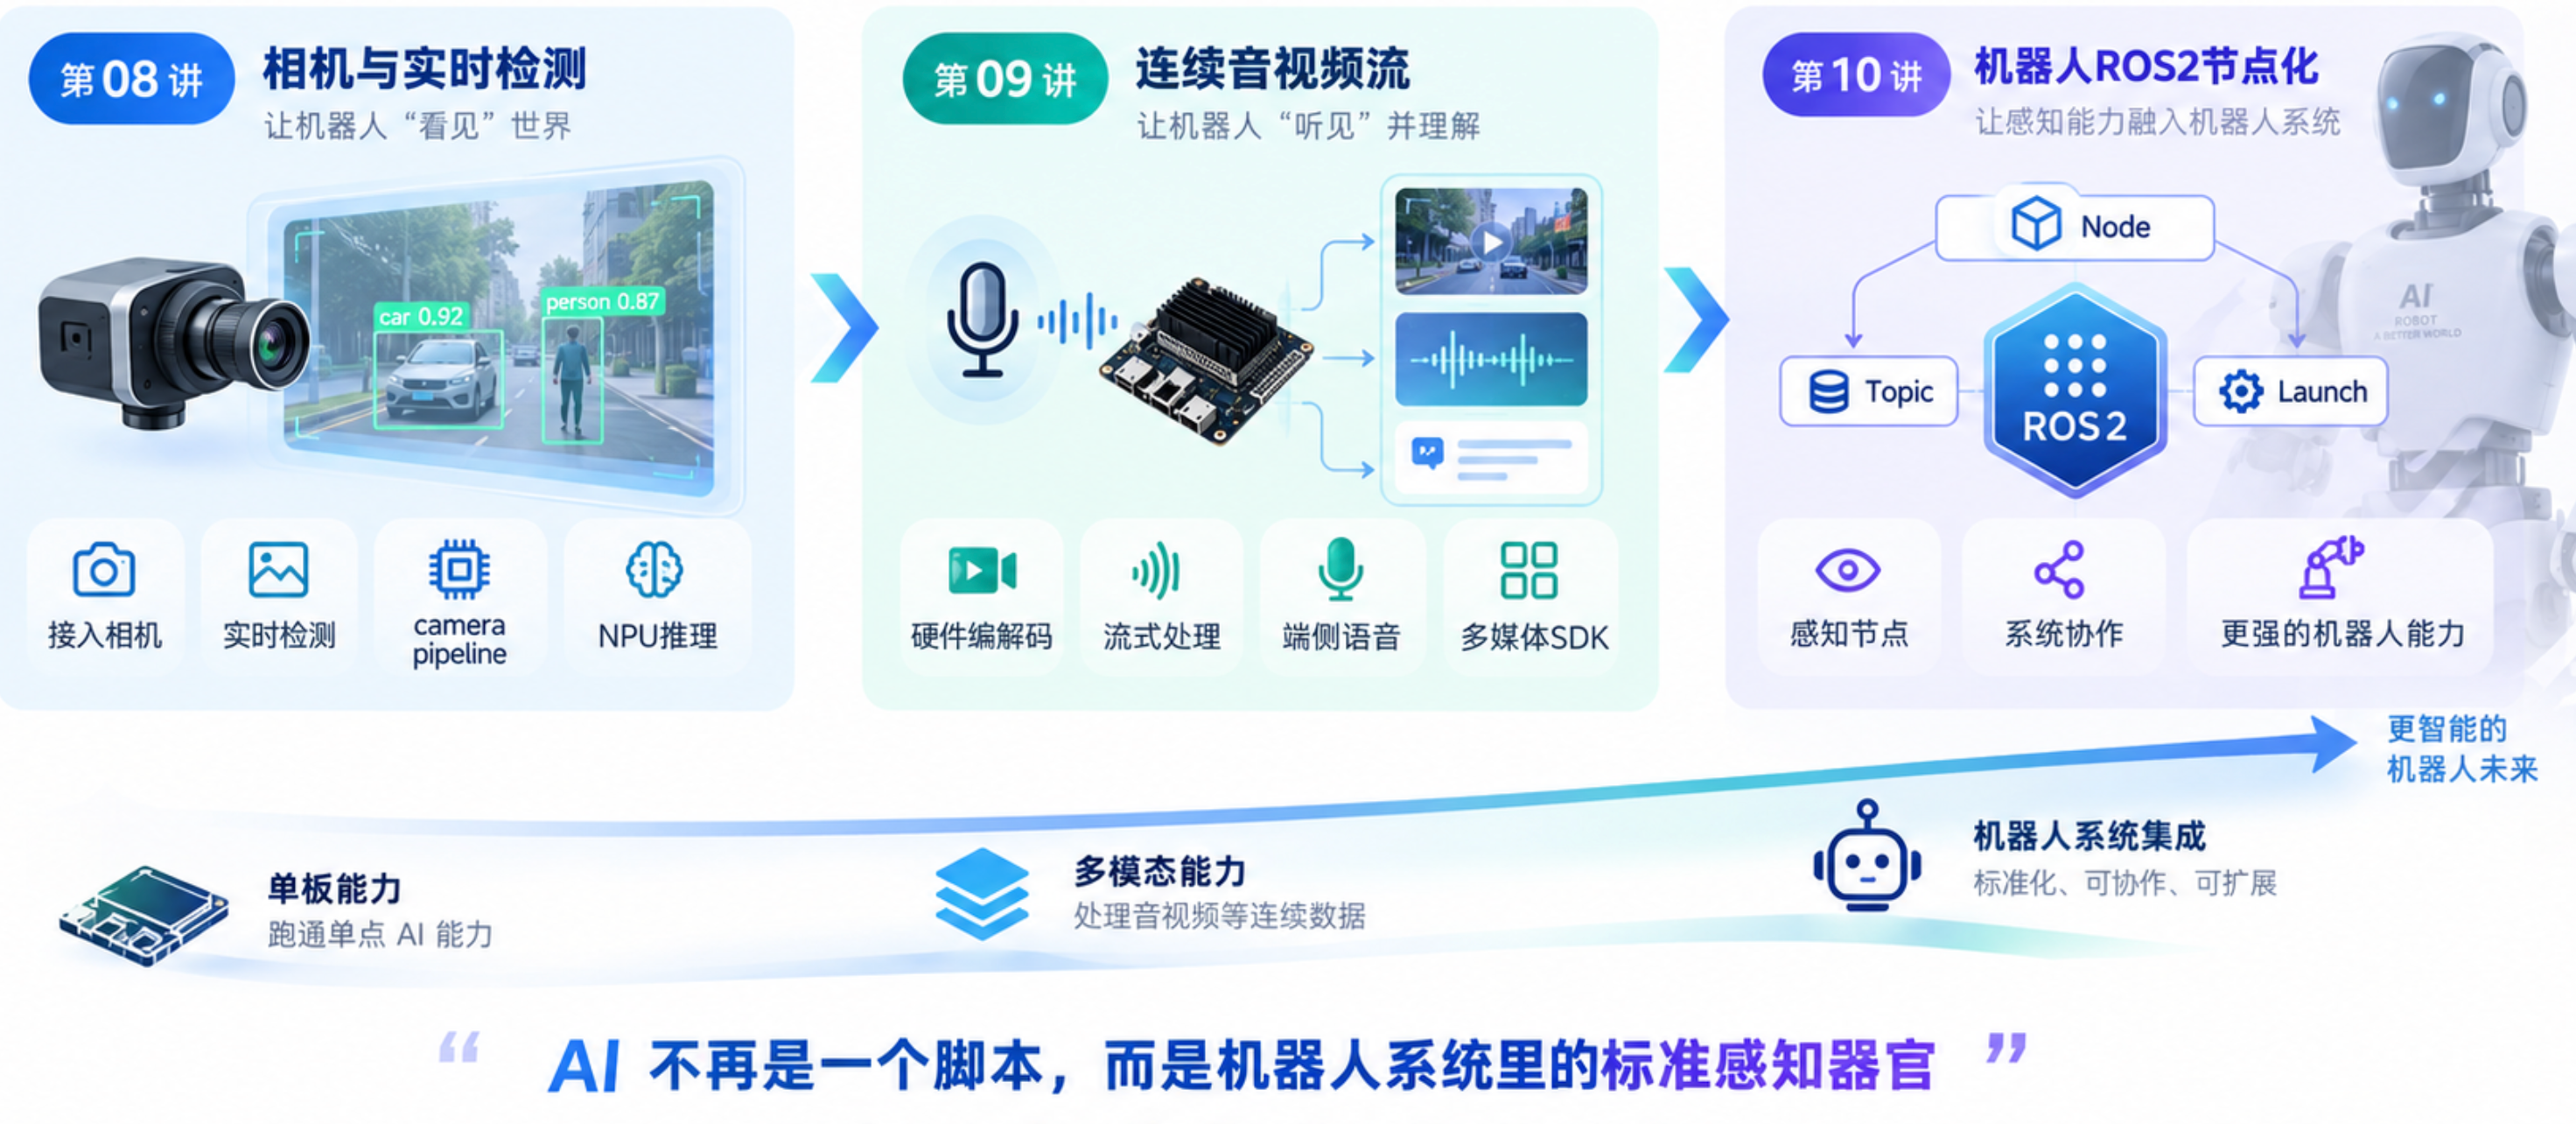
本讲目标
- 目标读者:已完成第 03–09 讲,能在板上跑通视觉/语音推理,想把它做成机器人/具身 AI 产品的人。
- 本讲目标:
- 理解 ROS2 的基本心智模型(node / topic / launch),即便你没接触过也能上手。
- 掌握"相机节点 → 推理节点 → 检测结果节点"的节点设计。
- 理解实时性:推理节点发布频率与下游(决策/控制)频率如何匹配,避免丢帧与堆积。
- 能拼出一个 ROS2 推理节点模板(Python/C++ 伪代码 + launch 示例)。
- 你将带走:一个 ROS2 推理节点模板、topic 频率匹配表、多模型并发下的 NPU 算力分配思路。
一、环境调研:为什么机器人需要"节点化"的 AI
1.1 从"一个程序"到"一个系统"
单板跑检测,你写一个 while True: detect() 就行。但机器人要:
- 同时处理相机、激光雷达、IMU、轮速编码器多路传感;
- 感知、定位、规划、控制解耦,各团队并行开发;
- 任意模块可替换、可热插拔、可分布式部署(感知在板上,决策在工控机)。
这恰好是 ROS2 解决的领域。把 AI 推理变成一个 ROS2 节点,它就不再是孤零零的脚本,而是能和其它节点用标准消息通信的"器官"。
1.2 高通的机器人 SDK 定位
[官方] 高通提供面向机器人的开发支持(Intelligent Robotics SDK / 机器人感知相关组件),其价值在于:把相机、推理、导航等常用能力预做成 ROS2 节点/组件,降低从"裸板"到"机器人系统"的台阶。具体组件名、版本、接口以阿加犀/高通官方资料为准,本讲给架构与集成原则。
1.3 本讲环境前提
- 已按第 03 讲点亮犀牛派 A1,第 04 讲装好 QNN SDK,第 07 讲在 HTP 上跑通量化模型,第 08 讲接相机做实时检测。
- ROS2 运行环境(如 Humble/Iron 等 LTS 版本)由系统镜像/官方资料提供;具体安装与版本以官方为准。
1.4 为什么不直接用多线程脚本
有人会问:“我用多线程把相机、推理、控制都写在一个脚本里不行吗?” 短期行,长期不行。当系统从 3 个模块涨到 30 个、当某模块要换人维护、当感知要从板子移到另一台机器时,硬耦合脚本会迅速腐化。ROS2 用"话题契约"把耦合降到最低——这正是工程化与玩具的分界线,也是本系列一贯主张的"工程风"。
二、ROS2 基础:给没接触过的读者补背景
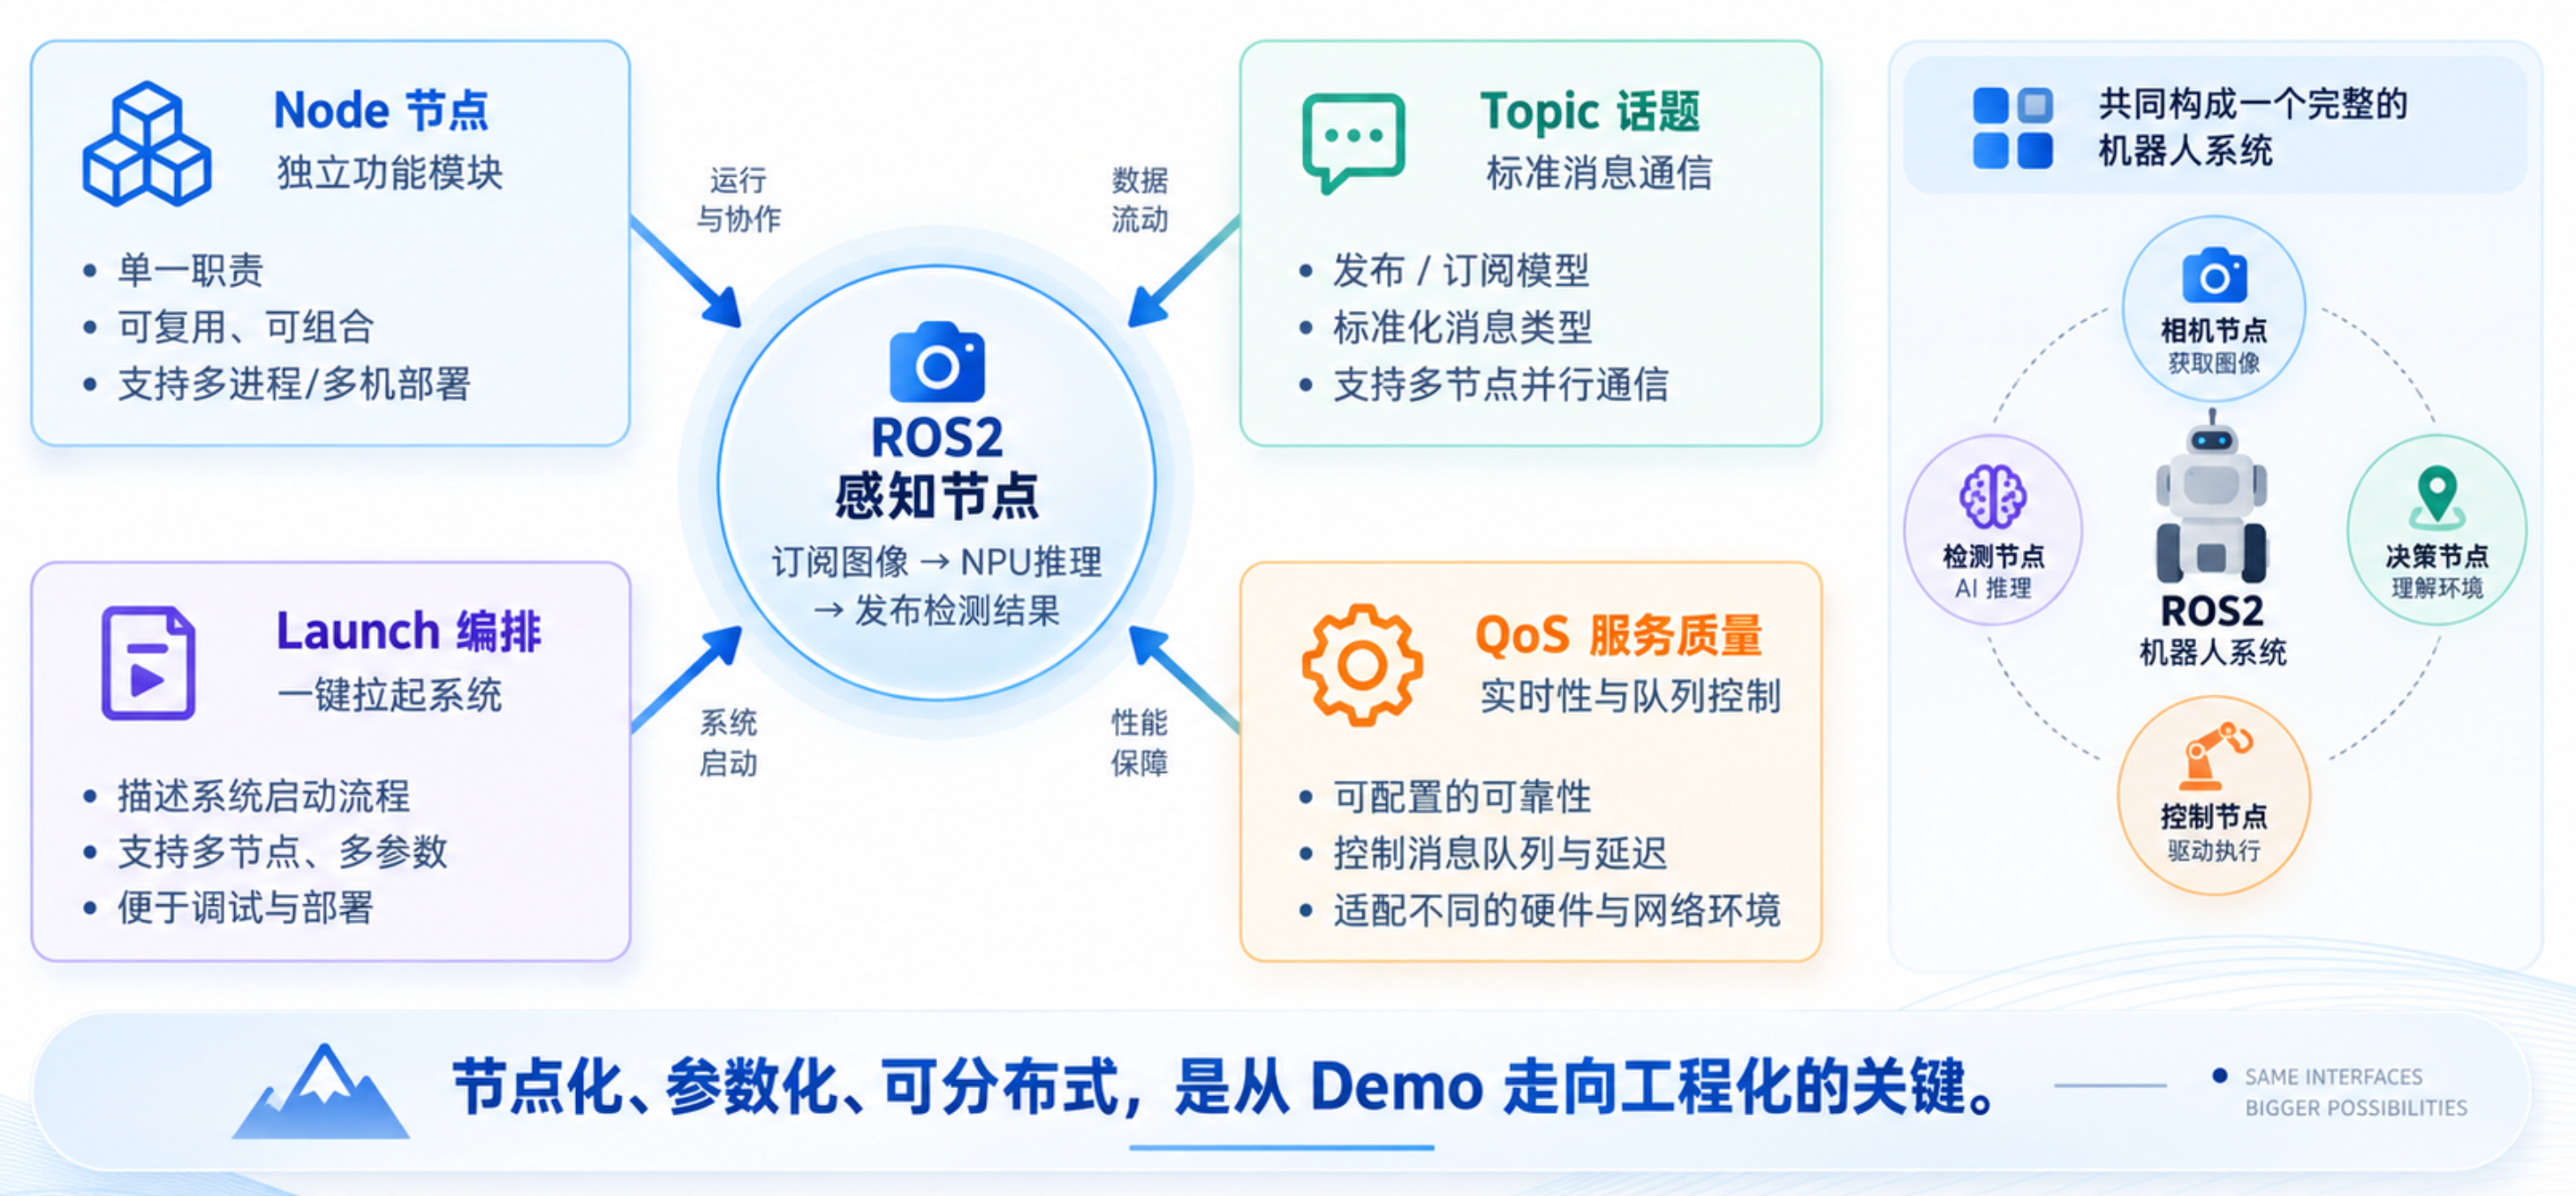
| 概念 | 类比 | 在 AI 机器人里的角色 |
|---|---|---|
| Node(节点) | 一个进程/功能模块 | 相机节点、检测节点、导航节点 |
| Topic(话题) | 发布/订阅的总线 | /image_raw、/detections 消息流 |
| Launch(启动文件) | 把多个节点编排起来 | 一键拉起整个感知+决策系统 |
[官方] ROS2 用 DDS 作为底层通信中间件,天然支持分布式(节点可以跑在不同机器/板子上),并带 QoS(服务质量)策略——这对实时系统很重要(见 2.4)。
2.2 消息类型
相机常用 sensor_msgs/Image 或压缩图像;检测结果常用自定义消息或 vision_msgs/Detection2DArray。节点之间用标准消息解耦,A 节点不知道 B 节点怎么实现,只认消息格式。
2.3 一个最小节点长什么样
# [推算] ROS2 推理节点骨架(伪代码,API 以 ROS2 + 板端 SDK 为准)
import rclpy
from rclpy.node import Node
from sensor_msgs.msg import Image
# 假设有检测结果消息类型 Detections

class DetectNode(Node):
    def __init__(self):
        super().__init__('npu_detector')
        self.sub = self.create_subscription(Image, '/image_raw', self.cb, 10)
        self.pub = self.create_publisher(Detections, '/detections', 10)
        self.net = load_qnn_context('yolo_ctx.bin')   # 第07讲产物

    def cb(self, msg):
        frame = msg_to_numpy(msg)          # 像素 → numpy
        det = self.net.run(frame)          # HTP 推理
        self.pub.publish(to_det_msg(det))  # 发布结果

rclpy.init(); rclpy.spin(DetectNode()); rclpy.shutdown()
把第 07 讲的 net.run(frame) 包进 ROS2 的回调里,一个感知节点就成形了。
2.4 QoS:实时性的开关
DDS 的 QoS 决定"消息丢了怎么办、要不要保序、队列多大"。对推理节点:
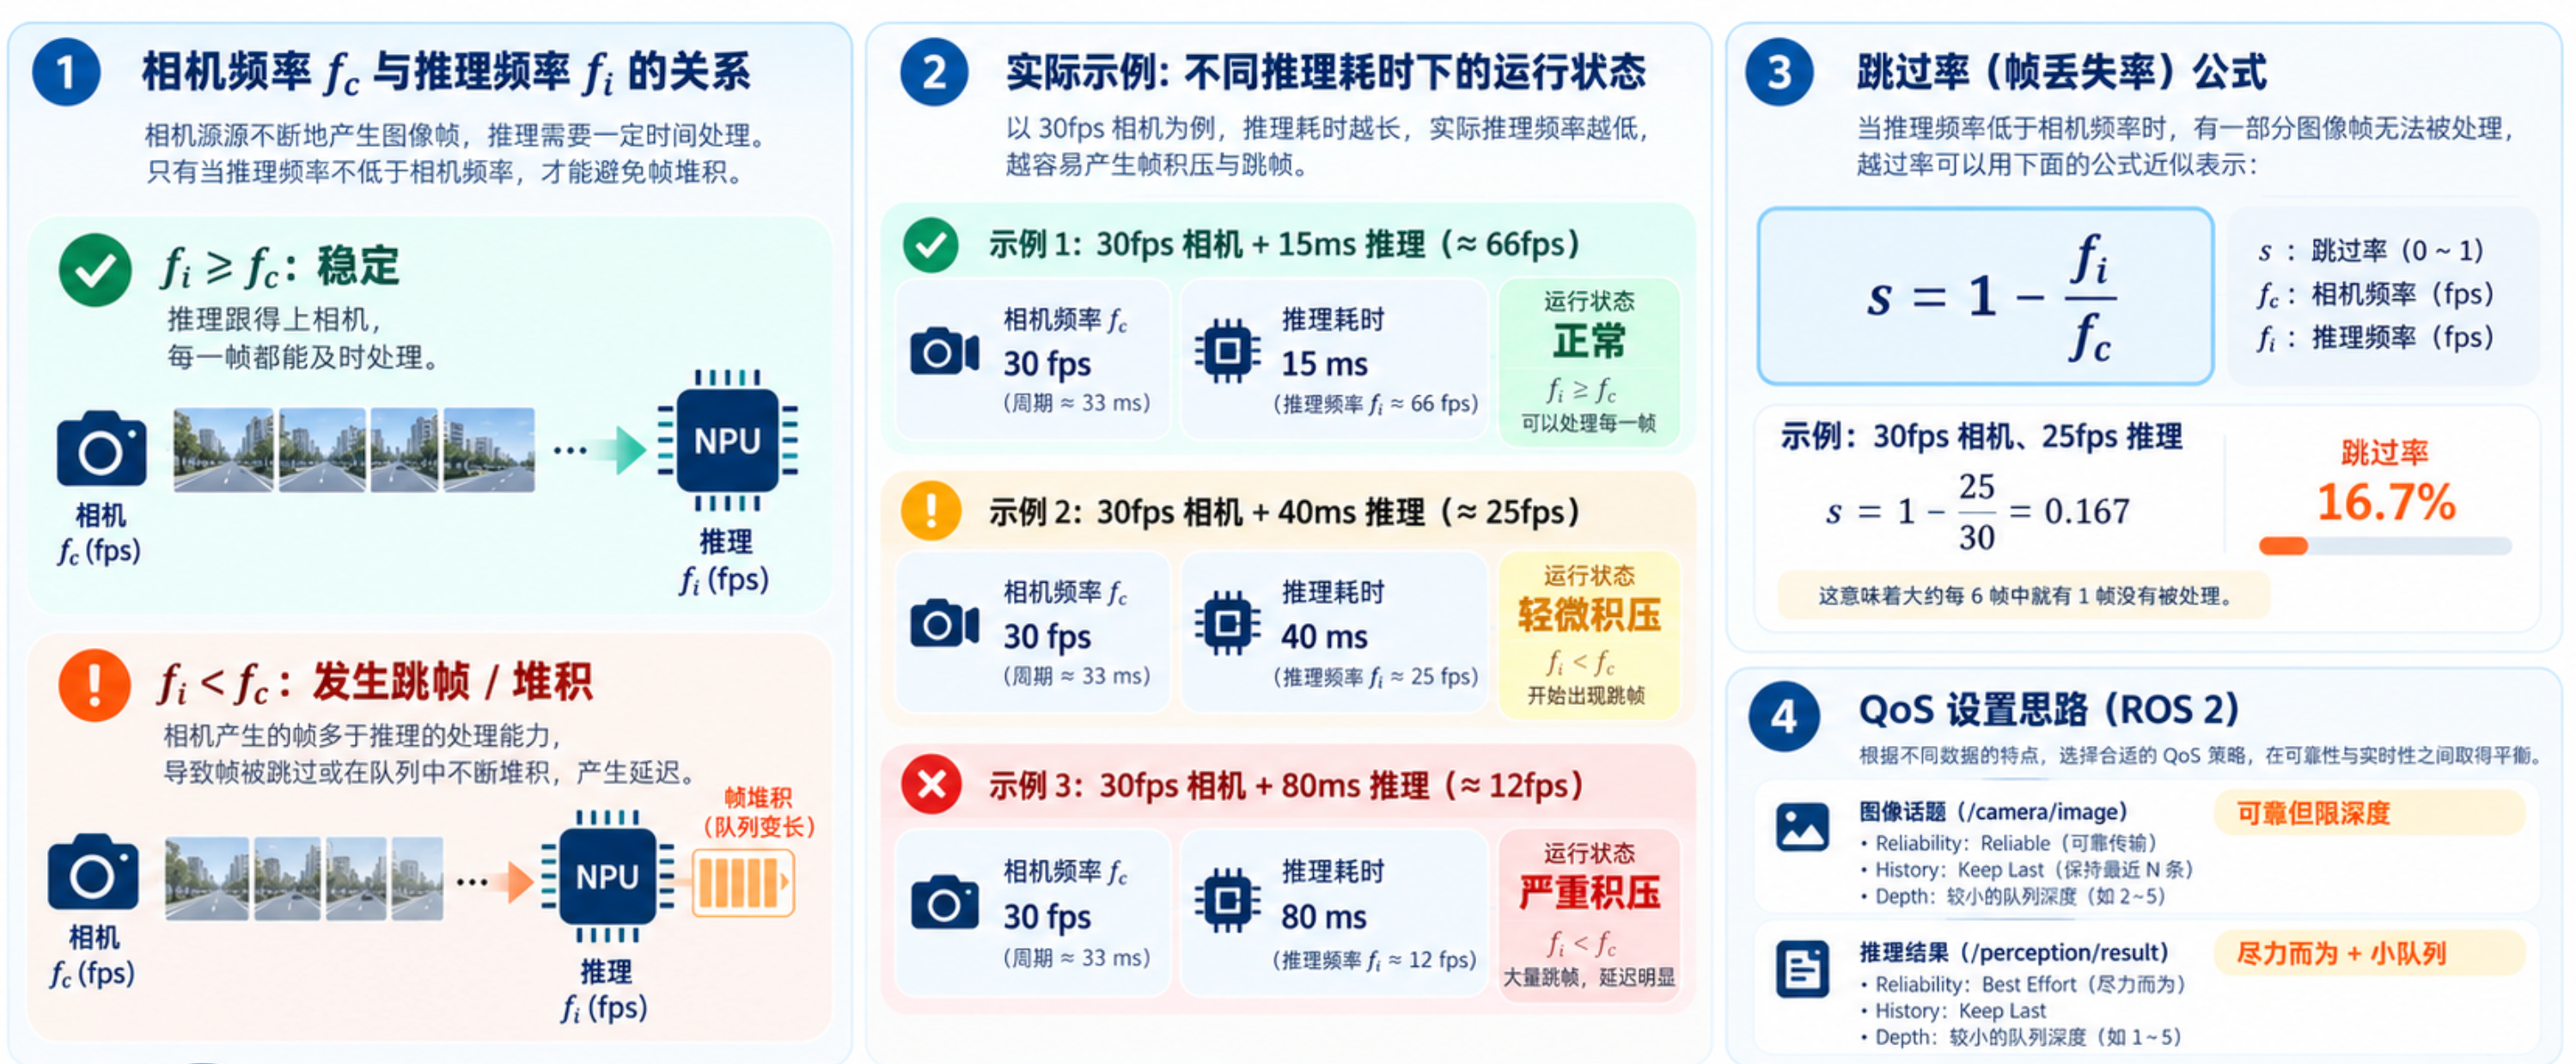
- 发布检测结果:可以用"尽力而为 + 小队列",丢了就等下一帧——实时场景丢旧结果优于堆积。
- 发布图像:若下游对帧完整性敏感,用"可靠"策略,但要配好队列深度,否则卡顿会反压上游。
2.5 Launch 文件:把系统"一键拉起"
单个节点只是零件,launch 文件把它们组装成系统。一个最小 launch(伪 YAML/Python 风格)大致描述:启动相机节点、启动检测节点(指向你的 context binary)、启动决策节点,并声明它们之间的话题连接。这样做的好处是:换板子、换模型只改参数,不动代码;复现环境一条命令搞定(呼应第 04 讲"固化工具链环境"的思路)。
三、推理节点设计:相机 → 推理 → 检测
3.1 节点拓扑
相机节点只管出图,检测节点只管推理,互不耦合。这也是 ROS2 的精髓:谁也不依赖谁的实现,只依赖话题契约。
3.2 频率匹配:最容易踩的坑
推理节点不可能无限快。假设相机 30fps 出图,但你的 NPU 模型单帧推理要 30ms(约 33fps 上限),看起来刚好。但一旦叠加跟踪、再加第二路分割模型,NPU 就不够了——于是检测结果 topic 的发布频率会低于相机频率。
| 相机频率 | NPU 单帧耗时 | 推理可达频率 | 是否积压 | 对策 |
|---|---|---|---|---|
| 30 fps | 15 ms | ~66 fps | 否 | 正常 |
| 30 fps | 40 ms | ~25 fps | 是(轻微) | 降相机频率 / 轻量化模型 |
| 30 fps | 80 ms | ~12 fps | 是(严重) | 换更大算力 SoC / 减模型 |
[推算] 上表为量级示意。真实单帧耗时请用第 07 讲的 qnn-profile 在你的模型上实测——不要拿厂商峰值算力除以 FLOPs 估算,那会严重乐观(可回到第 01 讲查看"峰值 vs 实得")。
3.3 多模型并发时的 NPU 算力分配
机器人常要"检测 + 分割 + 位姿"多任务。两种组织方式:
- 串行:同一节点里依次跑,简单但慢,总耗时是各模型之和。
- 并行:多个节点各自订阅、各自推理。注意 NPU 是共享资源,并行不等于同时——它们分时复用 HTP,要按优先级调度。
[推算] 若检测 25fps、分割 15fps、位姿 20fps,三者并发且都跑满,总 NPU 需求约 (25+15+20)=60 fps 当量。QCS6490 的 ~12 TOPS 能否扛住,取决于各模型实际算力占用——务必实测,不要拍脑袋。
3.4 生命周期节点与参数化
ROS2 的**生命周期节点(LifecycleNode)**让节点有明确的"配置→激活→休眠"状态机,方便系统级启停(比如机器人待机时把检测节点休眠省电)。**参数(Parameter)**机制则让模型路径、置信度阈值、话题名都可在 launch 里配置,不写死在代码里——这对"同一套代码适配不同机器人"至关重要。
四、示例:视觉感知如何接入机器人
4.1 机械臂抓取中的检测节点
机械臂"看到并抓取"一个物体,链路是:相机 → 检测节点出 bbox → 位姿估计节点出 6D 位姿 → 规划节点算抓取轨迹 → 控制节点驱动关节。其中检测/位姿节点就是你前面装好的 NPU 推理,只是现在通过 topic 把结果交给下游。
4.2 导航中的感知
自主导航(VSLAM/避障)里,相机或深度相机出图 → 特征/障碍物检测节点 → 定位与代价地图 → 规划 → 控制。感知节点的延迟直接决定避障反应速度(呼应第 01 讲延迟墙:几十毫秒内不闭环就撞上)。
4.3 与第 08 讲 camera pipeline 的衔接
第 08 讲的"相机 → ISP → NPU → 后处理"是单板内部流水线;本讲把它包成一个 ROS2 节点,对外只暴露 /image_raw(入)和 /detections(出)。这样第 08 讲的所有优化(硬件预处理、zero-copy)都保留在节点内部,系统其它部分无感。
五、性能与实时性:让感知节点站得稳
5.1 回调里不要做重活
ROS2 节点的回调(callback)应尽量轻:只负责"取帧 → 入队 / 发结果"。重推理放到独立线程或执行器(executor)里,否则回调阻塞会让节点收不到新消息、也发不出心跳,被系统误判为"掉线"。
5.2 零拷贝传输
帧在节点间传递,若每次都深拷贝,CPU 立刻被内存搬运吃满(又是带宽墙)。ROS2 支持共享内存风格的零拷贝传输(以及厂商优化的图像传输),让大图像在节点间"传引用不传数据"。这对高分辨率多相机系统尤其关键。
5.3 频率与延迟的权衡公式
设相机频率 f_c、推理频率 f_i、单帧推理耗时 t_i。稳态条件 f_i ≈ 1/t_i 且 f_i ≤ f_c。若 f_i < f_c,每 f_c/f_i 帧中约有一帧被跳过——跳过率 s = 1 - f_i/f_c。例如 30fps 相机、25fps 推理,跳过率 16.7%,即每 6 帧约有 1 帧没被检测。这个比率要控制在业务可接受范围内(高速运动场景容忍度更低)。
六、坑点清单
6.1 推理频率低于相机频率却还全收全发
症状:队列堆积、延迟雪崩。对策:相机节点做"丢旧帧"或降频,推理节点只处理最新一帧。
6.2 QoS 配错导致反压
症状:相机节点因下游队列满而阻塞。对策:检测结果用尽力而为 + 小队列;图像用可靠但限制深度。
6.3 多模型无脑并行拖垮 NPU
症状:所有模型都慢。对策:按优先级分时调度,或用第 11 讲的并发/batch 策略;必要时升级 SoC。
6.4 节点间拷贝开销
症状:帧在节点间传递时 CPU 飙升。对策:用共享内存传输(sensor_msgs 的零拷贝机制 / 厂商优化传输),避免每跳一次深拷贝。
6.5 推理节点阻塞 spin
症状:回调里推理太久,节点收不到新消息。对策:推理放独立线程/执行器,回调只负责取帧与发布。
6.6 时间戳不对齐
症状:检测结果和当前帧错位。对策:保留并传播 header.stamp,下游按时间戳对齐,别用"最新即当前"。
6.7 模型路径/阈值写死
症状:换机器人/换场景要改代码重编译。对策:全部走 Parameter,launch 里配置。
七、FAQ
Q1:一定要用 ROS2 吗?
不一定。简单产品一个进程搞定也行。但一旦多传感、多模块、要分布式,ROS2 的节点/话题/DDS 模型能省大量自研通信的坑。
Q2:NPU 推理在 ROS2 节点里是阻塞的吗?
不应该是。把推理放独立线程/回调组,不让它阻塞节点的消息收发(见 5.1)。
Q3:检测和跟踪放一个节点还是两个?
看解耦需求。前期放一起简单;后期要换跟踪算法时,拆成两个节点只改接口更灵活。
Q4:多相机怎么组织?
每路相机一个节点,各自发 /cameraN/image_raw;推理节点按需订阅。注意总带宽(第 08/09 讲带宽墙)和总 NPU 算力(3.3 节)。
Q5:推理节点的延迟怎么测?
在回调入口打时间戳、发布前打时间戳,差值即节点内耗时;端到端延迟还要加上传输与下游。用第 07 讲 profile 工具测 NPU 段。
Q6:能跑在犀牛派 A1 上吗?
可以。QCS6490 的算力适合中轻量机器人感知节点(如单路/双路检测、轻量分割);重负载(多路高分辨率 + 多模型)要考虑 QCS8550 或 IQ 系列(第 02 讲选型)。
Q7:和 Intelligent Robotics SDK 什么关系?
[官方] 它提供预制的相机/推理/导航等 ROS2 组件,能让你少写底层胶水代码。具体组件与版本以官方资料为准;本讲给的是集成原则和自己写节点的通用方法。
Q8:本讲和第 11 讲怎么衔接?
本讲把 AI 做成节点,第 11 讲负责把节点的延迟、功耗、并发调到量产级,并解决 thermal 降频等真实部署问题。
Q9:LifecycleNode 一定要用吗?
不是必须,但建议。它让系统能统一启停节点(比如低功耗模式休眠感知),是工程化系统的标配。
Q10:跨机器部署(感知在板、决策在工控机)怎么保证实时?
靠 DDS 的 QoS 与网络(如 TSN/实时以太网)。但跨网络本身引入延迟,关键闭环(避障)尽量留在板端本地,跨机只传高层语义(检测结果而非原始图)。
八、实战模板与术语表
8.1 完整 launch 示例(伪代码,YAML 风格)
下面是一份把"相机 + NPU 检测 + 决策"组装起来的 launch 骨架。注意所有可变项(模型路径、阈值、话题名)都通过参数注入,不写死在节点代码里:
# [推算] ROS2 launch 示意(具体语法以 ROS2 版本为准)
nodes:
  - name: camera_node
    pkg: perception_pkg
    exec: camera
    params:
      topic: /image_raw
      width: 1280
      height: 720
      fps: 30

  - name: npu_detector
    pkg: qnn_ros_pkg
    exec: detector
    params:
      model_ctx: /models/yolo_ctx.bin     # 第07讲编译产物
      confident_th: 0.5
      sub_topic: /image_raw
      pub_topic: /detections
      use_zero_copy: true                  # 零拷贝传输

  - name: decision_node
    pkg: robot_pkg
    exec: planner
    params:
      sub_topic: /detections
      cmd_topic: /cmd_vel

qos:
  images: reliable
  detections: best_effort
这份 launch 的价值:换板子、换模型、换机器人,只改参数不改代码;新人一条命令复现整套系统。这正是第 04 讲"固化环境"思想在机器人层的延伸。
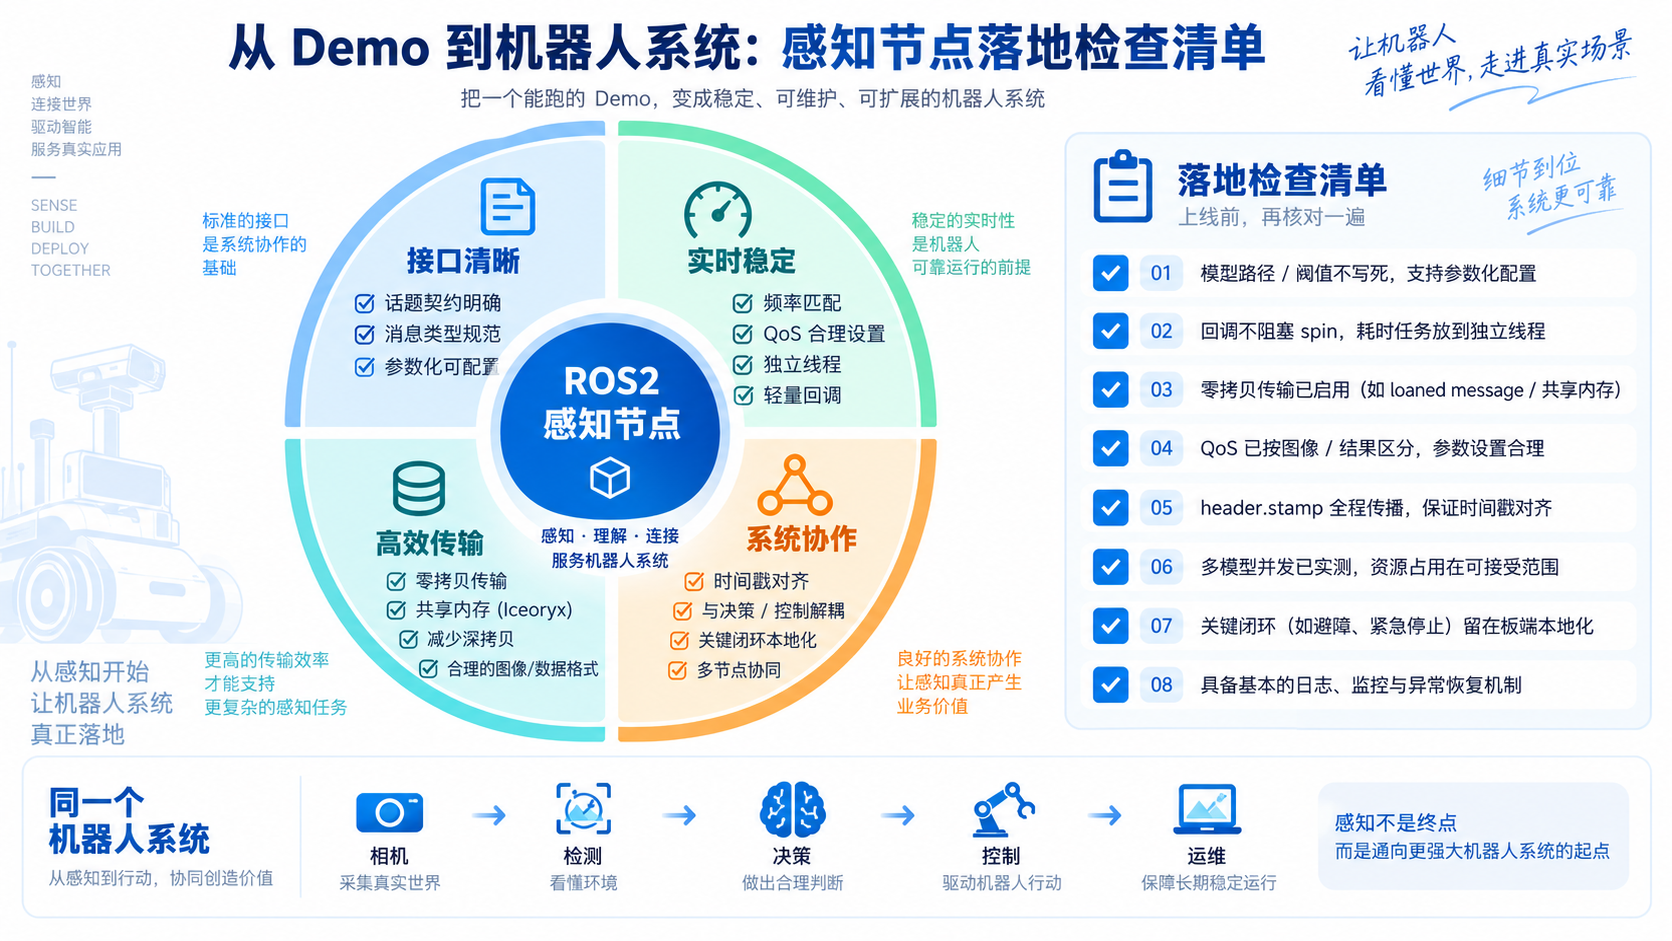
8.2 机器人感知系统 checklist
部署前按这张单逐项确认:
- 各节点话题契约清晰、消息类型统一
- 推理节点重活在独立线程,回调轻量(不阻塞 spin)
- QoS 策略按"图像可靠 + 结果尽力"配置
- 频率匹配:推理频率 ≥ 业务最低要求(用 3.3 节公式算跳过率)
- 零拷贝传输已启用(高分辨率多相机必开)
- 时间戳
header.stamp全程传播、下游按时间戳对齐 - 参数化:模型路径/阈值/topic 不写死
- 多模型并发下 NPU 占用实测可控(用第 11 讲方法)
- 关键闭环(避障)留在板端本地,跨机只传高层语义
8.3 选型映射:哪颗 SoC 跑哪种机器人负载
把第 02 讲的选型逻辑落到机器人场景([官方] 算力档位,具体以规格书为准):
| 机器人负载 | 推荐 SoC | 理由 |
|---|---|---|
| 轻量巡检/服务机器人(单路检测) | QCS6490(犀牛派 A1) | ~12 TOPS 够用、生态成熟、成本友好 |
| 多相机导航/AMR | QCS8550 | ~48+12 TOPS,多路视觉+语义更从容 |
| 工业多臂/视觉伺服(多路高分辨率) | IQ-9075 | ~100 TOPS、12–16 路相机,专为视觉 |
| 入门教育/验证 | QCS5430 | 预算优先,轻量模型可行 |
规律和第 02 讲一致:负载越重(多路、高分辨率、多模型)、温度越严,越往旗舰 QCS / IQ 走;越轻量成本敏感,越往入门走。犀牛派 A1(QCS6490)是绝大多数中轻量机器人感知节点的甜点。
8.4 跨讲串联:用前 10 讲搭一台巡检机器人
把本系列成果串起来,一台"基于犀牛派 A1 的视觉巡检机器人"是这样长出来的:
- 第 03 讲:点亮犀牛派 A1,确认 NPU 节点可见。
- 第 04 讲:装好 QNN SDK / AI Hub,固化工具链。
- 第 05 讲:把自训检测模型转成 QNN IR。
- 第 06 讲:INT8 量化,校准集覆盖现场光照/角度,控制掉点。
- 第 07 讲:编译成 context binary,在 HTP 上首跑出延迟。
- 第 08 讲:接 MIPI 相机做实时检测,优化 camera pipeline。
- 第 09 讲:把相机流做成"边解码边推理",必要时硬件编码回传。
- 第 10 讲(本讲):封装成 ROS2 感知节点,接入决策/控制,组 launch 一键拉起。
每一步的产出都是下一步的输入——这就是全系列"artifact 衔接链"在机器人上的具象。第 11 讲会让它跑得稳,第 12 讲会做整体复盘。
8.5 术语表
- LifecycleNode:带"配置→激活→休眠"状态机的节点,便于系统级启停与低功耗。
- Parameter:ROS2 的参数机制,让模型路径/阈值/topic 等可外部配置,不写死代码。
- QoS(Quality of Service):DDS 的通信策略,控制可靠/尽力、队列深度、保序等。
- DDS:ROS2 的底层通信中间件,支持分布式与实时。
- Zero-copy:节点间传大图像时传引用/共享内存而非深拷贝,避免带宽墙。
- 跳过率(Skip Rate):因
f_i < f_c未被检测的帧占比,s = 1 - f_i/f_c。
8.6 本讲速记
- 机器人 = 多节点协作系统,AI 推理只是其中一个"感知器官"。
- 感知节点三件事:订阅图像、跑 NPU、发布结果;重活放线程,回调要轻。
- 实时性的命门是频率匹配与 QoS,不是单帧延迟。
- 一切可配置、可分布式、可零拷贝——这是工程化与玩具的分界。
8.7 两个闭环示例(伪代码)
把感知节点接到下游,才是"机器人能用"。下面两个最简闭环,展示 topic 如何把 AI 与机器人传统栈解耦。
导航避障闭环:
# [推算] 避障节点:订阅检测结果 + 激光/深度,发布速度指令
class AvoidNode(Node):
    def __init__(self):
        self.create_subscription(Detections, '/detections', self.on_det, 5)
        self.create_subscription(LaserScan, '/scan', self.on_scan, 5)
        self.cmd = self.create_publisher(Twist, '/cmd_vel', 5)
    def on_det(self, det):
        # 检测到行人/障碍 → 减速(只消费高层语义,不碰原始图)
        if any(d.conf > 0.6 for d in det.objects):
            self.cmd.publish(slow_down())
    def on_scan(self, scan):
        if min(scan.ranges) < 0.5:
            self.cmd.publish(stop())
要点:感知(检测节点)与执行(避障节点)完全解耦;避障节点只订阅 /detections 与 /scan,跨机部署时只传这些高层语义,省下原始图像带宽。
机械臂抓取闭环:
# [推算] 抓取节点:检测 → 位姿 → 规划 → 控制
class GraspNode(Node):
    def __init__(self):
        self.create_subscription(Detections, '/detections', self.on_det, 5)
    def on_det(self, det):
        box = pick_target(det)        # 选抓取目标
        pose = estimate_6d(box)       # 位姿估计(另一 NPU 模型)
        traj = plan_grasp(pose)       # 运动规划(传统机器人栈)
        move_arm(traj)                # 控制关节
要点:检测与位姿是两个 NPU 模型,按 3.3 节分时复用 HTP;规划与控制是经典机器人算法,通过 topic 和 AI 解耦——换抓取算法不用动检测,换检测模型不用动控制。
8.8 上机故障排查实例
实例 A:检测节点"假死"
现象:系统跑几分钟后 /detections 不再更新,进程却还在。排查:回调里直接做了重推理,spin 被阻塞(见 5.1/6.5);把推理移到独立线程后恢复。这是新手最高频的错误。
实例 B:相机节点 CPU 飙高
现象:相机节点 CPU 占满,帧率却只有 5fps。排查:图像在节点间是深拷贝而非零拷贝(6.4);启用共享内存传输后 CPU 降到个位数、帧率回到 30。
实例 C:避障反应迟钝
现象:检测到障碍但车已撞上。排查:端到端延迟超 100ms,且跳帧率 30%(3.3/5.3);降相机频率到 20fps 或轻量化模型后达标。
共同点是:问题几乎都不在"模型准不准",而在"系统怎么把模型接进去"——这正是本讲要解决的。
8.9 把本讲的节点送进第 11 讲的性能账
本讲让系统"功能正确",第 11 讲让它"跑得稳"。对感知节点而言,第 11 讲要算的几笔账:
- 单节点 NPU 占用:用
qnn-profile读逐层耗时,得到该模型实占 HTP 多少(呼应第 07 讲)。 - 并发总占用:多节点同时跑,HTP 总占用是否超 80%——留余量防降频。
- thermal 波动下的跳过率:降频后
f_i掉、s = 1 - f_i/f_c升;系统要在f_i波动时仍不崩(呼应第 09 讲缓冲弹性)。 - 功耗预算:常驻感知节点 vs 唤醒式(KWS,第 09 讲)的功耗差异,决定电池设备能否撑一天。
把这几笔账在节点设计阶段就留好余量,量产时才不会返工。
8.10 媒体流与 ROS2 节点如何共存
一个常见困惑:“第 09 讲的媒体栈和第 10 讲的 ROS2,到底谁管相机?” 答案是分层协作、不冲突:
- 第 09 讲的媒体栈(硬件解码、zero-copy、队列)活在单个节点内部——比如相机节点内部用硬件解码出帧、用共享内存持有 buffer。
- ROS2 是节点之间的胶水——相机节点把帧通过
/image_raw话题发给检测节点。
媒体栈是"节点内优化",ROS2 是"节点间通信",两者正交。把第 09 讲的能力封进节点、用第 10 讲的话题接起来,就是一台完整机器人感知系统的标准拼法。
8.11 把感知节点组件化 / 容器化部署
工程落地时还有两个进阶手法:
- 组件化(Composable Nodes):ROS2 支持把多个节点"组合"进同一个进程,节点间通信走进程内通道,省掉跨进程拷贝与序列化开销。对高分辨率多相机系统,能再砍一层带宽税。代价是生命周期耦合——组件崩了整个进程一起崩,要权衡。
- 容器化交付:把感知节点 + 模型 + 依赖打进容器镜像,配合 OTA 下发(呼应第 11 讲量产迁移)。好处是"环境一致、回滚简单";代价是镜像体积与启动时间,边缘设备要精打细算。
这两者都属于"功能跑通之后"的优化,优先级低于先让系统正确运行。记住工程化的次序:先正确,再快,再稳,最后才谈极致优化。
8.12 真实项目的节点拓扑模板
把本讲思想落到一个中等复杂度的机器人(带视觉 + 激光雷达 + 机械臂的 AMR)上,典型节点划分长这样:
按职责分四层:
- 感知层:相机、激光雷达、检测节点、抓取节点(NPU)。负责"把物理世界变成结构化信息"。
- 认知层:定位、融合/决策、规划。负责"理解并决定做什么"。
- 执行层:控制、机械臂控制。负责"把决定变成动作"。
- 运维层:健康监控、日志/录制。负责"系统可观测、可回溯"(呼应第 09 讲录制)。
工程要点:关键闭环尽量本地。底盘避障这种几十毫秒级闭环,检测→决策→控制最好都在同一台板(如犀牛派 A1)上本地完成;跨机只传高层语义(检测结果、目标位姿),原始图像/点云不跨网。这样即使网络抖动,机器人也不会"瞎"。这也解释了为什么端侧 NPU 平台在机器人里不可替代——AI 要在产生数据的那台设备上就地闭环,而不是把原始传感全传上云。
8.13 给团队的实施建议
把本讲方法落到团队,有五条经验最值得记:
- 先单节点、后系统:先用第 07/08 讲在板端把单路推理跑通跑稳,再封装成 ROS2 节点、再拼系统。一上来就搭十几节点的系统,排错成本指数级上升。
- 一切参数化、launch 管编排:模型路径、阈值、话题名、QoS 全走参数,launch 一键拉起。新人克隆仓库、装好依赖、一条命令就能复现整套系统,而不是"只有老王机器上能跑"。
- 实时性命门是频率匹配与 QoS:单帧延迟好看没用,要看"推理频率跟不上相机频率时的跳过率"和"QoS 反压"。这两处调错,系统会在负载一高时雪崩。
- 关键闭环本地、跨机只传语义:避障、急停这类几十毫秒闭环必须板端本地完成;跨机器只传检测结果/目标位姿等高层语义,绝不传原始图/点云。网络抖一动,机器人也不会"瞎"。
- 优化有次序:先 best-effort 跑通 → 再上 lifecycle(统一启停)→ 再上 composition(减拷贝)→ 最后容器化/OTA。前一步没稳就跳下一步,只会把问题藏得更深。
这五条和第 04 讲"固化工具链环境"、第 11 讲"量产迁移"是一脉相承的工程纪律:边缘 AI 项目能不能交付,往往不取决于模型多先进,而取决于这些"不起眼"的系统工程是否到位。
本讲速记卡:
- 机器人 = 多节点协作系统,AI 推理只是其中的"感知器官"。
- 感知节点三件事:订阅图像、跑 NPU、发布结果;重活在独立线程,回调要轻。
- 实时性的命门是频率匹配 + QoS,不是单帧延迟;用跳过率
s = 1 - f_i/f_c量化。 - 一切可配置(参数化)、可分布式(DDS)、可零拷贝(共享内存)——这是工程化与玩具的分界。
- 关键闭环本地完成,跨机只传高层语义,绝不传原始传感。
- 优化次序铁律:先通 → 再稳 → 再省 → 最后才谈极致优化。
把这六条贴在工位上,本讲就算吃透了,下一讲(第 11 讲)我们会把这棵"功能正确的系统树",修剪成"跑得稳、跑得久、能量产"的形态。
回到本讲的起点再强调一次:你并不需要一开始就把系统做得完美。先让一个感知节点正确运行,把它通过话题接到决策节点,再逐步把频率匹配、QoS、零拷贝、thermal 余量这些工程细节补齐。工程化是渐进的,不是一次性的——这和第 04 讲"固化环境"、第 03 讲"先点亮板子再谈 AI"是同一套方法论:先建立可靠的地基,再往上长。第 11 讲要告诉你的是,当系统要从"能跑"变成"能量产",还要补齐哪几块最后的拼图:性能剖析、功耗与热、并发与 batch、模型轻量化,以及从开发板到 OEM 量产的关键迁移
九、结论与下讲预告
核心一句话:把 NPU 推理封装成 ROS2 感知节点,你就从"会跑模型的人"变成"能搭机器人系统的人"——关键是管好话题契约、频率匹配和 QoS,让感知成为系统里可替换、可复用的器官。
下一讲(第 11 讲) 我们离开"功能正确",进入"跑得稳、跑得久、能量产":性能调优(profile 定位热点)、功耗与热(thermal 降频对策)、并发与 batch 策略、模型轻量化,以及从开发板到 OEM 量产的关键迁移(BSP 锁定、SOM 选型)。系统搭好了,接下来要让它扛住真实世界。
本讲所有节点代码、launch 示例、频率/跳过率公式均为架构示意;具体的 ROS2 API、消息类型、组件名以你采用的 ROS2 版本与板端 SDK 为准。落地前请用
qnn-profile实测各模型的 HTP 实占算力,再据此核定频率匹配与并发策略,不要直接套用推算值。
参考链接

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)