《概率机器人》读书笔记-第四章 非参数滤波器
本章概述
上一篇的高斯滤波虽然优雅,却只会画“一团云”,画不出“好几团云”:全局定位、绑架问题里置信度天然多峰,高斯假设就此失灵。本篇换一条路,不再假设分布形状,用格子或粒子把分布直接“撒”出来。你会看到直方图滤波的直观与维度灾难,以及粒子滤波“运动采样、似然赋权、重采样”的三步循环,为 MCL 与 FastSLAM 打下算法地基。
前置依赖:第二章贝叶斯滤波。后继联系:第 8 章 MCL、第 13 章 FastSLAM 都建立在粒子滤波之上。
核心知识点
4.1 非参数化的动机
高斯滤波的两大限制:
-
单峰假设:无法表达"机器人可能在 A 或 B"这类多模态置信度。
-
线性化/高斯噪声假设:强非线性系统近似误差大。
非参数滤波器的思路是用一组离散元素显式表示置信度,对分布形状不做先验约束:
-
直方图滤波:把状态空间切成格子,每个格子存一个概率。
-
粒子滤波:用带权重的随机样本(粒子)表示分布。
直觉:高斯滤波像"用椭圆画一团云",非参数滤波像"撒一把沙子来描出云的形状"——后者能描出任意外形,但样本越多越准。
4.2 离散贝叶斯滤波 / 直方图滤波
把连续状态空间离散化为有限个区域(bin),每个区域 上置信度用一个标量
表示,满足
。
贝叶斯滤波的两步直接写成离散形式:
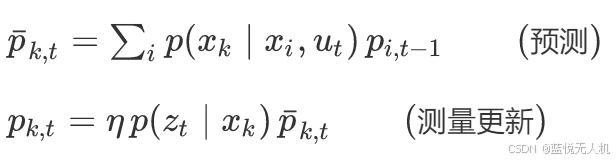
性质
-
简单、直观,可以表达多峰分布。
-
维度灾难:状态维数 d 增加时,格子数按
指数增长,三维以上状态空间几乎不可用。
-
适合低维状态(如 1D 走廊定位)。
4.3 粒子滤波(Particle Filter)
格子法困在维度上,那把固定格子换成可以自由移动的样本呢?核心思想:用 M 个带权样本 近似置信度:
样本越多,近似越精确;粒子可以聚集在高概率区域,从而自适应地分配表达力。
4.4 重要性采样与序贯重要性重采样(SIR)
直接从后验采样通常困难。粒子滤波借助提议分布 (proposal)来采样本,再通过权重修正:
最常用的提议分布就是运动模型本身:,此时权重简化为
直觉:粒子先按运动模型"撒出去",再用观测似然给每颗粒子打分——观测匹配好的粒子权重大,差的粒子权重小。
权重退化与重采样
权重经多步后会退化(少数粒子占绝大部分权重),浪费计算。重采样(resampling)从当前粒子集中按权重有放回地抽 M 个新粒子,使权重重新均匀。
常用的低方差重采样(low-variance sampling):用一个随机起点 + 等距步长抽取,比独立有放回采样方差更小。
4.5 标准粒子滤波算法(SIR 形式)
算法: Particle_filter(X_{t-1}, u_t, z_t, M)
─────────────────────────────────────────────
输入: X_{t-1}={x_{t-1}^{[m]}, w_{t-1}^{[m]}}, 控制 u_t, 观测 z_t
1. 对 m = 1..M:
     x_t^{[m]} = sample_motion_model(u_t, x_{t-1}^{[m]})   // 从运动模型采样
     w_t^{[m]} = measurement_prob(z_t, x_t^{[m]})          // 按观测似然赋权
2. X_t = X̄_t = {(x_t^{[m]}, w_t^{[m]})}
3. 重采样:
     构造累积权重,按权重抽 M 个粒子(低方差法),权重重置为 1/M
4. 返回 X_t
─────────────────────────────────────────────
性质
-
收敛性:随
,粒子分布收敛到真实后验。
-
能表达多峰后验:粒子自然聚集到多个高概率模式。
-
维度敏感但比直方图温和:粒子会自适应集中到高概率区,所需粒子数随维度增长比格子法缓慢。
-
退化-重采样权衡:重采样太频繁会损失多样性(粒子 impoverishment),太稀疏又退化。
关键公式速查
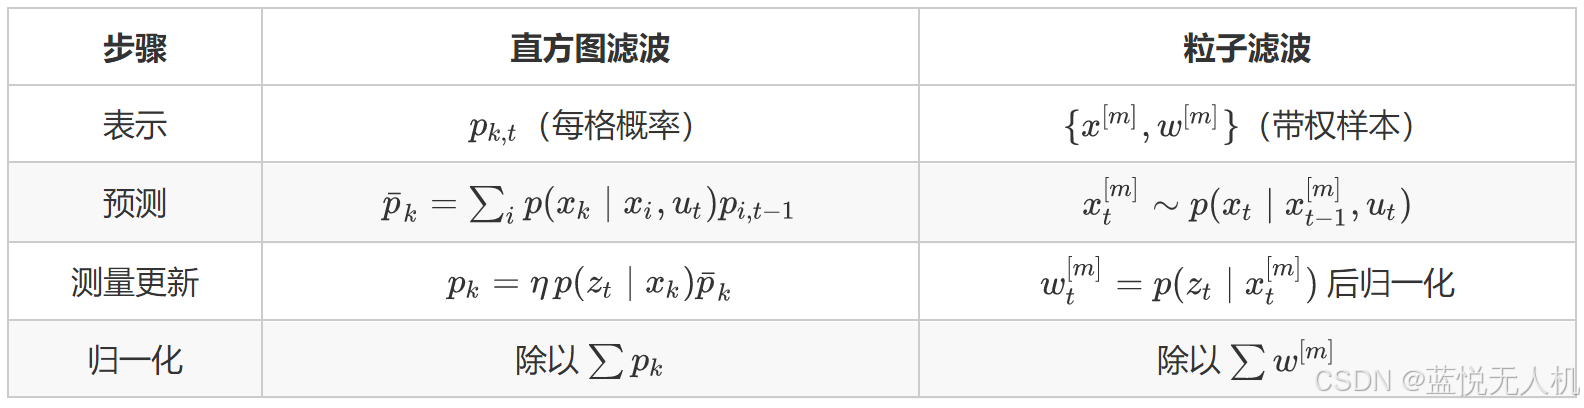
章节小结
-
非参数滤波放弃高斯假设,能表达任意(含多峰)后验。
-
直方图滤波简单直观但受维度灾难限制,适合低维。
-
粒子滤波用带权样本表示置信度,由"运动采样 → 似然赋权 → 重采样"三步循环;收敛性有理论保证,是后续 MCL、FastSLAM 的算法基石。
-
两类滤波器本质上都是第二章贝叶斯滤波的具体实现,只是置信度的表示方式不同。
后续联系:第 8 章把粒子滤波直接套到定位问题上得到 MCL;第 13 章用粒子滤波同时估计轨迹与地图得到 FastSLAM。
思考与延伸
算法跑起来只是开始,落地时还有几个绕不开的坑:
-
粒子匮乏(particle deprivation):重采样后高概率区粒子集中、多样性丢失,可能丢掉真实位姿。缓解方法:自适应重采样(只在有效样本数
低于阈值时重采样)、注入随机粒子。
-
提议分布选择:用观测引导的提议分布(如基于最近观测的高斯)可大幅减少所需粒子数,是 AMCL、FastSLAM 2.0 的改进点。
-
粒子数 vs 精度:粒子数与状态维数、置信度峰宽相关;工程上需通过实验确定。盲目增加粒子会拖慢实时性。
-
与高斯滤波的混合:Rao-Blackwellized 粒子滤波(第 13 章 FastSLAM)对部分状态用粒子、其余用解析高斯,兼顾表达力与效率。
写在最后
核心观点一句话:非参数滤波用表达自由度换取计算代价。直方图滤波直观,却困在维度灾难里;粒子滤波让样本自适应聚集到高概率区,配合重采样拿到收敛保证,成为 MCL、FastSLAM 等经典系统的地基。从机器人定位到目标跟踪,这套“撒粒子”的思想始终活跃在工程一线。下一步把它套到定位问题上,就是经典的蒙特卡洛定位。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)