【ECCV 2026】ContextFlow 论文解读:上下文流匹配让机器人零微调泛化未见任务|从机器人动作解码范式视角
摘要
本文解读 ECCV 2026 论文《ContextFlow: In-Context Flow Matching for Robot Manipulation》。该论文提出 ContextFlow,把机器人领域的 in-context 模仿学习从“离散动作逐 token 预测”改写为“以演示为条件的连续动作块流匹配”,通过融合条件流匹配(conditional flow matching)、Perceiver 式多模态上下文压缩器与混合专家双塔骨干,让策略只看几条演示、不做任何参数更新就能完成未见过的任务配置,其特别之处在于用同骨干、同初始化的受控对照证明了增益来自解码范式替换本身,而不是别的架构细节。实验表明 LIBERO 未见配置平均成功率 73.5%,比自回归基线 ICRT 高 35 个百分点,并追平 1-shot 微调的 π0(72.5%);真机 ALOHA 平均 41.7%,为机器人泛化提供了一条“条件化而非重训练”的路线。
视频讲解:B 站视频 BV1RraH6iEMm
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | ContextFlow: In-Context Flow Matching for Robot Manipulation |
| 标题(中文) | ContextFlow:面向机器人操作的上下文流匹配 |
| 作者 | Jian Ding, Xianjie Dai, Roei Herzig, Nussair Hroub, Jinjie Mai, Dengxin Dai, Bernard Ghanem, Mohamed Elhoseiny |
| 机构 | KAUST Vision-CAIR / IVUL · UC Berkeley · Zurich |
| 会议 | ECCV 2026 |
| arXiv | arXiv:2609.06852 |
| 项目网站 | dingjiansw101.github.io/contextflow-page |
| 数据集规模 | 1,318 条真机 ALOHA 遥操作轨迹 / 25 种任务配置 |
背景与动机:为什么“给几条演示就会做”这么难
人类看两次示范就能学会一个新动作,这种能力在机器学习里叫 in-context learning:模型在推理时以少量输入输出样例为条件,不更新梯度就适配新任务。GPT-3 之后,大语言模型把这种能力变成了训练规模的自然涌现结果;机器人领域也沿着同一条路探索,形成了 in-context 模仿学习——把演示表示成观测与专家动作的序列,让策略从几条演示里学会新任务,从而绕开传统模仿学习必须的微调环节。
问题在于,机器人操作的动作是连续、长时程的。已有的 in-context 模仿方法,比如 ICRT,把连续动作离散化成 token,再用自回归的 next-token prediction 一步步往外吐。这条路有两个先天代价:一是向量量化本身引入的量化误差,二是每一步预测都以之前所有预测为条件,早期的微小偏差会被后续每一步放大,也就是复合误差(compounding error)。这个代价在训练分布内还压得住,一旦遇到未见过的任务配置,分布偏移会把误差累积放大得更加明显。
另一条线是流匹配。它在连续动作空间里学习一个时间相关的速度场,一次并行预测整段动作块,天然规避了逐 token 的串行依赖。π0 已经证明流匹配可以做成 VLA 的动作解码器,OpenVLA-OFT 也展示了并行连续动作头的价值。但把 in-context 学习放进流匹配框架这件事,此前基本是空白——自回归 in-context 学习在 LLM 里有成熟的架构与训练配方,流匹配却没有对等的“上下文条件化”方案。
从技术谱系看,这篇文章的位置相当清晰。2022 年,Flow Matching 与 Rectified Flow 提出用确定性常微分方程做输运,把生成建模从随机微分方程采样里解放出来;2023 年,ACT 与 Diffusion Policy 证明并行预测动作块能抑制复合误差,为连续动作解码铺平道路;2024 年,ICRT 把 in-context 模仿写成 next-token prediction,π0 则首次把流匹配带进 VLA——这两条线当时仍然是分离的。ContextFlow 要做的,就是把它们接上。
研究主线:从问题到结论
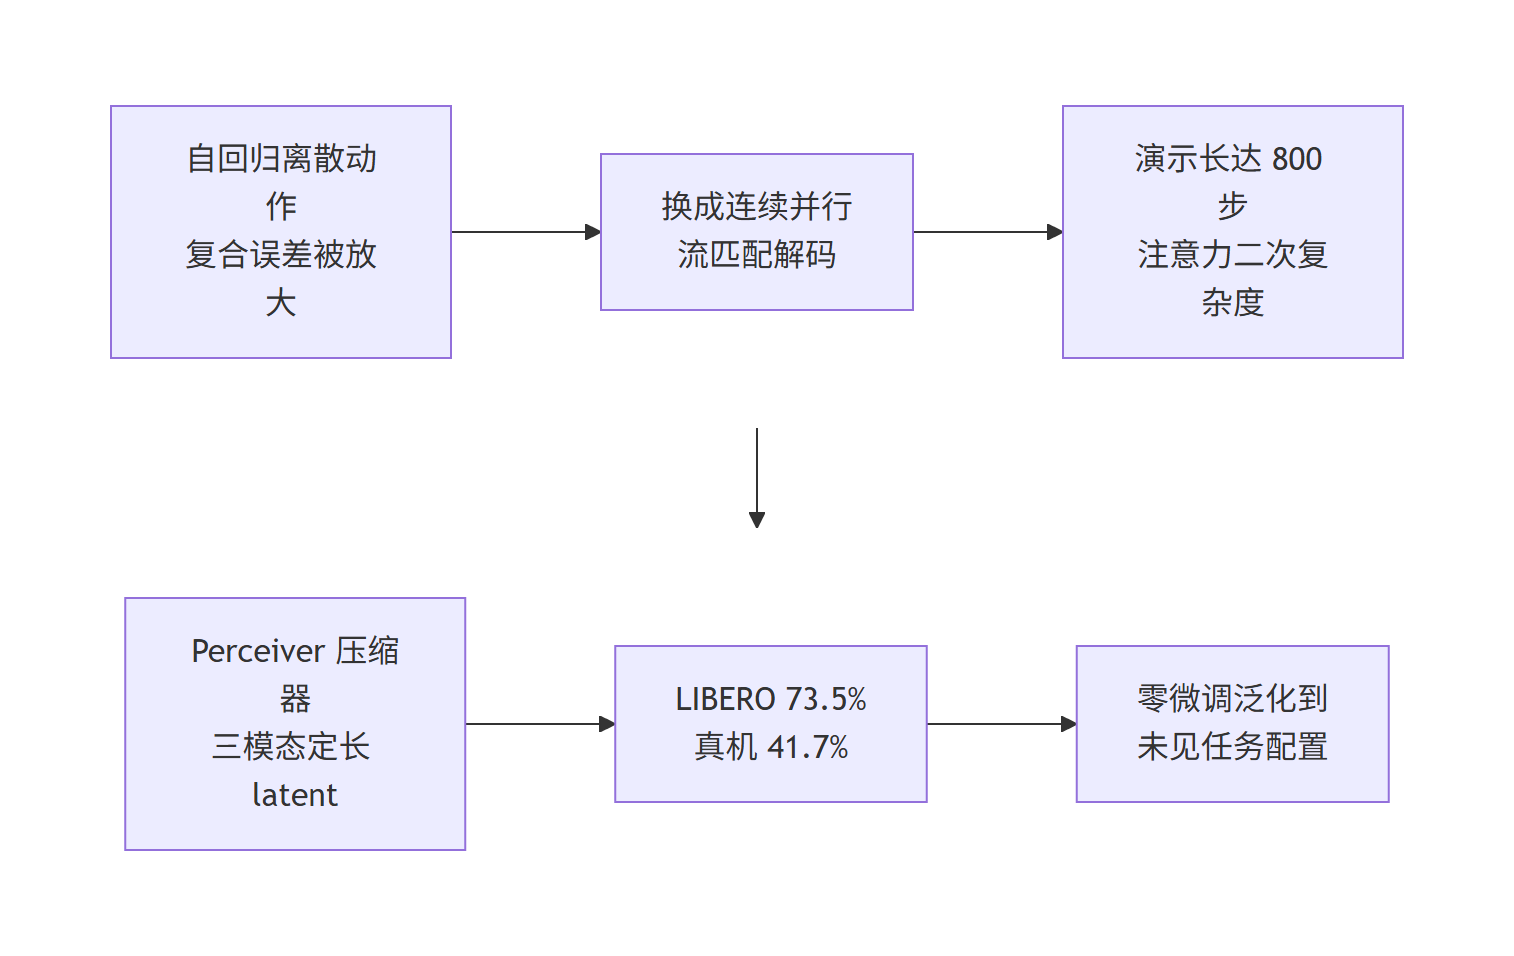
图 5:ContextFlow 研究主线(Mermaid 流程图):问题 → 动机 → 基准设计 → 方法 → 实验 → 结论。
ContextFlow 基准与方法设计:连续并行 + 条件压缩
ContextFlow 的设计可以拆成两个互相咬合的决策。
第一个决策是换掉动作解码的范式。既有工作用自回归模型学习条件分布 $\pi(\mathbf{a} \mid o, d)$,但需要把连续动作离散成 token,带来量化误差。作者改为用条件流匹配(conditional flow matching):给定当前观测与演示,学习一个时间相关的确定性速度场,让样本从简单高斯先验被平滑地输运到目标条件分布,全程在连续动作空间里进行,不做任何离散化。
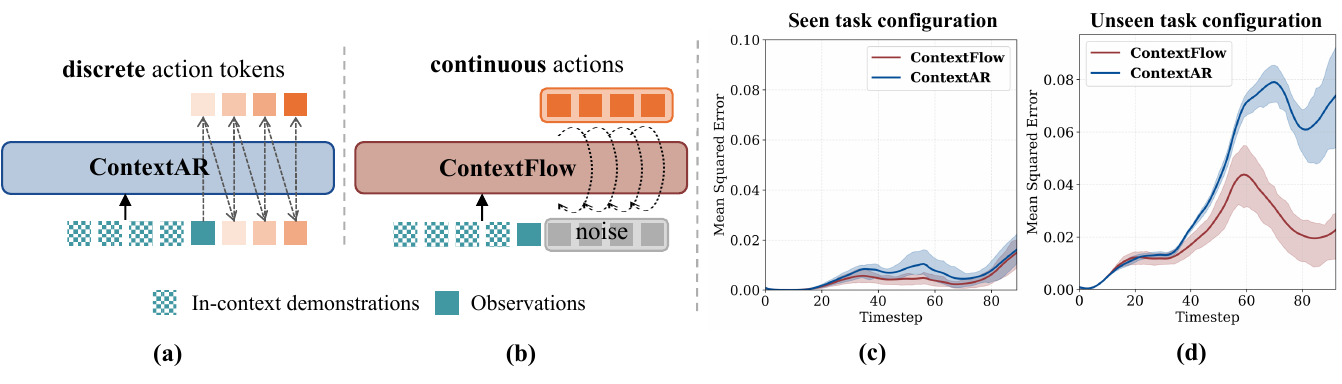
图 1:自回归 (a) 与流匹配 (b) 在动作解码与复合误差上的对比;已见配置 (c) 与未见配置 (d) 下的复合误差曲线。
这张动机图把论点摆得很清楚:左侧的自回归模型逐 token 生成离散动作,早期偏差被后续步骤不断放大;右侧的流匹配框架一次并行预测一整段动作块,误差不会被逐 token 累积。下半部分的曲线进一步说明,已见配置下两种方法的复合误差差距有限,但到了未见配置,自回归的误差曲线明显上扬,这正是作者反复强调的“分布偏移放大复合误差”。
第二个决策是给演示做选择性压缩。机器人轨迹经常长达数百步:连“把鸡蛋放进盒子”这样一个任务的演示长度都有 $T_d \approx 800$ 步,还附带多路相机的视觉输入。注意力的复杂度对序列长度是二次的,把原始序列直接送进 transformer 代价高到不可接受。作者的做法是先对每个模态做时间子采样,再用一层 Perceiver 式的可学习 query 把长序列压成定长 latent,拼成统一的条件表示 $\mathbf{T}{\text{context}} = [\mathbf{Z}{\text{img}}; \mathbf{Z}{\text{state}}; \mathbf{Z}{\text{action}}]$,其中图像、状态、动作三路各自压成 32 个 token,所以上下文长度是“32 × 相机数 + 64”——LIBERO 用两路相机对应 128 个 token,ALOHA 用三路相机对应 160 个。这个设计的价值不只是省算力:作者发现,如果去掉压缩器、单纯增加图像 token 数,性能反而下降,说明注意力被大量冗余 token 稀释之后,真正相关的信息更不容易被聚焦。把“看得更多”换成“看得更准”,是这一路的关键。
分类全景:一个方法的三层结构
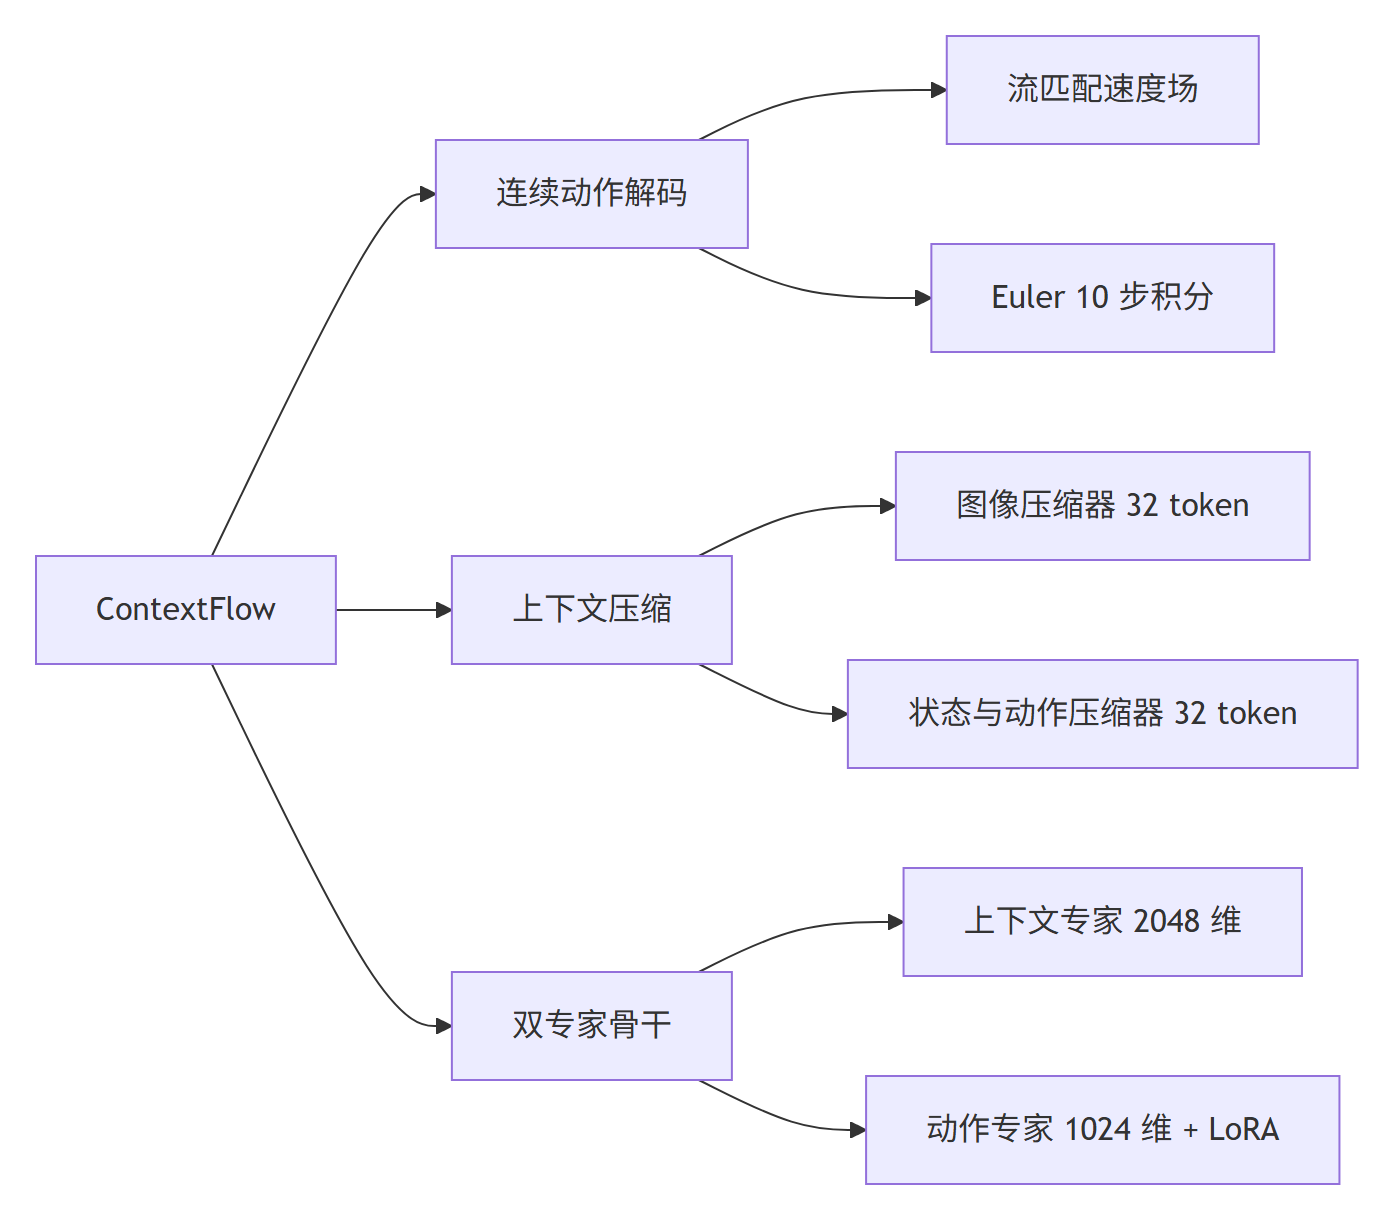
图 6:ContextFlow 方法结构全景(Mermaid 分类图):解码层、条件层与骨干层。
方法细节:流匹配怎么读演示
问题形式化。 一条演示被表示为四元组 $d = [T, X, Q, A]$,分别对应任务指令、图像序列、本体状态序列与动作序列;策略要建模的是 $\pi(\mathbf{a} \mid o, d)$,即以当前观测 $o$ 和整条演示 $d$ 为条件的动作分布。
条件流匹配。 作者用一条线性插值路径连接噪声与真实动作,即 $\mathbf{a}^s = (1-s)\,\epsilon + s\,\mathbf{a}$,其中 $s \in [0, 1]$ 是插值时间、$\epsilon$ 是标准高斯噪声。这条路径对应的条件速度场有闭式解,就是从加噪动作指向干净动作的直线位移。用神经网络 $u_\theta(\mathbf{a}^s, o, d, s)$ 去拟合它,训练目标就是让预测位移逼近真实位移的均方误差,即条件流匹配损失 $\mathcal{L}_{\text{CFM}}(\theta)$。推理时用前向 Euler 求解器从 0 积分到 1,十步之后得到长度为 50 的动作块。
双专家骨干。 模型遵循混合专家设计,分成两个专家:上下文专家负责编码当前观测与压缩后的演示 token,动作专家负责编码本体状态与加噪动作 token,并通过注意力读取上下文专家的输出。为了让同一份上下文能在十步流匹配里被复用,作者引入块状因果注意力——动作 token 可以看上下文 token,反过来不行。初始化上,动作专家与 SigLIP 视觉编码器从 π0 继承权重、用 rank 32 的 LoRA 微调,上下文专家随机初始化并全量训练,这样既复用了 VLA 的预训练先验,又把训练成本压了下来。
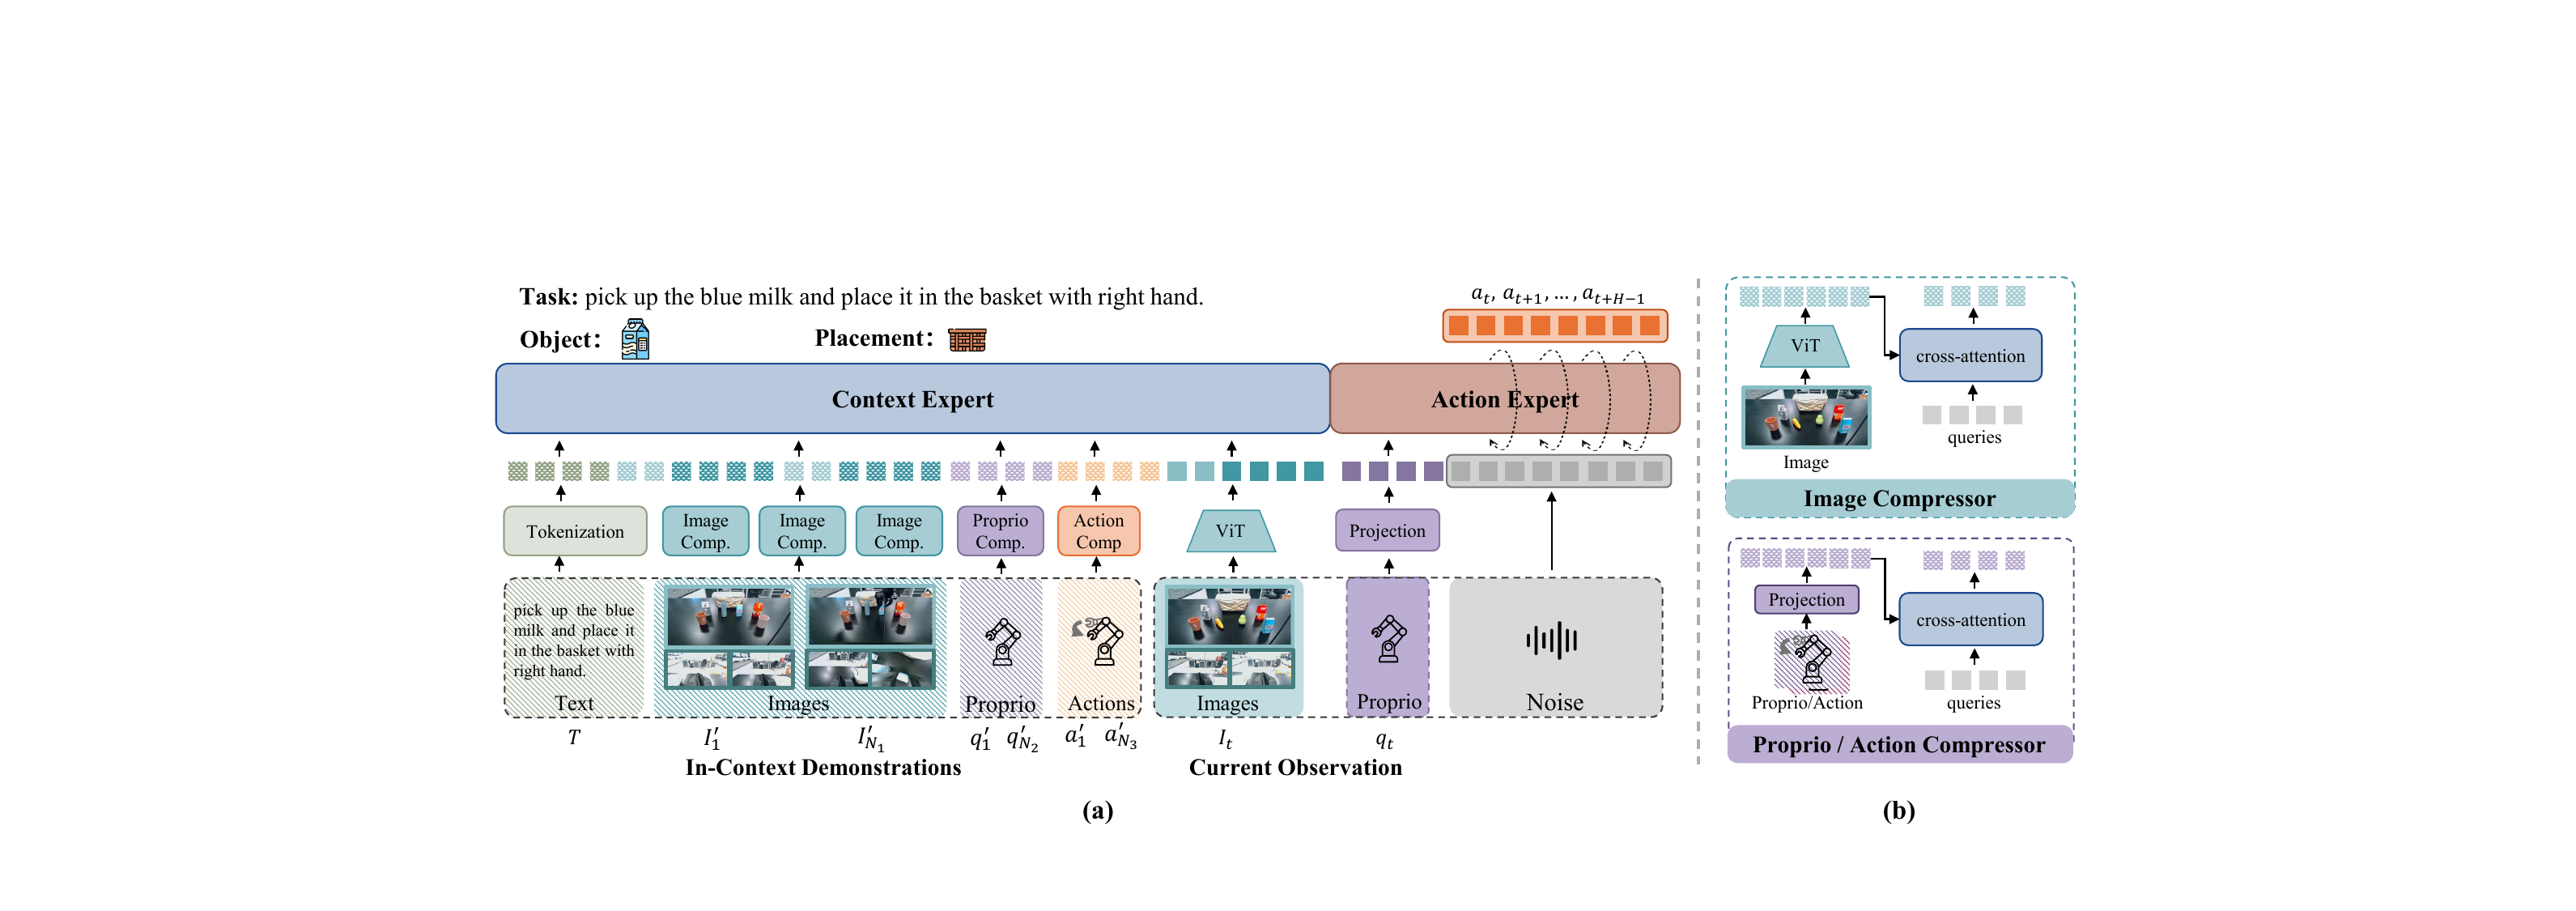
图 2:ContextFlow 模型架构。观测、文本指令与 in-context 演示先经过多模态上下文压缩器,压缩 token 送入上下文专家;当前本体状态与动作噪声送入动作专家,由动作专家执行流匹配步骤预测动作。
压缩器的模态分工。 视觉端用 SigLIP So400m/14 在 224×224 分辨率下编码,每路相机产生 256 个视觉 token;图像压缩器把多帧演示的视觉 token 一起压成 32 个 latent,权重跨相机共享。状态与动作各有独立压缩器,同样各产出 32 个 token,且彼此不共享权重。压缩器内部由若干层交替的 cross-attention 与 self-attention 组成:cross-attention 让可学习 query 去“读”输入序列,self-attention 让 query 之间交换信息,每层都带 pre-norm 与残差连接。
实验设计与结果:受控对照下范式替换值多少分
实验分仿真与真机两层。仿真在 LIBERO 上做,评测空间推理(LIBERO-Spatial)与物体操作(LIBERO-Object)两套任务,每套 10 个任务、500 条专家演示,训练时额外混入 LIBERO-Goal 与 LIBERO-10 增加数据多样性。真机部分作者自建了一个 ALOHA 数据集,含 1,318 条多模态轨迹、25 种任务配置,覆盖单臂抓放与需要高频闭环反馈的双臂精细任务。评测协议值得特别注意:每套任务固定划出 8 个已见任务与 2 个未见配置,每个任务跑 50 次试验取平均成功率。
| 任务配置 | ICRT(自回归) | ContextAR(自回归⁺) | CF-Plain(流匹配) | ContextFlow |
|---|---|---|---|---|
| Spatial S₁ | 54.0 | 94.0 | 90.0 | 86.0 |
| Spatial S₂ | 0.0 | 12.0 | 20.0 | 42.0 |
| Object O₁ | 4.0 | 16.0 | 92.0 | 76.0 |
| Object O₂ | 96.0 | 92.0 | 54.0 | 90.0 |
| 平均 | 38.5 | 53.5 | 64.0 | 73.5 |
这张表里最关键的不是最后一行,而是 ContextAR 与 ContextFlow-Plain 这一对。两者使用同一个视觉骨干、同样从 π0 初始化,唯一差别就是自回归还是流匹配;在如此受控的条件下,流匹配版本高出 10.5 个百分点,说明增益确实来自解码范式的替换。这也解释了为什么作者要把 ContextAR 单独搭出来——它是把“范式”这个变量从架构选择里隔离出来的诊断工具。相比之下,ICRT 作为外部自回归基线平均只有 38.5%,完整的 ContextFlow 比它高出 35 个百分点。
真机结果的方向是一致的。在 ALOHA 的未见任务配置上,ContextFlow 平均成功率 41.7%,π0 为 26.7%,ICRT 只有 3.3%。其中开笔帽这个新配置达到 40%(4/10),而 ICRT 在精细双臂任务上全部失败——作者把原因归到 ICRT 的状态 token 设计上:视觉 latent 与本体 latent 被注意力池化成单个 token,定位所需的空间细节在池化里被丢掉了。
| 模型 | 训练(A100 小时) | 推理吞吐(Hz) |
|---|---|---|
| OpenVLA-OFT | 30 | 77.8 |
| π0 | 21 | 569.0 |
| ICRT | 16 | 44.3 |
| ContextAR | 65 | 3.7 |
| CF-Plain | 21 | 310.2 |
| ContextFlow | 40 | 130.6 |
效率上的对比同样值得看:自回归基线 ContextAR 的推理只有 3.7 Hz,因为它必须逐 token 生成动作;ContextFlow 达到 130.6 Hz,快了 35 倍。对真机闭环控制来说,这是量级层面的差别。训练成本方面 ContextFlow 需要 40 A100 小时,高于 π0 的 21 小时,但低于 ContextAR 的 65 小时。
消融实验回答了“每个部件到底贡献多少”。上下文压缩器方面,只开图像压缩器把平均成功率从 64.0 提到 68.0,图像与状态/动作压缩器全开则到 73.5。模态消融更能说明结构:去掉本体状态与动作后平均只剩 29.0(损失 44.5 个百分点),去掉图像剩 45.0(损失 28.5 个百分点),去掉文本剩 64.5(损失 9.0 个百分点)——三个模态都有贡献,但影响量级差别很大,本体状态与动作是最关键的。演示长度上,图像从 4 帧增加到 8 帧提升 3.0 个百分点,状态与动作数以 128 为最优,加到 256 反而降到 66.5。动作头对比最有说服力:MLP L1 直接回归能到 58.0,扩散跑 100k 步只有 33.5,而流匹配 20k 步就达到 73.5,收敛速度与上限同时更好。
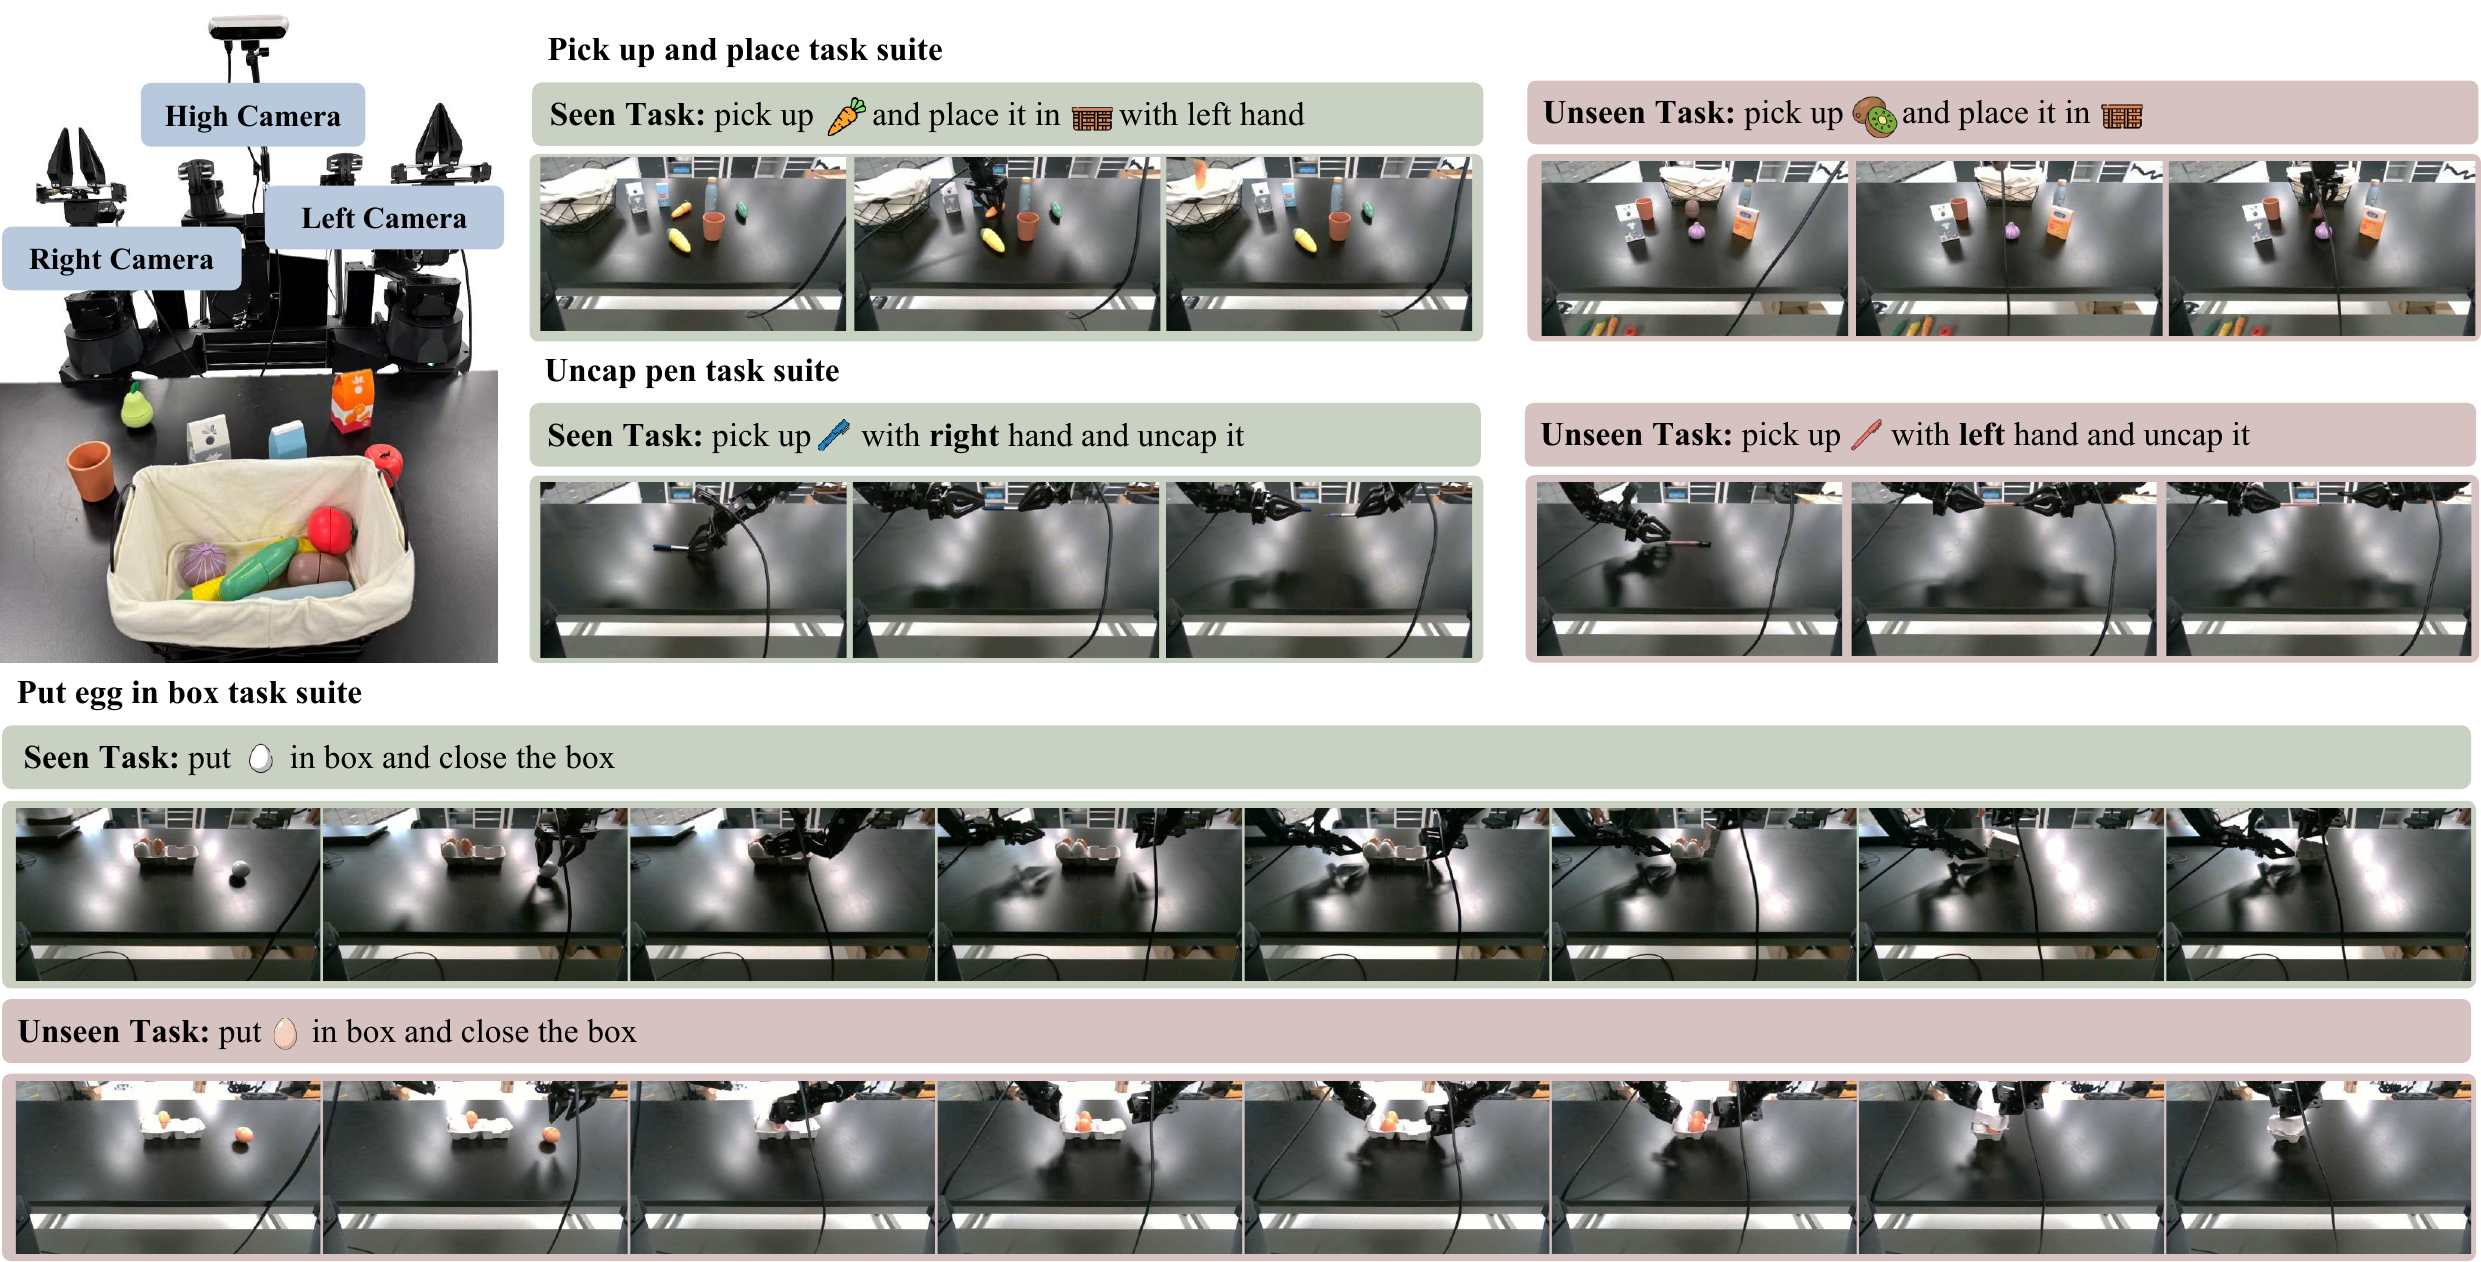
图 3:真机 in-context 实验设置(ALOHA 平台)。三套任务族,每族含多种在操作物体或左右手运动上不同的任务配置。
真机数据集的具体构成是这样的:抓放任务有 14 种已见配置、527 条轨迹,平均长度 235 步,未见配置是左手的梨与橙汁、右手的猕猴桃与香蕉;开笔帽任务有 6 种已见配置、338 条轨迹,平均长度 543 步,未见配置是左手的红笔;放鸡蛋任务只有 1 种已见配置,但轨迹长达 735 步,未见配置是红鸡蛋;另有 4 种仅用于训练的双臂任务(handover、cup stack、stir、water wipe),共 254 条。所有任务都用统一的指令模板加物体名与左右手填空,篮子位置决定用哪只手执行。
失败模式分析给出了更有解释力的细节。失败被归为三类:抓取阶段的误识别、抓取阶段的夹爪失败,以及放置阶段失败。ICRT 的失败集中在第一阶段,而且表现为“接近但没有碰到”目标物;ContextFlow 的失败更均匀地分布在三个阶段。抓取位置分析补充了一个结构性解释:演示的抓取位置在水平面上呈两个明显空间簇,未见的番茄酱物体高度接近训练均值,而未见的牛奶显著高于训练均值——这正是物体操作套件里两个未见配置成功率不对称的原因。
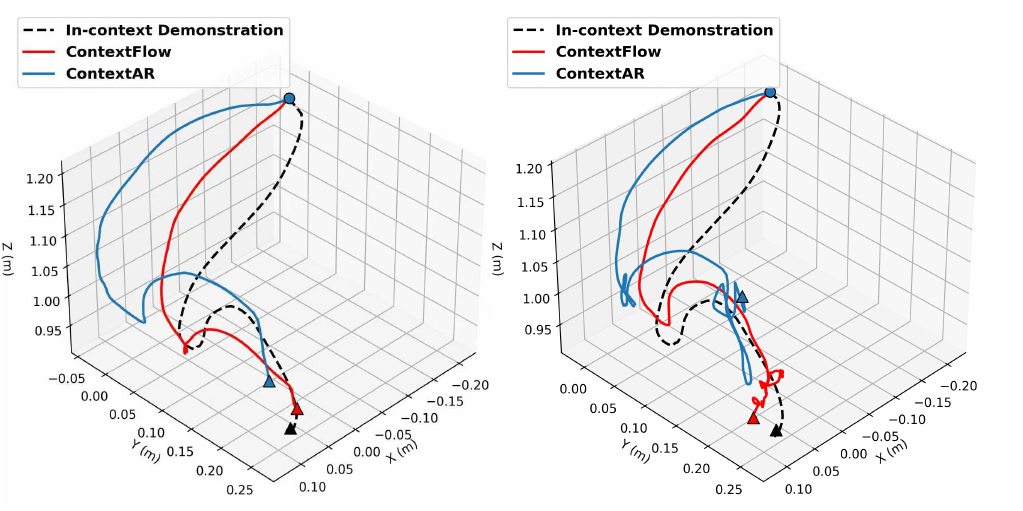
图 4:左为 in-context 演示与 ContextFlow / ContextAR 的成功轨迹,右为失败轨迹。
扩展训练数据的实验回答了一个自然的问题:把数据加多能不能救回难任务?作者把 LIBERO-90 并入训练集,并在 LIBERO-Goal 与 LIBERO-10 上各取两个未见任务评测,总平均从 36.8 提升到 43.0,首次让 Goal 与长时程套件上的未见任务拿到非零分(29.0 与 3.0)。这说明当前方法的泛化上限确实与数据覆盖强相关,而不是纯粹的架构问题。
结果对比总结
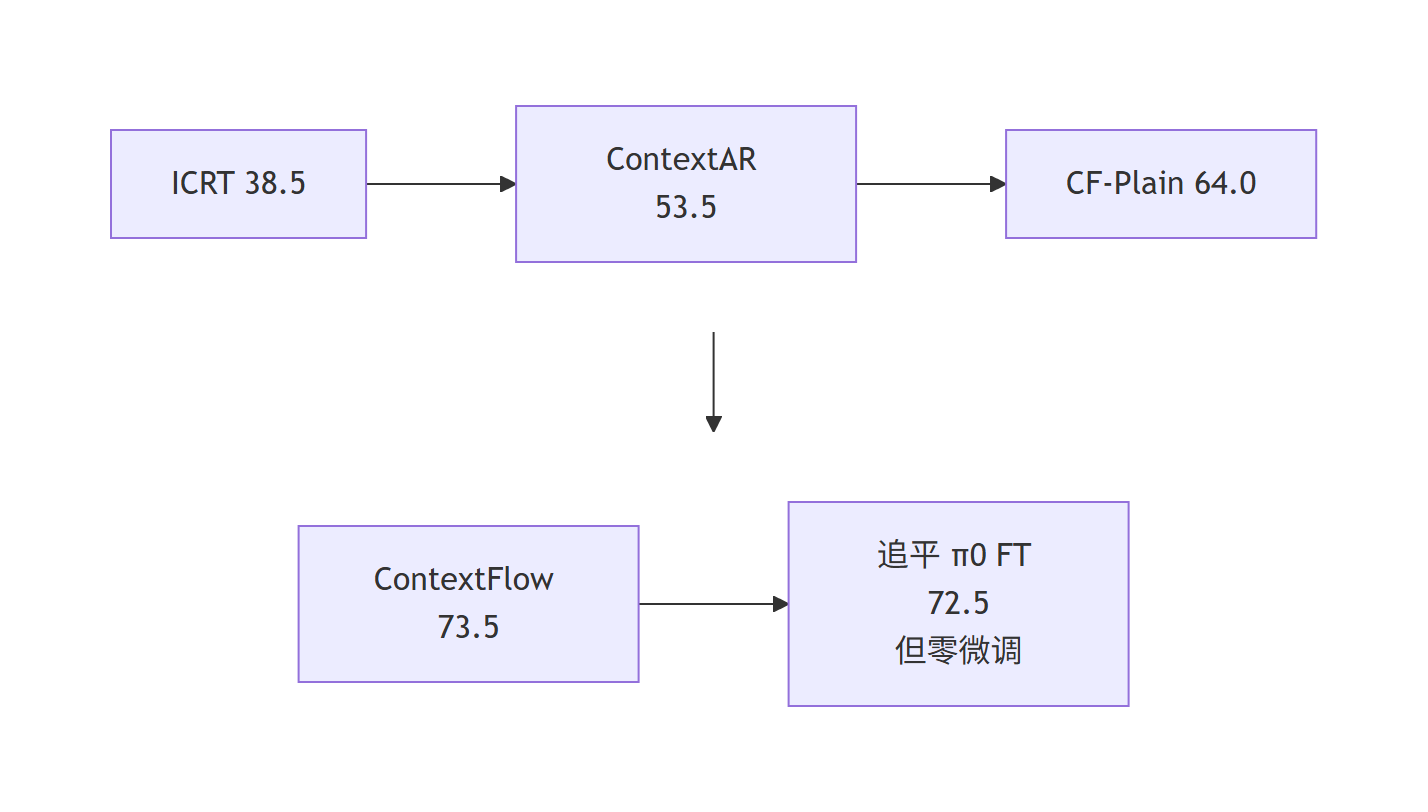
图 7:LIBERO 未见配置平均成功率对比链路(Mermaid 流程图),数值为成功率百分比。
关键发现
- 范式替换本身就是增益来源。 在同视觉骨干、同 π0 初始化的受控对照下,流匹配版本(CF-Plain 64.0)比自回归版本(ContextAR 53.5)高出 10.5 个百分点,这是全文最干净的一条因果证据。
- 复合误差被直接量化了。 累积 MSE 从 ContextAR 的 4.7 降到 CF-Plain 的 3.0、再到完整模型 ContextFlow 的 2.2,误差下降与成功率提升方向一致,不是间接推断。
- 零微调追平微调。 LIBERO 未见配置平均 73.5% 对比 1-shot 微调 π0 的 72.5%,前者不需要在未见任务上做任何参数更新,适配速度与遗忘风险都更优。
- 压缩比扩大 token 更有效。 只开图像压缩器即从 64.0 提到 68.0;而单纯增加图像 token 数反而掉点,说明选择性压缩比获取更多原始信息更重要。
- 模态贡献严重不均衡。 去掉本体状态与动作损失 44.5 个百分点,去掉图像损失 28.5 个百分点,去掉文本只损失 9.0 个百分点——文本影响最小,但去掉后零样本能力消失。
- 真机与仿真结论一致。 ALOHA 未见配置上 ContextFlow 平均 41.7%、π0 26.7%、ICRT 3.3%;开笔帽新配置达 40%(4/10),而 ICRT 的精细双臂任务全部失败。
从创新模式的角度看,这篇文章同时命中三条高频模式:“通过条件化适配而非重训练”(用演示条件替代参数更新,并用 1-shot 微调基线做严格对比)、“替换算子或表示”(把自回归离散解码器换成流匹配连续解码器)、“统一异构输入到同一空间”(图像、状态、动作经压缩器统一到定长 latent)。它最有说服力的地方不在于提出了新模块,而在于把混杂变量隔离掉,让“流匹配本身有用”从主张变成了测量事实。
局限性
- 泛化范围有限。 作者明确声明,本文的泛化主要限于未见物体与未见空间布局,也就是相关原语内部的未见配置,而非任意新任务。LIBERO-Goal 与 Long-10 的未见任务即使加入 LIBERO-90 训练也只有 29.0 与 3.0 分。
- 演示仍是重型条件。 单个任务的演示可达 800 步、含多路相机,压缩之后仍占用 128 至 160 个上下文 token,推理吞吐 130.6 Hz 低于 π0 的 569.0 Hz。
- 训练成本高于纯自回归方案。 ContextFlow 需要 40 A100 小时,π0 是 21 小时;流匹配的多步采样在推理与训练两端都有额外算力开销。
- 真机规模仍小。 25 种配置、每任务 10 次试验,成功率天花板为 6/10,统计置信度有限,且未覆盖高精度接触类任务。
- 作者展望。 自回归头(π0-FAST 路线)训练更快、目标更简单,流匹配头泛化更好;作者指出混合动作头是一个有前景的方向,这也是本文留给后续工作的开口。
常见问题(FAQ)
ContextFlow 和 π0 是什么关系?
ContextFlow 站在 π0 的肩膀上:动作专家与 SigLIP 视觉编码器都从 π0 继承权重,用 rank 32 的 LoRA 微调,上下文专家则随机初始化并全量训练。区别在于 π0 是任务特定微调的 VLA,而 ContextFlow 把演示当作上下文条件,靠 in-context 学习完成适配,不在未见任务上更新任何参数。
为什么一定要用流匹配,用扩散或者直接回归不行吗?
作者做了动作头对比:MLP L1 直接回归平均 58.0,扩散跑 100k 步只有 33.5,流匹配 20k 步就达到 73.5。扩散在同样的训练预算下收敛明显更慢,而直接回归虽然简单有效,但上限偏低。流匹配在收敛速度与最终精度上同时占优,这是它被选为默认动作头的原因。
上下文压缩器到底压掉了什么?
它压掉的是空间与时间上的冗余。原始演示里图像、状态、动作都是长序列,且相邻帧高度相似;压缩器用 32 个可学习 query 通过交替的 cross-attention 与 self-attention 把每个模态提炼成定长 latent。消融显示只加图像压缩器就能把平均成功率从 64.0 提到 68.0,说明被压掉的主要是冗余而不是信息。
这个方法在真机上表现如何?
在 ALOHA 平台的未见任务配置上,ContextFlow 平均成功率 41.7%,π0 为 26.7%,ICRT 只有 3.3%。单臂抓放与双臂精细任务上它都能工作,开笔帽这个新配置达到 40%(4/10),而 ICRT 在需要高频闭环反馈的精细双臂任务上全部失败。
复现这篇文章需要什么资源?
按作者报告,训练 ContextFlow 需要约 40 个 A100 GPU 小时,推理吞吐 130.6 Hz;动作块长度 50,流匹配积分 10 步,训练 20K 迭代、批大小 32,动作专家用 rank 32、α 为 32 的 LoRA 微调。数据集方面,仿真用公开的 LIBERO,真机的 1,318 条 ALOHA 轨迹由作者自建。
这篇文章在写作上有什么值得注意的地方?
它的叙事弧线很清晰:开场用自回归与流匹配的对比立题,中段用受控归因建立可信度(强调两个模型使用同一视觉骨干、同一 π0 初始化),结尾用 35 个百分点的提升与追平微调模型的结果收束。证据框架做得很好,结论句基本都带数字前置。需要注意的是对冲表达残留较多,例如摘要与结论中反复出现“suggest that”“appears beneficial”“mainly limited to”,在削弱自身声明;另外源文件中还留有投稿模板的待办注释与投稿编号未清理。
参考链接
- 论文 arXiv 页:arXiv:2609.06852
- 项目主页(含真机 rollout 视频):dingjiansw101.github.io/contextflow-page
- ICRT: In-Context Imitation Learning via Next-Token Prediction:arXiv:2408.15980
- π0: A Vision-Language-Action Flow Model for General Robot Control:arXiv:2410.24164
- OpenVLA-OFT: Fine-Tuning Vision-Language-Action Models:arXiv:2502.19645
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献68条内容

所有评论(0)