OmniBot-System多任务机器人:任务调度器路由设计与Jetson Thor端侧部署实践
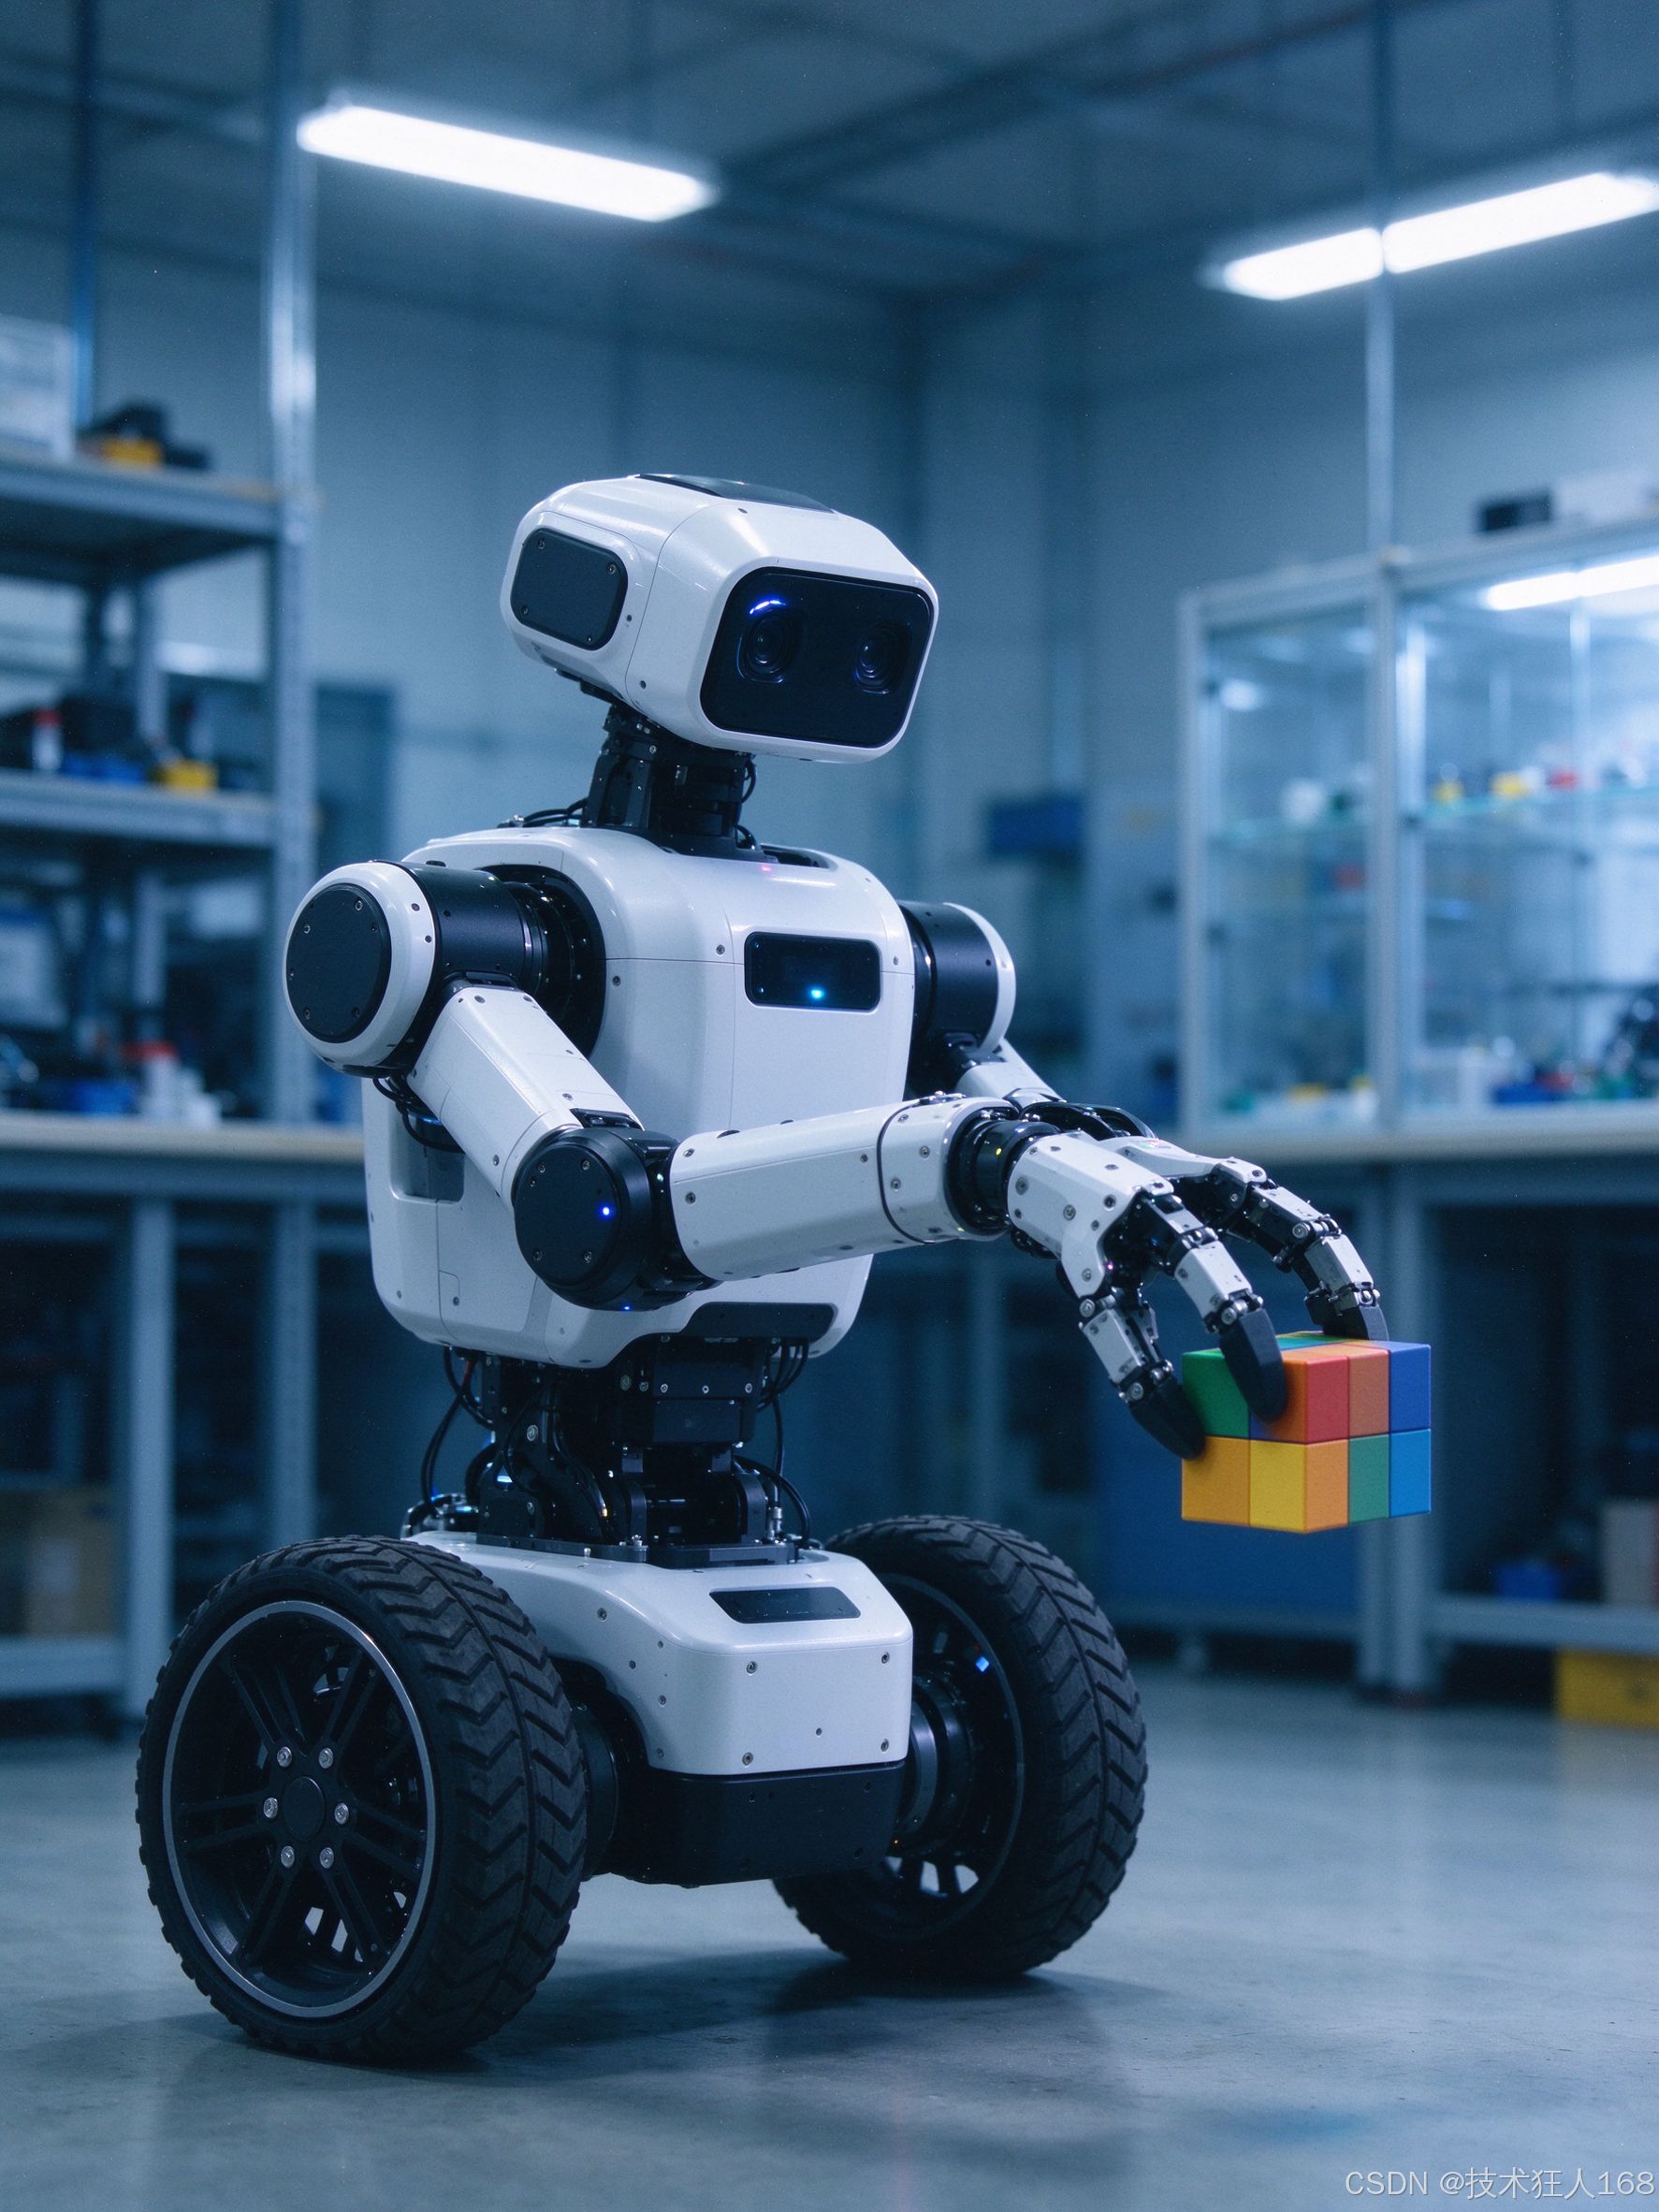
最近把OmniBot-System这个多任务机器人系统从训练到端侧部署完整跑了一遍,把过程中的关键设计和代码片段记录下来。这个系统的核心思路是用一个任务调度器把Manip(操作)、Nav(导航)、World(世界模型)三个子模型路由起来,而不是三个独立机器人硬拼。下面按模块拆开讲。
1. 整体架构与任务调度器
系统入口是自然语言指令,调度器根据指令语义判断走哪个子模型。我们没有用大模型做意图识别(延迟扛不住),而是用了一个轻量分类器+规则引擎混合方案。分类器输出三个子模型的概率分布,置信度高的直接路由,置信度低的走规则兜底。平均路由延迟压在30ms左右,最坏不到50ms。
调度器路由逻辑核心代码:
# task_scheduler.py
import re
from typing import Literal
from lightweight_intent_classifier import IntentClassifier

class TaskScheduler:
    def __init__(self):
        self.clf = IntentClassifier(model_path="scheduler_intent_clf.pt")
        # 规则引擎兜底:识别指令中的导航/操作关键词
        self.nav_kw = re.compile(r"(走|去|到|导航|移动|前进|穿过)")
        self.manip_kw = re.compile(r"(拿|抓|取|放|推|拉|开|关)")
        self.world_kw = re.compile(r"(如果|假设|万一|想象|会不会)")

    def route(self, instruction: str) -> str:
        prob = self.clf.predict_proba(instruction)
        # 置信度高直接走分类结果
        if prob.max() > 0.85:
            return prob.argmax()
        # 置信度低走规则多标签路由
        labels = []
        if self.nav_kw.search(instruction):
            labels.append("nav")
        if self.manip_kw.search(instruction):
            labels.append("manip")
        if self.world_kw.search(instruction):
            labels.append("world")
        if not labels:
            return "manip"  # 默认兜底
        return labels  # 多标签返回列表,由执行器串起来
这个设计的关键权衡是:纯分类器在模糊指令下会路由错,纯规则又覆盖不了长尾,混着用是实测下来最稳的。
2. Nav导航子模型加载
Nav子系统有2B/4B/8B三个尺寸,训练样本15.6M条。端侧部署时根据Jetson Thor的可用内存动态选择尺寸。模型加载这块要注意:PyTorch版本直接加载在Jetson Thor上帧率不到1Hz,必须转TensorRT。
模型加载代码:
# nav_model.py
import torch
import tensorrt as trt
from torch2trt import torch2trt

class NavPolicy:
    def __init__(self, size: str = "4B", device="jetson_thor"):
        self.size = size
        self.device = device
        self.model = self._load_raw(size)
        # 端侧部署:动态量化 + TensorRT转换
        if device == "jetson_thor":
            self.model = self._quantize(self.model)
            self.model = self._to_tensorrt(self.model)
        self.model.eval()

    def _load_raw(self, size: str):
        # 2B/4B/8B三个尺寸对应不同配置
        from nav_policy_config import CONFIGS
        cfg = CONFIGS[size]
        model = build_nav_model(cfg)
        ckpt = torch.load(f"checkpoints/nav_{size}.pt", map_location="cpu")
        model.load_state_dict(ckpt)
        return model

    def _quantize(self, model):
        # INT8动态量化,calibration用15.6M样本中抽的1000条
        model = torch.quantization.quantize_dynamic(
            model, {torch.nn.Linear}, dtype=torch.qint8
        )
        return model

    def _to_tensorrt(self, model):
        # 输入是[1, 3, 224, 224]的环视图 + 指令token
        dummy_img = torch.randn(1, 3, 224, 224).cuda()
        dummy_txt = torch.randint(0, 1000, (1, 32)).cuda()
        model_trt = torch2trt(
            model, [dummy_img, dummy_txt],
            fp16_mode=True, max_batch_size=1
        )
        return model_trt
实测在Jetson Thor上端侧推理跑到5.1Hz。一开始直接转TensorRT精度掉了2个点,排查后发现是某些LayerNorm算子的calibration没覆盖到,重新标定后精度拉回来了。
3. World世界模型数据增强管线
World子系统支持三场景视频生成,我们把生成的2000条增强数据注入到导航策略训练里,导航策略实测提升6%。关键不是生成多少,而是挑难例。
数据增强管线代码:
# world_aug_pipeline.py
import torch
from video_world_model import WorldVideoGenerator

class WorldAugPipeline:
    def __init__(self):
        self.gen = WorldVideoGenerator(
            scenes=["corridor", "lab", "warehouse"],  # 三场景
            ckpt="world_model_3scene.pt"
        )
        self.difficulty_filter = DifficultyFilter()  # 难例过滤器

    def generate_aug_data(self, base_nav_dataset, n_target=2000):
        aug_samples = []
        # 1. 对现有导航失败case做针对性生成
        fail_cases = base_nav_dataset.get_failure_cases()
        for case in fail_cases:
            videos = self.gen.generate(
                scene=case.scene,
                prompt=f"如果在{case.location}出现{case.obstacle}, "
                       f"机器人视角的导航画面",
                n=4  # 每个失败case生成4条候选
            )
            # 2. 用难例过滤器挑最有信息量的
            for v in videos:
                score = self.difficulty_filter.score(v, case)
                aug_samples.append((v, case, score))
        # 3. 按分数排序取top N
        aug_samples.sort(key=lambda x: -x[2])
        selected = aug_samples[:n_target]
        # 4. 时序一致性后处理(解决画面闪烁)
        selected = [self._temporal_smooth(v) for v, _, _ in selected]
        return selected

    def _temporal_smooth(self, video):
        # 简单的光流一致性平滑,避免画面闪烁导致策略抖动
        ...
这里最关键的发现是:随机生成的视频对导航策略提升几乎为零,必须针对失败case生成难例。2000条是精挑细选的结果,不是随机堆量。
4. Manip推理接口
Manip子系统用38100小时操作数据训练,零样本指令跟随在LIBERO上跑到99.1%。推理接口设计要注意action chunk的输出方式——不是单步输出,而是输出未来一段动作序列,降低控制频率。
Manip推理接口代码:
# manip_inference.py
import torch
from manip_vla import ManipVLA

class ManipInference:
    def __init__(self):
        self.model = ManipVLA(
            action_dim=7,
            chunk_size=16,  # 一次输出16步动作
            ckpt="manip_38100h.pt"
        )
        self.model.eval()
        self.kv_cache = None  # streaming KV cache

    @torch.no_grad()
    def step(self, obs_image, instruction, t=0):
        # 零样本指令跟随:instruction直接是自然语言,无需任务特定适配
        obs = self._preprocess(obs_image)
        txt = self.model.tokenize(instruction)
        # streaming KV cache:只在chunk边界重新计算KV
        if self.kv_cache is None or t % 16 == 0:
            actions, self.kv_cache = self.model(obs, txt, use_cache=True)
        else:
            actions, self.kv_cache = self.model(
                obs, txt, use_cache=True, past_key_values=self.kv_cache
            )
        return actions[t % 16]  # 取当前步对应的动作

    def _preprocess(self, img):
        # DINOv3视觉token + SigLIP文本token拼接
        ...
LIBERO 99.1%这个分数是在零样本setting下跑的,训练时没见过LIBERO里的任务指令。这里踩过的坑是:一开始我们把数据配比做得太偏单一物体,结果零样本分数掉了,后来重新平衡不同物体/姿态/光照的组合才拉回来。
5. Jetson Thor端侧部署配置
端侧部署的完整配置:
# jetson_thor_deploy.sh
# Jetson Thor 端侧部署配置
# 系统:JetPack 6.1, CUDA 12.2, TensorRT 10.x

# 1. 开启MAXN功率模式(最高性能)
sudo nvpmodel -m 0
sudo jetson_clocks

# 2. 设置CUDA缓存
export CUDA_CACHE_MAXSIZE=2147483648
export CUDA_CACHE_PATH=/home/nvidia/cuda_cache

# 3. Nav模型选4B尺寸(端侧甜点)
export NAV_MODEL_SIZE=4B

# 4. 调度器进程优先级拉高
sudo chrt -f -p 80 $(pgrep -f task_scheduler.py)

# 5. 启动三个子模型服务
python manip_server.py --port 9001 &
python nav_server.py --port 9002 --size 4B &
python scheduler_server.py --port 9000

# 6. 实测延迟分解(单位ms)
# 调度器路由:    ~30
# Nav推理(5.1Hz): ~196 (每帧)
# Manip推理:      ~100 (action chunk摊销)
# World:         离线,不进在线循环
实测端侧帧率:Nav 5.1Hz,Manip约10Hz(action chunk摊销后),调度器路由<50ms。整个系统从指令进入到动作输出的端到端延迟主要受Nav推理限制。
小结
OmniBot-System这套系统的核心不是三个子模型本身多强,而是任务调度器怎么把三者路由起来、怎么在端侧算力约束下把帧率跑起来。38100小时操作数据、15.6M导航样本、2000条世界模型增强数据,这些数字背后是大量的数据配比和消融实验。从LIBERO 99.1%、Jetson Thor 5.1Hz、导航策略+6%、路由<50ms这几个指标来看,多任务统一系统在端侧是可落地的。
完整的训练笔记、延迟分解表、踩坑记录和面试应答要点都整理成文档资料了,做具身智能方向的朋友可以交流。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)