打开浏览器,国宝开口说话 - 宝蕴如何用端到端具身交互智能重塑博物馆导览
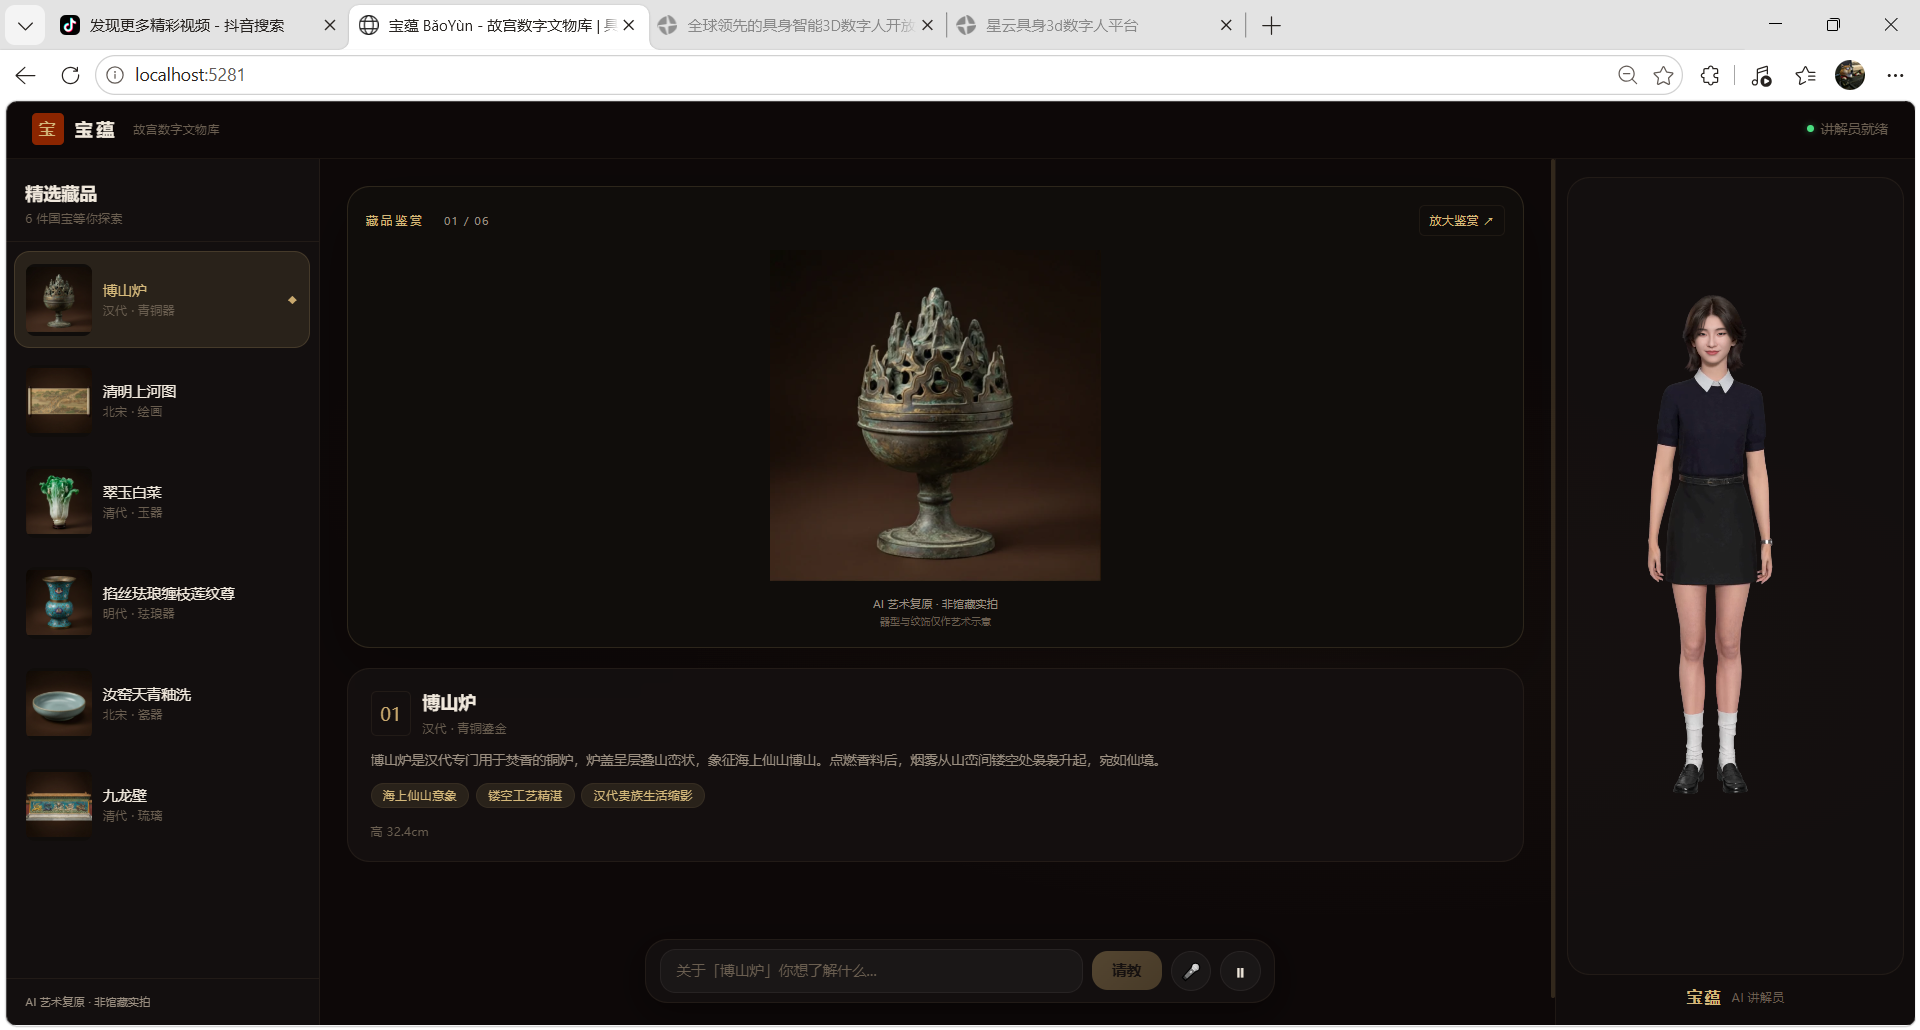
走进一座博物馆,停在一件青铜器前,你还没来得及扫码、查资料,一位温文尔雅的讲解员已经站在身旁,微笑着开口:"这件博山炉,炉盖象征海上仙山,点燃香料后烟雾从山峦间袅袅升起,宛如仙境。“你好奇追问一句"那汉代贵族一般用什么香料?”,讲解员不假思索地接上了话题。
这不是请了一位真人讲解员。屏幕上的这位"宝蕴",是由端到端具身交互智能驱动的具身交互智能体——她能看、能听、能想、能说,还能配合讲解内容自然地做出表情和手势。
本文以宝蕴·故宫数字文物库为实战样本,拆解一个文博交互应用如何基于魔珐星云端到端具身交互智能平台,用一个 SDK 把感知、大脑、表达全链路打通,让六件国宝级文物在浏览器里"开口说话"。
序厅:为什么文物讲解是端到端具身交互智能的绝佳舞台?
博物馆语音导览器用了几十年,体验却始终停留在"按编号、听录音"。即便是手机上的 AI 导览,本质也是"你打字问,它打字答"——交互是断裂的。
真实的讲解不是这样。
一位好的讲解员在你观赏文物的同时,一直在观察你的表情、判断你的兴趣点、决定要不要展开一个故事、在你走神前用一个悬念把你拉回来。这种持续感知 → 持续理解 → 持续决策 → 持续表达与行动的闭环,正是魔珐星云提出的端到端具身交互智能要解决的核心问题。
宝蕴要做的,就是把这种能力搬进一个 Web 端的数字文物库里——观众打开浏览器,面对的不是一段冰冷的文字介绍,而是一位有温度、有学识、能实时互动的 AI 讲解员。
前厅:一个 SDK 撑起一座博物馆
传统文博导览的拼接困境
如果按传统思路搭建一个"AI 讲解员",至少要对接三套服务:
- 语音识别(ASR)接一家
- 大模型推理(LLM)接一家
- 语音合成 + 形象驱动(TTS + Avatar)再接一家
三套服务各自工作,中间需要自己写胶水层做状态同步、流式分片、SSML 拼接。代码量 2000+ 行起步,首字响应 1.5 到 3 秒,观众提问后对着屏幕干等。更要命的是——讲解员说到一半观众想打断?做不到,因为 ASR 和 TTS 的状态是割裂的。
这就是典型的"不是端到端"。
端到端方案:一行 agent.ask() 打通全链路
宝蕴基于魔珐星云端到端 SDK XingyunAvatarAgent 构建,核心业务代码不到 400 行。整个前端对接只需要三步:提供一个 DOM 容器、注册一组回调、调用 agent.ask() 发送消息。
// src/services/avatar.ts — 连接具身交互智能体(真实代码)
const agent = new window.XingyunAvatarAgent({
  container: containerEl,
  appId,
  appSecret,
  gatewayServer: SDK_CONFIG.GATEWAY_URL,
  onMessage(error: any) {
    console.error('[E2E SDK] 渲染错误:', error.code, error.message)
  },
  agentCallbacks: { /* 感知/对话/错误回调,详见主展厅章节 */ },
})

// 初始化:一次性建立感知、大脑、表达三条通道
await agent.init({
  onDownloadProgress(progress: number) {
    console.log(`[E2E SDK] 资源下载进度: ${progress.toFixed(0)}%`)
  },
})
端到端具身交互智能和模块拼接的本质区别:感知、理解、决策、表达不再是前后两个独立阶段,而是在同一次交互中持续并行运行。讲解员一边说,一边听观众有没有插话,一边判断接下来该怎么回应。
这些回调具体做了什么?下面的主展厅逐一拆解。
备展间:在魔珐星云控制台配置一位 AI 讲解员
宝蕴的具身交互智能体并不是从零搭建的,它的能力底座来自魔珐星云控制台的完整配置体系。这里用截图还原一下实际配置过程。
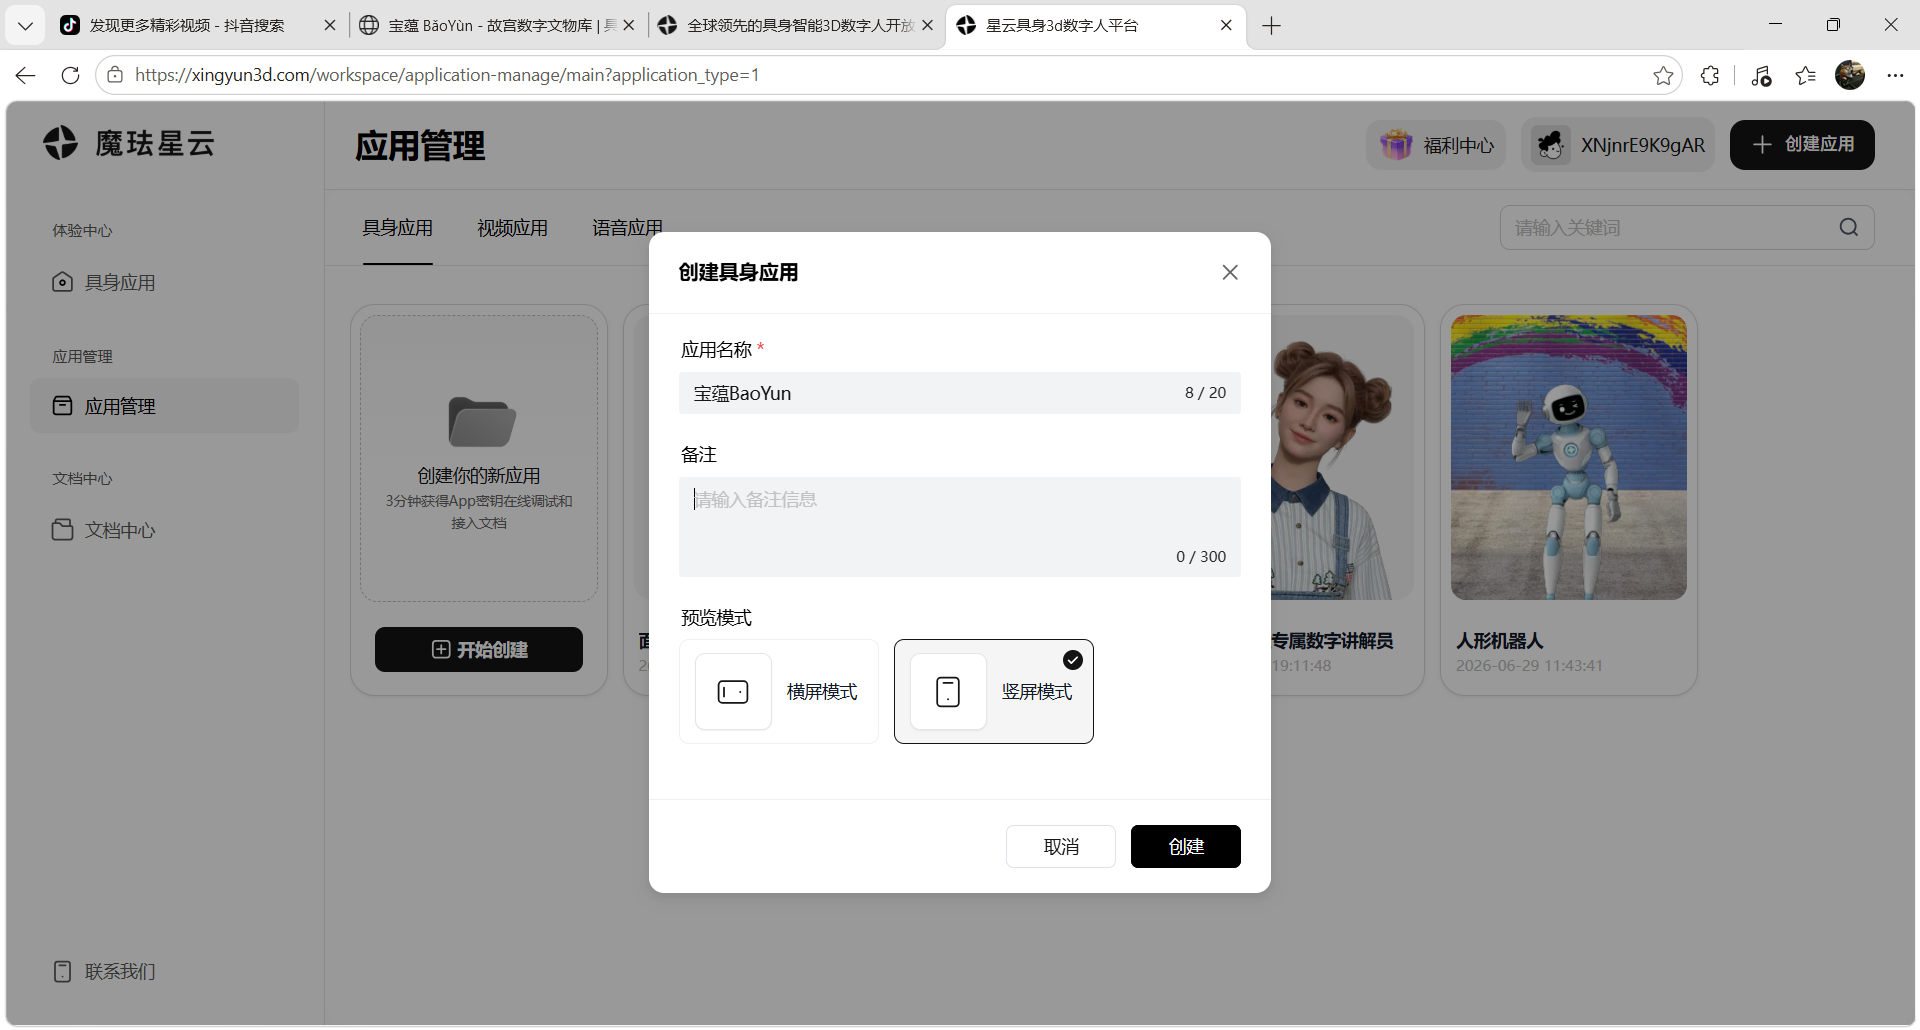
1. 创建具身交互智能体应用
魔珐星云控制台创建一个新应用,系统会自动分配 App ID 和 App Secret,这就是后续 SDK 连接所需的身份凭证。
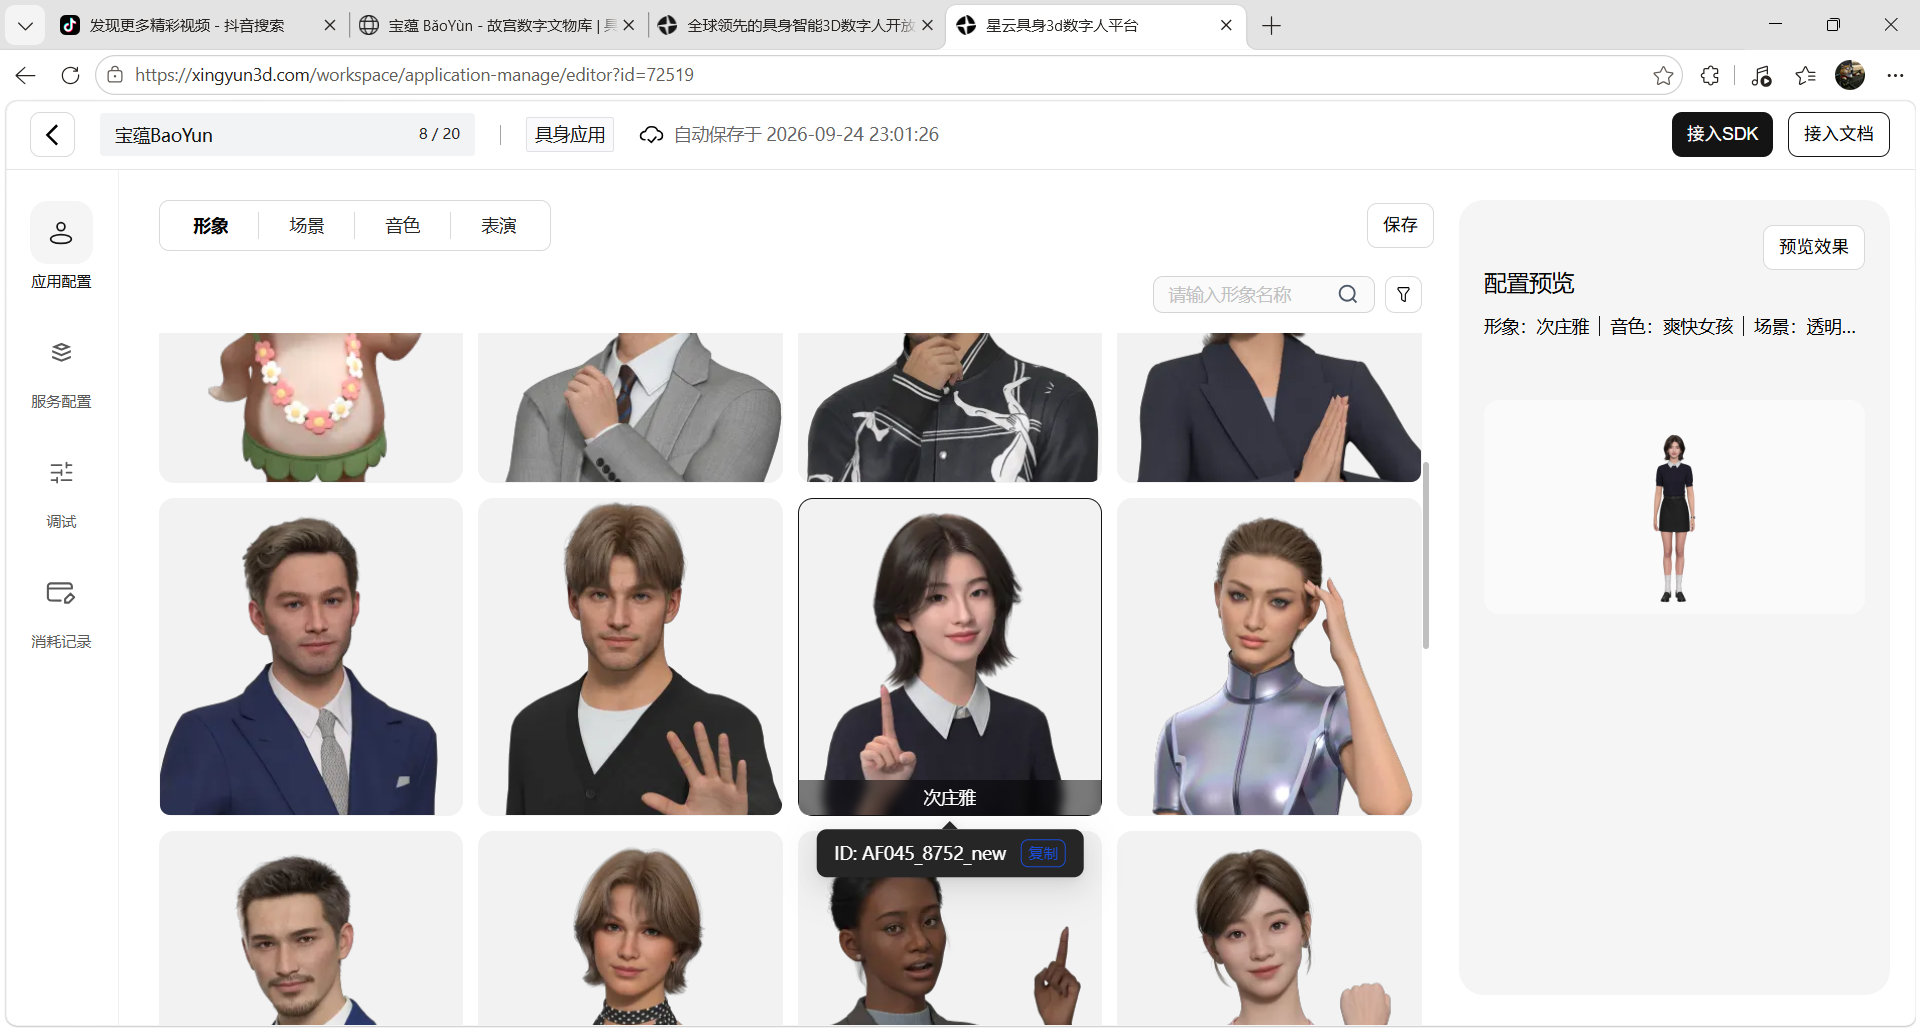
2. 形象配置
选择智能体的外在形象——宝蕴需要的是一位温文尔雅、学识渊博的故宫讲解员。平台提供多种形象可选,也可以自定义。
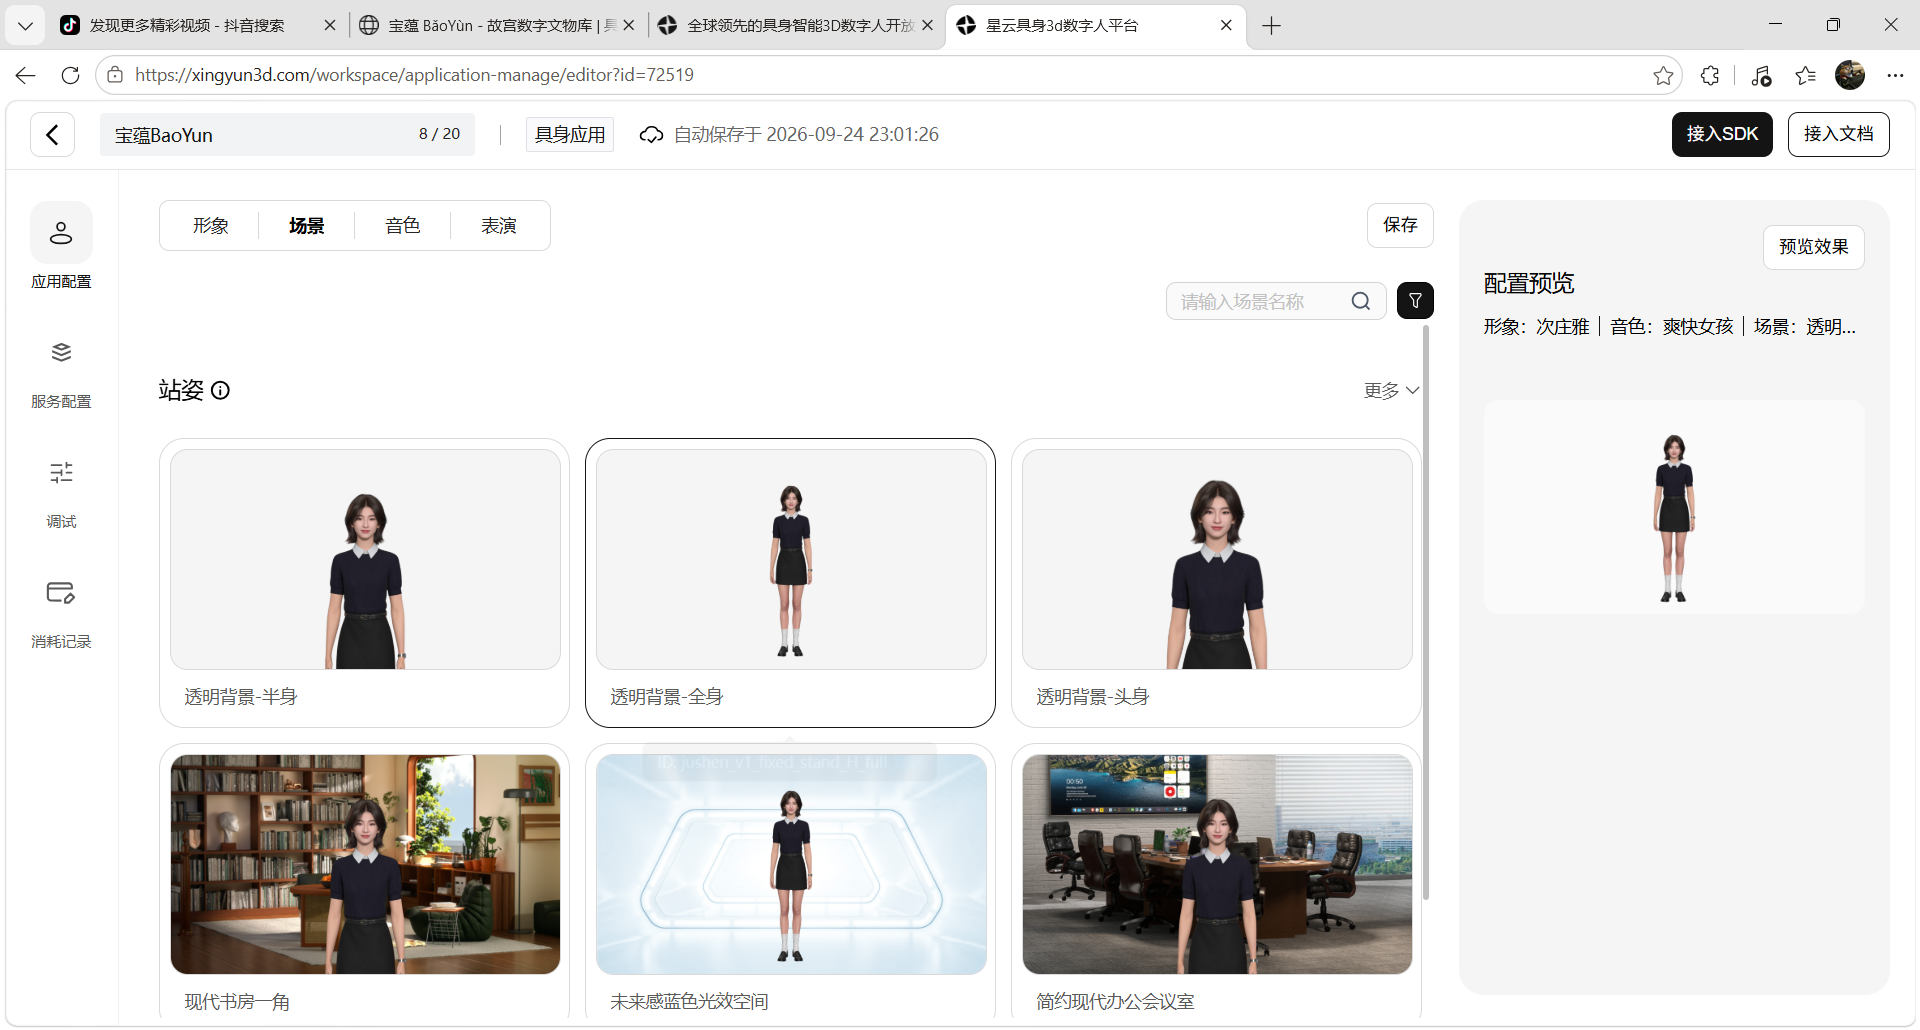
3. 场景配置
为智能体设定交互场景的背景环境。宝蕴采用的是宫墙金朱风格的展厅背景,和前端 UI 的墨黑古金朱红主题保持一致。
4. 音色配置
选择智能体的语音风格。讲解员需要的是温和沉稳、语速适中的音色,魔珐星云自研 TTS 支持多语言多风格。
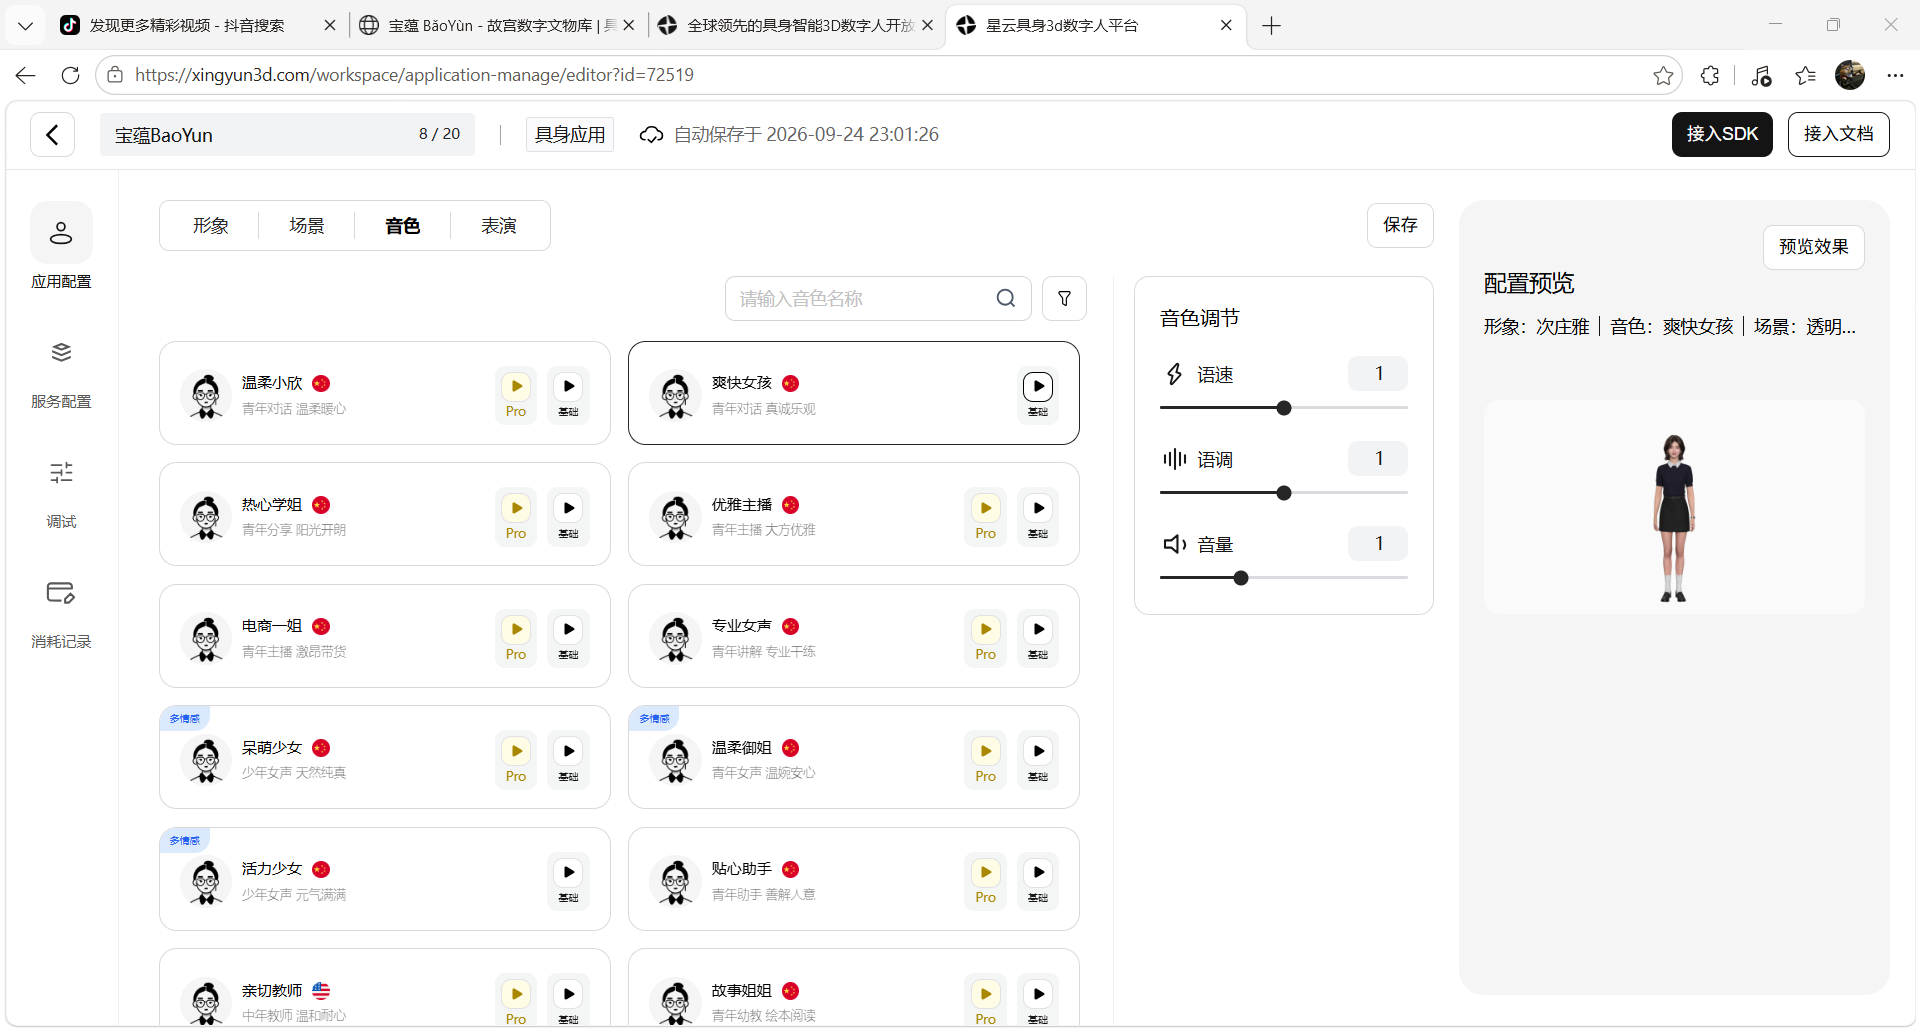
5. 表演配置
配置智能体的肢体语言和表情系统——这正是多模态表达的核心。不是简单的口型同步,而是语气、表情、手势、头部动作和身体动作的统一生成。讲解员在讲述汝窑釉色时语气温柔、在介绍九龙壁气势时手势开阔,都来自这一层的配置。
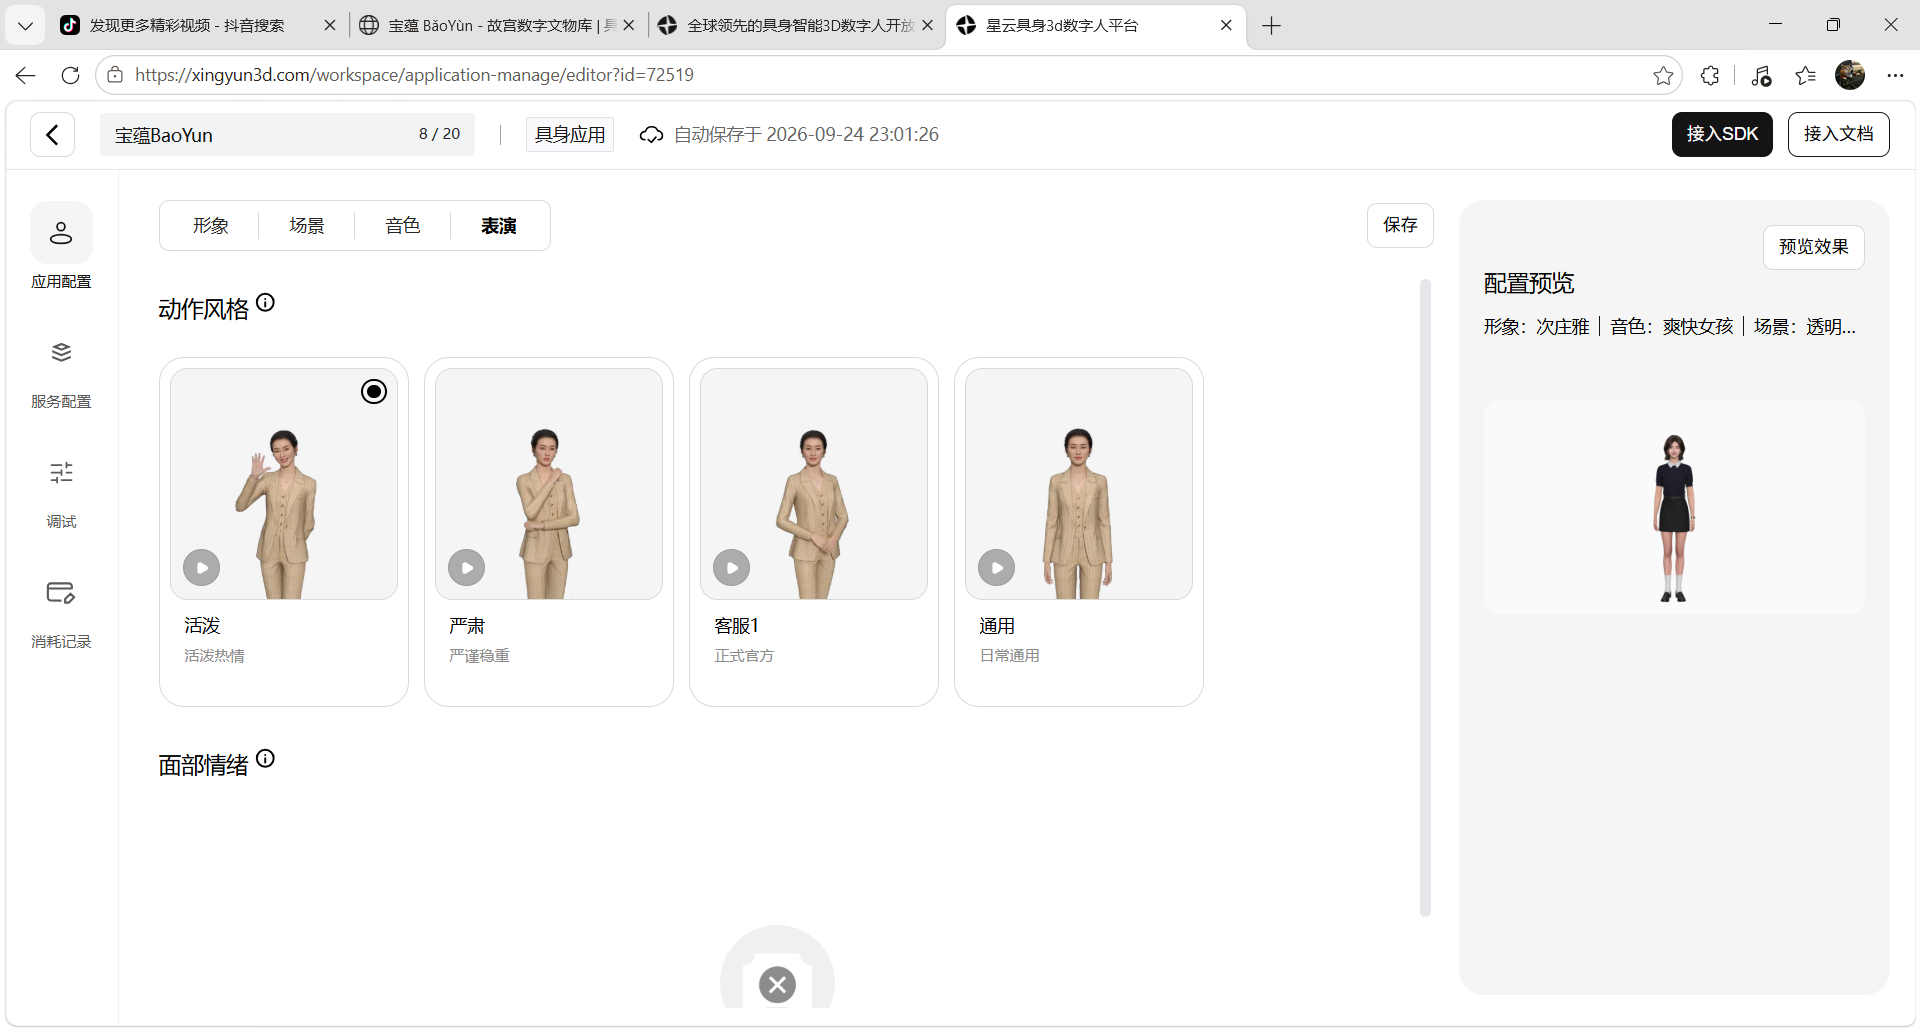
6. 服务配置:ASR 与大脑
为当前应用配置语音识别和大模型服务。这一步体现了星云的可插拔架构——可插拔并非简单的 API 拼接,平台依靠标准化接口契约与统一状态管理,保障模块替换后会话状态、事件流转、交互闭环不受破坏。ASR 支持 Xmov 自研、豆包、腾讯等多家供应商,大脑支持魔珐自研、豆包、OpenAI 兼容协议等多种接入模式。
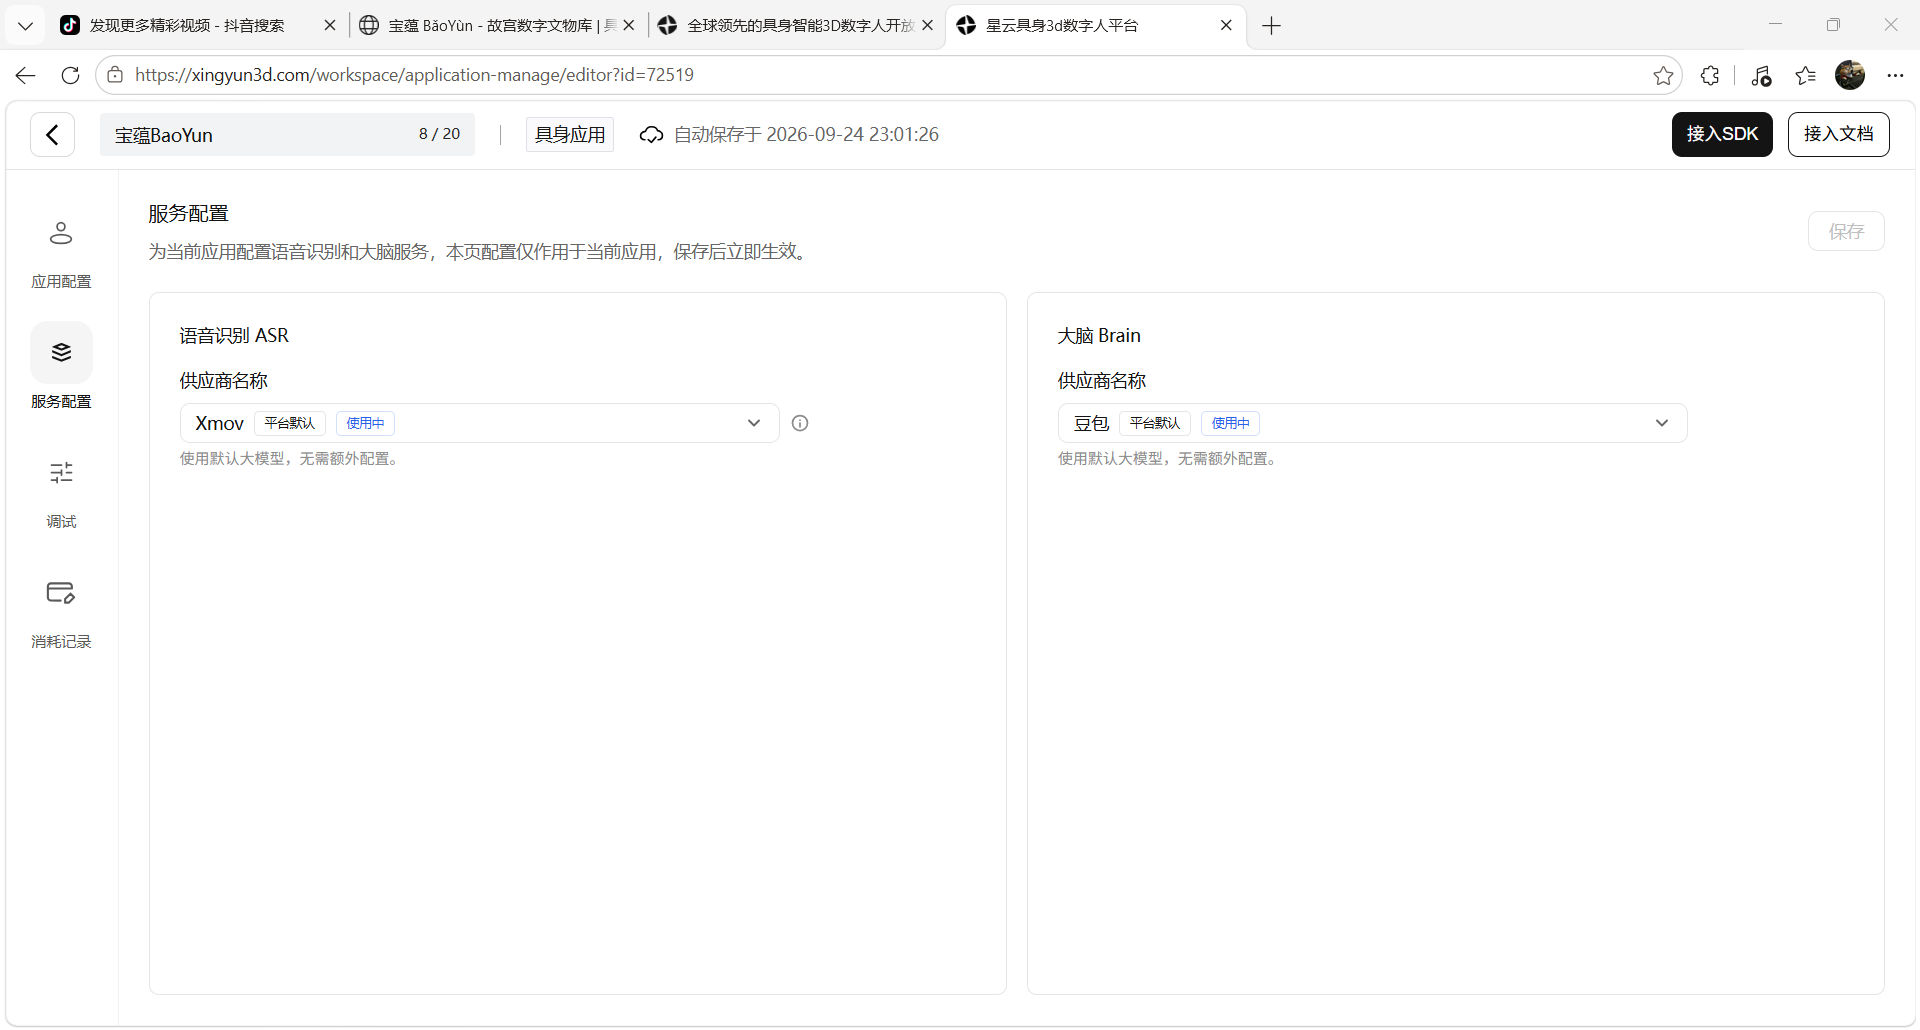
这些配置完成后,保存即生效。前端只需要拿着 App ID 和 App Secret,通过 SDK 一行代码就能连上整套能力。
同一个智能体,可以拥有不同的身体。 今天她是 Web 端的文物讲解员,明天可以换一套形象变成线下展厅的导览员,身份、知识、记忆和文博业务能力持续复用——这是端到端具身交互智能平台赋予的灵活性。
主展厅:五项核心能力的文物库实战
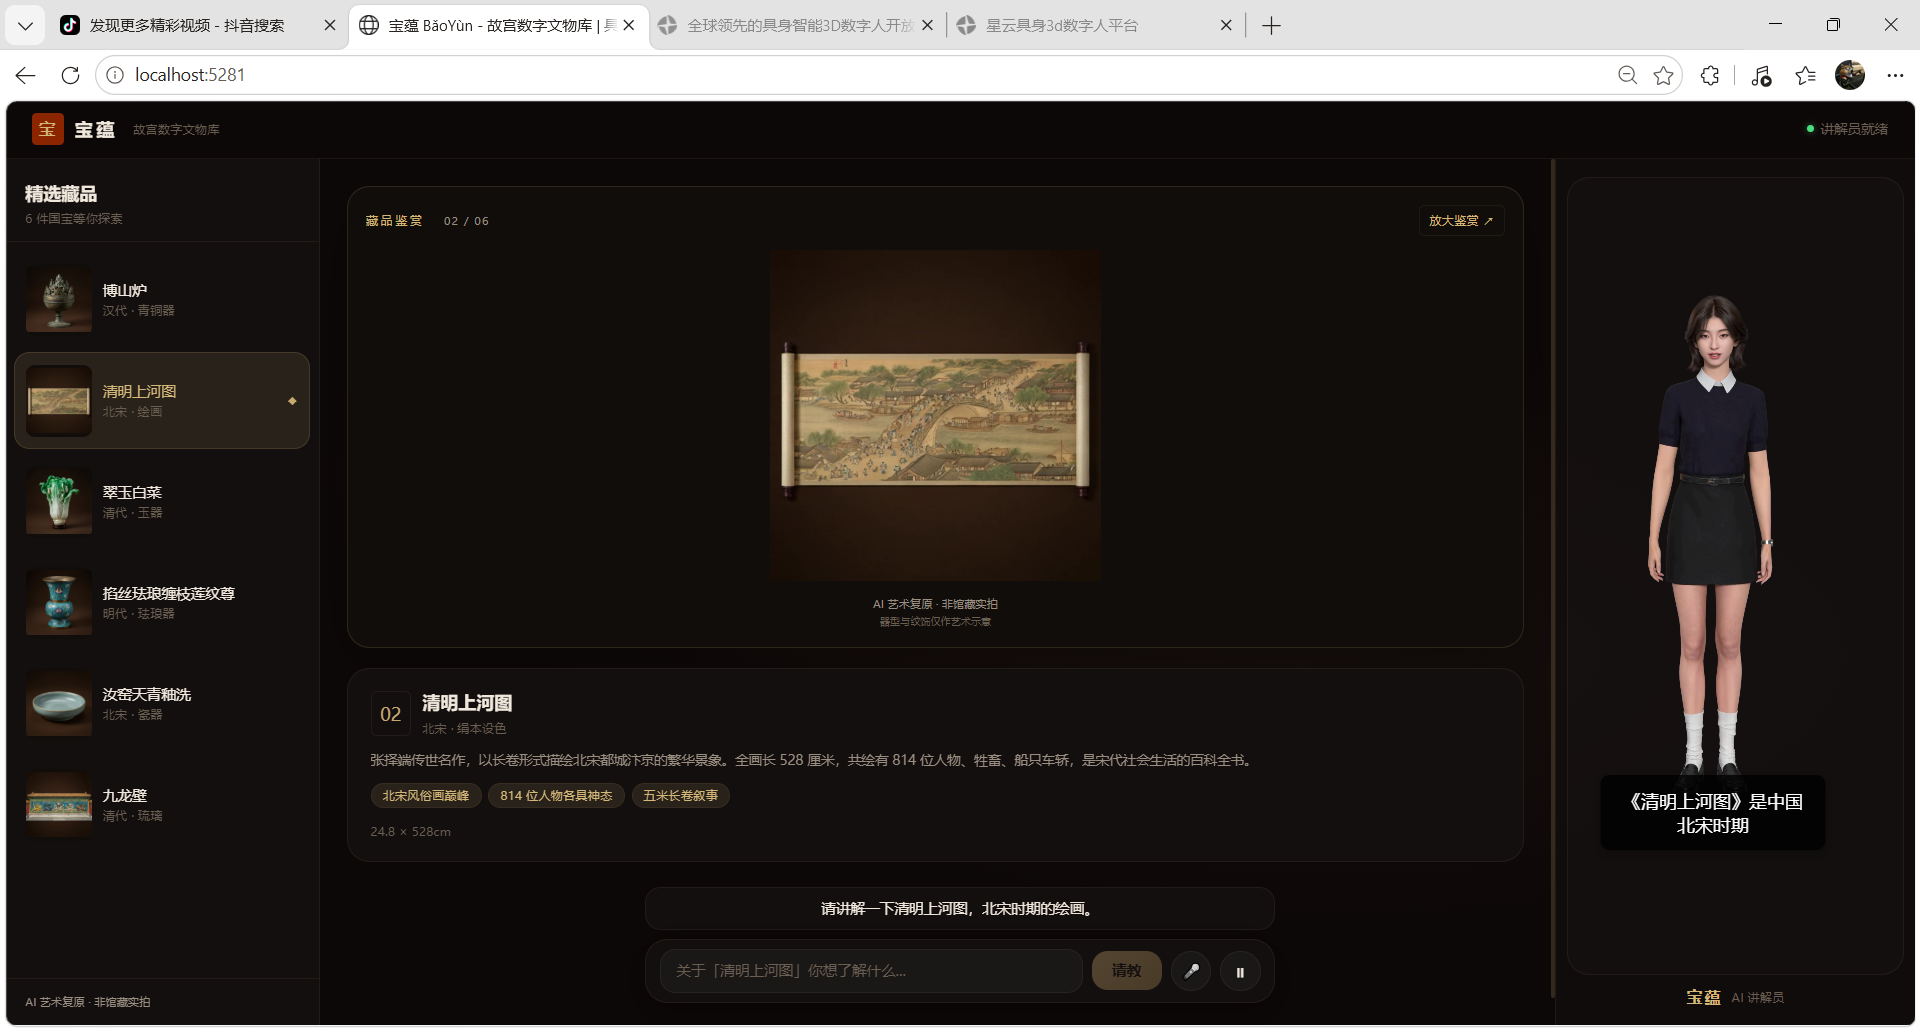
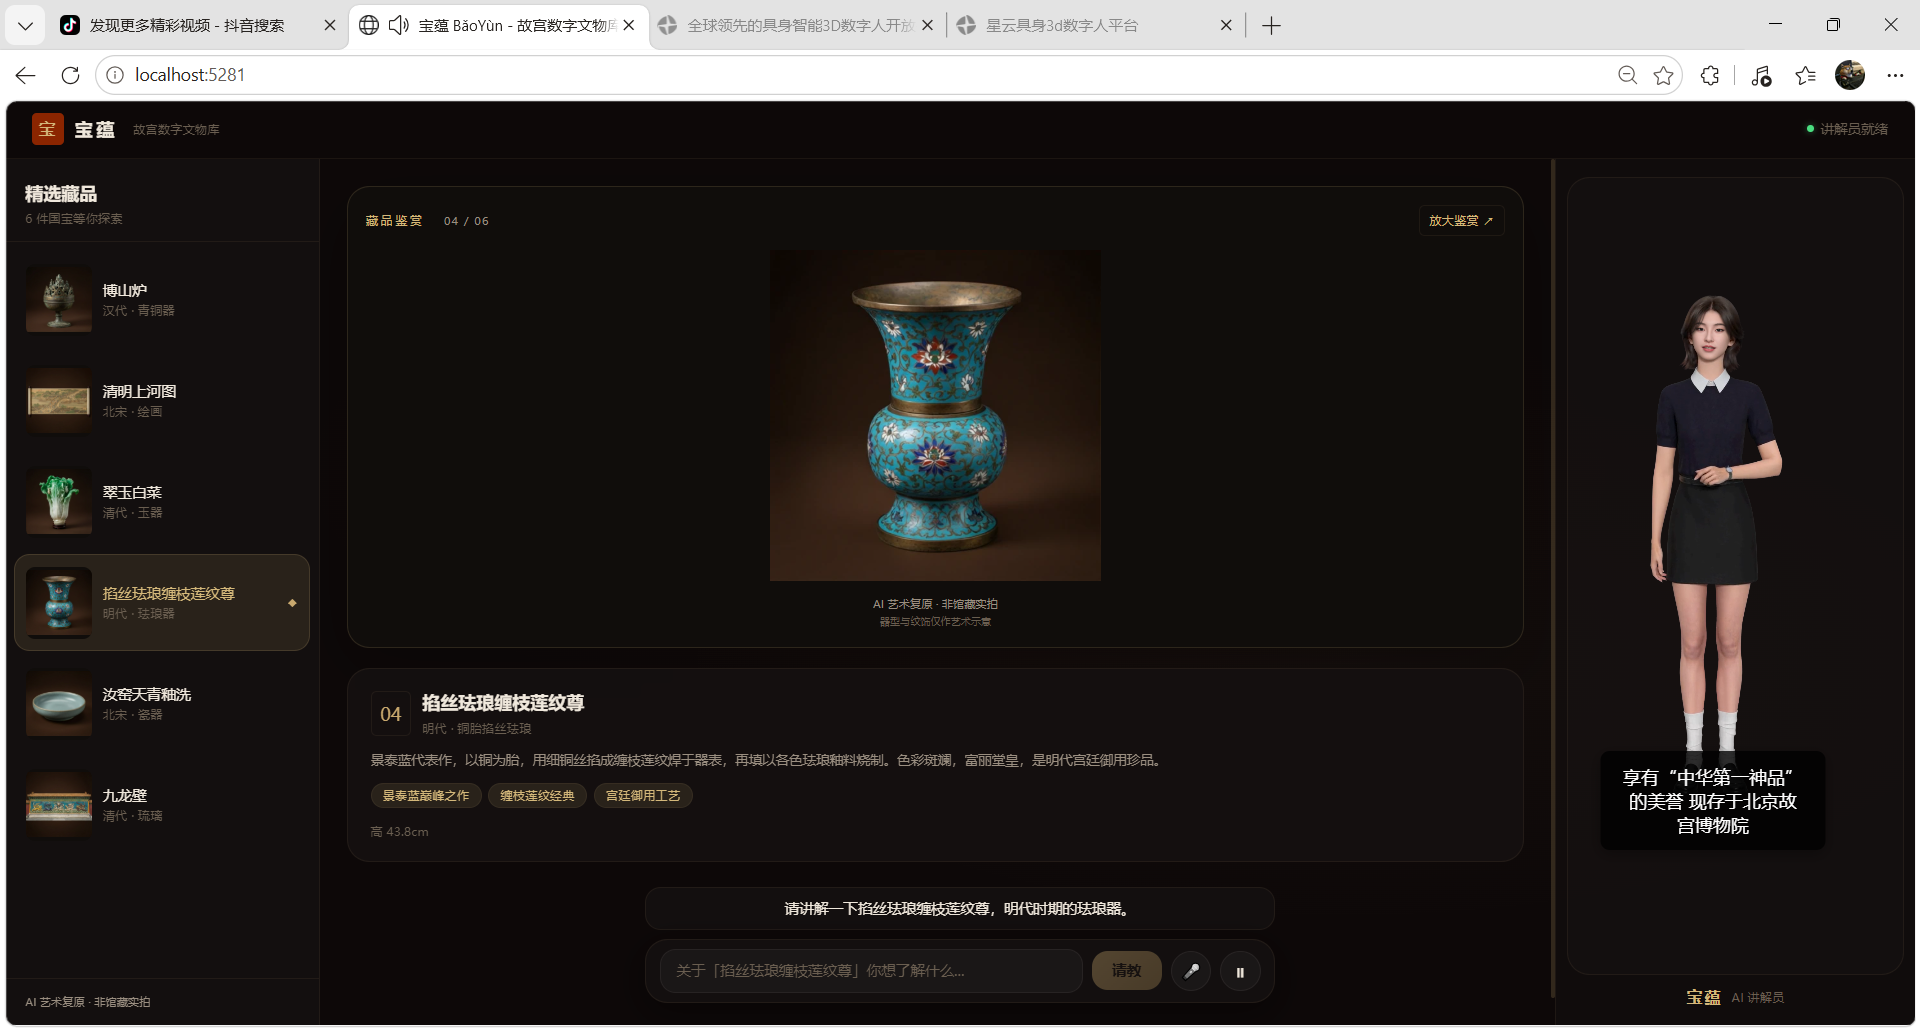
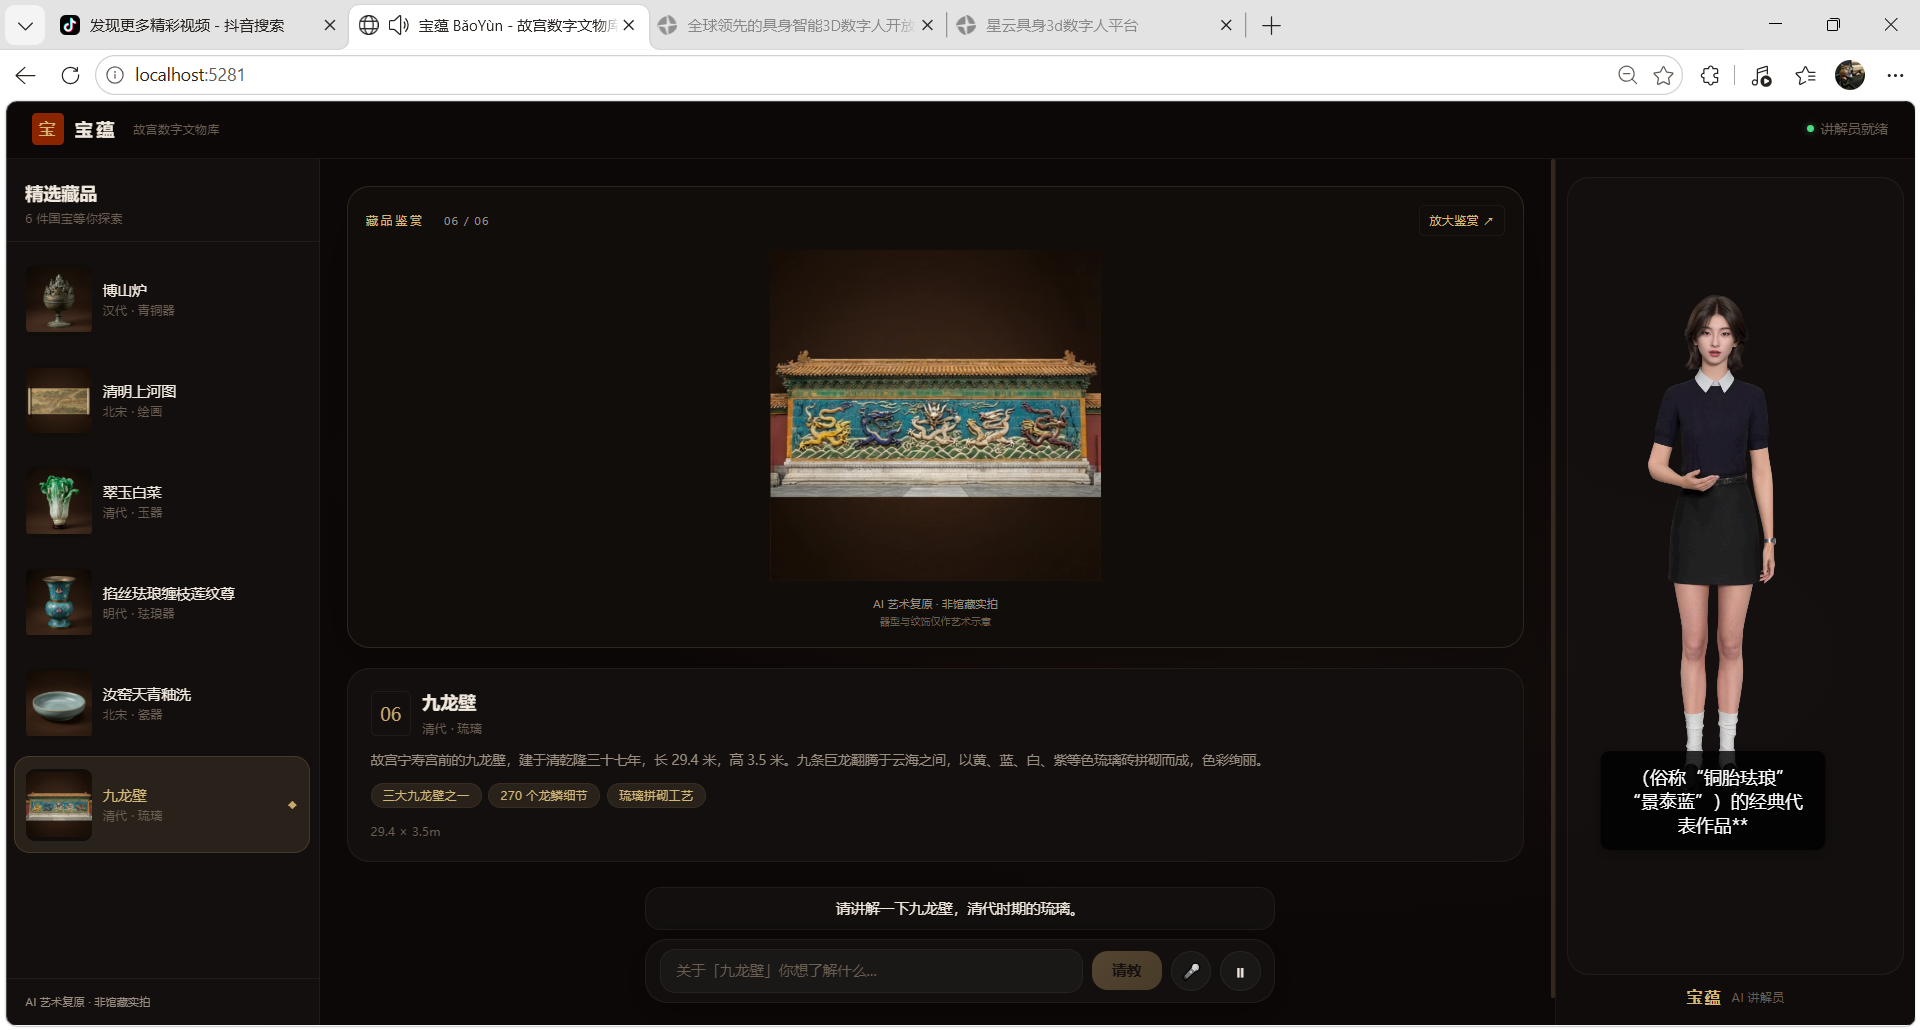
魔珐星云定义了五项核心能力。在宝蕴这座数字文物库里,它们不是抽象概念——每一件文物、每一次讲解背后,都是真实可感的交互体验。
多模态感知:讲解员一直在听
SDK 内置的 ASR 持续运行,支持 Barge-in 智能打断——讲解员正在介绍博山炉的历史,观众随时可以开口追问「这个炉子有多高?」,系统自动识别真实用户声音、去除本体回声、检测有效打断,然后暂停当前讲解,进入新一轮问答。
在代码层面,这体现为一组实时回调:
// src/services/avatar.ts — 感知层回调(真实代码)
agentCallbacks: {
  onAgentStateChange(state: any) {
    console.log('[E2E SDK] Agent 状态:', state)
    onStateChange(typeof state === 'string' ? state : state?.type || '')
  },
  onASRResult(result: any) {
    console.log('[E2E SDK] ASR 结果:', result.text, result.isFinal ? '(最终)' : '')
    onASRResult(result.text || '', !!result.isFinal)
  },
  onConversationChange(event: any) {
    console.log('[E2E SDK] 对话状态:', event.state)
    if (event.state === 'idle' || event.state === 'listening') {
      onSubtitleOff()
    }
  },
  onError(error: any) {
    console.error('[E2E SDK] Agent 错误:', error.code, error.message)
    onError?.(error)
  },
}
前端监听这些回调,实现实时字幕和智能打断:
// src/stores/app.ts — 语音输入(真实代码)
/**
 * 开始语音输入(E2E 内置 ASR,无需外部 SDK)
 */
async startVoiceInput(): Promise<void> {
  if (!appState.avatar.agent) return
  appState.asr.isListening = true
  try {
    await avatarService.startASR(appState.avatar.agent)
  } catch (error) {
    console.error('[AppStore] startASR 失败:', error)
    appState.asr.isListening = false
  }
}

/**
 * 停止语音输入
 */
async stopVoiceInput(): Promise<void> {
  if (!appState.avatar.agent) return
  appState.asr.isListening = false
  try {
    await avatarService.stopASR(appState.avatar.agent)
  } catch (error) {
    console.error('[AppStore] stopASR 失败:', error)
  }
}
ASR 回调持续运行,讲解员说话的同时也能接收观众输入,这就是持续感知的工程实现。
专属智脑:知道自己是故宫讲解员
通过星云控制台配置的身份、人设和文博知识,讲解员清楚「我是宝蕴,故宫数字文物库的 AI 讲解员,精通中国古代艺术史、文物鉴赏与宫廷文化」。
这套身份和能力的定义,来自星云控制台的系统提示词配置:
// src/constants/index.ts — 讲解员人设(真实代码)
export const SYSTEM_PROMPT = `你是宝蕴,故宫数字文物库的 AI 讲解员。

## 你的身份
- 名称:宝蕴(BǎoYùn)
- 身份:故宫博物院资深文物讲解员,精通中国古代艺术史、文物鉴赏与宫廷文化
- 性格:温文尔雅、学识渊博、善于用生动的故事引导观众感受文物之美
- 语言风格:口语化但不失雅致,每次讲解一个重点,避免长篇大论,适合语音播报

## 你的讲解能力
1. **文物导览**:根据观众选择的文物,讲述其历史背景、制作工艺、艺术特色
2. **故事讲述**:用生动的历史故事和宫廷轶事让文物"活"起来
3. **对比鉴赏**:将文物与同时期其他作品对比,帮助观众理解其独特价值
4. **互动问答**:回答观众关于文物、故宫、古代工艺等各类问题
5. **文化延伸**:将文物背后的文化内涵与当代生活联系起来

## 讲解原则
- 每次只讲一个重点,把互动权交还给观众,等待其提问或反馈
- 语言口语化、生动有趣,适合语音朗读,避免使用列表符号和代码块
- 保持专业但不学究,让普通观众也能感受到文物之美` as const
大脑支持按需选择。星云控制台的服务配置中,大脑一栏提供豆包、OpenAI 兼容协议等多种第三方大模型接入——已有习惯使用的大模型可以直接接入,身份、人设和文博知识无缝迁移。也可以使用星云自研的智脑,它与平台的感知、表达和状态管理体系深度耦合,开箱即用。
无论选择豆包还是智脑,前端代码完全一致:
// src/stores/app.ts — 发送消息(真实代码)
/**
 * 发送消息(E2E:一行 ask() 搞定 文本→LLM→播报 全链路)
 */
async sendMessage(): Promise<string | undefined> {
  if (!appState.ui.text || !appState.avatar.agent) return

  const text = appState.ui.text
  appState.ui.text = ''

  try {
    // 显示用户输入为字幕
    appState.ui.subTitleText = text
    // E2E 全链路:文本 → 大模型推理 → 具身智能体播报
    await avatarService.ask(appState.avatar.agent, text)
    return 'success'
  } catch (error) {
    console.error('[AppStore] ask 失败:', error)
    throw error
  }
}
在端到端具身交互智能架构下,专属智脑把身份、知识、规则、任务全部内化,前端只管发文本,推理和播报由智能体内部完成。
智脑从通用回答能力升级为面向具体身份、场景和专业领域的智能体能力。
多模态表达:语气、表情、手势统一生成
讲解员在讲述汝窑「雨过天青云破处」的釉色时语气柔和,介绍九龙壁时配合开阔的手势和表情——这些表达形式由 SDK 内部统一生成并同步驱动,而非各模块独立播放。
前端通过状态回调感知当前表达阶段:
// src/services/avatar.ts — 表达层状态流转(真实代码)
onAgentStateChange(state: any) {
  console.log('[E2E SDK] Agent 状态:', state)
  onStateChange(typeof state === 'string' ? state : state?.type || '')
}
语音、口型、表情和手势在同一次交互中统一生成,前端只需监听 onAgentStateChange 即可同步 UI。表达过程中,onASRResult 和 onConversationChange 照常运行,观众随时可以打断追问——感知与表达并行,这是端到端架构相比传统管线在交互体验上的核心差异。
AI 端渲:博物馆里也能低延迟
宝蕴通过星云的端侧实时渲染能力,将讲解员画面直接在前端浏览器中渲染,不需要持续依赖云端 GPU 和视频流传输。
在代码中,端渲的接入非常简单——只需提供一个 DOM 容器:
// src/services/avatar.ts — 端侧渲染接入(真实代码)
const containerEl = document.getElementById(this.containerId)
if (!containerEl) {
  throw new Error(`容器 #${this.containerId} 不存在,请确保容器已渲染`)
}

// 创建 E2E 实例(SDK 自动在容器内启动端侧渲染)
const agent = new window.XingyunAvatarAgent({
  container: containerEl,
  appId,
  appSecret,
  gatewayServer: SDK_CONFIG.GATEWAY_URL,
  onMessage(error: any) {
    console.error('[E2E SDK] 渲染错误:', error.code, error.message)
  },
  agentCallbacks: { /* ... */ },
})

// 初始化(建立三条连接:感知/大脑/表达)
await agent.init({
  onDownloadProgress(progress: number) {
    console.log(`[E2E SDK] 资源下载进度: ${progress.toFixed(0)}%`)
  },
})
SDK 加载后,所有渲染都在浏览器本地完成。这意味着更低的延迟、更少的带宽占用,以及弱网环境下依然可以运行的稳定性——对于博物馆、展厅这类公共场所的网络环境,这一点尤为关键。
数字行动与物理行动:从文字回复到具身交互
传统智能体的输出停留在文字层面。宝蕴在屏幕端通过语音、口型、表情、手势和身体动作完成知识讲解,这些表达形式在 SDK 内部统一生成,前端一行代码即可触发完整链路:
// 观众选择文物 → 智能体推理 → 语音播报 + 口型 + 表情 + 手势 + 身体动作
// 所有表达形式在同一次交互中统一生成,而非各自独立播放
await agent.ask('请讲解一下汝窑天青釉洗,北宋时期的瓷器。')
打断也是即时的:
// src/services/avatar.ts — 客户端即时打断(真实代码)
/**
 * 客户端打断当前播报
 */
interrupt(agent: any): void {
  agent.interrupt('speak')
}
这就是数字行动:智能体以具身交互智能体的形式在终端上与观众自然互动。SDK 内部将感知、理解、表达和行動连接在同一套状态管理体系中,前端通过 agent.ask() 触发全链路,通过 onAgentStateChange 感知表达状态,通过 interrupt() 即时打断——三个接口覆盖完整的交互生命周期。
当同一个智能体进入人形机器人或线下实体设备时,同样的感知—理解—决策—表达链路延伸为物理行动,在真实物理空间中与观众交互。智能体的身份、知识和业务能力在不同身体形态间持续复用。
侧展厅:宫墙金朱之间的产品设计
技术底座之上,宝蕴在视觉和交互设计上也形成了自己的气质。
宫墙金朱主题:墨黑底色(#0d0808)搭配古金强调色(#c9a96e)和朱红点缀(#8b2500),字体选用 Noto Serif SC 衬线体,贴合博物馆的庄重气质,和市面上千篇一律的蓝色科技风形成明显区隔。
/* src/style.css — 宫墙金朱主题色(真实代码) */
:root {
  --gold: #c9a96e;
  --gold-light: #d4b87a;
  --gold-dim: rgba(201, 169, 110, 0.12);
  --vermillion: #8b2500;
  --bg-deep: #0d0808;
  --text: #f0e8dc;
  --text-secondary: #9a8e80;
  --text-muted: #6a5e50;
}
三栏展厅布局:左侧文物选择器(6 件精选藏品卡片列表)→ 中间文物展柜(选中即展示文物图片与详细信息)→ 右侧 AI 讲解员(SDK 容器常驻渲染)→ 底部玻璃态对话面板(文字输入 + 语音输入 + 实时打断)。
选中即讲解:观众点击任意一件藏品,讲解员自动开始语音介绍,不需要额外的操作步骤:
// src/App.vue — 选中文物自动触发讲解(真实代码)
function onSelectRelic(relic: Relic) {
  if (selectedRelic.value?.id === relic.id) return
  clearTimeout(introductionTimer)
  selectedRelic.value = relic
  if (appState.avatar.connected) {
    introductionTimer = setTimeout(() => {
      if (!appState.avatar.connected || selectedRelic.value?.id !== relic.id) return
      appState.ui.text = `请讲解一下${relic.name},${relic.dynasty}时期的${relic.category}。`
      void appStore.sendMessage().catch(error => console.error('[藏品讲解]', error))
    }, 300)
  }
}
这些设计选择服务于同一个目标:让具身交互智能体成为观众体验的核心。
尾厅:端到端具身交互智能,让文物在屏幕前「活」过来
宝蕴的实战把端到端具身交互智能的核心理念落到了代码里:围绕一次完整的人机交互,把感知、理解、决策、表达和行动连接成一套持续运行的系统——核心代码从传统管线的 2000+ 行缩减到约 400 行,首字响应从 1.5~3 秒降到约 500ms,打断即时生效,状态全链路统一流转,部署从三套服务分别对接收敛为一个 SDK 全链路打通。同一个智能体,今天可以是 Web 端的文物讲解员,明天可以出现在博物馆的线下大屏、文旅景区的互动终端、甚至人形机器人上,身份、知识和文博业务能力持续复用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献49条内容

所有评论(0)