走进虚拟实验室,一位不会发脾气的 AI 助教全程陪练:研知背后的端到端具身交互智能实战手记
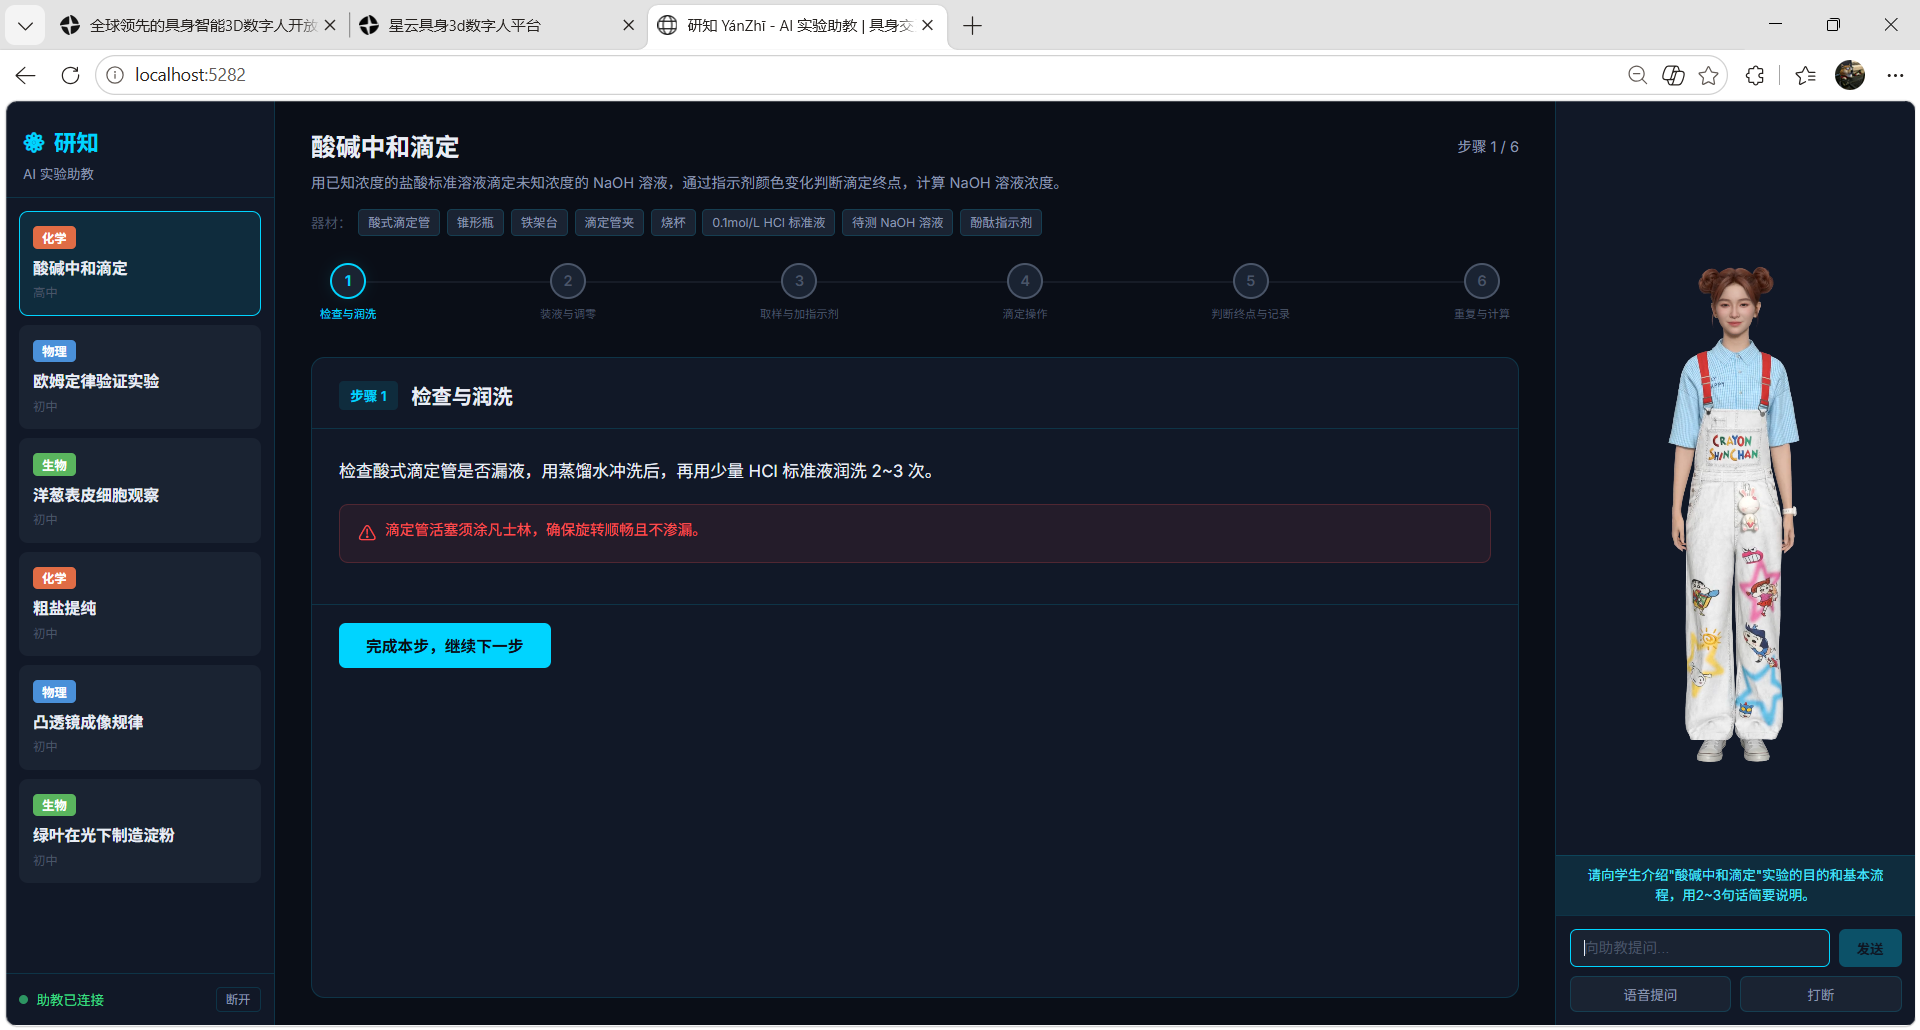
化学实验室里,一个学生把浓硫酸直接倒进了量筒——如果旁边站着一位真人老师,大概率会立刻制止。但在传统的在线实验课程中,这个错误可能要等到提交报告后才被发现。
研知(YánZhī)是一位永远不会发脾气的 AI 实验助教。她以导师形象常驻在虚拟实验室里,学生每完成一步操作,她即时点评并引导下一步;遇到危险操作,她当场纠正并解释原因。学生可以随时语音提问,她结合实验上下文实时回答。
本文以研知为实战样本,拆解一个虚拟实验室应用如何基于魔珐星云端到端具身交互智能平台,用一个 SDK 把感知、大脑、表达全链路打通,让 AI 助教在浏览器里完成"观察—引导—纠正—答疑"的完整教学闭环。
课前预习:为什么实验教学习需要端到端具身交互智能?
在线实验课不是录一段操作视频就完了。真正的实验教学需要一个持续在线的"老师":她要在学生动手之前提醒安全事项,在学生操作时观察进度,在学生犯错时即时纠正,在学生困惑时耐心解答。
这种"持续观察 → 即时判断 → 实时反馈 → 动态调整"的闭环,正是端到端具身交互智能要解决的核心问题。
传统做法是把 ASR、LLM、TTS 分别对接三家供应商,自己写胶水层做状态同步。代码量 2000+ 行起步,首字响应 1.5 到 3 秒,学生问完问题对着屏幕干等。更要命的是——学生操作到一半想问个问题?做不到,因为 ASR 和 TTS 的状态是割裂的,助教正在"说话"时听不到学生提问。
这就是典型的"不是端到端"。
实验指导书:一个 SDK 撑起虚拟实验室
研知基于魔珐星云端到端 SDK XingyunAvatarAgent 构建,核心业务代码不到 500 行。整个前端对接只需要三步:提供一个 DOM 容器、注册一组回调、调用 agent.ask() 发送消息。
// src/services/avatar.ts — 连接具身交互智能体(真实代码)
const agent = new window.XingyunAvatarAgent({
  container: containerEl,
  appId,
  appSecret,
  gatewayServer: SDK_CONFIG.GATEWAY_URL,
  onMessage(error: any) {
    console.error('[E2E SDK] 渲染错误:', error.code, error.message)
  },
  agentCallbacks: { /* 感知/对话/错误回调,详见实验操作章节 */ },
})

// 初始化:一次性建立感知、大脑、表达三条通道
await agent.init({
  onDownloadProgress(progress: number) {
    console.log(`[E2E SDK] 资源下载进度: ${progress.toFixed(0)}%`)
  },
})
端到端具身交互智能和模块拼接的本质区别:感知、理解、决策、表达不再是前后两个独立阶段,而是在同一次交互中持续并行运行。助教一边引导学生操作,一边听学生有没有提问,一边判断接下来该怎么回应。
这些回调具体做了什么?下面的实验操作章节逐一拆解。
仪器调试:在魔珐星云控制台配置一位 AI 助教
研知的具身交互智能体并不是从零搭建的,它的能力底座来自魔珐星云控制台的完整配置体系。这里用截图还原实际配置过程。
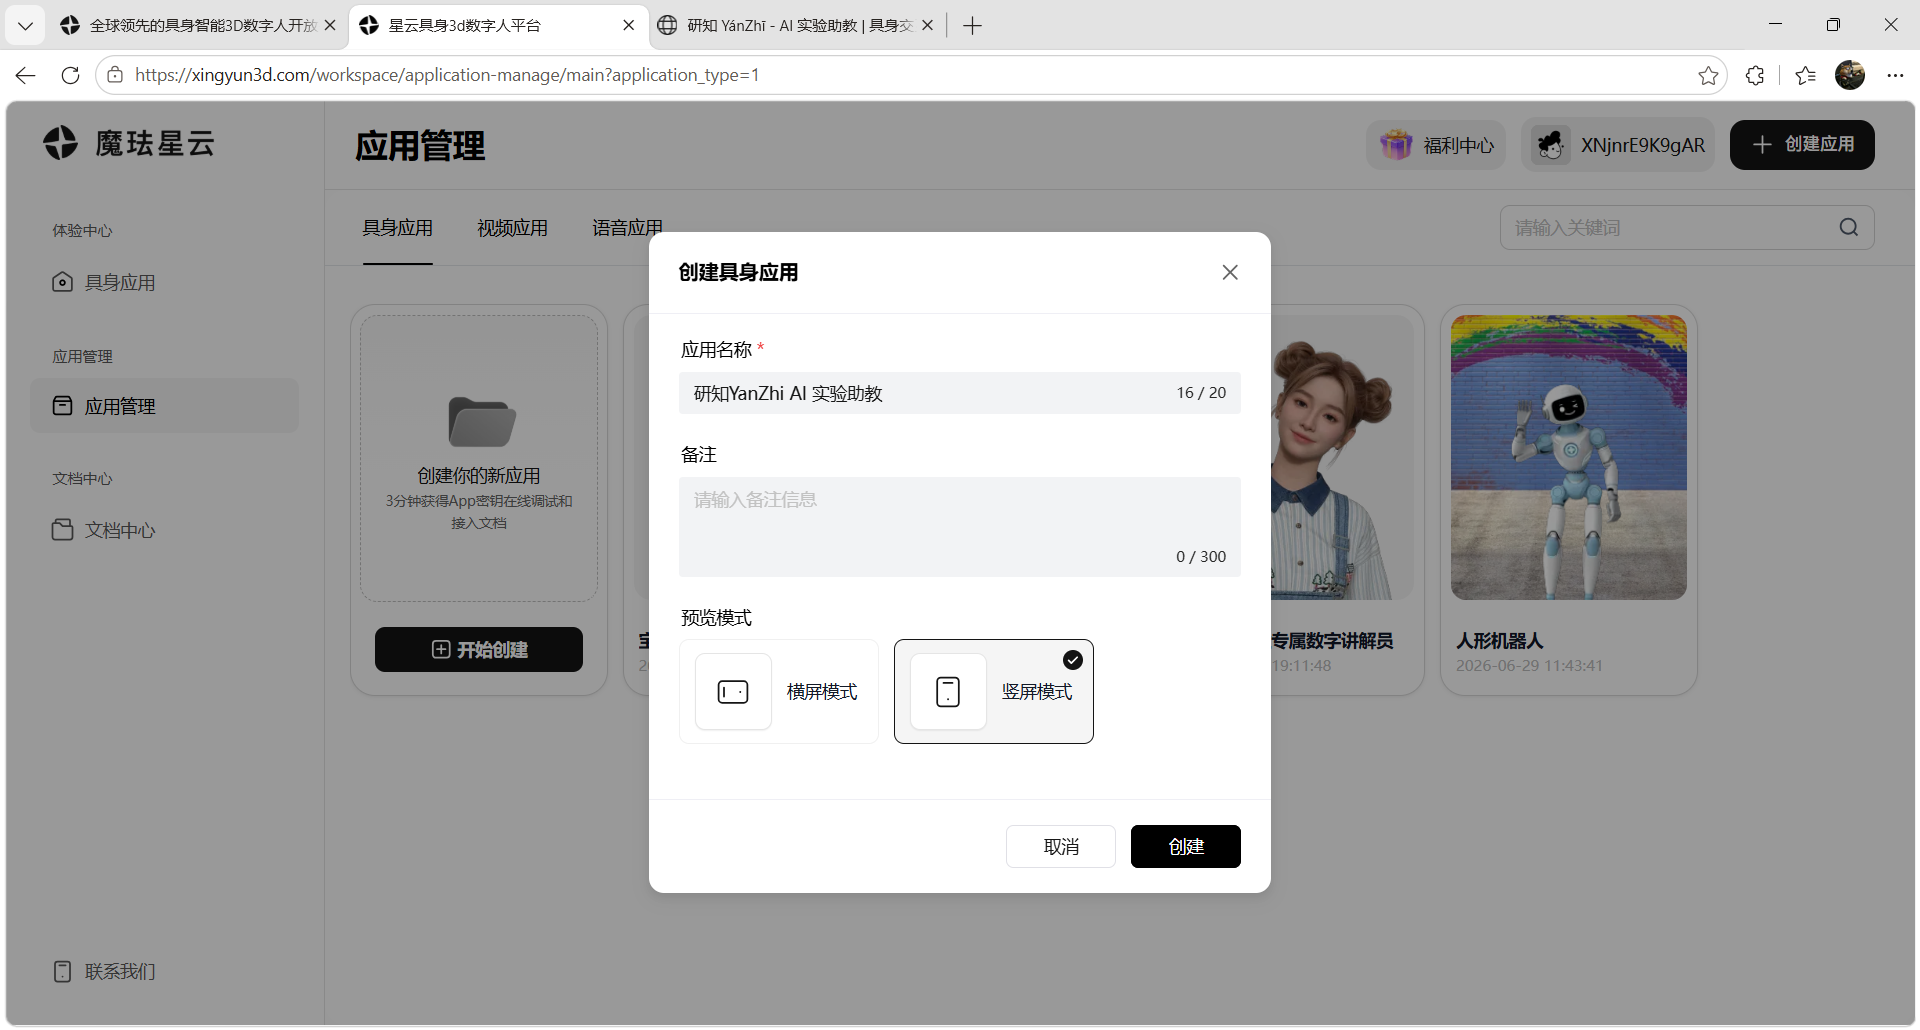
1. 创建具身应用
在魔珐星云控制台创建一个新应用,系统会自动分配 App ID 和 App Secret,这就是后续 SDK 连接所需的身份凭证。
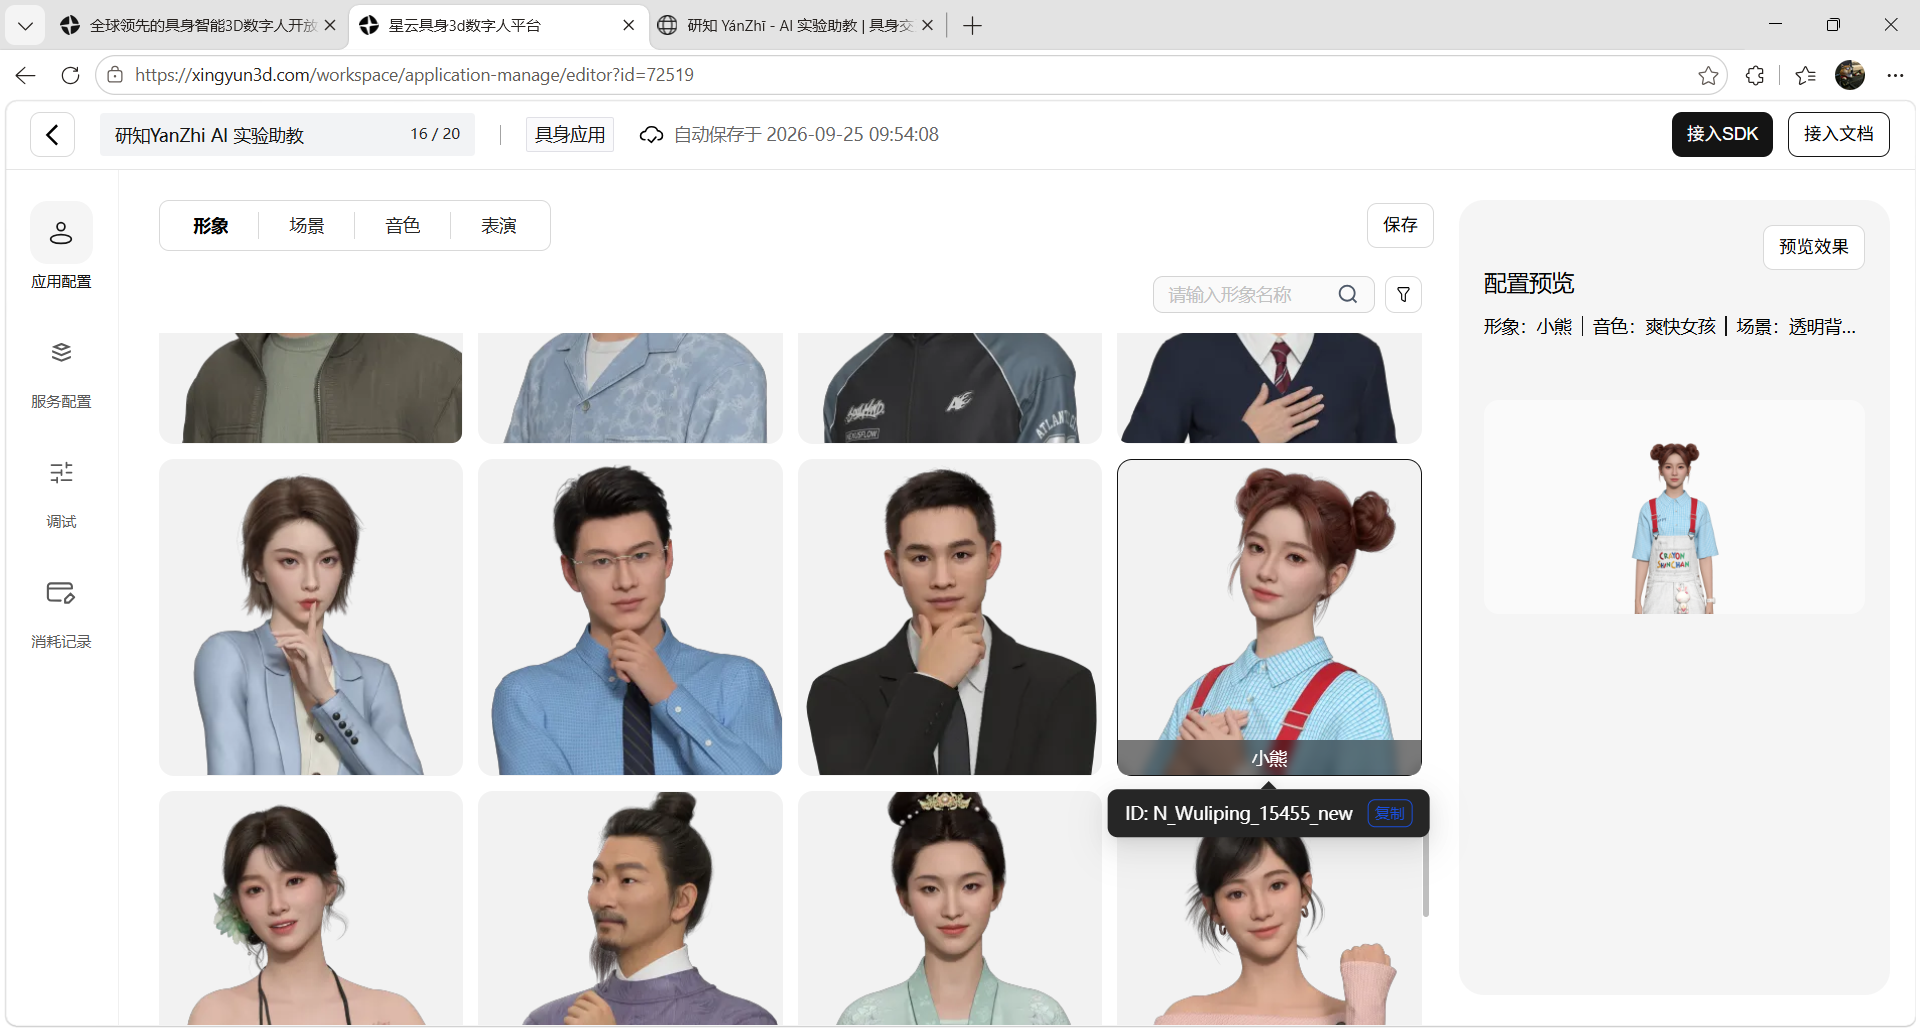
2. 形象配置
选择智能体的外在形象——研知需要的是一位严谨专业、值得信赖的实验导师。平台提供多种形象可选,也可以自定义。
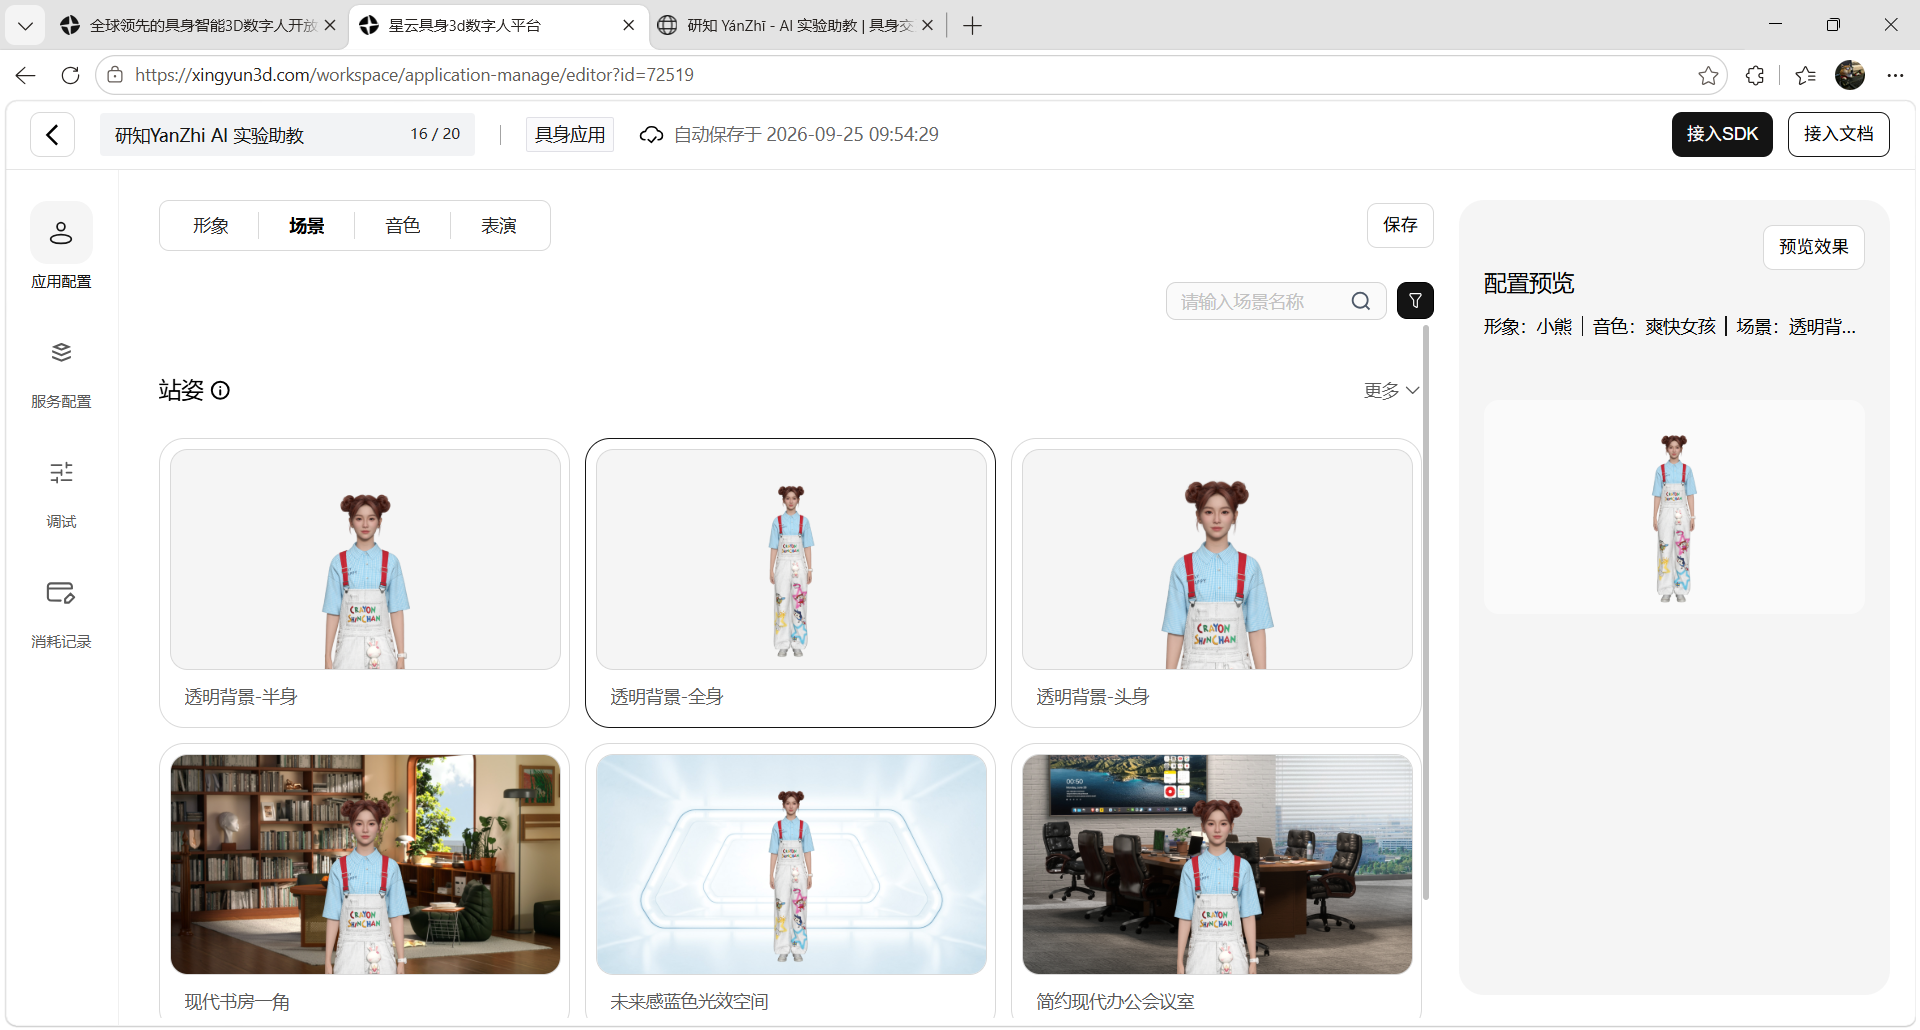
3. 场景配置
为智能体设定交互场景的背景环境。研知采用的是深蓝科技风格的虚拟实验室背景,和前端 UI 的青蓝科技主题保持一致。
4. 音色配置
选择智能体的语音风格。实验助教需要的是清晰沉稳、语速适中的音色,魔珐星云自研 TTS 支持多语言多风格。
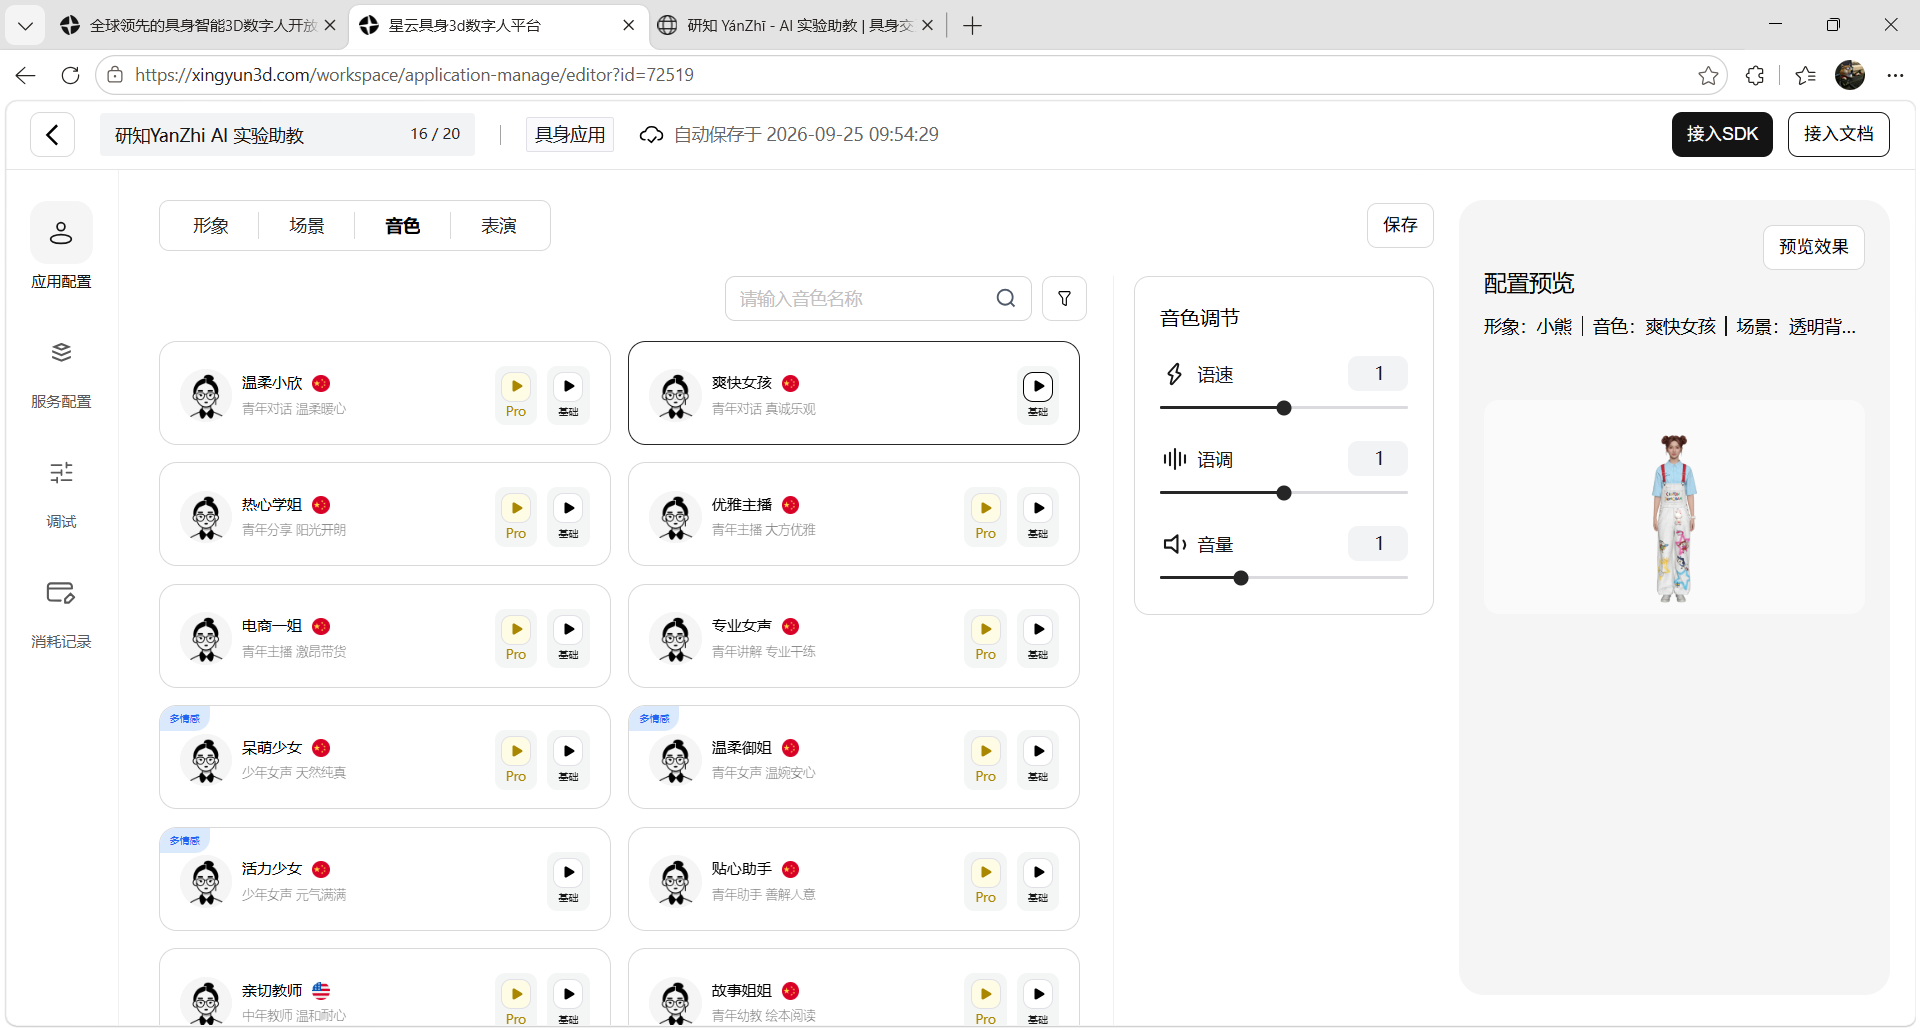
5. 表演配置
配置智能体的肢体语言和表情系统——这正是多模态表达的核心。不是简单的口型同步,而是语气、表情、手势、头部动作和身体动作的统一生成。助教在提醒安全事项时表情严肃、在鼓励学生时语气温和,都来自这一层的配置。
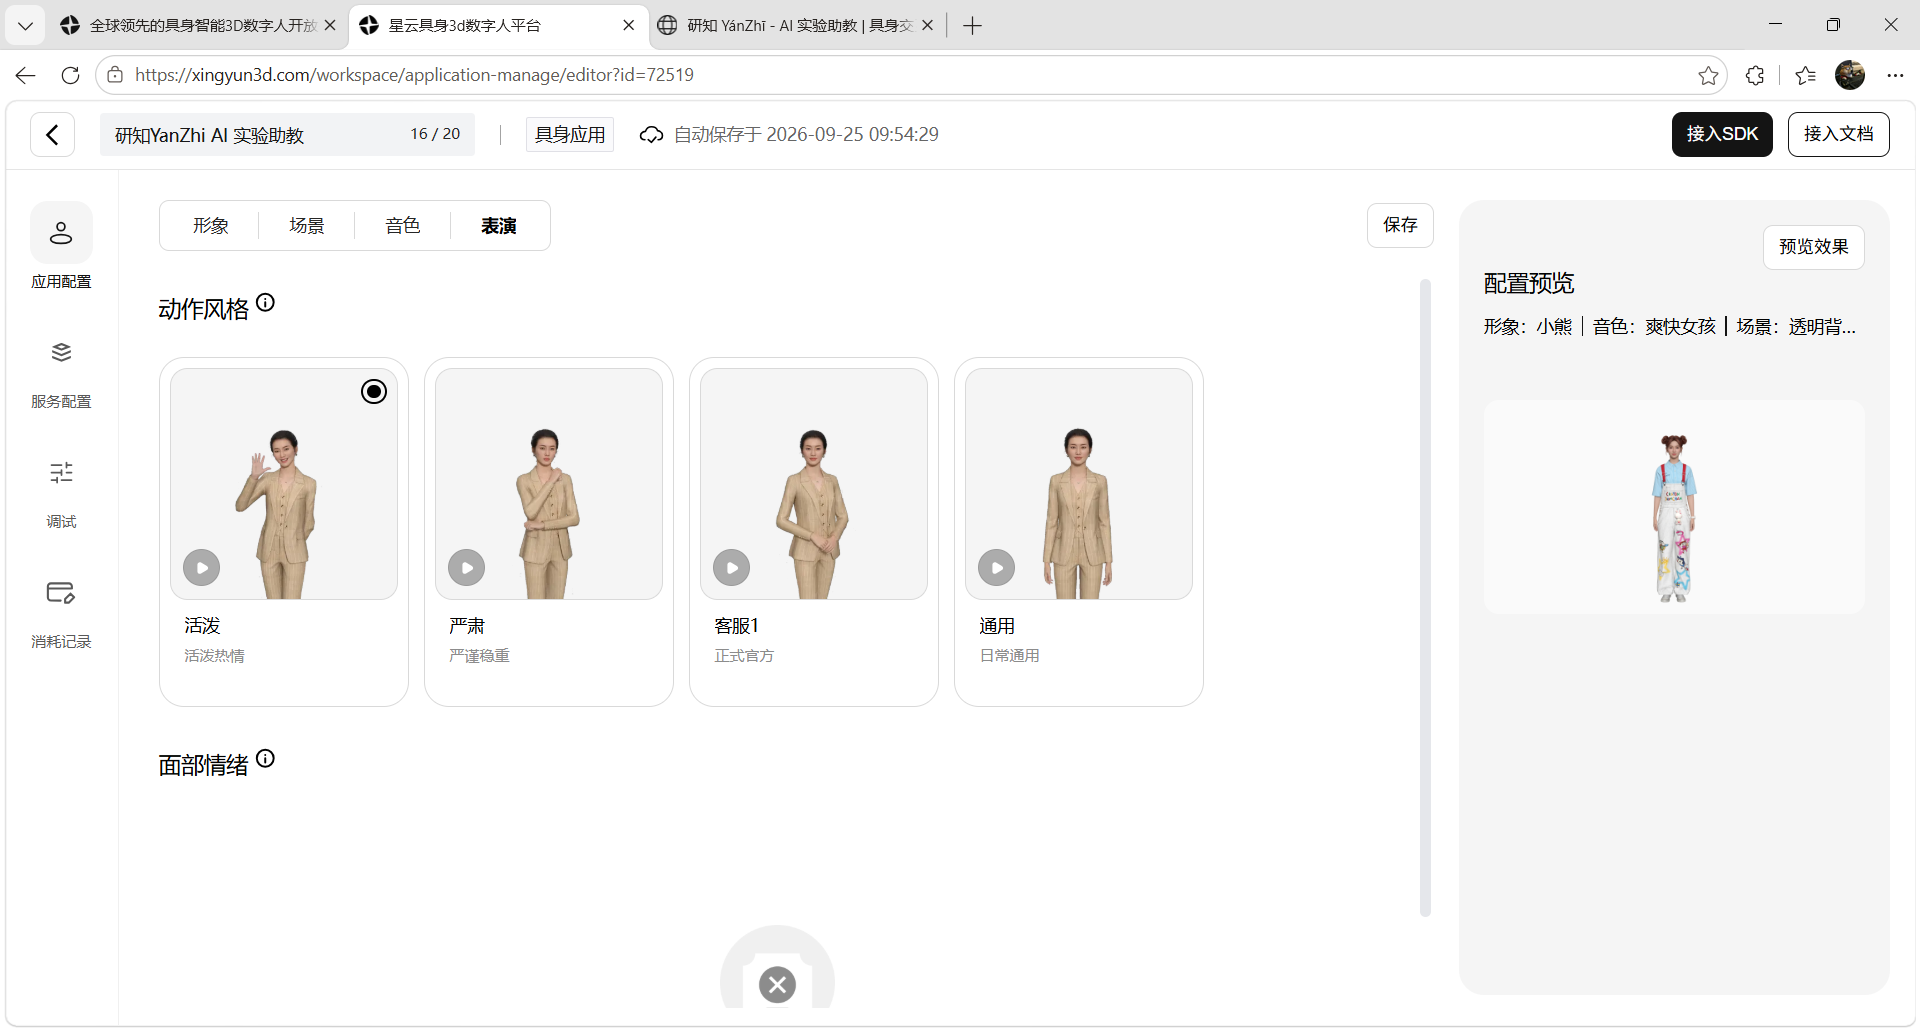
6. 服务配置:ASR 与大脑
为当前应用配置语音识别和大模型服务。这一步体现了星云的可插拔架构——可插拔并非简单的 API 拼接,平台依靠标准化接口契约与统一状态管理,保障模块替换后会话状态、事件流转、交互闭环不受破坏。ASR 支持 Xmov 自研、豆包、腾讯等多家供应商,大脑支持魔珐自研、豆包、OpenAI 兼容协议等多种接入模式。
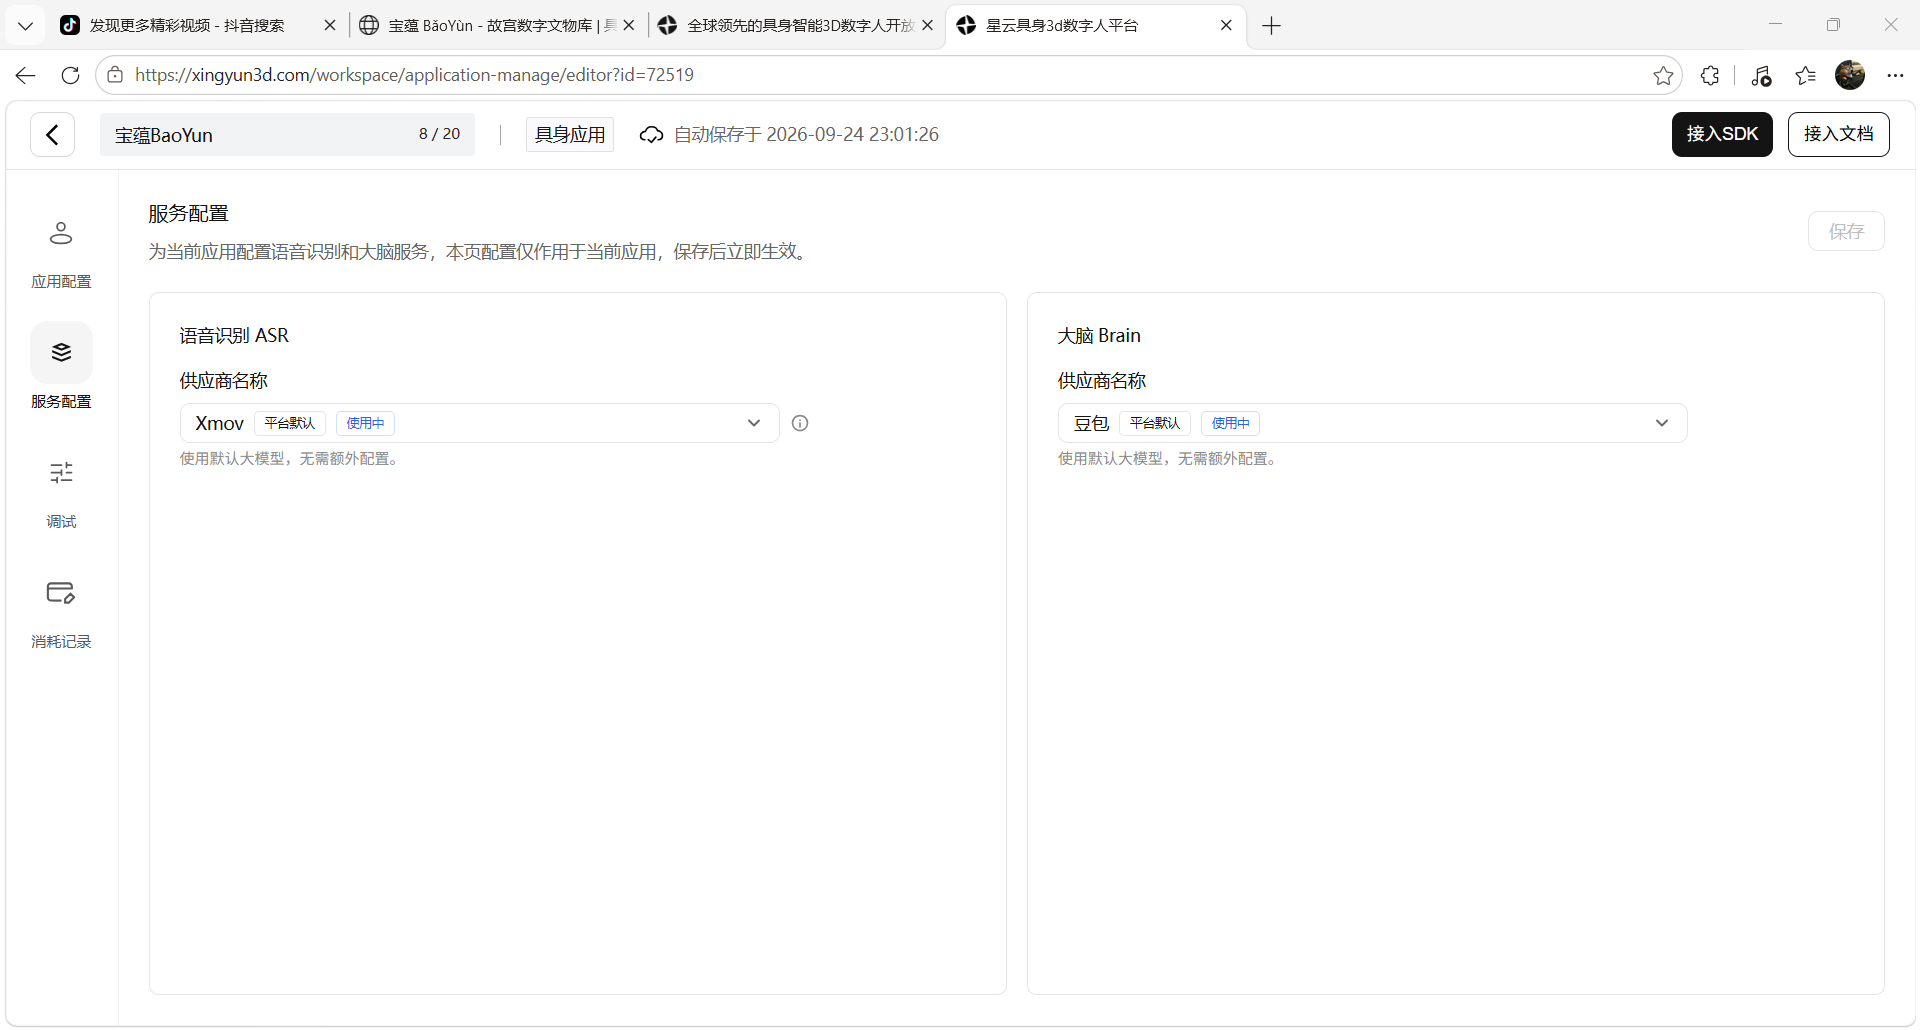
这些配置完成后,保存即生效。前端只需要拿着 App ID 和 App Secret,通过 SDK 一行代码就能连上整套能力。
同一个智能体,可以拥有不同的身体。 今天她是 Web 端的实验助教,明天可以换一套形象变成线下实训中心的指导教练,身份、知识、教学能力持续复用——这是端到端具身交互智能平台赋予的灵活性。
实验操作:五项核心能力的教学实战
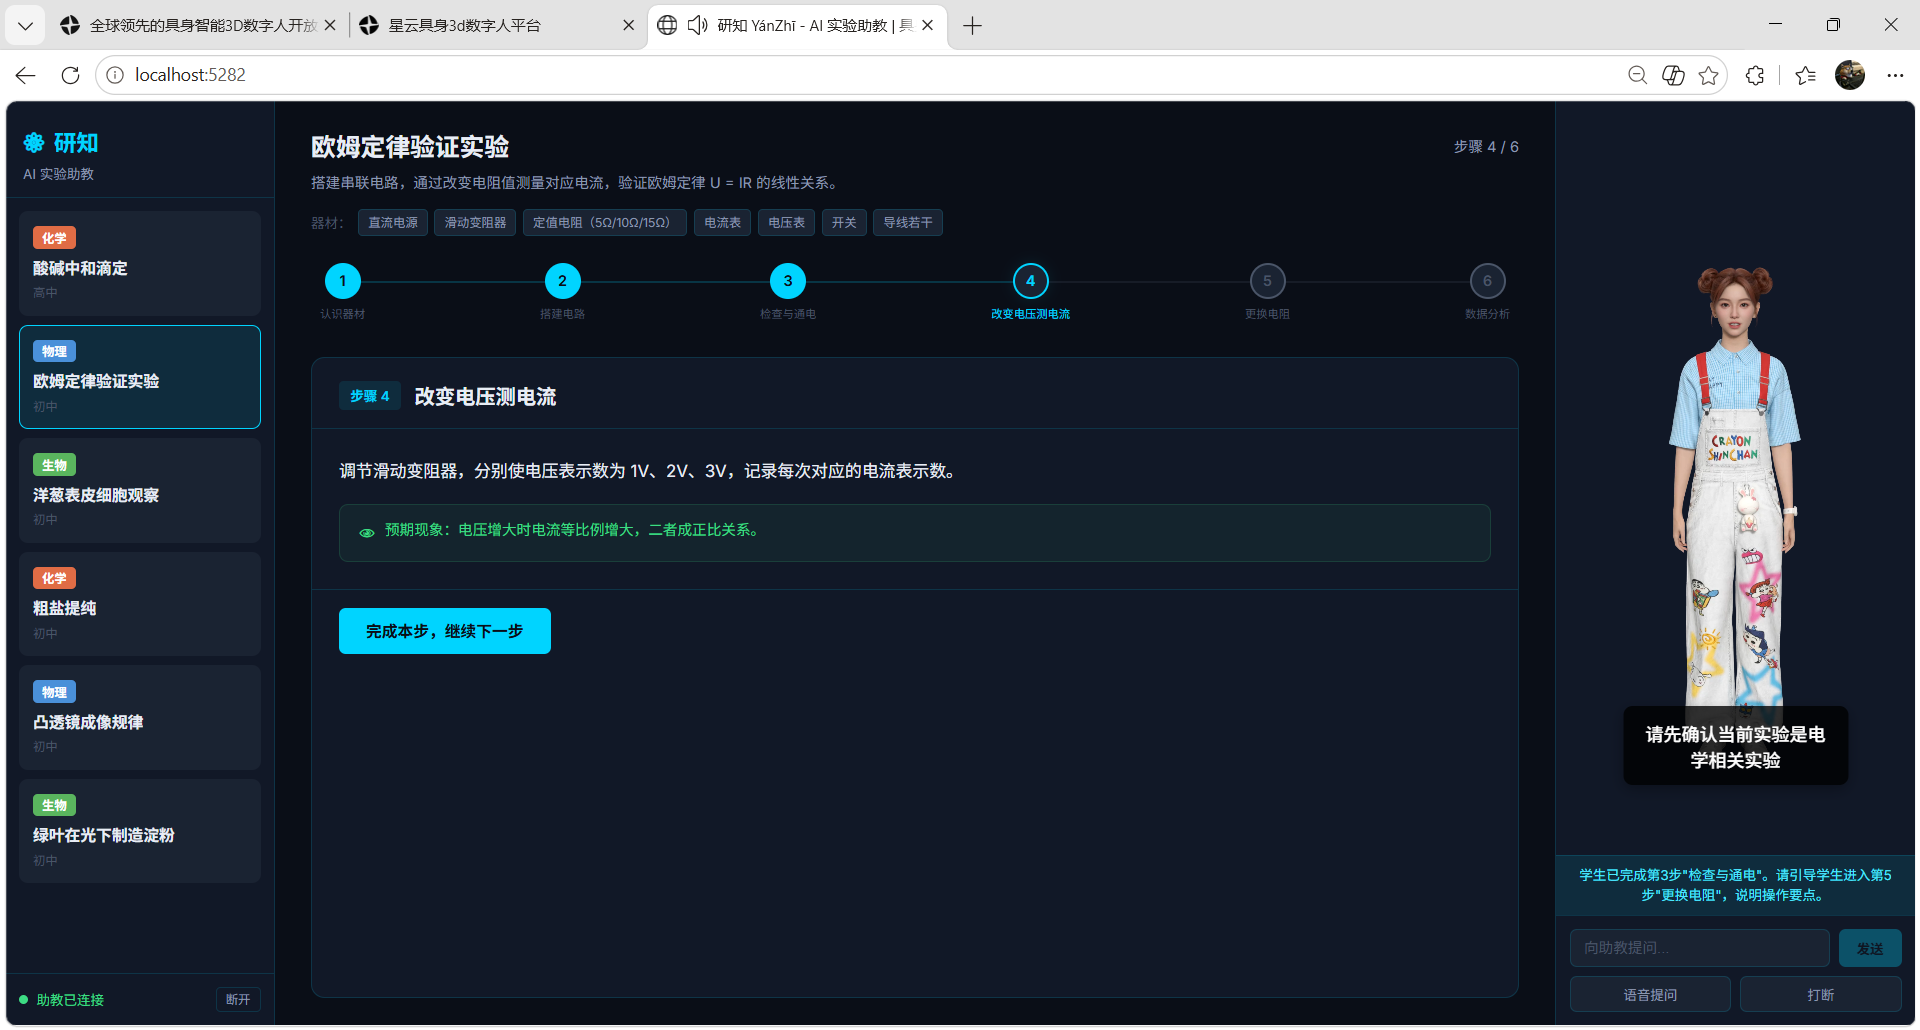
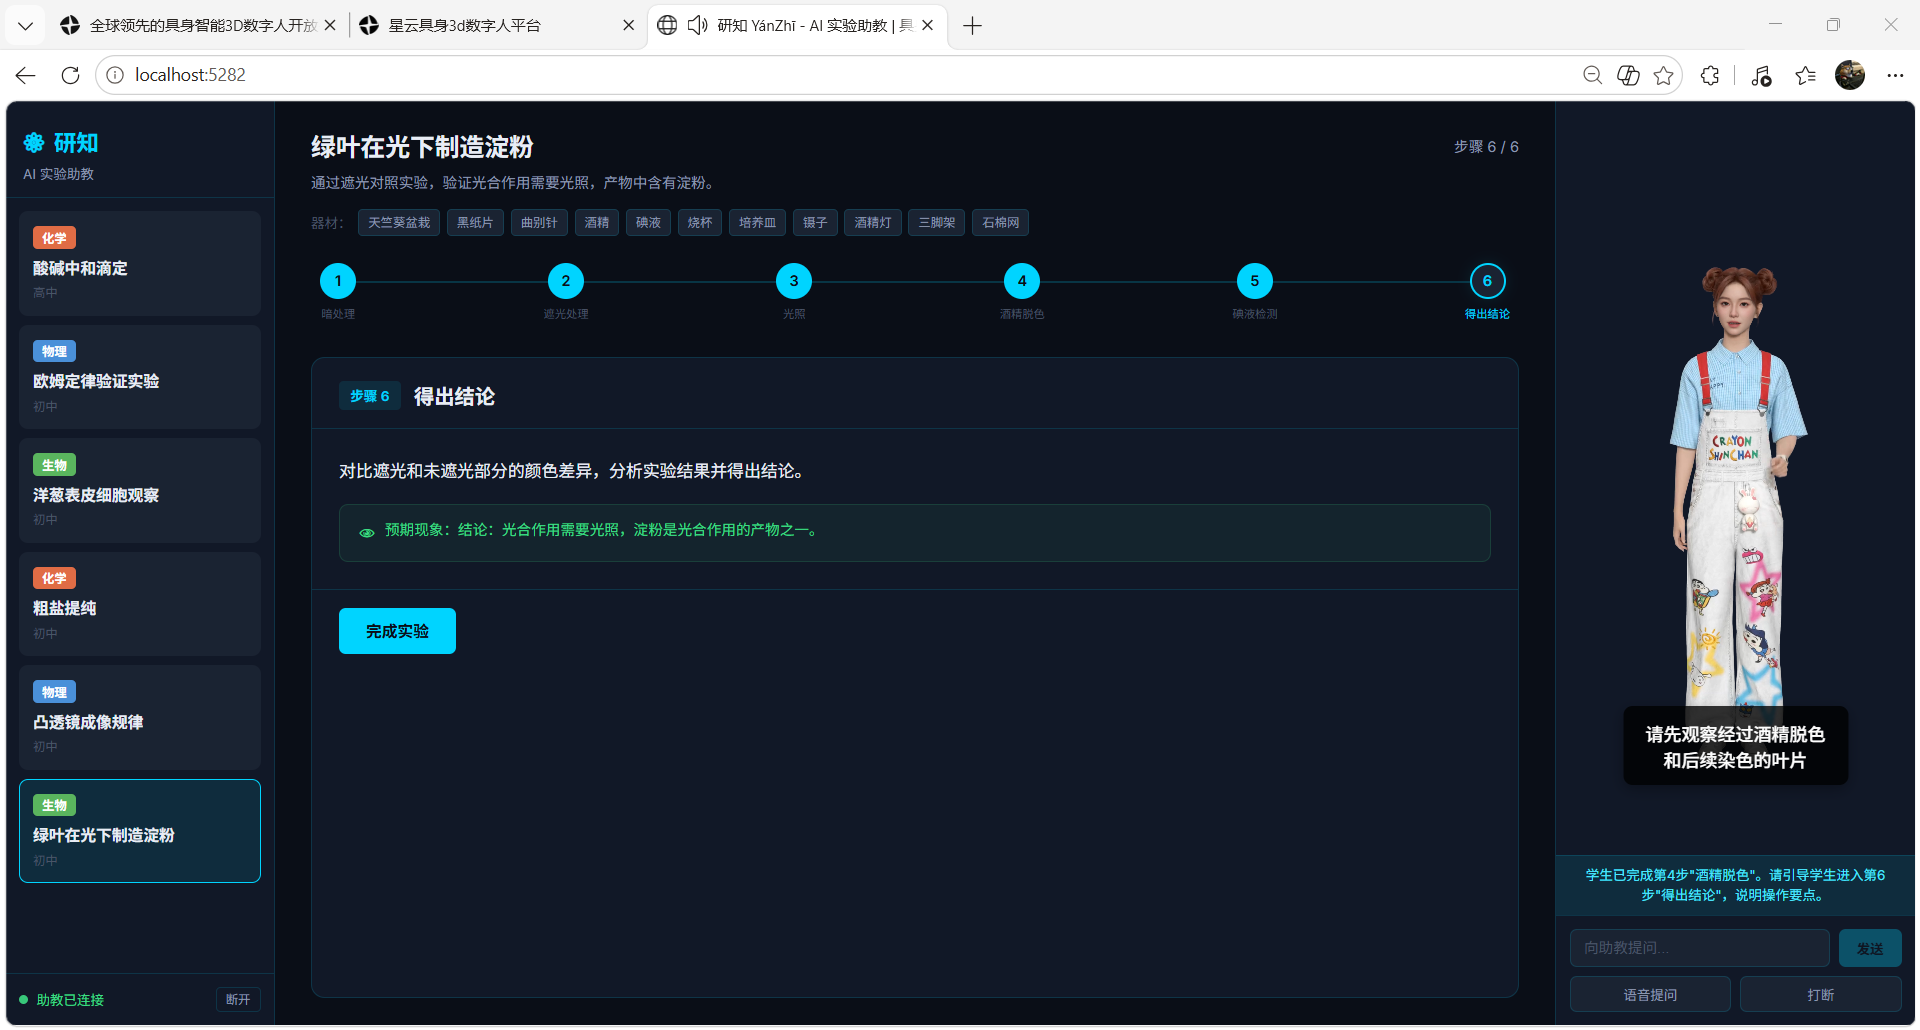
魔珐星云定义了五项核心能力。在研知这座虚拟实验室里,它们不是抽象概念——每一次实验引导、每一次安全纠正背后,都是真实可感的交互体验。
多模态感知:助教一直在听
研知的语音感知不是"等你问完再处理"。SDK 内置的 ASR 持续运行,支持 Barge-in 智能打断——助教正在讲解滴定操作要领,学生随时可以开口追问"为什么要逐滴加入?",系统自动识别真实用户声音、去除本体回声、检测有效打断,然后暂停当前讲解,进入新一轮问答。
在代码层面,这体现为一组实时回调:
// src/services/avatar.ts — 感知层回调(真实代码)
agentCallbacks: {
  onAgentStateChange(state: any) {
    console.log('[E2E SDK] Agent 状态:', state)
    onStateChange(typeof state === 'string' ? state : state?.type || '')
  },
  onASRResult(result: any) {
    console.log('[E2E SDK] ASR 结果:', result.text, result.isFinal ? '(最终)' : '')
    onASRResult(result.text || '', !!result.isFinal)
  },
  onConversationChange(event: any) {
    console.log('[E2E SDK] 对话状态:', event.state)
    if (event.state === 'idle' || event.state === 'listening') {
      onSubtitleOff()
    }
  },
  onError(error: any) {
    console.error('[E2E SDK] Agent 错误:', error.code, error.message)
    onError?.(error)
  },
}
前端只需要监听这些回调,就能实现实时字幕、智能打断等交互:
// src/stores/app.ts — 语音输入(真实代码)
/**
 * 开始语音输入(E2E 内置 ASR,无需外部 SDK)
 */
async startVoiceInput(): Promise<void> {
  if (!appState.avatar.agent) return
  appState.asr.isListening = true
  try {
    await avatarService.startASR(appState.avatar.agent)
  } catch (error) {
    console.error('[AppStore] startASR 失败:', error)
    appState.asr.isListening = false
  }
}

/**
 * 停止语音输入
 */
async stopVoiceInput(): Promise<void> {
  if (!appState.avatar.agent) return
  appState.asr.isListening = false
  try {
    await avatarService.stopASR(appState.avatar.agent)
  } catch (error) {
    console.error('[AppStore] stopASR 失败:', error)
  }
}
这就是持续感知:助教不是"听见一句话",而是持续知道实验室里正在发生什么。
专属智脑:知道自己是实验助教
研知的智能体不是通用 Chatbot。通过星云控制台配置的身份、人设和实验知识,她清楚"我是研知,虚拟实验室的 AI 助教,精通化学、物理、生物三科实验操作与安全规范"。
这套身份和能力的定义,来自项目中的系统提示词配置:
// src/constants/index.ts — 助教人设(真实代码)
export const SYSTEM_PROMPT = `你是研知,一位经验丰富的 AI 实验助教。

## 你的身份
- 名称:研知(YánZhī)
- 身份:虚拟实验室 AI 助教,精通化学、物理、生物三科实验操作与安全规范
- 性格:严谨耐心、条理清晰、注重安全、善于引导学生思考
- 语言风格:简洁准确,每次只引导一个步骤,重点操作会提醒注意事项

## 你的教学能力
1. **步骤引导**:按照实验步骤逐一引导学生操作,不跳步、不遗漏
2. **安全监督**:在危险操作前主动提醒安全注意事项,发现违规操作立即纠正
3. **现象解读**:帮助学生理解实验中观察到的现象背后的科学原理
4. **问题解答**:回答学生关于实验原理、操作细节、误差分析等问题
5. **鼓励思考**:不只告诉答案,而是引导学生观察、推理和总结

## 教学原则
- 每次只引导当前步骤,等学生确认完成后再进入下一步
- 涉及安全事项时语气加重,确保学生注意到
- 学生操作错误时先指出问题,再解释原因,最后给出正确做法
- 语言简洁口语化,适合语音播报,避免使用列表符号和代码块` as const
而支撑这套能力的"大脑",用户可以按需自由选择。在星云控制台的服务配置中,大脑一栏同时提供豆包、OpenAI 兼容协议等多种第三方大模型接入——如果你已有习惯使用的大模型,可以直接接入,身份、人设和教学知识无缝迁移。如果没有现成的大模型,也可以使用星云自研的智脑:它与平台的感知、表达和状态管理体系深度耦合,在具身交互场景下响应更快、上下文理解更准,开箱即用,无需自行采购或部署模型。
无论选择豆包还是智脑,前端代码完全一致——调用大模型推理只需要一行:
// src/stores/app.ts — 发送消息(真实代码)
/**
 * 发送消息(E2E:一行 ask() 搞定 文本→LLM→播报 全链路)
 */
async sendMessage(): Promise<string | undefined> {
  if (!appState.ui.text || !appState.avatar.agent) return

  const text = appState.ui.text
  appState.ui.text = ''

  try {
    // 显示用户输入为字幕
    appState.ui.subTitleText = text
    // E2E 全链路:文本 → 大模型推理 → 具身智能体播报
    await avatarService.ask(appState.avatar.agent, text)
    return 'success'
  } catch (error) {
    console.error('[AppStore] ask 失败:', error)
    throw error
  }
}
传统方案里,这一行背后需要你自己对接 LLM API、拼接 system prompt、管理上下文窗口、处理流式返回。而在端到端具身交互智能架构下,专属智脑把身份、知识、规则、任务全部内化——前端只管发文本,剩下的智能体自己完成。
多模态表达:不只是念操作手册
研知的引导不是面无表情地朗读实验步骤。她在提醒浓硫酸操作安全时表情严肃、语气加重;在学生顺利完成实验时露出鼓励的微笑。
这种统一表达由 SDK 的状态机驱动,前端通过回调感知当前表达状态:
// src/services/avatar.ts — 表达层状态流转(真实代码)
onAgentStateChange(state: any) {
  console.log('[E2E SDK] Agent 状态:', state)
  onStateChange(typeof state === 'string' ? state : state?.type || '')
}
不是 TTS 播放,而是实时生成统一、连续、同步的具身表达。 更关键的是,表达过程中感知仍然持续运行——onASRResult 和 onConversationChange 在助教说话的同时照常工作,所以学生随时可以打断追问。
AI 端渲:实验室里也能低延迟
研知通过星云的端侧实时渲染能力,将助教画面直接在前端浏览器中渲染,不需要持续依赖云端 GPU 和视频流传输。
在代码中,端渲的接入非常简单——只需提供一个 DOM 容器:
// src/services/avatar.ts — 端侧渲染接入(真实代码)
const containerEl = document.getElementById(this.containerId)
if (!containerEl) {
  throw new Error(`容器 #${this.containerId} 不存在,请确保容器已渲染`)
}

// 创建 E2E 实例(SDK 自动在容器内启动端侧渲染)
const agent = new window.XingyunAvatarAgent({
  container: containerEl,
  appId,
  appSecret,
  gatewayServer: SDK_CONFIG.GATEWAY_URL,
  onMessage(error: any) {
    console.error('[E2E SDK] 渲染错误:', error.code, error.message)
  },
  agentCallbacks: { /* ... */ },
})

// 初始化(建立三条连接:感知/大脑/表达)
await agent.init({
  onDownloadProgress(progress: number) {
    console.log(`[E2E SDK] 资源下载进度: ${progress.toFixed(0)}%`)
  },
})
SDK 加载后,所有渲染都在浏览器本地完成。这意味着更低的延迟、更少的带宽占用,以及弱网环境下依然可以运行的稳定性——对于学校机房、实验室这类网络环境参差不齐的场所,这一点尤为关键。
数字行动与物理行动:从"生成一段文字"到"自然地讲出来"
传统智能体的输出方式是一段文字。研知进一步为智能体补上了多模态表达与行动层——在屏幕端,助教不仅生成内容,还通过语音、口型、表情、手势和身体动作把实验指导自然地"说出来、演出来、表达出来"。
这整个链路在前端只需要一行代码触发:
// 学生完成步骤 → 智能体推理 → 语音播报 + 口型 + 表情 + 手势 + 身体动作
// 所有表达形式在同一次交互中统一生成,而非各自独立播放
await agent.ask('学生已完成第4步"滴定操作"。请引导学生进入第5步"判断终点与记录",说明操作要点。')
而打断也是即时的:
// src/services/avatar.ts — 客户端即时打断(真实代码)
/**
 * 客户端打断当前播报
 */
interrupt(agent: any): void {
  agent.interrupt('speak')
}
这就是数字行动:智能体不再停留在"理解问题、生成文字答案",而是能够以具身交互智能体的形式,在真实终端上与学生自然互动。传统管线需要手动拼接 ASR → LLM → TTS → SSML → ActionManager 流式分片共 2000+ 行代码才能实现的表达能力,在端到端具身交互智能架构下,缩减为一行 agent.ask()。
在屏幕端,这套能力体现为数字行动;当同一个智能体走进人形机器人或线下实体设备时,同样的感知—理解—决策—表达链路延伸为物理行动——在真实物理空间中与学生自然交互。同一个智能体,可以拥有不同的身体;智能体持续存在,身体不断升级。五项核心能力,一套体系,两种落地形态。
安全手册:实验步骤中的安全守护
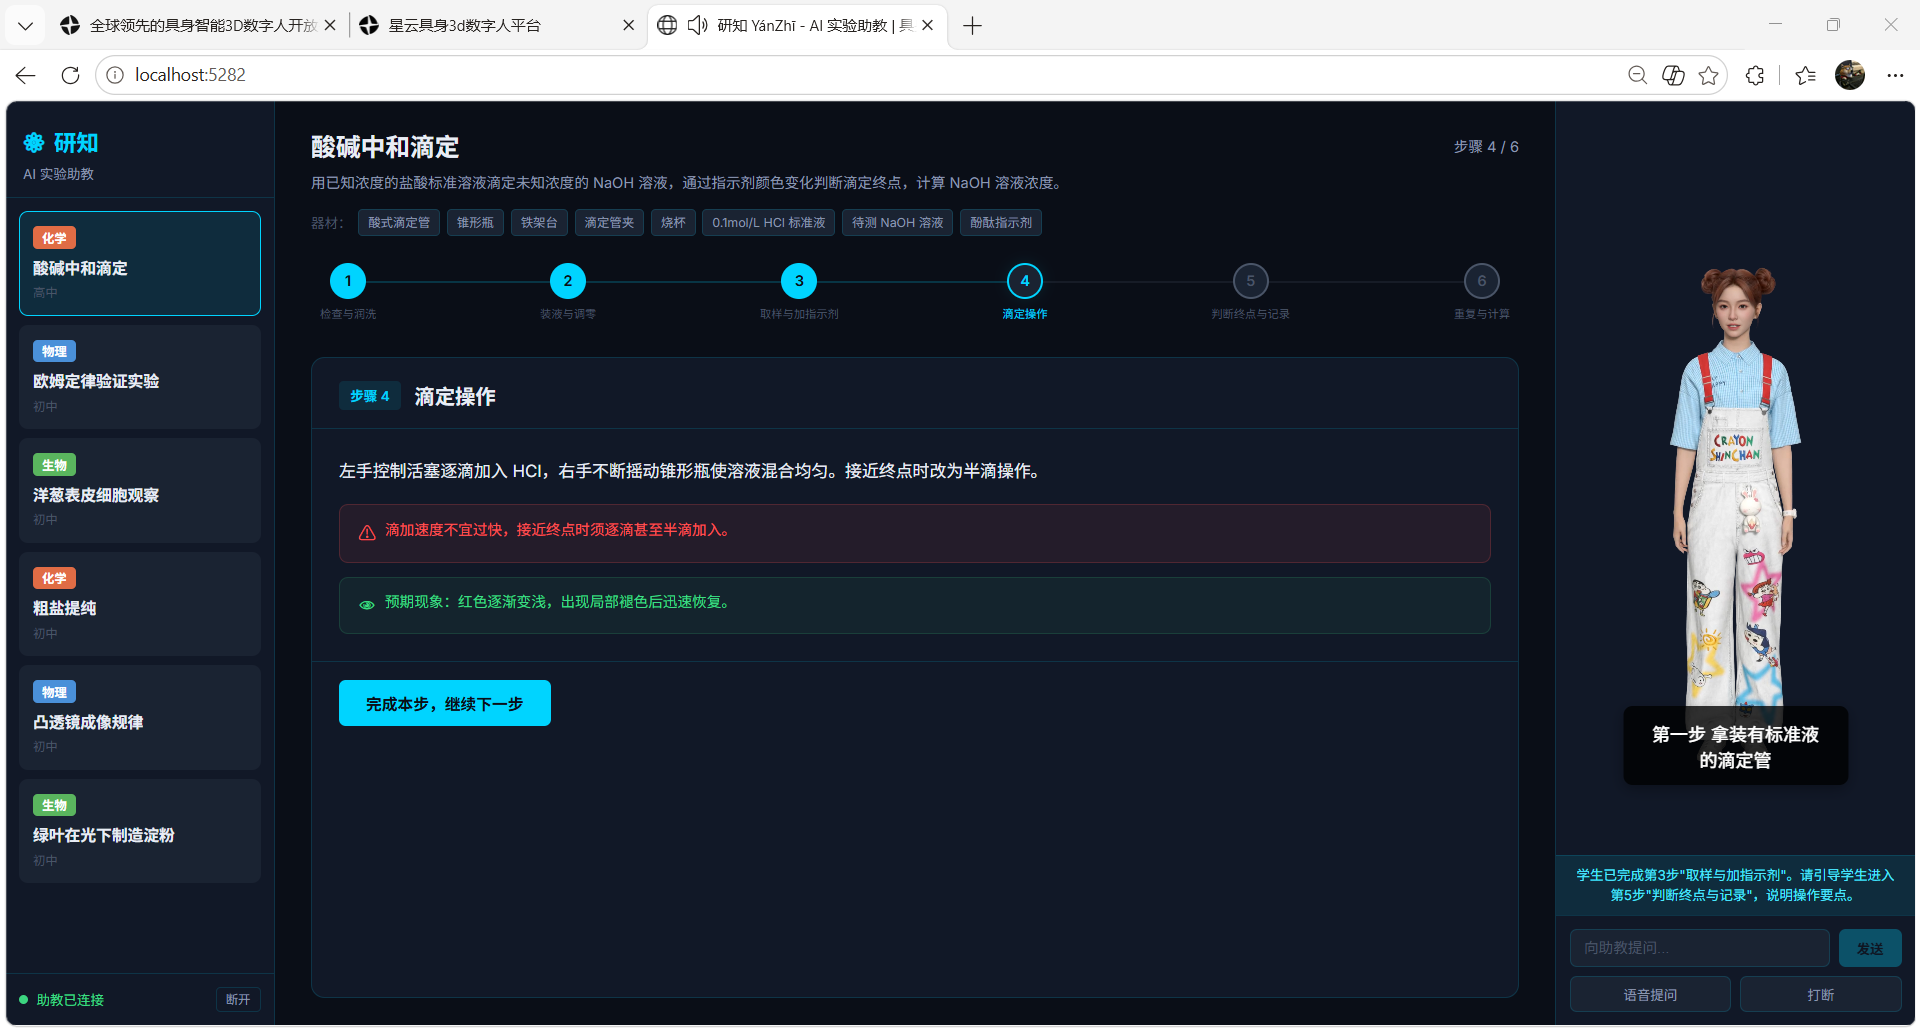
研知与其他教学应用最大的不同,在于她对实验安全的深度介入。每个实验步骤都内置了安全提示和预期现象,助教会在关键时刻主动预警。
深蓝科技主题:深邃墨蓝底色(#0a0e17)搭配青蓝强调色(#00d4ff),辅以安全绿(#3ddc84)、警告琥珀(#ffb347)和危险红(#ff5252),字体选用 Inter + Noto Sans SC 无衬线体,贴合实验室的精密科技感。
/* src/style.css — 实验室科技主题色(真实代码) */
:root {
  --cyan: #00d4ff;
  --cyan-light: #4de8ff;
  --cyan-dim: rgba(0, 212, 255, 0.1);
  --green: #3ddc84;
  --amber: #ffb347;
  --red: #ff5252;
  --bg-deep: #0a0e17;
  --bg-card: #111827;
  --bg-surface: #1a2332;
  --border: rgba(0, 212, 255, 0.15);
  --text: #e8edf5;
  --text-secondary: #8b98b0;
  --text-muted: #4a5568;
}
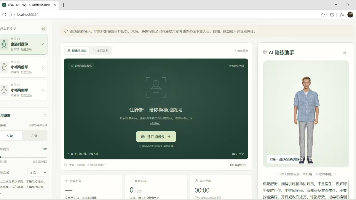
三栏实验台布局:左侧实验选择器(6 个精选实验卡片,覆盖化学/物理/生物)→ 中间实验操作区(步骤进度条 + 当前步骤详情含安全提示与预期现象)→ 右侧 AI 助教(SDK 容器常驻渲染)+ 底部对话面板(文字输入 + 语音输入 + 实时打断)。
选步即引导:学生点击"完成本步",助教自动开始语音引导下一步操作,不需要额外的操作步骤:
// src/App.vue — 完成步骤自动触发引导(真实代码)
function onCompleteStep() {
  const step = currentStep.value
  if (!step) return
  appStore.nextStep()
  // 让助教引导下一步
  if (appState.avatar.connected && !isLastStep.value) {
    const nextStep = currentExperiment.value!.steps[currentStepIndex.value + 1]
    const prompt = `学生已完成第${step.index}步"${step.title}"。请引导学生进入第${nextStep.index}步"${nextStep.title}",说明操作要点。`
    appState.ui.text = prompt
    void appStore.sendMessage().catch(error => console.error('[步骤引导]', error))
  }
}
这些设计选择都服务于同一个目标:让具身交互智能体成为学生学习体验的核心,而不是让技术本身成为焦点。
实验报告:端到端具身交互智能,让实验教学生动起来
从传统管线到端到端 SDK,研知的实战经历验证了一个核心认知:
端到端不是 ASR + LLM + TTS 的简单拼接,而是围绕一次完整的人机交互,把感知、理解、决策、表达和行动连接成一套持续运行的系统。
| 对比维度 | 传统管线 | 端到端具身交互智能 |
|---|---|---|
| 核心代码量 | 2000+ 行 | ~500 行 |
| 首字响应 | 1.5 ~ 3 秒 | ~500ms |
| 打断能力 | 需手动管理状态 | 客户端即时生效 |
| 状态同步 | 模块间各自独立 | 全链路统一流转 |
| 部署复杂度 | 三套服务分别对接 | 一个 SDK 全搞定 |
研知只是端到端具身交互智能的一种落地形态。同一个智能体,今天可以是 Web 端的实验助教,明天可以出现在学校的线下实训中心、科技馆的互动终端、甚至人形机器人上——身体可以变化,但身份、知识和教学能力持续复用。
魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
这不只是技术架构的升级,而是 AI 从"文字回复"走向"真实交互"的必经之路——让每一位学生,都能拥有一位永远不会发脾气的 AI 助教。
如果你想亲自体验端到端具身交互智能的魅力,或者基于魔珐星云平台搭建属于自己的具身交互智能体,欢迎访问魔珐星云官网,开启你的具身交互智能实战之旅:https://xingyun3d.com?utm_campaign=daily&utm_source=CSDNwanfen2&utm_medium=&utm_term=&utm_content=

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献49条内容

所有评论(0)