PUBG‑Ally:具备对话能力的具身游戏AI队友智能体
PUBG‑Ally:具备对话能力的具身游戏AI队友智能体
arXiv编号:arXiv:2609.29837v1
摘要
本文介绍PUBG‑Ally(简称Ally),部署在《绝地求生》中的语音交互具身智能体,它可以自主推理、执行游戏动作,作为AI队友和真人玩家并肩作战。开发该AI队友需要同时攻克两大难点:严格延迟约束下感知持续变化的游戏世界,同时和玩家开展自然语音交互;语音输出必须和自身游戏行为保持同步一致。
为此本文设计双层智能体架构:语言模型智能体通过受控工具接口读取游戏信息、解析玩家语音、维护上下文,决定对话内容并输出高层动作指令;底层高速控制层负责执行对延迟敏感的移动、战斗、救援动作。
训练该系统面临独特的数据挑战:真人玩家与Ally的语音、动作会持续互相影响,共同塑造对局走向,因此必须采集真实玩家参与的对局数据。本研究累计收集近39000场真实玩家与Ally共同游玩的会话,完整记录游戏过程、玩家语音、智能体决策、工具调用、动作执行以及玩家反馈,用于迭代训练与系统改进。
队友质量不能只靠战斗指标、指令完成率衡量,本文基于玩家偏好与问卷反馈迭代完善评测体系,对齐真实玩家对于AI队友的实际价值诉求。产品落地需要设备端低延迟运行、面向玩家对话的安全防护;通过模型压缩、上下文精简、定向安全训练、运行时防护栅栏、记忆内容脱敏实现上述需求。设备端单轮语音交互耗时约1.6s,云端版本为3.4s。
在面向141个国家玩家的公开Beta测试中,确认有对局记录的受访者,推荐意愿正面反馈较负面高出25.1个百分点;有50%的受访者将Ally认知为“队友”或者“伙伴”。据调研,Ally是首款商用大逃杀游戏内、模型全部设备端本地运行的对话式具身AI队友;该架构思想也已经迁移到实体机器人项目Ludi 0.1。
关键词
具身智能体;游戏AI;双层系统1‑系统2架构;设备端小语言模型;人机协同;语音交互;真实玩家数据采集;游戏AI队友
目录
1 引言
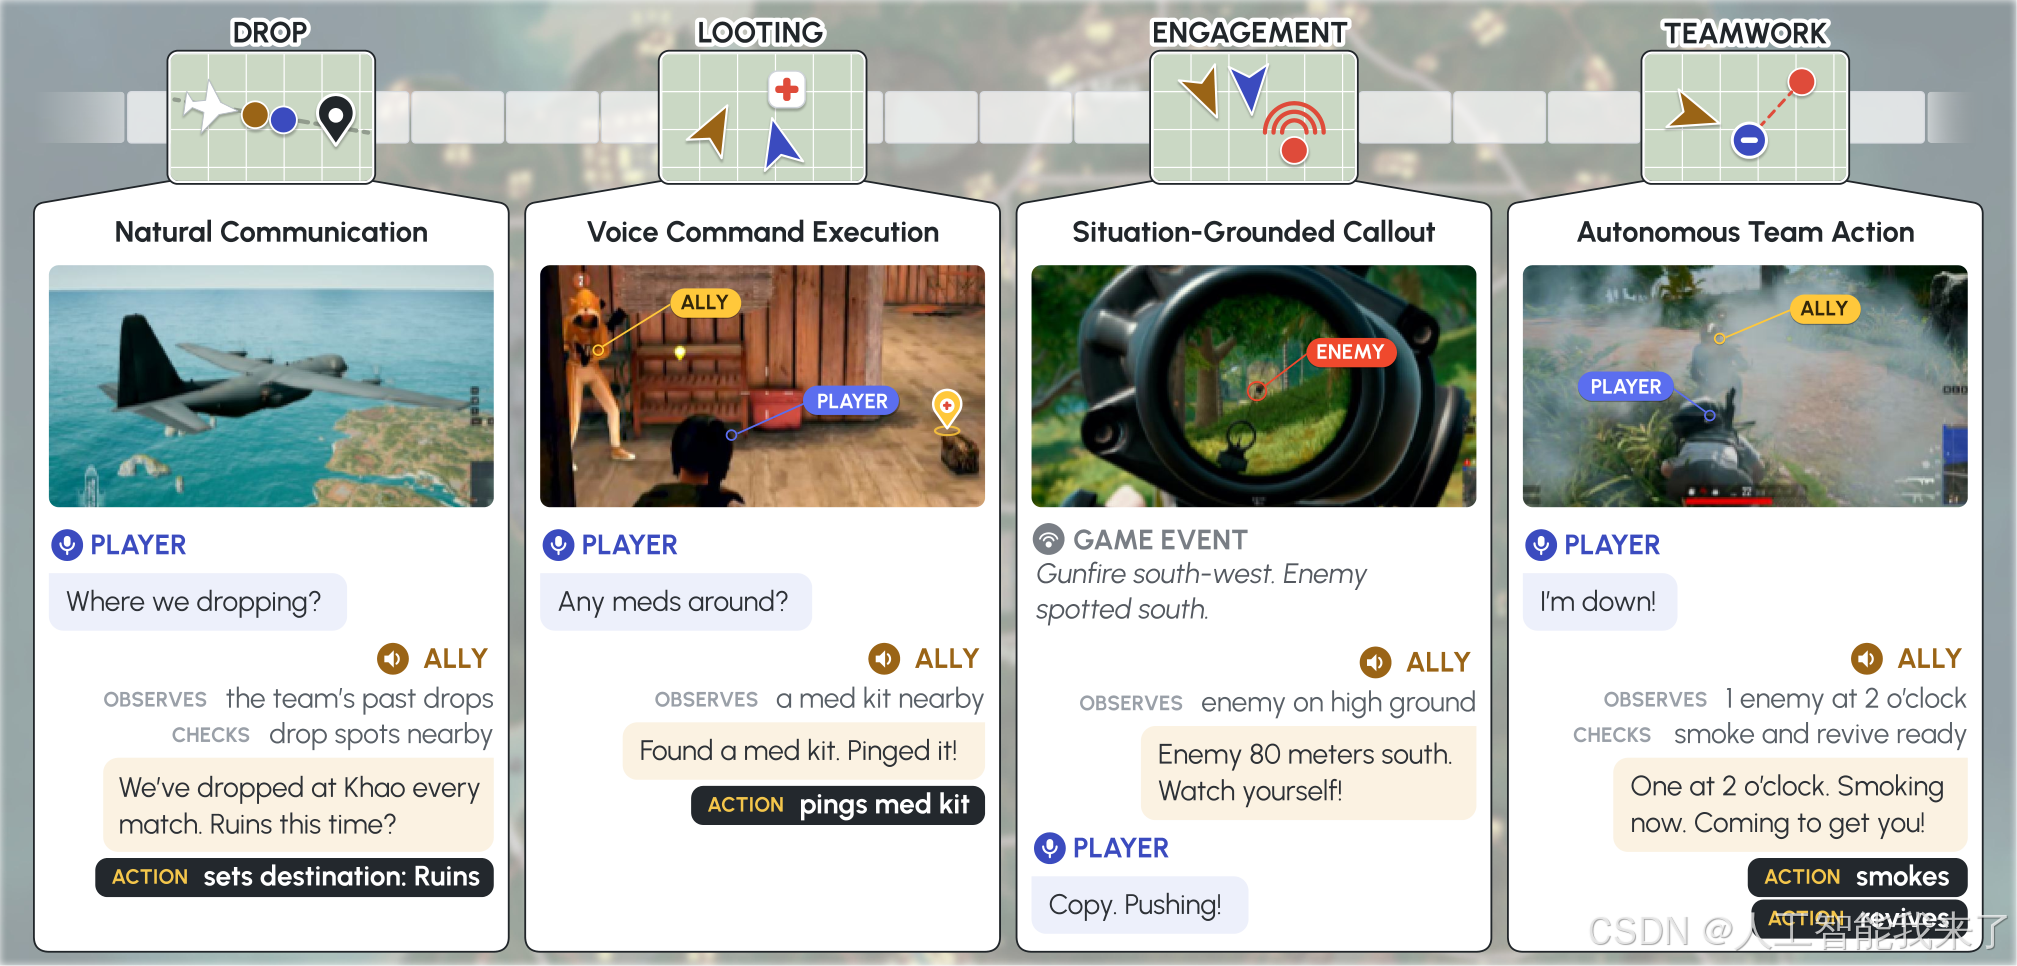
大逃杀游戏PUBG中双人模式需要两名队友协同跳伞、搜集物资、交战、互相救援。Ally作为可共玩角色(Co‑Playable Character,CPC),和真人玩家组成小队,通过语音沟通,自主完成游戏行为。典型交互包括:协商跳伞落点、响应语音指令搜集物资、报点敌人、交火掩护、倒地后释放烟雾进行救援。
现有游戏AI大多聚焦纯自主对局;Ally的核心难点:持续和真人队友语音交互,同时游戏环境高速动态变化,语言输出必须和实际游戏动作保持同步,不能出现言行不一致。
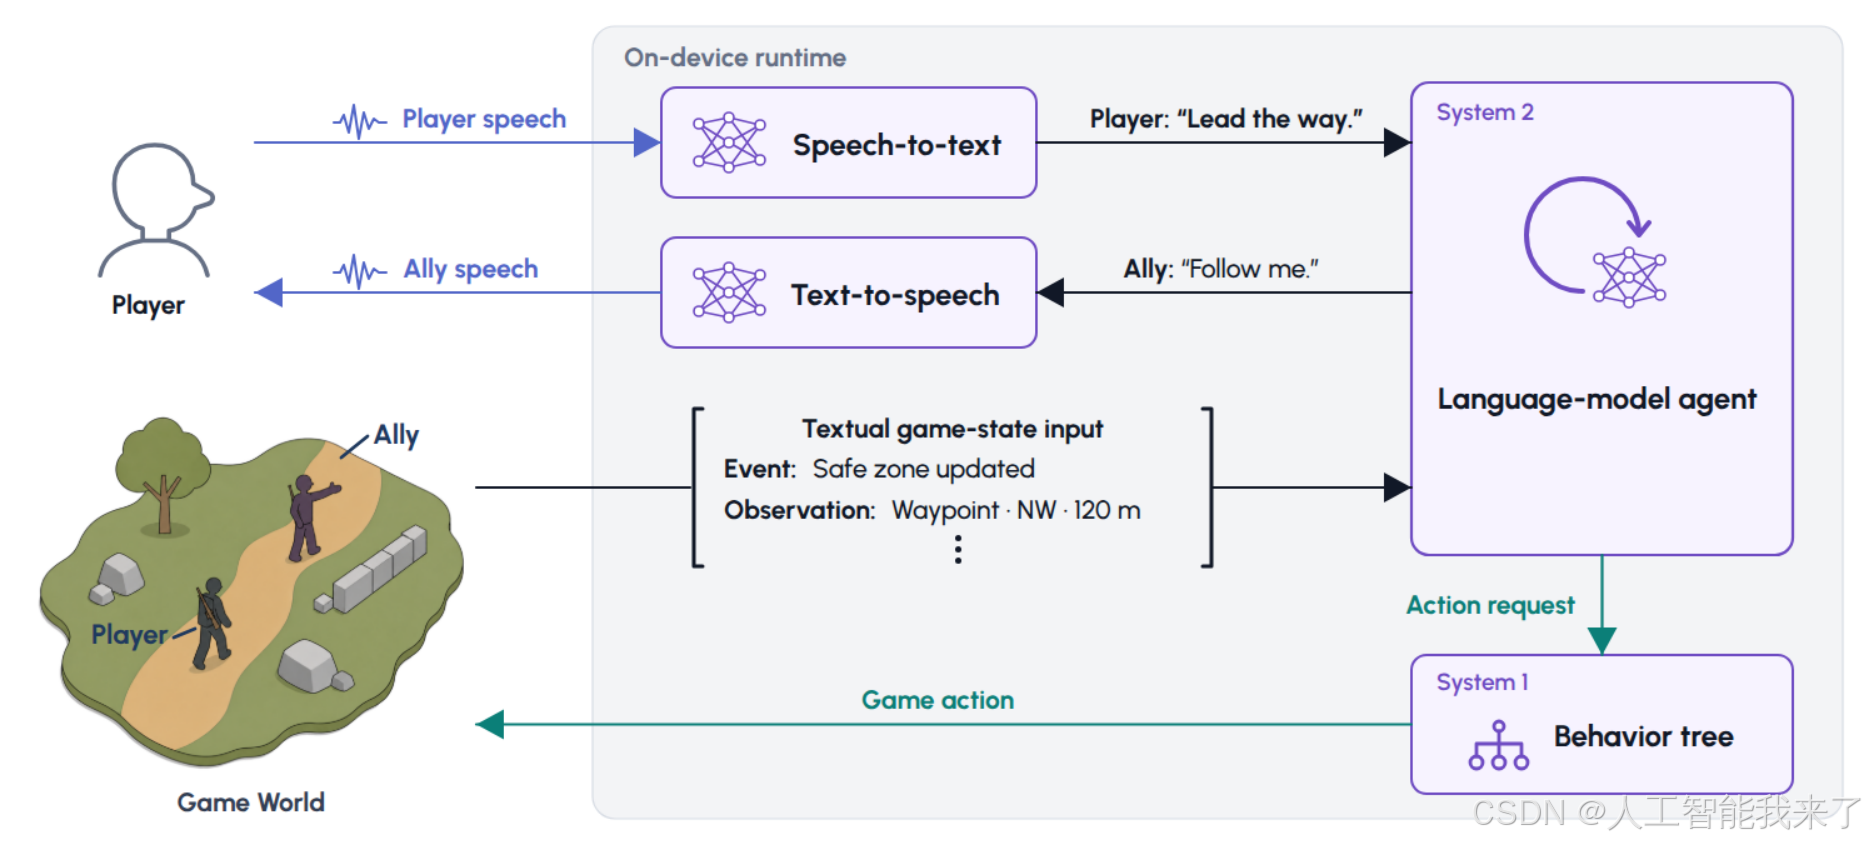
本文采用卡尼曼System1‑System2双系统思想:
- System2(思考层):语言模型智能体;接收游戏事件、玩家语音,做高层推理,输出对话内容与高层动作请求;不在游戏每帧循环内运行。
- System1(执行层):行为树;接收高层意图,以游戏帧频率执行移动、战斗、救援等对延迟敏感的底层行为。两层互相通信,System2下发意图,System1反馈实时状态。
数据难点:玩家和AI的行为互相影响,改变后续对局走向,不能只依靠静态仿真脚本;需要采集真实人类参与的完整对局。本项目在韩国游戏网吧招募1046名参与者,累计采集38956场完整会话。训练流程借鉴DAgger思想:先用31B教师模型采集示范数据;再迭代训练设备端可部署2B小模型;学生模型遇到的新状态,由教师模型生成修正样本加入训练集。
评测难点:AI队友好坏,不能只用击杀、任务完成率衡量,还要看响应度、自然度、协作感。本文利用玩家问卷反馈迭代评测标准,对齐玩家真实诉求。
生产部署难点:全部语言、语音模型运行在玩家本地设备;需要模型压缩、上下文精简;同时做上下文安全防护,区分正常游戏战斗话术与现实世界有害言论。
本文主要贡献
- 一套对话式具身游戏智能体双层架构:受控工具接口 + System1/System2分层控制,兼顾大模型高层推理与游戏实时控制。
- 大规模真实人机交互数据集,近39k场真实玩家对局;基于教师示范+教师修正学生轨迹完成设备端小模型训练。
- 以玩家偏好为核心的队友质量评测框架,覆盖对话质量、游戏行为、团队协作。
- 面向游戏场景的上下文感知安全机制,区分游戏内战斗话术和现实世界有害内容。
- 完整工程落地方案,实现多语言Beta公测,模型全部本地设备端运行。
2 PUBG双人模式与部署环境
2.1 双人对局模式
PUBG双人模式,两名玩家组队,跳伞落地搜集物资,安全圈持续收缩,需要沟通落点、转移路线、交战策略;可以互相丢物资、救援倒地队友。
AI队友需要处理隐式口语指令、游戏黑话、地名;跨轮次记忆玩家偏好;语音输出必须和当前游戏行为对齐,不能出现过时信息;响应必须低延迟。
2.2 部署配置
- 地图:萨诺(Sanhok)双人64人对局;支持英语、韩语、中文。
- 交互方式:按键通话Push‑to‑Talk;
- 硬件要求:消费级显卡至少8GB显存,所有STT、TTS、小语言模型SLM设备端本地运行,消除网络往返延迟。
- 性能:本地设备端单轮语音交互约1.6s;云端推理版本约3.4s。
3 PUBG‑Ally系统架构
3.1 分层智能体总架构
- System2(事件驱动语言模型层):不会固定按游戏帧频率触发;由事件驱动;通过工具接口获取文本化游戏状态,输出对话与高层动作请求。
- System1(行为树实时执行层):每游戏帧执行;接收System2高层意图,完成移动、战斗、救援;向System2反馈执行状态。
两层双向通信:System2下发意图;System1回传实时游戏状态;语言模型不在延迟敏感的游戏主循环。
3.2 System2:事件驱动智能体执行框架
受控工具接口
不把完整原始游戏画面/状态直接喂给模型;提供16个工具,分为6大类:
| 功能分组 | 工具数量 | 说明 | 示例 |
|---|---|---|---|
| 对局观测 | 7 | 获取战斗、装备、标记点等聚焦信息 | get_combat_info() 返回敌人方位距离 |
| 知识与记忆 | 2 | 游戏知识库查询、持久化玩家记忆读写 | lookup_game_knowledge("M416")武器说明 |
| 动作执行 | 2 | 检查动作可用性、下发高层动作 | execute_action(move_to, dest) 移动至目标点 |
| 玩家通信 | 3 | 语音输出、简短应答、开关语音 | speak("Need cover.")TTS输出语音 |
| 智能体循环控制 | 1 | 压缩保存未完成计划,移交下一轮循环 | compact("Revive, then clear enemy") |
| 安全控制 | 1 | 标记不安全输入用于脱敏 | flag_unsafe(privacy) |
运行约束:执行动作前先调用可用性检查;无法观测的信息直接回复不可用,禁止模型编造信息。
智能体循环与事件调度
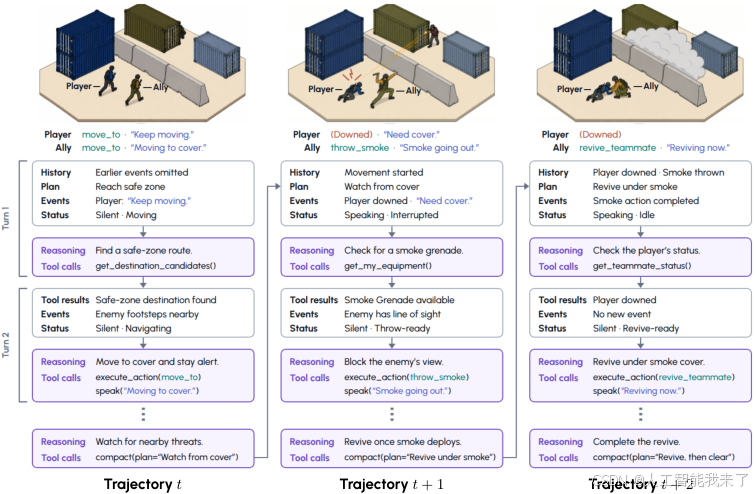
- Agent‑loop智能体循环:收到事件(玩家语音、游戏状态变更、工具返回)执行一轮模型推理;循环结束调用
compact(),将未完成计划压缩保存,移交下一轮循环。 - 事件驱动调度:不固定时钟触发;事件进入队列,区分优先级;高优先级优先处理,队列过载丢弃低优先级事件。
- 反应度先验(Reactivity priors):针对每一类事件,分别配置「是否应该说话」「是否应该执行动作」的优先级;例如玩家倒地事件要求必须语音响应,推荐执行救援动作。
- 受控主动性Proactivity:设置事件冷却时间,避免AI无意义频繁插话;既可以主动支援队友,又不会过度打断游戏。
跨循环上下文管理
- 实时观测得到的游戏状态不跨循环持久保存,避免过时信息;需要时重新调用观测工具。
- 未完成任务、对玩家承诺、待办计划通过
compact()压缩后跨循环保留。 - Prompt布局做缓存友好优化:系统提示、工具定义放在最前面,动态事件放在后方;事件历史批量截断,提升KV缓存复用效率;上下文预算约5000 tokens。
3.3 System1:有状态实时控制层
基于行为树实现;每游戏帧求值;高层意图转换为底层移动、瞄准、开火、救援、投掷烟雾弹。
- 支持抢占:高优先级事件(自身血量危急、队友倒地)可以打断当前正在执行的任务。
- 动作完成/失败/被抢占时,生成事件反馈上报给System2语言模型层。
附录C包含行为树完整实现语义。
4 数据采集与训练流程
4.1 真实玩家数据采集
在韩国线下游戏网吧开展28天采集;1046名参与者,总计38956场对局会话;单场对局平均14.1分钟,平均59次智能体循环轨迹。
采集内容:玩家语音、游戏事件、工具调用请求、工具返回、Ally输出语音、执行的全部游戏动作;对局结束同步采集玩家问卷反馈。
训练数据分为两类来源:
- 教师模型轨迹:Gemma‑4‑31B作为教师模型,配合GEPA提示优化,和真人玩家对局采集示范数据;
- 学生模型运行轨迹:迭代部署各版本设备端学生模型;学生遇到的新状态,使用教师模型重新生成修正轨迹。
4.2 多阶段训练流水线
借鉴DAgger思想,解决分布偏移:学生模型行为会改变游戏环境,出现教师示范里未见过的状态。
训练分三阶段:
- 阶段(a):8B中间教师监督微调:使用教师原始轨迹硬标签训练8B中间教师模型。
- 阶段(b):离线知识蒸馏:用8B教师输出soft logits,离线蒸馏得到2B学生模型。
- 阶段©:智能体在线蒸馏:让2B学生模型执行交互,复现当时游戏上下文;8B教师对学生生成的整条轨迹给出soft目标,继续迭代优化学生模型。
不使用强化学习奖励;完全基于教师模型输出分布做蒸馏。
补充合成数据增强:补充稀有游戏场景、少见玩家指令样例;对数据集做质量过滤、样本均衡,压制高频重复事件样本权重。
各语言版本模型选型
| 地区 | 中间教师模型 | 部署学生模型 |
|---|---|---|
| 英语 | Mistral‑NeMo‑Minitron‑8B‑Instruct | Mistral‑NeMo‑Minitron‑2B‑128K‑Instruct |
| 韩语 | Kanana 1.5‑8b‑instruct | Kanana 1.5‑2.1b‑instruct |
| 中文 | Qwen3‑8B | Qwen3‑1.7B |
5 安全与生产防护机制
游戏场景安全存在特殊矛盾:游戏内模拟战斗、击杀话术属于正常协作;但要拦截映射到现实世界的仇恨、意识形态、人身伤害内容,不能简单关键词黑名单,否则会大量误拦截正常游戏对话。
- 安全分类规范:区分6类现实世界不安全类别,增加游戏内暴力安全豁免标签;默认把模棱两可的战斗话术判定为游戏内场景。不安全类别:意识形态敏感、仇恨言论、自残、现实世界伤害、隐私泄露、持续现实世界施压。
- 安全专项训练:基于规范生成合成样本,加入训练集。
- 运行时防护栅栏:工具
flag_unsafe()标记不安全内容,触发记忆脱敏,拒绝传播有害输出。 - 迭代式安全开发:线上捕获案例,迭代更新安全样例、评测用例。
6 评测体系
AI队友不能只看击杀数据;需要同时评估对话、协作、游戏行为;并且对齐真实玩家主观偏好。
- 能力评测:离线重放测试,评估跳伞、物资交互、报点、救援、语音响应等。
- 安全评测:区分游戏战斗话术与现实世界有害输入,统计误拒率、漏过率。
- 线上实测:线下网吧受控玩家实验,采集行为指标与问卷。
- 迭代优化评测标准:当离线评测结果和玩家真实偏好出现矛盾,回溯案例,修订评测标准,新增对应测试场景。
7 主要实验结果
- 离线能力评测:经过训练的版本,在跳伞协商、物资交互、战斗报点、倒地救援等任务指标显著优于早期基线。
- 安全评测:在保持游戏正常沟通前提下,有效拦截现实世界类有害输入,控制过度拒绝。
- 线下网吧实测:和离线评测趋势基本对齐,但部分离线表现不错的版本,玩家主观评价一般,证明单纯离线指标不能完全替代真实人在回路测试。
8 公开Beta版本玩家调研结果
面向141个国家开放Beta公测。
- 确认对局记录的受访者:推荐意愿正向反馈较负面高出25.1个百分点。
- 角色认知统计:18.5%选择“队友”,31.5%选择“伙伴”;合计50%玩家将Ally视为协作同伴,而不是单纯工具。
9 结论
PUBG‑Ally实现商用游戏中设备端本地运行的对话式具身AI队友。
- System1‑System2双层架构:语言模型负责高层推理对话;行为树负责帧级实时游戏控制;事件驱动调度,保障游戏动态环境下言行一致性。
- 大规模采集真实人机交互对局;借鉴DAgger的教师修正蒸馏流水线,训练得到多语言设备端小模型。
- 建立以玩家主观偏好为导向的评测框架;不能只依靠战斗指标衡量AI队友。
- 设计游戏场景专属上下文安全规范,区分游戏模拟暴力和现实世界有害内容,降低过度拒绝。
真实Beta测试证明该AI可以被玩家接纳为队友/伙伴;该架构已经迁移到实体机器人项目Ludi 0.1。
10 贡献者与致谢
完整作者列表、资助、第三方开源组件参见原文附录。
附录简要说明
- 附录A 背景与相关工作:基础模型产品智能体、游戏环境接口、商用AI游戏伙伴相关工作综述。
- 附录B 上下文压缩、KV缓存优化实现细节。
- 附录C 行为树引擎、执行语义、语言模型接口完整说明。
- 附录D 参与者招募、知情同意流程。
- 附录E 数据集划分、验证策略。
- 附录F 对局后问卷、反馈处理流程。
- 附录G 模型开销、部署硬件细节。
- 附录H 语音模型训练数据与适配。
- 附录I 基于玩家反馈自动修复执行框架的实现。
- 附录J 能力评测完整用例细节。
- 附录K 安全评测完整用例。
- 附录L Beta公测调研原始细分统计。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献16条内容

所有评论(0)