Show-Harness——仅凭一个VLM智能体即可操控机器人:12个语义动作单元(前进/旋转/抓取)既是模型的思考语言、又是机器人的物理指令
前言
基础型视觉-语言模型(VLMs)展现出对世界广泛的智能,但要将这种智能转化为机器人控制仍然充满挑战
对此,作者提出 Show-Harness,这是一种具身式 Harness,使VLM 能够通过一个紧凑的语义接口,将意图“操控”到机器人行为上
- Show-Harness暴露出离散的语义动作单元,VLM 可以自然地在其上进行推理,而具身相关的解释器则以确定性的方式将这些语义单元落地为局部机器人动作,从而让 VLM 直接对细粒度的物理决策负责
通过同一接口,Show-Harness 证明了以下两点的可行性: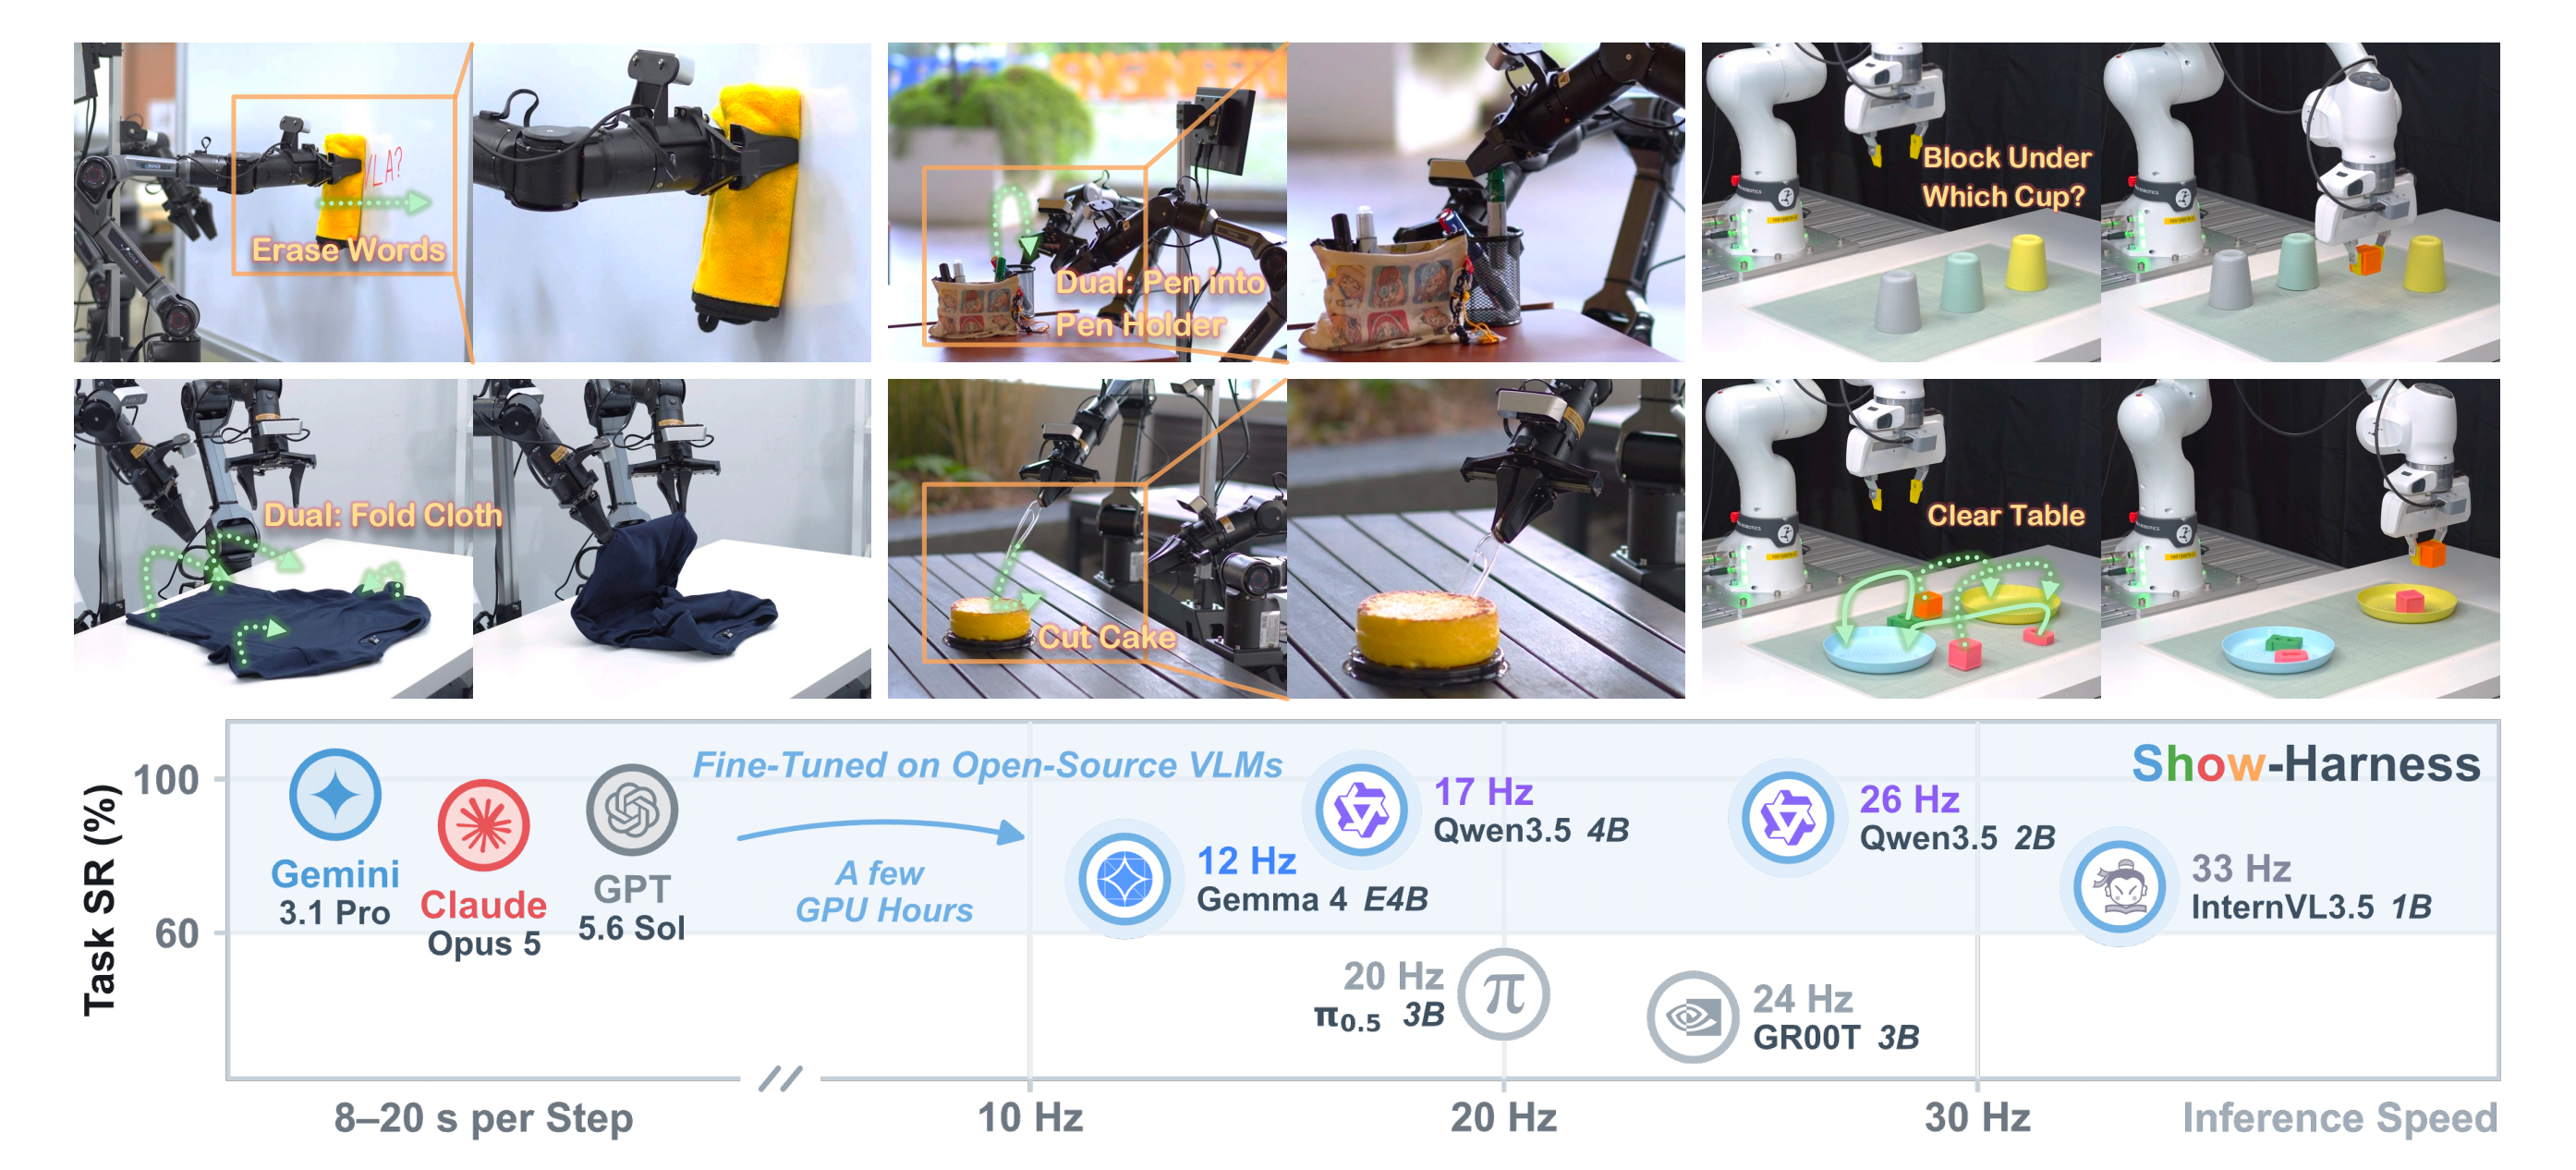
1)在零样本设置下,直接解锁闭源前沿 VLM 用于机器人控制;
2)只需少量GPU 小时的微调,就能将小规模开源 VLM 适配为低成本部署 - 且作者进一步提出GUMI(GUI Manipulation Interface,GUI 操作接口),将同一语义动作空间扩展到基于 GUI 的示教数据采集,使人类和智能体无需专用远程操控硬件即可在不同具身形态上“操控”机器人
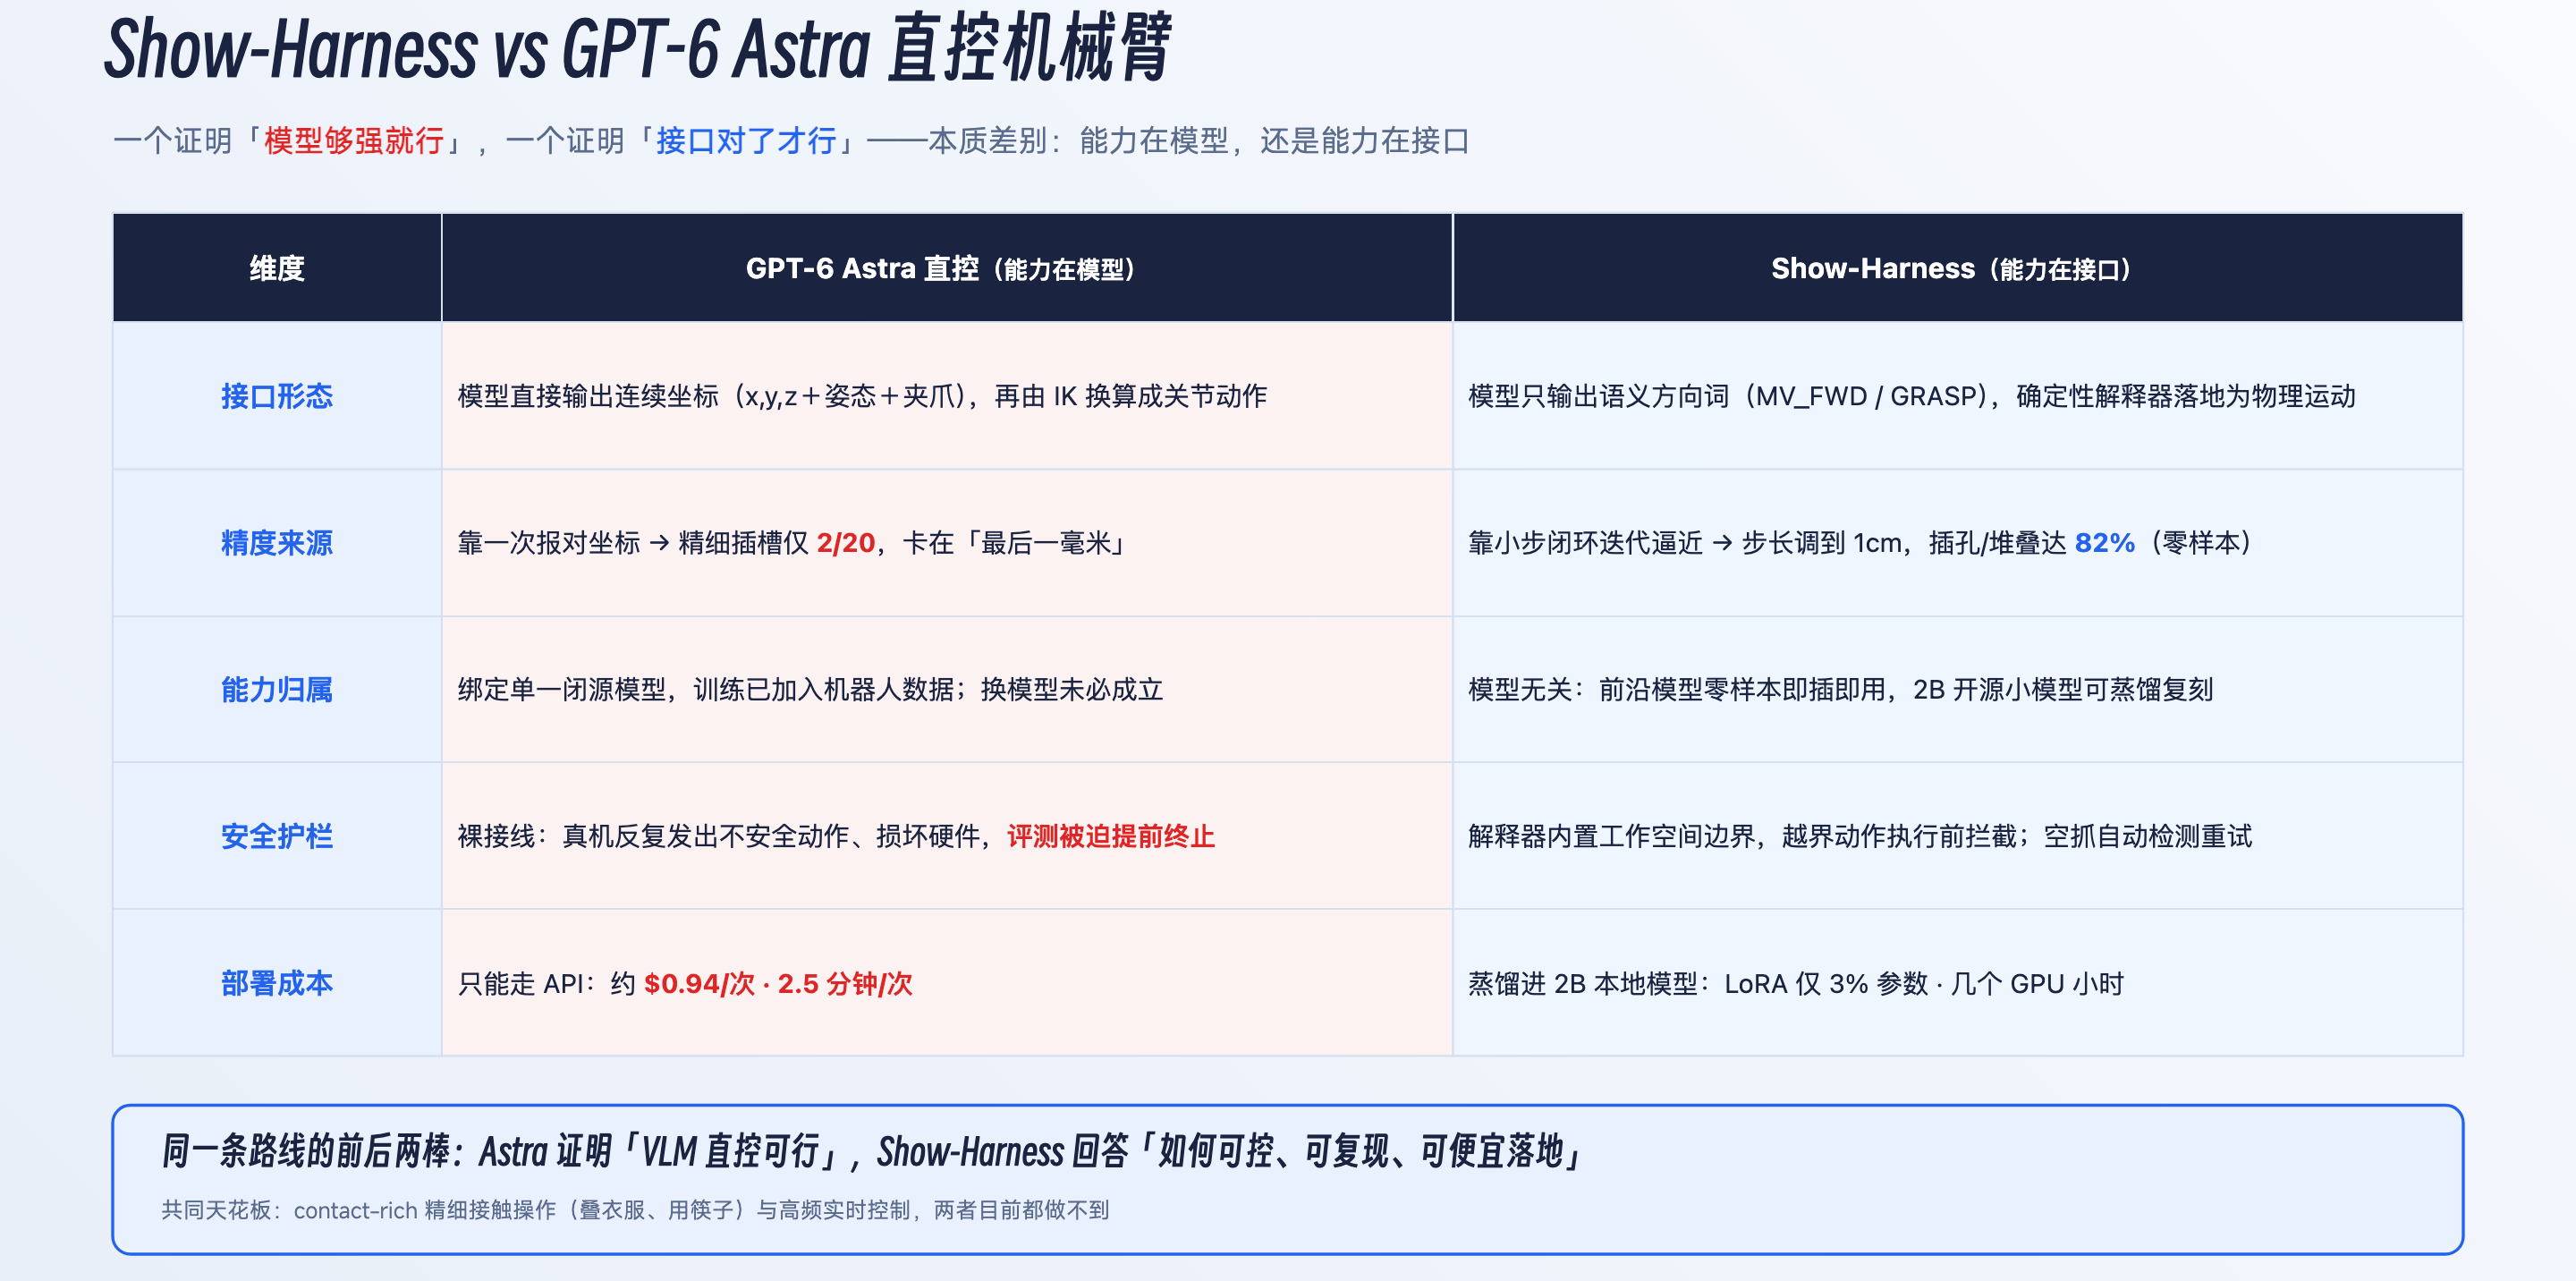
此外,其与近期大火GPT-6 Astra的本质区别在于
第一部分 Show-Harness: Just a VLM Agent Can Play Robots
1.1 引言与相关工作
1.1.1 引言
如原论文所说,基础视觉–语言模型(VLMs)已经编码了机器人操作所需的大部分能力,例如识别物体及空间关系,以及分解长时间跨度的目标 [24,40,82,97]
然而,这些知识却难以直接转化为机器人的实际行为
- 视觉–语言–动作模型(VLA)通过微调 VLM,使其回归与具体具身形式相关的连续动作,将其拉向低层控制
在这一过程中,广泛的语义知识被压缩为一种不透明的从像素到执行的映射,并且往往需要针对不同任务、环境和具身形式反复进行适配 [8,12,45,66] - 分层和程序化系统则走了相反的路线:由 VLM生成显式的中间抽象表示,包括子任务级别的调用 [1,37,76,92],以及基于人工设计控制 API 的程序 [15,36,54]
尽管这种方式在实践中是有效的,但物理控制是由下游控制器或特定系统机制来实现的,从而削弱了语义意图与物理执行之间的直接关联
作者认为,要将基础模型级的智能引入物理世界,就需要一个合适的接口:一种既对VLM 语义上有意义、又足够细粒度以实现直接物理控制的动作空间
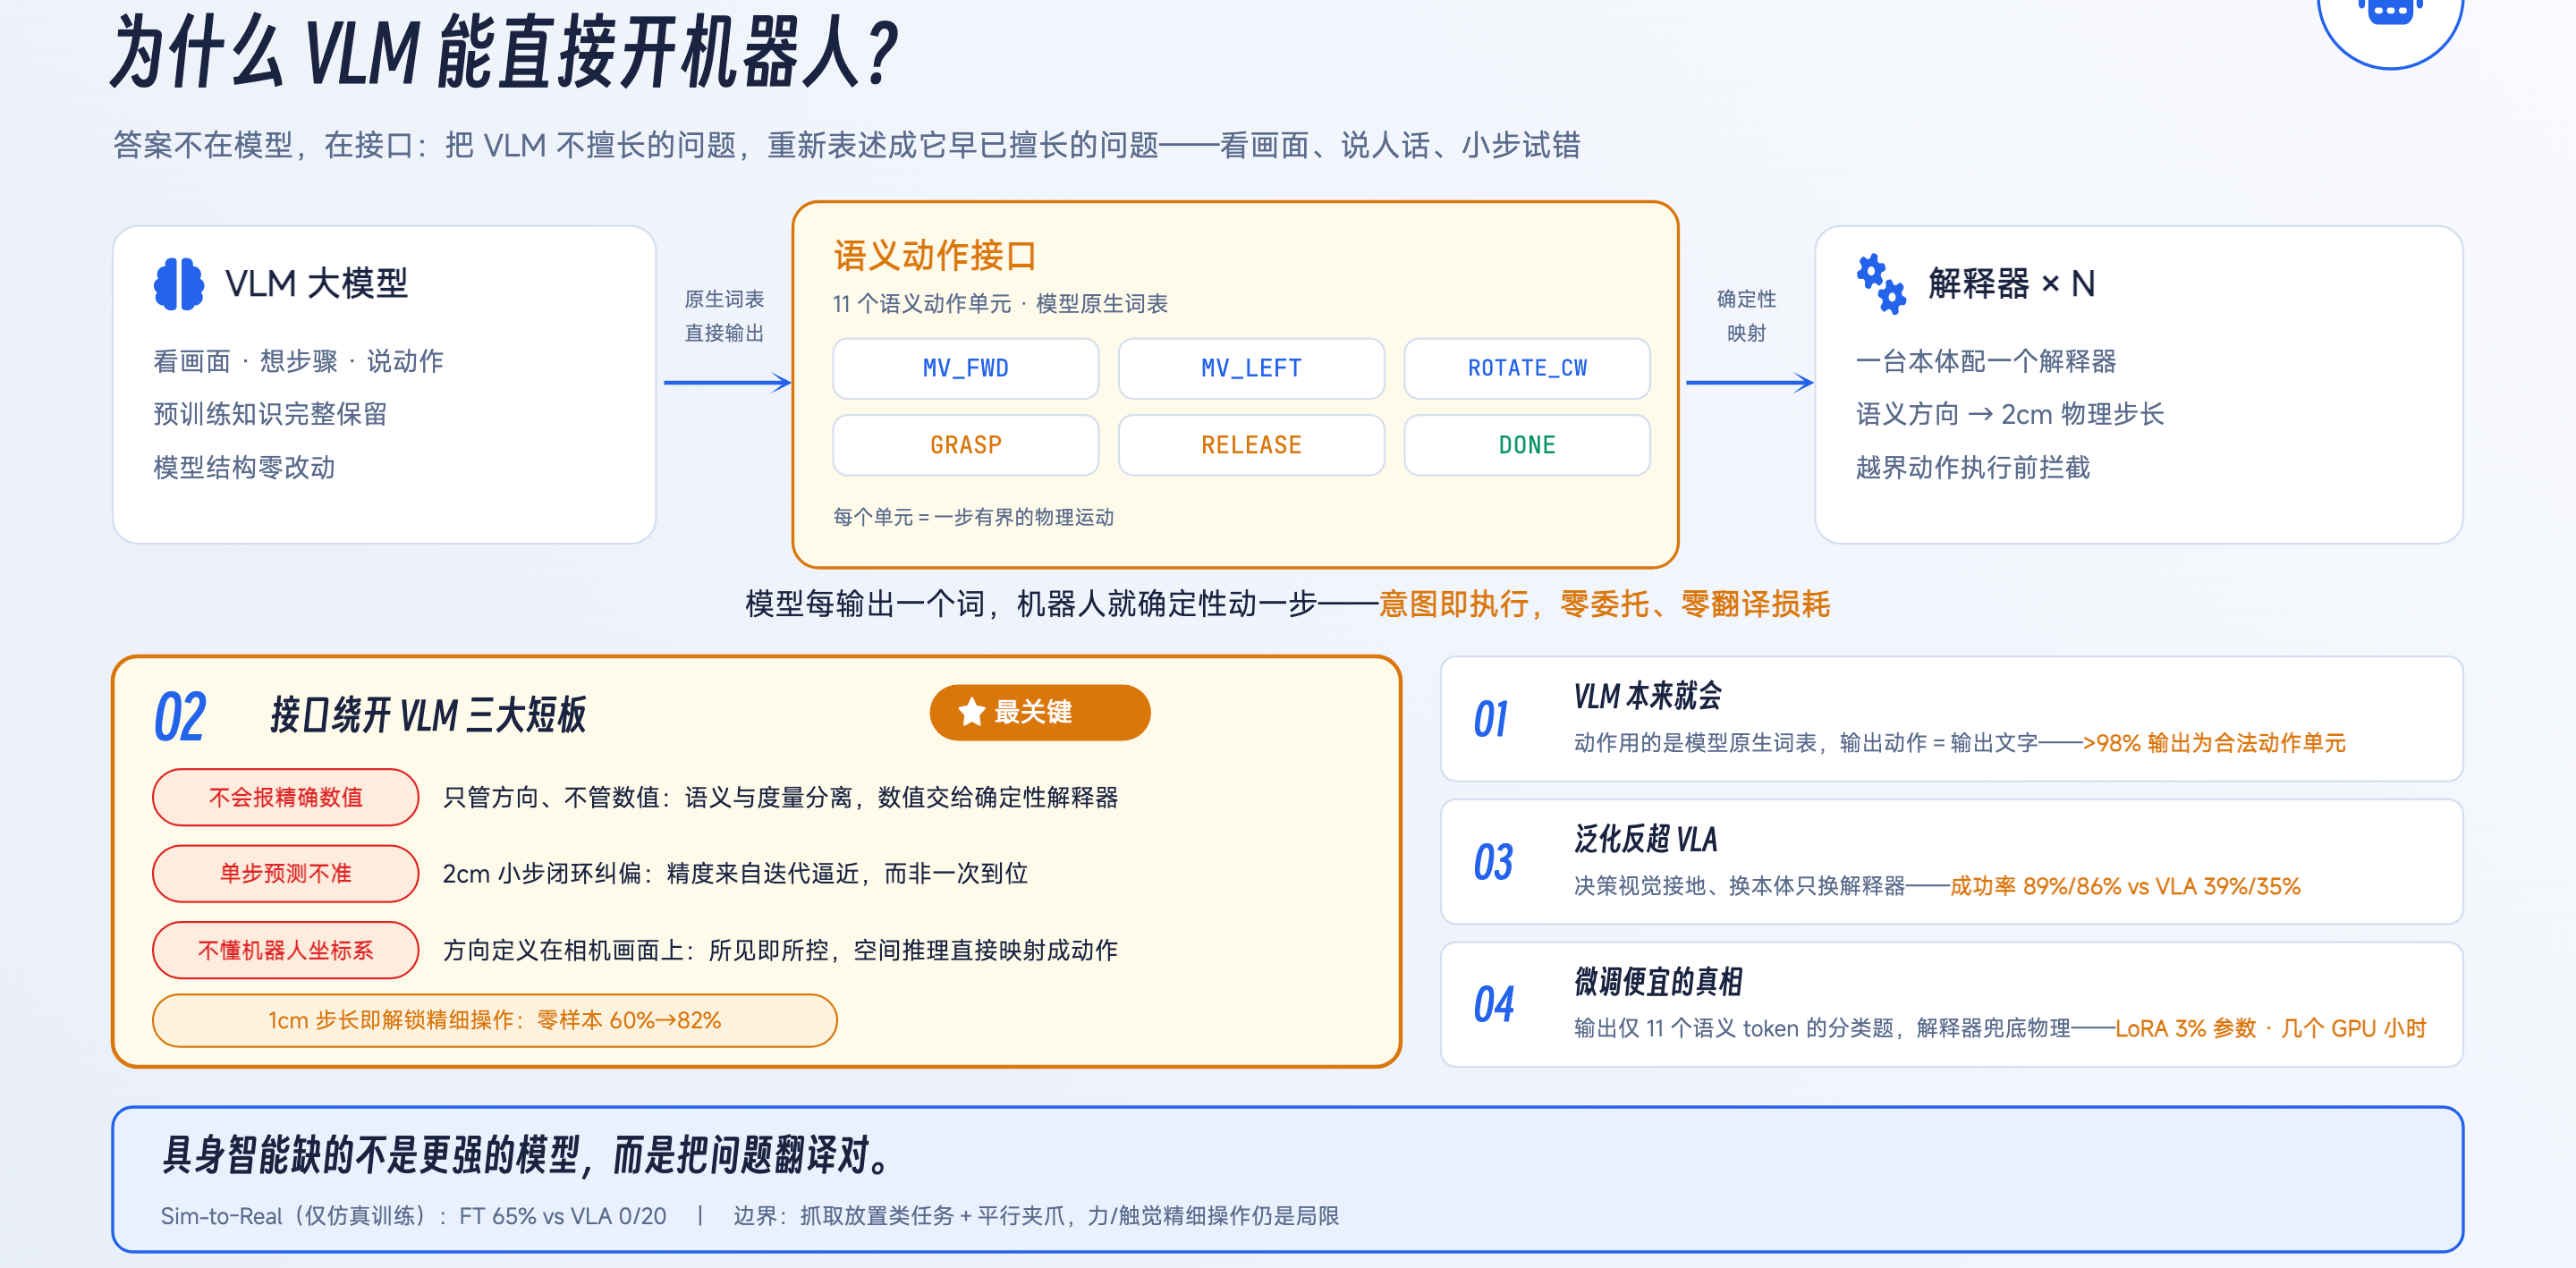
而接口不是随便定的,每一条都在"避短":
- VLM 不擅长输出精确数值 → 那就别让它输出数值
语义决策("往左一步")和度量执行("左 = 2cm")分离,具体多少厘米由确定性解释器负责。模型只做它擅长的方向判断 - VLM 单步预测不准 → 那就把控制改成小步快走+闭环纠偏
每步只动 2cm,动完拍张照给模型看,偏了下一步修回来。精度不来自"一次猜对",而来自"迭代逼近"——这正是为什么换 1cm 步长就能做插孔任务,模型完全不用重训 - VLM 不懂机器人坐标系 → 方向定义在可观测的相机视角上("画面中向左"),而不是关节角或世界坐标
空间推理直接落在它看得见的画面上
对此,来自的研究者提出 Show-Harness,这是一种与具体模型无关的具身控制“挂架”(Embodied Harness),使得VLM 能够通过这样的接口来“操控”机器人
正如图 2 所示
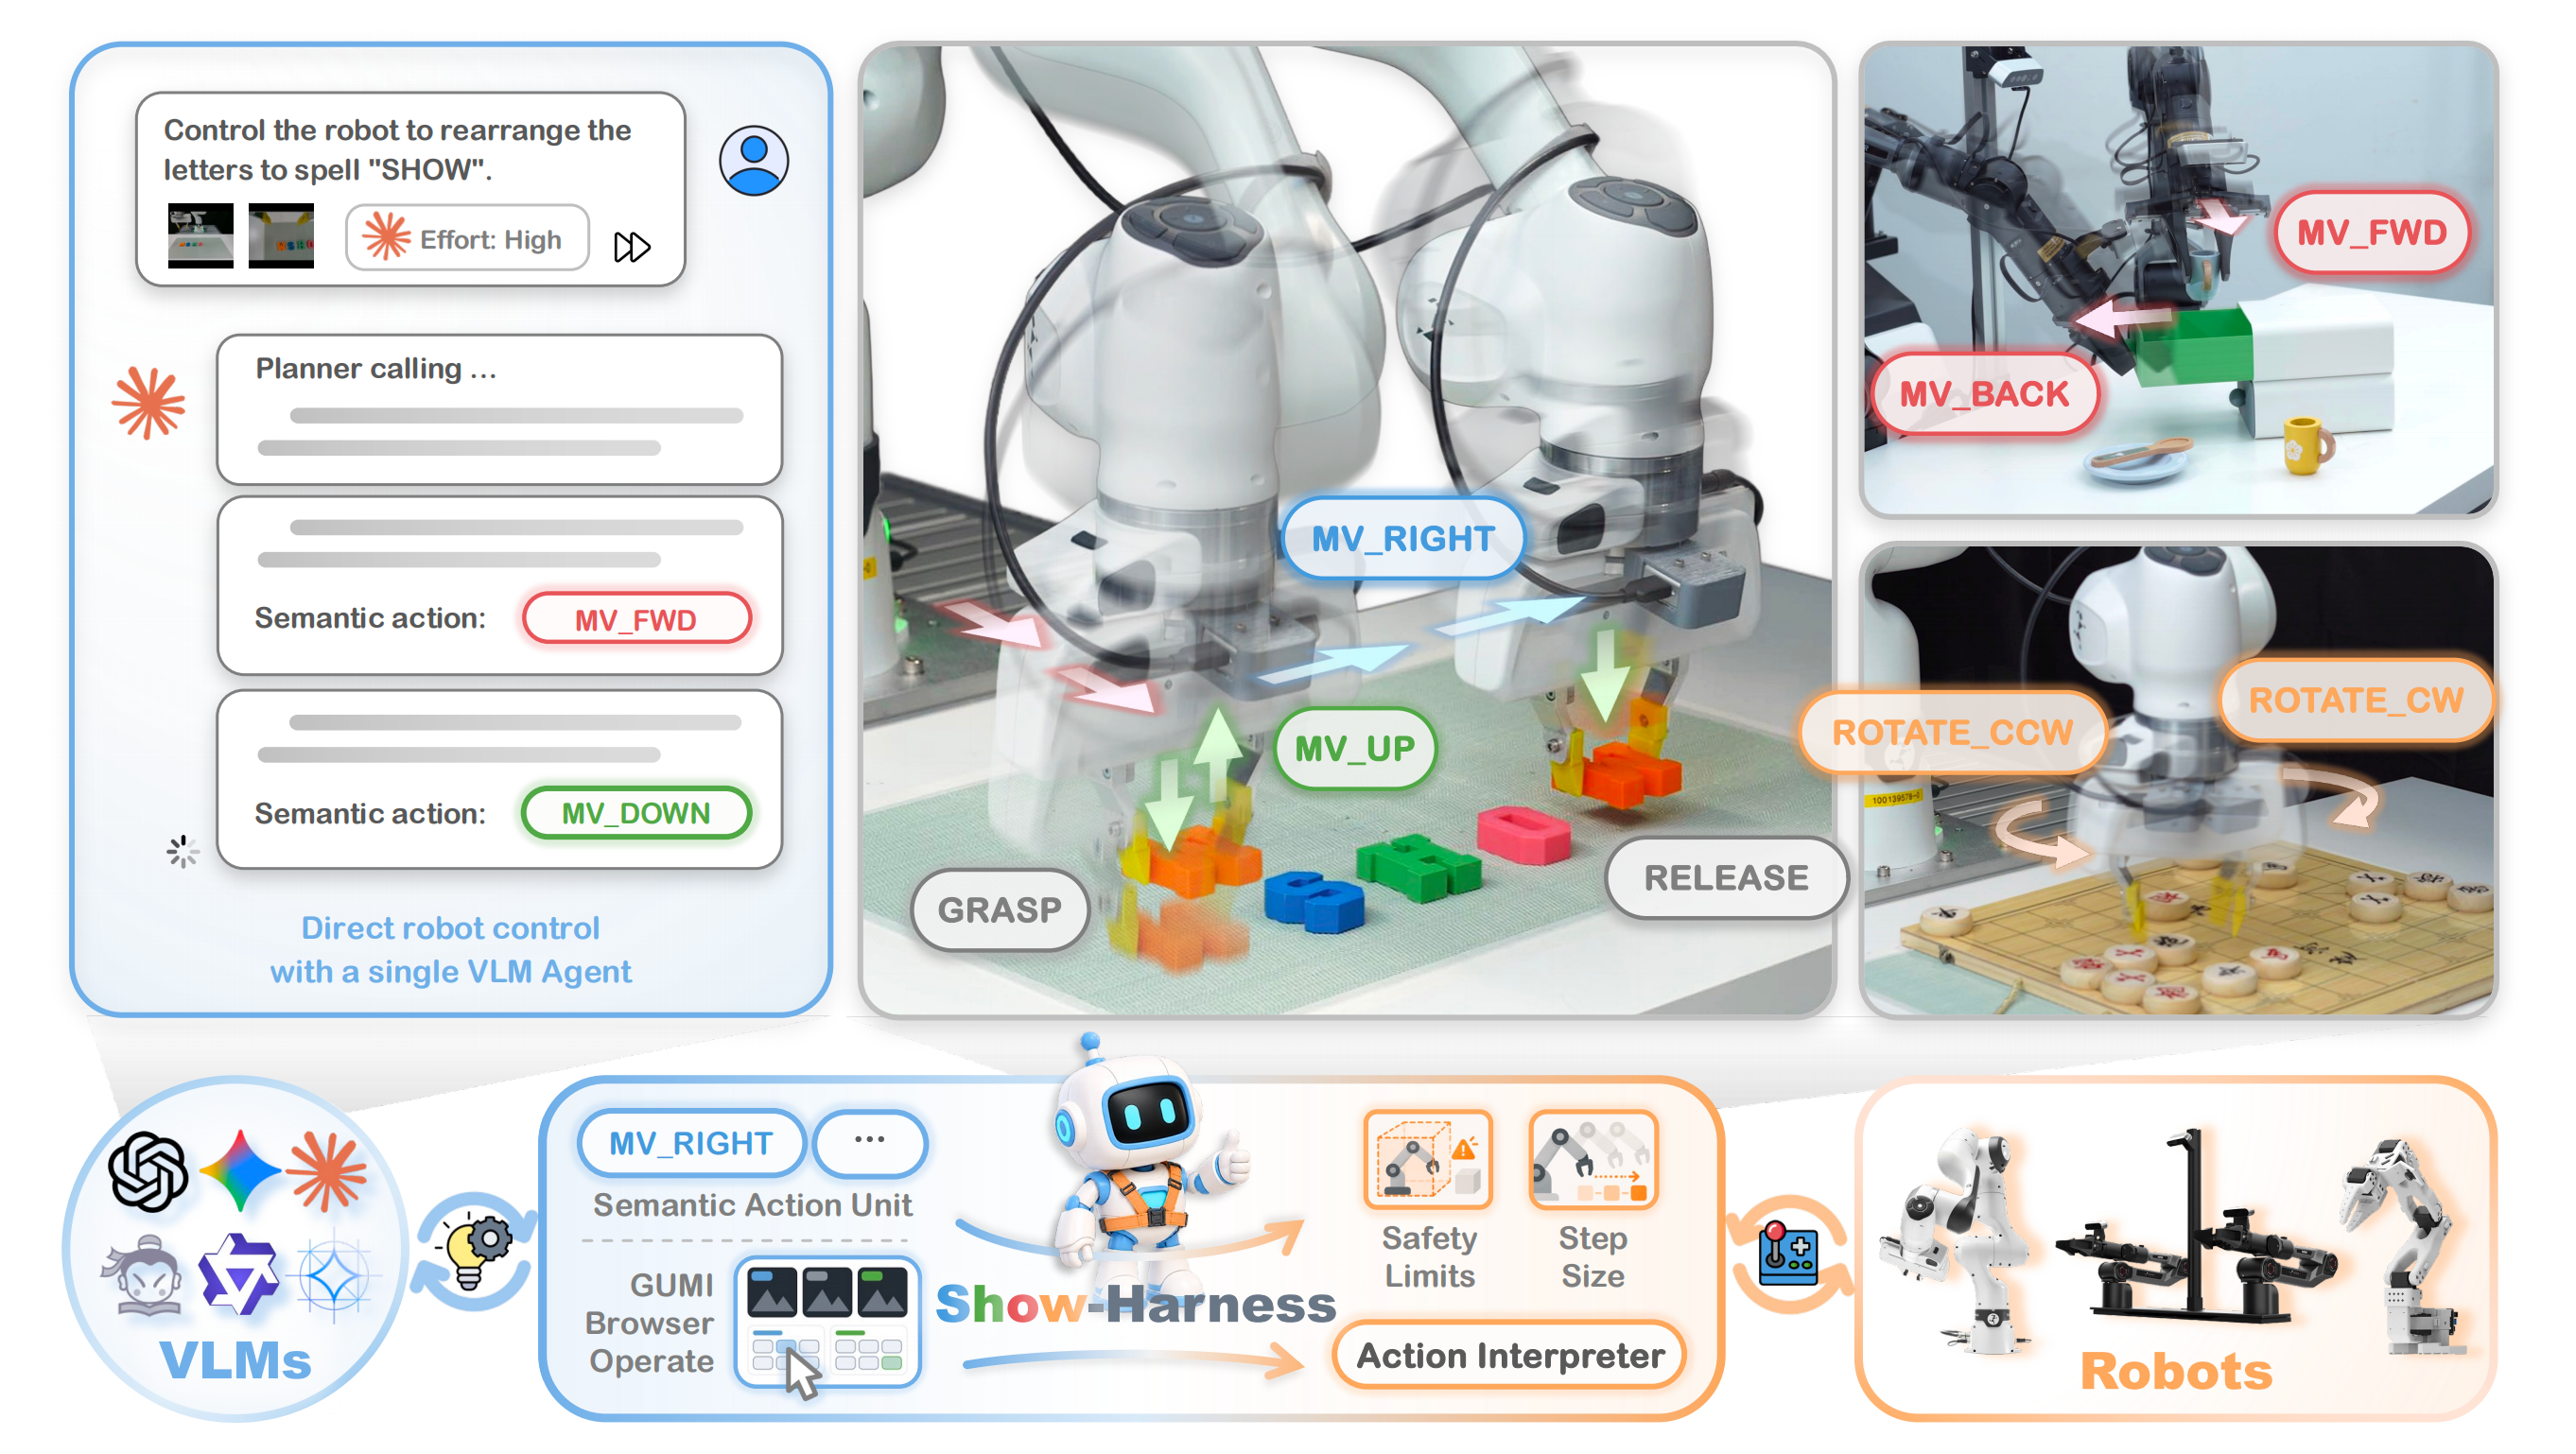
Show-Harness 将机器人控制重构为一组离散的语义动作单元
- 每个动作单元指定在给定方向上的单步运动或一次夹爪动作,使其对 VLM 来说可以直接解释
- 随后,一个与具体具身形态相关的解释器会以确定性的方式,将每个动作单元落实为一个小且有界的机器人运动,从而让每一次语义决策都真正落地到物理世界
在这一核心机制周围,该“挂架”形成闭环:它将多视角观测和本体感受组织成一个感知上下文,支持子任务推理与恢复,并在每个动作单元执行后返回执行反馈,从而将数字化的 VLM 转变为“情境化代理”(situated agents)
这些代理在其本就擅长理解的语义空间中进行推理与行动,同时仍然要对细粒度的物理决策直接负责
进一步而言,Show-Harness 实现了两种机器人控制模式
- 首先,它可以在无需微调的情况下,将闭源前沿 VLM(视觉语言模型)无缝转换为零样本机器人智能体,在多个任务、不同具身形式和环境中,性能优于具有代表性的 agentic harness 框架
- 其次,它使得轻量级VLM(例如参数规模为 2B 的模型)只需消耗数个 GPU 小时的微调,即可在相同动作空间中“操控”机器人,在受控实验下,比具有代表性的 VLA 范式实现更强的泛化能力与从仿真到现实的迁移效果
综合来看,这些结果表明,一个合适的语义接口可以从基础VLM 中释放出可观的具身能力,提供一条可扩展的路径:一方面继承前沿大模型的进展,另一方面将这种控制能力扩展到更小、更低成本的模型上
由于该动作空间具有可解释性且可被人类和模型直接操作,Show-Harness 自然地将基于 VLM 的机器人智能体与类似 GUI 的人类控制方式统一到一起。即作者进一步构建了 GUMI,这是一种基于 GUI 的操作界面,使得人类和智能体都可以在同一个语义动作空间中采集机器人示范,而无需专用的远程操控硬件,并且能够自然地支持跨形体复用以及人类–智能体协同数据采集
1.1.2 相关工作
首先,对于面向机器人操作的基础模型
如原论文所述,第一,将基础模型用作低层策略。视觉–语言–动作(VLA)模型在预训练的 VLM 主干上附加学习到的动作生成模块,用于预测机器人低层控制
这些控制可以表现为
- 通过回归、扩散或流匹配生成的连续动作片段 [8,22,35,61,79,82,102];
离散化的电机(马达)token [11,12,41,45,69];
任务空间中的关键帧或空间网格动作 [71,78];
或者从机器人轨迹和视频中学习到的潜在动作编码 [4,13,18,43,47,64,93,103] - 最新的扩展工作将动作预测与未来视觉动力学耦合在一起,形成统一的视频–动作或世界–动作模型[51,53,67,89,94,106]
机器人基础模型则进一步在异构任务和具身形式上扩展学习到的动作生成能力 [7,9,10,23,27,30,66,83],后续工作则改进了动作初始化、token 化以及对新具身形式和新任务的适应性 [6,17,32,42,85,88]
然而,这一路径在语义与控制之间做出了权衡。将模型重新拟合到特定具身形式的电机信号上,会把其广泛的预训练知识折叠成不透明的感觉–运动映射,并且通常要求为新的任务族或新的具身形式采集新的机器人轨迹 [44,104]
第二,对于作为中间决策者的基础模型
- 另一种路径是将视觉语言模型(VLM)置于低层控制之上,利用其预训练的语义知识对指令进行分解,并输出子目标、关键点、可供性目标、价值地图或空间约束 [24,26,38–40,97]
- 下游控制器再处理它们在物理世界中的实现方式
这样做在保留语义的同时却放弃了物理层面:模型只在不知道其具体实现方式的情况下给出意图规范 [29,34],而且每一种表示形式都被绑定到一个精心设计的、特定于系统的落地(grounding)管线之上 [26,38,39,60]
在实际部署中,还需要长时程规划、闭环反馈以及故障恢复 [29],这就把这些分层式设计进一步推向了下一节将讨论的具身智能体(agentic systems)范式
其次,对于具身智能机器人系统
第一,具身智能体系结构
- 具身智能系统在一个“外骨骼”中保持底座 VLM 完整不变,该外骨骼将模型的决策转换为机器人行为,并将结果反馈回来,从而闭合感知–决策–执行环路 [37,55,59,92]
不同系统的主要差异在于决策如何被执行:
模型可以在感知与控制 API 之上组合程序 [15,28,36,54,80,84,101]
从预定义技能库中选择技能[1,2,50,73,74,96]
用语言子目标来引导已学习的策略(例如 VLA)[16,34,68,76,100]
或将决策外包给符号规划器和数值优化器 [19,20,57,95]
该外骨骼还提供支持长时程交互的机制:
任务上下文与持久化记忆 [3,73,100]
基于反馈的监控与反思 [37,77]
以及用于重新规划和恢复的失败检测 [25,62,92]
第二,具身执行的接口
- 在这些范式中,VLM 最终都是通过其所处系统对外暴露的原语来发挥作用,因此接口设计成为一个核心问题
前沿 VLM 在不同抽象层级上的表现差异巨大 [5,34]:由人类设计的抽象(例如 place(object, target))能显著提升可靠性,而在低层感知与控制 API 之上直接进行组合仍然非常困难 [28,59] - 因此,当前占主导地位的解决方案是,将完整的技能、控制器或 VLA 作为可调用的原语对外暴露[1,16,68,76,100]:智能体只决定做什么(what),而由一个不透明的执行器来决定如何做(how)[29]
与之相对,Show-Harness 直接将“如何做”本身暴露出来,具体表现为细粒度的语义动作单元,其物理实现是确定性的且透明的,从而使 VLM 能够对细粒度的物理决策保持直接责任
第三,从数字界面到物理操控
- Show-Harness 的离散语义动作空间呼应了一个在数字与仿真智能体领域更广泛的界面原则:提供紧凑、可解释且同时可被人类和基础模型操作的动作集合
计算机使用代理和游戏代理通过鼠标、键盘或控制器输入进行动作[56,65,70,86,99],而仿真的具身智能体则使用离散动作或技能级动作[48,49,52,91]
在导航任务中,离散方向基元是仿真器和基准中的原生构件 [46,75],且近期的通用智能体已经可以有竞争力地驱动这些系统 [105] - 然而,在真实世界的操作任务中,并不存在同样简单且广泛可用的接口:控制通常是具身特定的、高维的,并且需要精细的空间精度
Show-Harness 通过将细粒度的语义动作以确定性的方式落地为物理机器人的运动,同时向 VLM 智能体和人类暴露相同的动作空间,从而弥合了这一鸿沟
1.2 Show-Harness的完整方法论
1.2.0 概述
Show-Harness 是一种具身形态的控制框架(embodied harness),其设计目的是通过将基础视觉-语言模型(VLM)置于一个迭代的“感知–推理–行动”闭环中,将这类模型的智能能力转化为在物理世界中可落地的机器人行为
在每一个交互步骤中,模型会接收感知输入,交互历史,推理接下来该做什么,将其意图表达为语义层面的动作决策,并在该决策被落实为机器人实体运动之后,观测由此产生的环境变化
具体而言,如图 3 所示
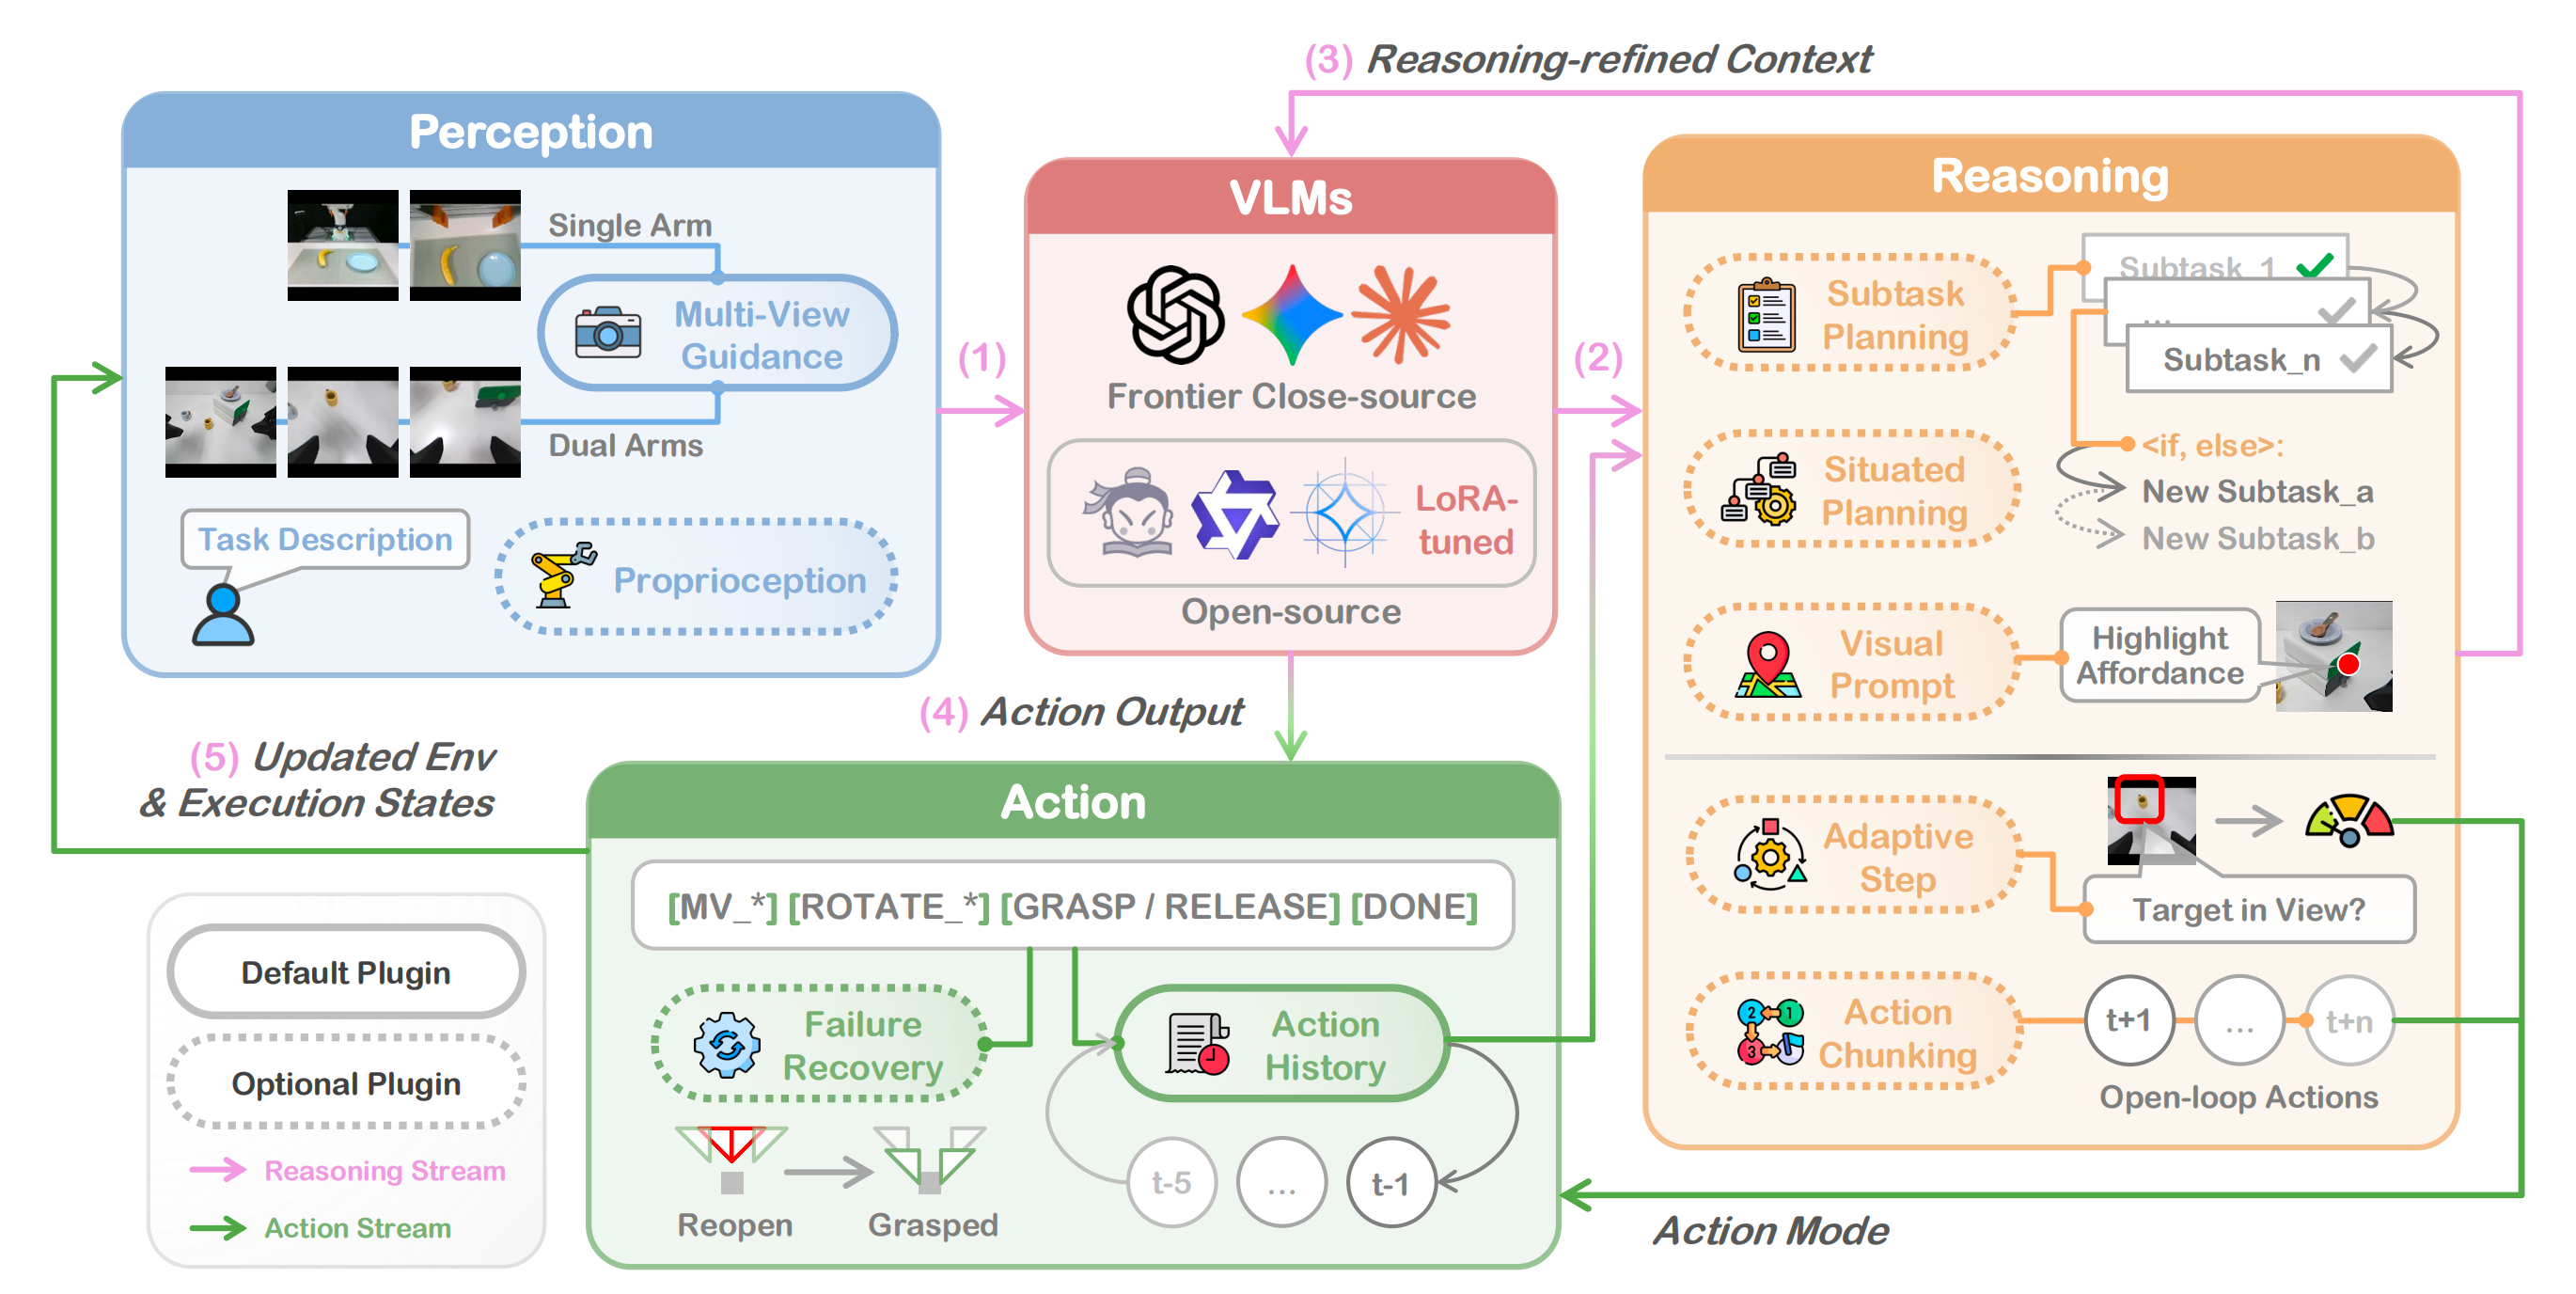
给定一条语言指令 ,在第
步时,系统获取一条观测
,其中
表示多视角视觉观测,
表示机器人的本体感知状态
- 系统首先通过一组可配置的推理插件
,对当前观测和一个压缩形式的交互历史
进行处理,从而生成经推理优化的上下文
- 然后,中央 VLM 在精炼后的上下文
的条件下选择一个语义动作——定义为公式2
其中是一个紧凑的细粒度可执行单元集合,用于定义 VLM 与机器人之间的语义接口
每个单元都指定一种可直接解释的末端执行器运动或夹爪意图,而不会向模型暴露与具体形体相关的控制变量(第 3.2 节) - 得到的语义决策
随后被传递给一个与形体相关但与模型无关的解释器,由其以确定性的方式将该决策落实为可执行的机器人控制
其中,表示机器人的具身形式,
是解释器的内部设定点状态
执行会更新机器人和环境,产生新的观测和执行状态,并在下一次交互步骤中将其反馈回系统
1.2.1 物理落地的语义动作接口
Show-Harness 的核心是一种接口,它使 VLM 的决策在语义上保持有意义的同时,又具备足够细粒度,以便实现对物理系统的直接控制
首先,对于语义动作空间
- 式 (2)
中的共享动作空间 A 由一组紧凑的语义动作单元组成。在每一步,系统都会从当前观测中确定一个参考视角,用以定义末端执行器的运动方向
相对于该视角,MV_FWD/MV_BACK、MV_LEFT/MV_RIGHT 和 MV_UP/MV_DOWN 分别沿对应方向将末端执行器移动一个步长 - 对于需要改变末端执行器姿态的任务,ROTATE_CW 和 ROTATE_CCW(各自配合指定的轴 x、y 或 z)会围绕该轴以顺时针或逆时针方向逐步旋转末端执行器
GRASP 和 RELEASE 分别用于闭合和打开夹爪,而DONE 表示任务完成
相当于语义动作空间:只有约 12 个单元——MV_FWD/BACK/LEFT/RIGHT/UP/DOWN、ROTATE_CW/CCW(绕 x/y/z 轴)、GRASP、RELEASE、DONE。全部用 VLM 的原生词表表达,不需要动作头或特殊 token
该词汇体系围绕三项属性进行设计
- 增量性
每个单元只引发一次小而局部的物理变化,通过可观测的动作效果使 VLM 始终处于控制闭环之中,并通过连续纠正实现精细行为
作者宣称,他们的实证结果表明,VLM 在无需微调的情况下即可在不同的步长粒度间灵活切换(见第 5.3 节) - 可解释且与具体形体无关
动作被表示为语义符号而非数值目标,而具体形体相关的低层控制则交由下游解释器完成,从而使模型所面对的空间保持紧凑、可解释,并可在不同机器人之间复用 - 视觉基础
运动方向是相对于可观测视图定义的,使得空间推理可以直接映射到动作上
其次,对于具身落地
随后,VLM 所做出的每一个语义决策 都会传递给一个与具身相关的解释器
,由其以确定性的方式将单元
落地为机器人控制。对于一个动作单元,解释器会更新6 自由度笛卡尔位姿设定值
,即
其中
和
分别表示位置和姿态
和
分别编码平移和旋转:对于旋转,取
;对于平移,取
,否则
- 记
为斜对称矩阵算子
经标定的增量和
用于设定平移与旋转的幅值
而则将语义方向和轴映射到具身体
投影算子用于施加与具身相关的工作空间约束以及每步平移或旋转的幅度上限
夹爪类单元跳过位姿更新,直接映射为夹爪张开或闭合指令
不同具身体通过不同的底层控制器来实现相同的语义单元,例如
- Franka 通过阻抗控制跟踪笛卡尔设定点
- AgileX 使用逆运动学和持续下发的关节目标
- 而仿真器则执行相应的操作空间指令
通过将与具身相关的控制逻辑封装在 内部,语义模型接口在不同机器人之间保持不变。因此,适配一个新的具身体只需要一个新的解释器。诸如工作空间和桌面高度限制等安全边界,可以在解释器中灵活配置;违反这些约束的动作会在执行前被阻止,从而确保物理交互的安全性
即具身解释器:每个机器人配一个确定性解释器,把语义动作映射成有界的 6-DoF 笛卡尔位姿增量(Franka 用阻抗控制、AgileX 用 IK),并内置工作空间安全边界。换新本体只需换解释器,模型侧接口不变
1.2.2 具身 Harness 架构
具身 Harness 将基础模型的交互循环组织为三个可配置阶段:感知(Perception)、推理(Reasoning)和行动(Action)。表 1 总结了在每个阶段实例化的插件
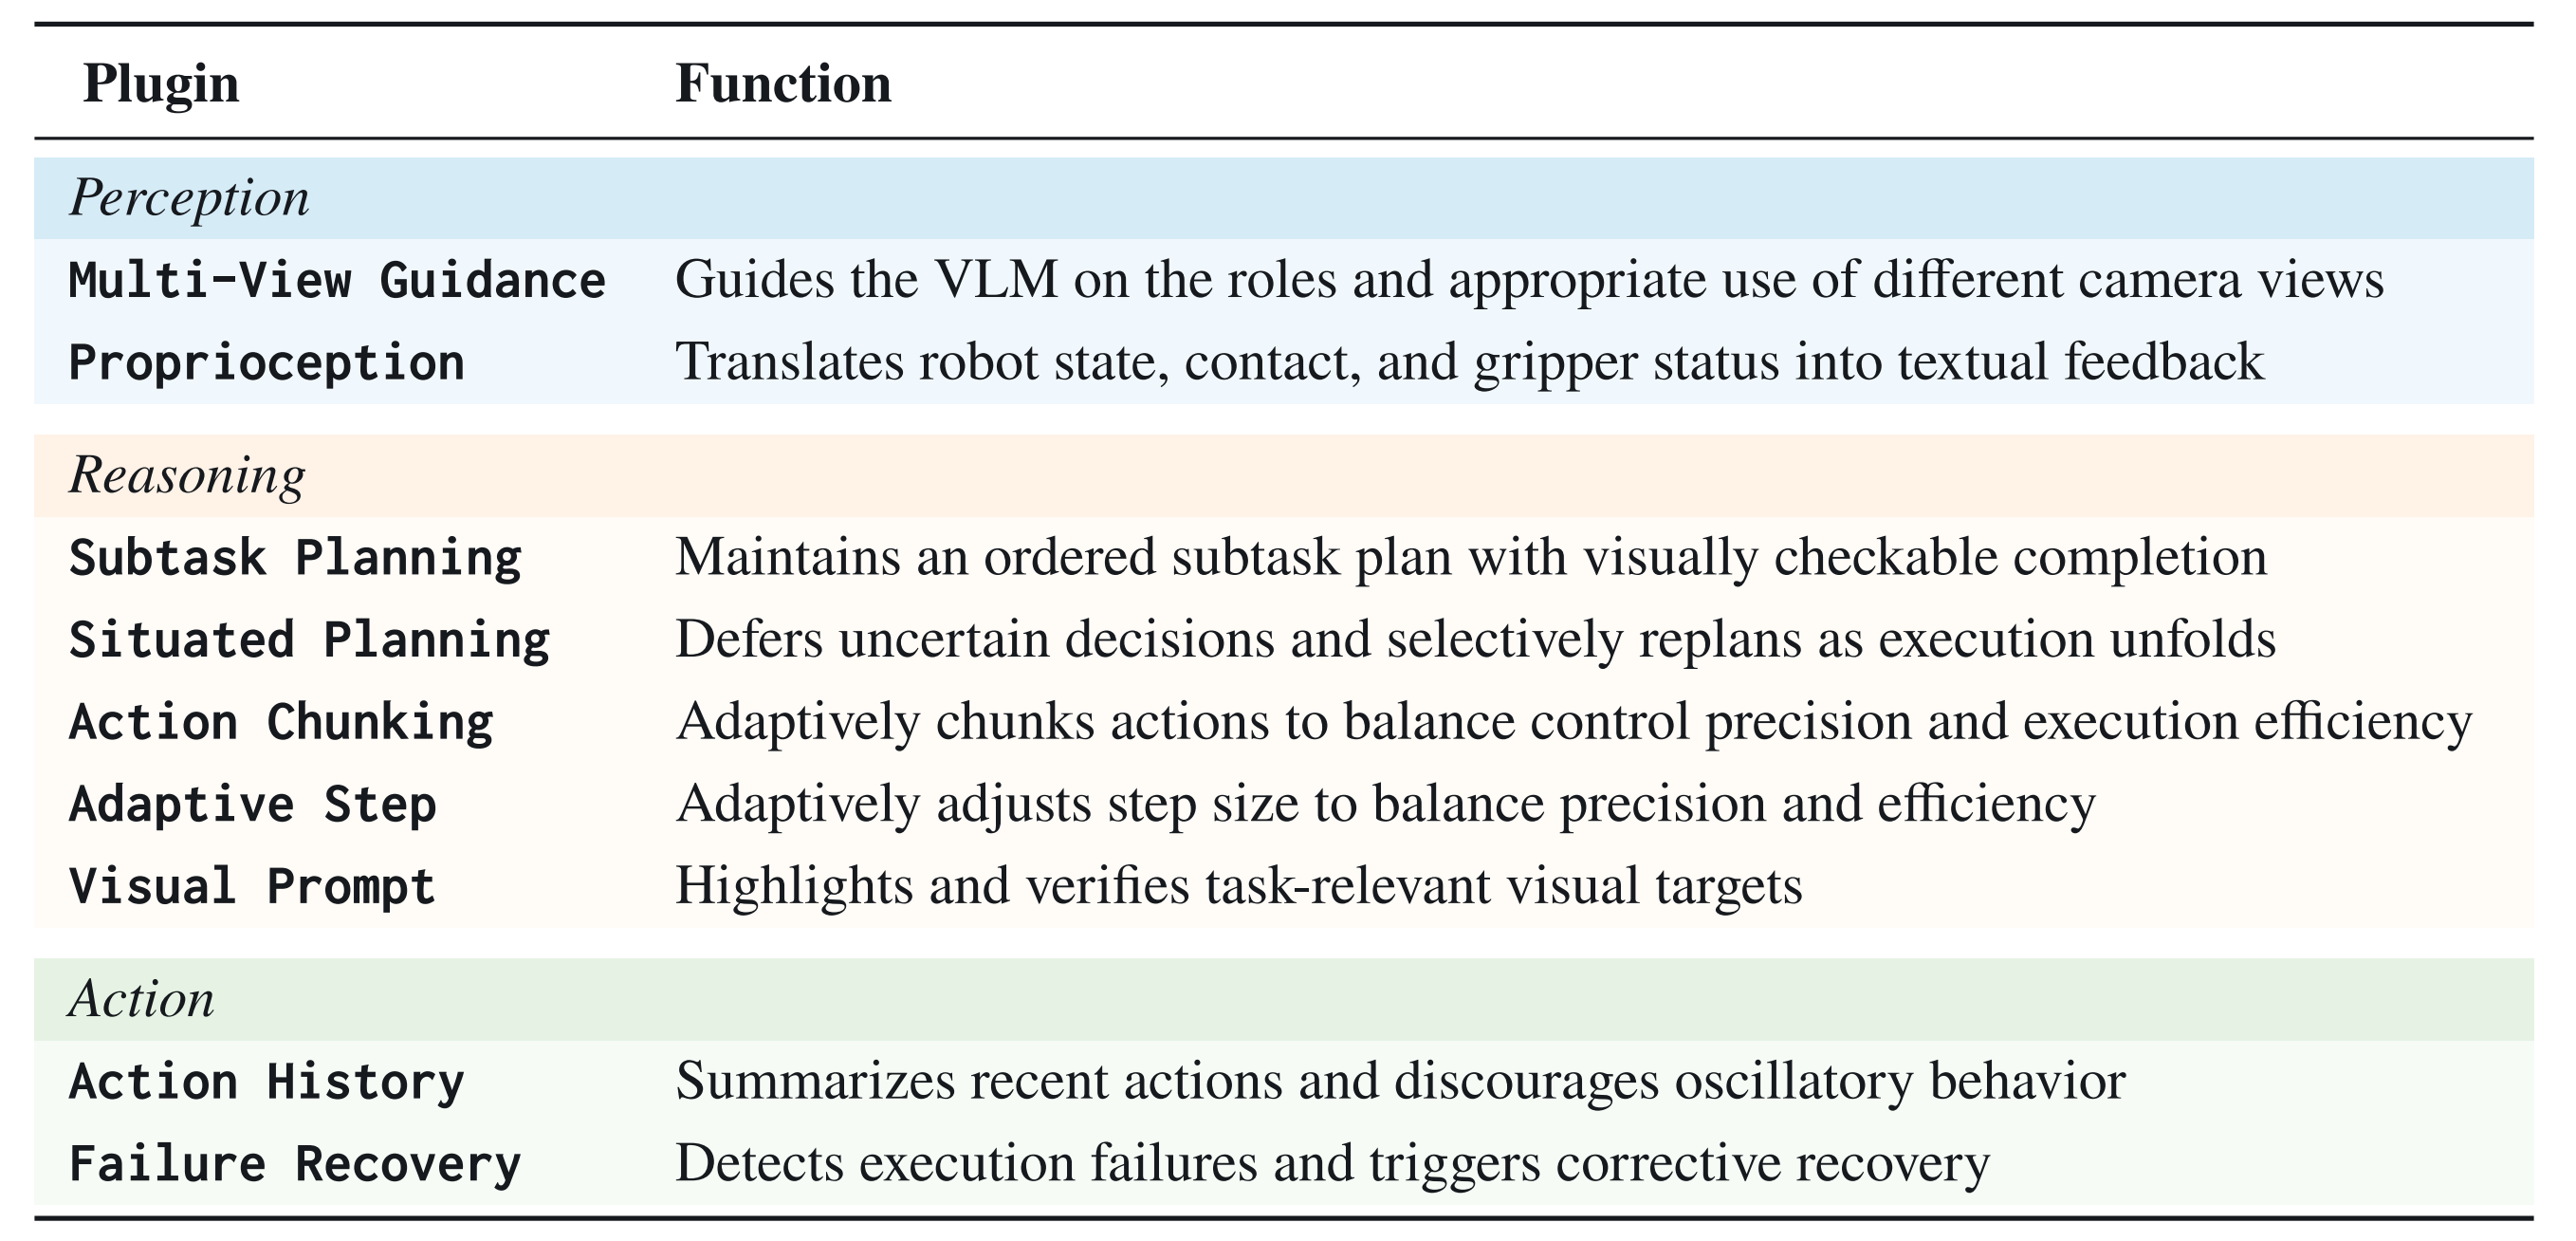
首先,对于感知Perception
- 多视角引导(Multi-View Guidance)告知 VLM 应该如何使用并优先考虑不同的摄像机视角
例如,全局的主观视角/客观视角能够提供场景级上下文,而腕部安装的视角则为细粒度的对齐与操作提供近距离的视觉证据 - 本体感受将机器人的内部状态转换为简明的文本反馈,包括当前夹爪高度、单步动作引起的位移、与任务阶段相关的执行提示(例如在高度仍然较高时先向下移动)、接触状态以及夹爪状态
其次,对于推理Reasoning
推理类插件将任务结构化为可执行的中间决策,并细化当前上下文,用于做出粒度更细的动作级别决策:
- 子任务规划首先调用 VLM 作为规划器,将任务指令 ℓ 分解为带有完成判据的有序子任务序列
在执行过程中,子任务的切换由模型决定:在每一步,它都会基于当前图像检查对应的完成判据;当判据尚未满足时继续执行动作,一旦满足则宣告该子任务完成,从而推进整体计划 - 情境规划会推迟做出存在不确定性的决策,并在执行过程中所需信息变得可用时,有选择性地触发重新规划
与其在一开始就对所有未来分支做出承诺,初始计划会将此类决策保留为未定状态,直到相关证据变得可观测为止
随后,VLM 会根据当前观测结果来解析分支,并相应地更新剩余计划。这样一来,条件性任务就能够根据执行状态的演变进行自适应调整,而无需在每一次交互步骤都进行重新规划 - 动作分块(Action Chunking)在尚不需要细粒度反馈时(例如目标仍然较远时)自适应地降低模型查询频率,使得 VLM 能够一次性输出一小段语义动作序列,并在下一次模型查询前以开环方式依次执行这些动作
- 自适应步长(Adaptive Step)会动态调整步长大小,以在效率与精度之间取得平衡:当目标较远时使用较大的步长,而在需要近距离对齐时则采用较小的步长
- 视觉提示(Visual Prompt)通过一次专门的模型调用,将含糊的语言目标转换为视觉参照,并高亮相关的可供性区域,从而使后续推理能够基于该视觉标记进行落地。当前交互区域难以用语言精确描述时,将启用该插件
最后,对于动作Action
在上文(原论文第 3.2 节)提出的物理上有根基的语义动作接口基础之上,动作阶段通过轻量级的交互记忆和恢复机制对执行过程进行增强,这些机制支持健壮的闭环控制。在此阶段运行两个插件:
- 操作历史 会将最近的操作作为轻量级上下文带入下一次交互步骤,并附带一些简单的使用指导,例如避免在相反操作之间来回摇摆。这种精简的历史记录为模型在多步过程中提供所需的时间记忆
- 失败恢复会自动检测抓取失败,并通过重置夹爪状态并回退到相关的抓取子任务来完成恢复
1.2.3 同一界面下的两种模式
该共享语义界面支持两种互为补充的机器人控制模式
- 前沿型 VLM 作为零样本智能体(ZS 模式)
前沿型 VLM 可以在无需任何微调的情况下,直接通过该控制框架操控机器人
此模式可以将前沿模型的能力直接用于物理控制,为物理世界中的控制任务提供一条可扩展的路径,从而继承并利用日益强大的基础模型所取得的进展 - 对小型 VLM 进行微调(FT 模式)
同一接口也支持对小型开源 VLM 进行轻量级适配,以便直接预测语义动作单元。给定在共享动作空间中收集的示范 D,策略通过最小化目标单元在token 级别的交叉熵来进行训练
其中,Pmin 有意仅保留最小化的决策上下文,以便进行可控的对比与分析,该上下文由任务指令 ℓ、多视角观测 ᵅ 和简短的动作历史 ℎ 构成
关键在于,语义动作是通过 VLM的原生词表来预测的,而无需专门的动作头或特殊token,这既使得在少量示例基础上进行轻量级的低秩适配成为可能,又比具有代表性的 VLA 基线方法表现出更强的泛化能力,如下文(对应原论文第 5 节)所示
1.2.4 GUMI:一种基于图形界面的操作交互系统
首先,对于面向人类、智能体和策略学习的共享接口
- 由于第 3.2 节中的语义动作空间是离散且可直接操作的,它可以很自然地通过一个轻量级图形界面暴露出来
基于这一特性,作者开发了 GUMI,一个基于 GUI 的操作界面,使人类和智能体都可以使用相同的语义动作单元来操控机器人
如图 4 所示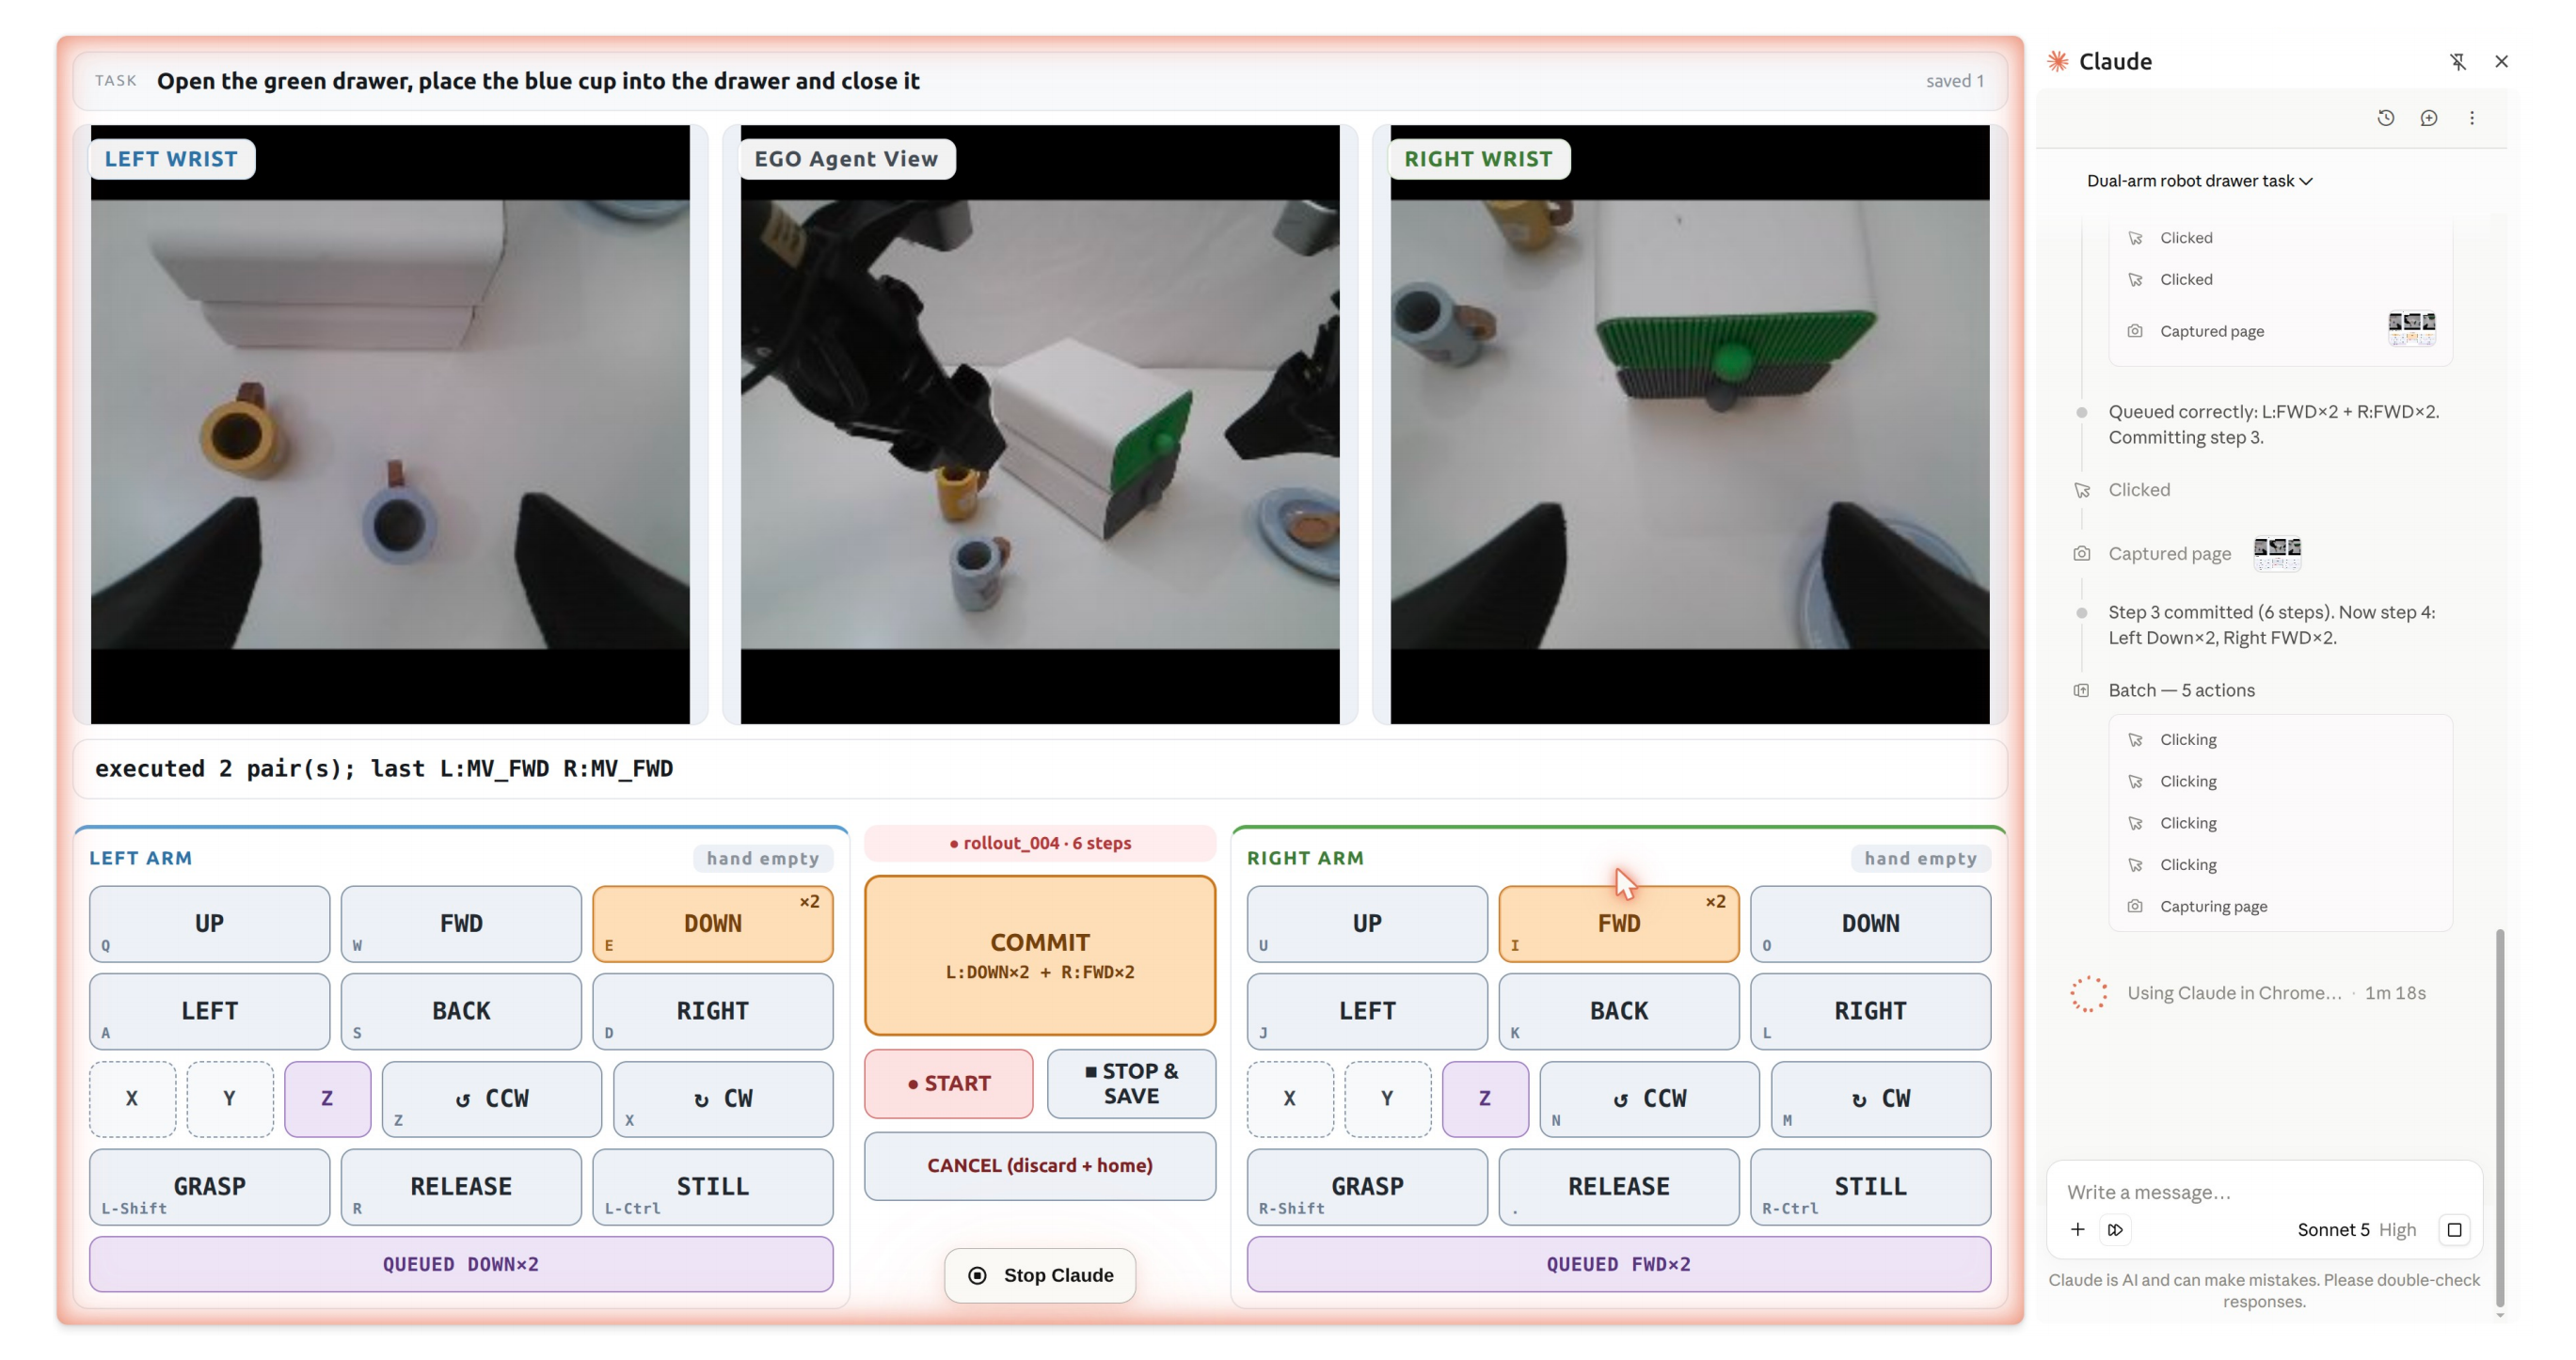
- 每个单元都映射到一个带标签的控件和按键:人类可以通过键盘“操纵”机器人,能够使用计算机的智能体可以操作同一个 GUI,而通用的 VLM 智能体则可以直接预测这些动作单元
在每一步中,GUMI 都会记录执行前的观测和所选的语义动作,得到可直接用于策略学习的样本对
由于每个语义单元都由具体具身相关的解释器进行确定性落地,系统在 rollout 过程中也可以保留相应的低层指令和轨迹,从而使得一次示范可以同时用于训练语义动作策略和连续控制策略
其次,对于灵活且可复用的数据采集
GUMI 支持分步控制、按队列执行的动作块、单臂与双臂操作,以及“人–智能体混合采集”模式,在该模式下,人类可以在智能体 rollout 过程中介入并进行纠正。且与依赖专用硬件 [21, 87,102] 或特定于仿真的控制方式 [58,63,107] 的传统远程操控流水线不同,GUMI 直接在共享的语义动作空间中记录示教轨迹
因此,只要不同载体的解释器实现了相同的单元,这些示教就可以在不同载体之间复用,同时,相同的工作流程同样适用于仿真环境和实际无需专用远程操控硬件的真实世界环境。其轻量化且可通过数字方式访问的设计,进一步支持远程数据采集,而不需要与机器人在物理空间上共址
1.3 实验
1.3.1 实验设置
第一,对于硬件
作者他们的实验使用了两种机器人平台,每种都配备了平行夹爪(图5)
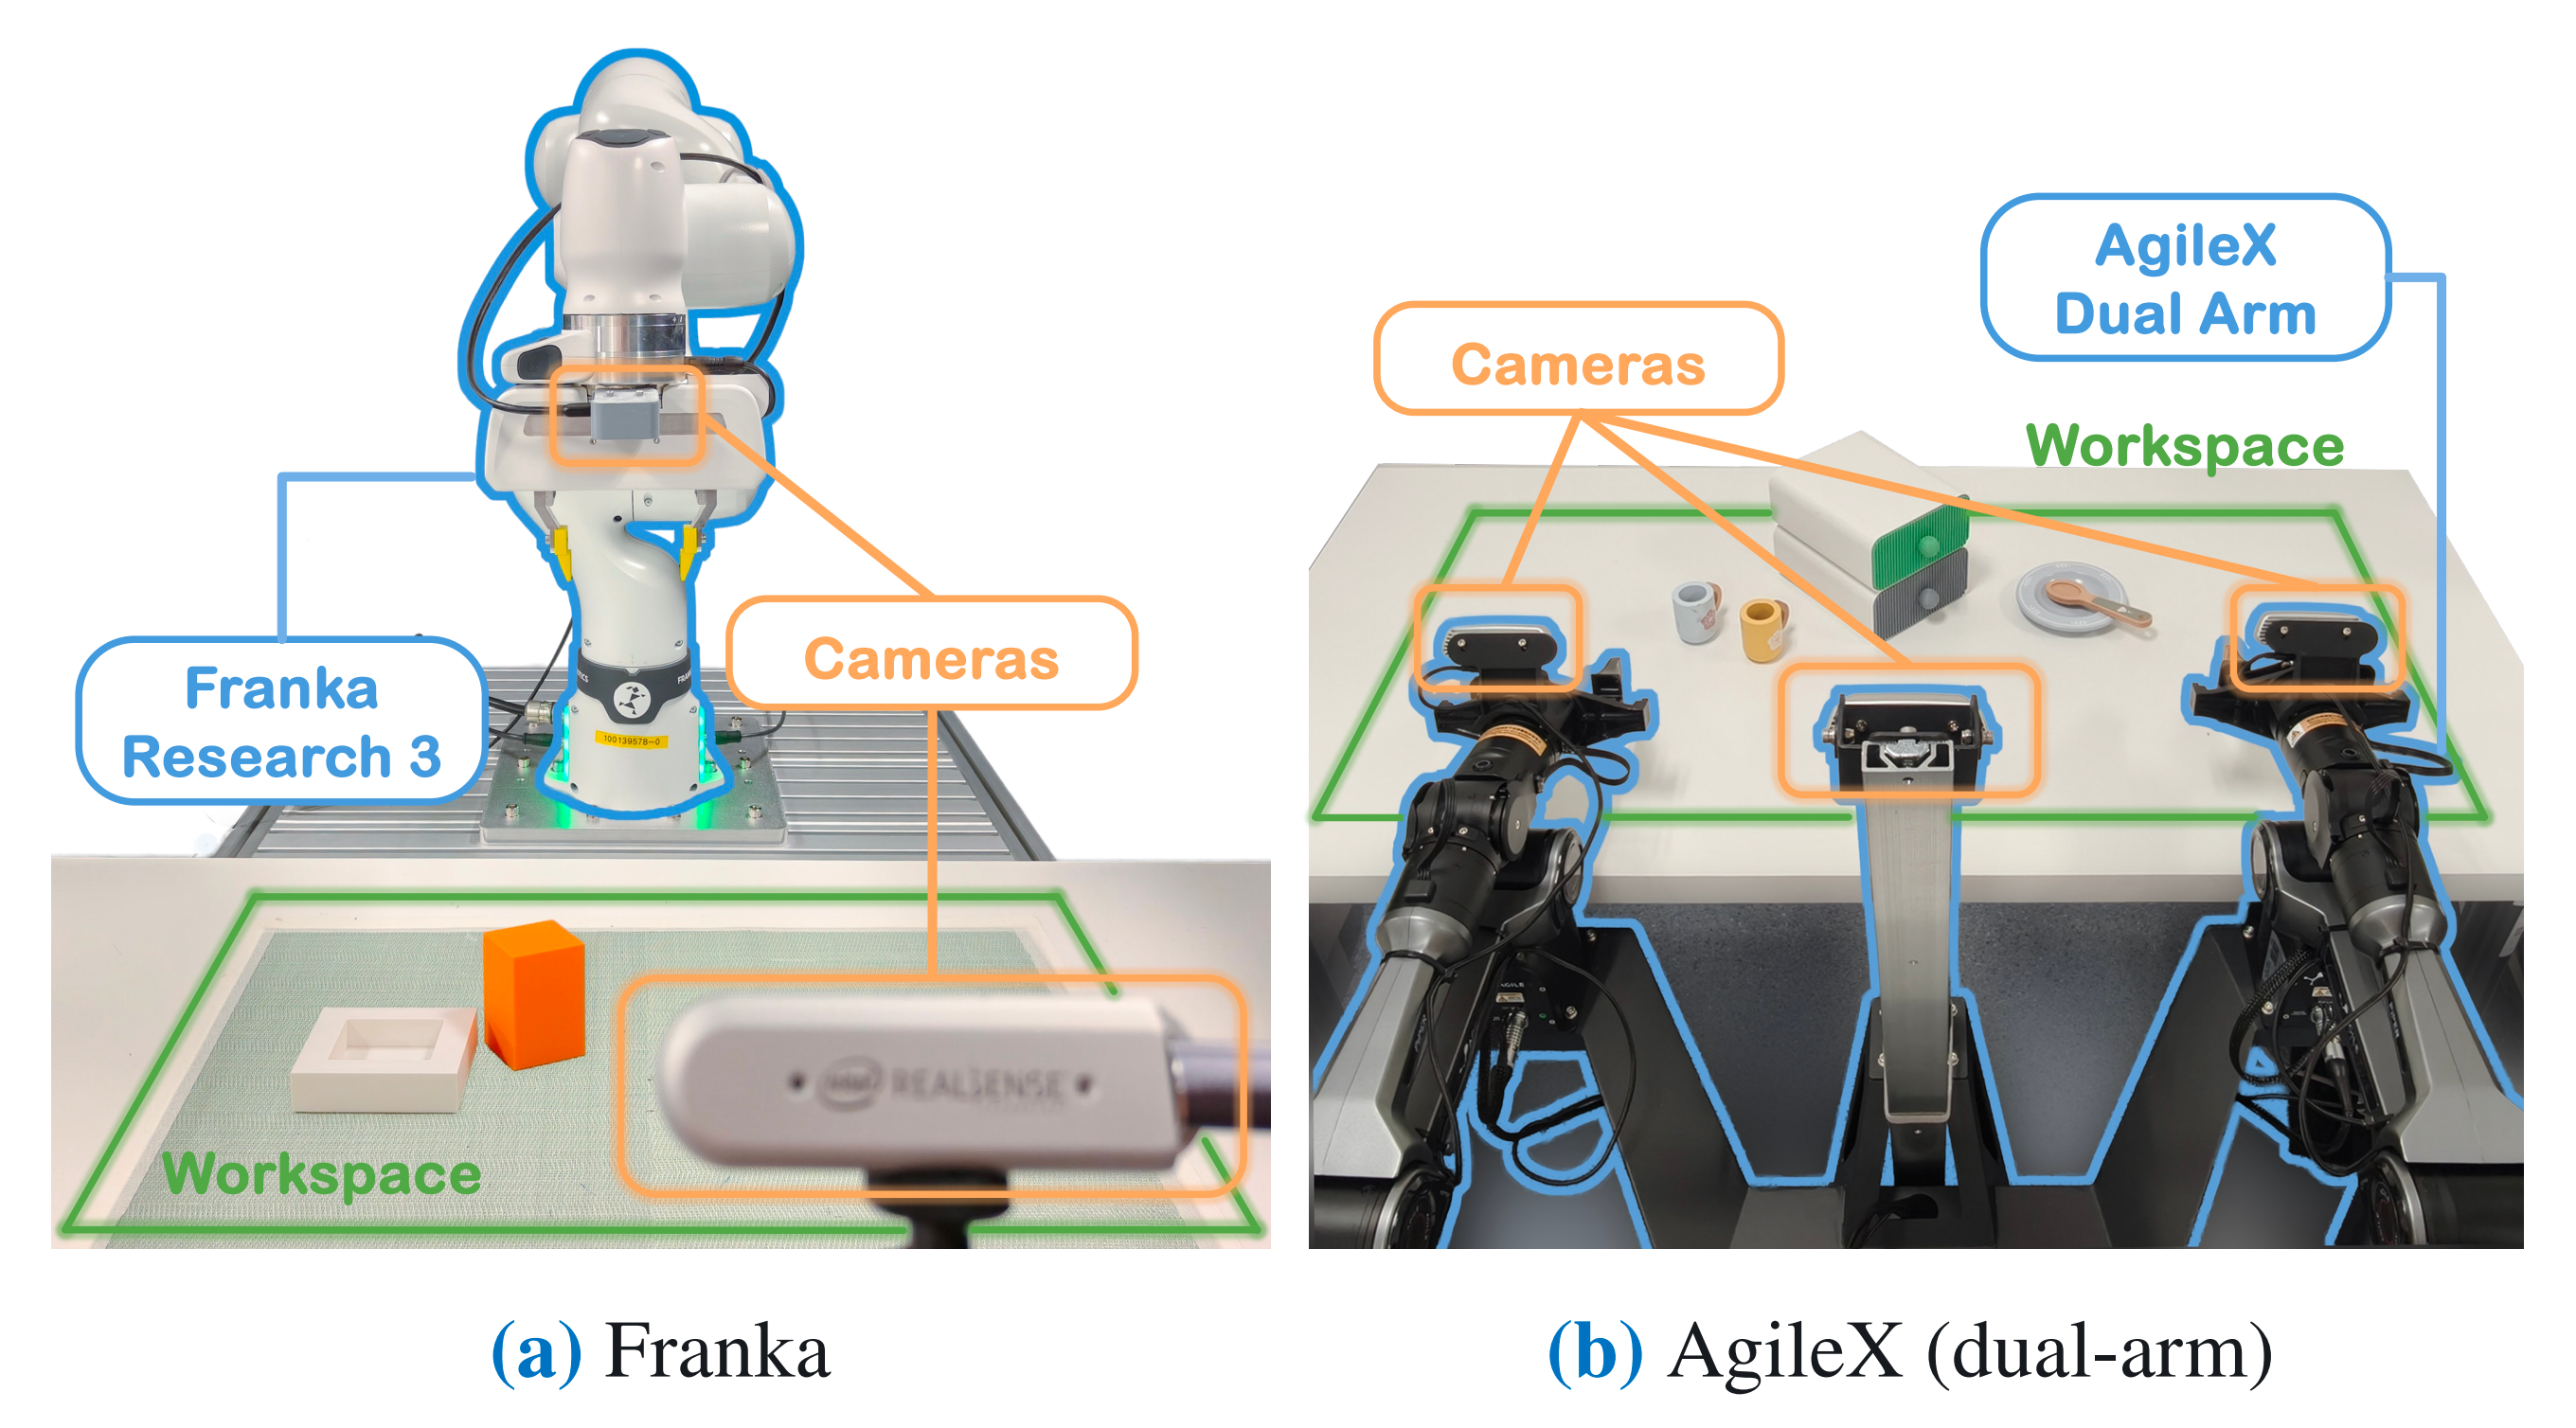
- 第一种是一个 7 自由度的 Franka Research 3 机械臂
由一个面向工作空间的外部视角Intel RealSense D435 相机和一个腕部安装的 Intel RealSense D405相机进行观测,从而提供两路视角 - 第二种是一个由 AgileX 双臂平台构成的双手操作装置
配备两条 6 自由度机械臂,由三台 Orbbec Dabai DC1 相机进行观测:
一台为两条机械臂共享的自我视角相机,以及每个机械臂腕部各一台腕部视角相机
本地模型部署在一块 RTX 5090 GPU 上运行,而前沿模型则通过其提供的 API 进行访问
第二,对于任务与评测指标
- 作者通过将五种物体与两种目标接收器(盘子和碗)配对,构建了十个真实机器人操作任务。每个任务都需要完成定位、接近、抓取、搬运以及适当放置等步骤
- 物体涵盖多样的物理属性:具有刚性几何形状的方块(block)、形状不规则的香蕉(banana)、具有滚动物理特性的网球(tennis ball)、可变形的泰迪熊(teddy bear),以及需要高精度操作的国际象棋棋子(chess piece)
- 对于经过微调的开源VLM,仅方块、香蕉和网球出现在示范数据中。泰迪熊和棋子则被保留用于分布外(OOD)评估
除上述任务外,第5.3节和第5.4节还引入了针对性的情景,用于探查更广泛的能力和设计选择
最终,作者报告成功率和每个回合的平均步数。除非另有说明,作者对每个任务在随机物体摆放条件下运行10 次试验。每个回合最多 50 步,超时则计为失败
第三,对于VLM 智能体与执行框架
- 前沿 VLM 作为零样本智能体(ZS 模式)。除非特别说明,作者默认使用 Gemini-3.1 Pro [31] 作为前沿 VLM
且将“思考开销”定义为在推理阶段分配给 VLM 的推理预算,并设定三个等级——低、中、高——默认使用“中”等级;在消融实验中会分析其他 VLM 主干以及不同的推理预算
AdaptiveStep 插件使用两种平移步长:当目标在腕部视角中可见时使用 2 cm 的精细步长,否则使用 4 cm 的粗步长。该简单配置已足以完成基本的抓取-放置任务,同时 VLM 无需微调即可灵活适应更细粒度的步长(参见第 5.3 节)
动作历史保留最近 5 个动作。如原论文所说,第 3.3 节中的所有插件在默认情况下均被启用,除了 Situated Planning 和 VisualPrompt,它们仅在需要时被激活 - 微调小型 VLM(FT 模式)
作者默认使用Qwen3.5-2B [72],并在消融实验中分析不同模型容量。且在所有语言模型的线性层上应用 rank-64 的 LoRA [33] 适配器,同时冻结视觉编码器和多模态投影层,仅更新约 3% 的参数
第四,对于基线方法
作者将本方法与三大代表性机器人控制系统家族进行对比:
- VLA 基线:这类方法将观测和指令直接映射为低层级机器人动作,包括 π0.5 [9] 和 GR00T [7]
为进行可控的公平比较,且对二者都进行了微调,使用与训练作者 VLM 策略相同的一组示范,将其转换为连续末端执行器轨迹 - 以 VLA 为中心的智能体
这类方法保留 VLA 作为主要的物理执行模块,同时在其外部增加智能体层以实现规划、监控或干预
代表方法为 Harness VLA [100](在表中记为 H-VLA),和 Goal-VLA [14](在表中记为 G-VLA) - 代码即策略(code-as-policy)智能体:这类方法将高层推理翻译为可执行程序或 API 调用,代表方法为 CaP-X [28] 和 RATS [98]
第五,对于演示数据收集
- 为进行开源 VLM 训练以及可训练的 VLA 基线,作者通过 GUMI 使用人类键盘控制以及前沿 VLM 在浏览器界面中的 rollout 来收集演示数据
总体上,作者在共享 2cm 平移设置下收集了 164 段真实机器人实验轨迹(7.8K 个决策步):其中7 自由度 Franka 机器人上采集了 101 段(5.0K 步),单臂 AgileX 机器人上采集了 63段(2.8K 步) - 然后作者把微调后的策略与对比的 VLA 基线共同在来自这两种机体形态的演示数据上进行训练
————
对于 sim-to-real 实验,所有对比模型都在 230 段通过相同接口收集的模拟轨迹(13.5K 步)上进行训练,这些数据覆盖两个模拟器:其中在 ManiSkill[81] 中使用默认 Panda 机械手采集了 100 段,在 RoboLab [90] 中针对 12 个抓取与放置任务共采集了 130 段。更多细节见附录 7.2
1.3.2 主要结果
如原论文所述,作者主要评估了三个层级的泛化能力,其概括见表 2
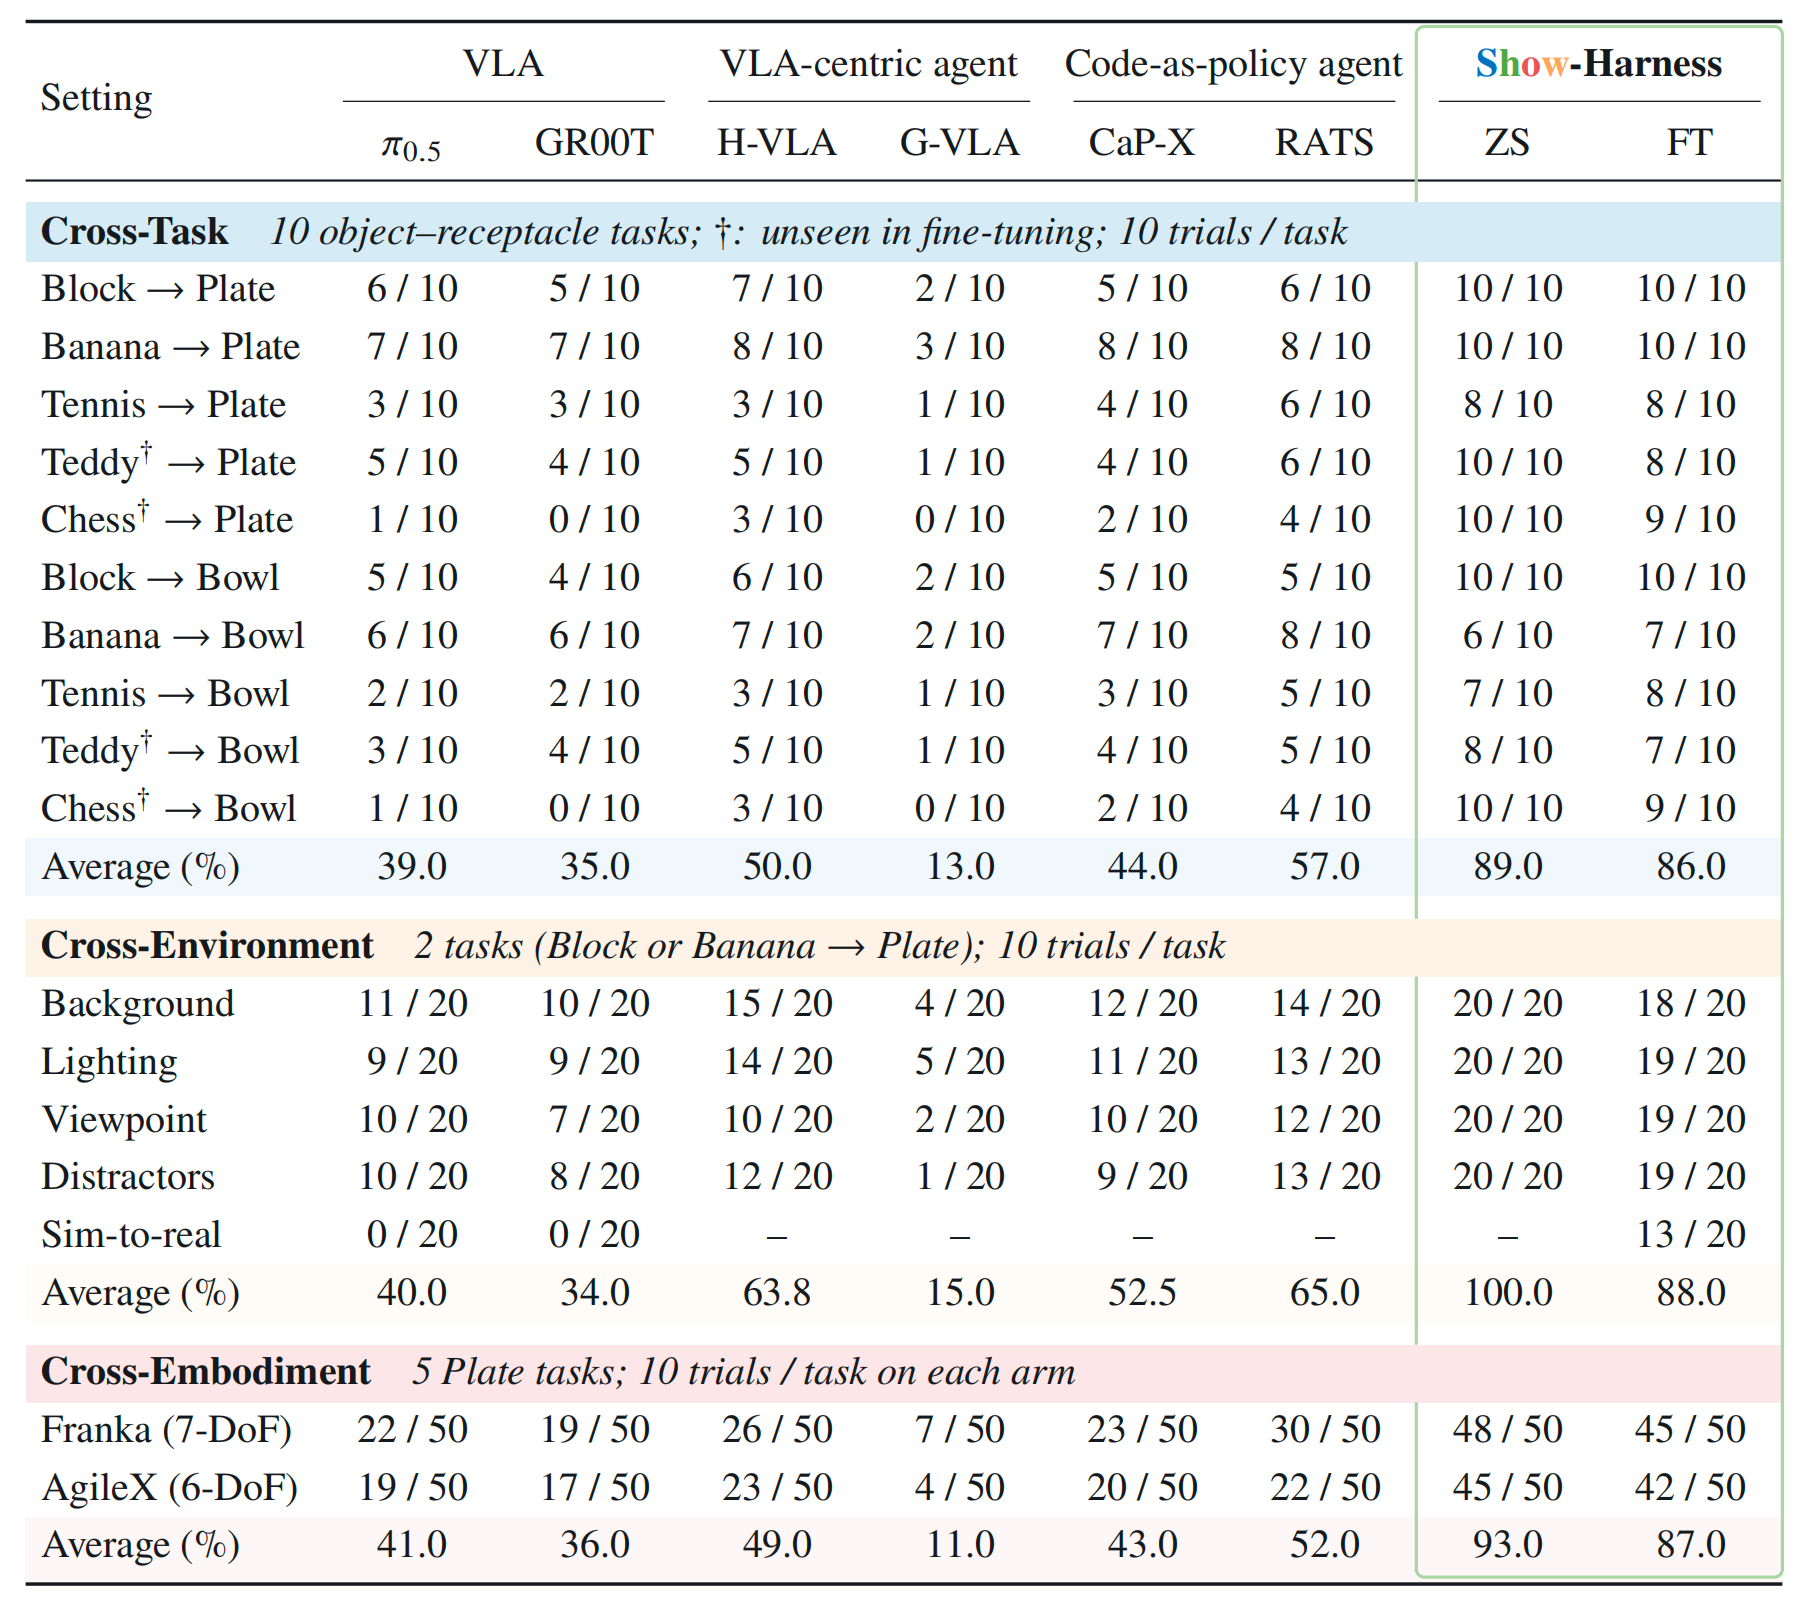
- 跨任务设置涵盖所有十个“物体–容器”任务
- 跨环境评估背景、光照、视角、干扰物,以及训练阶段或标准测试设置中未出现的仿真到现实(sim-to-real)分布迁移
对于仿真到现实场景,可训练方法仅使用通过同一 GUMI 接口在仿真环境中收集的演示数据进行训练,并在真实 Franka 机械臂上进行评估 - 跨形体评估 Franka 机械臂与 AgileX 机械臂之间的迁移:零样本(zero-shot)智能体仅通过特定于形体的解释器来切换形体,而微调后的策略在来自两种形体的演示数据上共同训练,并直接在每个机械臂上进行评估
// 待更

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献121条内容

所有评论(0)