基于YOLO11端到端的视觉空间定位方法研究
摘 要
随着移动机器人、自主导航、增强现实和智慧空间等应用的发展,基于图像的视觉空间定位技术受到越来越多关注。针对传统定位方法在复杂建筑场景中部署成本高、流程复杂等问题,本文围绕端到端视觉空间定位方法展开研究,设计并实现了一个基于单张场景图像预测相机三维位置的实验系统。系统采用 Cambridge Landmarks 数据集中的 Kings College 场景作为实验对象,输入为单张 RGB 图像,输出为相机在场景坐标系下的三维位置坐标 x、y、z。本文首先完成数据集解析、图像预处理和坐标标准化处理;然后构建 ResNet18 空间位置回归基线模型、改进 ResNet 空间位置回归模型和 YOLO11 改造空间位置回归模型,并进行对比实验。改进 ResNet 模型在 ResNet18 骨干网络基础上引入门控残差修正结构,使模型能够在稳定主预测基础上学习细粒度位置偏差。实验结果表明,改进 ResNet 模型平均定位误差为 1.208 m,低于 ResNet18 基线模型的 1.333 m,Success@1m 达到 61.8%,优于基线模型的 59.8%;YOLO11 改造模型平均误差为 4.016 m,说明目标检测模型直接迁移到整图空间坐标回归任务时适配性较弱。最后,本文基于 FastAPI 和 Vue 实现了视觉空间定位实验系统,支持数据集展示、图像推理、训练指标可视化和模型对比分析。实验结果验证了端到端视觉空间定位方法的可行性,也说明门控残差修正结构能够提升连续空间坐标回归效果。
关键词: 视觉空间定位;端到端学习;ResNet;位置回归;Kings College
Abstract
With the development of mobile robots, autonomous navigation, augmented reality, and intelligent spatial applications, image-based visual localization has attracted increasing attention. To address the problems of high deployment cost and complex processing pipelines in traditional localization methods, this thesis studies an end-to-end visual spatial localization method and designs an experimental system for predicting the three-dimensional camera position from a single scene image. The Kings College scene from the Cambridge Landmarks dataset is used as the experimental object. The input of the system is a single RGB image, and the output is the three-dimensional camera position coordinates x, y, and z in the scene coordinate system. First, dataset parsing, image preprocessing, and coordinate normalization are completed. Then, three models are constructed and compared, including a ResNet18 position regression baseline model, an improved ResNet position regression model, and a modified YOLO11 position regression model. The improved ResNet introduces a gated residual correction structure based on the ResNet18 backbone, enabling the model to learn fine-grained position offsets while maintaining stable main predictions. Experimental results show that the improved ResNet achieves an average localization error of 1.208 m, lower than 1.333 m of the ResNet18 baseline, and its Success@1m reaches 61.8%, higher than 59.8% of the baseline model. The modified YOLO11 model obtains an average error of 4.016 m, indicating that object detection models are not well suited for direct transfer to whole-image spatial coordinate regression tasks. Finally, a visual spatial localization experimental system is implemented based on FastAPI and Vue, supporting dataset visualization, image inference, training metric visualization, and model comparison. The results verify the feasibility of end-to-end visual spatial localization and demonstrate that the gated residual correction structure can improve continuous spatial coordinate regression performance.
Key Words: visual spatial localization; end-to-end learning; ResNet; position regression; Kings College
目 录
随着移动机器人、自主导航、增强现实、智慧城市与数字孪生等应用的发展,设备在复杂环境中获取自身空间位置的能力变得越来越重要。传统卫星定位方法在室内、遮挡严重或尺度较小的建筑场景中容易受到信号衰减和多路径效应影响,难以满足精细化定位需求。视觉定位利用摄像机采集的场景图像识别环境结构和空间线索,具有设备成本低、信息量丰富、部署灵活等特点,因此成为计算机视觉和智能系统领域的重要研究方向。
视觉空间定位的核心任务是根据图像内容估计相机在场景坐标系中的位置或位姿。传统方法通常依赖局部特征提取、特征匹配、三维地图构建和几何优化等步骤,具有较好的几何解释性,但系统流程较长,对特征质量、地图维护和匹配鲁棒性要求较高。深度学习方法则尝试直接从图像中学习场景表达,将视觉输入映射为连续空间坐标。PoseNet 等工作证明卷积神经网络能够从单张 RGB 图像中端到端回归相机位姿,为简化视觉定位流程提供了新的研究思路[1]。
本课题面向端到端视觉空间定位方法展开研究,选取 Cambridge Landmarks 数据集中的 Kings College 场景作为实验对象。根据项目代码与数据统计,当前数据共包含 1565 张图像,其中训练样本 1220 张、测试样本 343 张。每条标注包含图像路径、三维位置坐标 x、y、z 以及姿态四元数 w、p、q、r。本阶段研究聚焦于位置坐标预测,即输入单张建筑场景图像,输出对应的三维空间位置 x、y、z;姿态四元数字段仅作为原始标注保留,不作为当前训练目标。
开展该课题具有两方面意义。理论上,端到端视觉定位将图像特征提取、空间表达学习和坐标回归统一到同一模型中,有助于分析卷积神经网络对建筑场景全局结构、视角变化和光照扰动的表达能力。工程上,本课题不仅完成模型训练与评估,还实现了基于 FastAPI 的后端推理服务和基于 Vue 的前端可视化工作台,可以展示数据集、训练指标、模型对比和单图定位结果,为毕业设计答辩和后续实验扩展提供可运行、可展示的系统支撑。
国内关于视觉定位和视觉重定位的研究主要围绕机器人导航、无人车定位、室内服务系统、智慧园区与工业巡检等应用展开[1-2]。早期研究更多采用人工特征、词袋模型、图像检索、SLAM 与三维重建等方法,通过图像特征匹配和几何约束求解相机位置[3]。该类方法在场景结构清晰、纹理充分且地图可维护的情况下具有较高精度,但在光照变化、重复纹理、动态遮挡和低纹理区域中容易出现匹配不稳定问题[4-5]。
近年来,国内相关研究逐渐引入深度学习特征、卷积神经网络和注意力机制,将学习型图像表达用于场景检索、特征匹配、位姿回归和视觉惯性融合等任务[6]。一类研究将深度特征与传统几何流程结合,用学习特征替代人工特征,提高弱纹理和光照变化条件下的匹配鲁棒性;另一类研究直接采用端到端网络预测位置或位姿,降低系统工程复杂度[7]。对于本科毕业设计场景而言,端到端位置回归模型更便于在有限数据和算力条件下形成完整实验闭环,也更适合作为系统演示的核心算法[8]。
从实现难度和课题目标看,本研究并不追求构建大规模三维地图或完整 SLAM 系统,而是围绕单一公开场景开展端到端空间位置预测实验。代码目录中的 data、models、training、evaluation、app 和 frontend 模块分别对应数据处理、模型构建、训练评估、后端接口与前端展示,形成从数据读取到结果可视化的完整链路。这种设计更符合毕业论文对方法完整性、实验可复现性和系统可运行性的要求。
国外关于视觉定位的研究起步较早,既包括基于三维地图和几何约束的结构化方法,也包括基于深度学习的端到端回归方法[9]。Kendall 等提出的 PoseNet 将卷积神经网络用于单张图像的 6 自由度相机重定位,证明了深度网络可以直接学习图像到相机位姿的映射关系[10]。该思路简化了传统定位流程,但也带来了对训练数据分布敏感、跨场景泛化能力有限、精度受场景表达影响较大等问题。
为提高深度定位模型的几何一致性,后续研究开始将地图、序列约束和优化思想融入学习过程[12]。MapNet 将地图表示建模为深度网络,并利用视觉里程计、GPS 等信息形成几何约束,使模型训练不再只依赖单帧监督[13]。DSAC 则将 RANSAC 中的假设选择过程改造成可微形式,使鲁棒几何估计能够进入端到端训练流程[14]。这类研究说明,单纯的图像到坐标回归虽然流程简洁,但若能结合几何先验或鲁棒优化,定位精度和稳定性往往会进一步提升。
另一类国外研究强调检索、局部特征匹配与三维重建的组合,例如层次化视觉定位方法通过全局描述子完成候选图像检索,再利用局部特征进行精确匹配和位姿求解,在大规模场景中表现出较好的精度和可扩展性[15]。与这类复杂系统相比,本课题的研究对象更聚焦:在 Kings College 单场景内进行 x、y、z 三维位置回归,并比较 ResNet18 基线模型、改进 ResNet 模型和 YOLO11 改造模型的效果。该选择既保留了端到端学习方法的研究价值,又能结合项目代码完成训练、评估和系统展示。
综合国内外研究可以看出,视觉定位方法大致呈现两条路线:一是重视地图、特征匹配和几何求解的结构化路线,二是重视端到端表达学习和连续坐标回归的学习型路线。前者精度较高但工程链路复杂,后者部署简洁但需要针对数据集和模型结构进行优化。本课题以第二条路线为主,同时通过 YOLO11 改造模型与 ResNet 系列模型的对比,分析不同视觉骨干对整图空间坐标回归任务的适配差异。
本课题的总体目标是设计并实现一个端到端视觉空间定位实验系统,使系统能够以单张 Kings College 场景图像作为输入,预测相机在场景坐标系中的三维位置坐标 x、y、z,并通过训练指标、对比实验和前端页面展示模型效果。围绕这一目标,本文将研究重点放在数据集解析、模型构建、训练评估、推理服务和可视化展示五个方面。
第一,完成 Kings College 数据集读取与预处理。后端 data 目录中的 kings_college.py 负责解析 dataset_train.txt 和 dataset_test.txt,将每条标注组织为包含图像路径、三维位置和四元数信息的样本结构;transforms.py 负责图像尺寸调整、归一化、数据增强以及 YOLO 输入所需的 letterbox 处理;validate_dataset.py 负责生成数据集摘要并校验缺失图像和无效标注。训练阶段使用训练集坐标均值和标准差对 x、y、z 进行标准化,推理阶段再将模型输出反归一化为真实米制坐标。
第二,构建端到端位置回归模型。models 目录中实现了 ResNet18PoseRegressor、ResNetImprovedPoseRegressor 和 yolo11_pose_improved 三类模型。ResNet18 基线模型将原始分类头替换为 512→256→3 的回归头;改进 ResNet 在 ResNet18 全局特征后加入门控残差修正头,保留主回归分支,同时通过零初始化残差分支学习细粒度位置偏差;YOLO11 改造模型将检测模型的特征提取能力迁移到位置回归任务中,用于验证目标检测骨干在该任务上的适配性。
第三,设计训练与评价流程。training 目录中的 train.py 和 engine.py 负责训练命令解析、模型构建、优化器设置、学习率调度、日志记录和最优权重保存;metrics.py 计算平均位置误差、中位位置误差、P90 误差以及 Success@0.5m、Success@1m、Success@2m 等指标。losses.py 中的 PoseLoss 不仅计算标准化坐标空间下的 SmoothL1 损失,还结合真实米制位置误差和成功阈值约束,使训练目标更贴近最终评价指标。
第四,完成推理服务和实验结果展示。app 目录基于 FastAPI 提供健康检查、数据集摘要、测试图像列表、数据集图像推理、上传图像推理、训练指标读取和实验报告读取等接口。frontend 目录基于 Vue 3 与 Vite 实现前端工作台,包含总览、数据集、推理、训练指标和实验对比五个页面。通过前后端联调,系统可以展示模型训练曲线、真实训练指标、三模型对比结果以及单张图像定位输出。
第五,完成模型对比与结论分析。根据当前训练结果,改进 ResNet 在验证损失、平均误差、中位误差、P90 误差、最大误差和 Success@1m 等指标上优于 ResNet18 基线模型;YOLO11 改造模型的平均误差和 Success 指标明显落后,说明其面向目标检测的结构并不适合作为本课题最终主模型。本文将结合实验结果分析不同模型结构对单图空间定位任务的影响,并给出最终模型选择依据。
本文围绕端到端视觉空间定位方法研究与系统实现展开,全文共分为六章。
第1章为绪论。主要介绍视觉空间定位的研究背景和意义,分析国内外相关研究现状,明确本文的研究目标、研究内容和论文整体结构。
第2章为相关技术基础。主要介绍本文涉及的 Python 编程语言、PyTorch 深度学习框架、卷积神经网络、FastAPI 后端接口技术以及 Vue 前端框架,为后续系统设计和模型实现提供理论与技术支撑。
第3章为系统设计。主要从总体架构、功能模块和数据流程三个角度展开,说明数据集管理、模型训练、图像定位推理、训练指标可视化和实验对比等模块的设计思路,并给出前后端交互关系。
第4章为模型构建与实验分析。主要介绍 Kings College 数据集、图像预处理方法、ResNet18 基线模型、改进 ResNet 模型、YOLO11 改造模型、训练策略与评价指标,并结合训练结果分析不同模型的定位效果。
第5章为系统实现与测试。主要说明后端 API、模型推理服务、前端可视化页面和实验结果展示的具体实现过程,并从功能测试、性能测试和可视化效果等方面验证系统可用性。
第6章为总结与展望。主要总结本文完成的工作和实验结论,分析当前方法在数据规模、姿态预测、跨场景泛化和鲁棒性方面的不足,并对后续研究方向进行展望。
本章从研究背景、研究现状、研究目标和论文结构四个方面对课题进行了总体说明。后续章节将在此基础上进一步介绍相关技术、系统设计、模型构建、实验分析和系统测试内容。
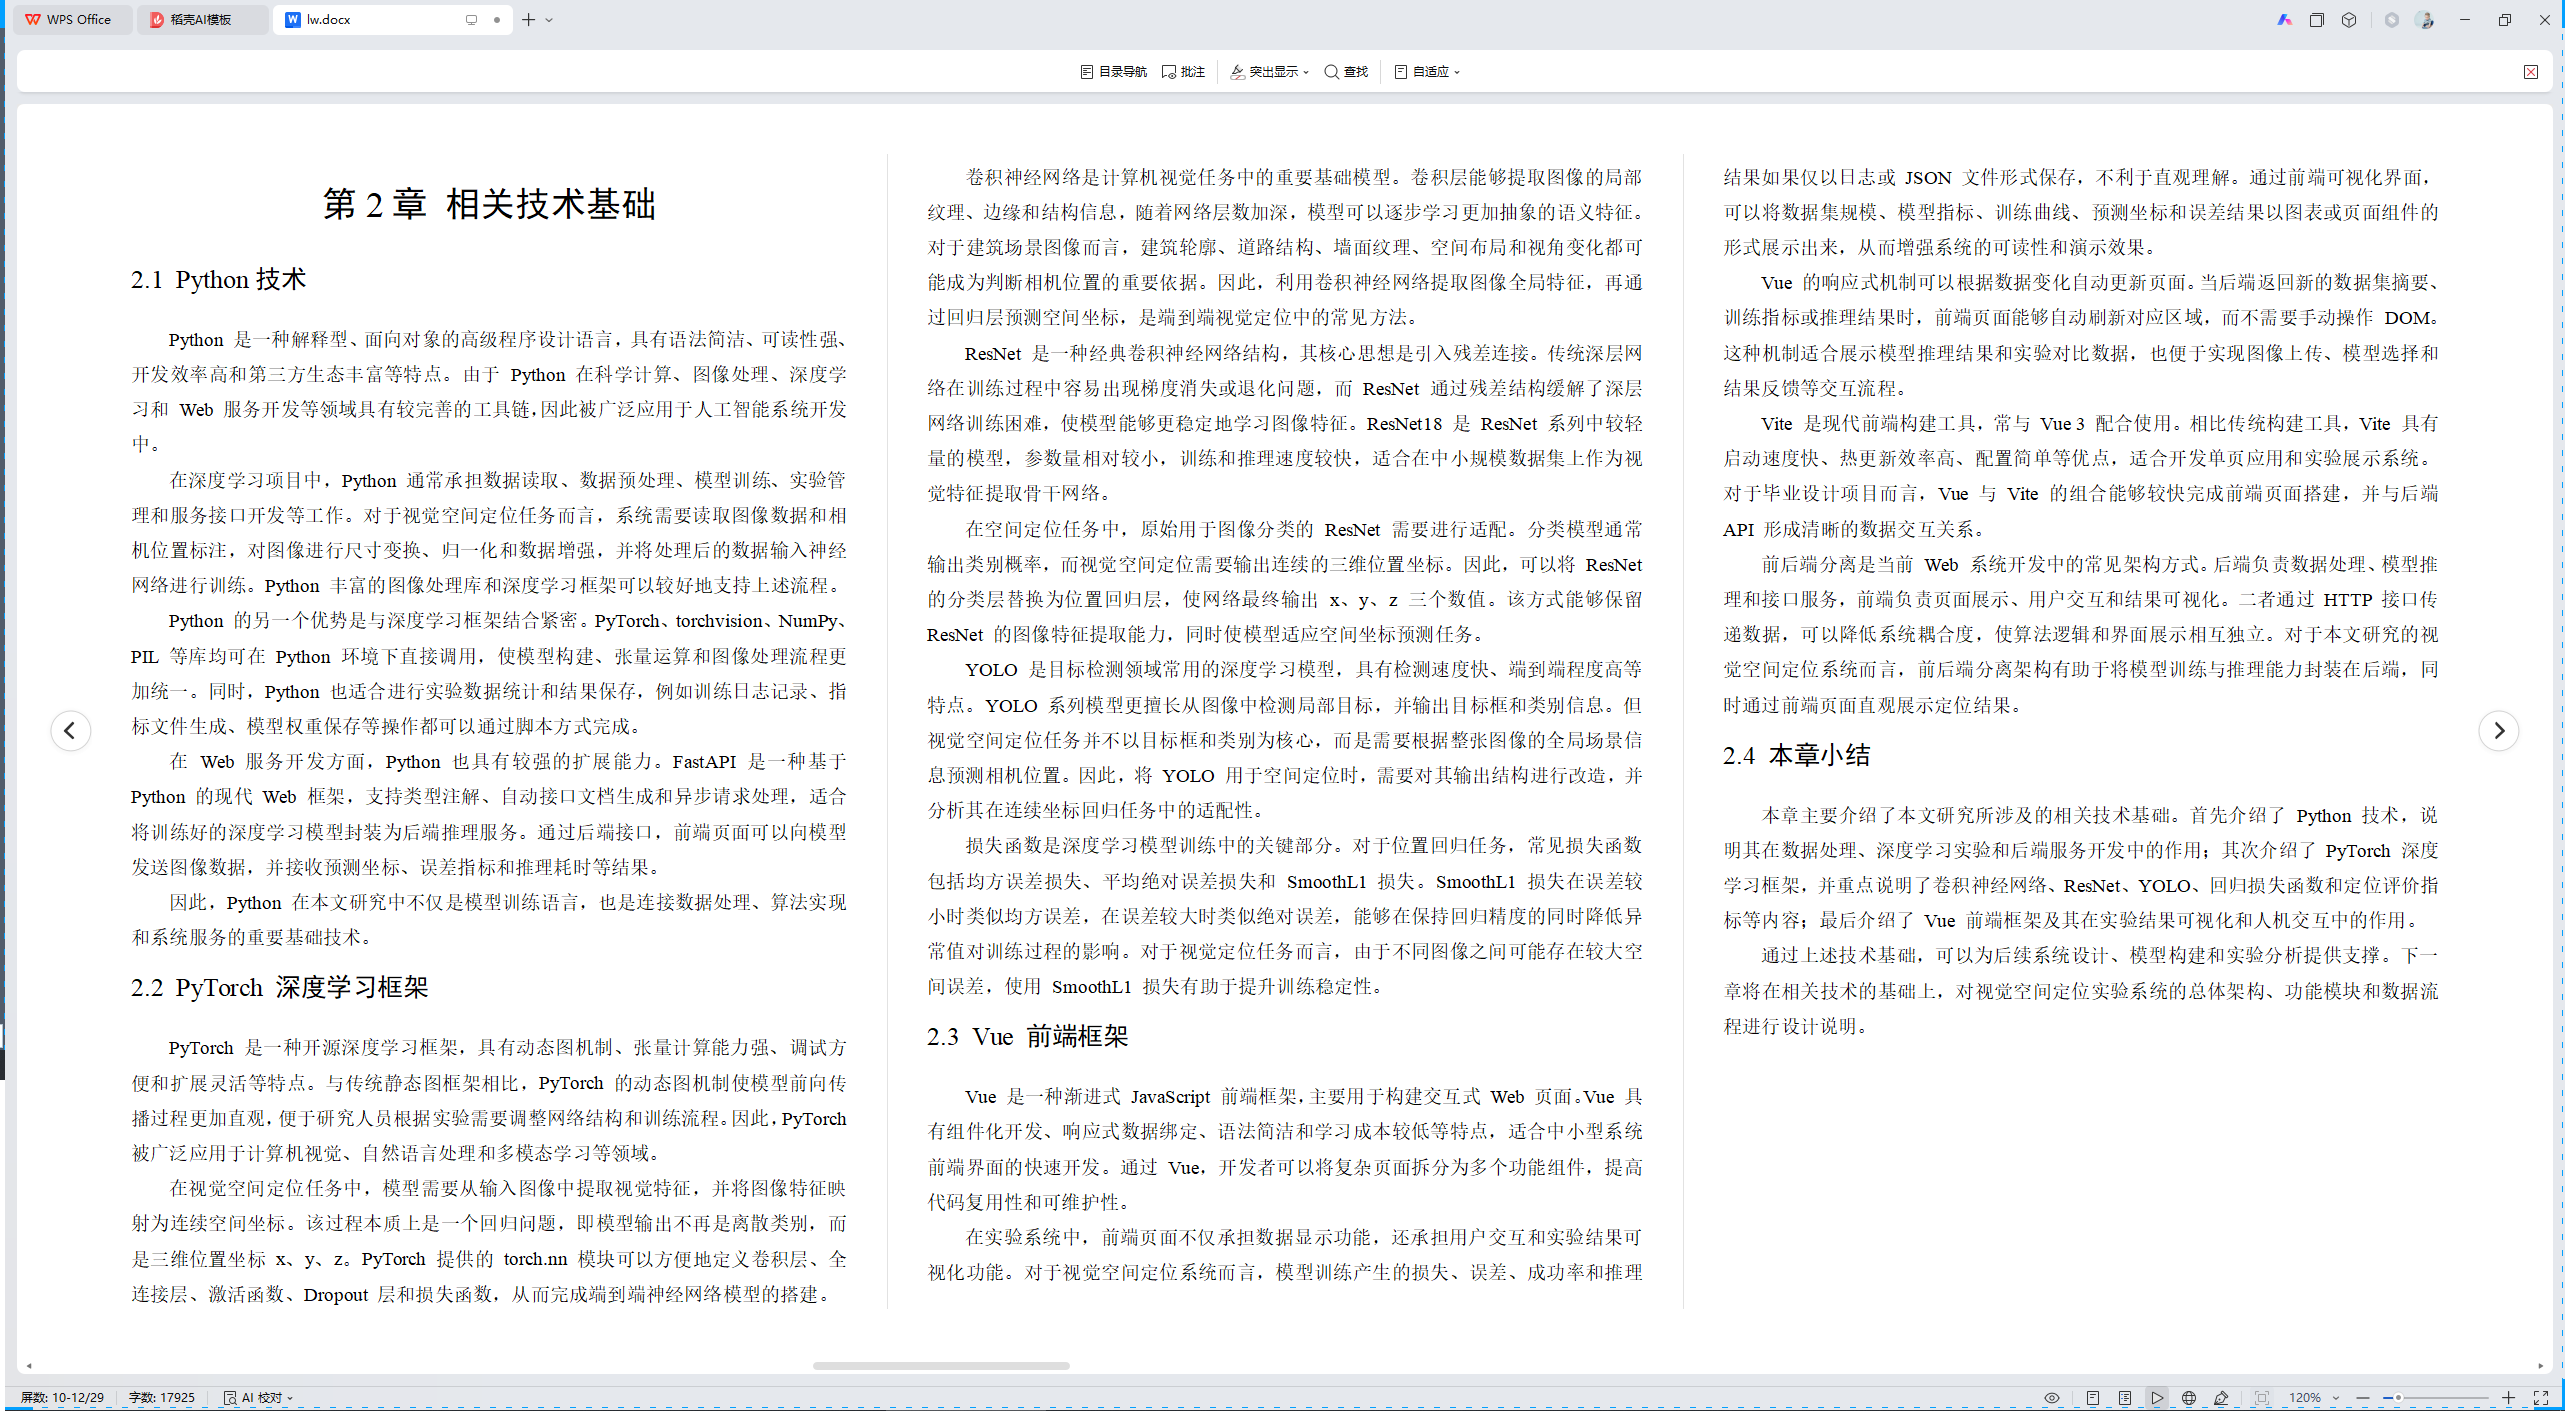
Python 是一种解释型、面向对象的高级程序设计语言,具有语法简洁、可读性强、开发效率高和第三方生态丰富等特点。由于 Python 在科学计算、图像处理、深度学习和 Web 服务开发等领域具有较完善的工具链,因此被广泛应用于人工智能系统开发中。
在深度学习项目中,Python 通常承担数据读取、数据预处理、模型训练、实验管理和服务接口开发等工作。对于视觉空间定位任务而言,系统需要读取图像数据和相机位置标注,对图像进行尺寸变换、归一化和数据增强,并将处理后的数据输入神经网络进行训练。Python 丰富的图像处理库和深度学习框架可以较好地支持上述流程。
Python 的另一个优势是与深度学习框架结合紧密。PyTorch、torchvision、NumPy、PIL 等库均可在 Python 环境下直接调用,使模型构建、张量运算和图像处理流程更加统一。同时,Python 也适合进行实验数据统计和结果保存,例如训练日志记录、指标文件生成、模型权重保存等操作都可以通过脚本方式完成。
在 Web 服务开发方面,Python 也具有较强的扩展能力。FastAPI 是一种基于 Python 的现代 Web 框架,支持类型注解、自动接口文档生成和异步请求处理,适合将训练好的深度学习模型封装为后端推理服务。通过后端接口,前端页面可以向模型发送图像数据,并接收预测坐标、误差指标和推理耗时等结果。
因此,Python 在本文研究中不仅是模型训练语言,也是连接数据处理、算法实现和系统服务的重要基础技术。
PyTorch 是一种开源深度学习框架,具有动态图机制、张量计算能力强、调试方便和扩展灵活等特点。与传统静态图框架相比,PyTorch 的动态图机制使模型前向传播过程更加直观,便于研究人员根据实验需要调整网络结构和训练流程。因此,PyTorch 被广泛应用于计算机视觉、自然语言处理和多模态学习等领域。
在视觉空间定位任务中,模型需要从输入图像中提取视觉特征,并将图像特征映射为连续空间坐标。该过程本质上是一个回归问题,即模型输出不再是离散类别,而是三维位置坐标 x、y、z。PyTorch 提供的 torch.nn 模块可以方便地定义卷积层、全连接层、激活函数、Dropout 层和损失函数,从而完成端到端神经网络模型的搭建。
卷积神经网络是计算机视觉任务中的重要基础模型。卷积层能够提取图像的局部纹理、边缘和结构信息,随着网络层数加深,模型可以逐步学习更加抽象的语义特征。对于建筑场景图像而言,建筑轮廓、道路结构、墙面纹理、空间布局和视角变化都可能成为判断相机位置的重要依据。因此,利用卷积神经网络提取图像全局特征,再通过回归层预测空间坐标,是端到端视觉定位中的常见方法。
ResNet 是一种经典卷积神经网络结构,其核心思想是引入残差连接。传统深层网络在训练过程中容易出现梯度消失或退化问题,而 ResNet 通过残差结构缓解了深层网络训练困难,使模型能够更稳定地学习图像特征。ResNet18 是 ResNet 系列中较轻量的模型,参数量相对较小,训练和推理速度较快,适合在中小规模数据集上作为视觉特征提取骨干网络。
在空间定位任务中,原始用于图像分类的 ResNet 需要进行适配。分类模型通常输出类别概率,而视觉空间定位需要输出连续的三维位置坐标。因此,可以将 ResNet 的分类层替换为位置回归层,使网络最终输出 x、y、z 三个数值。该方式能够保留 ResNet 的图像特征提取能力,同时使模型适应空间坐标预测任务。
YOLO 是目标检测领域常用的深度学习模型,具有检测速度快、端到端程度高等特点。YOLO 系列模型更擅长从图像中检测局部目标,并输出目标框和类别信息。但视觉空间定位任务并不以目标框和类别为核心,而是需要根据整张图像的全局场景信息预测相机位置。因此,将 YOLO 用于空间定位时,需要对其输出结构进行改造,并分析其在连续坐标回归任务中的适配性。
损失函数是深度学习模型训练中的关键部分。对于位置回归任务,常见损失函数包括均方误差损失、平均绝对误差损失和 SmoothL1 损失。SmoothL1 损失在误差较小时类似均方误差,在误差较大时类似绝对误差,能够在保持回归精度的同时降低异常值对训练过程的影响。对于视觉定位任务而言,由于不同图像之间可能存在较大空间误差,使用 SmoothL1 损失有助于提升训练稳定性。
Vue 是一种渐进式 JavaScript 前端框架,主要用于构建交互式 Web 页面。Vue 具有组件化开发、响应式数据绑定、语法简洁和学习成本较低等特点,适合中小型系统前端界面的快速开发。通过 Vue,开发者可以将复杂页面拆分为多个功能组件,提高代码复用性和可维护性。
在实验系统中,前端页面不仅承担数据显示功能,还承担用户交互和实验结果可视化功能。对于视觉空间定位系统而言,模型训练产生的损失、误差、成功率和推理结果如果仅以日志或 JSON 文件形式保存,不利于直观理解。通过前端可视化界面,可以将数据集规模、模型指标、训练曲线、预测坐标和误差结果以图表或页面组件的形式展示出来,从而增强系统的可读性和演示效果。
Vue 的响应式机制可以根据数据变化自动更新页面。当后端返回新的数据集摘要、训练指标或推理结果时,前端页面能够自动刷新对应区域,而不需要手动操作 DOM。这种机制适合展示模型推理结果和实验对比数据,也便于实现图像上传、模型选择和结果反馈等交互流程。
Vite 是现代前端构建工具,常与 Vue 3 配合使用。相比传统构建工具,Vite 具有启动速度快、热更新效率高、配置简单等优点,适合开发单页应用和实验展示系统。对于毕业设计项目而言,Vue 与 Vite 的组合能够较快完成前端页面搭建,并与后端 API 形成清晰的数据交互关系。
前后端分离是当前 Web 系统开发中的常见架构方式。后端负责数据处理、模型推理和接口服务,前端负责页面展示、用户交互和结果可视化。二者通过 HTTP 接口传递数据,可以降低系统耦合度,使算法逻辑和界面展示相互独立。对于本文研究的视觉空间定位系统而言,前后端分离架构有助于将模型训练与推理能力封装在后端,同时通过前端页面直观展示定位结果。
本章主要介绍了本文研究所涉及的相关技术基础。首先介绍了 Python 技术,说明其在数据处理、深度学习实验和后端服务开发中的作用;其次介绍了 PyTorch 深度学习框架,并重点说明了卷积神经网络、ResNet、YOLO、回归损失函数和定位评价指标等内容;最后介绍了 Vue 前端框架及其在实验结果可视化和人机交互中的作用。
通过上述技术基础,可以为后续系统设计、模型构建和实验分析提供支撑。下一章将在相关技术的基础上,对视觉空间定位实验系统的总体架构、功能模块和数据流程进行设计说明。
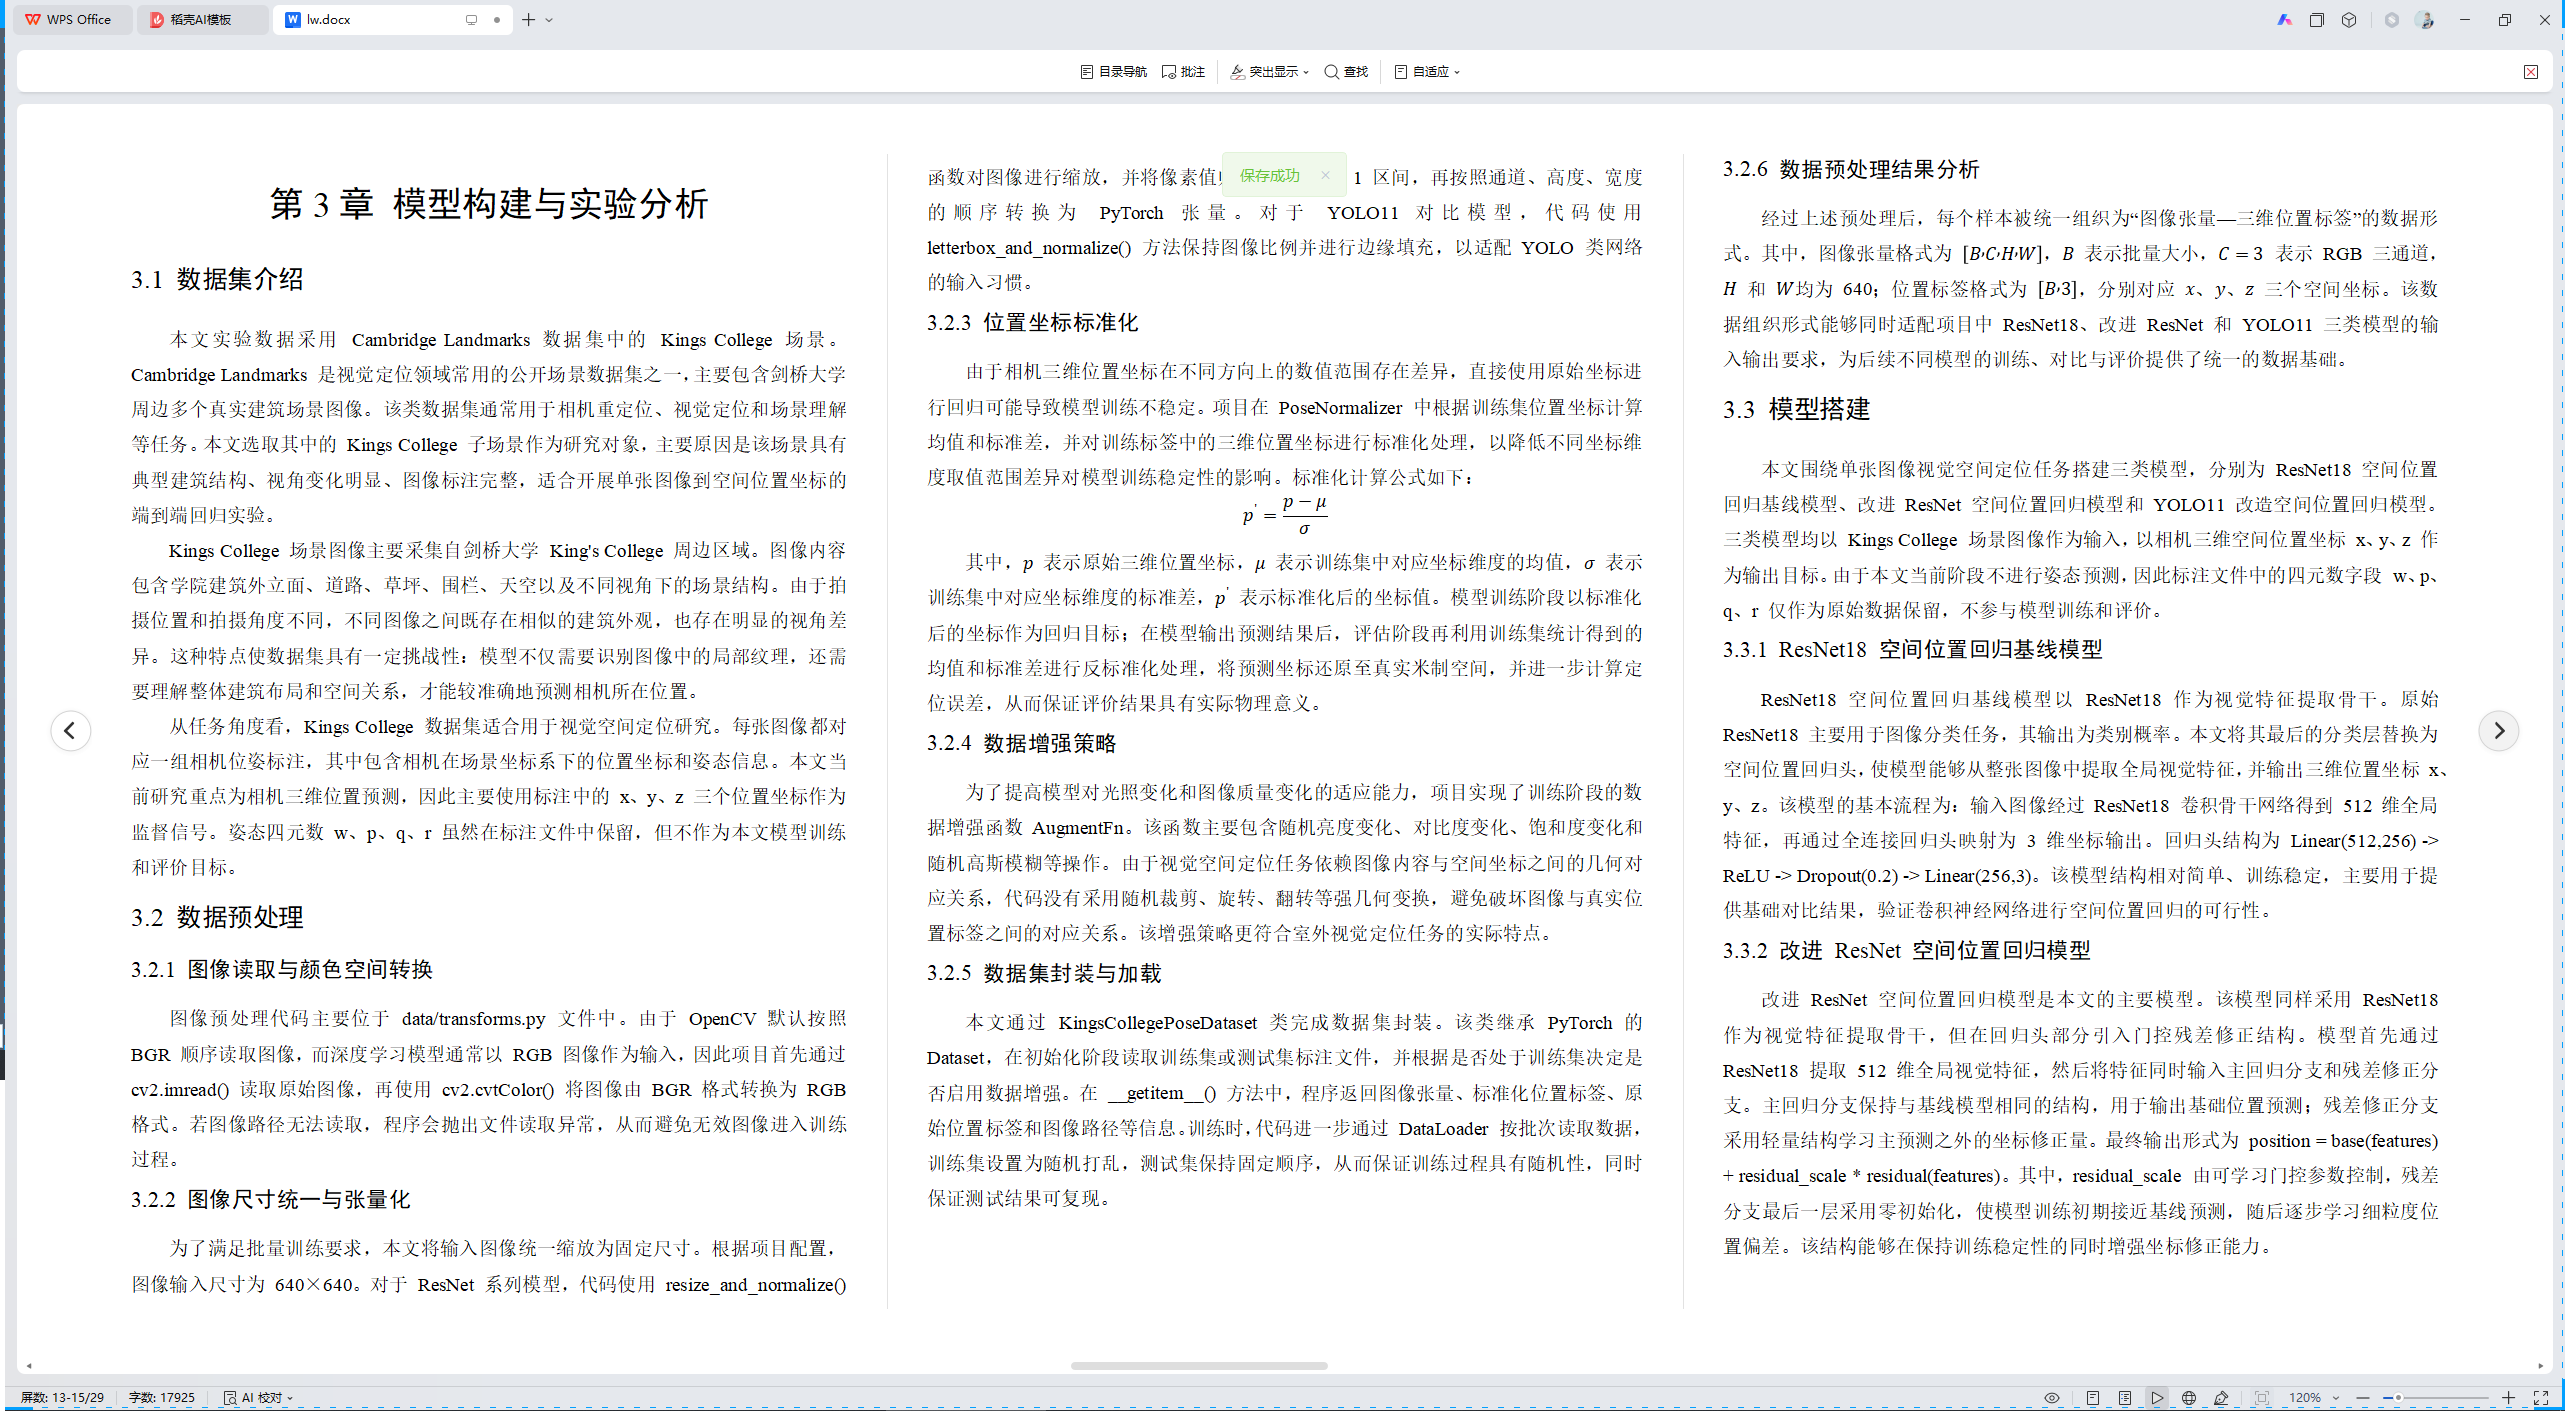
本文实验数据采用 Cambridge Landmarks 数据集中的 Kings College 场景。Cambridge Landmarks 是视觉定位领域常用的公开场景数据集之一,主要包含剑桥大学周边多个真实建筑场景图像。该类数据集通常用于相机重定位、视觉定位和场景理解等任务。本文选取其中的 Kings College 子场景作为研究对象,主要原因是该场景具有典型建筑结构、视角变化明显、图像标注完整,适合开展单张图像到空间位置坐标的端到端回归实验。
Kings College 场景图像主要采集自剑桥大学 King's College 周边区域。图像内容包含学院建筑外立面、道路、草坪、围栏、天空以及不同视角下的场景结构。由于拍摄位置和拍摄角度不同,不同图像之间既存在相似的建筑外观,也存在明显的视角差异。这种特点使数据集具有一定挑战性:模型不仅需要识别图像中的局部纹理,还需要理解整体建筑布局和空间关系,才能较准确地预测相机所在位置。
从任务角度看,Kings College 数据集适合用于视觉空间定位研究。每张图像都对应一组相机位姿标注,其中包含相机在场景坐标系下的位置坐标和姿态信息。本文当前研究重点为相机三维位置预测,因此主要使用标注中的 x、y、z 三个位置坐标作为监督信号。姿态四元数 w、p、q、r 虽然在标注文件中保留,但不作为本文模型训练和评价目标。
图像预处理代码主要位于 data/transforms.py 文件中。由于 OpenCV 默认按照 BGR 顺序读取图像,而深度学习模型通常以 RGB 图像作为输入,因此项目首先通过 cv2.imread() 读取原始图像,再使用 cv2.cvtColor() 将图像由 BGR 格式转换为 RGB 格式。若图像路径无法读取,程序会抛出文件读取异常,从而避免无效图像进入训练过程。
为了满足批量训练要求,本文将输入图像统一缩放为固定尺寸。根据项目配置,图像输入尺寸为 640×640。对于 ResNet 系列模型,代码使用 resize_and_normalize() 函数对图像进行缩放,并将像素值归一化到 0 至 1 区间,再按照通道、高度、宽度的顺序转换为 PyTorch 张量。对于 YOLO11 对比模型,代码使用 letterbox_and_normalize() 方法保持图像比例并进行边缘填充,以适配 YOLO 类网络的输入习惯。
由于相机三维位置坐标在不同方向上的数值范围存在差异,直接使用原始坐标进行回归可能导致模型训练不稳定。项目在 PoseNormalizer 中根据训练集位置坐标计算均值和标准差,并对训练标签中的三维位置坐标进行标准化处理,以降低不同坐标维度取值范围差异对模型训练稳定性的影响。标准化计算公式如下:
其中,
表示原始三维位置坐标,
表示训练集中对应坐标维度的均值,
表示训练集中对应坐标维度的标准差,
表示标准化后的坐标值。模型训练阶段以标准化后的坐标作为回归目标;在模型输出预测结果后,评估阶段再利用训练集统计得到的均值和标准差进行反标准化处理,将预测坐标还原至真实米制空间,并进一步计算定位误差,从而保证评价结果具有实际物理意义。
为了提高模型对光照变化和图像质量变化的适应能力,项目实现了训练阶段的数据增强函数 AugmentFn。该函数主要包含随机亮度变化、对比度变化、饱和度变化和随机高斯模糊等操作。由于视觉空间定位任务依赖图像内容与空间坐标之间的几何对应关系,代码没有采用随机裁剪、旋转、翻转等强几何变换,避免破坏图像与真实位置标签之间的对应关系。该增强策略更符合室外视觉定位任务的实际特点。
本文通过 KingsCollegePoseDataset 类完成数据集封装。该类继承 PyTorch 的 Dataset,在初始化阶段读取训练集或测试集标注文件,并根据是否处于训练集决定是否启用数据增强。在 __getitem__() 方法中,程序返回图像张量、标准化位置标签、原始位置标签和图像路径等信息。训练时,代码进一步通过 DataLoader 按批次读取数据,训练集设置为随机打乱,测试集保持固定顺序,从而保证训练过程具有随机性,同时保证测试结果可复现。
经过上述预处理后,每个样本被统一组织为“图像张量—三维位置标签”的数据形式。其中,图像张量格式为 三个空间坐标。该数据组织形式能够同时适配项目中 ResNet18、改进 ResNet 和 YOLO11 三类模型的输入输出要求,为后续不同模型的训练、对比与评价提供了统一的数据基础。
本文围绕单张图像视觉空间定位任务搭建三类模型,分别为 ResNet18 空间位置回归基线模型、改进 ResNet 空间位置回归模型和 YOLO11 改造空间位置回归模型。三类模型均以 Kings College 场景图像作为输入,以相机三维空间位置坐标 x、y、z 作为输出目标。由于本文当前阶段不进行姿态预测,因此标注文件中的四元数字段 w、p、q、r 仅作为原始数据保留,不参与模型训练和评价。
ResNet18 空间位置回归基线模型以 ResNet18 作为视觉特征提取骨干。原始 ResNet18 主要用于图像分类任务,其输出为类别概率。本文将其最后的分类层替换为空间位置回归头,使模型能够从整张图像中提取全局视觉特征,并输出三维位置坐标 x、y、z。该模型的基本流程为:输入图像经过 ResNet18 卷积骨干网络得到 512 维全局特征,再通过全连接回归头映射为 3 维坐标输出。回归头结构为 Linear(512,256) -> ReLU -> Dropout(0.2) -> Linear(256,3)。该模型结构相对简单、训练稳定,主要用于提供基础对比结果,验证卷积神经网络进行空间位置回归的可行性。
改进 ResNet 空间位置回归模型是本文的主要模型。该模型同样采用 ResNet18 作为视觉特征提取骨干,但在回归头部分引入门控残差修正结构。模型首先通过 ResNet18 提取 512 维全局视觉特征,然后将特征同时输入主回归分支和残差修正分支。主回归分支保持与基线模型相同的结构,用于输出基础位置预测;残差修正分支采用轻量结构学习主预测之外的坐标修正量。最终输出形式为 position = base(features) + residual_scale * residual(features)。其中,residual_scale 由可学习门控参数控制,残差分支最后一层采用零初始化,使模型训练初期接近基线预测,随后逐步学习细粒度位置偏差。该结构能够在保持训练稳定性的同时增强坐标修正能力。
YOLO11 改造空间位置回归模型用于对比分析目标检测骨干在视觉定位任务中的适配性。YOLO11 原本面向目标检测任务,主要输出目标框和类别信息,而本文任务不涉及目标框和类别预测,因此需要将其改造为三维位置回归模型。本文保留 YOLO11 的特征提取能力,并将输出目标调整为相机位置坐标 x、y、z,使其能够完成整图到连续坐标的预测。由于 YOLO 系列模型更强调局部目标检测特征,而视觉空间定位更依赖整张图像的全局场景结构,因此该模型主要作为可行性对比方案,用于说明检测模型直接迁移到空间定位任务时可能存在的局限。
本文模型训练目标是最小化预测位置与真实位置之间的误差。训练时,模型输入为经过预处理的场景图像,输出为标准化后的三维位置坐标。系统根据模型输出与真实标注计算损失,并通过反向传播更新模型参数。
损失函数方面,本文以 SmoothL1 损失作为基础位置回归损失。SmoothL1 损失在误差较小时具有较高回归精度,在误差较大时对异常值不敏感,因此适合用于视觉空间定位这种连续坐标回归任务。除此之外,训练过程中还结合真实米制位置误差和定位成功阈值约束,使模型优化目标更加贴近最终评价指标。
优化器方面,本文采用 AdamW 优化器。AdamW 具有较好的训练稳定性,并能通过权重衰减降低模型过拟合风险。学习率调度方面,本文采用余弦退火策略,使学习率随着训练逐渐减小,从而帮助模型在训练后期稳定收敛。
训练过程中记录每一轮的训练损失、验证损失、平均位置误差、中位位置误差、P90 误差、Success@0.5m、Success@1m、Success@2m 和训练耗时等指标。同时,系统根据验证结果保存表现最优的模型权重,并生成训练日志和训练曲线,便于后续进行实验分析和系统展示。
模型训练入口位于 training/train.py 文件中。程序运行后首先对训练参数进行解析,主要包括模型名称、训练轮数、批量大小、学习率、随机种子以及运行设备等内容。为保证实验结果的稳定性和可复现性,程序调用 seed_everything() 函数,对 Python、NumPy 和 PyTorch 中的随机种子进行统一固定,从而减少随机初始化和数据加载顺序对实验结果的影响。
在数据加载阶段,训练集和测试集分别通过 KingsCollegePoseDataset("train") 和 KingsCollegePoseDataset("test") 构建,并进一步利用 DataLoader 进行批量化读取。其中,训练集设置 shuffle=True,以增强样本输入顺序的随机性;测试集设置 shuffle=False,保证评估结果的一致性。根据项目配置文件,模型训练默认批量大小为 8。经过数据加载后,每个批次均包含输入图像张量及其对应的三维位置标签,为后续模型前向传播和损失计算提供数据基础。
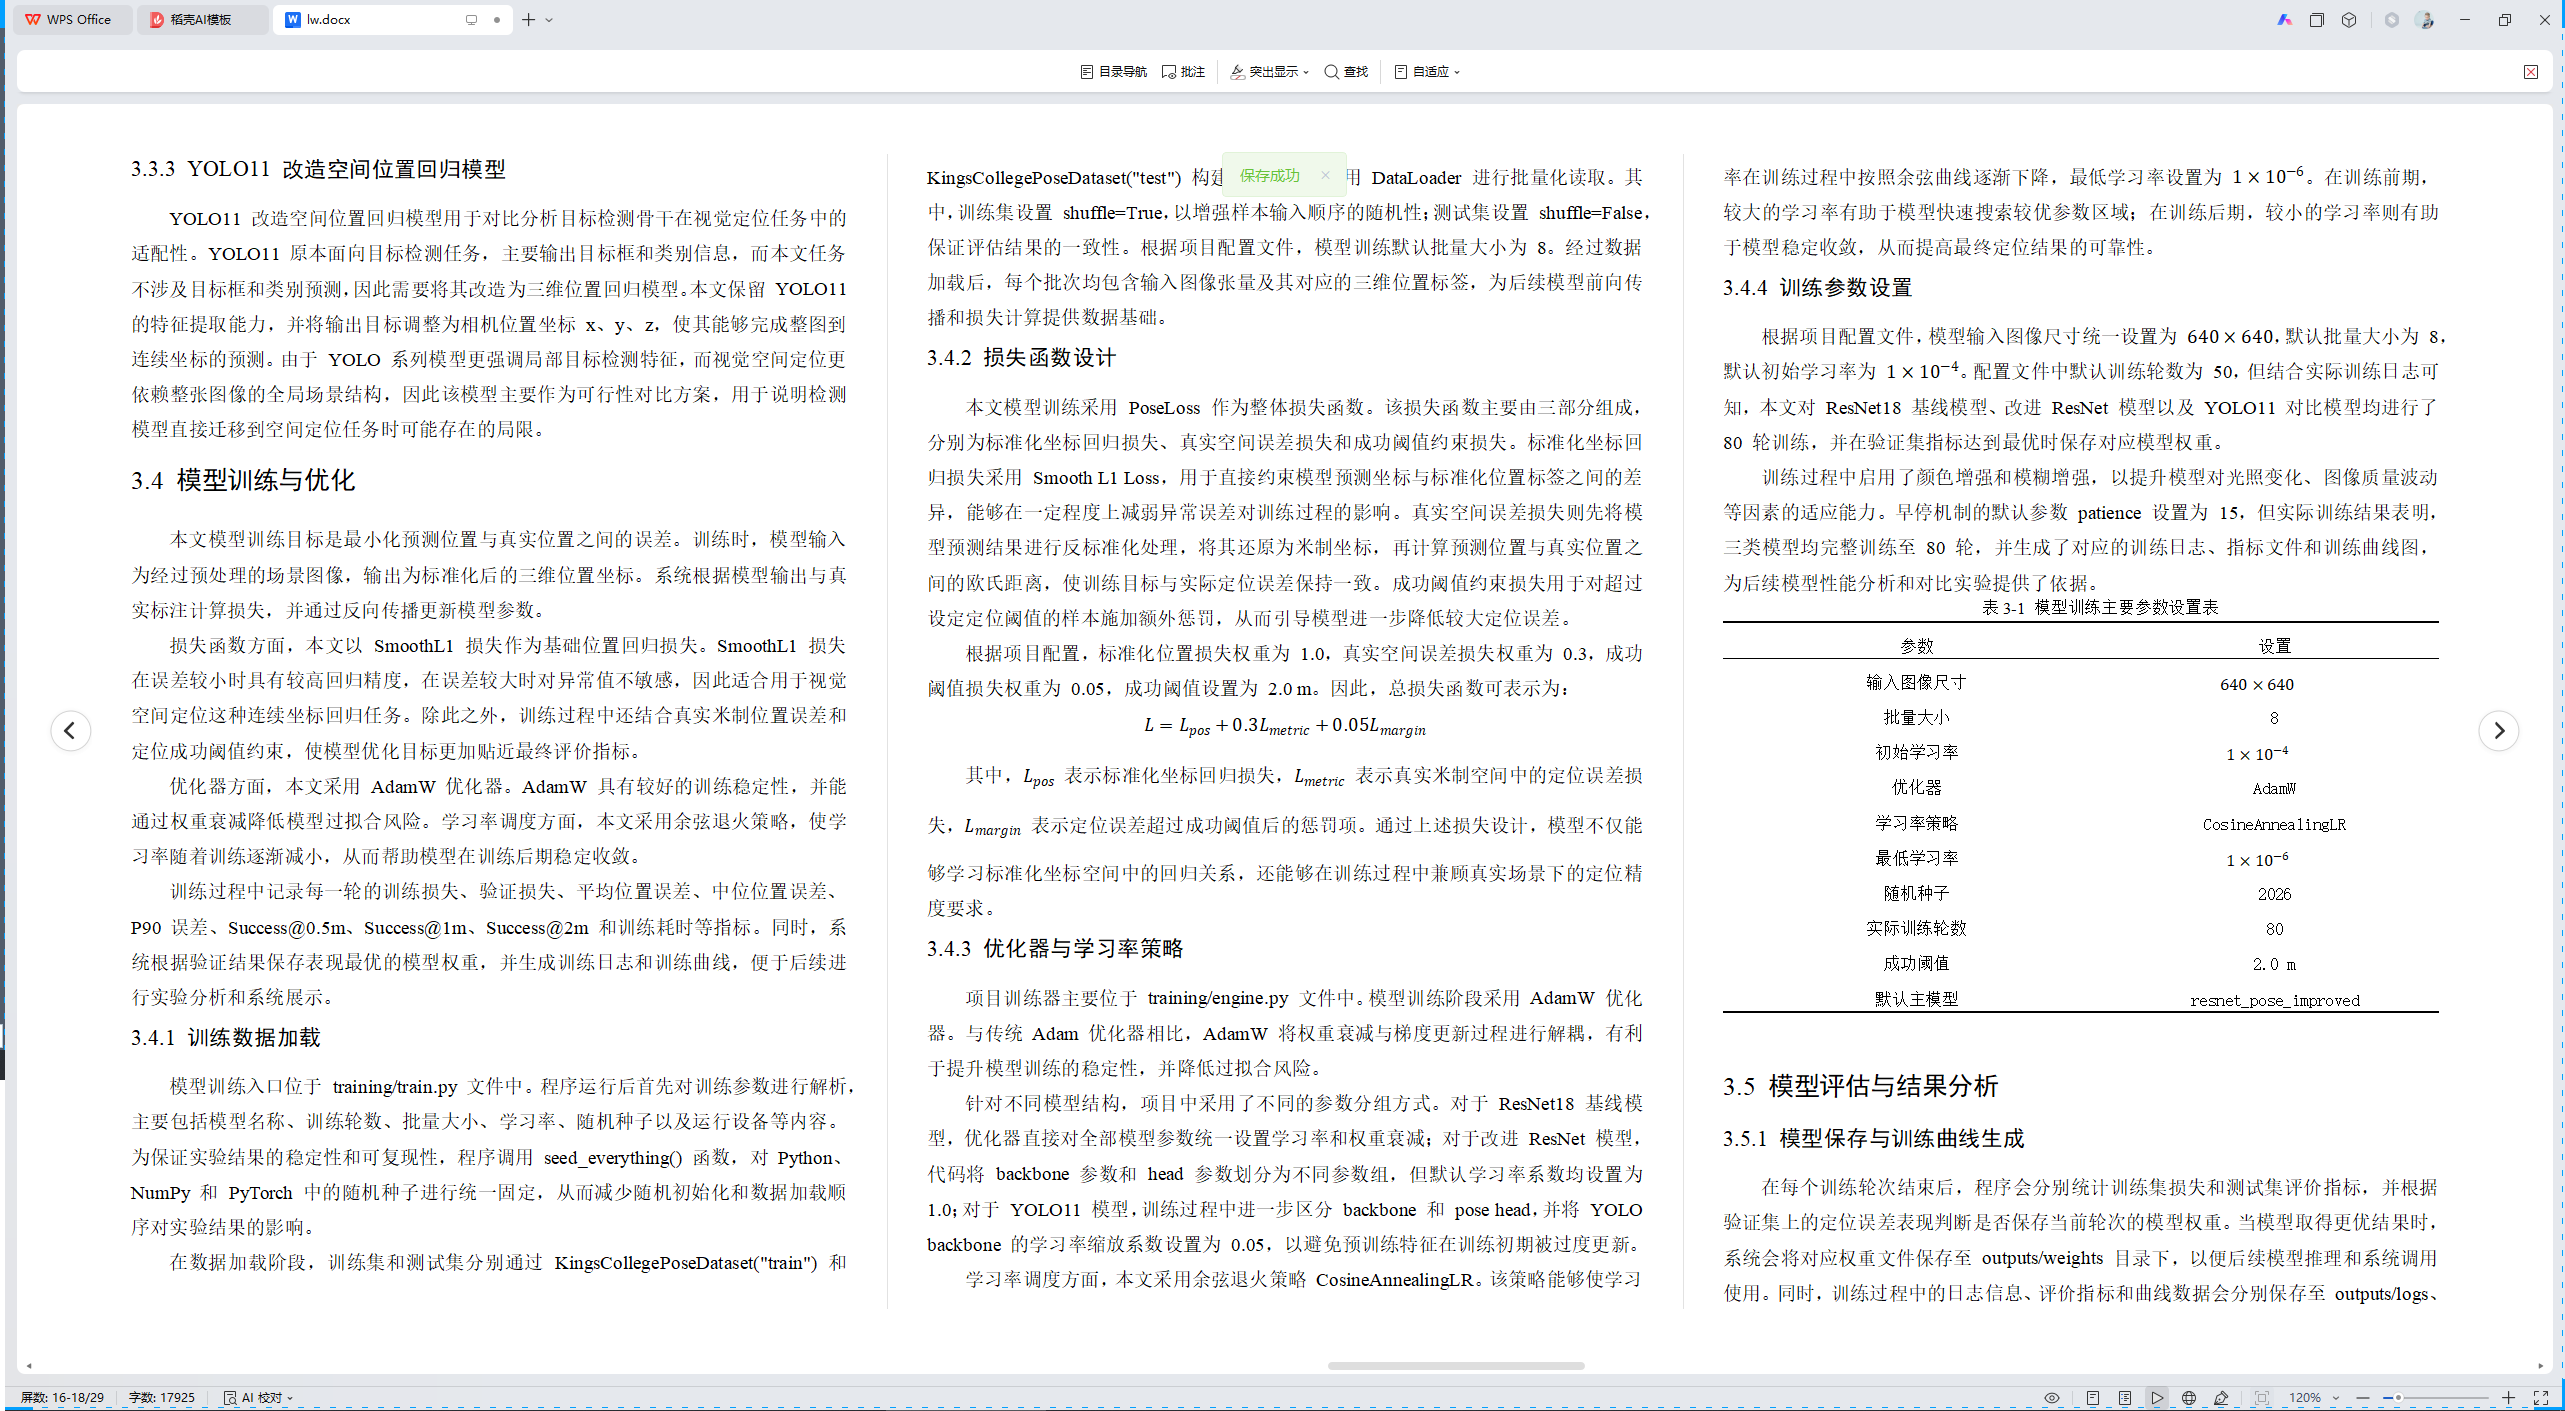
本文模型训练采用 PoseLoss 作为整体损失函数。该损失函数主要由三部分组成,分别为标准化坐标回归损失、真实空间误差损失和成功阈值约束损失。标准化坐标回归损失采用 Smooth L1 Loss,用于直接约束模型预测坐标与标准化位置标签之间的差异,能够在一定程度上减弱异常误差对训练过程的影响。真实空间误差损失则先将模型预测结果进行反标准化处理,将其还原为米制坐标,再计算预测位置与真实位置之间的欧氏距离,使训练目标与实际定位误差保持一致。成功阈值约束损失用于对超过设定定位阈值的样本施加额外惩罚,从而引导模型进一步降低较大定位误差。
根据项目配置,标准化位置损失权重为 1.0,真实空间误差损失权重为 0.3,成功阈值损失权重为 0.05,成功阈值设置为 2.0 m。因此,总损失函数可表示为:
其中,
表示标准化坐标回归损失,
表示真实米制空间中的定位误差损失,
项目训练器主要位于 training/engine.py 文件中。模型训练阶段采用 AdamW 优化器。与传统 Adam 优化器相比,AdamW 将权重衰减与梯度更新过程进行解耦,有利于提升模型训练的稳定性,并降低过拟合风险。
针对不同模型结构,项目中采用了不同的参数分组方式。对于 ResNet18 基线模型,优化器直接对全部模型参数统一设置学习率和权重衰减;对于改进 ResNet 模型,代码将 backbone 参数和 head 参数划分为不同参数组,但默认学习率系数均设置为 1.0;对于 YOLO11 模型,训练过程中进一步区分 backbone 和 pose head,并将 YOLO backbone 的学习率缩放系数设置为 0.05,以避免预训练特征在训练初期被过度更新。
学习率调度方面,本文采用余弦退火策略 CosineAnnealingLR。该策略能够使学习率在训练过程中按照余弦曲线逐渐下降,最低学习率设置为
。在训练前期,较大的学习率有助于模型快速搜索较优参数区域;在训练后期,较小的学习率则有助于模型稳定收敛,从而提高最终定位结果的可靠性。
根据项目配置文件,模型输入图像尺寸统一设置为
,默认批量大小为 8,默认初始学习率为
。配置文件中默认训练轮数为 50,但结合实际训练日志可知,本文对 ResNet18 基线模型、改进 ResNet 模型以及 YOLO11 对比模型均进行了 80 轮训练,并在验证集指标达到最优时保存对应模型权重。
训练过程中启用了颜色增强和模糊增强,以提升模型对光照变化、图像质量波动等因素的适应能力。早停机制的默认参数 patience 设置为 15,但实际训练结果表明,三类模型均完整训练至 80 轮,并生成了对应的训练日志、指标文件和训练曲线图,为后续模型性能分析和对比实验提供了依据。
表3-1 模型训练主要参数设置表
| 参数 | 设置 |
| 输入图像尺寸 |
|
| 批量大小 | 8 |
| 初始学习率 |
|
| 优化器 | AdamW |
| 学习率策略 | CosineAnnealingLR |
| 最低学习率 |
|
| 随机种子 | 2026 |
| 实际训练轮数 | 80 |
| 成功阈值 | 2.0 m |
| 默认主模型 | resnet_pose_improved |



在每个训练轮次结束后,程序会分别统计训练集损失和测试集评价指标,并根据验证集上的定位误差表现判断是否保存当前轮次的模型权重。当模型取得更优结果时,系统会将对应权重文件保存至 outputs/weights 目录下,以便后续模型推理和系统调用使用。同时,训练过程中的日志信息、评价指标和曲线数据会分别保存至 outputs/logs、outputs/metrics 和 outputs/charts 目录中。
训练完成后,程序调用 save_training_artifacts() 函数,对训练过程中的关键数据进行整理与可视化,主要生成训练损失变化曲线、定位误差变化曲线和不同阈值下的定位成功率变化曲线。这些训练结果文件不仅能够反映模型在训练过程中的收敛情况,也为后续实验分析、模型对比以及前端可视化展示提供了数据来源。
为全面评价模型在视觉空间定位任务中的性能,本文采用平均定位误差、中位定位误差、P25、P75、P90、最大误差以及不同阈值下的定位成功率作为主要评价指标。其中,定位误差由模型预测坐标与真实坐标之间的欧氏距离计算得到,其公式如下:
其中,
表示第
张图像的预测三维位置坐标,
表示该图像对应的真实三维位置坐标,
表示第
个样本的定位误差。平均定位误差用于反映模型整体定位精度,中位定位误差能够降低极端误差样本对评价结果的影响,P25、P75 和 P90 则用于描述误差分布情况。
此外,本文进一步统计不同误差阈值下的定位成功率,包括 Success@0.5m、Success@1m 和 Success@2m,分别表示定位误差小于 0.5 m、1.0 m 和 2.0 m 的样本比例。项目中的 accuracy、precision、recall 和 F1 指标均按照设定阈值下的成功定位比例进行统计,用于辅助展示模型在特定定位精度要求下的表现。
为了全面评价模型定位效果,本文采用平均位置误差、中位位置误差、P90 误差和不同阈值下的定位成功率作为主要评价指标。平均位置误差用于衡量模型整体预测偏差;中位位置误差能够减少极端异常值对评价结果的影响;P90 误差表示 90% 测试样本以内的误差上界;Success@0.5m、Success@1m 和 Success@2m 分别表示位置误差低于 0.5m、1m 和 2m 的样本比例。
三类模型的最佳实验结果如表4-3所示。
表3-2 三类模型最佳实验结果对比
| 模型 | 最佳轮次 | Val Loss | 平均误差/m | 中位误差/m | P90误差/m | Success@0.5m | Success@1m | Success@2m |
| ResNet18 基线模型 | 80 | 0.2691 | 1.333 | 0.829 | 2.654 | 25.9% | 59.8% | 86.3% |
| 改进 ResNet 模型 | 80 | 0.2327 | 1.208 | 0.792 | 2.644 | 25.9% | 61.8% | 85.7% |
| YOLO11 改造模型 | 74 | 0.7806 | 4.016 | 3.294 | 7.295 | 2.0% | 7.0% | 23.6% |
从表4-3可以看出,改进 ResNet 模型在综合误差指标上优于 ResNet18 基线模型。其平均误差从 1.333m 降低到 1.208m,中位误差从 0.829m 降低到 0.792m,P90 误差从 2.654m 降低到 2.644m,验证损失从 0.2691 降低到 0.2327。这说明门控残差修正结构能够在基线模型基础上进一步学习位置偏差,提高整体定位精度。
在定位成功率方面,改进 ResNet 的 Success@1m 为 61.8%,高于 ResNet18 的 59.8%,说明在较严格的 1m 阈值下,改进模型能够使更多样本落入高精度定位范围。Success@0.5m 两者均为 25.9%,说明在更高精度要求下仍有进一步优化空间。Success@2m 指标上,ResNet18 略高于改进 ResNet,但差距仅为 0.6 个百分点,综合误差指标仍然支持改进 ResNet 作为本文主模型。
YOLO11 改造模型的平均误差为 4.016m,中位误差为 3.294m,P90 误差达到 7.295m,Success@2m 仅为 23.6%,明显低于 ResNet 系列模型。这说明 YOLO11 虽然在目标检测任务中具有优势,但其结构更偏向局部目标检测特征,对本文这种整张图像到连续三维坐标的回归任务适配性较弱。因此,YOLO11 改造模型不适合作为本文最终主模型。
综合实验结果,本文选择改进 ResNet 模型作为最终主要定位模型。该模型在保持 ResNet18 全局图像特征表达能力的基础上,引入门控残差修正结构,使模型能够学习更细粒度的位置偏差。实验结果表明,该结构能够降低平均定位误差,并在 1m 精度阈值下取得更好的定位成功率。
本章围绕端到端视觉空间定位模型构建与实验分析展开。首先对 Cambridge Landmarks 数据集中的 Kings College 场景进行了详细介绍,包括数据来源、图像内容、标注格式、样本规模和序列分布;其次说明了图像预处理、坐标标准化和数据增强方法;然后分别介绍了 ResNet18 基线模型、改进 ResNet 模型和 YOLO11 改造模型的结构设计;最后从平均误差、中位误差、P90 误差和定位成功率等方面对三类模型进行了对比分析。
实验结果表明,改进 ResNet 模型在综合误差指标上优于 ResNet18 基线模型,说明门控残差修正结构能够提升连续空间坐标回归效果;YOLO11 改造模型在本任务中表现较弱,说明目标检测模型并不适合直接作为整图视觉空间定位任务的最终主模型。下一章将在模型实验结果基础上,进一步介绍系统实现过程和功能测试内容。
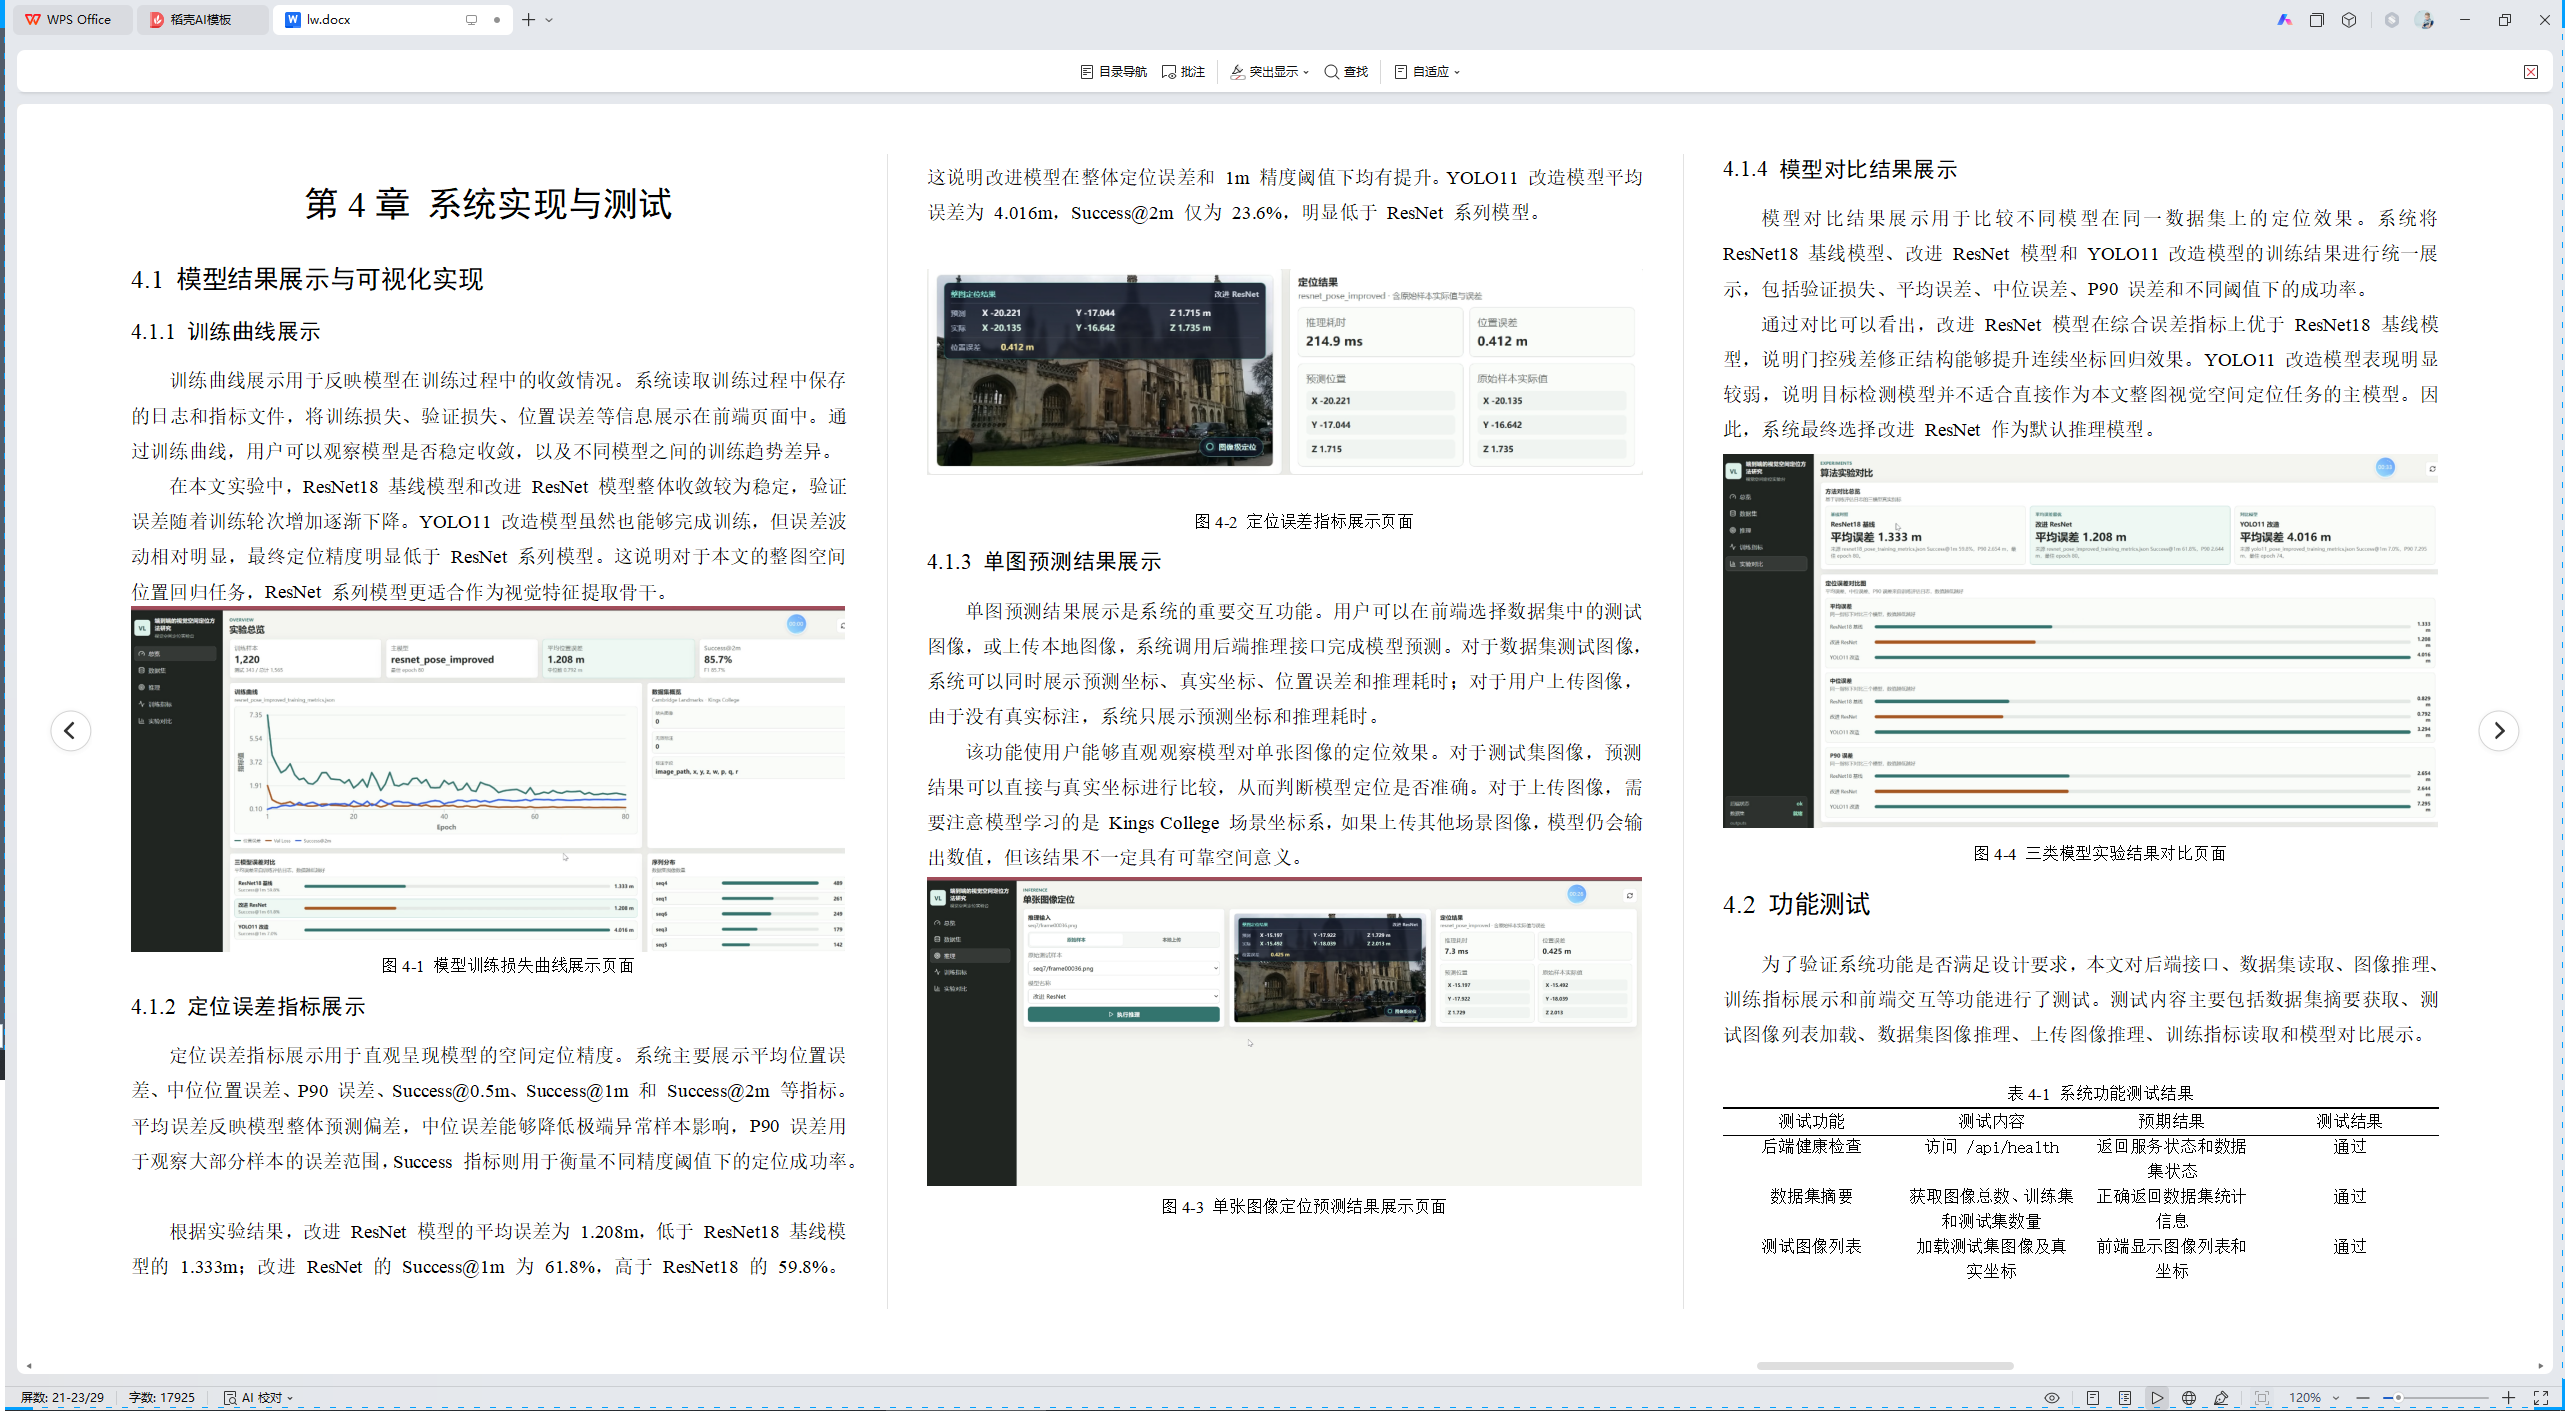
训练曲线展示用于反映模型在训练过程中的收敛情况。系统读取训练过程中保存的日志和指标文件,将训练损失、验证损失、位置误差等信息展示在前端页面中。通过训练曲线,用户可以观察模型是否稳定收敛,以及不同模型之间的训练趋势差异。
在本文实验中,ResNet18 基线模型和改进 ResNet 模型整体收敛较为稳定,验证误差随着训练轮次增加逐渐下降。YOLO11 改造模型虽然也能够完成训练,但误差波动相对明显,最终定位精度明显低于 ResNet 系列模型。这说明对于本文的整图空间位置回归任务,ResNet 系列模型更适合作为视觉特征提取骨干。
图4-1 模型训练损失曲线展示页面
定位误差指标展示用于直观呈现模型的空间定位精度。系统主要展示平均位置误差、中位位置误差、P90 误差、Success@0.5m、Success@1m 和 Success@2m 等指标。平均误差反映模型整体预测偏差,中位误差能够降低极端异常样本影响,P90 误差用于观察大部分样本的误差范围,Success 指标则用于衡量不同精度阈值下的定位成功率。
根据实验结果,改进 ResNet 模型的平均误差为 1.208m,低于 ResNet18 基线模型的 1.333m;改进 ResNet 的 Success@1m 为 61.8%,高于 ResNet18 的 59.8%。这说明改进模型在整体定位误差和 1m 精度阈值下均有提升。YOLO11 改造模型平均误差为 4.016m,Success@2m 仅为 23.6%,明显低于 ResNet 系列模型。
图4-2 定位误差指标展示页面
单图预测结果展示是系统的重要交互功能。用户可以在前端选择数据集中的测试图像,或上传本地图像,系统调用后端推理接口完成模型预测。对于数据集测试图像,系统可以同时展示预测坐标、真实坐标、位置误差和推理耗时;对于用户上传图像,由于没有真实标注,系统只展示预测坐标和推理耗时。
该功能使用户能够直观观察模型对单张图像的定位效果。对于测试集图像,预测结果可以直接与真实坐标进行比较,从而判断模型定位是否准确。对于上传图像,需要注意模型学习的是 Kings College 场景坐标系,如果上传其他场景图像,模型仍会输出数值,但该结果不一定具有可靠空间意义。
图4-3 单张图像定位预测结果展示页面
模型对比结果展示用于比较不同模型在同一数据集上的定位效果。系统将 ResNet18 基线模型、改进 ResNet 模型和 YOLO11 改造模型的训练结果进行统一展示,包括验证损失、平均误差、中位误差、P90 误差和不同阈值下的成功率。
通过对比可以看出,改进 ResNet 模型在综合误差指标上优于 ResNet18 基线模型,说明门控残差修正结构能够提升连续坐标回归效果。YOLO11 改造模型表现明显较弱,说明目标检测模型并不适合直接作为本文整图视觉空间定位任务的主模型。因此,系统最终选择改进 ResNet 作为默认推理模型。
图4-4 三类模型实验结果对比页面
为了验证系统功能是否满足设计要求,本文对后端接口、数据集读取、图像推理、训练指标展示和前端交互等功能进行了测试。测试内容主要包括数据集摘要获取、测试图像列表加载、数据集图像推理、上传图像推理、训练指标读取和模型对比展示。
表4-1 系统功能测试结果
| 测试功能 | 测试内容 | 预期结果 | 测试结果 |
| 后端健康检查 | 访问 /api/health | 返回服务状态和数据集状态 | 通过 |
| 数据集摘要 | 获取图像总数、训练集和测试集数量 | 正确返回数据集统计信息 | 通过 |
| 测试图像列表 | 加载测试集图像及真实坐标 | 前端显示图像列表和坐标 | 通过 |
| 数据集图像推理 | 选择测试图像进行推理 | 返回预测坐标、真实坐标和误差 | 通过 |
| 上传图像推理 | 上传本地图像并选择模型 | 返回预测坐标和推理耗时 | 通过 |
| 训练指标展示 | 读取模型训练指标 | 正确展示损失和误差数据 | 通过 |
| 模型对比展示 | 查看三类模型实验结果 | 正确展示模型对比指标 | 通过 |
从测试结果可以看出,系统各主要功能均能够正常运行。后端接口可以正确返回数据,前端页面能够完成数据加载、图像展示、模型推理和指标可视化,系统整体满足毕业设计演示和实验分析需求。
性能测试主要从模型定位精度和系统运行效率两个方面进行分析。模型定位精度已经在第四章中进行了详细实验,本节主要结合系统展示结果进行说明。系统运行效率主要关注图像推理过程能否在较短时间内返回预测结果,以及前端页面能否正常展示训练指标和推理结果。
从模型精度看,改进 ResNet 模型平均误差为 1.208m,Success@1m 为 61.8%,在综合误差指标上优于 ResNet18 基线模型。ResNet18 基线模型平均误差为 1.333m,Success@1m 为 59.8%,能够作为较稳定的基础模型。YOLO11 改造模型平均误差为 4.016m,定位成功率较低,不适合作为最终主模型。
表4-2 模型性能测试结果
| 模型 | 平均误差/m | 中位误差/m | P90误差/m | Success@1m | Success@2m |
| ResNet18 基线模型 | 1.333 | 0.829 | 2.654 | 59.80% | 86.30% |
| 改进 ResNet 模型 | 1.208 | 0.792 | 2.644 | 61.80% | 85.70% |
| YOLO11 改造模型 | 4.016 | 3.294 | 7.295 | 7.00% | 23.60% |
从系统运行角度看,后端采用已训练模型权重进行推理,前端通过接口请求获取结果,整体交互流程较为清晰。对于单张图像推理任务,系统能够完成图像读取、预处理、模型前向传播、坐标反标准化和结果返回。由于本文系统主要面向毕业设计演示和实验验证,当前性能能够满足单图推理和指标展示需求。
综合功能测试和性能测试结果可以看出,本文实现的视觉空间定位实验系统能够完成预期功能。数据集管理功能可以正确读取 Kings College 数据集信息,模型推理功能可以根据输入图像输出三维位置坐标,训练指标可视化功能可以展示不同模型的训练结果和定位误差,前端页面能够完成较完整的实验演示流程。
从模型表现看,改进 ResNet 模型整体效果最好。与 ResNet18 基线模型相比,改进 ResNet 在平均误差、中位误差、P90 误差、验证损失和 Success@1m 等指标上均有提升,说明门控残差修正结构能够改善空间位置回归效果。虽然 ResNet18 在 Success@2m 指标上略高,但差距较小,综合误差指标仍然支持改进 ResNet 作为系统默认模型。
YOLO11 改造模型在本文任务中的效果较差,主要原因是 YOLO11 原本面向目标检测任务,更关注局部目标框和类别特征,而本文任务需要根据整张图像的全局场景结构回归连续空间坐标。实验结果说明,模型结构需要与任务特性相匹配,不能简单将目标检测模型直接作为视觉空间定位主模型。
从系统实现角度看,前后端分离结构使系统具有较好的可维护性。后端专注于模型推理和数据管理,前端专注于交互展示和可视化。当后续需要扩展新的模型、增加新的评价指标或新增页面功能时,可以在对应模块中进行修改,不会对整体结构造成较大影响。
本章主要介绍了视觉空间定位实验系统的实现与测试。首先说明了系统后端接口和前端页面的实现方式,然后分别介绍了训练曲线展示、定位误差指标展示、单图预测结果展示和模型对比结果展示等功能。随后对系统进行了功能测试和性能测试,验证了系统能够正常完成数据集展示、模型推理、指标读取和实验对比等任务。
测试结果表明,本文系统能够满足端到端视觉空间定位实验展示需求。改进 ResNet 模型在综合误差指标上优于 ResNet18 基线模型,并明显优于 YOLO11 改造模型,因此适合作为系统默认定位模型。下一章将对全文研究内容进行总结,并对后续改进方向进行展望。
本文围绕端到端视觉空间定位方法展开研究,设计并实现了一个基于单张场景图像预测相机三维空间位置的实验系统。系统以 Cambridge Landmarks 数据集中的 Kings College 场景作为实验对象,输入为建筑场景图像,输出为相机在场景坐标系下的三维位置坐标 x、y、z。本文当前阶段不进行姿态四元数预测,而是聚焦于视觉图像到空间位置坐标的连续回归任务。
在数据处理方面,本文对 Kings College 数据集进行了整理与分析。该数据集共包含 1565 张图像,其中训练样本 1220 张,测试样本 343 张。每条标注包含图像路径、三维位置坐标和姿态四元数。本文保留姿态字段作为原始信息,但模型训练和评价主要使用 x、y、z 三维位置坐标。为了提高训练稳定性,本文对图像进行了统一预处理,并对位置坐标进行了标准化处理。
在模型构建方面,本文搭建了 ResNet18 空间位置回归基线模型、改进 ResNet 空间位置回归模型和 YOLO11 改造空间位置回归模型。ResNet18 基线模型用于验证卷积神经网络进行空间坐标回归的可行性;改进 ResNet 模型在基线结构基础上引入门控残差修正头,用于学习主预测之外的细粒度位置偏差;YOLO11 改造模型作为对比方案,用于分析目标检测模型在整图视觉空间定位任务中的适配性。
在模型训练与实验分析方面,本文采用位置回归损失、米制位置误差约束和不同阈值下的定位成功率作为评价依据。实验结果表明,改进 ResNet 模型在综合误差指标上优于 ResNet18 基线模型。改进 ResNet 的平均误差为 1.208m,低于 ResNet18 的 1.333m;Success@1m 为 61.8%,高于 ResNet18 的 59.8%。YOLO11 改造模型平均误差为 4.016m,Success@2m 仅为 23.6%,说明其并不适合作为本文任务的最终主模型。
在系统实现方面,本文采用前后端分离架构完成了视觉空间定位实验系统。后端基于 Python、FastAPI 和 PyTorch 实现,提供数据集摘要、测试图像列表、图像推理、训练指标读取和实验结果读取等接口;前端基于 Vue 3 和 Vite 实现,提供总览、数据集、推理、训练指标和实验对比等页面。通过该系统,用户可以直观查看数据集信息、模型训练指标、单张图像预测结果和不同模型的对比效果。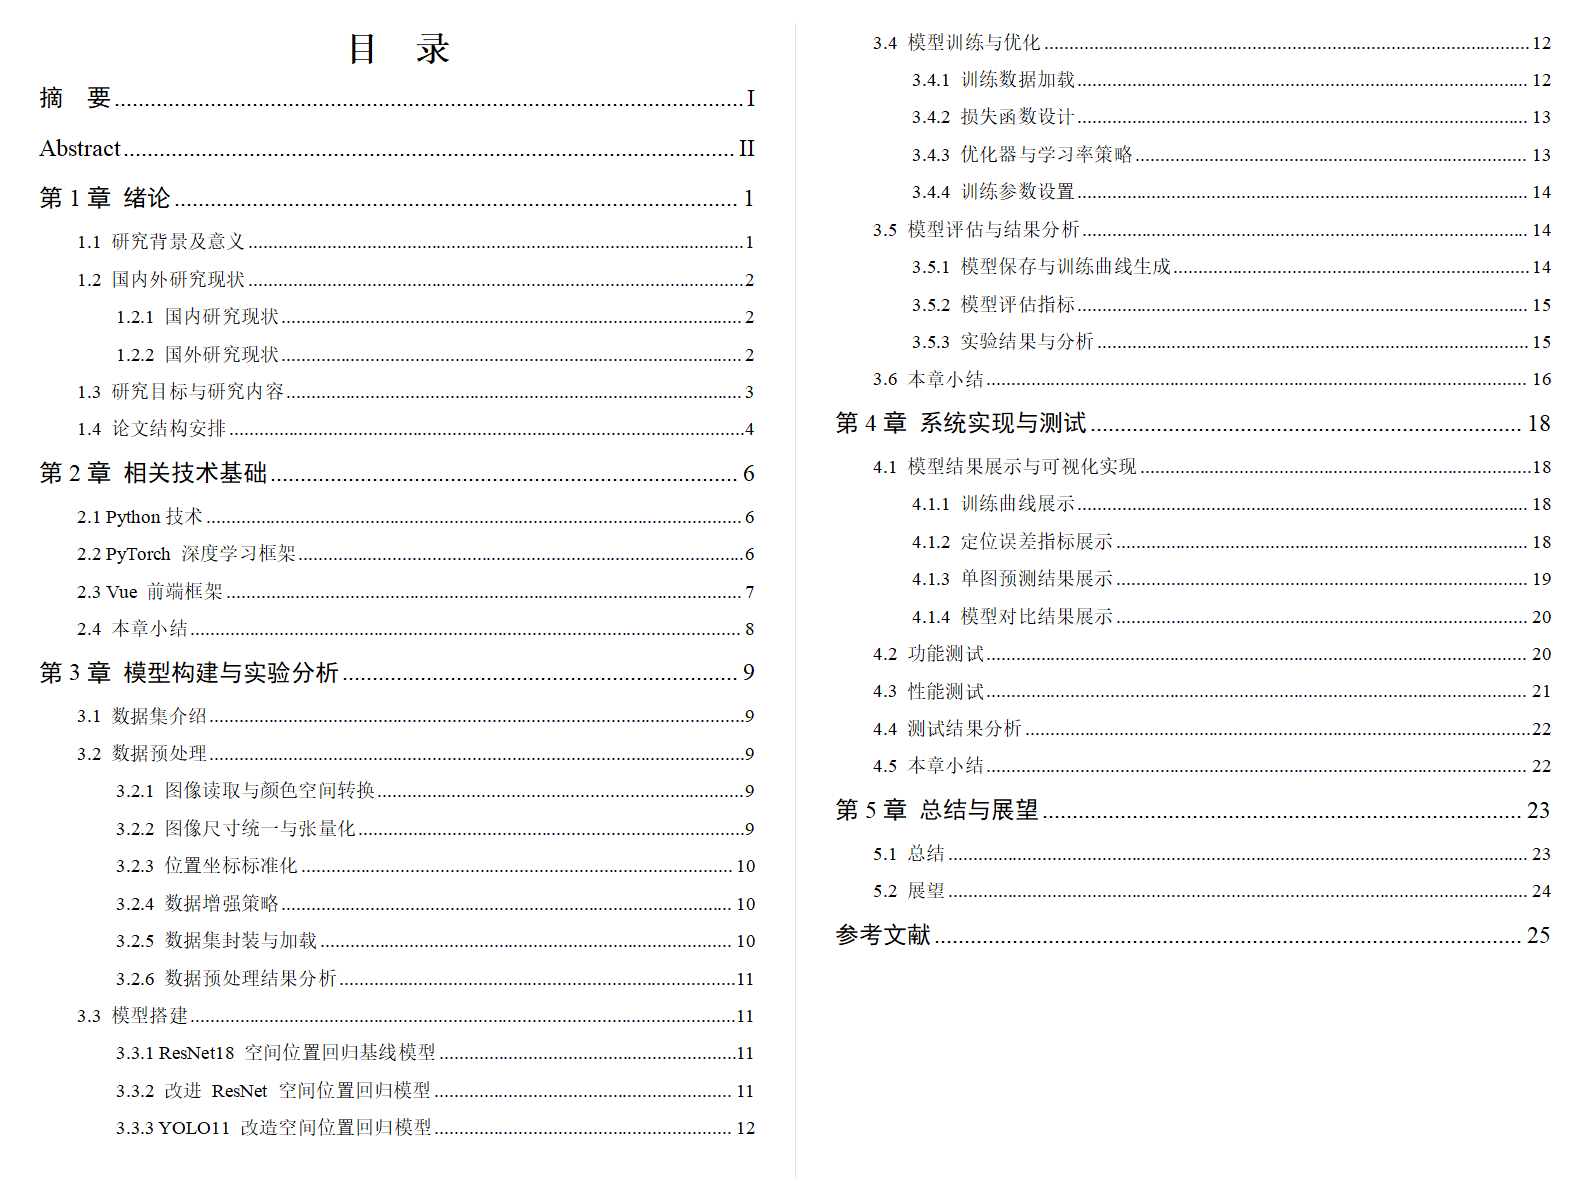

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献11条内容

所有评论(0)