调研 AI 机器人数据诚信闸门:失败含义与当天最小实验
千笔-AIWritePaper · https://www.aiwritepaper.com
在线问卷最危险的状态不是「发现了机器人」,而是「我们加了注意力检查,所以应该没问题」。本文素材是 CARMAresearch 频道发布的 CARMA 2026 AI 夏季研讨会录像 AI Bots in Research: Prevalence and Data Integrity(视频 id AqlMlLqWLeU,2026-08-25 发布,时长 1:49:28),三位讲者:Virginia Tech 的 Thomas(TJ)Shaw、Auburn University 的 Gargi Sawhney、University of Utah 的 Amber Thompson。本文依据视频的英文自动字幕逐段核对,方括号内为时间戳,引述为意译;自动字幕对人名、工具名的识别可能有误差。
三场报告指向同一个结论:**单一检查挡不住,必须分层;分层之后也只能减少,不能清零。**本文把它落成五道闸门、每道闸的失败含义,以及一个今天下午就能做完的最小实验。
视频:https://www.youtube.com/watch?v=AqlMlLqWLeU
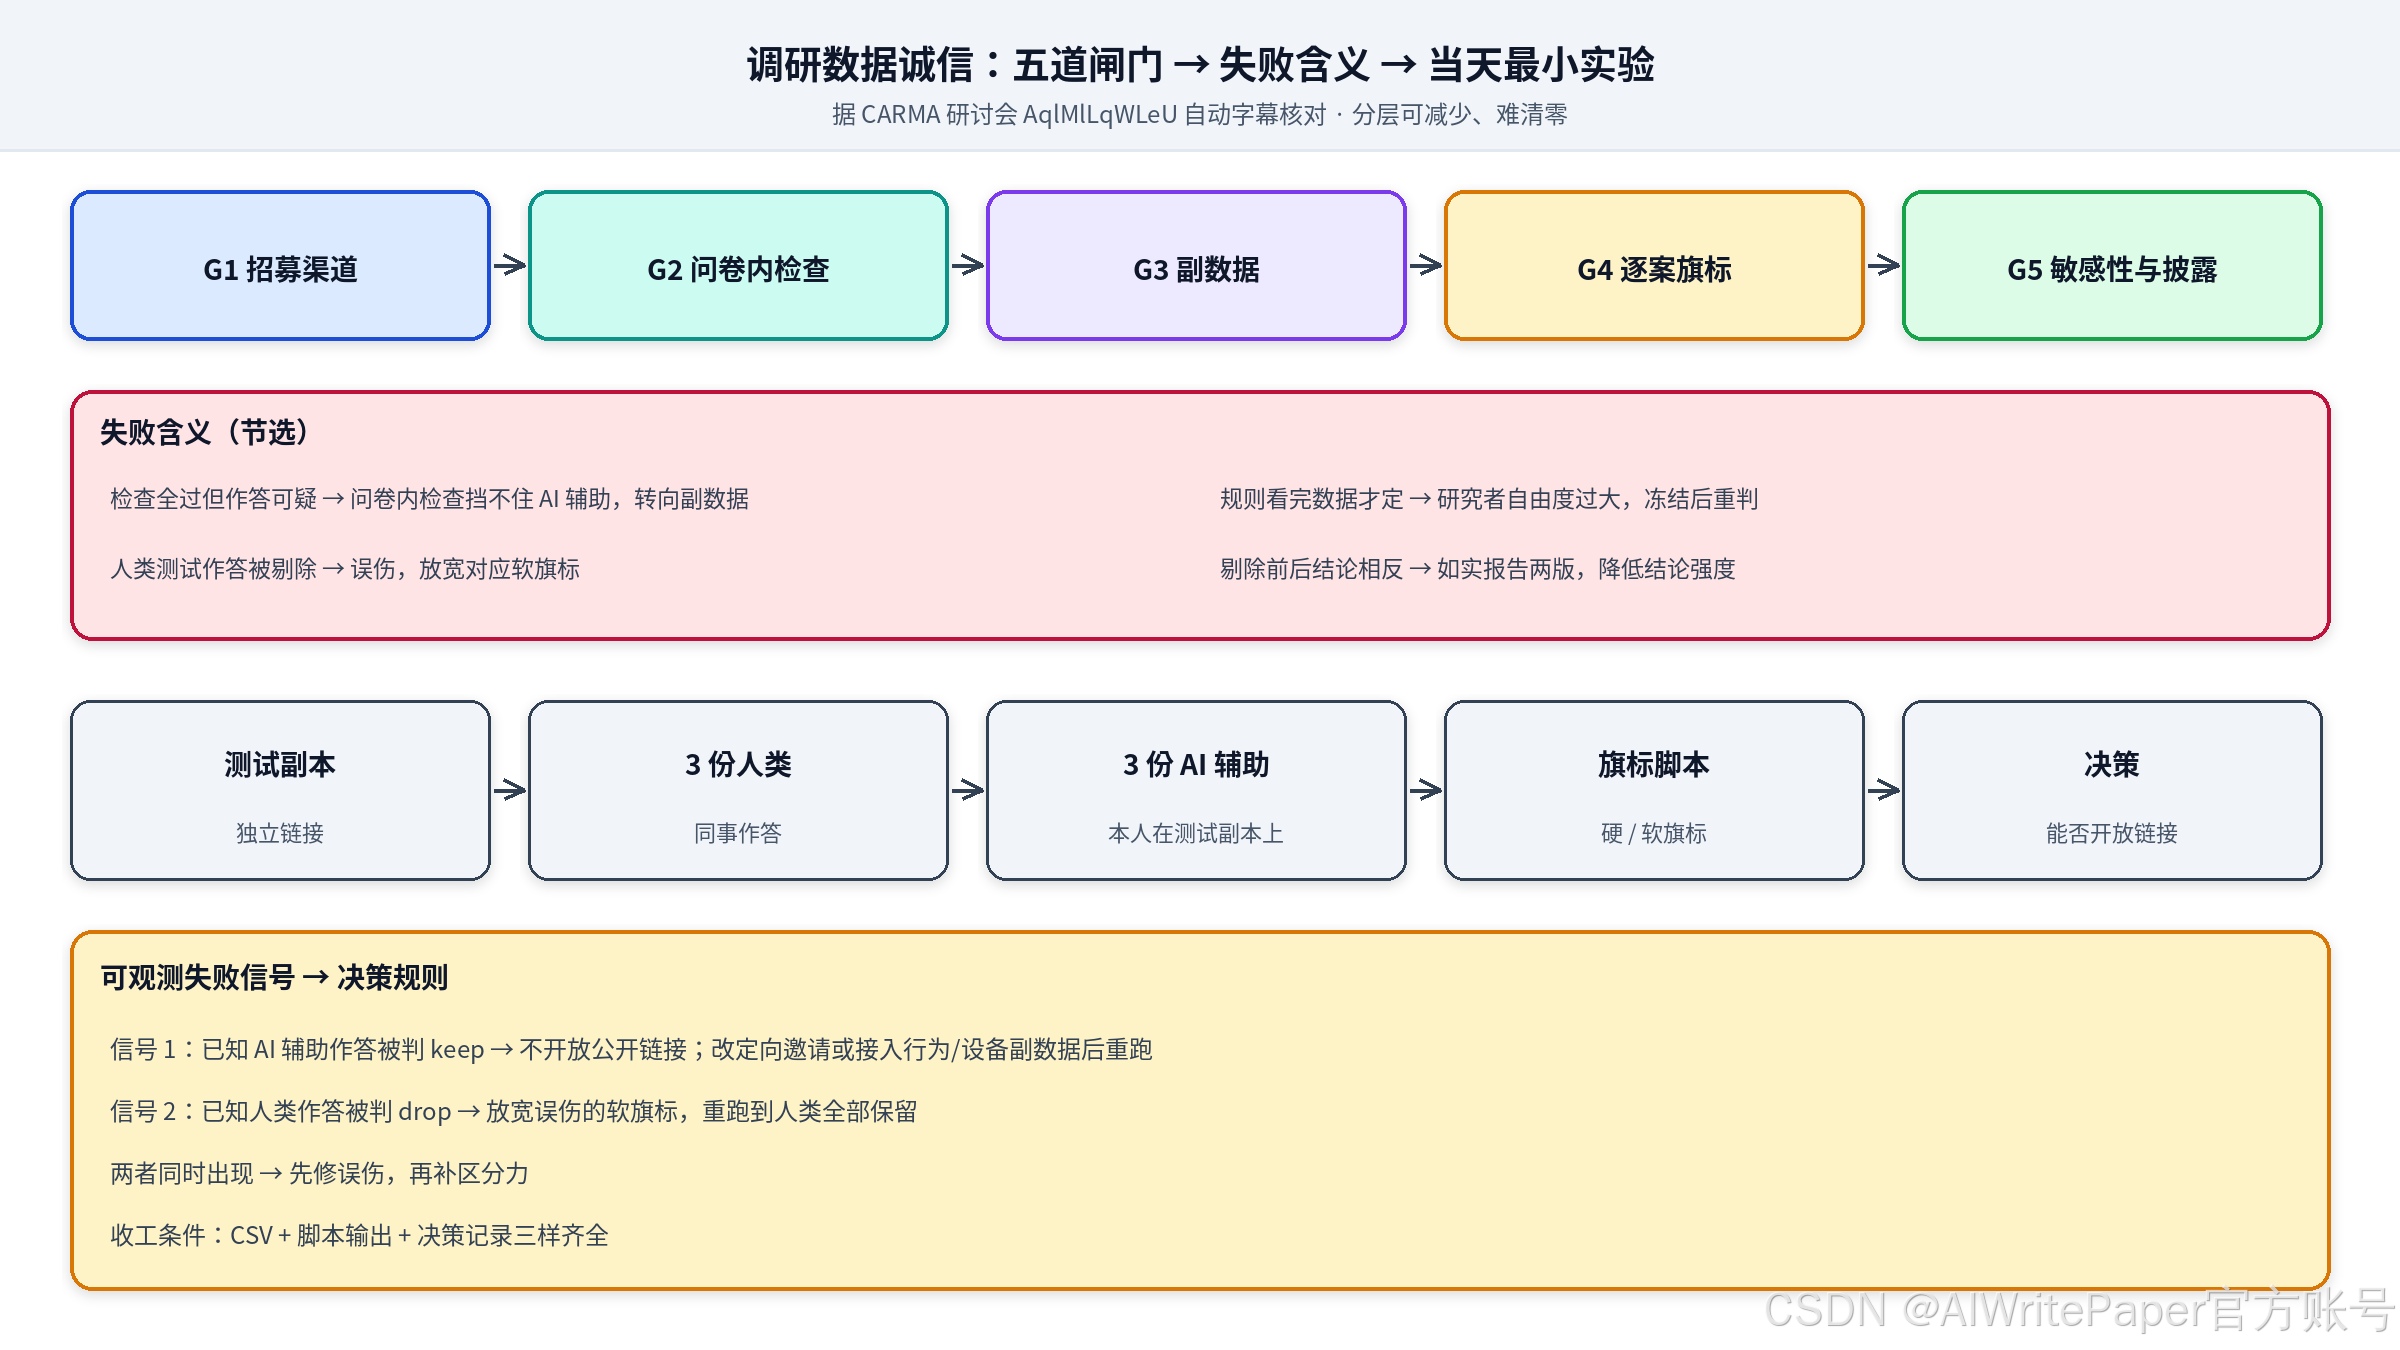
图:上方五道闸门;中部每道闸的失败含义;下方最小实验流程与决策规则。
录像里可核实的要点
| 讲者 | 要点(意译) | 时间戳 |
|---|---|---|
| TJ Shaw | 其团队 2025 年发表于 Psychological Methods 的研究:47 个招募周、超过 2.4 万份提交,最终保留 59 名参与者;提出高/中/低置信度的筛查分级(高置信检查失败一次即剔除,中、低置信需累计失败) | [11:00–12:33] |
| TJ Shaw | 他们原先依赖的开放题、完成时长、前后人口学信息一致性等检查,面对大模型驱动的机器人可能已不再有效 | [15:01–16:34] |
| TJ Shaw | 公开的研究摘要、预注册信息和已发表的检测方法,可能反过来帮助攻击者;他本人已不再做在线招募 | [18:08–21:13] [24:25–25:12] |
| Gargi Sawhney | 基准研究:1 个简单机器人加 4 个 AI 智能体,约 227 份机器人作答,对照 336 名大学生;问卷内嵌 10 项检查 | [38:31–40:06] |
| Gargi Sawhney | AI 智能体通过了大部分传统检查(如字谜题、指令题、蜜罐题);Stroop 题是主要例外,多数智能体全部失败 | [43:12–45:30] |
| Gargi Sawhney | 行为副数据差异明显:65% 的人类切换过标签页,多数智能体从未切换;所有机器人与智能体都呈现机器式鼠标轨迹,人类无一如此;设备指纹能区分,但约 5% 的人类被标为可疑(可能与学校虚拟服务器有关) | [45:30–47:53] [50:22–51:56] |
| Gargi Sawhney | 建议嵌入少量检查即可,不要用大量测试轰炸参与者;更看重作答过程而非只看答案 | [1:23:34–1:24:24] |
| Amber Thompson | 临终陪伴者(end-of-life doula)调研:首日 24 小时收到 65 份;用硬旗标(如重复 IP、重复开放题答案)与软旗标分层,逐案写审计记录;讲述中称最终剔除 94% | [58:14–1:09:07] |
| Amber Thompson | 改为向公开可联系的专业人士定向邮件邀请后,样本 270、分析样本 203,没有案例因机器人或不真诚作答被剔除 | [1:09:07–1:09:52] |
一处需要标注的差异:视频简介写的是「85% 的合格作答被识别为不真诚或机器人并剔除」,而录像中讲者口述为 94%。两者分母可能不同(简介写「合格作答」),本文不作推断,引用时请注明来源。
目标说明
读完应能独立完成五件事:
- 说清为什么「问卷内有注意力检查」不等于数据可信。
- 为自己的在线调研配置五道闸门,并写出每道闸失败意味着什么。
- 当天完成最小实验:用测试链接造出已知人类与已知 AI 辅助的作答,跑一遍旗标脚本。
- 根据可观测的失败信号作出决策:能否开放公开链接。
- 在论文方法部分如实写明筛查流程与剔除情况。
五道闸门
| 闸 | 问题 | 通过标准 | 产物 |
|---|---|---|---|
| G1 招募渠道 | 链接会被谁看到 | 能定向邀请就不用公开链接;公开渠道需书面说明理由 | recruitment-note |
| G2 问卷内检查 | 放了哪几项、每项预期挡住谁 | 少量且有依据(含 Stroop 类题),不堆砌 | check-list |
| G3 副数据 | 是否记录时长、IP、开始时间等 | 导出字段齐全,逐案可查 | export.csv |
| G4 逐案旗标 | 硬旗标与软旗标怎样组合 | 规则事先写定;每案留理由 | case-audit.csv |
| G5 敏感性与披露 | 剔除前后结论是否变化,方法部分如何写 | 两版结果并列,剔除数量与理由写进正文 | sensitivity-note |
门禁:G4 规则必须在看结果之前写定;G5 没有「剔除前后对照」不得定稿。
失败含义 → 下一步
| 失败 | 含义 | 下一步 |
|---|---|---|
| G1 只能用公开链接 | 暴露面最大 | 加强 G3/G4,或与社群合作定向发放 |
| G2 检查全部通过但作答可疑 | 问卷内检查挡不住 AI 辅助作答 | 不再加检查题,转向副数据 |
| G3 导出缺字段 | 事后无法逐案核查 | 修改平台设置后重新收集 |
| G4 规则是看完数据再定的 | 研究者自由度过大 | 冻结规则,重新逐案判定 |
| G5 剔除前后结论相反 | 结论依赖可疑数据 | 如实报告两版结果,降低结论强度 |
| 人类测试作答被判剔除 | 误伤 | 放宽对应软旗标,重跑实验 |
当天最小实验
材料
- 你的正式问卷的一份测试副本(独立链接,数据不进入正式样本)。
- 3 名同事作为已知人类测试者。
- 你本人借助聊天机器人为开放题生成答案,完成 3 份「已知 AI 辅助」作答。只在自己的测试副本上做,不在他人问卷上测试。
- 下面的旗标脚本(Python 标准库即可运行)。
步骤
- 在测试副本里放入 4 项检查:指令题(「请选非常不同意」)、年龄前后两问、一道 Stroop 类题、一个隐藏的蜜罐字段;加 3 道李克特题,其中 1 道为反向题。
- 同事按正常方式作答;你完成 3 份 AI 辅助作答。
- 导出 CSV,字段包括开始时间、时长、IP、各检查项与开放题。
- 运行脚本,得到逐案旗标与判定。
- 把结果写入
case-audit.csv与gate-log.csv。
旗标脚本
# flag_cases.py —— 逐案硬/软旗标 + 闸门判定(输入:测试链接导出的 CSV)
import csv, statistics, sys
from collections import Counter

rows = list(csv.DictReader(open(sys.argv[1], encoding="utf-8")))
med = statistics.median(float(r["duration_s"]) for r in rows if r["source"].startswith("human"))
norm = lambda s: "".join(s.split())
text_cnt = Counter(norm(r["open_text"]) for r in rows)
ip_cnt = Counter(r["ip"] for r in rows)

def flags(r):
    hard, soft = [], []
    if r["honeypot"].strip():                      hard.append("honeypot_filled")
    if text_cnt[norm(r["open_text"])] > 1:         hard.append("dup_open_text")
    if ip_cnt[r["ip"]] > 1:                        soft.append("dup_ip")
    if float(r["duration_s"]) < med / 2:           soft.append("fast<median/2")
    if r["age_q1"] != r["age_q2"]:                 soft.append("age_mismatch")
    if r["instructed"] != "strongly_disagree":     soft.append("instructed_fail")
    if r["stroop_pass"] != "1":                    soft.append("stroop_fail")
    lk = [int(r[k]) for k in ("lk1", "lk2", "lk3", "lk4_rev")]
    if min(lk) >= 4:                               soft.append("positivity(含反向题)")
    if len(norm(r["open_text"])) < 12:             soft.append("text_too_short")
    return hard, soft

print("resp_id,source,hard,soft,decision")
miss = []
for r in rows:
    h, s = flags(r)
    decision = "drop" if h else ("review" if len(s) >= 2 else "keep")
    print(f'{r["resp_id"]},{r["source"]},{"|".join(h) or "-"},{"|".join(s) or "-"},{decision}')
    if r["source"] == "ai_assisted_test" and decision == "keep":
        miss.append(r["resp_id"])
    if r["source"] == "human_test" and decision == "drop":
        miss.append(r["resp_id"] + "(误杀)")
print("GATE:", "FAIL -> 不得开放公开链接;补副数据层或改定向邀请后重跑" if miss else "PASS", miss)
用 6 行演示数据(_w/bot-gate/test_export.example.csv,人为构造,仅用于演示脚本,不是研究数据)实跑的输出:
resp_id,source,hard,soft,decision
H1,human_test,-,-,keep
H2,human_test,-,-,keep
H3,human_test,-,stroop_fail,keep
A1,ai_assisted_test,dup_open_text,dup_ip|fast<median/2|positivity(含反向题),drop
A2,ai_assisted_test,dup_open_text,dup_ip|fast<median/2|positivity(含反向题),drop
A3,ai_assisted_test,-,positivity(含反向题),keep
GATE: FAIL -> 不得开放公开链接;补副数据层或改定向邀请后重跑 ['A3']
可观测的失败信号
- 信号 1:任何一份「已知 AI 辅助」作答最终判定为 keep(演示中的 A3:通过了全部问卷内检查,只留下一个软旗标)。
- 信号 2:任何一份人类测试作答被判 drop(误伤)。
- 信号 3:所有 AI 辅助作答都通过了指令题和年龄一致性检查。这与录像中 AI 智能体轻松通过传统检查的发现方向一致。
失败含义
信号 1 出现,说明你的 G2 + G4 组合对「认真使用 AI 辅助的作答」没有区分力,A1、A2 被抓到只是因为它们复制了同一段文字。换句话说,你抓到的是粗糙的,漏掉的是细致的。信号 2 出现,说明某条软旗标对真实参与者太严,会让样本系统性地流失某类人(例如答题快的人、使用浏览器扩展的学生)。
决策规则
| 实验结果 | 决策 |
|---|---|
| 无信号 1、无信号 2 | 可以开放链接;G4 规则冻结写入方法部分 |
| 出现信号 1 | 不开放公开链接:改为定向邀请,或接入行为/设备副数据后重跑本实验 |
| 出现信号 2 | 放宽或删除误伤的软旗标,重跑,直到人类测试作答全部保留 |
| 两者同时出现 | 先修信号 2,再处理信号 1,避免为了抓机器人而误伤真人 |
收工条件:CSV、脚本输出、决策记录三样齐全,且决策记录写明对应哪一条规则。
方法部分怎么写(可抄的骨架)
G5 要求把筛查写进正文。下面是一段可直接改写的骨架,方括号处替换成你的实际情况:
数据质量控制:招募渠道为[定向邮件邀请/社群合作发放/公开链接,理由:…]。
问卷内设置[n]项检查:[指令题、年龄前后一致性、Stroop 类题、隐藏字段]。
平台导出[开始时间、完成时长、IP]等副数据。剔除规则于数据分析前确定:
出现任一硬旗标(隐藏字段被填写、开放题答案与他人完全重复)即剔除;
软旗标累计达到 2 项进入人工复核,复核记录见补充材料。
共收到[N]份作答,剔除[k]份(硬旗标[a]份,复核后剔除[b]份)。
剔除前后主要结果的对照见补充材料表[S1];两版结论[一致/存在差异,差异为…]。
写的时候注意三点:规则确定的时间点要写清(分析前);剔除数量要拆开写,不要只给一个总数;剔除前后结论不一致时,如实写出差异,不要只报剔除后的版本。
伦理与边界
- 测试作答必须用独立链接,不能混入正式样本。
- 对脆弱人群,不要为了筛查堆砌高负担的认知测试;录像问答环节里 Amber Thompson 更推荐从招募方式入手,例如社群合作、定向邀请 [1:25:11–1:27:36]。
- 不公开发布逐条检测规则。录像中讲者讨论过公开检测方法可能被利用,并设想改为向期刊编辑提供细节 [1:43:32–1:44:21]。
- 本文不提供任何让自动作答更像人类的方法。
能写 / 不能写
| 能写 | 不能写 |
|---|---|
| 录像中的基准研究显示 AI 智能体通过了多数传统检查 | 「注意力检查已完全失效」 |
| 讲者报告的行为副数据差异(标签页切换、鼠标轨迹) | 「鼠标轨迹可以百分之百识别机器人」 |
| 讲者认为分层可以减轻但难以清除欺诈作答 [1:39:29–1:41:06] | 「采用五道闸门即可保证数据无污染」 |
| 简介与讲述中的剔除比例不一致(85% / 94%) | 只引用其中一个数字且不注明来源 |
可审计产物
_w/bot-gate/flag_cases.py与flag_output.txt_w/bot-gate/test_export.example.csv(演示数据)_w/bot-gate/bot-acceptance.csv、bot-gate-log.csv_w/yt/AqlMlLqWLeU.txt(自动字幕整理稿,带时间戳)
总结
调研数据诚信的验收单位是五道闸门加一次带已知答案的最小实验,而不是问卷里多放几道注意力检查。最小实验的价值在于让失败可观测:已知的 AI 辅助作答有没有漏过去,已知的真人有没有被误伤。两个问题都答得上来,才有资格决定要不要开放公开链接。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献9条内容

所有评论(0)