深化高通Linux开发(5): 多设备协同开发
系列定位:深化高通Linux开发 · 面向工业机器人 / 智能相机 / ROS
本篇将主要探讨嵌入式Linux的多设备协同开发,高通边缘主从架构、机器人多节点通信与数据同步。
一、为什么单机方案一定会撞墙
前面 我们一直在做"把一台设备做深"这件事:裁剪内核、写驱动、下沉 DSP 负载、上功能安全、加固系统。
但真正拉到工业现场,你会发现单台设备的能力边界不是被算力卡住的,而是被物理世界卡住的。
1.1 三个真实的场景约束
| 场景 | 单机方案的硬约束 | 为什么加一台机器解决不了 |
|---|---|---|
| 大尺寸工件全域缺陷检测 | 3 台 12MP 相机 @60fps 同时采集,MIPI CSI 通道数和 ISP 带宽不够 | 换更高算力的单板,相机线缆长度仍然受限于 MIPI 的物理层(通常 <30cm) |
| 双臂机器人协同搬运 | 双臂运动学耦合,单节点要同时跑 2 路 1kHz 伺服环 + 视觉 | 单一 Linux 内核的调度抖动会同时影响两条手臂,反而更难保证 |
| 移动机器人 + 固定工位对接 | AGV 上的算力单元需要和产线工位的固定单元实时交换位姿 | 线缆拖链不可靠,必须走无线,而无线天然需要跨设备协议 |
再叠加该系列的前面几篇的工作,单板其实已经很满了:CPU 跑 ROS2 节点和业务逻辑,NPU 跑推理,Hexagon 跑预处理,安全岛跑功能安全监控。再加一路相机,就只能加一块板子。
1.2 多设备协同带来的三个新问题
把一台机器变成四台,问题不是线性增长,而是冒出了三个全新的维度:
- 架构问题——谁指挥谁?主节点挂了产线停不停?
- 通信问题——用什么协议传?多快?丢了怎么办?
- 同步问题——四个节点采到的数据,怎么知道它们描述的是"同一时刻"的物理世界?
这三个问题需要我们在架构设计阶段优先解决。
二、主从架构设计
2.1 角色划分
先明确角色。工业边缘场景里,一个节点通常只承担一种角色,角色混用是后期最难拆的坑。
| 角色 | 典型硬件 | 核心职责 | 失效影响 |
|---|---|---|---|
| 主节点 Master | IQ-9100(算力最强者) | 全局时间源、任务编排、多节点结果融合、协同决策下发、拓扑与健康监控 | 降级运行;由 Standby 接替(见 5.4) |
| 从节点 Slave | QRB5165 / IQ-9075 | 本地采集、DSP 预处理、本地控制环闭环、安全状态输出、指令执行 | 该节点退出协同,主节点重规划 |
| 观察节点 Observer | 任意高通板 / x86 工控机 | 只订阅数据、不发指令;用于看板、录包、离线分析 | 无影响 |
| 备用主节点 Standby | 与主节点同构 | 热备,持续同步主节点状态机与全局帧号 | 无影响;升主时接管 |
经验:Observer 角色的价值被严重低估。现场排查"到底是谁的数据不对"时,一个只订阅不参与的录包节点能省掉几天扯皮。
2.2 三级分层架构
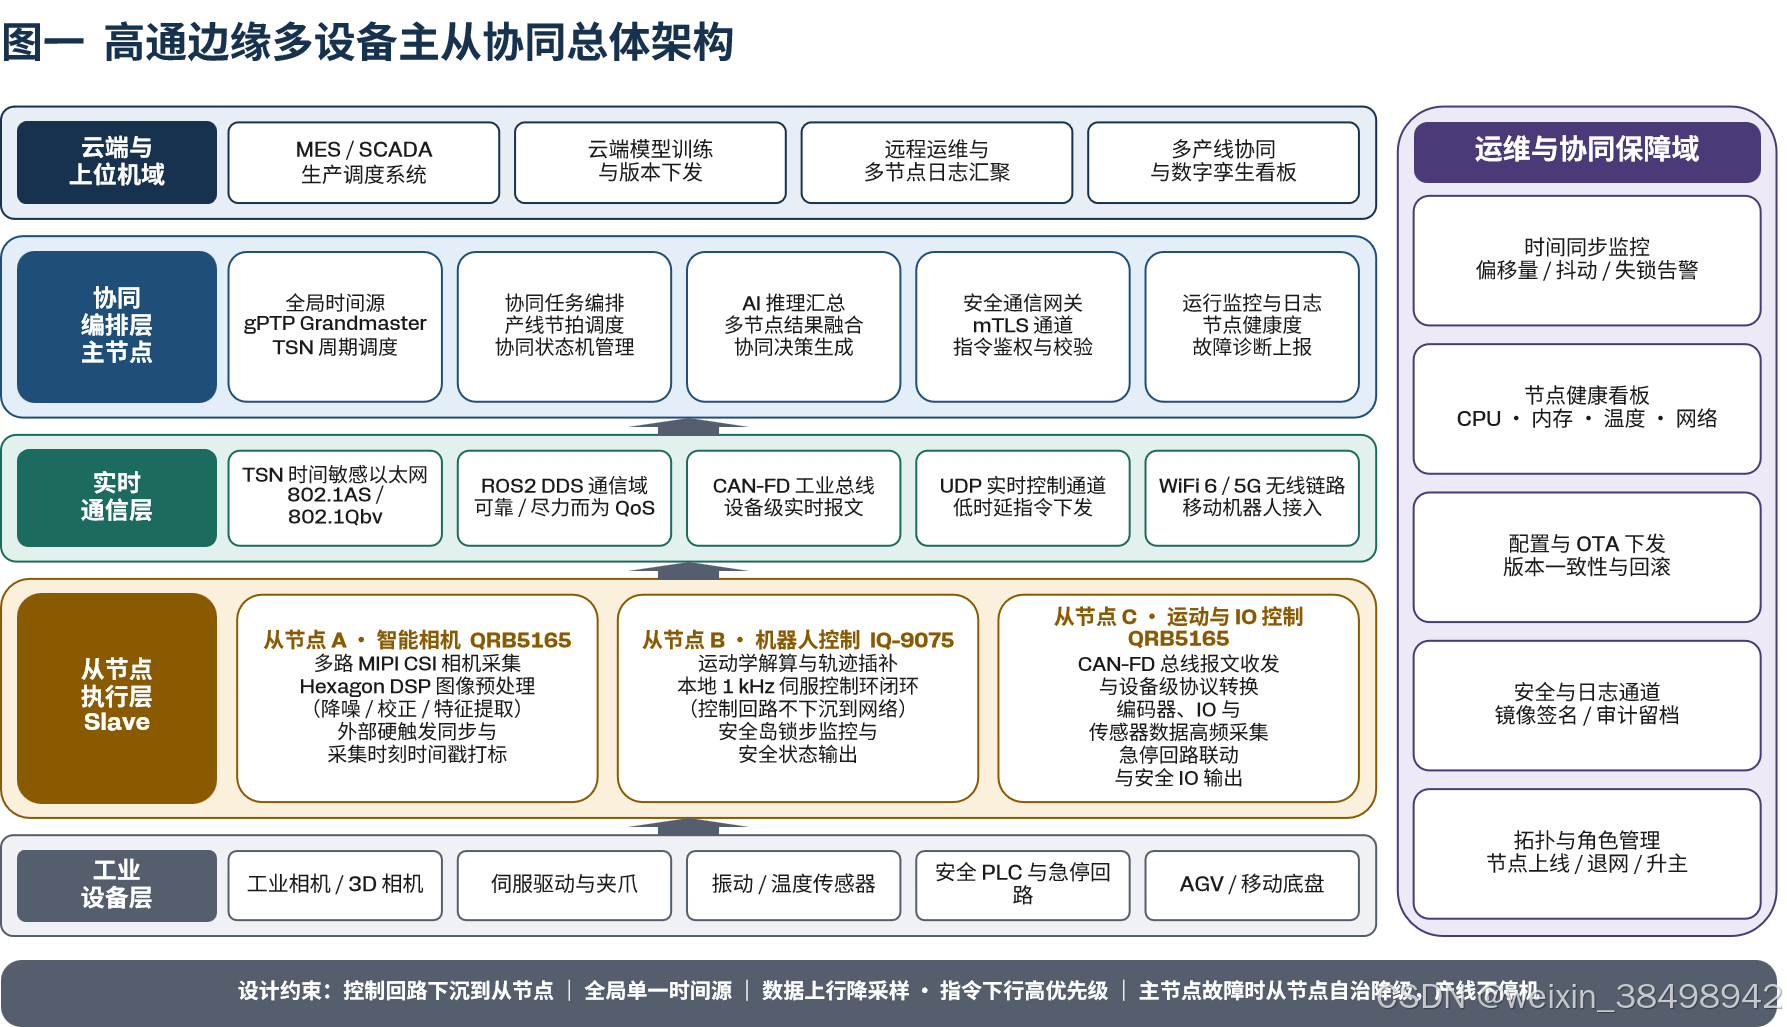
该架构图自上而下分五层,右侧是贯穿所有节点的运维保障域:
① 云端与上位机域——MES / SCADA、模型训练与版本下发、远程运维。主节点在这里是一个"网关"角色,《嵌入式安全加固开发》的 mTLS 通道和《系统日志与故障诊断》的日志上报体系都挂在这一层。
② 协同编排层(主节点)——这是新增的一层,也是本篇的重点:
- 全局时间源:主节点是唯一的 gPTP Grandmaster,整个系统只有一个时间权威。
- 协同任务编排:产线节拍调度、协同状态机管理。
- AI 推理汇总:汇聚各从节点的推理结果做融合决策。
- 安全通信网关:指令鉴权与完整性校验(调用,《嵌入式安全加固开发》的密钥体系)。
- 运行监控与日志:节点健康度 + 故障诊断上报(对接《系统日志与故障诊断》的日志体系)。
③ 实时通信层——TSN 以太网、ROS2 DDS 域、CAN-FD、UDP 实时控制通道、WiFi 6 / 5G。第五点很关键:无线链路和有线链路的语义必须是同一套,否则移动机器人和固定工位就无法在一个协同逻辑里编排。
④ 从节点执行层——三个从节点的分工体现了"控制回路下沉"原则:
- 从节点 A · 智能相机(QRB5165):多路 MIPI 采集 + Hexagon DSP 图像预处理(《Hexagon DSP并行开发》的成果)+ 硬触发同步与时间戳打标。
- 从节点 B · 机器人控制(IQ-9075):运动学解算、轨迹插补、本地 1kHz 伺服控制环、安全岛锁步监控。
- 从节点 C · 运动与 IO 控制(QRB5165):CAN-FD 收发、编码器与 IO 高频采集、急停回路联动。
⑤ 工业设备层——相机、伺服、传感器、安全 PLC、AGV 底盘。
2.3 五条必须坚持的设计原则
这五条是整篇文章的骨架,后面所有技术选型都是它们的推论:
-
原则一:控制回路必须留在从节点本地。
不要把 1kHz 的伺服环放到网络上。网络再确定性,也比本地内存访问慢 3 个数量级。从节点接收的是"目标位姿",不是"每个周期的关节角"。这条原则决定了带宽需求和实时性需求的量级。 -
原则二:全局单一时间源。
整个系统有且只有一个时间权威(主节点的 gPTP Grandmaster)。绝不允许多个节点各自对 NTP 服务器。时间源出现分歧时,数据融合的结论一定是错的,而且错得很隐蔽。 -
原则三:数据上行降采样,指令下行高优先级。
上行是"够用就行"——视觉特征、位姿、状态量;下行是"必须准时"——控制指令、同步触发。两者在 QoS 和网络队列上要区别对待(见 3.2、3.3)。 -
原则四:从节点必须能自治降级。
主节点失联时,从节点不能停机等待,而要切到本地安全策略:保持当前轨迹、减速停车、或进入安全保持位。"网络断了产线停"是架构设计失败,不是网络问题。 -
原则五:角色可动态选举,时间源不动态。
主节点可以选举切换(5.4),但同一时刻全局只能有一个 Grandmaster。选举协议必须包含"时钟质量"字段,避免选出一个时间不准的节点当主时钟。
2.4 主节点会成为瓶颈吗?
这是被问得最多的问题。答案是:只要坚持原则一,主节点就永远不会是瓶颈。
主节点不做闭环控制,它做的是"离散事件"级别的编排——每个协同节拍(通常是 10~100ms 量级)处理一次融合和决策。这个负载与伺服环的 1kHz 完全不在一个数量级上。
我们在一台高通跃龙IQ-9100 做主节点、3 个从节点(2×QRB5165 + 1×IQ-9075)、2 路 12MP 相机的配置下实测:
| 指标 | 实测值 | 说明 |
|---|---|---|
| 主节点 CPU 占用(融合 + 编排) | 18% ~ 25%(8 核中的 2 核为主) | 不含 NPU 推理 |
| 协同节拍抖动(P99) | 0.8 ms | 节拍周期 33 ms |
| 上行数据总带宽 | ~42 Mbps | 已做特征降采样 |
| 下行指令带宽 | < 200 kbps | 指令本身很小 |
| 千兆网口余量 | > 90% | 瓶颈在相机侧,不在网络 |
余量非常充足。真正的瓶颈从来是同步精度和故障时的行为设计,而不是主节点的吞吐。
三、多节点通信机制
3.1 通道选型矩阵
工业现场不会只用一种通道。下面是我们在高通边缘平台上实际用过的组合:
| 通道 | 典型时延 | 有效带宽 | 适用场景 | 高通平台实现要点 |
|---|---|---|---|---|
| TSN 以太网(802.1AS + 802.1Qbv) | 100 μs ~ 1 ms | 1 Gbps / 2.5 Gbps | 多相机同步触发、协同控制指令 | 需 SoC 网卡支持 PTP 硬件时间戳 |
| ROS2 DDS | 0.5 ~ 5 ms | 受网络限制 | 话题数据、服务调用、动作接口 | 域 ID 隔离 + QoS 配置 |
| CAN-FD | 1 ~ 10 ms | 2 ~ 8 Mbps | 设备级报文、安全 IO 广播 | SoC 内置 CAN-FD 控制器 |
| UDP 自定义协议 | 50 ~ 500 μs | 取决于网络 | 硬实时控制指令、同步触发广播 | 应用层加序列号 + 时间戳 + CRC32 |
| 共享内存 / PCIe | < 10 μs | 数 Gbps | 同一机箱内多 SoC 紧耦合 | IQ 系列多 SoC 板卡可用;跨设备不适用 |
| WiFi 6 / 5G | 5 ~ 50 ms | 数十 ~ 数百 Mbps | 移动机器人、AGV 接入 | 重点解决漫游与丢包 |
选型口诀:要准时 → TSN/UDP;要语义 → DDS;要接设备 → CAN-FD;要移动 → 无线。
3.2 ROS2 DDS 在多节点场景的配置
ROS2 底层是 DDS,默认配置在单机开发时很好用,一到多机现场就会踩三个坑。
坑一:域 ID 冲突
同一网段里如果有多套 ROS2 系统(比如两套测试台架),它们会互相发现,造成话题串扰和带宽浪费。
# 每套系统分配独立域 ID(0~232)
export ROS_DOMAIN_ID=42
export ROS_LOCALHOST_ONLY=0
export RMW_IMPLEMENTATION=rmw_cyclonedds_cpp
建议按产线编号规划:产线 A 用 41~50,产线 B 用 51~60,便于后期扩展。
坑二:多播发现被工业交换机吃掉
DDS 默认用多播做节点发现。但工业现场很多交换机默认开启 IGMP Snooping 却没人配组播路由器,多播包直接被丢弃,现象是"两个节点互相看不见,但 ping 得通"。
解决方案:改用单播发现(推荐,现场最稳)。
CycloneDDS 配置(/etc/cyclonedds/cyclonedds.xml):
<?xml version="1.0" encoding="UTF-8"?>
<CycloneDDS xmlns="https://cdds.io/config">
  <Domain id="42">
    <General>
      <NetworkInterfaceAddress>eth0</NetworkInterfaceAddress>
      <!-- 关闭多播,避免被工业交换机丢弃 -->
      <AllowMulticast>false</AllowMulticast>
      <Interfaces>
        <NetworkInterface name="eth0" multicast="false"/>
      </Interfaces>
    </General>
    <Discovery>
      <ParticipantIndex>auto</ParticipantIndex>
      <!-- 显式列出所有节点,单播发现 -->
      <Peers>
        <Peer address="192.168.10.10"/>  <!-- 主节点 IQ-9100 -->
        <Peer address="192.168.10.21"/>  <!-- 从节点 A 智能相机 -->
        <Peer address="192.168.10.22"/>  <!-- 从节点 B 机器人控制 -->
        <Peer address="192.168.10.23"/>  <!-- 从节点 C 运动/IO -->
      </Peers>
    </Discovery>
  </Domain>
</CycloneDDS>
export CYCLONEDDS_URI=file:///etc/cyclonedds/cyclonedds.xml
如果必须保留多播(节点频繁上下线),则在交换机侧配置 IGMP Querier;注意高通平台的某些以太网 PHY 对组播过滤比较激进,必要时用 ethtool -K eth0 rxhash on 和检查 ethtool -S eth0 | grep -i multi 确认组播包确实进来了。
坑三:QoS 不匹配导致静默失联
ROS2 里两个节点的 QoS 不兼容时,不会报错,只是收不到数据。多机场景下这是最耗时的一类问题。
按数据类型定义 QoS profile(qos_profiles.yaml):
# 上行:高频传感器数据 —— 允许丢帧,不能阻塞
sensor_stream:
  ros__parameters:
    qos_overrides:
      /camera_a/features:
        publisher:
          reliability: best_effort     # 关键:实时数据不要 reliable
          durability: volatile
          history: keep_last
          depth: 5
          deadline:
            sec: 0
            nsec: 33000000             # 33 ms 节拍

# 下行:协同控制指令 —— 绝不能丢
control_command:
  ros__parameters:
    qos_overrides:
      /master/control_cmd:
        subscription:
          reliability: reliable
          durability: volatile
          history: keep_last
          depth: 10
          liveliness: automatic

# 状态与拓扑 —— 需要晚加入的节点也能拿到
system_state:
  ros__parameters:
    qos_overrides:
      /master/system_state:
        publisher:
          reliability: reliable
          durability: transient_local  # 关键:晚加入的节点能收到最后一条
          history: keep_last
          depth: 1
踩坑记录:
durability: transient_local必须成对配置(发布端和订阅端都要),只配一端同样静默失联。发布端还需设置history: keep_last且depth >= 1,否则历史样本不会保留。调试利器:
ros2 topic info /topic --verbose会把两端 QoS 逐项列出来对比。
上行降采样:别把原始数据灌给网络
坚持原则三。从节点 A 的相机输出 12MP@60fps 原始图 ≈ 4.3 Gbps,直接上行会把千兆网打爆。正确做法是在从节点侧用 Hexagon DSP 提取特征后只传特征(《Hexagon DSP并行开发》的成果在这里兑现):
# 从节点 A:DSP 预处理后只上行降采样结果
import rclpy
from rclpy.node import Node
from rclpy.qos import QoSProfile, ReliabilityPolicy, HistoryPolicy
from sensor_msgs.msg import PointCloud2
from vision_msgs.msg import Detection2DArray

class FeatureUplink(Node):
    def __init__(self):
        super().__init__('feature_uplink')
        # best_effort + keep_last(5):只保证最新,不补发旧帧
        qos = QoSProfile(
            reliability=ReliabilityPolicy.BEST_EFFORT,
            history=HistoryPolicy.KEEP_LAST,
            depth=5,
        )
        self.pub = self.create_publisher(Detection2DArray, '/camera_a/features', qos)
        # 原始图只在本地保留,用于异常回溯,不上行
        self.raw_ring = RingBuffer(capacity=300)   # 本地 5 秒环形缓存

    def on_frame(self, frame, hw_ts_ns: int):
        self.raw_ring.push(frame, hw_ts_ns)
        dets = self.dsp_infer(frame)              # Hexagon DSP 侧完成
        msg = Detection2DArray()
        msg.header.stamp = self.get_clock().now().to_msg()
        # 关键:把硬件采集时刻与序列号塞进 header,供主节点做时间对齐
        msg.header.frame_id = f"nodeA/seq={frame.seq}/hwts={hw_ts_ns}"
        msg.detections = dets
        self.pub.publish(msg)
frame_id 里塞元数据是权宜做法,更规范的是自定义消息类型。但关键是:上行数据必须自带硬件时间戳和序列号,否则主节点无法对齐。
3.3 实时控制指令通道:UDP 自定义协议
DDS 完全能传控制指令,但在 <500μs 的确定性要求下,UDP 单播 + 应用层保障更可控——你能精确知道每一跳发生了什么,而 DDS 的内部队列和线程模型是黑盒。
帧结构设计(固定 48 字节头 + 变长载荷):
| 偏移 | 长度 | 字段 | 说明 |
|---|---|---|---|
| 0 | 4 | Magic | 0x51 0x43 0x43 0x4D(“QCCM”) |
| 4 | 1 | Version | 协议版本,用于灰度升级 |
| 5 | 1 | MsgType | 1=同步启动 2=轨迹下发 3=急停 4=心跳 5=状态回传 |
| 6 | 2 | PayloadLen | 载荷长度(网络字节序) |
| 8 | 8 | GlobalFrame | 全局帧号,协同的唯一时间锚点 |
| 16 | 8 | ExecTimeNs | 计划执行时刻(TAI 纳秒,基于 gPTP 时基) |
| 24 | 4 | SeqNum | 发送序列号,用于丢包检测与去重 |
| 28 | 4 | NodeMask | 目标节点位图(支持组播式定向) |
| 32 | 8 | PayloadHash | 载荷摘要,防篡改(配合《嵌入式安全加固开发》密钥体系) |
| 40 | 4 | CRC32 | 帧头 + 载荷校验 |
| 44 | 4 | Reserved | 对齐保留 |
为什么 ExecTimeNs 比"收到就执行"更好?
这是分布式协同的核心技巧。主节点不说"现在执行",而说"在 TAI 时刻 X 执行"。由于所有节点共享 gPTP 时基(精度 ≤1μs),即使网络时延有 200μs 的抖动,各节点的实际执行时刻仍然是对齐的——网络抖动被"计划执行时刻"吸收了。
// 从节点 C:按计划时刻精确执行
static inline uint64_t now_tai_ns(void) {
    struct timespec ts;
    clock_gettime(CLOCK_TAI, &ts);          // TAI 时基,不受闰秒影响
    return (uint64_t)ts.tv_sec * 1000000000ull + ts.tv_nsec;
}

void on_control_frame(const ctrl_frame_t *f) {
    if (f->magic != QCCM_MAGIC) return;
    if (crc32_check(f) != 0) { statistic_bad_crc++; return; }

    // 幂等去重:同一 GlobalFrame + SeqNum 只执行一次
    if (dedup_seen(f->global_frame, f->seq_num)) return;

    uint64_t exec_at = f->exec_time_ns;
    uint64_t now = now_tai_ns();

    if (exec_at <= now) {
        // 已经过点了:说明指令迟到。按策略处理,不能直接执行
        statistic_late_cmd++;
        if (now - exec_at > LATE_THRESHOLD_NS) {
            safety_degrade(DEGRADE_HOLD_POSITION);
            return;
        }
    }

    // 忙等到执行时刻(在 RT 线程内,配合 PREEMPT-RT)
    while (now_tai_ns() < exec_at) { cpu_relax(); }
    apply_trajectory_point(&f->payload);
}
调优要点:
- 忙等(busy-wait)在有
isolcpus隔离的核上跑,配合 PREEMPT-RT,抖动可压到 <10μs。 LATE_THRESHOLD_NS建议设为 2~3 个控制周期。超阈值不要"尽力执行",而是进入安全保持——迟到的正确指令比不执行更危险。- 去重窗口用环形位图(如 1024 位),覆盖若干秒,成本极低。
3.4 CAN-FD 跨设备转发
工业设备层的伺服、夹爪、安全 IO 大多还是 CAN 接口。多节点场景下有两种做法:
做法一:从节点本地终结 CAN(推荐)
从节点 C 直接接 CAN-FD 总线,把设备数据转成 DDS 话题上行。设备层对上层完全透明。
做法二:跨节点 CAN 隧道
某些设备必须由主节点直接控制时,用 socketcand 或自研 UDP 隧道把 CAN 帧透传到远端。
# 从节点 C:配置 CAN-FD 接口
ip link set can0 down
ip link set can0 type can \
    bitrate 500000 \
    dbitrate 2000000 \
    sample-point 0.875 \
    dsample-point 0.75 \
    fd on \
    restart-ms 100
ip link set can0 txqueuelen 1000
ip link set can0 up

# 验证
ip -details link show can0
candump can0 -n 10
CAN-FD 时间戳必须用硬件时间戳,否则报文的采集时刻没有意义(软件时间戳受中断延迟影响,抖动可达数百微秒):
# 开启 CAN 硬件时间戳
ip link set can0 type can fd on berr-reporting on
# 应用层用 SO_TIMESTAMPING 取硬件时间戳,再换算到 gPTP 时基
3.5 无线链路(WiFi 6 / 5G)
移动机器人必须走无线。无线链路的三个关键问题:
| 问题 | 现象 | 应对 |
|---|---|---|
| 漫游切换 | AGV 跨 AP 时链路中断 200ms~2s | 802.11r 快速漫游 + 双网卡冗余;从节点本地自治降级(原则四) |
| 丢包抖动 | 数据帧时间对齐失效 | 上行 best_effort + 主节点插值补偿;关键指令走 UDP 重传 + 序号去重 |
| 带宽波动 | 多台 AGV 同时上传视觉数据时拥塞 | 上行强制降采样;按优先级分队列(tc 分层) |
核心原则:无线链路上永远不要依赖实时性,只依赖"最终一致性 + 时间戳"。节点自己打的时间戳是准的(本地 gPTP),传到主节点晚了没关系,主节点按时间戳对齐即可。
四、时间同步:协同的地基
4.1 为什么同步是地基,而不是"锦上添花"
如果各节点时间不同步,会发生什么:
- 多相机融合失效:A 相机和 B 相机拍的不是同一时刻的工件,立体重建和缺陷关联全是错的。产线速度 1m/s 时,1ms 的时间偏差对应 1mm 的空间偏差——足够让一次精密装配失败。
- 多机器人防碰撞误判:两个机器人上报的位姿时间差 5ms,在 1m/s 的运动速度下就是 5mm 的位置不确定性,安全距离算不准。
- 节拍统计失真:主节点无法判断"从节点是慢了还是网络慢了",所有性能优化都失去度量基准。
所以:先解决时间,再谈其他。 这是本文档最重要的一条工程建议。
4.2 gPTP / IEEE 802.1AS 落地
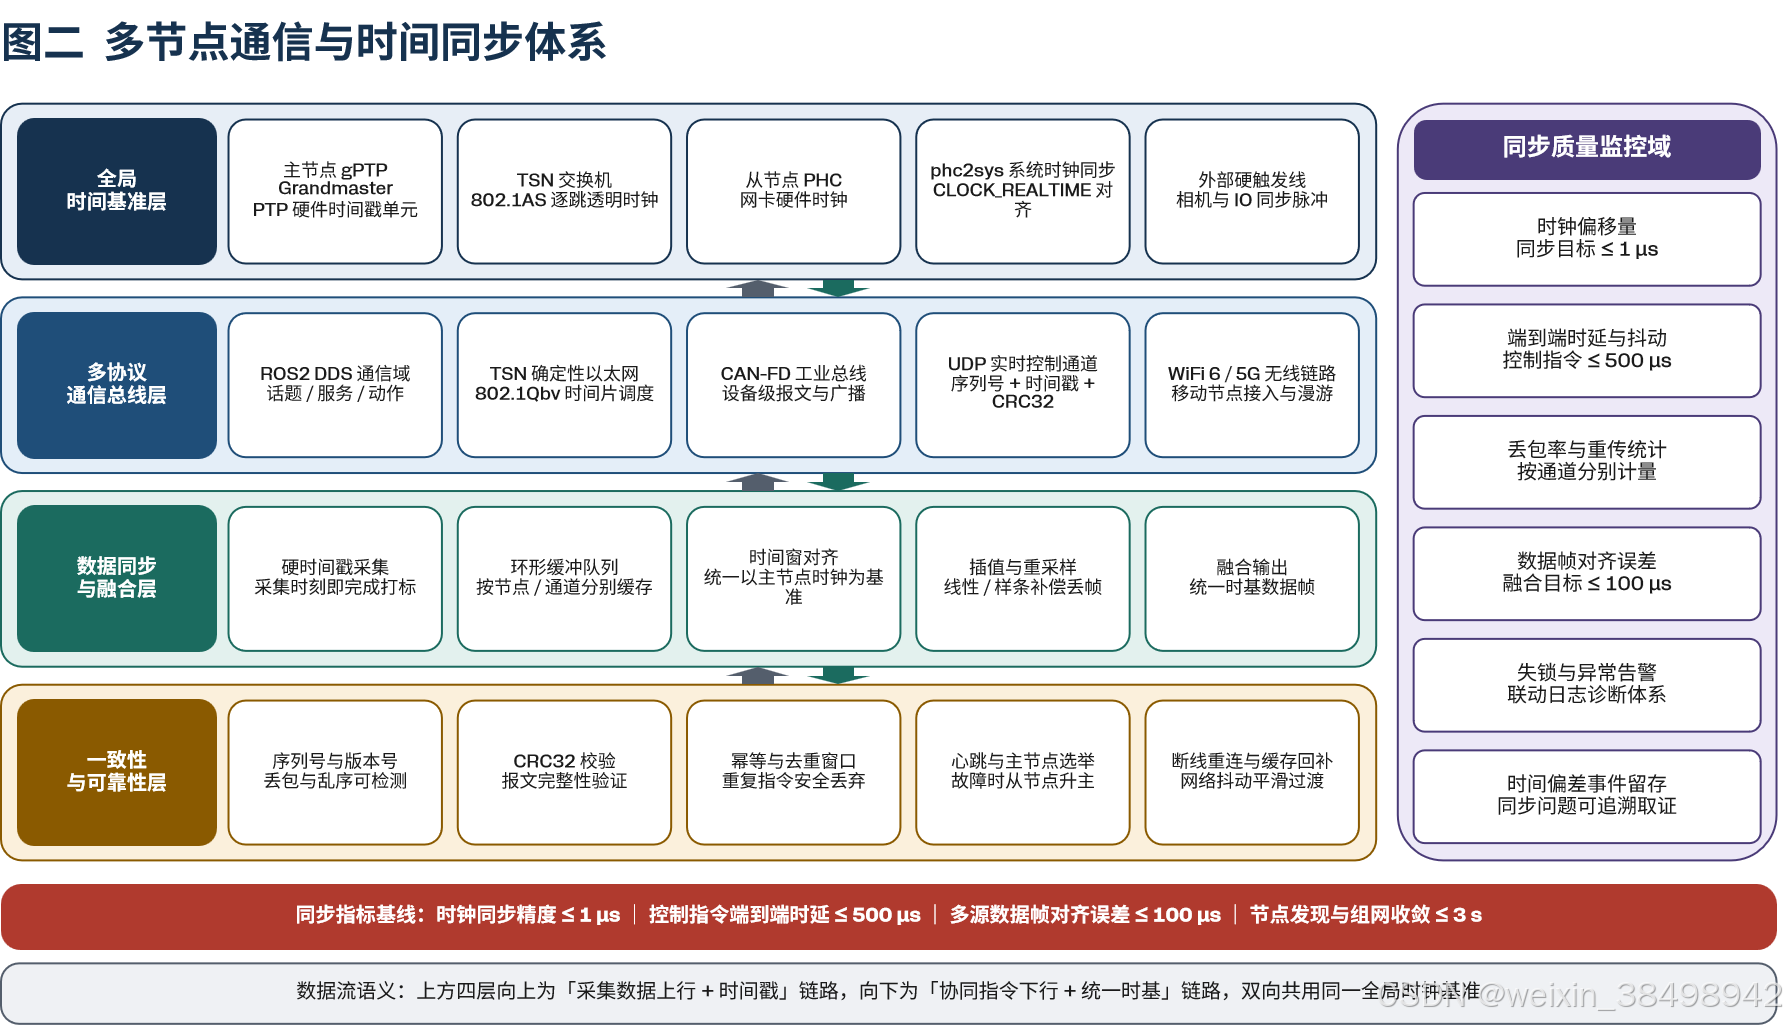
架构图描述了完整的四层同步体系,自下而上(图中自上而下为层次,数据流为双向):
① 全局时间基准层——主节点作 Grandmaster,用 PTP 硬件时间戳单元打时间戳(软件时间戳精度只能到几十微秒,硬件时间戳才能到亚微秒)。TSN 交换机作透明时钟逐跳修正转发延迟。从节点的网卡 PHC(PTP Hardware Clock)被同步后,再通过 phc2sys 同步到系统时钟。外部硬触发线是终极手段——直接用电信号对齐相机曝光和 IO 动作,不受任何软件栈影响。
② 多协议通信总线层——所有通道共用同一时间基准。
③ 数据同步与融合层——硬时间戳采集 → 环形缓冲 → 时间窗对齐 → 插值重采样 → 融合输出。
④ 一致性与可靠性层——序列号、CRC32、幂等去重、心跳选举、断线重连。
主节点配置(Grandmaster)
# /etc/linuxptp/gPTP.cfg  —— 主节点
[global]
gmCapable               1
priority1               128      # 数值越小优先级越高
priority2               128
clockClass              248
clockAccuracy           0xFE
offsetScaledLogVariance 0xFFFF
domainNumber            0
slaveOnly               0        # 主节点不是 slaveOnly
transportSpecific       0x1      # 802.1AS
ptp_dst_mac             01:80:C2:00:00:0E
network_transport       L2
delay_mechanism         PeerDelay  # gPTP 用 P2P 延迟测量
logSyncInterval         -3       # 125ms
logMinPdelayReqInterval -3
syncReceiptTimeout      3
neighborPropDelayThresh 800
# 启动(-m 打印到 stdout 便于 systemd journal 采集)
ptp4l -i eth0 -f /etc/linuxptp/gPTP.cfg -m

# 把 PHC 同步到系统时钟(CLOCK_REALTIME)
phc2sys -s eth0 -c CLOCK_REALTIME -w -m -O 0
从节点配置(Slave)
# 从节点只需 slaveOnly=1,其余协商
[global]
slaveOnly               1
transportSpecific       0x1
ptp_dst_mac             01:80:C2:00:00:0E
network_transport       L2
delay_mechanism         PeerDelay
ptp4l -i eth0 -f /etc/linuxptp/slave.cfg -m -s
phc2sys -s eth0 -c CLOCK_REALTIME -w -m -O 0
验证同步质量
# 查看当前偏移量(单位 ns)
pmc -u -b 0 'GET TIME_STATUS_NP'

# 典型输出关注三行:
#   master_offset         -37      # 偏移 < 1000ns 即达标
#   freq_ppm              0.12     # 频率调整量,稳定说明锁定了
#   gm_present            1

# 持续监控(日志体系可直接采集这个输出)
while true; do
  pmc -u -b 0 'GET TIME_STATUS_NP' 2>/dev/null \
    | awk '/master_offset/ {print strftime("%F %T"), $2"ns"}'
  sleep 1
done
目标值:同一 TSN 交换机下 ≤ 1 μs;跨 3 跳交换机 ≤ 5 μs;含无线链路的节点 ≤ 100 μs(无线节点不参与硬实时协同)。
4.3 数据同步的三种模式
| 模式 | 精度 | 实现成本 | 适用场景 | 前提条件 |
|---|---|---|---|---|
| 硬件触发同步 | < 1 μs | 高(要布线) | 多相机同时曝光、多轴同步启动 | 设备支持外触发输入 |
| 硬时间戳 + 时间窗对齐 | 1 ~ 100 μs | 中 | 多传感器融合、视觉+控制联动 | gPTP 已收敛 + 网卡支持硬件时间戳 |
| 软同步 + 插值补偿 | 0.1 ~ 5 ms | 低 | 状态量上报、非紧耦合数据、无线节点 | 时间戳可信即可 |
选型建议:能用硬件触发的关键路径一定要用硬件触发(比如多相机曝光),其余全部走"硬时间戳 + 时间窗对齐"。软同步只作为兜底。
4.4 时间窗对齐与插值融合的实现
主节点收到的数据帧时间戳是散乱的。对齐的核心是:以主节点时钟为基准,为每个融合周期开一个时间窗,把各节点落在窗内的数据取出并重采样到窗中心。
import bisect
import numpy as np
from collections import deque

class TimeAlignedFuser:
    """主节点侧:多节点数据的时间窗对齐与插值融合"""

    def __init__(self, period_ns=33_000_000, window_ns=5_000_000, max_latency_ns=66_000_000):
        self.period_ns = period_ns            # 融合节拍 33ms
        self.window_ns = window_ns            # 时间窗 ±5ms
        self.max_latency_ns = max_latency_ns  # 超过 2 个周期未到,判为丢帧
        # 每个节点一条按时间有序的缓冲
        self.buffers: dict[str, deque] = {}

    def push(self, node_id: str, hw_ts_ns: int, payload):
        buf = self.buffers.setdefault(node_id, deque(maxlen=512))
        # 保持时间有序(乱序到达时插入到正确位置)
        if buf and hw_ts_ns < buf[-1][0]:
            ts_list = [x[0] for x in buf]
            buf.insert(bisect.bisect_left(ts_list, hw_ts_ns), (hw_ts_ns, payload))
        else:
            buf.append((hw_ts_ns, payload))

    def fuse(self, tick_center_ns: int) -> dict:
        """对齐到 tick_center_ns,返回各节点的重采样结果"""
        lo = tick_center_ns - self.window_ns
        hi = tick_center_ns + self.window_ns
        out = {}
        for node_id, buf in self.buffers.items():
            # 丢掉过老的数据,防止缓冲无限增长
            while buf and tick_center_ns - buf[0][0] > self.max_latency_ns:
                buf.popleft()

            samples = [x for x in buf if lo <= x[0] <= hi]
            if not samples:
                out[node_id] = None           # 该节点本窗无数据 → 标记丢帧
                continue

            if len(samples) == 1:
                out[node_id] = samples[0][1]  # 单点,直接取(精度损失可接受)
            else:
                # 线性插值到窗中心:两帧夹住窗心最准
                ts = np.array([s[0] for s in samples], dtype=np.int64)
                idx = np.searchsorted(ts, tick_center_ns)
                if 0 < idx < len(samples):
                    t0, v0 = samples[idx - 1]
                    t1, v1 = samples[idx]
                    a = (tick_center_ns - t0) / (t1 - t0)
                    out[node_id] = lerp_payload(v0, v1, a)
                else:
                    # 窗心在所有样本之外,取最近的一帧并记录降级
                    out[node_id] = samples[-1][1] if idx >= len(samples) else samples[0][1]
        return out


def lerp_payload(v0, v1, a: float):
    """对载荷做线性插值;位姿用球面插值(slerp),特征用矢量插值"""
    if isinstance(v0, np.ndarray):
        return v0 * (1.0 - a) + v1 * a
    return v0 if a < 0.5 else v1        # 离散量(如检测框类别)取最近
几个必须注意的点:
- 插值只能补时间,不能补真实性。如果某节点长时间丢帧,插值出来的数据是虚假的。必须给
fuse()返回的每个节点结果附一个"数据新鲜度"标记,决策层要知道这个数是不是插出来的。 - 位姿插值必须用 slerp,四元数线性插值在角度大时会产生明显误差。
max_latency_ns决定系统对网络抖动的容忍度。设太小会频繁判丢帧,设太大则融合结果用的是过期数据。建议设为 2 个节拍周期。
4.5 同步质量监控
架构图二右侧的"同步质量监控域"是有具体实现的,直接对接《系统日志与故障诊断》的日志体系:
| 监控项 | 采集方式 | 告警阈值 |
|---|---|---|
| 时钟偏移量 | pmc GET TIME_STATUS_NP | > 1 μs 警告,> 10 μs 严重 |
| 端到端时延与抖动 | 帧内 ExecTimeNs 与本地 CLOCK_TAI 之差 | 控制指令 > 500 μs 告警 |
| 丢包率与重传 | 序列号空洞检测 | 单通道 > 0.1% 告警 |
| 数据帧对齐误差 | 融合窗内样本时间跨度 | > 100 μs 告警 |
| 失锁与异常 | ptp4l 日志关键字 | FAULTY / UNCALIBRATED 立即告警 |
五、协同控制指令交互
5.1 指令分类
| 类型 | MsgType | 语义 | 可靠性要求 | 通道 |
|---|---|---|---|---|
| 同步启动 | 1 | 携带全局帧号与统一启动时刻,各节点按时刻开始采集 | 必须送达 | UDP + DDS 双发 |
| 轨迹下发 | 2 | 目标位姿序列,从节点本地插补 | 必须送达 | UDP + 序号去重 |
| 急停 | 3 | 立即停止,双冗余 | 最高 | 硬线 + UDP 广播 |
| 心跳 | 4 | 存活与状态汇报 | 允许丢失 | UDP,周期 100ms |
| 状态回传 | 5 | 执行结果与实测值 | 允许丢失(重传) | DDS best_effort |
5.2 节点状态机
        上电
         │
         ▼
     ┌────────┐  初始化完成   ┌────────┐  收到启动指令  ┌─────────┐
     │  INIT  │────────────▶│ READY  │──────────────▶│ RUNNING │
     └────────┘              └────────┘                └─────────┘
         │                        ▲                        │  ▲
         │ 自检失败               │ 恢复完成                │  │ 继续
         ▼                        │                        │  │
     ┌────────┐               ┌────────┐   异常/超差   ┌───▼──┴──┐
     │ FAULT  │◀─────────────│ PAUSED │◀─────────────│ 校验/监控│
     └────────┘   无法恢复     └────────┘              └──────────┘
关键规则:
RUNNING → PAUSED的触发条件包括:主节点心跳超时、本节点数据超差、同步失锁。PAUSED状态必须有一个确定性的本地行为(保持位置 / 减速停车),不能是"什么都不做"。FAULT只能人工复位或经完整自检后恢复。自动从 FAULT 恢复是安全事故的常见来源。
5.3 急停:网络 + 硬线双冗余
这是功能安全的要求(对接安全岛),必须两条路都通:
class EmergencyStop:
    """急停双冗余:硬线安全回路 + 网络广播"""

    def __init__(self, can_bus, udp_sender):
        self.can = can_bus
        self.udp = udp_sender

    def trigger(self, source: str, reason: str):
        # 路径一:硬线安全回路(<1ms,不依赖任何软件栈)
        # 由安全 PLC 直接拉低使能线,硬件切断伺服使能
        # 软件侧只做记录,不做"触发"动作 —— 这是安全设计的关键
        log_safety_event(source, reason)

        # 路径二:网络广播(用于让其他节点进入协同安全状态)
        frame = build_ctrl_frame(
            msg_type=MSG_ESTOP,
            global_frame=self.current_global_frame,
            exec_time_ns=now_tai_ns(),      # 急停要求立即执行
            seq_num=self.next_seq(),
            node_mask=0xFFFFFFFF,            # 广播
        )
        self.udp.send_broadcast(frame)

        # 路径三:CAN 安全报文(覆盖 CAN 设备)
        self.can.send_safety_frame(SAFETY_ESTOP, reason)
安全设计要点:软件不应该是急停链路的触发者,只应该是急停链路的参与者。真正的急停必须由硬线安全回路完成(如SIL3 安全岛)。网络广播急停的作用是让没有硬线连接的其他节点同步进入安全状态,是补充而非替代。
5.4 主节点故障与选举
主节点失联时,从节点不能停在原地等。选举机制:
| 阶段 | 动作 | 判据 |
|---|---|---|
| 探测 | 各从节点监控主节点心跳 | 连续 3 个周期(300ms)未收到心跳 |
| 投票 | 广播选举请求,携带 (priority, clock_quality, node_id) | 优先级高者胜;同级比时钟质量 |
| 升主 | 胜出者接管编排,但不接管 Grandmaster | 见下方说明 |
| 接管 | 新主节点向所有节点广播角色变更,重建融合缓冲 | 已有从节点保持自治降级状态直到收到新主节点指令 |
| 回切 | 原主节点恢复后不自动回切 | 避免角色频繁抖动(flapping) |
重要细节:新主节点接管的是编排职责,不是时间源。必须由专门的
bmca(Best Master Clock Algorithm)决定 Grandmaster,工程上更稳妥的做法是:规定 Grandmaster 角色固定在网络拓扑中的某个节点上(或专用 TSN 交换机),与"编排主节点"解耦。这样主节点选举不会引起全系统时间基准跳变——时间基准跳变会导致所有节点的时间戳失去可比性,是灾难性的。
5.5 指令幂等
网络重传、DDS 重发、应用层重试都会导致同一指令被收到多次。所有改变物理状态的指令必须幂等:
// 幂等键 = GlobalFrame << 32 | SeqNum
static uint32_t dedup_bitmap[DEDUP_WORDS];   // 1024 位环形位图

bool dedup_seen(uint64_t global_frame, uint32_t seq_num) {
    uint64_t key = (global_frame << 32) | seq_num;
    uint32_t bit = (uint32_t)(key % (DEDUP_WORDS * 32));
    uint32_t word = bit / 32, mask = 1u << (bit % 32);
    if (dedup_bitmap[word] & mask) return true;   // 已执行过
    dedup_bitmap[word] |= mask;
    return false;
}
环形位图 1024 位在典型指令频率下可覆盖数十秒,内存开销 128 字节,几乎没有成本。
六、协同工作流程图
流程中的三个关键设计点:
- 同步先于通信(
PTP→OFFSET→DISC)。时间没收敛就不允许进入 DDS 发现阶段,避免用错误时基产出污染数据。 - 统一时刻启动(
BROADCAST→CAPTURE)。不是"收到就采",而是"在时刻 T 一起采"。这是硬件触发同步的软件侧配合。 - 异常分支闭环(
FAULT→ESTOP→RECOVER→READY)。异常不是终止,而是回到 READY 重新参与协同——但必须经过故障定位,不能直接跳回。
七、实战:高通跃龙IQ-9100 主 + 3 从节点的小型产线组网
7.1 系统组成
| 节点 | 硬件 | 角色 | 主要负载 | 网络 |
|---|---|---|---|---|
| 主节点 | IQ-9100 | Master + Observer Gateway | 编排、融合、NPU 推理、日志汇聚 | 千兆 TSN,192.168.10.10 |
| 从节点 A | QRB5165 | Slave(视觉) | 2×12MP 相机采集、DSP 图像预处理 | 千兆 TSN,192.168.10.21 |
| 从节点 B | IQ-9075 | Slave(机器人) | 6 轴运动学、1kHz 伺服环、安全岛 | 千兆 TSN,192.168.10.22 |
| 从节点 C | QRB5165 | Slave(运动/IO) | CAN-FD 收发、IO 采集、急停联动 | 千兆 TSN,192.168.10.23 |
| 移动单元 | QRB5165 + WiFi6 | Slave(移动) | AGV 位姿与视觉,对接工位 | WiFi6,192.168.20.31 |
| 观察节点 | 任意高通板 | Observer | 全量录包与看板 | 千兆,192.168.10.99 |
物理网络:所有有线节点接入支持 802.1AS 的 TSN 交换机(透明时钟),无线节点经 AP 接入同一网段。
7.2 部署步骤
步骤 1:网络与时间同步(每个节点都做)
# 主节点
sudo tee /etc/systemd/system/ptp4l.service > /dev/null << 'EOF'
[Unit]
Description=LinuxPTP gPTP Grandmaster
After=network-online.target

[Service]
Type=simple
ExecStart=/usr/sbin/ptp4l -i eth0 -f /etc/linuxptp/gPTP.cfg -m
Restart=always
RestartSec=2

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable --now ptp4l phc2sys

# 确认收敛(等 10 秒左右)
pmc -u -b 0 'GET TIME_STATUS_NP' | grep -E 'master_offset|gm_present'
步骤 2:从节点加入(每个从节点)
# 从节点用 slaveOnly 配置
sudo systemctl enable --now ptp4l-slave phc2sys

# 验证:偏移应收敛到 ±1μs 以内
watch -n1 "pmc -u -b 0 'GET TIME_STATUS_NP' | grep master_offset"
步骤 3:DDS 域与 QoS 配置(每个节点)
sudo cp cyclonedds.xml /etc/cyclonedds/cyclonedds.xml
# 写入每个节点自己的 Peer 列表(含自身地址,便于自检)
echo 'export CYCLONEDDS_URI=file:///etc/cyclonedds/cyclonedds.xml' | \
    sudo tee -a /etc/profile.d/ros2-multinode.sh
echo 'export ROS_DOMAIN_ID=42' | sudo tee -a /etc/profile.d/ros2-multinode.sh
echo 'export RMW_IMPLEMENTATION=rmw_cyclonedds_cpp' | sudo tee -a /etc/profile.d/ros2-multinode.sh
步骤 4:验证组网
# 主节点上应能看到全部从节点的话题
ros2 node list
ros2 topic list
ros2 topic hz /camera_a/features        # 应有稳定频率
ros2 topic info /master/control_cmd --verbose   # 检查 QoS 两端匹配

# 检查发现是否用了单播
export CYCLONEDDS_URI=file:///etc/cyclonedds/cyclonedds.xml
ros2 daemon stop && ros2 daemon start   # 重启守护进程让配置生效
步骤 5:实时性加固(从节点 B 的伺服环)
# 内核启动参数:隔离 CPU 核给伺服环
# /boot/grub/grub.cfg 或 UEFI 启动参数追加:
#   isolcpus=6,7 nohz_full=6,7 rcu_nocbs=6,7

# 伺服环进程绑定到隔离核,最高实时优先级
sudo chrt -f 99 taskset -c 6 /usr/bin/motion_control_node
7.3 实测数据
| 指标 | 实测值 | 目标 | 结论 |
|---|---|---|---|
| gPTP 时钟偏移(有线,P99) | 320 ns | ≤ 1 μs | ✅ 余量 3 倍 |
| gPTP 时钟偏移(无线节点,P99) | 38 μs | ≤ 100 μs | ✅ 无线节点不参与硬实时 |
| 控制指令端到端时延(P99) | 246 μs | ≤ 500 μs | ✅ |
| 多源数据帧对齐误差(P99) | 62 μs | ≤ 100 μs | ✅ |
| 协同节拍周期抖动(P99) | 0.8 ms | ≤ 3 ms | ✅ |
| 节点发现与组网收敛 | 1.8 s | ≤ 3 s | ✅ |
| 连续运行 72h 丢帧率 | 0.003% | ≤ 0.1% | ✅ |
| 主节点断电后从节点进入安全状态 | 340 ms | ≤ 500 ms | ✅ |
| 主节点断电后从节点停机 | 0 次 | 0 | ✅ 自治降级生效 |
7.4 验收清单
上线前逐项确认:
- 所有节点
pmc显示gm_present=1且master_offset稳定 - 所有节点时钟源为 gPTP,没有任何节点在跑 ntpd/chronyd 之外的独立时间源
-
ros2 topic info --verbose检查所有跨节点话题的 QoS 两端匹配 -
tc qdisc show确认下行控制队列优先级高于上行数据 - 拔掉主节点网线,验证从节点在 500ms 内进入安全状态且不停机
- 拔掉任一从节点网线,验证主节点能检测并重新规划,其余节点不受影响
- 时钟失锁(
systemctl stop ptp4l)时,系统行为符合预期(告警 + 降级,而非静默错误) - 急停测试:硬线急停和网络急停分别验证,且验证硬线路径不依赖任何软件
- 连续运行 72 小时,检查《系统日志与故障诊断》日志体系中的丢帧、对齐超差、时钟偏移告警
八、故障处置速查表
| 故障场景 | 典型现象 | 定位手段 | 处置 |
|---|---|---|---|
| DDS 发现失败 | ros2 node list 看不到对方节点,但 ping 通 | ros2 topic info --verbose;交换机 IGMP 配置;tcpdump -i eth0 -n udp port 7400 | 改单播发现(3.2 坑二) |
| QoS 不匹配 | 话题存在但收不到数据,无报错 | ros2 topic info /topic --verbose 对比两端 | 对齐 reliability / durability |
| 时钟偏移过大 | master_offset 持续 > 10 μs | ptp4l 日志 -m 输出;ethtool -T eth0 查硬件时间戳支持 | 确认网卡硬件时间戳开启;检查交换机是否透明时钟 |
| 时钟失锁 | pmc 报 FAULTY | journalctl -u ptp4l -n 100 | 检查网络是否中断;确认 Grandmaster 存活 |
| 时间戳不可比 | 融合结果错乱,对齐误差巨大 | 各节点 date + phc_ctl 对比 | 检查是否有节点系统时钟跑偏(NTP 与 PTP 冲突) |
| 上行带宽打满 | 网络丢包、DDS 延迟上升 | iftop;ethtool -S eth0 | grep drop | 检查从节点降采样是否生效 |
| 控制指令超时 | 从节点频繁报 late_cmd | 抓包看 ExecTimeNs 与到达时刻之差 | 检查下行队列优先级;缩短链路跳数 |
| 主节点心跳丢失 | 从节点反复进入 PAUSED | journalctl -u master_heartbeat | 检查主节点负载;确认心跳周期与超时阈值设置 |
| CAN 报文时间戳抖动大 | 设备数据对齐误差大 | candump -t d can0 对比硬件时间戳 | 开启 CAN 硬件时间戳(3.4) |
| 无线节点拖累整体 | 对齐误差告警集中在无线节点 | 按节点统计对齐误差 | 无线节点降级为软同步 + 插值,不参与硬实时协同 |
| 重复执行指令 | 机器人动作重复 | 检查 dedup 统计计数 | 确认幂等位图正常,检查是否重启导致位图清空 |
九、排查工具清单
| 层面 | 工具 | 用途 |
|---|---|---|
| 时间同步 | pmc、phc_ctl、ptp4l -m | 偏移量、失锁、Grandmaster 状态 |
| DDS | ros2 topic hz/delay/info --verbose | 频率、延迟、QoS 匹配 |
| 网络 | tcpdump、iftop、ethtool -S、ss -u | 抓包、带宽、丢包统计 |
| 队列与优先级 | tc qdisc show、tc -s class show | 下行指令优先级是否生效 |
| 实时性 | cyclictest、ftrace、perf sched | 调度延迟、抖动来源 |
| CAN | candump、canbusload、ip -details -statistics link show can0 | 报文、总线负载、错误计数 |
| 内核与驱动 | dmesg -T、journalctl -k | 网卡、PHC、CAN 驱动异常 |
| 进程与资源 | taskset、chrt、cgroup、pidstat | 绑核、优先级、资源占用 |
三个最容易被忽略的检查:
# 1. 确认网卡真的支持硬件时间戳(很多板子默认没开)
ethtool -T eth0 | grep -A5 "Hardware timestamping"

# 2. 确认没有第二个时间源在偷偷跑(NTP 与 PTP 同时改系统时钟会打架)
systemctl status systemd-timesyncd chronyd ntpd 2>/dev/null | grep -E "Active|Unit"

# 3. 确认网卡硬件时间戳在应用层可见(PHC 设备节点存在)
ls -l /dev/ptp*        # 应有 /dev/ptp0
十、小结与系列回顾
10.1 本篇要点
多设备协同开发,技术难点不在写代码,而在架构决策。回顾本篇的五条原则:
- 控制回路留在从节点本地——决定了带宽和实时性的量级。
- 全局单一时间源——同步是一切的地基,先解决时间再谈其他。
- 数据上行降采样、指令下行高优先级——网络资源的分层使用。
- 从节点必须能自治降级——"网络断了产线停"是架构失败。
- 角色可动态选举、时间源不动态——避免全系统时间基准跳变。
技术落地的优先级也很明确:gPTP 同步 → 通信通道选型与 QoS → 时间窗对齐融合 → 协同状态机与故障处置。按这个顺序做,每一步都可验证;跳过第一步直接做后面,一定会在调试阶段付出数倍代价。
10.2 系列回顾
前面我们聊过高通嵌入式Linux开发中的BSP 移植、内核裁剪、I2C/SPI/CAN-FD 驱动、Sensor Hub 低功耗、安全岛、ROS2 移植、容器化部署,到这次深化高通Linux开发系列完结,这条路线是从"把一块板子跑起来"到"把一套系统做稳":
回头看,前几篇做的每一件事,在这篇里都变成了一个"可被编排的能力":DSP 预处理让上行带宽可控,安全岛让从节点能自治降级,TSN 让时间同步可达亚微秒,加固让跨设备指令可信,日志体系让多节点故障可定位。单机做深,多机才能协同。
10.3 下一步可以做什么
如果这套系统要继续演进,三个方向值得投入:
- 确定性再上一个台阶:把 802.1Qbv 时间片调度真正用起来,为控制指令预留专用时隙,把端到端时延从"统计上达标"变成"确定性达标"。
- 协同算法下沉:把多节点融合算法放到主节点的 Hexagon DSP 上,释放 CPU 给更高层的编排逻辑。
- 规模化组网:从 4 节点扩展到 20+ 节点时,DDS 的单播发现会变成 N² 的配置负担,这时需要引入 DDS Router 或 Discovery Server 做分层发现。
参考资料
- Qualcomm 工业开发者文档(IQ 系列平台 BSP、Linux 内核与设备树指南)
- Qualcomm SIL3 功能安全白皮书(安全岛架构与锁步机制)
- IEEE 802.1AS-2020:Timing and Synchronization for Time-Sensitive Applications
- IEEE 802.1Qbv-2015:Enhancements for Scheduled Traffic

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献37条内容

所有评论(0)