深化高通嵌入式Linux开发(4): 系统日志与故障诊断
系列定位:深化高通嵌入式Linux开发 · 面向工业机器人 / 智能相机 / ROS
本篇将主要探讨嵌入式系统日志与故障诊断,工业设备日志采集、过滤、上报与异常定位。
前言:工业设备的日志体系,和云端/消费级完全不是一回事
如果你是从互联网后端转过来的,第一反应可能是"日志嘛,ELK 一套就完了"。但把同一套思路搬到工业现场,几乎必定翻车。
原因在于工业边缘设备有四个绕不开的约束:
| 约束 | 具体表现 | 对日志体系的硬性要求 |
|---|---|---|
| 无人值守 | 设备装在产线夹层、机械臂基座、AGV 内部,现场没有工程师 | 日志必须能远程取回,且故障现场必须自持——断网时也得留下证据 |
| 故障复现成本极高 | 停机按分钟计损失,客户不允许"你再来一次我看看" | 必须一次抓全,尤其是崩溃瞬间的现场 |
| 存储介质是 eMMC/UFS | 写寿命有限(TLC 约 1~3K P/E cycle),且工业设备要跑 5~10 年 | 日志不能无限落盘,必须分级 + 配额 + 轮转 |
| 异构多核 | 高通平台除 APSS 外还有 ADSP/CDSP/SLPI/AOP/安全岛,日志分散在 6+ 个核 | 必须有跨核汇聚能力,这是高通平台区别于普通 ARM Linux 的核心难点 |
一句话总结目标:在有限存储和不可靠网络下,把"事故现场"完整地保留下来,并且能在事后 5 分钟内定位到根因。
1. 系统总体架构
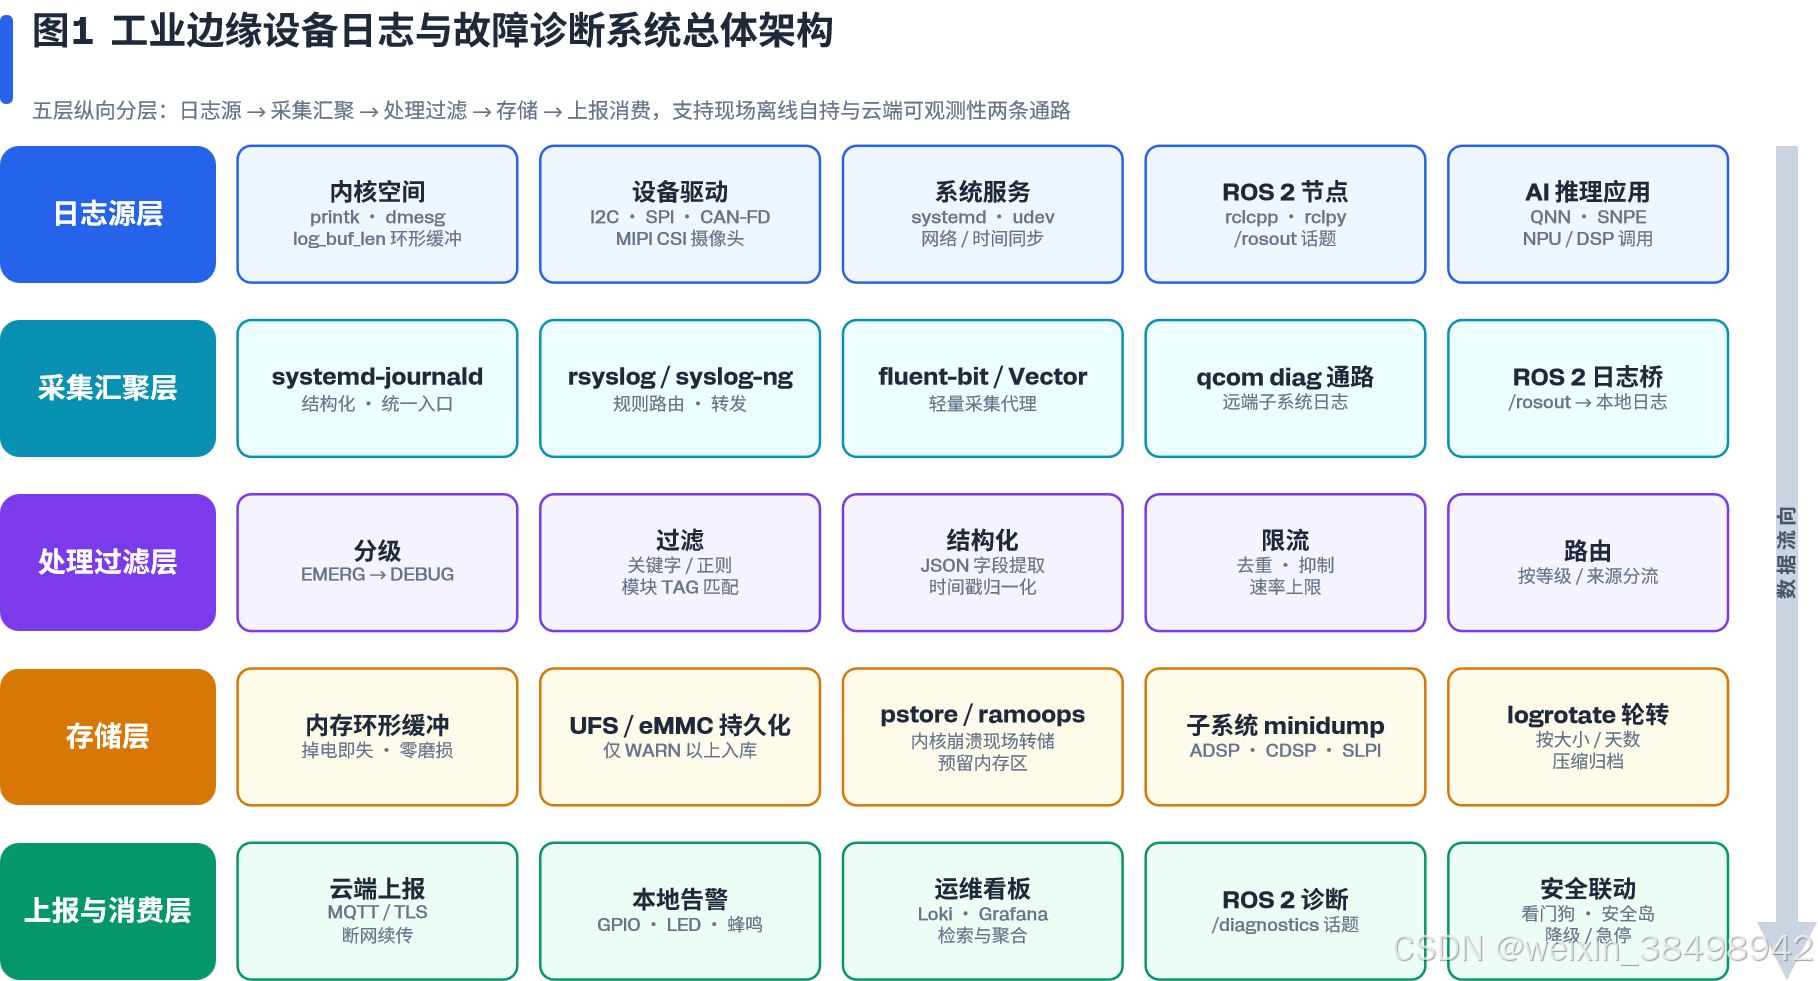
先看全局。图 1 给出了一套经过工业现场验证的五层日志与故障诊断架构。
逐层说明
① 日志源层——先把"日志从哪来"数清楚,这一步漏了就是永久盲区。
内核空间:printk 环形缓冲、dmesg、log_buf_len容量配置设备驱动:I2C/SPI/CAN-FD/MIPI CSI 的驱动级报错,工业设备 70% 的现场故障在这一层露出第一手证据系统服务:systemd、udev、网络与时间同步(时间戳不准 = 多源日志无法对齐)ROS 2 节点:rclcpp/rclpy 日志与/rosout话题AI 推理应用:QNN/SNPE 侧日志与 NPU/DSP 调用异常
② 采集汇聚层——统一入口,避免每个应用各写各的日志文件。
③ 处理过滤层——这是省钱省寿命的一层,也是最多人跳过的一层。
④ 存储层——内存优先、落盘分级、崩溃转储单独预留。
⑤ 上报与消费层——云端可观测性 + 本地告警/安全联动,两条通路互为备份。断网时本地告警必须仍能动作,这是功能安全的基本要求(呼应第 6 篇的看门狗与安全岛)。
2. 高通平台的日志源全景
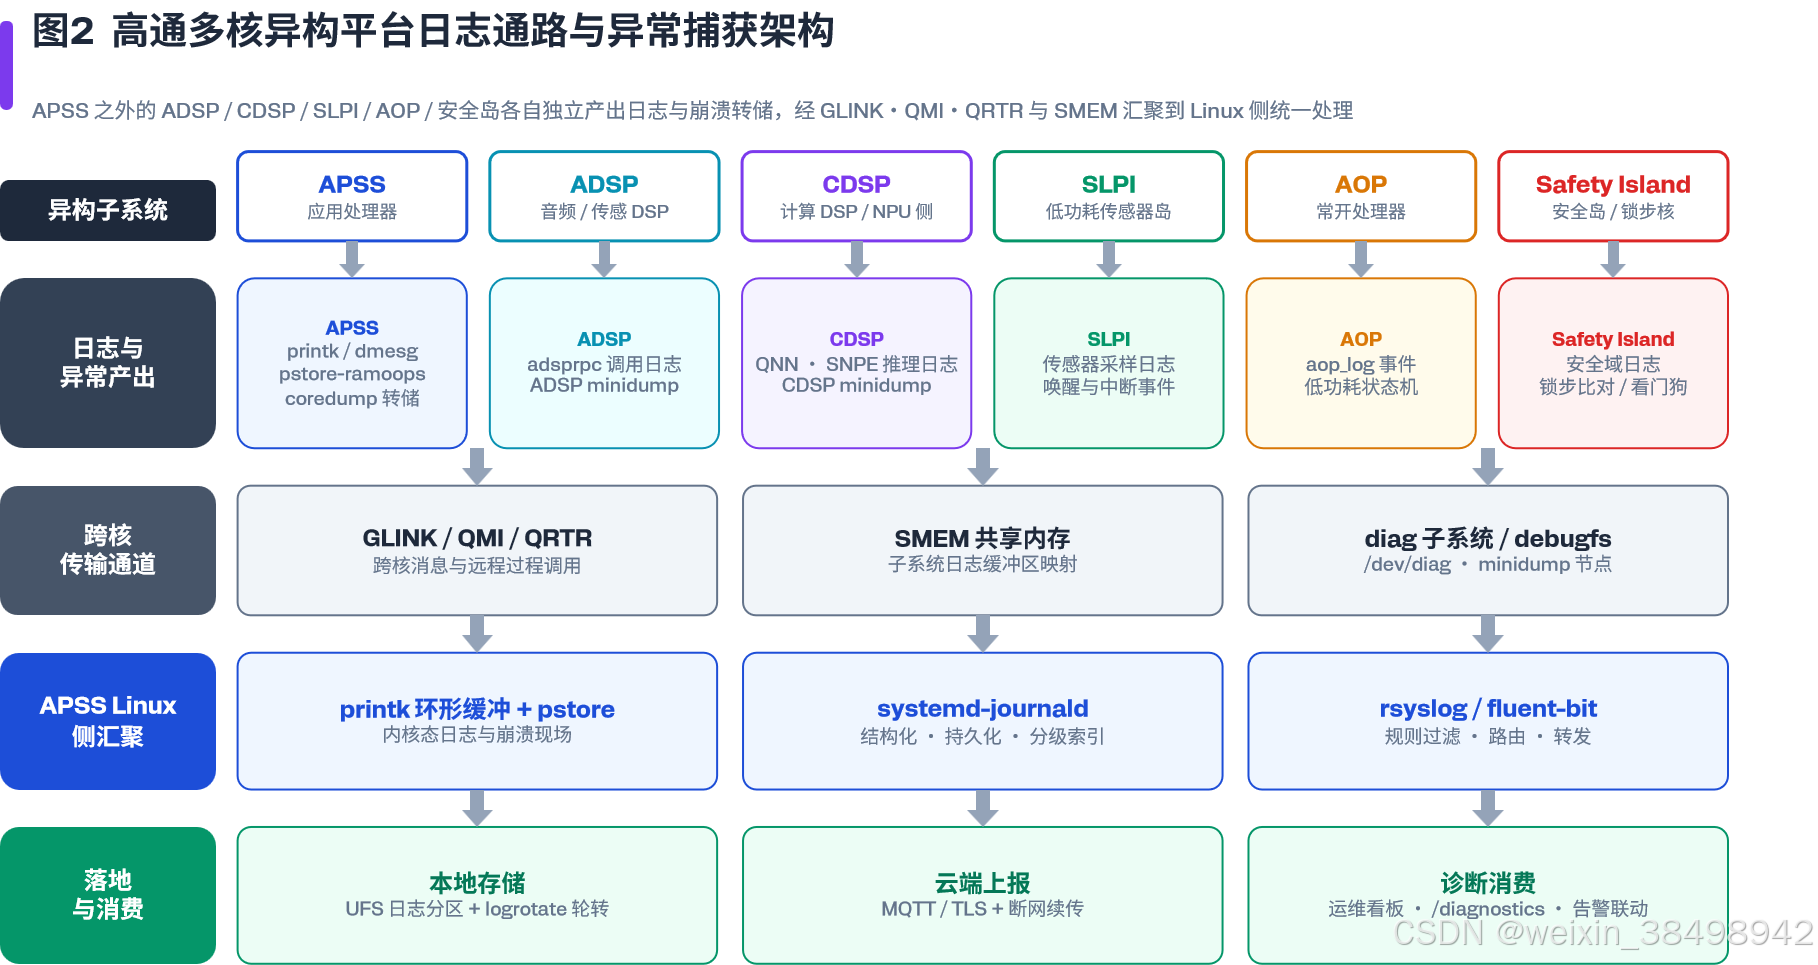
图 1 是通用工业架构,但高通平台真正的坑在图 2:APSS 之外的子系统,日志根本不走 Linux 的 printk。
2.1 各子系统的日志通路对照
| 子系统 | 典型用途 | 日志/异常产出 | APSS 侧获取手段 |
|---|---|---|---|
| APSS | 应用处理器(Kryo 大小核) | printk、dmesg、coredump | dmesg、/sys/fs/pstore、coredumpctl |
| ADSP | 音频、传感器融合(Hexagon) | adsprpc 调用日志、ADSP minidump | minidump 节点、subsys-restart 内核日志 |
| CDSP | 计算 DSP,QNN 推理后端(Hexagon) | QNN/SNPE 推理日志、CDSP minidump | FastRPC 报错、/dev/adsprpc-smd、QNN 日志级别 |
| SLPI | 低功耗传感器岛(Hexagon) | 采样日志、唤醒与中断事件 | 通常只在崩溃时经 minidump 可见 |
| AOP | 常开处理器(Cortex-M) | aop_log、低功耗状态机事件 | debugfs aop 节点、minidump |
| Safety Island | 安全岛,锁步核(IQ 系列) | 安全域日志、锁步比对/看门狗事件 | 安全域专用通路 + 内核告警 |
⚠️ 关键认知:ADSP/CDSP/SLPI 都是 Hexagon 核,跑的是 QuRT 实时系统,没有 Linux 的 printk 机制。它们的日志要靠 GLINK/QMI/QRTR 消息通道或 SMEM 共享内存搬过来。这也解释了为什么很多团队"NPU 一崩就什么日志都没有"——你根本没接上那条通路。
2.2 必须认识的几个内核日志特征串
当远端子系统崩溃时,APSS 侧内核会打印类似下面的特征行,这是你判断"是不是 DSP 挂了"的第一线索:
[  412.338120] subsys-restart: subsystem_restart_dev(): Restart sequence requested for adsp, restart_level = SYSTEM.
[  412.350774] subsys-restart: subsystem_shutdown(): [adsp]: Shutting down
[  412.512003] subsys-restart: subsystem_powerup(): [adsp]: Powering up
[  412.671290] subsys-restart: subsystem_restart_dev(): [adsp]: Brought out of reset
字段名随内核版本略有差异(
subsys-restart/subsys_notif/subsystem_restart),但形态稳定。判读要点:
restart_level = SYSTEM→ 整机被拉复位,属于严重故障restart_level = RELATED→ 仅重启该子系统,Linux 侧通常表现为应用报错- 出现
Powering up但没有Brought out of reset→ 子系统起不来,多半是固件加载问题
3. 采集落地:从内核到应用
3.1 内核日志:先把环形缓冲调够
工业现场最常见的低级失误,是崩溃日志被后续日志冲掉。默认 log_buf_len 在 32~128 KiB 量级,机器人高频控制场景下几秒钟就刷满。
# 开机参数(推荐写进 bootargs 或 device tree chosen/bootargs)
log_buf_len=4M printk.time=1

# 运行期确认
cat /proc/sys/kernel/printk        # 形如: 4  4  1  7
#  console_loglevel / default_message_loglevel / minimum / default_console

# 降低控制台刷屏(现场设备通常无串口,控制台输出纯属浪费)
echo "4 4 1 7" > /proc/sys/kernel/printk

# 打开内核 printk 限流,防止单条错误刷爆缓冲
sysctl -w kernel.printk_ratelimit=5
sysctl -w kernel.printk_ratelimit_burst=10
跟随观察(调试期用,生产不建议常开):
dmesg -T -w                       # -T 转可读时间戳,-w 持续跟随
dmesg -T -l err,crit,alert,emerg  # 只看错误级别以上
3.2 崩溃转储:pstore / ramoops
这是整篇文章最重要的一节。设备意外复位后,内存里的东西全没了——除非你提前预留了一块"重启不清零"的内存。
Device Tree 配置(高通平台放在 reserved-memory 下):
/ {
    reserved-memory {
        #address-cells = <2>;
        #size-cells = <2>;
        ranges;

        ramoops: ramoops@b0000000 {
            compatible = "ramoops";
            reg = <0x0 0xb0000000 0x0 0x00100000>;  /* 预留 1 MiB */

            record-size  = <0x00020000>;   /* 128 KiB:内核 oops/panic 记录 */
            console-size = <0x00040000>;   /* 256 KiB:控制台最后输出 */
            pmsg-size    = <0x00020000>;   /* 128 KiB:用户态 pmsg 通道 */
            ftrace-size  = <0x00020000>;   /* 128 KiB:ftrace 现场 */

            max-reason   = <4>;            /* PANIC | OOPS | EMERG | SHUTDOWN */
        };
    };
};
内核配置:
CONFIG_PSTORE=y
CONFIG_PSTORE_DEFLATE_COMPRESS=y   # 压缩后同样容量能存更多现场
CONFIG_PSTORE_RAM=y
CONFIG_PSTORE_CONSOLE=y
CONFIG_PSTORE_PMSG=y
CONFIG_PSTORE_FTRACE=y
读取现场:
mount -t pstore pstore /sys/fs/pstore     # systemd 通常已自动挂载
ls -l /sys/fs/pstore/
# -r--r--r-- dmesg-ramoops-0      ← panic 时的内核日志(最有价值)
# -r--r--r-- console-ramoops-0    ← 控制台最后输出,含崩溃前的刷屏
# -r--r--r-- pmsg-ramoops-0       ← 用户态主动写入的上下文
# -r--r--r-- ftrace-ramoops-0     ← ftrace 缓冲区快照
两个必须知道的坑:
- ramoops 只在"热复位"下存活。 PANIC → 内核 reboot(warm reset)路径内存不掉电,可保留;但看门狗硬复位、掉电、长按电源键属于冷复位,内容会丢。这是功能安全场景下必须与硬件看门狗策略一起设计的原因(见第 6 篇)。
- 预留地址要和 bootloader 的内存映射对齐。 只改 DTS 不改 XBL/ABL 侧的内存划分,会出现"内核以为这块是自己的、bootloader 以为可以随便用",表现为随机性数据损坏——非常难查。
用户态补充上下文(崩溃前把关键状态写进 pmsg):
/* 机器人控制节点:每次运动指令下发前记录上下文 */
#include <linux/pstore_ram.h>   /* 或直接写 /dev/pmsg0 */
int fd = open("/dev/pmsg0", O_WRONLY);
dprintf(fd, "cmd=%s joint=%d target=%.4f seq=%u\n",
        cmd_name, joint_id, target_rad, seq++);
close(fd);
这条通道极便宜(一次 write 系统调用),却能在内核 panic 时把"最后一个动作是什么"完整带出来。强烈建议在机器人运动控制、相机触发这类关键路径上默认开启。
3.3 用户态统一入口:systemd-journald
# /etc/systemd/journald.conf
[Journal]
Storage=persistent
Compress=yes

# —— 容量配额:保护 UFS 寿命的核心 ——
SystemMaxUse=64M           # 持久化分区总上限
SystemMaxFileSize=8M
RuntimeMaxUse=16M          # /run 下的内存日志(掉电即失)
MaxRetentionSec=7day

# —— 只有 WARN 及以上才落盘,INFO/DEBUG 留在内存 ——
MaxLevelStore=warning
MaxLevelSyslog=warning

# —— 日志风暴保护 ——
RateLimitIntervalSec=30s
RateLimitBurst=2000

ForwardToSyslog=no         # 由 rsyslog 主动拉取,避免双写放大
MaxLevelStore=warning 这一行的价值被严重低估:它让"全量打日志便于调试"和"不能写坏 UFS"这两个矛盾的需求同时成立——调试期照常打 INFO/DEBUG,它们进内存环形缓冲可以正常 journalctl 查看,只是不落盘。
常用检索:
journalctl -b                       # 本次启动
journalctl -b -1                    # 上一次启动(复位的上一次!)
journalctl -b -1 -p err             # 上次启动的错误及以上
journalctl -k -b -1                 # 上次启动的内核日志
journalctl -u robot-control.service --since "10 min ago"
journalctl -p warning --since today -o json | jq -r '.MESSAGE'
journalctl --disk-usage
应用崩溃转储:
coredumpctl list                    # 列出所有应用 core dump
coredumpctl info 12345              # 单个进程详情
coredumpctl debug 12345             # 直接进 gdb 带符号调试
ls /var/lib/systemd/coredump/
3.4 规则路由:rsyslog
journald 负责"收",rsyslog 负责"分流"。下面这套配置把日志按等级和来源拆成不同文件,同时把严重日志直接推向 MQTT 桥:
# /etc/rsyslog.d/10-industrial.conf
module(load="imjournal" StateFile="imjournal.state")
module(load="omfwd")

template(name="jsonLine" type="string"
  string="{\"ts\":\"%timereported:::date-rfc3339%\",\"host\":\"%hostname%\",\
\"svc\":\"%programname%\",\"sev\":\"%syslogseverity%\",\"pid\":\"%procid%\",\
\"msg\":%msg:json%}\n")
注意配置里不能有反斜杠换行以外的东西,上面仅为排版折行。
%msg:json%需要 rsyslog ≥ 8.1901,它会自动做 JSON 转义——手工拼 JSON 是注入漏洞的常见来源。
# ① CRIT 及以上:高优先级,立即上报云端
if ($syslogseverity <= 3) then {
    action(type="omfile" file="/var/log/industrial/critical.log" template="jsonLine")
    action(type="omfwd" target="127.0.0.1" port="5140"
           protocol="tcp" template="jsonLine" action.resumeRetryCount="-1")
}

# ② 总线类故障:单独归档,便于统计"哪条总线最容易出问题"
if ($programname startswith "i2c" or $programname contains "can" or
    $programname contains "spi") then {
    action(type="omfile" file="/var/log/industrial/bus.log" template="jsonLine")
}

# ③ 子系统重启:单独立项,这是高通平台的高频故障
if ($msg contains "subsys-restart" or $msg contains "subsystem_restart") then {
    action(type="omfile" file="/var/log/industrial/subsys.log" template="jsonLine")
    action(type="omfwd" target="127.0.0.1" port="5140"
           protocol="tcp" template="jsonLine")
}
3.5 ROS 2 日志接入
ROS 2 用 spdlog 作为后端,默认写到 ~/.ros/log/——而 ~ 往往在只读或小容量的 rootfs 上,这是第一个要改的:
# 把 ROS 日志重定向到大容量可写分区
export ROS_LOG_DIR=/var/log/ros
export RCUTILS_LOGGING_USE_STDOUT=0      # 关掉 stdout 重复输出
export RCUTILS_LOGGING_BUFFERED_STREAM=1 # 缓冲写入,降低 I/O 次数
export RCUTILS_COLORIZED_OUTPUT=0        # 落盘日志去 ANSI 色码,否则检索困难
export RCUTILS_CONSOLE_OUTPUT_FORMAT='[{severity}] [{time}] [{name}]: {message}'
代码侧:优先用带节流/条件的宏,而不是裸 INFO
#include "rclcpp/rclcpp.hpp"

class ControlNode : public rclcpp::Node {
public:
  ControlNode() : Node("robot_control") {
    // 高频循环里绝不能用裸 RCLCPP_INFO —— 1000 Hz 控制周期会瞬间刷爆磁盘
    RCLCPP_INFO_THROTTLE(get_logger(), *get_clock(), 5000,
                         "control loop alive, cycle=%ld us", cycle_us_);

    // 只在状态变化时打印
    RCLCPP_WARN_SKIPFIRST_THROTTLE(get_logger(), *get_clock(), 1000,
                                   "joint %d following error %.3f rad",
                                   joint_id, err);

    // 致命错误:FATAL 会直接进 /rosout,务必留给真正需要停机的事件
    if (std::abs(err) > kEmergencyThreshold) {
      RCLCPP_FATAL(get_logger(), "joint %d exceeded limit, requesting e-stop", joint_id);
    }
  }
private:
  long cycle_us_{0};
};
_THROTTLE(按时间节流)、_ONCE(只打一次)、_SKIPFIRST(跳过首次)、_STREAM(流式)四组宏是 ROS 2 日志体系的精髓。工业机器人场景下,裸RCLCPP_INFO出现在控制循环里应视为代码缺陷。
运行期调整等级(不用重新编译):
ros2 run pkg node --ros-args --log-level debug
ros2 launch bringup robot.launch.py --ros-args --log-level robot_control:=debug
ros2 topic echo /rosout --field msg
诊断话题(对接图 1 的"ROS 2 诊断"消费端):
#include "diagnostic_updater/diagnostic_updater.hpp"

diagnostic_updater::Updater updater(this);
updater.setHardwareID("iq9100-cam0");

updater.add("can_bus", [this](diagnostic_updater::DiagnosticStatusWrapper &s) {
  if (bus_off_count_ > 0) {
    s.summary(diagnostic_msgs::msg::DiagnosticStatus::WARN,
              "CAN bus-off recovered " + std::to_string(bus_off_count_) + " times");
    s.add("bus_off_count", bus_off_count_);
    s.add("last_recovery_ms", last_recovery_ms_);
  } else {
    s.summary(diagnostic_msgs::msg::DiagnosticStatus::OK, "CAN bus healthy");
  }
});
4. 分级、过滤与限流:日志不能自己变成故障源
4.1 等级映射
| syslog | 数值 | ROS 2 | 语义 | 落盘策略 |
|---|---|---|---|---|
emerg | 0 | — | 系统不可用 | ✅ 立即落盘 + 立即上报 |
alert | 1 | FATAL | 必须立即处理(如急停触发) | ✅ 立即落盘 + 立即上报 |
crit | 2 | ERROR | 严重故障(子系统重启、看门狗触发) | ✅ 立即落盘 + 立即上报 |
err | 3 | ERROR | 一般错误(单次通信失败) | ✅ 落盘(聚合上报) |
warning | 4 | WARN | 需要关注(重试成功、降级运行) | ✅ 落盘(聚合上报) |
notice | 5 | INFO | 正常但重要(状态切换) | ⚠️ 内存缓冲 |
info | 6 | INFO | 常规运行信息 | ❌ 仅内存 |
debug | 7 | DEBUG | 调试细节 | ❌ 仅内存 + 按需开关 |
4.2 日志风暴:工业场景的头号杀手
算一笔账:一路 I2C 传感器在 1 kHz 采样下持续 NAK,如果驱动每帧打一条错误:
1000 条/秒 × 200 字节 = 200 KB/秒
              = 17 GB/天
一块 32 GB 的 eMMC,两天就被写穿,而且真正的故障线索被淹没在噪声里。
四道防线,缺一不可:
# 防线 1:内核层限流(内核 printk 自带)
sysctl -w kernel.printk_ratelimit=5
sysctl -w kernel.printk_ratelimit_burst=10

# 防线 2:journald 层限流(见 3.3 的 RateLimitIntervalSec/Burst)
# 防线 3:rsyslog 层聚合——用 action.resumeRetryCount 和磁盘队列限流,
#         配合 `$msg` 去重规则(同一 svc+msg 在窗口内只落一条)
# 防线 4:应用层令牌桶(驱动/应用自己实现)
应用层令牌桶的极简实现(放进公共库,全项目复用):
/* log_limiter.c —— 同一 key 的日志每 interval_ms 最多输出 burst 条 */
typedef struct { uint64_t window_start_ms; int count; } rl_slot_t;

static rl_slot_t slots[64];   /* key 做简单哈希 */

bool log_allow(const char *key, int burst, int interval_ms) {
    uint32_t h = fnv1a(key) & 63;
    rl_slot_t *s = &slots[h];
    uint64_t now = now_ms();

    if (now - s->window_start_ms >= (uint64_t)interval_ms) {
        s->window_start_ms = now;
        s->count = 0;
    }
    if (s->count >= burst) return false;
    s->count++;
    return true;
}
配套的"被抑制条数统计"很关键——上游必须知道发生了什么:
static unsigned long suppressed;

void log_err_throttled(const char *key, const char *fmt, ...) {
    if (log_allow(key, 5, 1000)) {
        if (suppressed) {
            real_log("... %lu similar messages suppressed in last window", suppressed);
            suppressed = 0;
        }
        real_log(fmt, ...);
    } else {
        suppressed++;
    }
}
5. 存储策略:为 UFS 寿命做设计
5.1 分区规划建议
| 分区/路径 | 介质 | 容量建议 | 内容 | 掉电存活 |
|---|---|---|---|---|
/run/log/journal | RAM | 16 MB | 全量日志(含 INFO/DEBUG) | ❌ |
/var/log/journal | UFS | 64 MB | WARN 及以上 | ✅ |
/var/log/industrial/ | UFS | 128 MB | 结构化分流日志 | ✅ |
reserved-memory ramoops | RAM(不掉电区) | 1 MB | 崩溃现场 | ⚠️ 仅热复位 |
| 崩溃转储分区 | UFS 独立分区 | 512 MB | minidump / coredump | ✅ |
不要和 rootfs 共用分区。 日志写满导致 rootfs 无法写入,是现场"设备变砖"的经典成因。独立分区 + 配额,让日志写满只影响日志。
5.2 轮转配置
# /etc/logrotate.d/industrial
/var/log/industrial/*.log {
    daily
    rotate 14                # 保留 14 天
    size 16M                 # 或者单文件到 16 MB 就切
    compress
    delaycompress
    missingok                # 文件不存在不报错(避免日志系统自己产生日志)
    notifempty
    copytruncate             # 不重启写入进程
    maxage 30
    create 0640 root adm
}
5.3 写在落盘之前:脱敏
工业现场的日志里经常夹带不该出厂的数据:产线节拍参数、客户工件尺寸、相机图像元数据里的车牌/人脸。落盘和上报前必须过一遍脱敏:
import re
PATTERNS = [
    (re.compile(r'\b\d{17}[\dXx]\b'), '[ID_CARD]'),          # 身份证
    (re.compile(r'\b1[3-9]\d{9}\b'), '[PHONE]'),              # 手机号
    (re.compile(r'(?i)(token|password|secret)=\S+'), r'\1=[REDACTED]'),
    (re.compile(r'\b(?:\d{1,3}\.){3}\d{1,3}\b'), '[IP]'),     # 按合规要求决定
]
6. 上报:从设备到云端
6.1 分级上报策略
工业现场的流量是要花钱的(4G/5G 物联网卡),而且产线网络经常被隔离。上报必须"吝啬":
| 等级 | 上报时机 | 传输内容 | QoS |
|---|---|---|---|
| FATAL/CRIT | 立即(< 1 s) | 完整日志 + 崩溃转储摘要 | QoS 1 |
| ERROR/WARN | 聚合,30 s 一批 | 结构化字段 + 去重计数 | QoS 1 |
| INFO/DEBUG | 默认不上报 | 仅在远程诊断会话中按需拉取 | QoS 0 |
| 心跳 | 60 s | 设备健康度摘要(CPU/内存/温度/总线错误计数) | QoS 0 |
# MQTT 主题设计
factory/{line_id}/{device_id}/log/{severity}
factory/{line_id}/{device_id}/health
factory/{line_id}/{device_id}/cmd        # 下行:请求拉取详细日志
6.2 断网续传
现场网络中断是常态,不是异常。上报代理必须是磁盘队列 + 有界缓存:
# 上报代理的队列上限策略(示意)
MAX_QUEUE_BYTES = 256 * 1024 * 1024      # 磁盘队列上限 256 MB
POLICY = "drop_oldest"                    # 超限丢最旧,绝不让日志撑爆存储

def enqueue(record: dict):
    if disk_queue.size() + len(serialize(record)) > MAX_QUEUE_BYTES:
        disk_queue.drop_oldest()          # 并累加 dropped_counter
        metrics.inc("log_dropped")
    disk_queue.push(serialize(record))

# 重连后按严重级别优先补传
def drain():
    for rec in disk_queue.sorted_by(severity_rank, then=timestamp):
        publish_with_retry(rec)
关键点:超限时必须丢最旧的,并在心跳里上报 log_dropped 计数。一个悄悄丢日志的上报代理比没有上报更危险——运维会以为"没告警就是没问题"。
6.3 压缩
日志是文本,压缩收益极大:
# 典型压缩比:纯文本日志 zstd -3 约 8~15x
zstd -3 -T4 critical.log -o critical.log.zst
按 8 倍压缩比算,上面那份 17 GB/天的噪声日志压完还有 2 GB/天——所以压缩不能替代限流,只能锦上添花。
7. 故障诊断流程
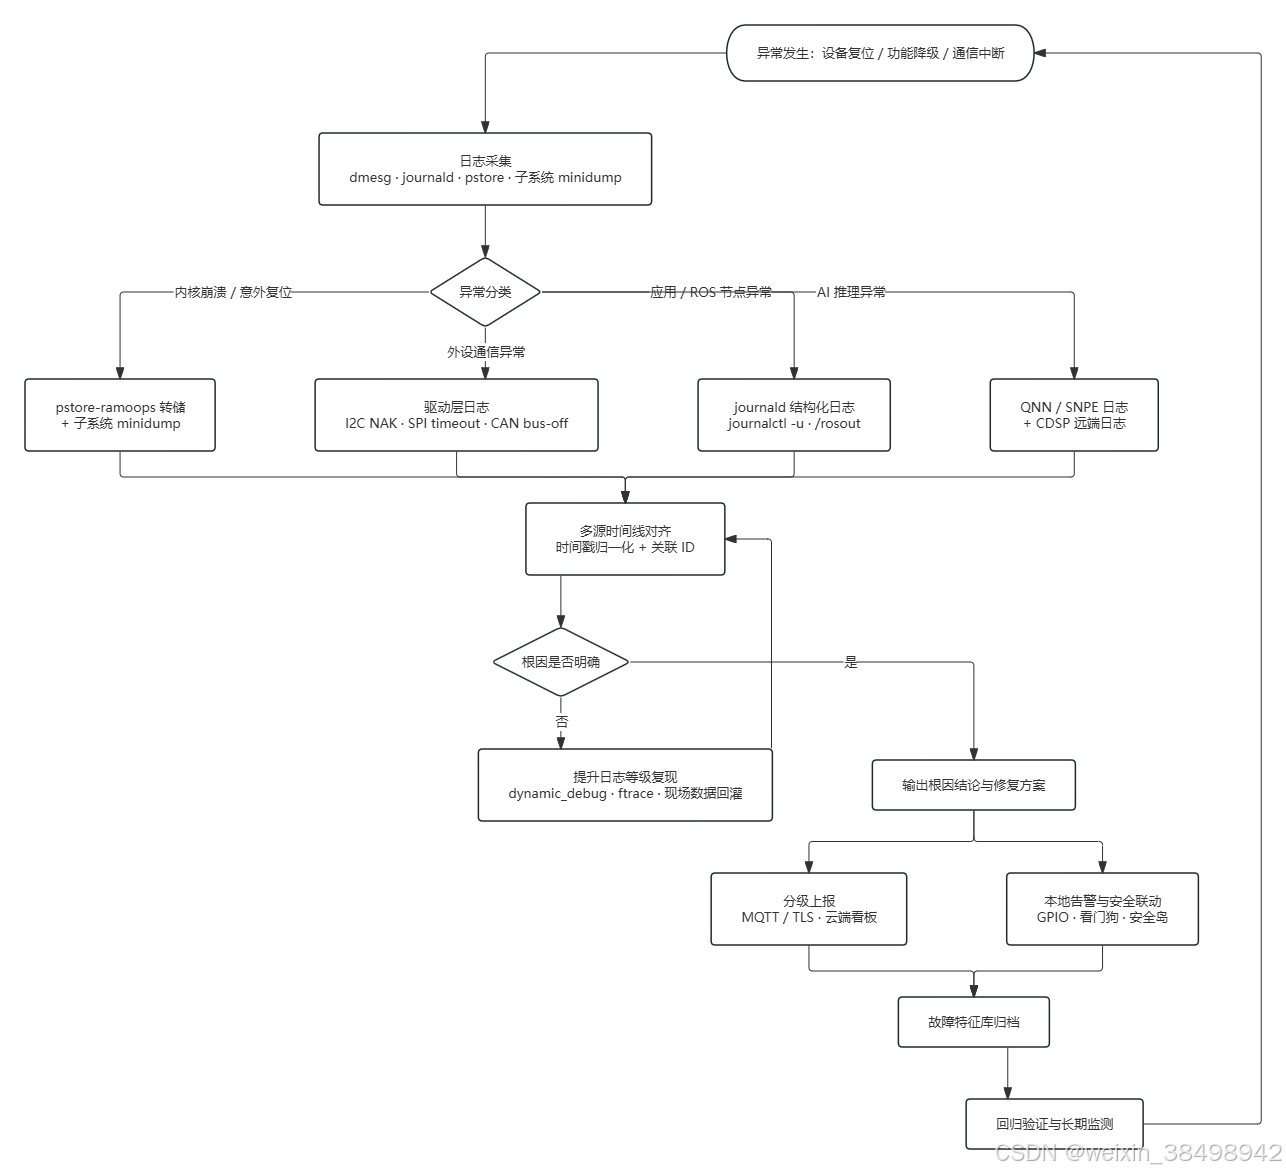
采集和存储就绪后,真正的工作是"出问题时怎么查"。图 3 是推荐的标准诊断流程——注意它是一个闭环,最后的复盘会沉淀成故障特征库,用于快速回归。
7.1 时间线对齐:多源日志的前提
跨子系统日志能对齐,前提是时间戳同源。工业设备的常见坑:
# 1. 确认时间同步(无 RTC 的设备开机后时间会跳变,直接把日志搞乱)
timedatectl status
systemctl status systemd-timesyncd

# 2. 确认内核日志用的是同一个时钟源
cat /sys/devices/system/clocksource/clocksource0/current_clocksource
dmesg -T | head -3          # -T 会把 monotonic 转成 wall clock

# 3. 给跨模块事件加统一的关联 ID(trace id),比纯时间戳可靠得多
强烈建议在机器人控制指令、相机触发、CAN 报文这三条关键路径上带一个全局递增的 seq,并在日志里输出。事后按 seq 对齐,比按时间戳对齐稳健一个量级——尤其是存在 DDS 传输抖动和 DSP 异步的场景。
8. 四类典型故障的实战定位
8.1 内核崩溃 / 意外复位
现象:设备莫名重启,uptime 很短,无任何应用侧报错。
# ① 先确认是"内核主动重启"还是"看门狗/掉电硬复位"
journalctl -b -1 -k | tail -50
last -x reboot | head -5

# ② 读崩溃现场
cat /sys/fs/pstore/console-ramoops-0 | tail -100
cat /sys/fs/pstore/dmesg-ramoops-0

# ③ 符号化(需要与设备上内核完全一致的 vmlinux)
./scripts/faddr2line vmlinux drv_my_sensor_probe+0x1a4/0x320
aarch64-linux-gnu-addr2line -e vmlinux -f -i ffffffc0104a3b2c
判读要点:
console-ramoops-0里出现Kernel panic - not syncing:→ 拿后面的PC is at ...地址去符号化- 出现
Unable to handle kernel NULL pointer dereference→ 空指针,看PC is at与调用栈 - pstore 文件为空 ≠ 没有崩溃:很可能发生了冷复位(掉电/看门狗硬复位),内存内容已丢失。此时只能依赖串口抓取或外置调试器(JTAG/Coresight)。这也是为什么量产设备强烈建议保留一个串口 header——它是最后的手段。
- 若日志停在子系统重启序列中间 → 优先怀疑 ADSP/CDSP 固件加载失败,去查
subsys.log
8.2 外设总线异常(I2C / SPI / CAN-FD)
I2C —— 最常见,也最容易定位
# 典型错误串
dmesg | grep -iE "i2c|geni"
# [  88.221] i2c-qcom-geni 984000.i2c: Transfer timed out
# [  88.535] i2c i2c-4: sendbytes: NAK bailout.

# 复现与确认
i2cdetect -y 4                       # 扫描总线上有哪些地址
i2cget -y 4 0x50 0x00 w
i2ctransfer -y 4 w2@0x50 0x00 0x00 r4
| 错误串 | 含义 | 根因方向 |
|---|---|---|
NAK bailout | 从设备没应答 | 器件未上电 / 地址错 / 器件忙 |
Transfer timed out | 时钟被拉低不释放 | 从设备死锁(需硬件复位)/ 上拉电阻不足 / 走线过长 |
Bus arbitration lost | 多主竞争 | 总线上有第二个 master |
SPI(Qualcomm QUPv3 / GENI)
dmesg | grep -iE "spi-geni|qup"
# spi-geni-qcom a80000.spi: DMA transfer failed
# 排查方向:DMA 通道冲突、片选时序、CS 建立/保持时间
CAN-FD
# 状态与错误计数器——CAN 排查的第一站
ip -details -statistics link show can0
# 关注:state、berr-counter、restart-ms、bus-off 计数

# 典型内核日志
dmesg | grep -i can
# [ 231.117] can: can0: bus-off
# [ 231.118] can: can0: bus error: arbitration lost
# 打开自动恢复(bus-off 后 100 ms 自动重启控制器)
ip link set can0 down
ip link set can0 type can bitrate 1000000 dbitrate 5000000 fd on restart-ms 100
ip link set can0 up

# 抓错误帧
candump -e can0
判读:bus-off 频繁出现 → 检查终端电阻(CAN 必须 120Ω × 2)、线缆屏蔽、波特率与采样点是否与对端一致。注意 CAN-FD 的仲裁段与数据段波特率是分开的,只对一半是最常见的低级错误。
8.3 NPU / DSP 推理报错
这是高通平台最"玄学"的一类,因为它跨了 APSS → CDSP 两个世界。
# ① 先看子系统有没有重启过
journalctl -k -b | grep -iE "subsys|cdsp|adsp|fastrpc"
# subsys-restart: subsystem_restart_dev(): [cdsp]: Brought out of reset  ← 崩过

# ② FastRPC 层报错
dmesg | grep -i adsprpc
# adsprpc: fastrpc_init_create_process: Error 0x80000404

# ③ 应用侧打开 QNN 日志(QNN SDK)
export QNN_LOG_LEVEL=verbose
export ADSP_LIBRARY_PATH="/usr/lib/rfsa/adsp;/usr/lib/dsp"

# ④ 提高内核侧 FastRPC 日志
echo 'module adsprpc +p' > /sys/kernel/debug/dynamic_debug/control
排查路径:
- 模型本身在 PC 侧仿真能否跑通(排除模型/量化问题)
- CDSP 固件版本与 QNN SDK 版本是否匹配(版本错配是最常见根因)
- DSP 侧内存是否被占满(连续推理 + 高分辨率输入容易 OOM)
- 是否发生了
subsys-restart—— 若是,去取 CDSP minidump - 温度墙:工业现场高温环境下 DSP 降频/复位,用
cat /sys/class/thermal/thermal_zone*/temp排查
8.4 ROS 2 节点异常与实时性抖动
# 节点为什么退出?
journalctl -u robot-control.service -b --no-pager | tail -80
systemctl show robot-control.service -p Restart -p NRestarts -p ExecMainStatus

# 是崩溃还是被 kill(OOM)?
coredumpctl list
dmesg | grep -iE "oom|killed process"

# DDS 层问题(节点互相看不见 / 通信超时)——单独打开 RMW 日志
export RMW_IMPLEMENTATION=rmw_cyclonedds_cpp
export CYCLONEDDS_URI=file:///etc/cyclonedds.xml   # 内含 <Verbosity> 配置

# 整机诊断
ros2 doctor --report
ros2 topic hz /joint_states
ros2 topic echo /diagnostics
实时性抖动的日志定位思路:抖动本身不会打日志,要靠主动埋点。
// 在控制循环里统计周期抖动,超阈值才打印(避免自身引入抖动)
auto now = std::chrono::steady_clock::now();
auto dt_us = std::chrono::duration_cast<std::chrono::microseconds>(now - last_).count();
if (dt_us > kPeriodUs * 3) {
    RCLCPP_WARN_THROTTLE(get_logger(), *get_clock(), 500,
        "control loop jitter: %ld us (target %ld us, overrun #%u)",
        dt_us, kPeriodUs, ++overrun_count_);
}
配合 ftrace 抓调度延迟:
# 抓取 sched 唤醒延迟
cd /sys/kernel/debug/tracing
echo 0 > tracing_on
echo 1 > events/sched/sched_wakeup/enable
echo 1 > events/sched/sched_switch/enable
echo 1 > tracing_on
sleep 5
echo 0 > tracing_on
cat trace | head -100
9. 落地清单(Checklist)
上线前逐项核对采集:
-
log_buf_len≥ 2 M,printk.time=1已开启 - pstore/ramoops 已配置,且实测验证过能读到 panic 日志(人为触发一次
echo c > /proc/sysrq-trigger) - ramoops 预留地址与 bootloader 内存映射一致
- 远端子系统(ADSP/CDSP/SLPI)日志通路已打通并有实际日志验证
- ROS 2
ROS_LOG_DIR已改到大容量分区 -
RCUTILS_COLORIZED_OUTPUT=0,避免落盘日志带 ANSI 码
过滤与存储
- journald
MaxLevelStore=warning,容量配额已设 - rsyslog 按等级/来源分流规则已配
- 日志分区与 rootfs 物理隔离
- logrotate 策略已验证(手工触发一次轮转)
- 日志风暴限流已生效(实测:制造 1 kHz 错误,观察磁盘写入速率)
- 写寿命估算已做过(日增量 × 365 × 5 年 < eMMC TBW)
上报
- 断网续传已验证(拔网线 30 min 后恢复,确认日志补传完整)
- 队列溢出策略为
drop_oldest且log_dropped计数已进心跳 - 脱敏规则已过一遍真实日志样本
- 流量估算已做(月度流量 × 单价在预算内)
诊断能力
- 每台设备保留串口 header(pstore 失效时的最后手段)
- 内核
vmlinux与System.map已归档,且与出货固件版本一一对应 - 关键路径已埋入全局 seq / trace id
- 时间同步已启用并验证(断网后时钟漂移可接受)
- 一台设备做过完整的"人为制造故障 → 远程定位"演练
10. 小结
这一篇的核心,其实只有三句话:
- 先数清楚日志从哪来——高通平台 6 个以上子系统各自产出日志,漏掉任何一个都是永久盲区;
- 崩溃现场必须提前预留——pstore/ramoops 是唯一能在 panic 后存活的通道,且要清醒地知道它撑不过冷复位;
- 日志系统本身要能扛住故障——限流、配额、分区隔离、有界队列,四者缺一不可。一个把自己写死设备的日志系统,比没有日志更糟。
对比之前的功能安全:安全机制负责让设备不出事,日志与诊断体系负责出事后能讲清楚发生了什么。两者合起来,才构成工业设备可交付、可维护、可追责的完整闭环。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献37条内容

所有评论(0)